本地部署huggingface模型,建立自己的翻译应用

what is hugging face?官方/国内镜像网站 & hugging face操作界面详解 & 在hugging face下载源码 & hugging face快速复现大模型 what is hugging face?官方/国内镜像网站 & hugging face操作界面详解 & 在hugging face下载源码 & hugging face快速复现大模型 一文搞定 阅读详情
AI摘要

本文介绍了大模型AI的学习路径,包括初阶应用、高阶应用、模型训练和商业闭环四个阶段,还分享了翻译模型Helsinki - NLP/opus - mt - zh - en等在本地部署的方法,以及Hugging Face Transformers库中函数的参数使用,最后提供了大模型AI学习资料的免费领取方式。

过去,我们使用翻译接口时,往往都是使用百度等的接口,每天有一定量的免费额度。今天为大家介绍一个可以进行翻译的模型,具备英译中、中译英的能力。并且在这个过程中,向大家介绍一个如何在本地部署模型。在之前的”五天入门RAG“中,我们介绍过如何线上运行,但这是需要网络条件的,当你不具备时,可以在本地安装使用。

这个模型就是Helsinki-NLP/opus-mt-zh-en和Helsinki-NLP/opus-mt-en-zh。在后面,我们会再带大家体验具备语音翻译,转录的模型SeamlessM4T。

首先进入:https://huggingface.co/

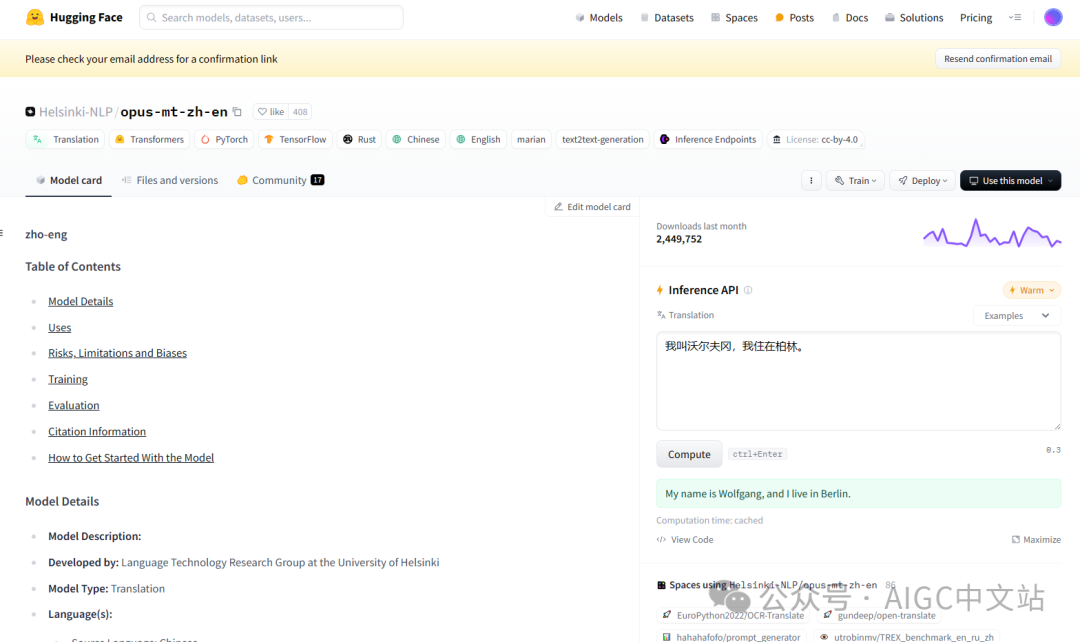
搜索:Helsinki-NLP/opus-mt-zh-en
图片

点击右边的compute试一下,翻译效果还不错。

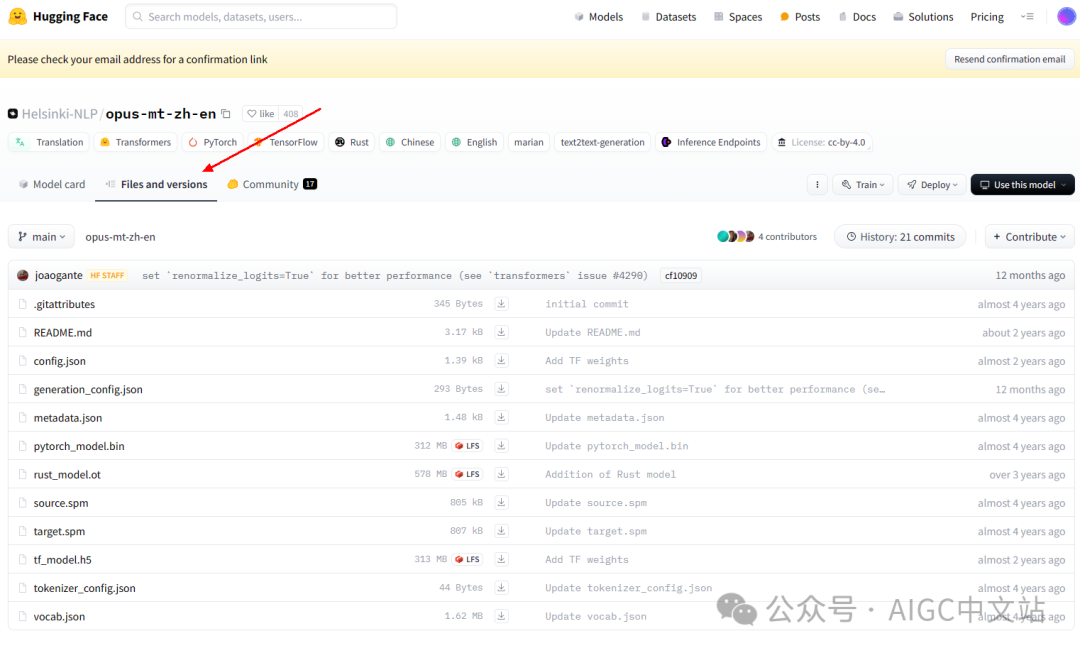
然后点击files卡片。
图片

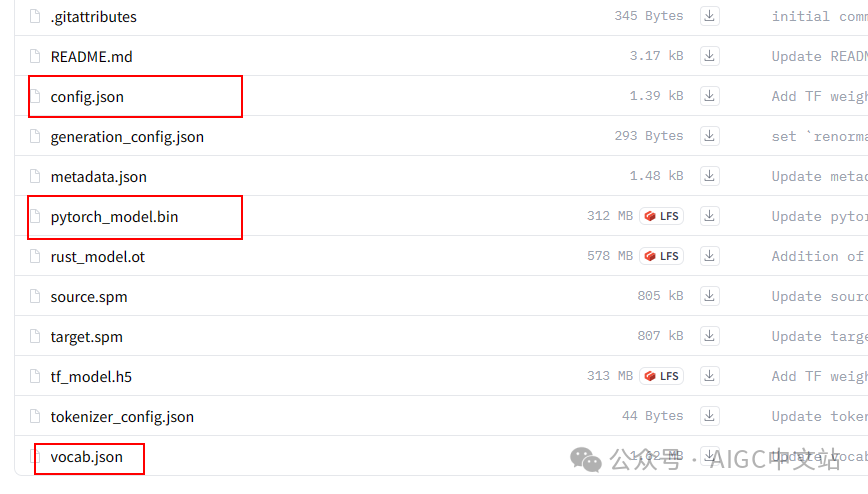
主要下载如下的几个文件。

图片

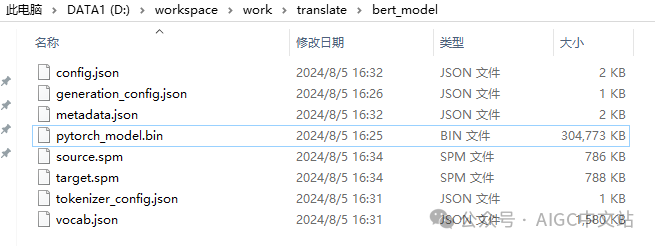
放到自己本地目录下:

图片

然后输入我们的翻译代码:

from transformers import AutoTokenizer, AutoModelForSeq2SeqLM

# 模型名称,如果模型已经下载到本地,可以直接指定路径
modelName = "D:/workspace/work/translate/bert_model/"
srcText = [
"大家好,我是一只来自中国的大熊猫",
"在这种方式下,我们的transformers才能发挥最大的作用",
"啊!华山,你可真是壮美",
]


#---------------------------------

tokenizer = AutoTokenizer.from_pretrained(modelName)
model = AutoModelForSeq2SeqLM.from_pretrained(modelName)
translated = model.generate(**tokenizer(srcText, return_tensors="pt", padding=True))
# 返回结果
r = [tokenizer.decode(t, skip_special_tokens=True) for t in translated]


print(r)

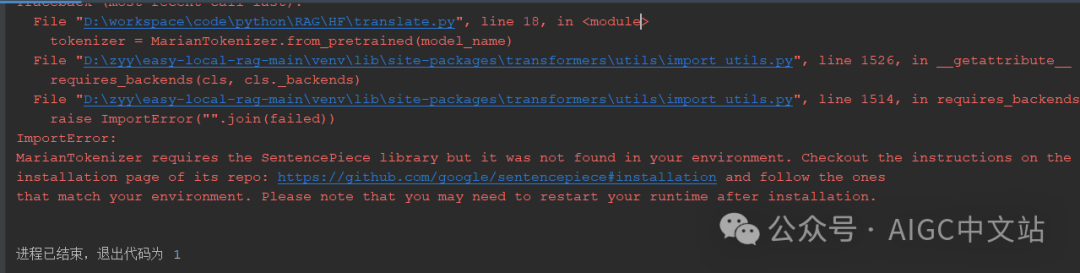
代码可能会提示错误
图片

那么我们安装这个就是了,代码如下:

pip install SentencePiece

然后再运行:

图片

["Hello. I'm a big panda from China.", 
"In this way, our transformers will be most effective.", 
"Oh, you're so beautiful, Wahshan."]

同样的,英译中使用另一个模型即可。

我们简单解释一下代码!

AutoTokenizer.from_pretrained

用于加载预训练的文本处理模型(Tokenizer),以便将文本数据转换为模型可以接受的输入格式。这个方法接受多个参数,以下是这些参数的详细说明:

1.pretrained_model_name_or_path (str):

-这是最重要的参数,指定要加载的预训练模型的名称或路径。可以是模型名称(例如 “bert-base-uncased”)或模型文件夹的路径。

\2. inputs (additional positional arguments, optional)

它表示额外的位置参数,这些参数会传递给标记器(Tokenizer)的__init__()方法。这允许你进一步自定义标记器的初始化。

\3. config ([PretrainedConfig], optional)

这个配置对象用于确定要实例化的分词器类。

4.cache_dir (str, optional):

用于缓存模型文件的目录路径

\5. force_download (bool, optional):

如果设置为 True,将强制重新下载模型配置,覆盖任何现有的缓存。

\6. resume_download (bool, optional):

-这是可选参数,如果设置为 True,则在下载过程中重新开始下载,即使部分文件已经存在。

\7. proxies (Dict[str, str], optional)

proxies(可选参数):这是一个字典,用于指定代理服务器的设置。代理服务器允许您在访问互联网资源时通过中继服务器进行请求,这对于在受限网络环境中使用 Transformers 库来加载模型配置信息非常有用。

​ proxies = { “http”: “http://your_http_proxy_url”, “https”: “https://your_https_proxy_url” }

\8. revision (str, optional):

指定要加载的模型的 Git 版本(通过提交哈希)。

\9. subfolder (str, optional)

如果相关文件位于 huggingface.co 模型仓库的子文件夹内(例如 facebook/rag-token-base),请在这里指定。

\10. use_fast (bool, optional, defaults to True)

这是一个布尔值,指示是否强制使用 fast tokenizer,即使其不支持特定模型的功能。默认为 True。

\11. tokenizer_type (str, optional)

参数用于指定要实例化的分词器的类型

\12. trust_remote_code (bool, optional, defaults to False)

trust_remote_code=True:

默认情况下,trust_remote_code 设置为 True。这意味着当您使用 from_pretrained() 方法加载模型配置文件时,它将下载来自 Hugging Face 模型中心或其他在线资源的配置文件。这是一个方便的默认行为,因为通常这些配置文件是由官方提供的,且是可信的。

trust_remote_code=False:

如果您将 trust_remote_code 设置为 False,则表示您不信任从远程下载的配置文件,希望加载本地的配置文件。这对于安全性或定制性要求较高的场景可能是有用的。

在这种情况下,您需要提供一个本地文件路径,以明确指定要加载的配置文件

总之,trust_remote_code 参数允许您在使用 Hugging Face Transformers 库时控制是否信任从远程下载的配置文件。默认情况下,它被设置为 True,以方便加载官方提供的配置文件,但您可以将其设置为 False 并提供本地配置文件的路径,以进行更精细的控制。

AutoModel.from_pretrained()

AutoModel.from_pretrained() 是 Hugging Face Transformers 库中的一个函数,用于加载预训练的深度学习模型。它允许你加载各种不同的模型,如BERT、GPT-2、RoBERTa 等,而无需为每个模型类型编写单独的加载代码。以下是 AutoModel.from_pretrained() 函数的主要参数:

\1. pretrained_model_name_or_path (str):

-这是一个字符串参数,用于指定要加载的预训练模型的名称或路径。可以是模型的名称(如 “bert-base-uncased”)或模型文件夹的路径。

\2. *model_args

直接传参的方式,传入配置项,例如,我们将编码器层数改为3层

model = AutoModel.from_pretrained(“./models/bert-base-chinese”, num_hidden_layers=3)

加载模型时,指定配置类实例

model = AutoModel.from_pretrained(“./models/bert-base-chinese”, config=config)

3.trust_remote_code (bool, optional, defaults to False)

trust_remote_code=True:

默认情况下,trust_remote_code 设置为 True。这意味着当您使用 from_pretrained() 方法加载模型配置文件时,它将下载来自 Hugging Face 模型中心或其他在线资源的配置文件。这是一个方便的默认行为,因为通常这些配置文件是由官方提供的,且是可信的。

trust_remote_code=False:

如果您将 trust_remote_code 设置为 False,则表示您不信任从远程下载的配置文件,希望加载本地的配置文件。这对于安全性或定制性要求较高的场景可能是有用的。

在这种情况下,您需要提供一个本地文件路径,以明确指定要加载的配置文件

总之,trust_remote_code 参数允许您在使用 Hugging Face Transformers 库时控制是否信任从远程下载的配置文件。默认情况下,它被设置为 True,以方便加载官方提供的配置文件,但您可以将其设置为 False 并提供本地配置文件的路径,以进行更精细的控制。

hub_kwargs_names = [

“cache_dir”, #同上面

“force_download”,#同上面

“local_files_only”,

“proxies”, #同上面

“resume_download”, #同上面

“revision”, #同上面

“subfolder”, #同上面

“use_auth_token”,

]

local_files_only:

如果设置为True,将只尝试从本地文件系统加载模型。如果本地文件不存在,它将不会尝试从Hugging Face模型存储库下载模型文件。如果本地存在模型文件,它将从本地加载。如果设置为False(默认值),它将首先尝试从本地加载,如果本地不存在模型文件,它将尝试从Hugging Face模型存储库下载模型文件并缓存到本地,然后加载。

from transformers import AutoModel

model = AutoModel.from_pretrained(“bert-base-uncased”, local_files_only=True)

详解 use_auth_token 参数:

默认值:use_auth_token 参数的默认值通常为 None,这意味着在默认情况下不使用身份验证令牌。

作用:Hugging Face Model Hub 上的一些模型可能需要身份验证令牌才能访问。这通常是因为模型的创建者希望对其进行访问控制,或者出于其他原因需要进行身份验证。如果模型需要身份验证令牌,你可以在 use_auth_token 参数中提供有效的令牌,以便在下载模型时使用。

获取身份验证令牌:要获得有效的身份验证令牌,你需要注册并登录到 Hugging Face Model Hub,然后访问你的个人配置文件(profile),那里会提供一个 API 令牌(API token),你可以将其用作 use_auth_token 的值。

from transformers import AutoModel

# 使用身份验证令牌来加载模型

model = AutoModel.from_pretrained(‘model_name’, use_auth_token=‘your_auth_token’)

大多数模型不需要身份验证令牌,并且可以在不提供 use_auth_token 参数的情况下加载。只有在你确实需要进行身份验证才需要使用此参数。

model.generate()

model()的使用场景:当你需要对输入数据执行一次完整的前向计算时使用,如分类任务、特征提取等。
model.generate()的使用场景:当你需要模型自动生成文本或序列,尤其是在语言模型中,如GPT、T5等。

return_tensors=‘pt’, 自动的将所有的结果都转化成二纬的tensor数据,因此,后面我们还需要将数据进行解码,完成编码解码。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
Huggingface 超详细介绍 Hugging face 起初是一家总部位于纽约的聊天机器人初创服务商,他们本来打算创业做聊天机器人,然后在github上开源了一个Transformers库,虽然聊天机器人业务没搞起来,但是他们的这个库在机器学习社区迅速大火起来。目前已经共享了超100,000个预训练模型,10,000个数据集,变成了机器学习界的github。其之所以能够获得如此巨大的成功,一方面是让我们这些甲方企业的小白,尤其是入门者也能快速用得上科研大牛们训练出的超牛模型。 阅读详情

相关推荐

HuggingFace 简介

HuggingFace 简介

engchina的专栏 2万+

Huggingface的介绍,使用(优快云最强Huggingface入门手册)

Huggingface即是网站名也是其公司名,随着transformer浪潮,Huggingface逐步收纳了众多最前沿的模型和数据集等有趣的工作,与transformers库结合,可以快速使用学习这些模型。进入Huggingface网站,如下图所示。Models(模型),包括各种处理CV和NLP等任务的模型,上面模型都是可以免费获得Datasets(数据集),包括很多数据集Spaces(分享空间),包括社区空间下最新的一些有意思的分享,可以理解为huggingface朋友圈。

大模型天花板 7万+

HuggingFace入门指南:从核心概念到模型微调与部署

在人工智能与自然语言处理领域,预训练模型已成为技术落地的关键基础设施,而HuggingFace作为模型共享与工具集成的生态平台,正逐步统一模型获取、数据处理与推理部署的标准化流程。其核心价值在于通过Tokenizer、Model、Pipeline等组件,将复杂的深度学习原理封装为简洁易用的接口,让开发者无需深入底层机制,即可调用BERT、GPT等先进模型完成文本分类、情感分析等任务。同时,datasets与accelerate库进一步降低了数据准备和分布式训练的门槛,使得在小规模算力下进行模型微调成为可能。

weixin_34342207的博客 457

HuggingFace简明教程

什么是huggingface?huggingface是一个开源社区,它提供了先进的NLP模型,数据集,以及其他便利的工具。这些数据集可以根据任务、语言等来分类官方文档:主要的模型:自回归:GPT2、Transformer-XL、XLNet自编码:BERT、ALBERT、RoBERTa、ELECTRA安装环境:前置环境:python、pytorch安装#安装transformers#pip安装#conda安装#安装datasets#pip安装#conda安装。......

weixin_44748589的博客 2万+

HuggingFace实战指南:从模型调用、数据准备到微调部署

在自然语言处理(NLP)和大模型应用开发中,统一工具链是提升效率的关键。HuggingFace生态以Transformer模型为核心,通过AutoModel、AutoTokenizer等标准化接口,将模型调用、数据处理、微调与部署串成一条完整链路。无论是文本分类、命名实体识别还是生成式任务,开发者都可以基于同一套API快速构建和切换模型。面对真实业务,数据清洗与分词、参数高效微调(如LoRA)、量化部署等环节常常成为落地瓶颈。这篇内容从实践出发,按照模型调用、数据准备、微调、部署的顺序,梳理每个模块的作用与

weixin_30911451的博客 413

【模型之美】18、HuggingFace大模型部署全攻略:从本地测试到生产环境一键上线

大模型部署实战:HuggingFace工具链全解析 本文系统介绍HuggingFace生态的核心工具链,帮助开发者实现大模型的高效部署。主要内容包括: 基础工具:Transformers Pipeline实现一行代码调用模型,支持30+种任务,自动处理预处理/推理/后处理全流程。 模型优化:通过量化和剪枝技术提升性能,量化可将7B模型从13GB压缩至3.5GB(Int4),推理速度提升4-6倍。 部署方案: 免费部署:HuggingFace Spaces提供容器化Web应用托管 生产级部署:推理端点支持自动

2025博客之星Top81。专注AI工程化与架构实战。从分布式思维到模型部署,用工程化视角为你厘清AI落地的真实路径。 1637

本地化Huggingface模型:轻松创建自己的翻译应用

过去,我们使用翻译接口时,往往都是使用百度等的接口,每天有一定量的免费额度。今天为大家介绍一个可以进行翻译的模型,具备英译中、中译英的能力。并且在这个过程中,向大家介绍一个如何在本地部署模型。在之前的”五天入门RAG“中,我们介绍过如何线上运行,但这是需要网络条件的,当你不具备时,可以在本地安装使用。这个模型就是Helsinki-NLP/opus-mt-zh-en和Helsinki-NLP/opus-mt-en-zh。在后面,我们会再带大家体验具备语音翻译,转录的模型SeamlessM4T。

2401_84495872的博客 1539

飞塔防火墙和paloalto防火墙构建ipsec

一、配置fortigate防火墙1.防火墙配置上网功能1.1配置fortigate的wan1接口IP为100.100.100.2/24VLAN交换internal,IP地址为192.168.156.99/24。开启DHCP分配IP地址范围为192.168.156.110-192.168.156.2101.2配置访问互联网的缺省路由1.3配置访问互联网的安全策略2.配置与Paloalto防火墙的IPSECVPN。

weixin_44675999的博客 3739

HuggingFace镜像网站支持模型卡片翻译

HuggingFace镜像站现已支持模型卡片自动翻译为中文,结合ms-swift框架实现高效下载、轻量微调与一键部署,显著降低中文开发者使用门槛。通过CDN加速和智能路由,模型获取速度提升5-10倍,配合QLoRA等技术,单卡即可完成大模型微调,真正实现开箱即用的本地化开发体验。

weixin_28872035的博客 737

STM32进入HardFault_Handler时,如何找到问题所在?

当STM32进入HardFault_Handler时,定位问题发生的点

m0_60831979的博客 2150

从零到一:构建嵌入式Nginx的模块化架构与跨平台部署实战

本文详细介绍了在ARM32架构的RV1126嵌入式设备上,通过交叉编译技术构建模块化Nginx服务器的完整实战流程。涵盖环境配置、依赖库编译、Nginx核心与http_ssl_module等模块集成、性能优化及部署调试,为嵌入式开发提供高效可靠的Web服务器解决方案。

rock5的博客 202

LLM大模型-大模型 API 集成使用、部署本地大模型(huggingface、modelscope)、实现Qwen和Deepseek本地部署

人工智能中的大模型(Large Model / Foundation Model),是指参数规模通常在数十亿甚至千亿以上的深度神经网络。它们依靠大规模数据和高算力平台训练而成,具备强泛化能力和跨任务迁移能力,能够在自然语言处理、计算机视觉、语音、多模态等多个领域展现出较强的性能。参数规模巨大:例如 GPT-3 拥有 1750 亿参数。预训练 + 微调:先在海量通用数据上进行预训练,再通过少量标注数据进行下游任务微调。

2202_75674969的博客 2414

整理的15个公开且可直接使用的电力视觉输电线路领域数据集

而巡检数据是目前来说影响我们做科研的最大阻碍,为此本内容主要总结了,现有的且公开免费的巡检数据集,供大家使用。STN PLAD数据集133个航拍图像,五个电力部件:电力塔及其塔的ID、绝缘子,防震锤,联板(yoke),图像的尺寸在5472×3648到5472×3078。IDID数据集:2000张图像,包含三个类别,正常绝缘子,破损绝缘子和闪络绝缘子三个类别,用于目标检测的实验。TTPLA数据集,用于实例分割,1100张尺寸为3840×2160,包含两个类别,电力杆塔和电力线。主要用于电力杆塔的目标检测。

weixin_42048361的博客 5017

学习AI第一课:本地部署AI大模型

AI 大模型发展到现在,国内外都有在线和离线版本,那如何在自己本地部署大模型呢?本文分享了一种简单的办法,一起来看看吧。我们经常能看到某某公司开源了一款 AI 大模型的新闻。这些模型都有着超强的能力,从生成大段的文字、逼真的图像,到理解和翻译不同语言,再到创造出令人叹为观止的音乐和艺术作品。对于我们普通人来说,这些高科技听起来不仅遥不可及,而且似乎与我们的日常生活无关,他们像是只有那些天才和大神们才能操作和使用的。

GIS摆渡人 4112

EtherCAT丢包问题深度解析:从原理到实战排查指南

在工业自动化与运动控制领域,实时通讯网络的稳定性是系统可靠运行的基石。EtherCAT(以太网控制自动化技术)作为一种高性能工业以太网协议,其核心在于独特的“飞读飞写”机制和纳秒级的分布时钟同步,以实现多设备间的精准协同。然而,物理链路干扰、配置不当或硬件性能瓶颈都可能导致数据帧丢失,破坏时钟同步,进而引发伺服抖动、定位精度下降乃至生产线停机。本文聚焦于EtherCAT丢包这一典型故障,结合SSC(Slave Stack Code Tool)从站协议栈开发与实时系统调优等工程实践,系统阐述其成因、影响及一套

weixin_32050773的博客 341

避开这些坑!QMT多因子策略实盘中的5个常见错误及解决方案

本文深入剖析了在QMT平台上实施多因子策略时常见的5个错误,包括因子过拟合、数据延迟处理不当、因子失效、交易成本低估和风险控制缺失,并提供了实用的解决方案。通过优化因子筛选、数据对齐和动态管理,帮助量化交易者提升策略稳健性和实盘表现。

k5l6m的博客 238

三步搞定HuggingFace BERT预训练模型的本地部署与调用

本文详细介绍了如何将HuggingFace BERT预训练模型下载并部署到本地,实现离线调用。通过精准获取模型文件、配置Python环境、从本地路径加载模型三个核心步骤,帮助开发者彻底摆脱网络依赖,提升模型推理的稳定性和速度,适用于网络受限或需要离线部署的NLP项目场景。

weixin_29276847的博客 419

机器人视觉联动精度优化:从±2mm到±0.02mm,产线级手眼标定全实战

2025年我接东莞长安Type-C接口分拣项目的时候,就是栽在了手眼标定上:实验室里标定完精度±0.5mm,一到产线直接掉到±2mm,机器人10次有3次抓不住,2000多件Type-C接口直接报废,还撞坏了2套汇川SCARA机器人的吸盘,本来45天的工期拖了3个月,不仅没赚到钱,还倒贴了几万块。手眼标定从来不是简单的跑个demo、算个矩阵就完事了,它是一个系统工程:从硬件选型、安装固定、相机标定、标定流程、算法优化、环境控制、重复验证,每一个环节都会影响最终的联动精度。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 386

HuggingFace翻译模型ONNX部署实战:从导出到量化

将HuggingFace上的生成式模型投入生产环境时,常见的部署瓶颈是笨重的PyTorch运行时与低效的CPU推理。ONNX Runtime通过静态计算图和轻量执行引擎,让模型脱离原始库独立运行,成为工业界主流的模型优化与部署方案。以英译中任务为例,翻译模型属于Encoder-Decoder架构,推理需自回归生成,无法像分类模型那样一次导出,必须将编码器与解码器拆分为独立ONNX文件,并手写解码循环。文章围绕这一核心挑战,详细梳理了从Optimum导出、动态轴配置、精度对比到Int8量化的完整链路,并给出了

weixin_29042035的博客 206

《网络安全自学教程》- 防火墙原理分析与Windows防火墙使用配置

防火墙分类及原理,Windows开启防火墙,Windows防火墙添加策略,

wangyuxiang946的博客 1万+

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

HuggingFace模型迁移ONNX实战:翻译模型部署优化与量化指南

在生产环境中部署深度学习模型,常常要面对依赖臃肿、启动缓慢和推理性能不足等难题。开放神经网络交换格式ONNX作为一种跨框架的中间表示,能将训练好的模型标准化导出,并借助ONNX Runtime实现高效推理。其原理在于将计算图进行算子融合、内存复用等静态优化,配合动态量化技术可进一步缩减模型体积并提升CPU处理速度。这一技术路线广泛应用于NLP推理服务、边缘设备部署等场景。本文以英译中翻译模型为案例,完整演示了从HuggingFace平台选取模型、手动导出ONNX、配置动态轴、int8量化,到使用ONNX R

weixin_29048775的博客 290

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

HuggingFace镜像站也能用!腾讯HunyuanOCR模型下载与部署技巧

腾讯推出的HunyuanOCR将检测、识别与结构化抽取集成于1B参数的端到端模型中,支持百种语言且适配消费级显卡。借助HuggingFace镜像站,国内用户可高效下载并部署,结合vLLM加速和FastAPI服务,轻松构建高性能OCR系统。

weixin_33816734的博客 761

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

Hunyuan-MT-7B-WEBUI能否翻译HuggingFace模型卡片?

Hunyuan-MT-7B-WEBUI凭借强大的多语言翻译能力与图形化操作界面,能够准确翻译HuggingFace上的英文模型卡片。它在技术术语处理、上下文理解方面表现优异,特别优化中英互译,配合一键部署的WEBUI系统,让非专业用户也能快速获取高质量译文,极大提升了中文用户使用国际AI资源的效率。

weixin_35728286的博客 1054

HuggingFace 入门到实战:模型下载、本地推理与 API 部署全指南

大模型应用开发中,模型托管与推理接口的统一是降低工程门槛的关键。HuggingFace 作为全球主流的模型平台,集中了海量预训练权重与开源工具链,通过 Transformers 库将不同架构的模型封装为一致的 Pipeline 调用方式。开发者借助国内镜像加速,可稳定完成模型下载与本地部署,无需从零训练即可实现文本分类、文生图、OCR、语音合成等任务。平台还提供数据集管理、模型微调及 Gradio/FastAPI 接口封装能力,支撑从离线验证到生产环境 API 服务的完整链路。本文围绕资源获取、环境配置、推

weixin_31499265的博客 344
上一篇: 我可真厉害,3分钟让你成为AI高手:提示词(prompt)制作及调优(免费教你,别再被割了)
下一篇: 前端开发转行AI大模型?应该如何准备面试?面试题+答案来了!!!
AI程序猿人
博客等级 码龄3年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值