使用Docker和Bitnami镜像快速搭建本地Kafka环境

在Ubuntu 20.04服务器上使用Bitnami堆栈创建WordPress博客 1、目的 ​ 最近准备搭建一个自己的博客网站,如果用WordPress完全建站的话,前端没办法自定义,所以就想自己搭建前端,然后用WordPress的后台。于是准备先在自己的ubuntu服务器上大家WordPress,如果是用镜像的话,那服务器就没办法做其他用途了,所以准备自己搭建。但是纯手工搭建需要配置apache, sql, php…太麻烦了┗|`O′|┛ 。调研了一番,决定使用Bitnami堆栈搭建!!! 2、Bitnami堆栈 ​ BitNami提供wordpress等开源程序,只需要下载安装包,然 阅读详情
AI摘要

本文介绍了使用Docker在本地搭建Kafka环境,包括工具地址、搭建集群问题、单机配置及Kafka UI搭建。还分享了AI大模型学习经验,提供学习路线、视频教程、书籍、实战案例和面试题库等资料,阐述学会大模型后的收获及学习意义。

一、前言

随着即将到来的Kafka 4.0的发布,Zookeeper将会完全淘汰,只有KRaft模式将得到支持。这一重大变化需要项目和开发者双方做好准备工作。

截至目前,最新的Kafka版本是3.6.1,从2022年10月3日发布的3.3.1版本开始,KRaft在生产环境下已经完全支持。

根据当前的发布计划,Kafka 3.7(预计于2024年1月发布)将是最后一个支持Zookeeper的版本。

如果想全面了解KRaft,我建议阅读这篇文章[1]。

在本指南中,我将教你如何使用Docker在本地搭建一个Kafka环境,并提供一个UI工具查看我们的Kafka数据。

注:本文大部分内容参考自 Setting up a Local Kafka Environment in KRaft Mode with Docker-Compose and Bitnami Image, Enhanced by Provectus Kafka-UI[2],侵权删。

二、工具及其地址

Bitnami镜像:https://hub.docker.com/r/bitnami/kafka/

Provectus Kafka UI:https://github.com/provectus/kafka-ui

注意:目前广泛使用的 wurstmeister[3] 镜像仅支持Zookeeper(且目前测试Dockerhub没有该镜像),不支持KRaft,而Bitnami两者都支持!

三、搭建Kafka集群遇到的问题

在搭建Kafka集群的过程中,我遇到了一些问题,可能对你会有所帮助!

问题一:

如果是单机Kafka,则无需指定KAFKA_KRAFT_CLUSTER_ID。与某些教程所建议的相反,Kafka会动态生成一个ID,并将其记录在日志中。如果是集群Kafka,则需要指定,但需注意,一个集群的所有Kafka示例的KAFKA_KRAFT_CLUSTER_ID都是一致的。

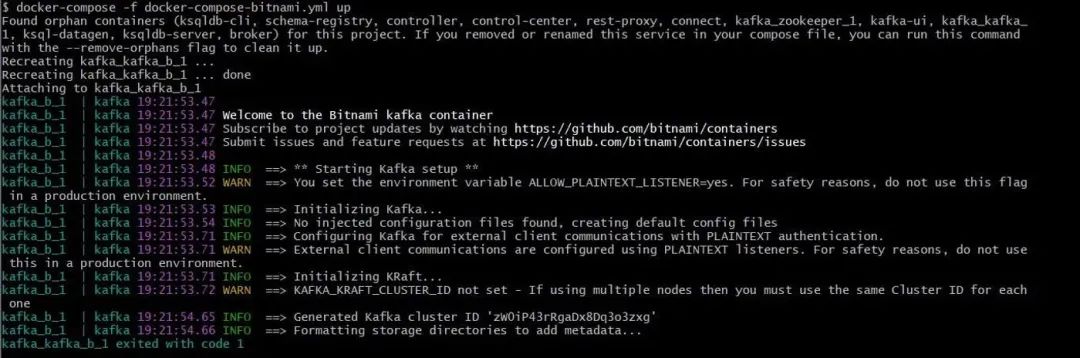
问题二:kafka_kafka_1 exited with code 1
img

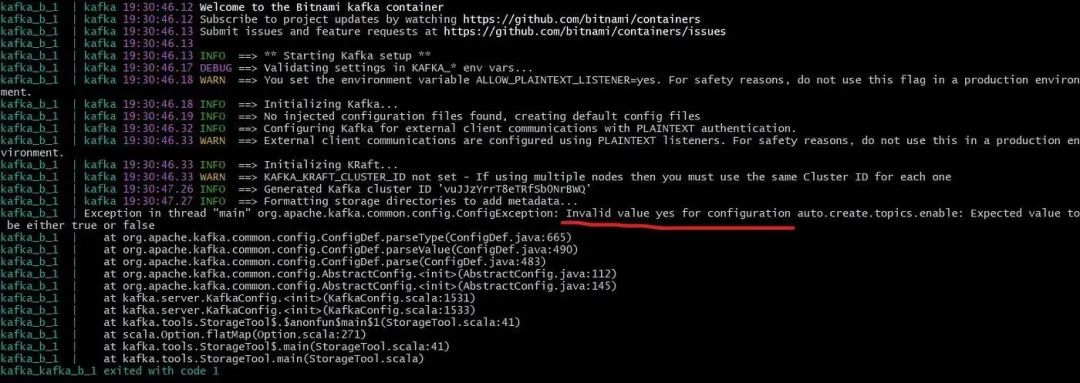
如上图,Kafka可能在没有抛出异常的情况下就失败了,在我的情况下,我复制了一个错误的环境配置,唯一确定真正问题的方法是通过BITNAMI_DEBUG=yes 启用调试日志记录,这使我能够找到问题的根本原因,因此我建议在故障排除时使用此配置。

这是我报错的根本原因:
img

四、搭建单机Kafka的配置

你可以在**这里[4]**找到由Bitnami提供的docker-compose文件,但它并不特别有用,因为您需要单独搜索所需的配置。

# $dir/kafka.yml
version: "3"
services:
  kafka_b:
    image: docker.io/bitnami/kafka:3.4
    hostname: kafka_b
    ports:
      - "9092:9092"
      - "9094:9094"
    volumes:
      - "kafka_data:/bitnami"
    environment:
      - KAFKA_ENABLE_KRAFT=yes
      - KAFKA_CFG_PROCESS_ROLES=broker,controller
      - KAFKA_CFG_CONTROLLER_LISTENER_NAMES=CONTROLLER
      - KAFKA_CFG_LISTENERS=PLAINTEXT://:9092,CONTROLLER://:9093,EXTERNAL://:9094
      - KAFKA_CFG_LISTENER_SECURITY_PROTOCOL_MAP=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT,EXTERNAL:PLAINTEXT
      - KAFKA_CFG_ADVERTISED_LISTENERS=PLAINTEXT://127.0.0.1:9092,EXTERNAL://kafka_b:9094
      - KAFKA_BROKER_ID=1
      - KAFKA_CFG_CONTROLLER_QUORUM_VOTERS=1@127.0.0.1:9093
      - ALLOW_PLAINTEXT_LISTENER=yes
      - KAFKA_CFG_NODE_ID=1
      - KAFKA_AUTO_CREATE_TOPICS_ENABLE=true
      - BITNAMI_DEBUG=yes
      - KAFKA_CFG_NUM_PARTITIONS=2
volumes:
  kafka_data:
    driver: local

关于配置,有几个注意点:

1、你可以使用 KAFKA_ENABLE_KRAFT 变量来切换 KRaft/Zookeeper 模式

2、你可以指定 hostname 配置,这样可以便于Kafka-UI工具查看你的数据(如果主机的UI工具,请注意配置下hosts文件)

3、你如果不想使用默认端口9092,则注意要修改 ports 和 KAFKA_CFG_ADVERTISED_LISTENERS 环境变量

4、如果你想允许自动创建Topic,则可以将 KAFKA_CFG_AUTO_CREATE_TOPICS_ENABLE 环境变量设置为 true

这里有另外一份配置可以参考下:

version: "2"

services:
  kafka:
    image: docker.io/bitnami/kafka:3.6
		# 指定你的容器名,不然是一串随机字符串
    hostname: kafka_b
#    networks:
#      - kafka_net
    ports:
      - "9095:9092"
    volumes:
      - "kafka_data:/bitnami"
    environment:
      # KRaft settings
      - KAFKA_CFG_NODE_ID=0
      - KAFKA_CFG_PROCESS_ROLES=controller,broker
      - KAFKA_CFG_CONTROLLER_QUORUM_VOTERS=0@kafka:9093
      # Listeners
      - KAFKA_CFG_LISTENERS=PLAINTEXT://:9092,CONTROLLER://:9093
			# 注意这里要同步改成9095
      - KAFKA_CFG_ADVERTISED_LISTENERS=PLAINTEXT://:9095
      - KAFKA_CFG_LISTENER_SECURITY_PROTOCOL_MAP=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT
      - KAFKA_CFG_CONTROLLER_LISTENER_NAMES=CONTROLLER
      - KAFKA_CFG_INTER_BROKER_LISTENER_NAME=PLAINTEXT
      # auto create topics
      - KAFKA_CFG_AUTO_CREATE_TOPICS_ENABLE=true
volumes:
  # data in: /var/lib/docker/volumes/{$network}
  kafka_data:
    driver: local

#networks:
#  kafka_net:
#    driver: bridge

注意:搭建集群版Kafka的配置可以在**这里[5]**找到。

五、搭建 Provectus Kafka UI

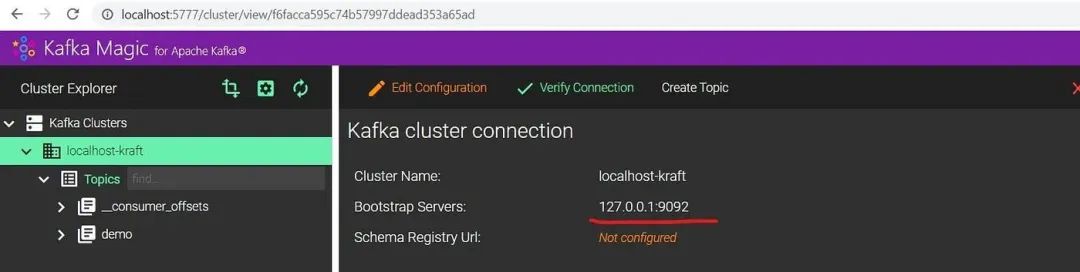
我测试了几个Kafka-UI工具(Conduktor,Kafka Magic,Offset Explorer等),发现当你需要通过外部名称连接到集群时,它们的行为可能会有所不同,这取决于您的部署策略。例如,使用Kafka Magic,即使没有外部侦听器(因为此UI未通过docker部署),我也能够直接连接到本地主机(127.0.0.1),但我不使用此工具,因为许多有用的功能仅在许可证下可用。
img

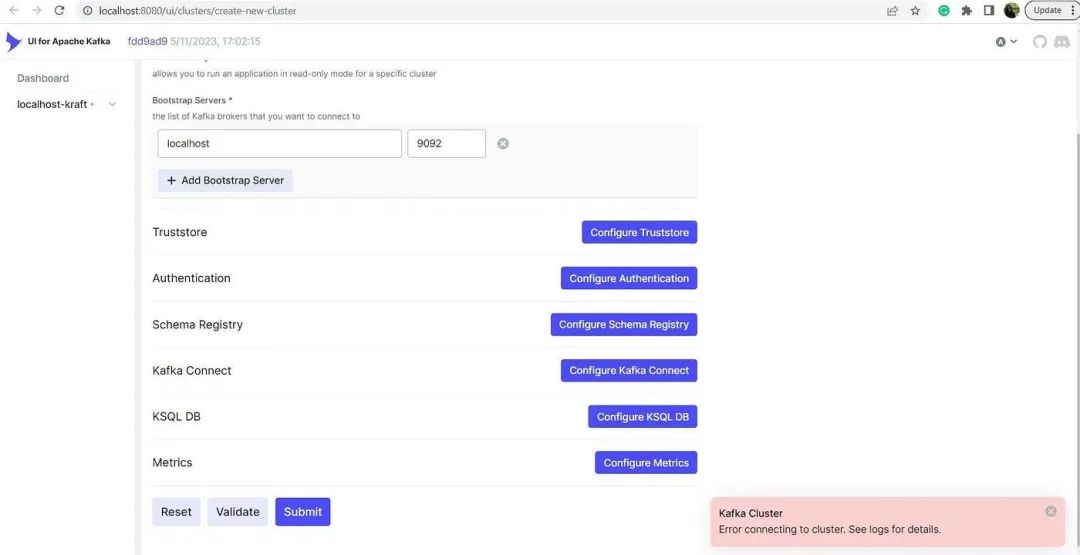
如果您正在寻找一个免费的开源工具,则 Provectus kafka-ui 可能会适合你。通过它的快速开始教程[6],你同样可以使用Docker快速搭建一个Kafka-ui,但需要注意的是,如果是用容器搭建的,此时连接我们前面的Kafka集群时,使用 localhost:9092[7] 的地址将会连接失败!
img

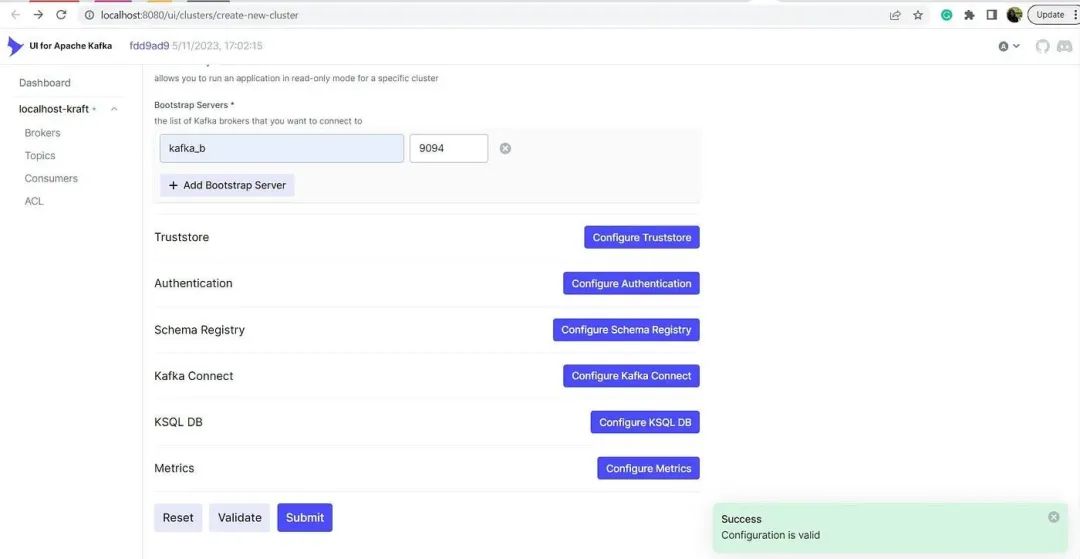
为了成功连接到我们前面搭建的本地Kafka,我们需要指定正确的主机名和端口,这些配置在我们的Kafka自身的docker-compose文件中已经设置(注意是 kafka_b:9094,9094是暴露给外部使用的端口,9092是内部使用的端口)。
img

这是 Provectus kafka-ui 对应的配置

# $dir/kafka-ui.yml
services:
  kafka-ui:
    container_name: kafka-ui
    image: provectuslabs/kafka-ui:latest
    ports:
      - 8080:8080
    environment:
      DYNAMIC_CONFIG_ENABLED: 'true'
      LOGGING_LEVEL_ROOT: 'DEBUG'
#    volumes:
#      - /c/tools/kafka/kui/config.yml:/etc/kafkaui/dynamic_config.yaml

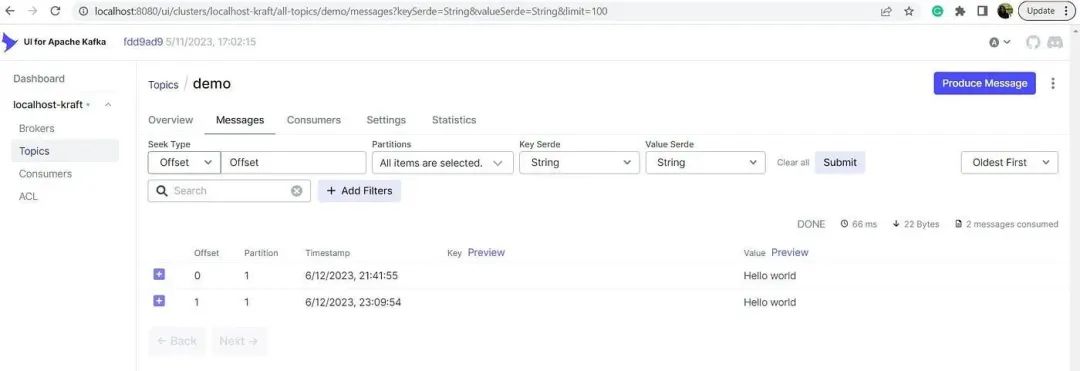
LOGGING_LEVEL_ROOT 配置用于故障排除,但实际上并不需要。在启动之后,我们可以在kafka-ui中的相应主题中查看我们的消息。
img

如果走到这一步,那么恭喜!您的环境现在已经完全设置好并可以使用了。

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍!

外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传

四、AI大模型各大场景实战案例

在这里插入图片描述

五、AI大模型面试题库
在这里插入图片描述

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

为什么bitnami 安装的软件进入容器,用户名都是I have no name 可以看到输出,current_user 处会显示主机当前用户的名字,这解决了主机用户对挂载的卷没有权限的问题。主机当前目录出现了容器内创建的 tmp.txt,但是其权限、用户和组均是 root,其他用户不可写。除了用户名显示问题还存在一个问题,在绑定挂载中如果没有挂载的目录容器没有权限写入内容。,这是因为我们通过 --user 参数指定了容器内部的用户 id,这样容器运行过程往 /project 写的临时文件都会出现在主机上。在k8中容器默认好像是以uid=1001启动的,可以修改该uid。 阅读详情

相关推荐

从零到可视化监控:我的Kafka 3.x学习环境搭建全记录(Docker Compose + bitnami镜像)

本文详细记录了使用Docker Compose和bitnami镜像搭建Kafka 3.x学习环境的全过程,包括环境规划、网络模式选择、编排文件配置及可视化界面实战。特别介绍了如何通过kafka-manager实现Kafka集群的可视化监控,帮助开发者快速掌握Kafka的核心概念和运行机制。

weixin_33733810的博客 655

Docker下的Kafka

在上一篇文章中我们已经成功地拉取了3.5.9版本的zookeeper官方镜像以及bitnami镜像,下面将通过使用bitnami的Kafka镜像搭配使用bitnami的zookeeper镜像来体验Kafka的使用。Kafka是一个分布式流处理平台和消息队列系统,旨在实现高吞吐量、持久性的日志型消息传输,并广泛应用于构建实时数据管道和大规模事件驱动型应用程序。

qq_59975945的博客 4704

docker 单节点arm架构服务器安装zookeeper、kafka并测试通信

kafka和zookeeper常见的镜像有以下三个:wurstmeister/zookeeper、kafka、confluentinc/cp-zookeeper、cp-kafka 和 bitnami/zookeeper、kafka。wurstmeister/xxx: 由wurstmeister团队维护,提供的镜像适用于开发和测试环境,具有便捷部署、版本多样、可自定义配置等特点。

weixin_45797022的博客 2102

Docker 安装 Kafka

docker在3.0以前依赖于zookeeper,在安装kafka之前需要先安装zookeeper集群。关于 zookeeper 集群的安装本文不做介绍,大家可以自行百度。

帝上无天的博客 7115

Windows 本地用 Docker Compose 搭建 Kafka 测试环境与联调指南

消息队列是后端架构中实现异步解耦、削峰填谷的核心组件,而 Kafka 凭借高吞吐、分布式与持久化能力成为日志采集、流处理和业务消息场景的事实标准。在 Windows 开发机上搭建 Kafka 测试环境时,原生安装包往往受制于 JDK 版本、环境变量和残留文件,而容器化技术通过镜像封装与编排文件,将中间件栈变成可复现、可一键启停的基础设施。掌握 Docker Compose 的配置语法、端口映射与容器网络原理,就能快速构建本地消息中间件沙箱,完成主题创建、生产消费验证和消费组位移监控。当外部客户端连接失败或消

weixin_30899023的博客 199

WSL下的Kafka开发容器:Docker搭建、API、整合

本文介绍了如何在WSL下使用Docker搭建Kafka容器,并使用Python的kafka-python库和FastAPI框架实现了一个简单的API。同时,还将该服务整合到一个整体的docker-compose中。文章详细介绍了Docker网络、Kafka环境变量配置、Python连接Kafka的方法以及API的开发。

GuapoChen的博客 1259

Docker部署Kafka避坑指南:从单节点到三节点集群配置详解

消息队列是现代分布式系统异步通信的基石,而Kafka作为高吞吐量的代表,常被用于日志收集、流量削峰和事件驱动架构。在实际工程实践中,容器化技术Docker能大幅简化Kafka的本地搭建流程,但随之而来的网络配置问题,尤其是advertised.listeners设置不当,经常导致客户端连接失败。本文从Kafka与Docker结合的架构选型入手,解析KRaft模式取代ZooKeeper后的配置变化,并逐步演示单节点启动、三节点集群编排、故障切换验证及典型报错排查。对于本地开发环境快速验证生产消费链路,或测试环

weixin_33563728的博客 167

Windows下用Docker搭建Kafka测试环境:从零到联调实战

消息队列是分布式系统解耦与削峰填谷的核心组件,而Kafka凭借高吞吐、可持久化等特性成为行业事实标准。然而在Windows本机直接部署Kafka,往往面临JDK版本不匹配、ZooKeeper依赖、环境变量冲突等繁琐问题。容器化技术恰好解决了这些痛点,通过Docker将Kafka及其运行环境封装进独立容器,实现环境隔离与快速启停。借助WSL2后端,Docker Desktop能在Windows上无缝运行Linux容器,只需一条Compose命令即可拉起完整的Kafka服务。从创建Topic、生产消费验证,到宿

weixin_33428613的博客 240

Docker 安装 kafka (bitnami/kafka:4.0)

这条命令启动了一个基于 Bitnami 提供的 Kafka 4.0 镜像的容器,并在 KRaft 模式(即不依赖 Zookeeper)下同时担任 controller 和 broker。它设置了时区、节点 ID、监听器及广告地址,指定数据和日志存储目录,限制了文件句柄数、内存和 CPU 使用,并在主机上映射了对应端口,保证容器重启策略为“始终重启”。命令的整体概览,然后逐行详解各个参数和环境变量的作用。

m0_51431003的博客 5362

Bitnami镜像实战:5分钟搞定Kafka 4.0容器化部署(含外网访问配置)

本文详细介绍了如何使用Bitnami官方镜像,在5分钟内快速完成Kafka 4.0的容器化部署。文章重点剖析了Docker网络模式与`ADVERTISED_LISTENERS`核心参数的配置,提供了从本地开发到公网访问的多种实战场景解决方案,并涵盖防火墙、安全组等生产环境必备的网络配置细节,帮助用户彻底解决Kafka外网访问的难题。

weixin_28335283的博客 467

从单机到集群就差一步?手把手教你用Docker Compose配置Kafka高可用伪集群(基于Bitnami镜像)

本文详细介绍了如何使用Docker Compose和Bitnami镜像在单机上快速搭建Kafka高可用伪集群。通过配置多个Kafka容器实例模拟不同Broker,结合Zookeeper协调服务,实现分布式消息队列的集群部署。文章包含完整的docker-compose.yml示例、关键配置说明、网络模式选择建议以及集群验证方法,帮助开发者高效学习Kafka集群部署。

weixin_26757925的博客 388

docker镜像wurstmeister/kafka、confluentinc/cp-kafka 和 bitnami/kafka

Confluent是一个提供企业级Kafka解决方案的公司,他们的镜像提供了更全面和功能齐全的Kafka部署。bitnami/kafka: 这个镜像由Bitnami维护,Bitnami是一个提供各种流行应用的Docker镜像和软件包的公司。bitnami/kafka镜像提供了一个简单且易于使用的Kafka部署。wurstmeister/kafka、confluentinc/cp-kafka 和 bitnami/kafka 是三个常见的Docker镜像,用于在Docker容器中运行Apache Kafka。

时时刻刻看着自己的心的专栏 3784

bitnami-docker-kafka:用于Kafka的Bitnami Docker映像

bitnami-docker-kafka:用于Kafka的Bitnami Docker映像

Kafka Docker 配置对比:Bitnami vs Apache 官方镜像

Docker Compose 配置 Kafka 时存在两种环境变量前缀差异:Bitnami 镜像使用 KAFKA_CFG_ 前缀(如 KAFKA_CFG_LISTENERS),而 Apache 官方镜像直接使用 KAFKA_ 前缀(如 KAFKA_LISTENERS)。这种差异源于两者的设计理念:Bitnami 通过封装脚本统一管理配置,适合快速部署;Apache 镜像则保持原生配置风格,适合需要精细控制的场景。生产环境推荐使用 Bitnami 镜像(指定具体版本),因其开箱即用且社区支持完善,而 Apac

小小的木头人的博客 403

从按键开机到I2C隔离:手把手拆解一个智能硬件项目里的MOS管实战配置

本文详细解析了智能硬件项目中MOS管的实战配置,从按键开机电路到I2C总线隔离,全面覆盖电源管理和信号隔离的关键技术。通过PMOS+NMOS组合方案实现可靠的开机功能,并采用双NMOS方案优化I2C通信隔离,提升系统稳定性和信号质量。

weixin_28691741的博客 326

QuickFix Java 讲解(五)消息的收发与查看

本系列力求手把手教你怎样利用QuickFix Java 搭建自己的 FIX 协议收发平台,以及其中的注意事项。 所有源码的地址(免费): https://github.com/zongzhec/QuickFixPractise 这节我们讨论将Acceptor和Initiator启动以后,收到的消息极其查看方式。 6. 收发双方的通信 6.1. 启动后的通信和登录 为方便起见,这里我们使用统一的源码:https://github.com/zongzhec/QuickFixPractise ..

2246

Kafka(一)使用Docker Compose安装单机Kafka+Kafka UI+Prometheus JMX Exporter

这里我们的配置是选择的是KRaft,因为Kafka官方已经计划在Kafak中移除Zookeeper。对于UI配置项没什么特别要说的,这里只是提一下,注意这里的docker-compose.yml中environment的写法,和上面的Kafka镜像中environment的写法不同,这是两种不同的写法。> 文档网址 > Compose examples 下面可以找打很多Kafak ui的compose文件示例,不仅对UI的配置很有帮助,而且对刚入门Kafka的同学,也提供了非常好的示例,

本博客已迁移到 https://jacksparrow414.com 1万+

数据字典实战:如何用Excel快速搭建你的第一个数据字典(附模板下载)

本文针对中小团队在软件开发中面临的术语不一致问题,提供了一套使用Excel快速搭建数据字典的实战指南。文章详细讲解了核心字段设计、填充示例、高阶技巧及团队协作维护流程,旨在通过这一轻量级工具统一团队共识、提升开发效率,并附有实用模板下载。

weixin_29303701的博客 380

使用Docker部署Kafka

使用bitnami的kafka镜像,参考文档 拉取镜像: docker pull bitnami/kafka:2.4.1 https://raw.githubusercontent.com/bitnami/bitnami-docker-kafka/master/docker-compose.yml

qq_35939417的博客 3607

告别Qweb!用ReportBro在Odoo 13-19版本中5步搞定动态报表

本文介绍了如何在Odoo 13-19版本中使用ReportBro替代Qweb快速实现动态报表设计。通过5步集成指南,包括环境准备、前端集成、后端服务搭建等,展示了ReportBro在可视化设计、即时预览和多格式输出(PDF/XLSX)方面的优势,显著提升开发效率和报表灵活性。

mac99的博客 800

LIGGGHTS颗粒模拟入门:从DEM原理到工程实践

离散元法(DEM)是一种用于模拟颗粒物质行为的数值方法,其核心原理是通过计算每个颗粒的运动和相互作用来预测颗粒系统的宏观行为。该方法基于牛顿第二定律和接触力学模型,能够精确描述颗粒间的碰撞、摩擦和粘结等微观机制。在工程实践中,DEM技术为优化工业设备设计、预测材料流动和减少实验成本提供了重要价值。它广泛应用于制药造粒、矿石破碎、粉体输送和农业加工等领域,帮助工程师和研究人员深入理解颗粒系统的复杂动力学。LIGGGHTS作为一款基于LAMMPS的开源DEM软件,继承了其高效的并行计算架构,并针对颗粒模拟进行了

weixin_33979203的博客 419

基于Docker快速搭建Kafka 3.6.1集群(Kraft模式)| 2025最新实战教程

本文详细介绍如何使用Docker Compose在Windows环境下快速搭建高可用的Kafka 3.6.1三节点集群,采用最新的Kraft模式(无需Zookeeper),包含完整的配置文件、网络规划、性能优化及常见问题解决方案。适合实时计算、大数据处理等场景的学习与生产环境部署。

niujiao666的博客 1347

解密网页视频Blob链接:从防盗链到流媒体分片技术

本文深入解析了网页视频中Blob链接的工作原理,揭示了其作为现代视频防盗链与流媒体分片技术核心的本质。文章详细阐述了Blob对象与Media Source API如何协同工作,将视频数据分片传输,并结合HTML5的video元素实现安全、流畅的播放体验,有效提升了资源保护能力。

c7d8e的博客 317

Bitnami 镜像拉不下来了?官方策略变更与替代方案一篇讲清

Bitnami官方已全面取消Docker Hub上的免费镜像下载服务,包括Kafka、Redis、MySQL等核心安全镜像。本文提供两种替代方案:1) 商业订阅获取最新安全镜像;2) 通过轩辕镜像仓库拉取旧版遗留镜像(https://xuanyuan.cloud)。详细说明了镜像查询、拉取方法及不同场景下的使用建议,特别提醒旧版镜像仅限临时使用,生产环境需购买商业订阅。文中包含具体操作命令和重要注意事项,帮助开发者快速应对此次调整。

java_logo的专栏 843

GeoServer下载与安装(详细图文教程)

GeoServer官方版可以方便的发布地图数据,允许用户对特征数据进行更新、删除、插入操作,通过 GeoServer 可以比较容易的在用户之间迅速共享空间地理信息。

大剑师兰特的GIS世界 3275

【OpenClaw企业级智能体实战】第09篇:OpenClaw金融投研实战:17个场景+完整代码,打造专属数字研究员

金融投研面临信息过载、流程重复、数据安全合规三大核心痛点,OpenClaw作为本地部署的新一代AI智能体,凭借“长期记忆+主动执行+数据不出域”的优势,成为券商分析师集体追捧的效率工具。本文基于8家头部券商公开研报,拆解OpenClaw在金融投研的17个核心应用场景(信息处理、研报撰写、量化策略、流程自动化),详解原理、技术选型、实操流程,并提供可直接运行的完整代码与执行结果。文章兼顾新手入门与进阶提升,强调安全隔离部署与幻觉防范,读者可按步骤搭建专属投研智能体,将信息处理、数据整理等重复工作效率提升80%

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 674
上一篇: 大模型太给力了,数据库运维工作量直接减少 50%!
下一篇: docker-compose本地部署FastGPT与简单使用
少喝冰美式
博客等级 码龄3年 6839粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值