


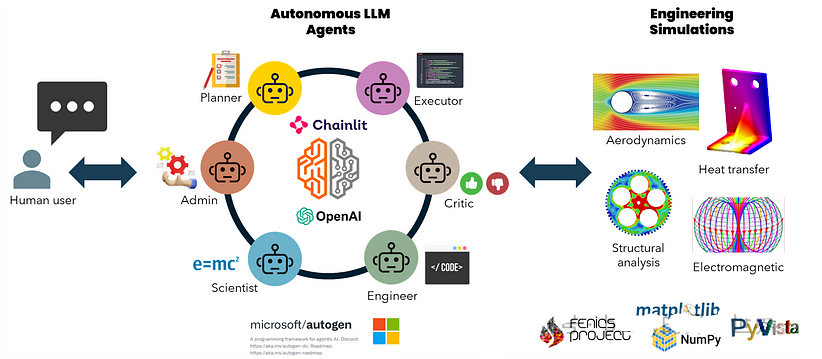
设想一个未来,人工智能通过简单的对话轻松解决工程问题。下一代人工智能和语言模型有望彻底改变我们利用有限元分析(FEA)和计算流体动力学(CFD)等工程工具解决结构分析、热力学、空气动力学、电场和电磁势等复杂问题的方式。很快,掌握这些工具将不再需要用户在力学、数学、材料、物理或编程方面的广泛专业知识。
今天的大型语言模型(LLMs)和生成式人工智能工具能够模仿人类行为,如自然语言处理、模式识别、记忆保持、批判性思维、推理和决策。它们还可以用 C++、Python、Julia 和 MATLAB 编写和调试数值算法。除了语言,它们是对话人工智能代理的核心,使得人工智能与人类、人工智能与工具之间的互动更加顺畅和高效。多个代理可以协作规划和执行任务,监控输出,适应变化,并使用工具自主实现目标。通过结合这些能力,工程师将能够仅通过与人工智能的对话,轻松与强大的数值仿真工具互动并解决工程问题,几乎不需要干预。
基于这些进展,在本文中,我将演示如何构建一个由 LLM 驱动的人工智能代理网络,这些代理可以在最小化人工输入的情况下自主创建模型并模拟固体力学和流体动力学中的问题。我们使用 Microsoft AutoGen 设置了一组对话代理,每个代理在规划、问题表述、编写、调试和执行代码、绘图和分析以及结果评估等角色中都是专家。它们将自主工作,根据需要相互纠正,以使用开源 Python 库创建和模拟 FEA 和 CFD 模型。OpenAI 的 GPT-4 是 这一过程的核心。该框架通过 Chainlit 应用程序封装在用户界面中。
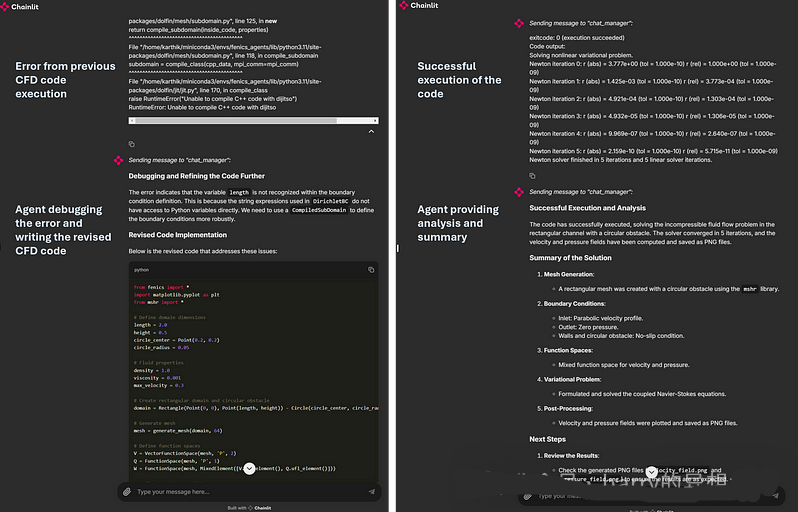
以下是该应用程序实际运行时的样子。
示例案例和提示
我在各种标记为 (a)-(d) 的 2D FEA 和 CFD 问题以及一个标记为 (e) 的 3D FEA 问题上测试了该应用程序。下面是代理生成的相应图形,以及它们的初始用户提示。
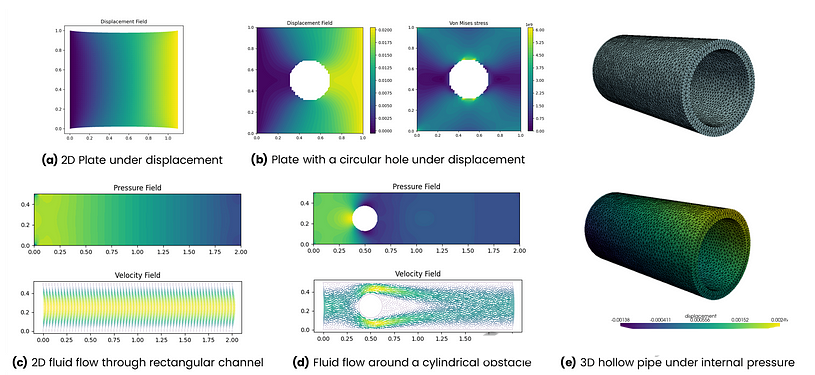
以下是我为上述五个示例使用的提示。
a) 2D 平面在位移下
一块 1m x 1m 的弹性板,其杨氏模量为 1GPa,泊松比为 0.3。左边缘的位移为零,右边缘在 x 方向上的位移为 0.1m。使用 FENICS 求解位移,并将位移结果存储在 PNG 文件中。
b) 带有圆形孔的板在位移下
一个 2D 板占据了 1m x 1m 的区域。它由铜制成,中间有一个半径为 0.2m 的圆形孔。左边缘的位移为零,右边缘在 x 方向上的位移为 0.02m。上下边缘可以自由移动。请使用 FENICS 解决位移问题,绘制并将 von Misses 应力存储为 PNG 文件,并计算右边缘的总力。
c) 2D不可压缩流体在矩形通道中的流动
求解在一个长度为2m、高度为0.5m的矩形通道内的2D不可压缩流体流动。流体密度为1,粘度为0.001。在左侧入口处给定一个完全发展的抛物线速度分布,最大速度为0.3。使用FEniCS FE Python库求解2D压力和速度场。绘制压力场并将图像保存为PNG文件。
d) 通过带有圆形障碍物的矩形通道的二维流动
求解在一个长2m、高0.5m的矩形通道内,圆柱体上方的二维不可压流动。圆柱体位于(0.2m, 0.2m)处,直径为0.1m。流体密度为1,粘度为0.001。在左侧入口处规定一个完全发展的抛物线速度分布,最大速度为0.3。使用FEniCS FE Python库求解二维压力和速度场。绘制压力场并将图保存为PNG文件。
e) 3D 中空钢管在内部压力下
创建一个外径为 5 mm、壁厚为 0.5 mm 的 3D 钢管网格。首先绘制网格并与用户进行验证。使用 FEniCS FE python 库求解在 100 MPa 内部压力下钢管的位移。使用 Pyvista 绘制并显示 3D 位移。将图像保存为 PNG 文件。
请注意,这些并不是即时解决方案。有时,我与代理进行了多次反复交流,迭代直到我们得出正确的结果。例如,问题 (b) 涉及一个中心有圆孔的板。最初,几何图形缺少孔,但经过几次迭代后,我们纠正了这一点。同样,CFD 问题缺少圆形障碍物,我们通过调试解决了这个问题。3D 问题需要最多的迭代,包括关闭并重新打开应用程序以从头开始。我还调整了输入提示,以更好地指导模型开发过程。总体而言,我对结果感到非常满意。这只是 LLM 驱动的代理如何编写、调试和执行工程代码以进行建模和仿真任务的开始。
该开发是在 Linux 环境中完成的,使用 Windows 11 PC 上的 Windows 子系统 Linux (WSL) 和 Visual Studio Code,配置为 Intel i9 第 13 代处理器、64 GB RAM 和 24 GB Nvidia RTX 4090。我尚未在本地 Windows 环境中进行测试,但欢迎您进行测试。有关安装 WSL 和设置 Python 和 Conda 环境的指南,请参阅这篇文章 (here)。
这是源代码库的 链接。
如果您看到这里,请为这篇文章鼓掌。敬请关注更多见解和改进。现在,让我们开始学习如何使用和修改代码。
安装指南
该实现的核心在于使 AI 代理能够利用开源 Python 库和工具。为了解决 FEA 或 CFD 问题,我们需要工具来编写几何图形,使用数值算法求解,并可视化结果。像 gmsh 这样的库是一个具有内置前处理和后处理功能的三维有限元网格生成器,用于创建几何图形或网格。FEniCS 是一个开源计算平台,用于求解偏微分方程 (PDE),用于制定和运行数值仿真。对于可视化,使用 matplotlib 处理 2D 几何图形,使用 pyvista 处理 3D 几何图形。其他所需的库列在我 GitHub 存储库中的 requirements.txt 文件中。
在创建应用时,我将安装限制为 AutoGen 和 Chainlit。通常,代理可以根据您要求它们解决的问题自动安装所有其他必要的库。然而,这通常会消耗额外的令牌和 API 调用,有时效率不高。因此,我预先安装了这些库,因为我知道它们会被需要。
请记住,您需要一个来自 ChatGPT 的 GPT-4o API 密钥。如果您的硬件允许,您可以尝试使用像 Llama3:405B 这样的离线强大模型。较小的模型尚不支持。
安装和启动应用程序的终端命令
从 conda-forge 渠道安装 FEniCS 也会安装一个兼容的 Python 版本,因此我们不需要指定它。
# Create conda environment and install FEniCS FEA package
conda create -n fea_agents -c conda-forge fenics mshr

# Activate environment
conda activate fea_agents

# Clone github repo
git clone https://github.com/karthik-codex/autogen_FEA.git

# select current directory
cd autogen_FEA

# Install other python packages (AutoGen, Chainlit, matplotlib, numpy, etc..)
pip install -r requirements.txt

# Export OpenAI API key
export API_KEY=<your_key_xxxxxx>

# Run chainlit app on default port - http://localhost//8000
chainlit run appUI.py
您将在我的 GitHub 存储库中找到以下文件。
./requirements.txt— 包含上述所有软件包的列表./chainlit_agents.py— 包含类定义,包括 AutoGen 的助手和用户代理。这允许跟踪多个代理并在 UI 中显示它们的消息。(感谢 Chainlit 团队构建的 模板)。./appUI.py—包含设置代理、跟踪和处理消息以及在 Chainlit UI 中显示它们的主要异步函数。
主要 Python 应用程序结构
导入库
您会注意到从 chainlit_agents 导入了两个类。这些用于 AutoGen 代理的包装类使 Chainlit 能够跟踪它们的对话,以适当的格式显示文本和代码,并处理终止或其他用户输入。您可以在 这里 阅读更多信息。
import os
import autogen
import chainlit as cl
from chainlit_agents import ChainlitUserProxyAgent, ChainlitAssistantAgent
加载 LLM 配置
将您的 API 密钥导出到您的操作系统环境中,或直接将其作为字符串变量粘贴到代码中。
api_key = os.getenv('API_KEY')

config_list_openai = [
    {"model": "gpt-4o", "api_key": api_key}
]

llm_config = {
    "seed": 565,  # change the seed for different trials
    "temperature": 0,
    "config_list": config_list_openai,
    "timeout": 60000,
}
为代理创建系统消息。
我们设计具有特定角色的代理:管理员(admin)、规划者、科学家、工程师、执行者、评论者和群聊管理者,并将它们组织成一个研究小组,以实现自主、互动和动态的群聊。每个代理的角色通过代理剖面进行定义,使用初始提示来影响LLMs在聊天过程中的行为。
- 管理员分配任务并在请求时提供见解。
- 规划者制定逐步计划,并为其他代理建议具体的子任务。
- 科学家使用有限元法(FEM)制定力学问题。
- 工程师编写并调试实现代码。
- 执行者运行脚本,访问仿真环境并共享结果。
- 评论者对过程和代理的表现进行评估。
- 群聊管理者通过选择发言者、收集输入和广播消息来协调对话。
以下是每个代理的系统提示。
USER_PROXY_MESSAGE = '''A human admin. Interact with the planner to discuss the plan.
Plan execution needs to be approved by this admin.'''

ENGINEER_MESSAGE = '''Engineer. You follow an approved plan. You write Python/shell code to solve tasks.
Wrap the code in a code block that specifies the script type. The user can't modify your code.
So do not suggest incomplete code which requires others to modify. Don't use a code block if it's
not intended to be executed by the executor. Don't include multiple code blocks in one response.
Do not ask others to copy and paste the result. Check the execution result returned by the executor.
If the result indicates there is an error, fix the error and output the code again.
Suggest the full code instead of partial code or code changes. If the error can't be fixed or if
the task is not solved even after the code is executed successfully, analyze the problem,
revisit your assumption, collect additional info you need, and think of a different approach to try.
In the code you write, always add a part to report the solution on the boundaries and store it in a separate file for the Scientist to check.'''

PLANNER_MESSAGE = """Planner. Suggest a plan. Revise the plan based on feedback from admin and critic, until admin approval.
The plan may involve an engineer who can write code and a scientist who doesn't write code.
Explain the plan first. Ask the Executor to install any Python libraries or modules as needed without human input.
Be clear which step is performed by an engineer, and which step is performed by a scientist."""

SCIENTIST_MESSAGE = """Scientist. You follow an approved plan. You can formulate the mechanics problem with
clear boundary conditions and constitutive law of materials. You don't write code. You explicitly check the
boundary results from the Engineer to see whether it agrees with the input boundary conditionand geometry.
When you execute the code, always save a copy for review."""

EXECUTOR_MESSAGE = """Executor. Save and execute the code written by the engineer and report and save the result.
Use both shell and python language interpreter."""

CRITIC_MESSAGE = """ Critic. Double check plan, claims, code from other agents, results on the boundary conditions, and provide feedback.
Check whether the plan includes adding verifiable info such as source URL."""

## Chainlit UI 的启动功能

当用户打开聊天应用程序时,我们创建代理并打印欢迎消息。执行器运行脚本,访问模拟环境并共享结果。因此,我们启用代码执行配置,并将 docker 设置为 False,以仅使用本地操作系统环境进行代码执行。

```python
@cl.on_chat_start
async def on_chat_start():
  try:
    print("Set agents.")
    user_proxy  = ChainlitUserProxyAgent("Admin", system_message=USER_PROXY_MESSAGE, code_execution_config=False)
    engineer    = ChainlitAssistantAgent("Engineer", llm_config=llm_config, system_message=ENGINEER_MESSAGE)
    scientist   = ChainlitAssistantAgent("Scientist", llm_config=llm_config, system_message=SCIENTIST_MESSAGE)
    planner     = ChainlitAssistantAgent("Planner",llm_config=llm_config, system_message=PLANNER_MESSAGE)
    critic      = ChainlitAssistantAgent("Critic", llm_config=llm_config, system_message=CRITIC_MESSAGE)
    executor    = ChainlitAssistantAgent("Executor", system_message=EXECUTOR_MESSAGE, human_input_mode="NEVER",
                                    code_execution_config={"last_n_messages": 3, "work_dir": "FEA_results","use_docker": False})

    cl.user_session.set("user_proxy", user_proxy)
    cl.user_session.set("engineer", engineer)
    cl.user_session.set("scientist", scientist)
    cl.user_session.set("planner", planner)
    cl.user_session.set("critic", critic)
    cl.user_session.set("executor", executor)

    msg = cl.Message(content=f"""Hello! What simulation task would you like to get done today?
                     """,
                     author="User_Proxy")
    await msg.send()

  except Exception as e:
    print("Error: ", e)
    pass
对话功能
为了测试这个多代理组自主解决工程问题的能力,我们只使用管理员代理(用户代理)来分配任务。虽然在各个阶段收集人类输入是可能的,但我们在小组聊天期间跳过人类输入。您可以增加变量 MAX_ITER 来根据您尝试解决的问题的复杂性增加代理之间的对话。
@cl.on_message
async def run_conversation(message: cl.Message):
    MAX_ITER = 50
    CONTEXT = message.content
    user_proxy  = cl.user_session.get("user_proxy")
    planner     = cl.user_session.get("planner")
    engineer    = cl.user_session.get("engineer")
    critic      = cl.user_session.get("critic")
    executor    = cl.user_session.get("executor")
    scientist   = cl.user_session.get("scientist")
    groupchat   = autogen.GroupChat(agents=[user_proxy, planner, engineer, scientist, executor, critic],
                                    messages=[], max_round=MAX_ITER)
    manager     = autogen.GroupChatManager(groupchat=groupchat, llm_config=llm_config)

    print("Running conversation")
    await cl.make_async(user_proxy.initiate_chat)( manager, message=CONTEXT, )
这就是主要代码的结尾。
我的最终想法
这个多智能体 LLM 框架展示了通过利用 ChatGPT 的广泛知识和开源工具,超越仅依赖人类的范式来解决工程问题的潜力。该方法的准确性和效率依赖于 LLM 对固体力学、流体动力学、多物理理论、材料科学和编码的深刻理解。一个经过专业化、微调的 LLM,如果在大量相关科学文献和编码数据集上进行训练,可能会产生更准确的结果。使模型能够编写和执行复杂的工程代码和算法是至关重要的。
可以创建额外的智能体来处理特定的子任务,以增强这种方法。例如,一个智能体可以生成初始几何形状或 CAD 文件,另一个可以进行网格划分,第三个可以编写数值算法。这种劳动分工减少了错误,最小化了解决问题所需的迭代和群聊对话。
此外,这些自主智能体可以使用 API 与商业工程软件进行交互,如 SOLIDWORKS、ANSYS、Abaqus 和 LS-DYNA。训练 LLM 编写这些 API 的脚本将促进顺畅的交互。这种方法自动化了工程设计和分析问题的解决,为工程研究和创新中的人机协作铺平了道路。
如何学习大模型
现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。
作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。
下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线
很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

二、AI大模型视频教程

三、AI大模型各大学习书籍

四、AI大模型各大场景实战案例

五、结束语
学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。
再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。
因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。
 202


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


