LoRA、完全微调到底有何不同?MIT 21页论文讲明白了

MIT深度学习实战路径:从课程作业到工业级AI工程能力 深度学习不仅是模型架构与训练流程,更是一套融合理论推导、底层源码理解、硬件协同优化与生产环境约束的系统性工程能力。其核心原理在于通过严格的工程实现反向锚定理论边界,例如用自定义门控单元重写强制深挖RNN梯度流,或借FlashAttention-2的block-level kernel重构理解数值稳定性与内存带宽的本质权衡。这种能力带来显著技术价值:提升模型压缩精度、加速大模型推理、支撑分布式训练落地。典型应用场景包括法律文书摘要优化、车载立体视觉深度估计、LLM服务API部署等。本文聚焦MIT公开课程体系中 阅读详情

本文旨在了解两种微调大型语言模型方法之间的差异:完全微调和低秩自适应 (LoRA)。这两种方法都用于将预训练模型适应特定的下游任务,但它们却有所不同。

微调(Fine-tuning)是将经过预训练的大语言模型应用于下游任务的关键范例。最近,低秩自适应 (LoRA) 等方法已被证明可以在各种任务上达到完全微调模型的性能,同时可训练参数的数量却大大减少。

这就提出一个问题,即它们学到的解决方案真的等效吗?

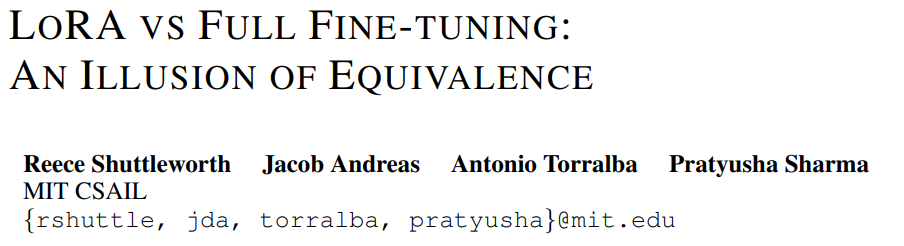
带着这一疑问,来自 MIT 的研究者在论文《 LORA VS FULL FINE-TUNING: AN ILLUSION OF EQUIVALENCE 》中进行了深入探讨。
img

论文地址:
https://arxiv.org/pdf/2410.21228v1

作者通过分析预训练模型权重矩阵的光谱特性来研究不同的微调方法如何改变模型。

研究发现,完全微调与 LoRA 产生的权重矩阵奇异值分解结构有显著不同,并且经过微调后的模型在面对超出适应任务分布的测试时也显示出不同的泛化行为。

特别是,LoRA 训练的权重矩阵中出现了称为「侵入维度(intruder dimensions)」的新的高秩奇异向量,而在完全微调中则不会出现这种情况。

这些结果表明,即使在微调分布上表现相同,但使用 LoRA 和完全微调更新的模型访问参数空间的不同部分。

作者通过研究 LoRA 微调模型中出现侵入维度的原因、它们为什么不受欢迎,以及如何最小化这些效果来展开研究。

最后,作者给出了以下几点观察:

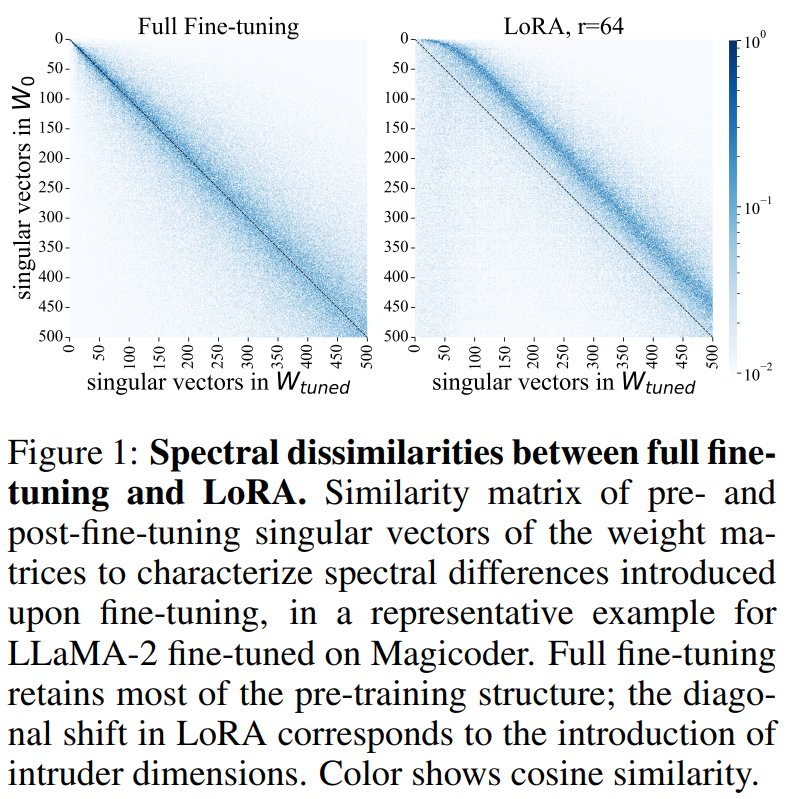
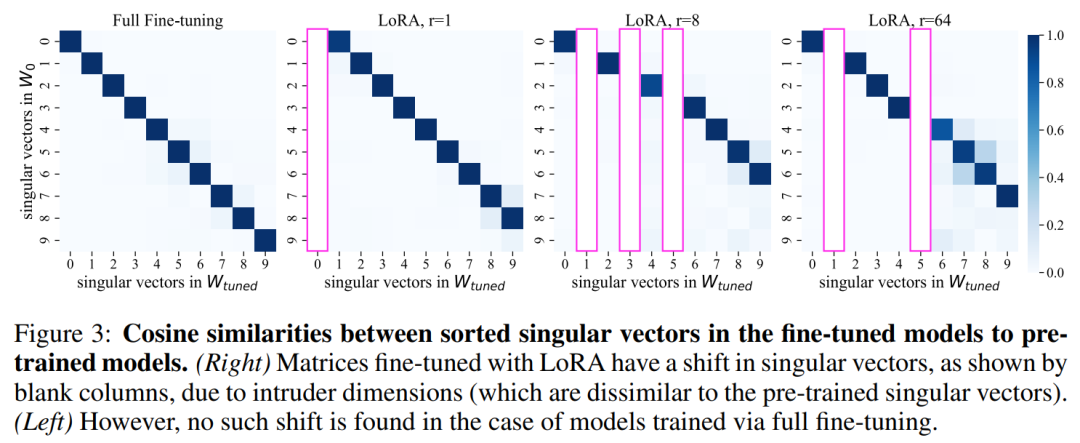
首先,LoRA 和完全微调在结构上产生不同的参数更新,这种差异由侵入维度的存在产生的。这些侵入维度是奇异向量,具有较大的奇异值,并且与预训练权重矩阵中的奇异向量近似正交。相比之下,完全微调模型在光谱上与预训练模型保持相似,不包含侵入维度。

其次, 从行为上看,与完全微调相比,具有侵入维度的 LoRA 微调模型会忘记更多的预训练分布,并且表现出较差的稳健连续学习能力:具有侵入维度的 LoRA 微调模型在适应任务分布之外不如完全微调模型,尽管分布准确度相当。

最后, 即使在目标任务上低秩 LoRA 表现良好,但更高秩的参数化可能仍然是可取的。低秩 LoRA(r ≤ 8)适合下游任务分布,完全微调和高秩 LoRA(r = 64)让模型泛化能力更强、自适应能力更加鲁棒。然而,为了利用更高的秩,LoRA 更新模型必须是秩稳定的。

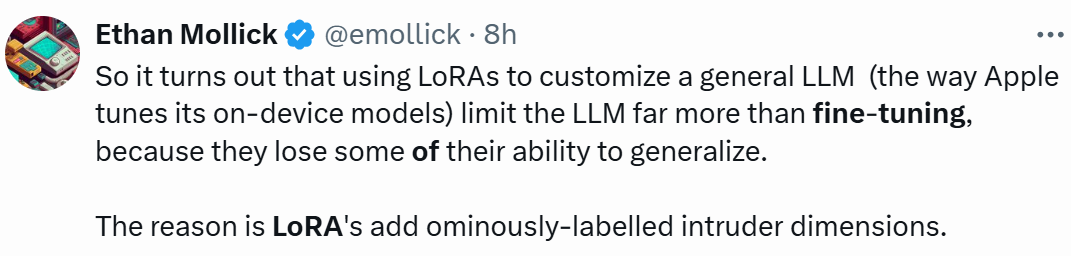
沃顿商学院副教授 Ethan Mollick 对此评论道:事实证明,使用 LoRA 定制通用 LLM(Apple 调优其设备内置模型的方式),对 LLM 的限制远大于微调,因为它们失去了一些泛化能力。原因是 LoRA 增加了不祥的侵入维度。
img

LORA 和完全微调模型的差异

本文采用神经网络参数的奇异值分解 SVD 来理解微调对预训练权值的变化。

特别是,本文测量了用 LoRA 微调过的权重矩阵中的奇异向量或完全微调过的权重矩阵中奇异向量映射到预训练权重中的奇异向量的程度,使用它们的余弦相似性。这些关系如图 1 和图 3 所示,颜色表示预训练和微调奇异向量之间的余弦相似度。
img

img

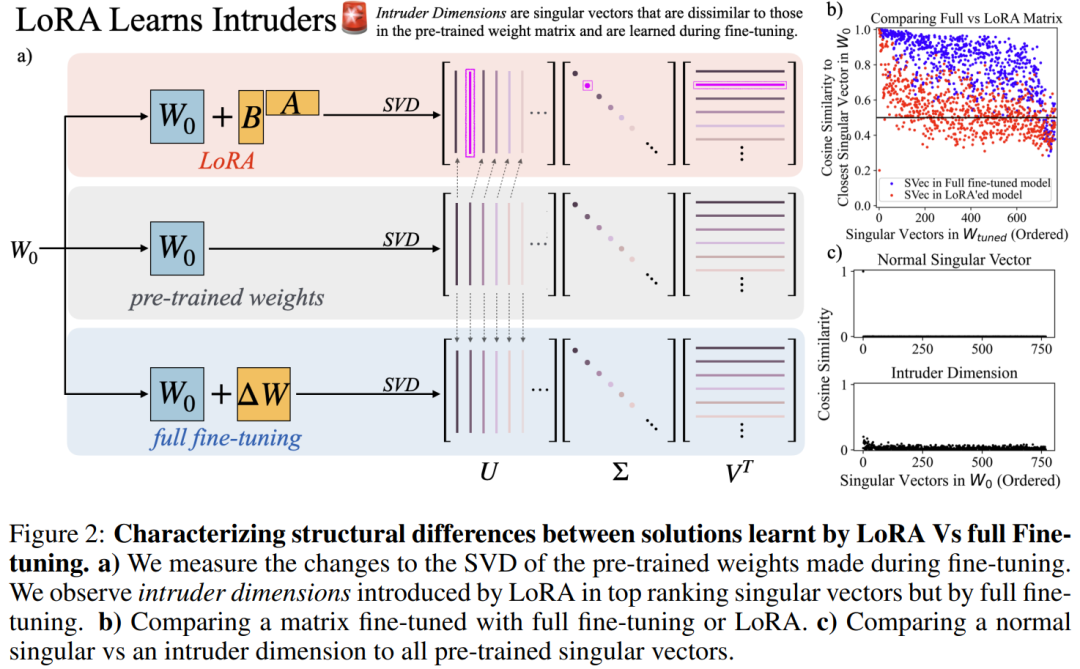
图 2 (b) 中观察到,LoRA 和完全微调的奇异向量与预训练奇异向量的相似度非常不同:与完全微调相比,使用 LoRA 微调的模型的奇异向量与预训练奇异向量的平均余弦相似度似乎要低得多。
img

图 2 (b) 中左下角有一个唯一的红点,作者将这些新维度命名为侵入维度,其正式定义如下:

img

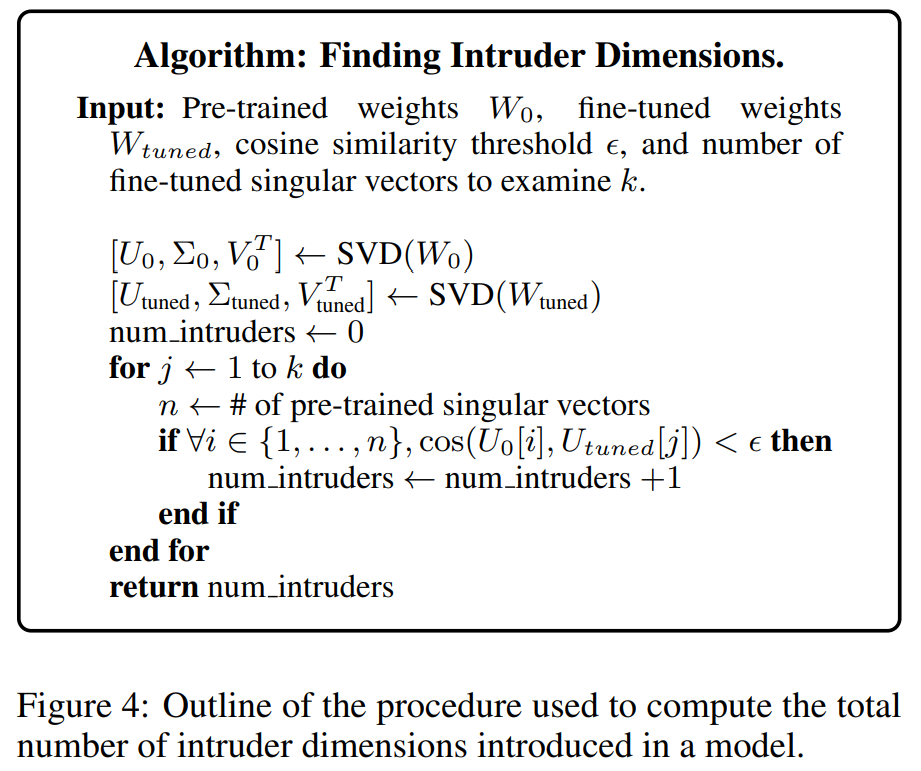
LoRA 微调模型包含高秩侵入维度,而完全微调的模型则不包含。为了量化特定权重矩阵的侵入维度集的大小,作者使用图 4 所示的算法。
img

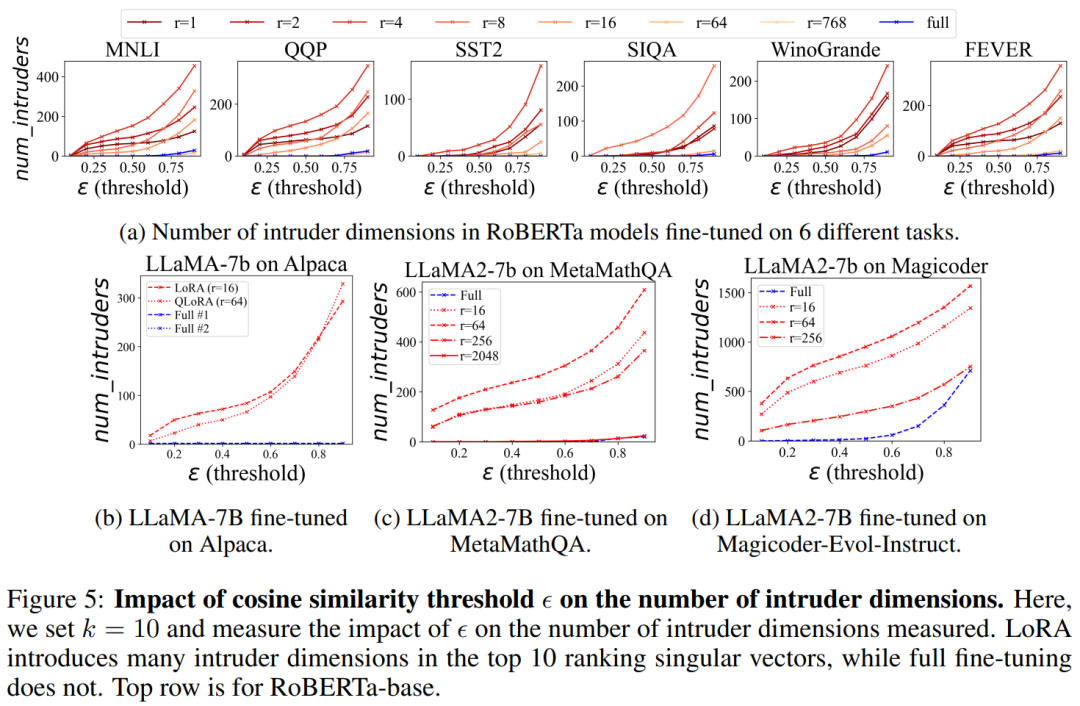
即使在 LoRA 微调模型学习效果不如完全微调的任务中,侵入维度也存在。

观察图 5b、5c 和 5d,我们可以清楚地看到,即使 LoRA 的 r=256,高秩奇异向量集中仍出现侵入维度。重要的是,当 r=2048 时没有侵入维度,而是展示了与完全微调非常相似的曲线。这支持了早先的发现:随着秩增加超过一个阈值,侵入维度会消失,LoRA 开始趋向于与完全微调相似。
img

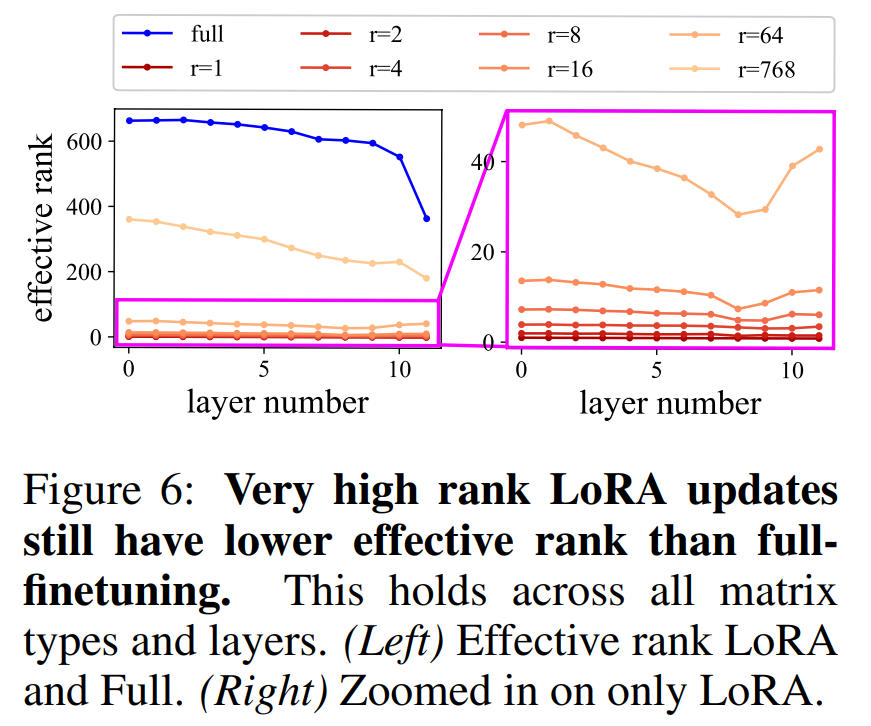
即使使用满秩矩阵执行 LoRA,完全微调更新也比 LoRA 更新具有更高的有效秩。如图 6 所示,可以观察到完全微调解决方案的有效秩明显高于通过 LoRA 学习到的解决方案的有效秩,即使 LoRA 具有更高的秩。
img

LORA 和完全微调之间的行为差异

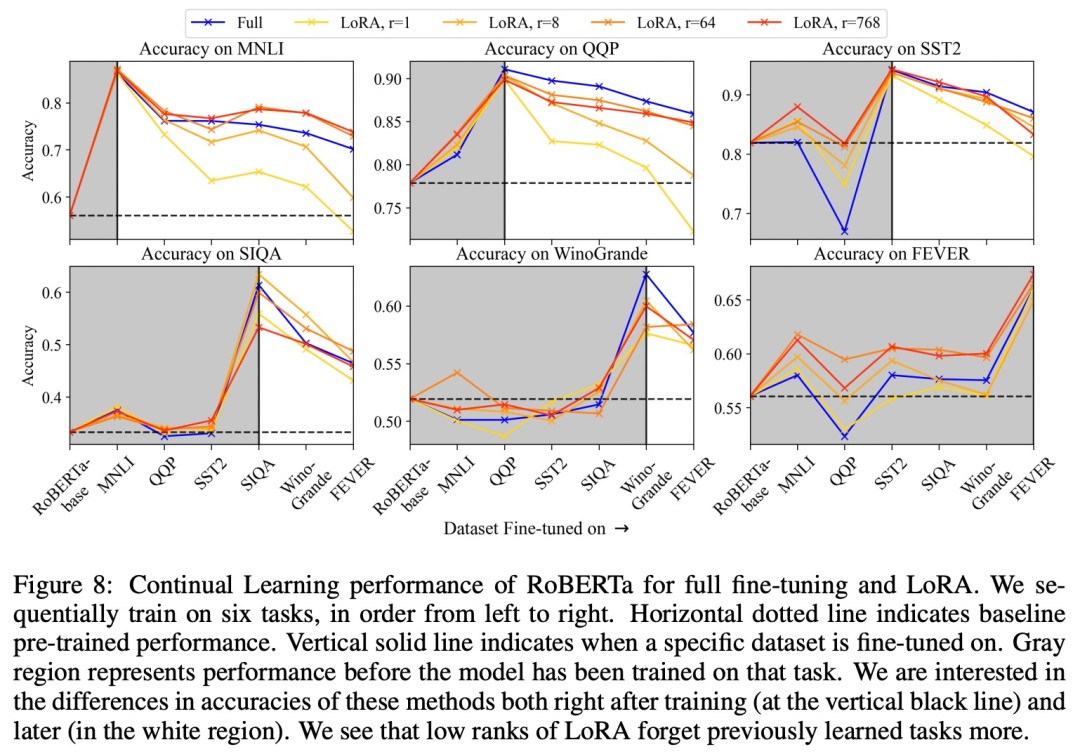
在较低秩,LoRA 在持续学习过程中的适应能力较差,会忘记更多之前的任务。该研究在多个任务上按顺序训练 RoBERTa,并测量学习新任务时性能的变化程度。

该研究使用与之前相同的训练方案、数据集,但在持续学习环境中使用以下数据集(按顺序)进行微调:MNLI、QQP、SST-2、SIQA、Winogrande、FEVER。在序列中某个数据集上进行训练后,将 LoRA 权重合并到模型中,并在下一个任务训练之前重新初始化,以便不受之前任务的影响。

在对特定任务进行训练后,该研究对所有任务进行测试,对于每个任务,在测试测试集之前分别重新训练分类头。这能够检查模型在这些任务上表现如何,而无需实际更改模型本身。

结果如图 8 所示。虽然 LoRA 最初与完全微调的性能相当,但较小的 LoRA 秩在持续学习过程中始终表现出更大的性能下降。特别是,对于前三个训练数据集,当 r = 1 时 LoRA 的性能下降到预训练基线以下。随着 LoRA 秩的提高,我们可以看到这种遗忘行为减少,并且更接近于完全微调,甚至在完成持续学习后在 MNLI 上的遗忘也更少。

整体情况是微妙的:虽然在某些情况下,LoRA 似乎忘记得较少,但对于某些任务(以及某些秩)事实上,LoRA 可能会忘记更多。
img

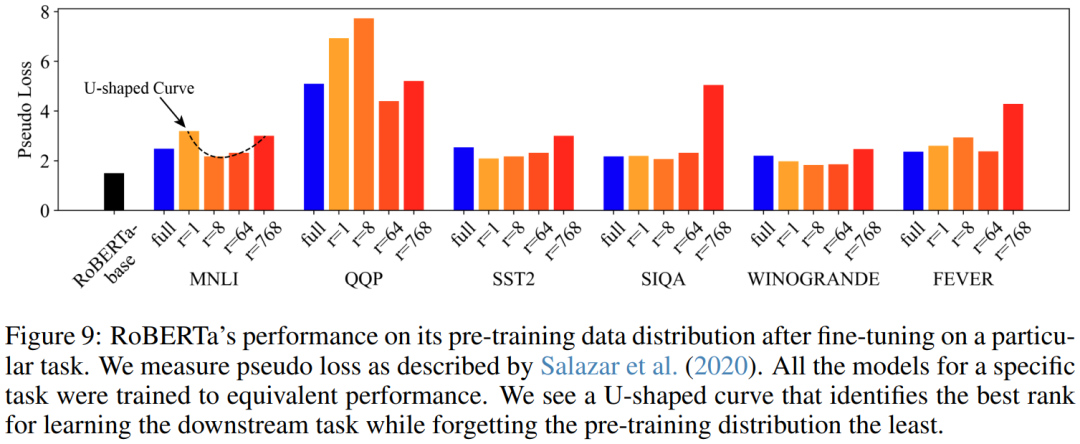
对于微调到等效测试精度的 LoRA 模型,可以看到一条 U 形曲线,该曲线标识了适合下游任务的最佳等级,同时最小程度的忘记了预训练分布。

图 9 报告了测量的伪损失分数。可以看到完全微调和 r = 768 时的 LoRA 之间呈现 U 形趋势。

相对于完全微调,低秩(r = 1)和高秩(r = 768)都会导致预训练分布的遗忘更大,而对于 r = 64,遗忘较少。也就是说:当 r = 1 时,使用 LoRA 微调的模型受到侵入维度的影响,并且似乎比没有侵入维度的 r = 64 有更多的遗忘。然而,当 r = 768 时,使用 LoRA 微调的模型也表现出更糟糕的遗忘,这表明由于过度参数化,它们对适应任务过度拟合。当 r = 8 和 r = 64 时,遗忘量少于完全微调。
img

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

一、AGI大模型系统学习路线

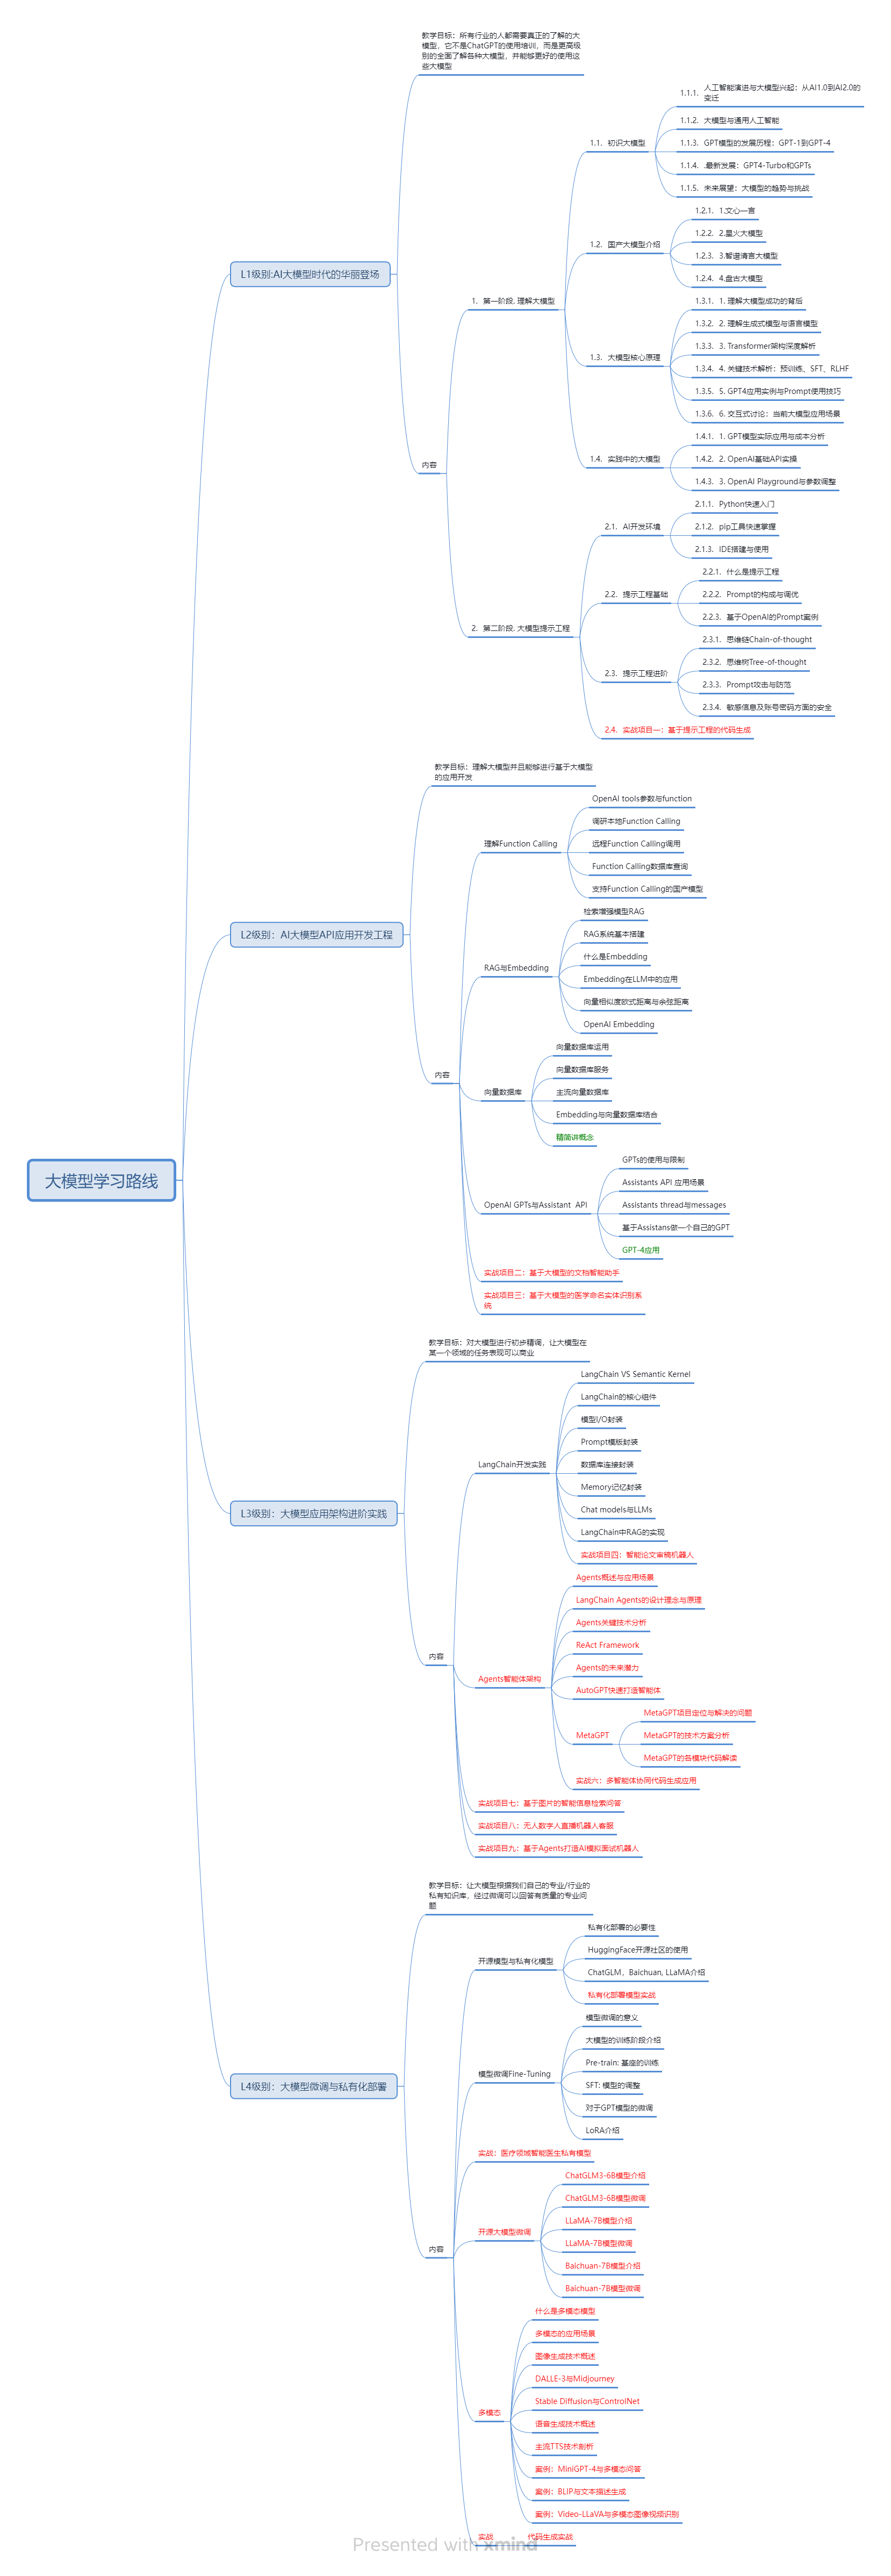
很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。
在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

从无序到结构化:HAC框架如何用哈希网格重构3D高斯压缩范式 | ECCV2024技术解读 本文深入解读了ECCV 2024提出的HAC框架,它通过引入二值哈希网格为无序的3D高斯锚点建立空间结构,并利用上下文模型进行自适应量化,从而实现了对3D Gaussian Splatting模型的高效压缩。该方法将压缩范式从单纯削减数据转向智能理解数据关系,在保持高质量渲染的同时,显著提升了压缩率,为移动端部署和实时应用提供了新方案。 阅读详情

相关推荐

开放平台 - 互动玩法演进之路

随着直播业务和用户规模日益壮大,如何丰富直播间内容、增强直播间内用户互动效果,提升营收数据变得更加关键。

bilibili_TC的博客 1746

MIT深度学习实战路径:从作业驱动到工业级落地

深度学习作为人工智能的核心技术,其学习路径正从理论推导转向工程实践与前沿复现。理解神经网络底层机制(如门控结构、注意力掩码、KV缓存)是掌握Transformer、LLM推理优化等state-of-the-art方法的前提;而MIT公开课程的价值,正在于以作业为锚点,将模型压缩、分布式训练、CUDA加速等硬核能力嵌入可验证的代码闭环中。这种‘理论→实现→调试→优化’的递进范式,天然适配工业界对可迁移建模思维和真实项目背书的需求——无论是复现FlashAttention内核,还是用LoRA微调Qwen-1.5

alexhill2009的博客 465

【k8s面试】超详细kubernetes面试题总结,面试必问!(附200道K8s Docker面试真题+答案详解

最近很多小伙伴找我要Linux学习资料,于是我翻箱倒柜,整理了一些优质资源,涵盖视频、电子书、PPT等共享给大家!

2401_83620959的博客 1466

lora-scripts许可证说明:MIT协议下的自由使用与分发

lora-scripts是一套基于MIT许可证的LoRA自动化训练工具,支持图像与文本生成模型的轻量化微调。通过配置驱动和模块化设计,用户可快速完成数据处理、训练到部署的全流程,且可自由用于商业与二次开发,极大降低了AI模型定制门槛。

weixin_36123300的博客 651

MSTAR数据集下载地址及处理方法

首先感谢博主冯子材提供下载的百度网盘地址。 在这里为了防止侵权,特此鸣谢,并给出其博客地址。 地址中有MSTAR百度网盘下载地址和需要使用的数据介绍,其中百度网盘中有数据转换工具 https://blog.youkuaiyun.com/taifengzikai/article/details/80600355 工具使用 因为下载得到的数据是二进制文件,需要使用官方提供的工具进行转换,可将其转换为jpeg。 有...

KamenRider 1万+

深入解析FOC电流环PI参数整定:从理论到实践

本文深入解析了FOC(磁场定向控制)中电流环PI参数整定的核心原理与实践方法。文章从永磁同步电机模型出发,详细阐述了基于带宽与零极点对消的工程法及考虑逆变器延迟的二阶系统整定法两种经典策略,并提供了从理论计算到安全上电调试的完整步骤与常见问题解决方案,帮助工程师精准调校电机控制性能。

weixin_29164497的博客 453

LoRA训练助手开源可部署:MIT协议镜像,支持私有化部署与二次开发

本文介绍了如何在星图GPU平台上一键自动化部署LoRA训练助手镜像,该工具能基于图片内容自动生成规范的英文训练标签。用户只需提供中文描述,即可快速获得适用于Stable Diffusion等模型的标签集,极大简化了AI绘画模型训练前的数据标注流程,提升效率。

weixin_28787801的博客 518

XDS110 USB Debug Probe连接错误-260:CCS Theia环境下的诊断与修复指南

本文详细解析了CCS Theia环境下XDS110 USB Debug Probe连接错误-260的诊断与修复方法。从硬件连接到驱动状态、固件更新到软件配置,提供了全面的排查指南,帮助开发者快速解决这一常见的调试器通信障碍问题,确保嵌入式开发工作流畅进行。

hope8的博客 287

Nano-Banana开源AI教程:MIT协议下二次开发Nano-Banana权重的路径

本文介绍了如何在星图GPU平台上自动化部署🖥️Nano-Banana: 结构拆解实验室镜像,快速构建AI驱动的工业与产品结构可视化环境。用户输入自然语言描述(如‘拆解运动鞋’),即可秒级生成带编号指示线和纯白背景的平铺图或爆炸图,广泛应用于服装设计、电子装配分析及工业教学等场景。

weixin_35916518的博客 302

对Palantir的本体论的理解

本体论Ontology是Palantir的整个技术架构的核心与基石,它远不止是一个数据模型,而是一个旨在对企业决策本身进行建模的“数字世界的操作系统”。

liuyukuan的专栏 1158

华为OD机试新系统真题【迷宫相遇】

华为OD机试 新系统真题【迷宫相遇】,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。华为OD机试真题【迷宫相遇】多语言题解。

qq_45776114的博客 775

Gemma 2工具链深度升级:FlashAttention-3、Q5_K_S量化与LoRA微调实战

大语言模型开源落地正从‘能跑’迈向‘稳跑、快改、省电’的新阶段。理解FlashAttention原理可优化显存占用与推理延迟,掌握GGUF量化规范(如Q5_K_S)能在精度与速度间取得关键平衡,而轻量级LoRA微调技术则大幅降低垂直领域适配门槛。这些工程化能力共同构成当前中小团队、教育场景及边缘设备部署的核心技术基础。本文聚焦Gemma 2系列最新工具链升级,详解其在PyTorch 2.4适配、Llama.cpp生态兼容及本地微调模板中的实践路径,覆盖Mac M2、Jetson Orin、树莓派5等典型硬件

diegouyi3472的博客 418

基于matlab实现的水果识别系统设计

本项目针对多种常见水果混合的图像,利用 Matlab 软件,对水果的识别进行研究。根据水果和背景的差别选取阈值,对去噪增强对比度后的图像进行二值化处理。再对图像进行边缘检测,选定连通区域,标记后再对不同种水果的颜色,形状,大小等特征进行快速识别水果,从而实现对水果的正确分拣。:水果识别、MATLAB、数字图像处理。

热情、奔放、快乐编程! 4863

Nano-Banana开源模型优势:无订阅费、无API调用限制、数据完全本地化

本文介绍了如何在星图GPU平台上自动化部署🖥️Nano-Banana: 结构拆解实验室镜像,实现本地化、离线式产品结构可视化。无需联网或API调用,用户可基于文字提示一键生成高精度Knolling平铺图与工程级爆炸视图,广泛应用于服装设计、消费电子包装及工业提案等场景。

weixin_29935511的博客 164

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

Wan2.2-T2V-5B模型许可证类型说明(MIT开源协议)

Wan2.2-T2V-5B是一款基于MIT协议开源的轻量级文本到视频生成模型,仅50亿参数即可实现秒级出片,支持本地部署、商业使用与定制化微调。其在消费级GPU上高效运行,适用于社交媒体运营、产品原型验证和品牌内容批量生产等场景,推动AI视频技术平民化落地。

weixin_42433737的博客 653

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

Jimeng AI Studio开源大模型实战:MIT许可下可商用的轻量影像生成终端

本文介绍了如何在星图GPU平台上自动化部署✨ Jimeng AI Studio (Z-Image Edition)镜像,快速构建轻量级影像生成终端。该镜像基于MIT许可,支持本地化高清图片生成,典型应用于电商主图制作、设计师概念草图输出及新媒体配图等商用场景,3秒内稳定产出1024×1024细节清晰图像。

weixin_36277197的博客 235

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

开源AI工具链实战:本地化部署与高效微调指南

大模型技术正从云端API走向本地化部署与自主可控的工程实践。理解模型量化、LoRA微调、RAG编排等核心原理,是实现低成本、低延迟、高合规AI应用的关键。开源工具链如llama.cpp、Ollama、Unsloth和LlamaIndex,通过标准化接口与模块化设计,显著降低了大模型在边缘设备、中小企业及垂直场景中的落地门槛。本文聚焦真实项目中的性能调优、许可证合规、显存管理与方言适配等硬核细节,为开发者提供可复现、可审计、可交付的开源AI工程路径。

weixin_30861459的博客 492

MIT新作,单次梯度+100样本实现LLM高效适配,无需训练提升24.6%准确率!

本文提出Compress to Impress方法,通过计算小样本梯度定位干扰知识,结合多子空间压缩技术,实现LLM高效适配新任务。仅需100个样本和单次梯度计算,在单GPU上几分钟内完成,比传统方法快52倍,准确率最高提升24.6%,为资源受限环境提供低成本LLM定制方案。

weixin_55154866的博客 963

GLM5全栈LoRA支持:DSA/MLA/MTP三大架构的工程对齐实践

大语言模型微调中的LoRA技术,本质是低秩适配器在参数空间的精准注入,其核心挑战在于训练、推理与权重存储三端的数值一致性与模块语义对齐。当模型引入稀疏注意力(DSA)、隐式多头注意力(MLA)和多token预测(MTP)等前沿结构时,传统LoRA框架面临indexer数值抖动、latent维度映射断裂、loss形状错配等系统性风险。本文聚焦国产大模型GLM5系列的全栈LoRA落地,深入解析DSA的确定性top-k控制、MLA与DSA的联合物化内核、MTP的版本感知损失对齐等关键技术路径,揭示如何通过协议级统

weixin_29775479的博客 264

莎士比亚英语风格迁移:全参数微调实战指南

早期现代英语(EME)是一种具有严格语法变位、代词格系统、韵律结构和历时语义特征的古典语言形式,其风格生成远超提示词工程能力边界。理解EME需把握动词屈折(如doth/hath)、人称代词格(thou/thee/thy)与抑扬格五音步的协同约束,技术价值在于实现低幻觉、高可解释的领域风格建模。该方法已成功迁移到中古英语、维多利亚书信及文言对话生成等任务,适用于NLP工程师构建专业级风格可控生成系统,也支撑语言学实证研究与戏剧教育数字化实践。

weixin_30924239的博客 458
上一篇: 从销售到 AI 算法工程师 | 转行人工智能大模型(含面经&裁员幸存指南)
下一篇: 全参微调与LoRA的区别,及7种LoRA变种方法解析
少喝冰美式
博客等级 码龄3年 6856粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值