


我叫王东,90后,和大家分享一下我的人工智能转型之路。
农学毕业,投身互联网做销售
机遇难求,养殖梦碎
我是土生土长的农村人,小时候经常和小鱼小虾打交道,上大学的时候就选择了农学专业,想着毕业之后回老家搞养殖种植。
大学期间,我看到了一些关于养殖龙虾、稻田套养的资料,就跟我父母商量,让他们承包一块稻田或者鱼塘,养殖龙虾。但当时我父母坚决不同意,就没有做成这个事情。
毕业之后,我想自己承包鱼塘搞养殖,但是没有资金,父母也不愿意支持我,所以最终还是没做成。
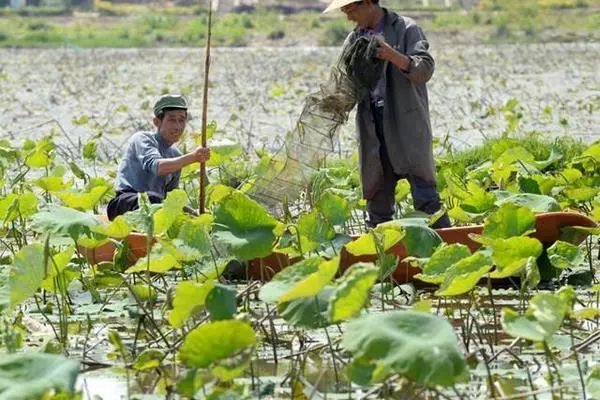
到了去年过年的时候,我们家那边很多人都已经开始在自己的稻田里面套养龙虾了。看到很多人做这个,我父母开始后悔为什么早没听我的。
可惜世上没有后悔药,总之我的农业梦想是暂时告一段落了。
果断决定,放弃读研
大学毕业之后,本来想直接工作,但是我的专业很少对口的岗位。大部分同专业同学都是去卖农药卖饲料之类的。
于是我选择了保送本专业读研。不过读了一年多一点,我就自己退学了。
在学校导师要求天天去实验室,但是去了实验室没有事情做。同学都是带着电脑去实验室,玩一天的手机电脑晚上回寝室。
我当时也不知道该学点什么,觉得这样读研很浪费时间,就退学了。
现在回头想想,当时对读研的事情认识得不太到位,不然的话现在的工资应该会高一点。
保险销售 & 银行客服
我研究生退学是在2016年的10月,出来之后先是在泰康人寿做了几个月的保险电话销售。
之所以选择一个和专业相差这么大的岗位,是因为我读过很多销售方面的书籍,也认识一些做销售的人,对销售工作很感兴趣,自己有心成为一个顶级的销售高手。
在泰康做了五个月,成绩不太理想。
之后又到银行当客服,具体工作是:信用卡的报账单到了,提醒客户还款日;客户欠款了,催他们还款;等等。
这两份工作都是在合肥的时候做的。
好友相邀,奔赴上海
我的一个大学同学在2016年8月去了上海,做人工智能、大数据的培训的招生顾问/课程顾问,其实就是销售。
他是学生物的,生物专业的本科毕业生也不太好找工作,所以他也转行了。
他在上海工作了一段时间之后,了解到我的工作状况不太好,就跟我说,可以考虑到上海这边做销售,比合肥容易赚钱一点。
在他的邀约下,我在2017年10月到了上海。
进阶互联网销售
到上海之后我做了两份销售的工作。
第一份工作是在宜信,通过电话方式推销贷款。这家公司办公区域二手烟很严重,而我对烟过敏,所以没做几个月就辞职了。
第二份工作是在一家教育机构做专升本的课程顾问。这份工作做得还可以,比我以往的销售业绩来好不少,每个月都能开很多单。
而以前在泰康人寿做电销,和在银行客服让客户办分期信用卡分期的时候,成交的单数都不多,工资也少得可怜。
这样,我在专升本课程顾问这个职位上工资还好,自我感觉有点满意。
转型之旅,向人工智能挺进
在2018年初的时候,我同学跟我说他想辞职了。因为他发现自己招进来的学员,零基础进来学大数据或者人工智能,培训完成后找工作,工资比他高了很多。他也想去做大数据技术岗位的工作。
2018年2月,我同学自己在他原本任销售的培训机构报名成了学员。到了2018年8月,他就找好了新工作,月薪16K!
我其实很喜欢做销售,梦想着有一天成为top sales,赚很多钱。但是,我也发现自己的销售工作做得并不好。
为此买了一些销售方面的书籍、课程学习,可是学完之后,并没有达到没有理想中的效果。应该是自己不适合做销售,于是,听到我同学的转行的事情后,我也决定转型了。
我听我同学说,人工智能(AI)还有大数据(Big Data)前景非常好,待遇也高,人才的需求量也大。
这时我就想,人生一定要善于抓住机会,看到可行机会一定要好好抓住,一旦错过就很难再挽回了。前些年,我错过了养龙虾的机会。不能再错过AI和Big Data的机会了!
于是,在接下来的时间里,我就一边上班做销售工作,一边自学相关课程。
整理基础,着手学习AI技能
制定学习计划
我问我同学:做人工智能,需要学什么课程?
他说:数据库要会一点;python也要会;数学基础要好;而且工作中多少会涉及到爬虫;还有就是数据分析、机器学习、深度学习都要会一些。
根据他的指导,我给自己制定了一个学习计划:
1. 数学基础:导数、微积分;简单的矩阵运算(比如说矩阵的转置,乘积等),矩阵的求导、矩阵转置的求导;概率统计知识,比如全概率,贝叶斯公式等。
2. Python编程:基础数据类型(字典、列表、集合之类);循环(while)、条件(if)结构;函数;os、datetime等常用模块;面向对象;会多线程、多进程能提高效率;会爬虫更好。
3. 数据分析:数据库;python做数据处理的pandas、numpy库;会matplotlib等绘图库更好。
4. 机器学习:线性回归、逻辑回归、KNN 、KMeans、决策树、GBDT、朴素贝叶斯,隐马尔可夫;以及深度学习。
原有基础
其实学任何知识,如果有一点相关的基础,学得就会较快一些。
我之前在大学学过C语言,虽然不太深入,但多少了解过。算是有编程基础。
而且,我的数学比较好的。大学数学我都没有听过课,然而高数、线性代数,还有概率论,考试都是在95分以上。数学基础自我感觉还可以。
我的英语也还可以。阅读英文资料都没有问题。
我相信拥有这些基础是可以应付人工智能学习的。
决定自学
我没有上辅导班,全部都是自学的。
为什么不报培训班呢?主要两个原因:
- 我没有那么多钱;
- 我听那个转行成功的同学讲了需要学习的内容,觉得自学可以搞定。
业余用功
因为白天还在上班做销售,所以学习都安排在晚上下班之后,和周六周日不加班的时候(一般周六要加班)。
第一步,我学了数据库。
总共花了两周的时间,只学了MySQL的增删改查和建表。因为听我同学说,数据库大都差不多的,先学个基础,工作中遇到不懂的再问、再搜索就可以了。
这些内容不太难,而且很多网上平台都有视频或者免费课,收费课程也很便宜。
第二步是Python编程。
也是在网上平台,找的课程。分为几个部分来学习:
最开始学基础的东西:数据类型,控制结构,函数,和面向对象等。
当时没有学太深入的东西,很多模块(比如OS模块),我学习的时候都不知道。那些模块是在工作之后,需要用时才学的。
之后,学了一点点爬虫。只看了爬虫中发送http请求的方法:get和post。
我自己在网上找到爬虫的样例代码,把它抄下来,自己做了一个非常非常小的爬虫,爬了一首歌。
那时候自我感觉还可以,居然把音乐给扒下来了(_)。但是进入公司之后才发现,当时掌握的实在是太浅太浅。
第三步是数据分析。
主要学了的numpy和pandas。这两个模块非常非常重要,特别是pandas,数据清洗、特征工程都要用得到。
学习它们。我花一个多月的时间。一边看视频课程,一边敲代码,完完全全的就是课上怎么说,我就怎么写。
pandas还有可视化相关的内容,不过我并没有学习这一块。
克服迷茫,硬啃机器学习
迷茫疲惫独自扛
在学习过程中,我感到挺累挺迷茫的。
转型的过程中会遇到很多问题,懒惰,每个人多少都会有一点。
独自摸索中,你不知道你选择的方向对不对;也不知道之前的工作要不要继续做下去,会不会取得很大的突破。这些都是未知的。
机器学习任务重
学习了Python和数据分析的基础之后,就开始机器学习的内容了。
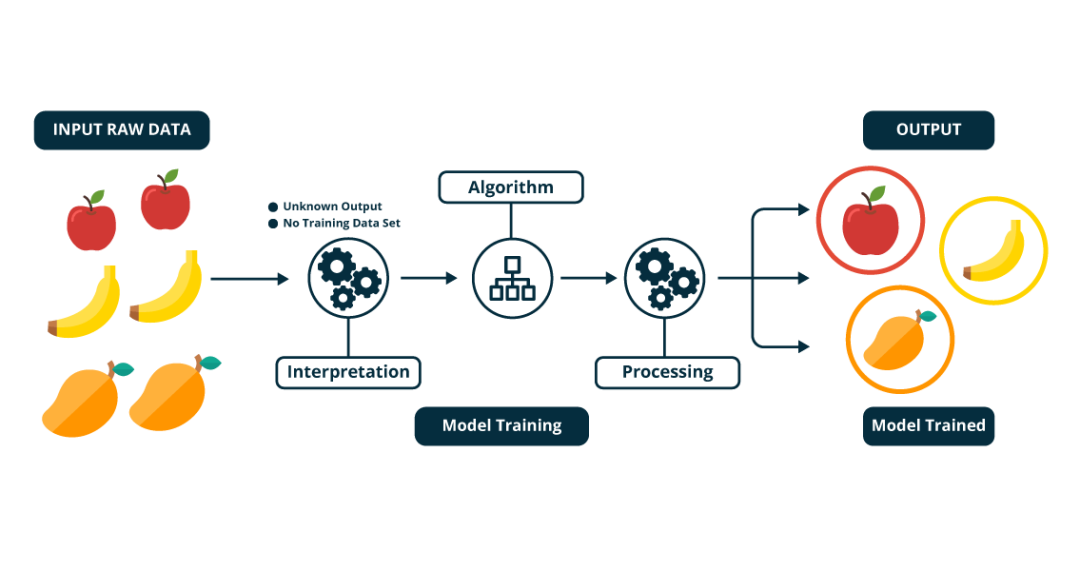
这一块儿我学得不太好,最初是从最普通的最简单的线性回归和逻辑回归开始的:
首先是线性回归:线性回归的核心是最小二乘法,原理和推导过程当中,会用到一些数学方面的知识,比如说微分、矩阵,和矩阵求导,并不是太复杂。
实际的应用中,我们只需要把数据简单处理一下(有时候甚至可以不处理),再调用别人写好的库,就能够得出结果。网上有案例,对照着来尝试几次的话,就能够掌握。
其次是逻辑回归:主要用的是sigmoid函数,还有概率方面的知识,也并不是太复杂。
接着是决策树:决策树又分为分类树和回归树,两者原理不一样。决策树我掌握得不够好。
之后学了KMeans和KNN,都比较简单,前者学得还不错。
然后是GBDT(梯度提升决策树),只是稍微学了一点。
至于朴素贝叶斯,隐马尔可夫等模型,最初并没有学。我感觉太复杂了,学不来。
在这个过程中,我发现,数学知识会用到,但用到的都比较简单,不是非得掌握到很深入的程度不可。
这样,我感觉自己可以去面试了。
建立自信,不为岗位描述所限
准备简历
我从网上下载了简历模板,还从我同学那边要了几个,参照之下自己写了份简历,在各大招聘网站上投了一下。总共大概投了五六份。
我当时没有考虑到的一点是面试时间,因为我是在12月投简历的。12月是招聘的淡季,很多企业已经不招人了,面试机会非常的少。
不过简历投出去之后,我还是获得了几个面试机会,下面慢慢讲。
不必拘泥于“岗位要求”
大家看到很多招聘AI技术职位的“岗位要求”都会写:要有本科以上的学历,金融、数学或者计算机方面的专业,还有些要2-5年不等的相关工作经验等……
虽然他们写的是这些,其实不满足要求的,也能够进去。
专业并不是很重要,经验也不是硬性规定。最关键的还是你会什么技能,有什么项目经验,能解决什么问题。
基本上只要在面试的时候,回答上来面试官的问题就可以了。别人邀请你去面试了,说明就有机会。
我本科是农学方面的大学,学校并不太好,安徽省内排名只能排在第五或者第六,不是985,也不是211。我也不是计算机、数学方面专业的。
我投了简历之后,在12月份招聘的淡季,还是有五家公司邀请我去面试。
这五家里,只有一家是我直接投的简历,有两家的HR直接联系我,还有两家是两个猎头联系我之后给安排的。
上阵临敌,多多面经分享给你
第一次面试
面试的第一家企业是在boss直聘上面投的简历,做垂直领域的电商平台。当时我是第一次过去面试,挺紧张的。
两个人一起面试我:一个是技术经理,另一个不太清楚是什么职位。这次只经历了一轮。
在面试的过程中,他们先问:pandas读取数据的时候,如果数据量非常的大,比如说有好几亿条的数据,应该怎么处理?
因为之前没有遇到过,也没有考虑过这个问题,我当时回答的比较白痴,我说:直接read,然后想取某些行的话就df.iloc,第一个参数写你要的那个行数的范围,第二个参数就是所有的列。
他们听完对视笑了一下,继续问我第二个问题:要预测接下来的一个月的销量或者一个季度的销量,该用什么方法?
我当时想了几分钟,最终我没有给出一个好的解决的方法。
然后他们又问:你会不会修改别人写好的库?
然后我就硬着头皮说:应该会。因为原理都是差不多。
他们还问:你上一份的工作做了什么事情?用到了什么工具?实现了什么结果?
这个我回答得很不好,因为我并没有实战经验,简历上面写的项目只是我在网上找的几个小项目,自己对着代码敲了一遍。
问了这几个问题,就让我走人了。
这是我的第一次面试,很失败。
第二次面试
第二家公司是一个猎头推荐的,这家公司承接其他企业(比如银行)的项目来做。这次经历了两轮面试。
第一轮就简单问了几句。
第二轮是一个技术人员,可能是主管级别。
他首先让我介绍项目经验,并没有追问太多。然后开始问技术问题。
他问:之前在训练模型的时候,用的数据集是多大的?
我跟他说:大约40兆。
他又问:你用的数据是多少维度?
因为我不知道,就随便说了一个,我说:十几维,12维左右。
他再问:12维的数据,有多少行?
我说:大概40万行。
他说:40万行,12维有40兆这么多吗?
我就说: 是清洗了之后,然后才有40兆的——因为40万行十几维的话,数据量应该就应该不止40兆。
这个问题当时回答得并不是太好。
再然后,他让我介绍逻辑回归线性回归的区别。
面试前我听转型成功的那个同学说,面试时,一般会要求推导线性回归和逻辑回归,所以我就做了准备,但是没让我推导。
他又问:GBDT的弱分类器是什么?
因为我好像在网上看到过说,GBDT的弱分类器可以是决策树、线性回归,或者朴素贝叶斯之类的。然后我就把这些回答他了。
他就笑了,跟我说:西瓜书你没有看?
我说:我买了,但是没怎么看。
他说让我回去好好看看那个书。
我问他:GBDT的它的弱分类器到底是什么?
他说:就是决策树,没有其他的。
他还问了决策树分叉的原理。
我回答他有基尼系数,信息增益、信息增益率之类的。
他又问:朴素贝叶斯分为哪几类,有什么区别?
这个问题我也没有回答上来。
这轮面试就这样结束了,他让我在面试的房间里等。半个多小时之后,人事过来告诉我说面试没有通过。
他们觉得我有一定的基础,但是很多原理就是并不是太懂,如果要进公司来工作的话,可能需要一段时间的上手。而他们希望招到的人能够最快时间投入工作。
第二次面试,就这样以失败告终。
第三次面试
经过两次失败的面试,到第三家公司面试,我就相对有经验一些了。
他们问的问题有我在训练营和前两次面试中遇到过的,这些基本上我都答对了。
最后他们还问了一个问题:GBDT怎么看特征的重要性?
这个问题的答案我不知道。我直说不知道。
然后面试官告诉我:GBDT里面有参数,可以通过打印参数来看到各个特征的重要性。
他们问我会不会数据可视化。
我说:会一点,但并不是太熟。
他们又问了点别的问题,就让我回去了。第三次面试也以失败告终。
第四次面试,成功!
第四家公司的面试比之前简单得很多,问题量也是最少的,是我遇到的面试当中就是最轻松的一个。
面试官首先让我自我介绍,介绍完后就让我讲讲之前项目经验,然后问了几个非常简单的问题:
(1)线性回归和逻辑回归的区别?
(2)SVM的原理是什么?
(3)会不会爬虫?
(4)Python学了多久?
(5)Pandas的DataFrame有哪些方法?做数据处理、数据分析,常用到哪些方法?
我回答得自己比较满意。
最后面试官又问我上一份薪资是多少?
我说,上一份工作薪资10K,其实很心虚。因为,在合肥工作的时候,工资也就两三千,到上海后有时三五千,有时能拿到八九千。不过九千多只拿过一次,大部分时间拿的工资还是比较少的。
他说声知道了,就让我走了。
当天下午我就收到了offer!
给的薪资虽然比之前工作的薪资都高了不少,不过感觉相比同学的16K还是有点低。所以我想再面试几家看一下。
第五次面试
第五家是一个汽车企业,他们要给一个博士生找一个做数据挖掘的助手。
他们对学历和技能的要求都非常高,我没有通过。简单地问了几个问题,就直接走人了。
这样我就决定去第四家——拿到offer的那家公司上班了。
变身之后,如履薄冰新人期
新人上岗,惴惴不安
2019年初,我进入了现在的公司。
刚进公司非常忐忑,虽然自己会一点python,懂一点机器学习的原理,但是没有在公司真正实战过,到底不踏实。
进公司的前两天,没人给安排任务。
开始我以为需要自己找事做,就去问了我们主管,有没有什么事情要做,或者有没有需求文档之类的给我看一下。他说这两天什么都不用干。
到了第三天,他开始给我分配任务。
任务到手,一团乱麻
我接到的第一个任务是和一个老员工一起做爬虫。
关于爬虫,我只会用最简单的方式发get/post请求,参数都不知道怎么加。他们用的是scrapy框架,我都没听说过。
接到任务的第一天,我感觉自己啥都不会,非常非常非常地焦灼。
那个老员工给了我代码,我跑了一下,发现那个网站网页结构变化了,原来的脚本跑不成功。然后我就在那儿坐着纠结了一天。
我们经理就坐在我对面,我的表现他都看在眼中。他当着我的面打电话给人事,说:以后再招员工的时候,一定要仔细一点。
我就想他们会不会赶我走。
虚心求教,学会爬虫
当天晚上,我找那个老员工请教:爬虫到底怎么做?爬虫框架到底是怎么一回事?
老员工人很好,他跟我讲了50分钟。听他讲完我才发现,scrapy框架其实很简单,需要修改的基本上只有spider文件。我又马上从京东买了本书,第二天到。
第二天上午的时候,我试了一下头天晚上学的方法,一边就是回忆同事教我的知识,一边在网上查,捣鼓了一整天。
第三天我对着书,基本上能够搞定最简单的json类型的爬虫了。
json大家应该都知道, import json, json.loads( response.text ),就能把它解析为字典或者列表格式,它们是Python内置的数据类型,处理起来非常方便。
那些天,我每天早晨六点钟起床,看爬虫的视频课程。每天晚上自己加一两个小时的班,专门学习爬虫。
有一次爬虫需要用到正则表达式,当天下班之后,我就在网上找了相关的资料来学习,连续学习了三个晚上加三个早晨。
其实在应用的过程中,只要你能对照着网上的代码,自己敲代码,运行有结果了,就会感觉非常简单,容易掌握了。
这样,我用一个星期能完全搞定一个爬虫了。后来缩短到三天,再后来缩短到一天,再后来,简单的爬虫半天就行了。
职责更新,成为骨干
做了一个月爬虫之后,我开始做数据分析方面的工作。
数据分析,我个人感觉学得还可以。我们小组其他的人不怎么会数据分析,而我之前自学到的,在工作中都用上了,给同事们帮了很大忙。
于是,组里同事有数据分析不懂的地方都来找我。
初遭裁员,忐忑成为幸存者
贵人指点,态度为先
我刚入职的时候,问了一下我同学:刚进公司,有哪些需要注意的事情?
然后把第一天主动问主管要任务和文档的事情和同学说了一下。
我同学让我没事别瞎问,否则会显得我很业余。IT公司基本上不会有人没事找事做,而且也并不是每天都那么忙。
他还特地告诉我:**如果你技术不是很好,那就每天晚上晚点走。**这样即使事情做得不是太好,但主管、同事都会看在眼里,知道你努力了,至少比他们晚走很多。如果事情做得不好,下班还走得早,同事们就有话说了。
这两件事我都听了他的。从一开始,我就每天下班走得很晚,比我们主管、经理都晚,尽可能用多出来的时间熟悉业务,学需要用到的知识。
亲睹裁员,职场无情
很不巧,我进公司得第二个月(刚开始做数据分析不久),公司就开始大规模裁员了。
有一天下午,有个人——应该是别的部门的经理——跑到我对面找我们经理,拿了一个名单跟我们经理说:这些人都要裁掉。你看他们,都下班就走,跟实习生一样,直接裁掉不要了。
我当时很忐忑,以为上面会有我的名字。但是后来我才知道,被负责人找谈话得才会被裁,我没有被找谈话,最终留了下来。
我们小组的一个同事,比我早来一个月,被裁了。还有一些工作了一年多,两年的同事,也被裁了。整栋楼里,很多人都被裁了。
结果驱动,贡献为准
我们公司很大,各个部门都有裁员。被裁掉的,绝大部分都是下班走得比较早,或者平时工作中,效率比较低的那种。
效率低其实不一定不是技术不好,很多是技术能力很厉害的,但是不愿意干活。
我们小组被裁的那个同事就很厉害,Python编程、数据库、图像处理都会,尤其爬虫很精通。
同样的爬虫任务,基本上他半天或者一天就能搞定了,我要做两三天才行。
但是,那位同事即使半天就能做完的任务,他也要做一周。非要等到最后一天才跟主管说他做好了。
他是怕主管给他分配新的任务,他不想多做,一周就做一个任务,实际用时半天或一天,空余的时间用来学习别的东西。
他的技术比我好的太多,想法也很好,但是最终他被裁了,而我没有。
确保产出,成为优选
很幸运,我在历时一个多月的裁员中幸存了下来。究其原因:
- 一方面是因为自己主动加班,表现出了良好的态度;
- 另一方面是因为相对做事情的效率不错。
虽然我做事情的效率其实不高,但是我做完就会向主管汇报。无论是否再给我安排新任务,都让他知道我的进度。
所以我给他们的印象应该是刚入职是个菜鸟,但是经过两个月,进步不少,不完美,但是至少总能交付结果。
相反,被裁的同组同事即使做好了也不及时的跟主管说,他在主管看来,效率就不高了。而且他还踩点就走,不愿意加班。
独立求解,互帮互助
在工作中,遇到棘手的问题,我会先自己查,实在自己找不到答案,再问我们的那个老员工。
刚开始基本上都是我问他,但是后来他遇到不会的也会来找我讨论。组里其他同事遇到数据分析的问题也会来找我。
我觉得,后续即使再裁员,应该也不会裁掉我。即使真的裁了我,我现在的技能也足以找到新工作了。
规划未来,学无止境需磨砺
虽然我是以机器学习算法工程师的身份进入公司的,但是具体工作还没有涉及到机器学习。
现在,我会在比较空闲的时候,自己跑几个机器学习模型,练习一下。比如前几天刚跑了一个逻辑回归。
之前的机器学习理论都是自学的,不够深入,现在已经学的差不多了。
我个人是比较喜欢自然语言处理,把这个也学了。
数据库也要再深入学习。数据库非常重要,只会简单操作是不够的。
需要学的还有很多,学无止境。
心得体验:机遇需要自己去抓住
有两句话送给大家,是我根据自己的经历总结出来的:
-
第一,要善于抓住机会。
我以前想搞养殖的,却没成功,错过了非常好的机会。现在第二次的机会,决不能再错过了,所以我选择了转行人工智能大模型。
-
第二,一定要找到适合自己的领域!
虽然每个人都可以通过学习进入自己不太擅长的领域,但是那样会很吃力。还是在自己擅长的领域发力,才能事半功倍。
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

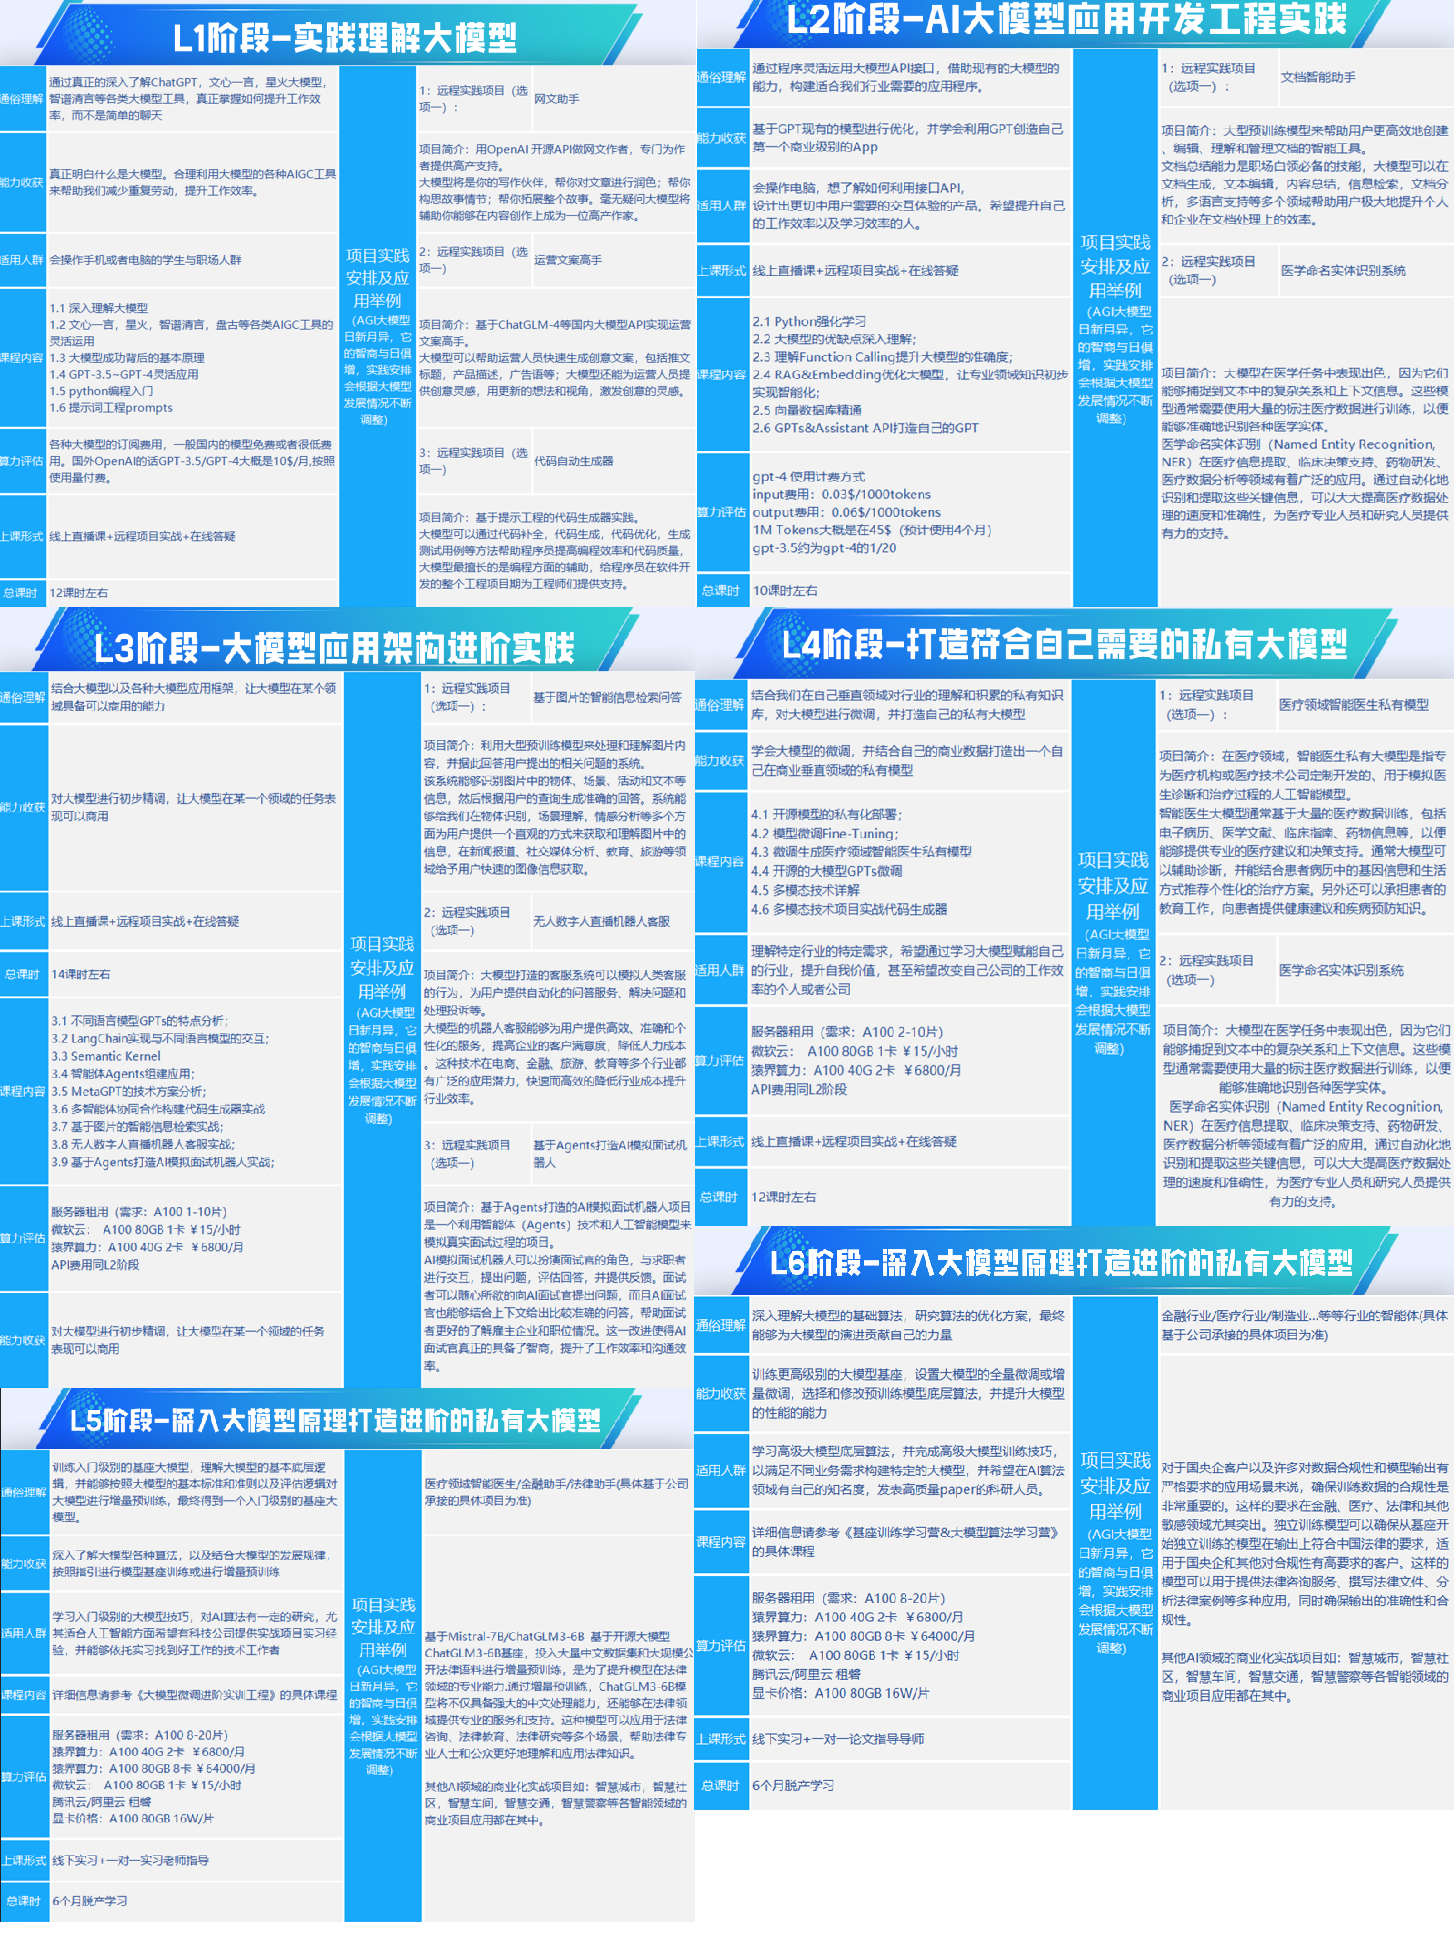
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
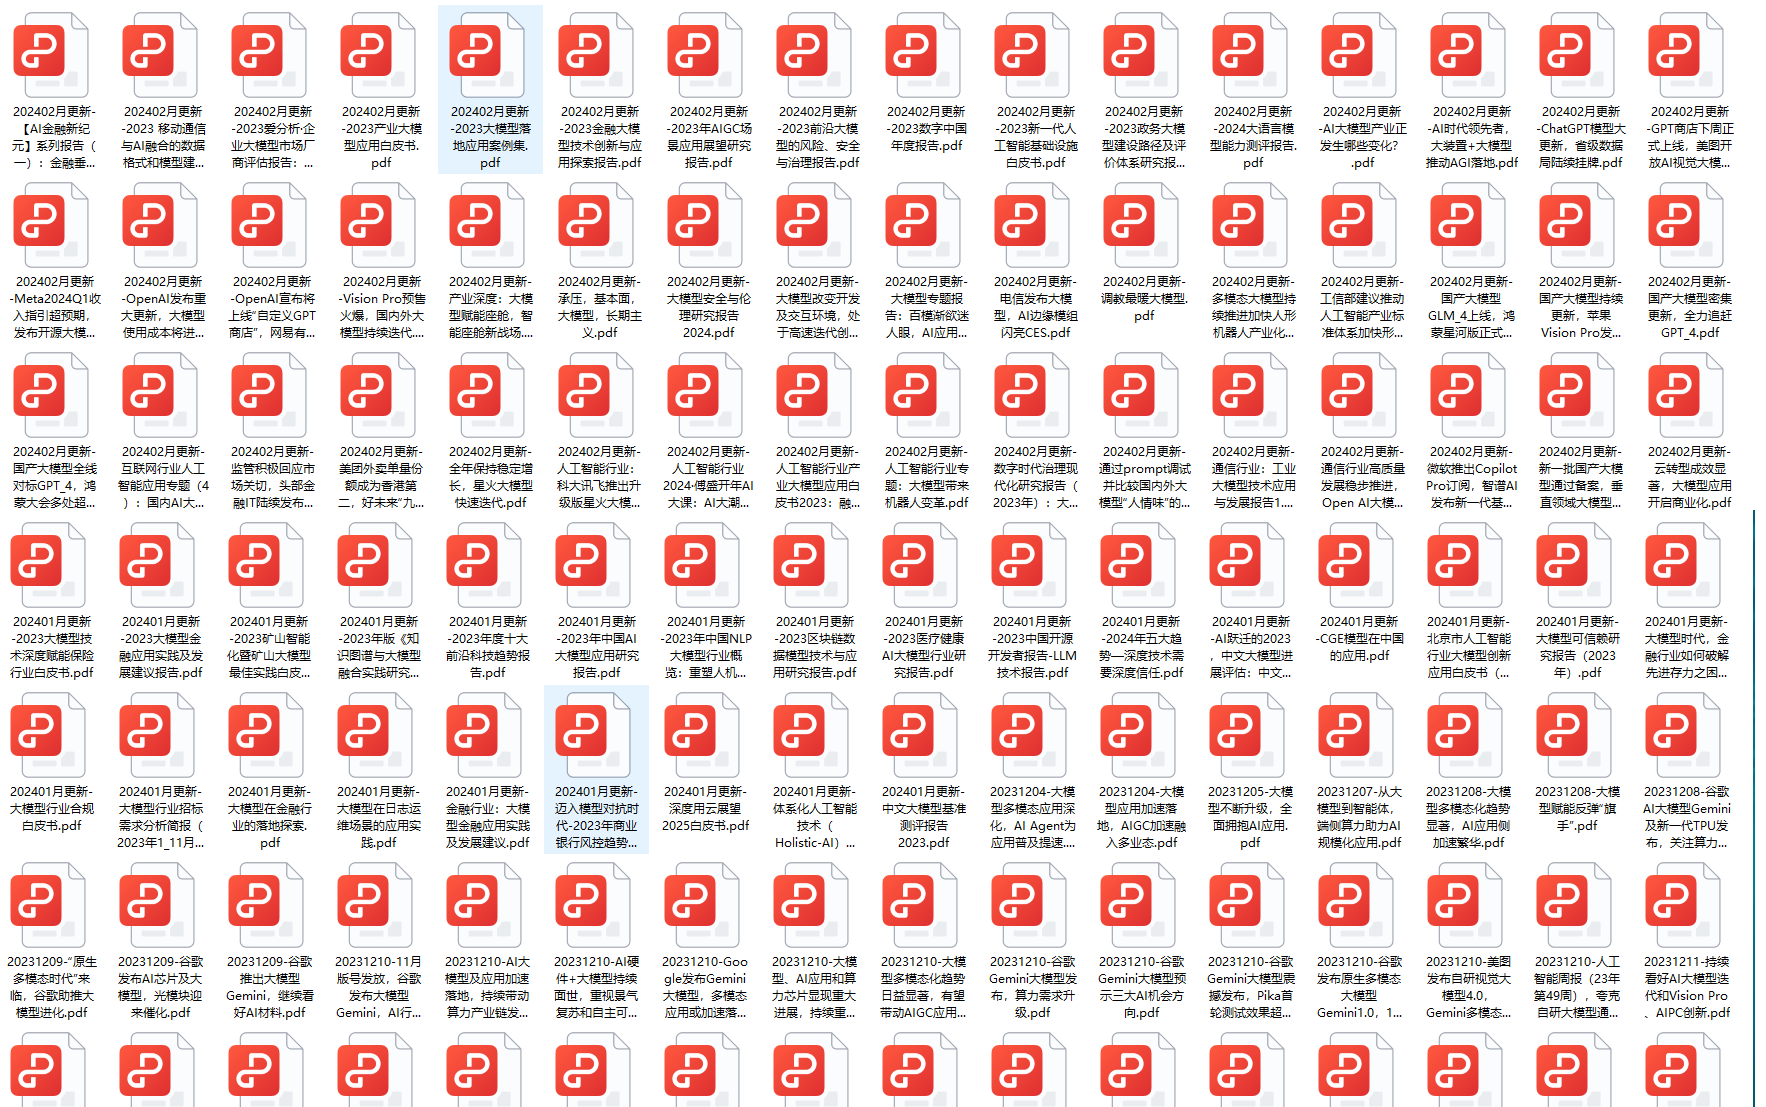
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
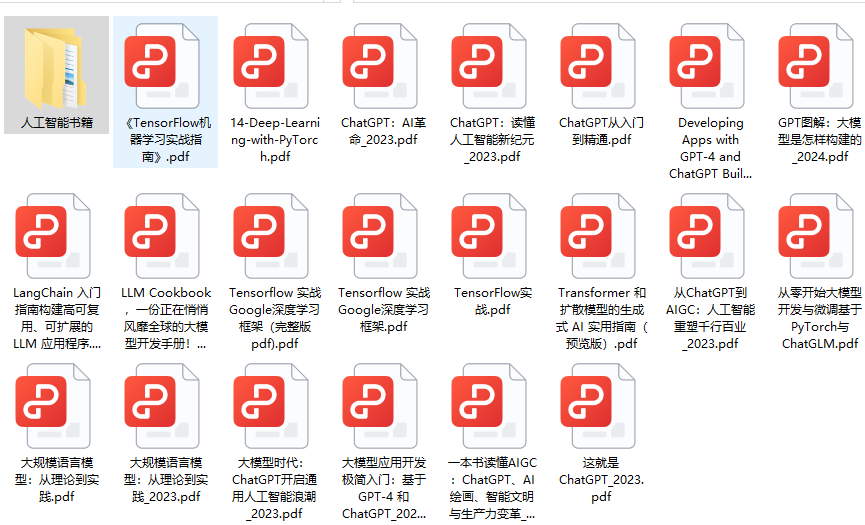
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
四、AI大模型商业化落地方案

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


