Ollama 初体验,本地部署大模型利器,小白也能在 M2 芯片的 Mac 上分分钟跑起来

智谱AI发布国产最强大模型GLM4,理解评测与数学能力仅次于Gemini Ultra和GPT-4,编程能力超过Gemini-pro,还有对标GPTs商店的GLMs 这是在智谱AI开发者大会上推出的新一代基座大语言模型,GLM4相比较此前最大的特点是三个变化:性能全面提升、上下文长度更长、支持更强的多模态能力。GLM4(GLM4)详细信息 | 名称、简介、使用方法,开源情况,商用授权信息 | 数据学习 (DataLearner) 阅读详情
AI摘要

本文介绍了在M2芯片的Mac上使用Ollama本地部署大语言模型的方法。先从官网下载Ollama应用程序并运行,再在终端执行命令下载运行模型,还可安装open - webui在浏览器使用。此外,作者还分享了AI大模型学习资料,包括学习路线、报告合集、经典书籍和商业化落地方案。

img

Ollama 是一个开源的大型语言模型(LLM)服务工具,旨在简化在本地运行大语言模型的过程,降低使用大语言模型的门槛。

有了 Ollama,即使是小白用户,也能分分钟在自己电脑上跑一个大模型玩玩。
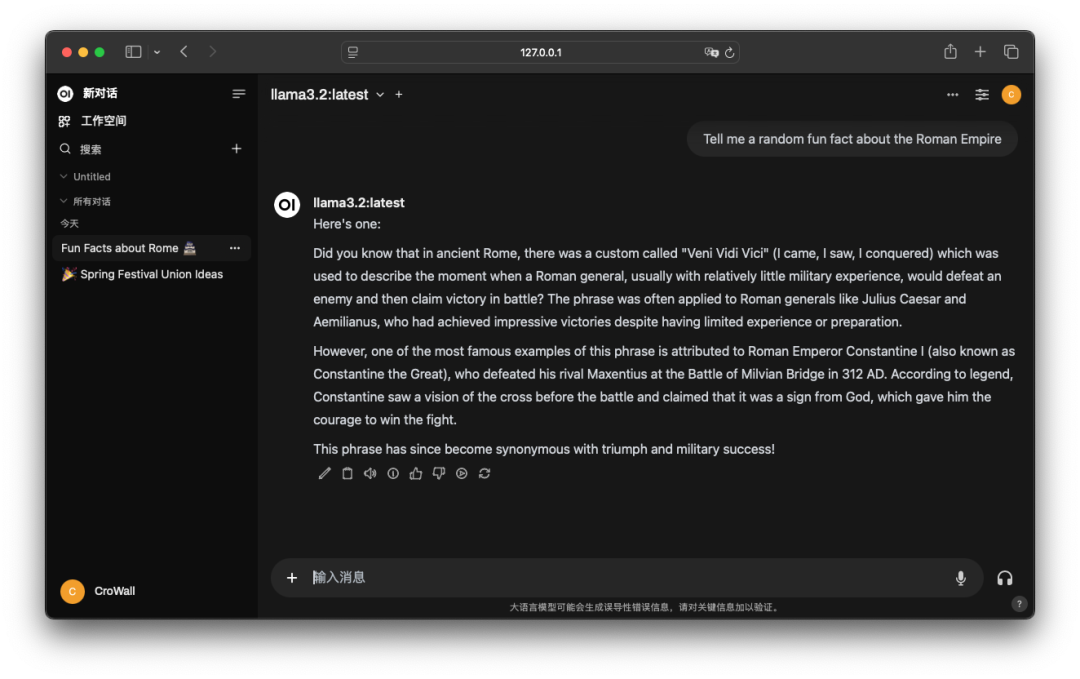
img

我之前一直以为大模型需要强悍的 GPU 才能在本地跑,所以虽然一直在用 ChatGPT 之类的 AI 工具,但从没想过在本地运行一个——因为我只有一个 M2 芯片的 MacBook Air,一直觉得带不动。

前天帮朋友在他的游戏本上安装了一个图片生成的秋叶整合包,顺便了解了一些相关资料,发现现在的大模型只是在本地跑跑推理并不需要太多的资源,跟训练模型不是一个量级,m2芯片也能带得动,看来我还是图样图森破了。

今天就尝试了一下,发现现在的工具是真的太方便了,就记录一下安装体验过程,分享一波。

话不多说,下面正式开始操作,本文以我的 M2 芯片的 Mac 为例。
img

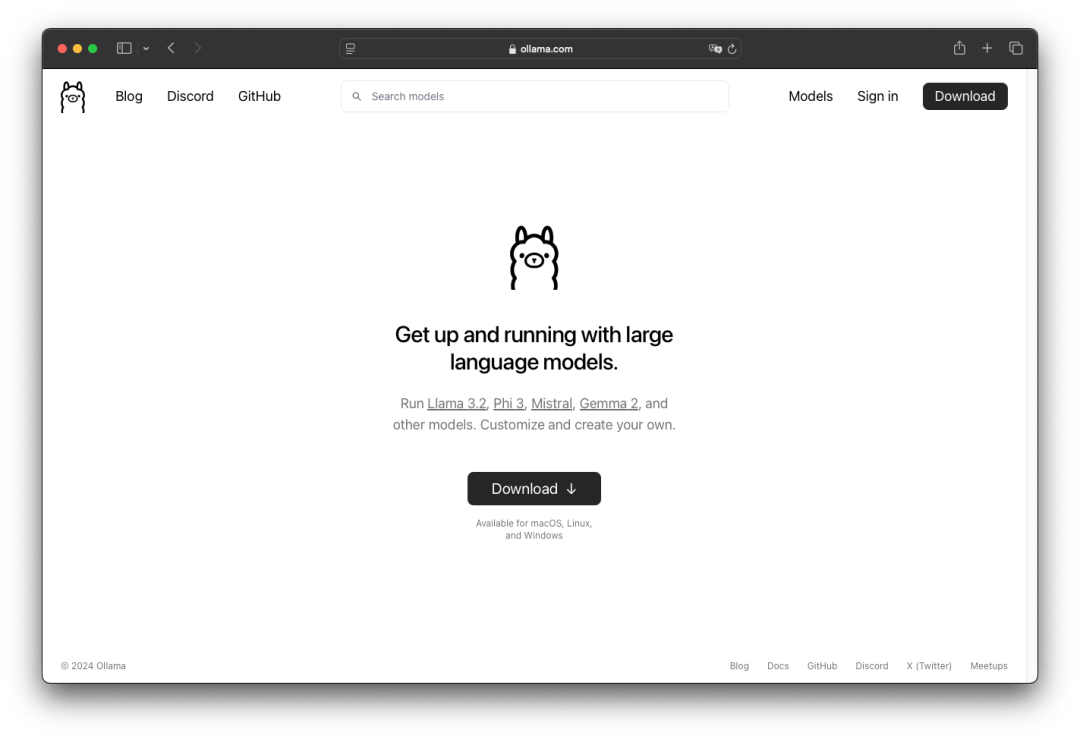
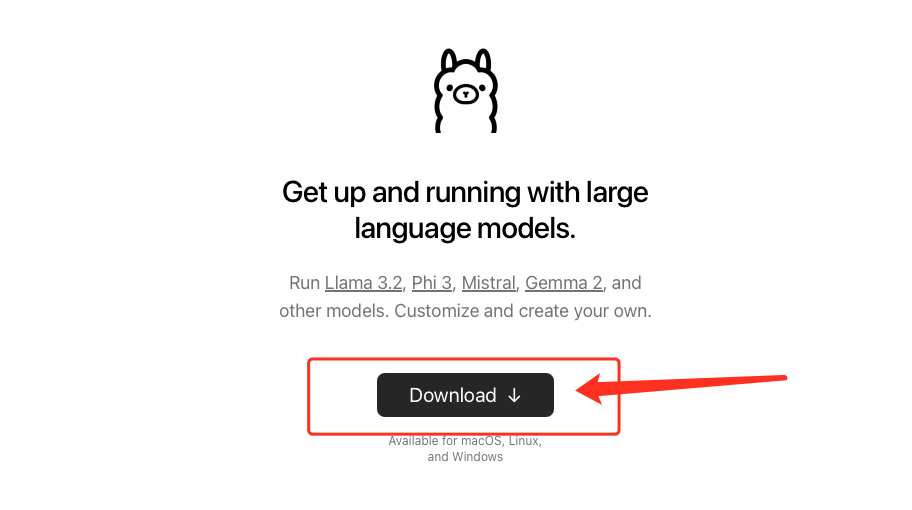
第一步,到官网下载 Ollama 应用程序。

官网地址 https://ollama.com

解压出 Ollama.app 移动到应用程序目录里,双击运行即可。

注意 Ollama 程序正常运行后其实是看不到界面的。
img

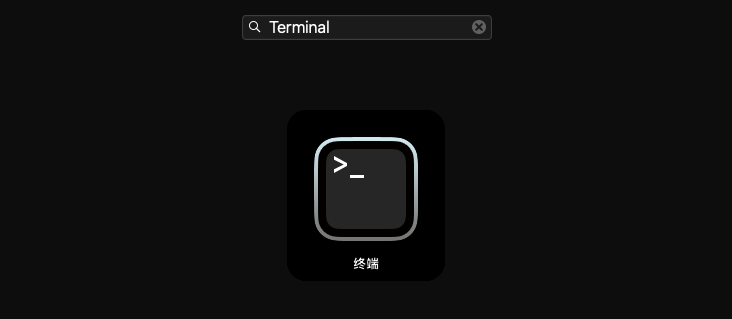
第二步,打开 终端(Terminal)应用,执行以下命令:

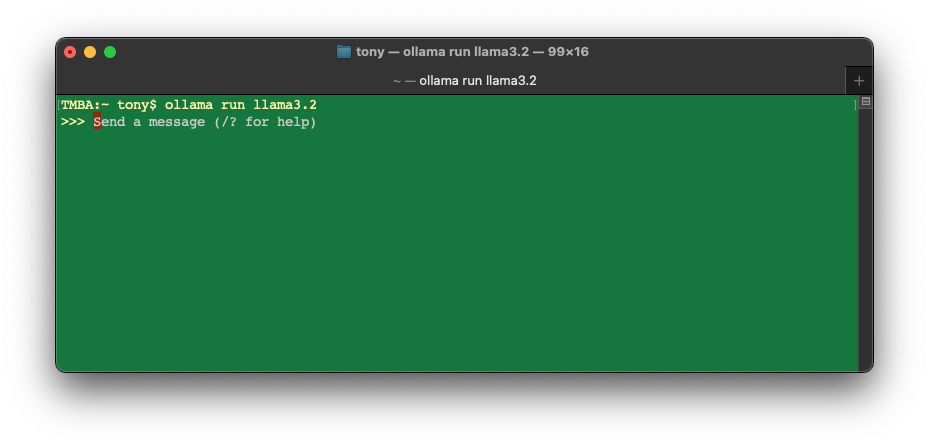
ollama run llama3.2

这个命令的意思就是让 Ollama 运行 llama3.2 模型。

该命令会自动下载并运行 llama3.2 模型,,这个模型大小为 2GB,所以第一次运行时需要等待几分钟(看你的网速快慢),等待模型下载完成后进入(后面再运行的时候,就很快进入了):
img

当然也可以使用其他模型,官网提供了很多模型,你可以根据你的偏好和硬盘大小选择。

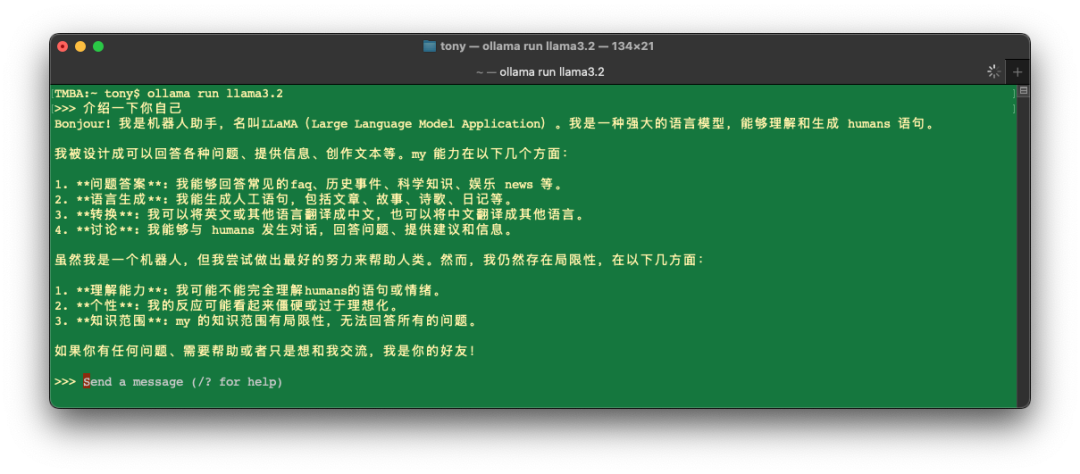
第三步,到这里其实就已经可以认为完成了(快不快?是不是分分钟?),你可以直接在终端里对话了。
img

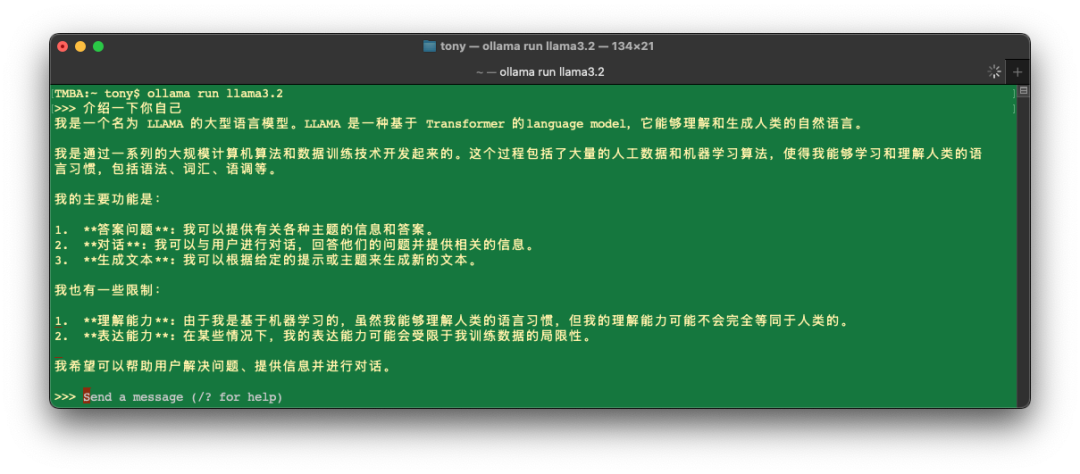
实际测试来看,llama3.2 虽然夹杂的英文单词比较多,但对中文的支持还是不错的。
img

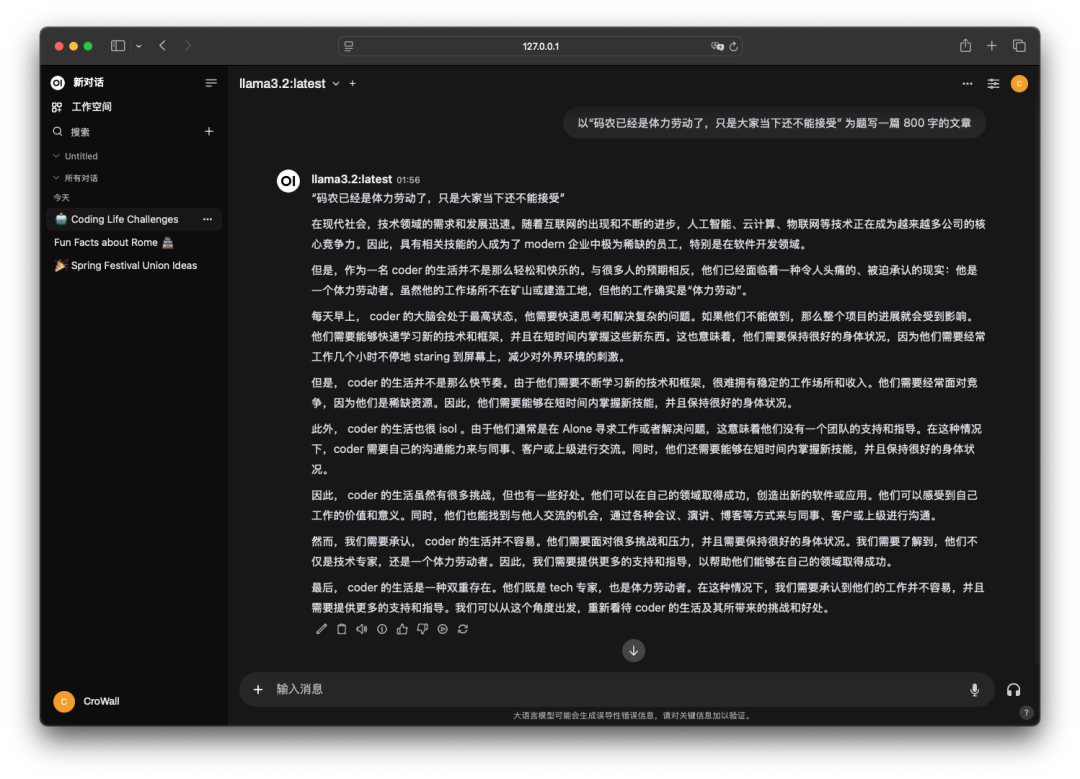
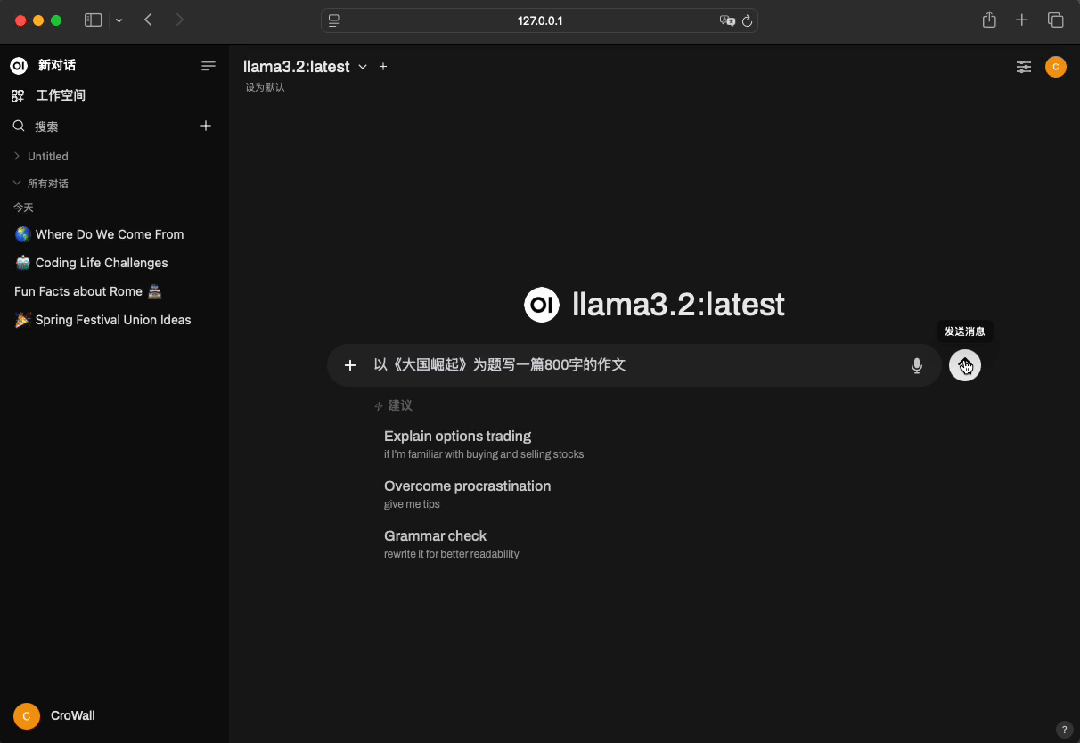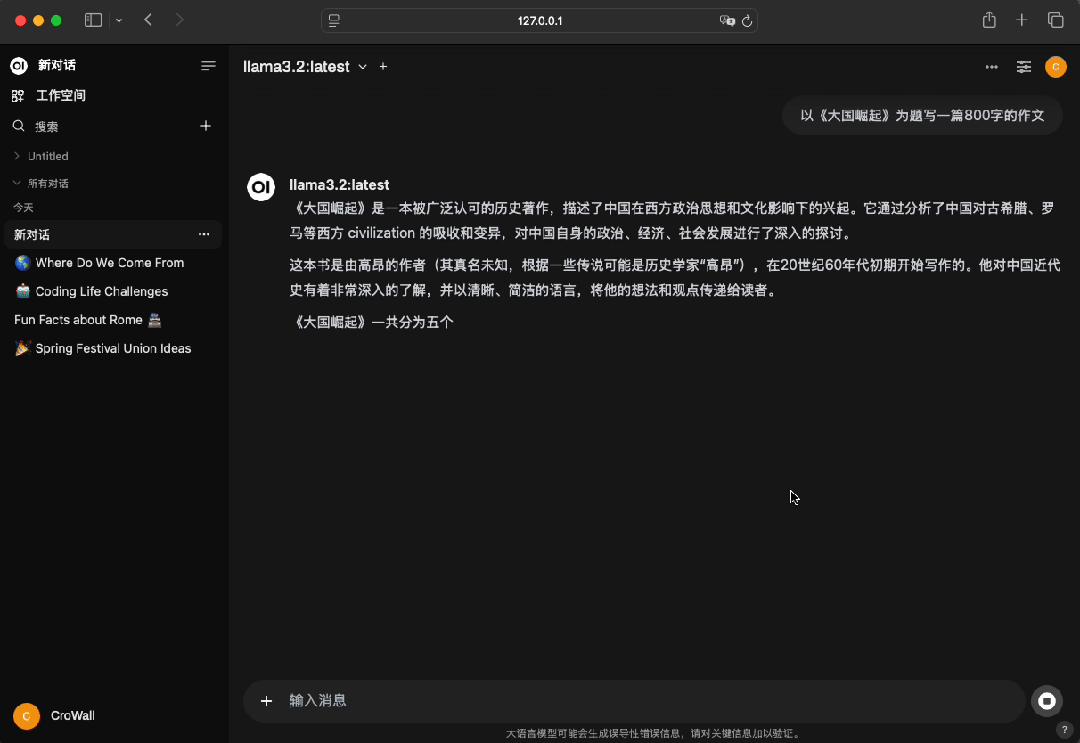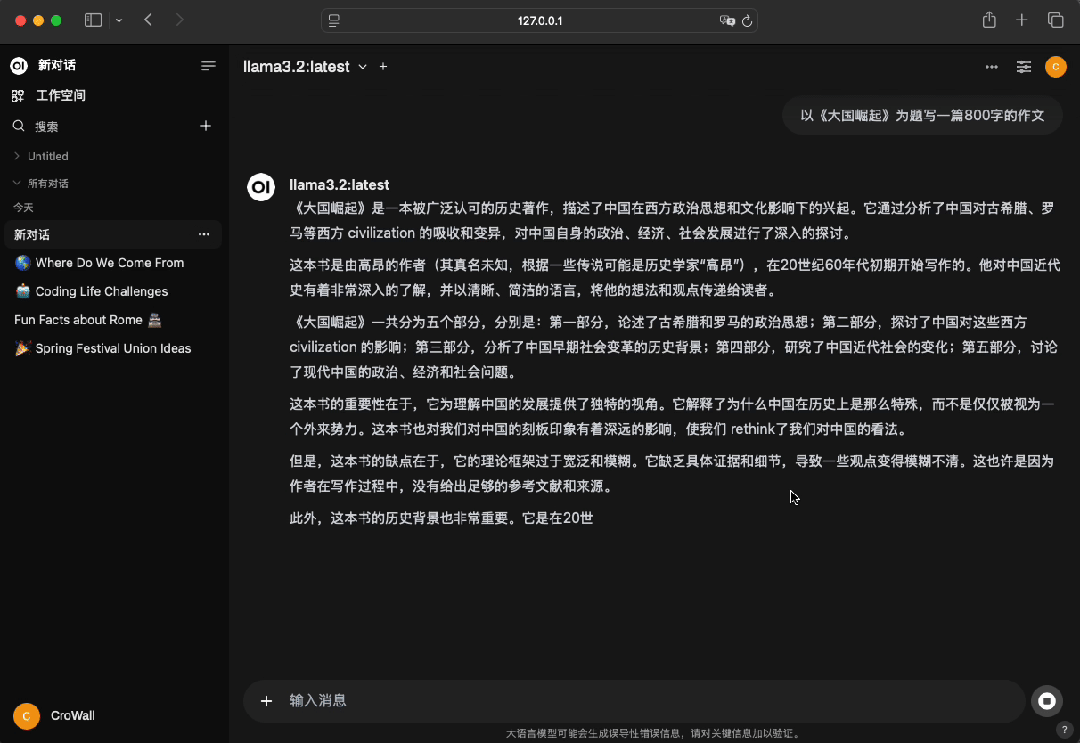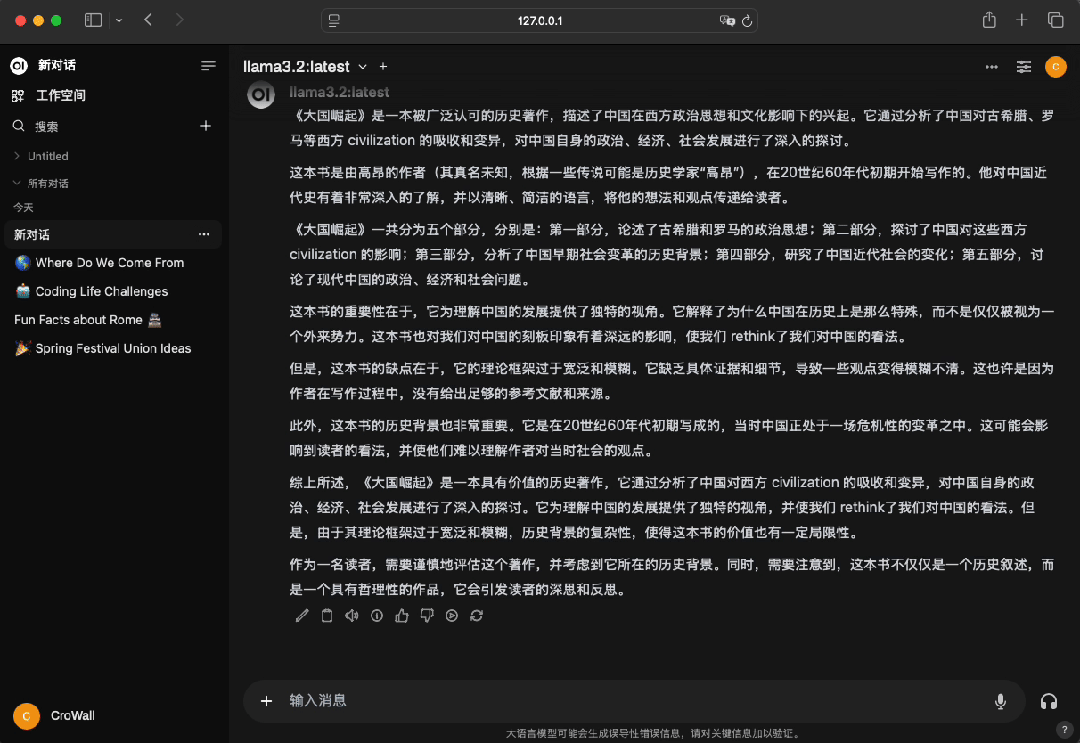
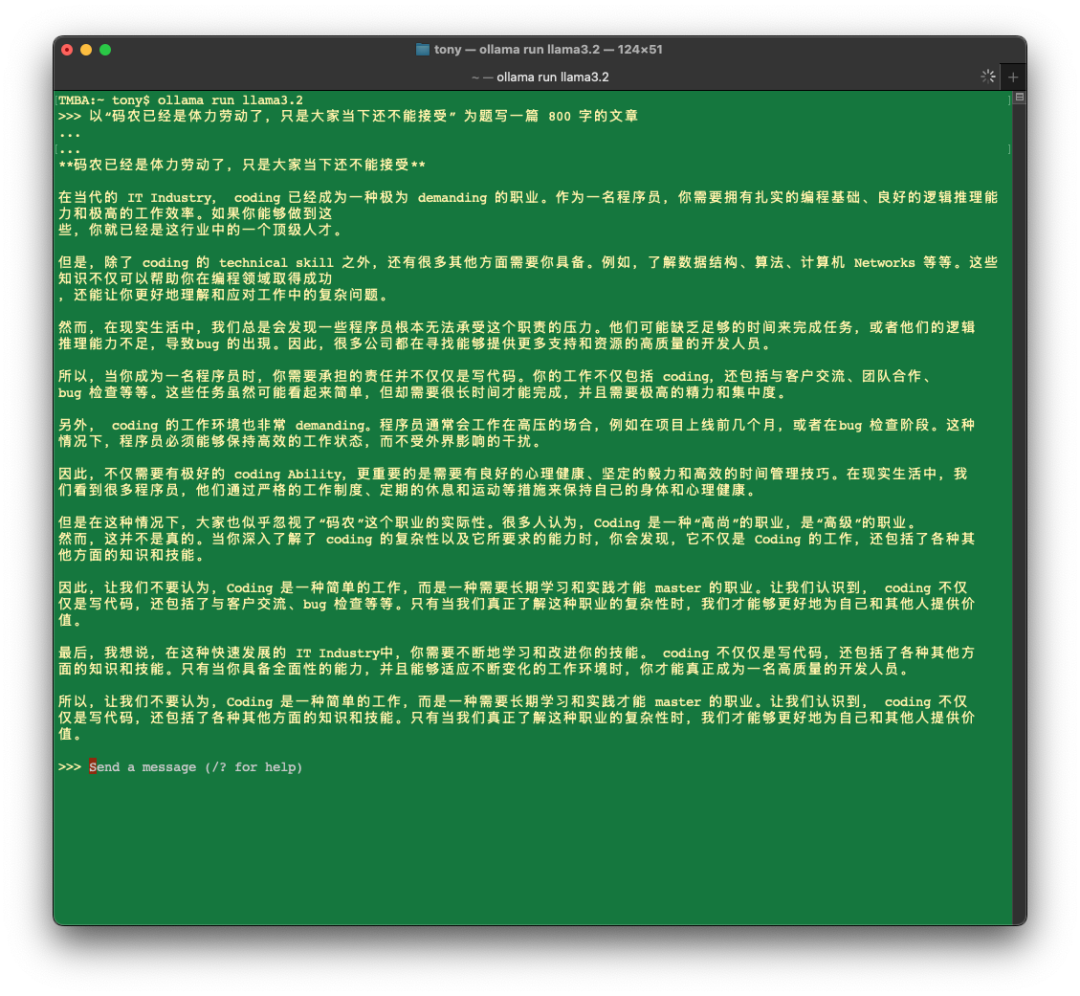
让它以“码农已经是体力劳动了,只是大家当下还不能接受” 为题写一篇 800 字的文章,也是分分钟写完,效果还可以。
img

我发现它写出的文章中夹杂的英文单词太多,于是又让它“不要使用英文词汇,全部使用中文”,结果 Coding 不见了,其他单词还在。

当然,只是在终端里面跑差点意思,下面我们安装 Web 界面,这样就可以在浏览器里使用了。

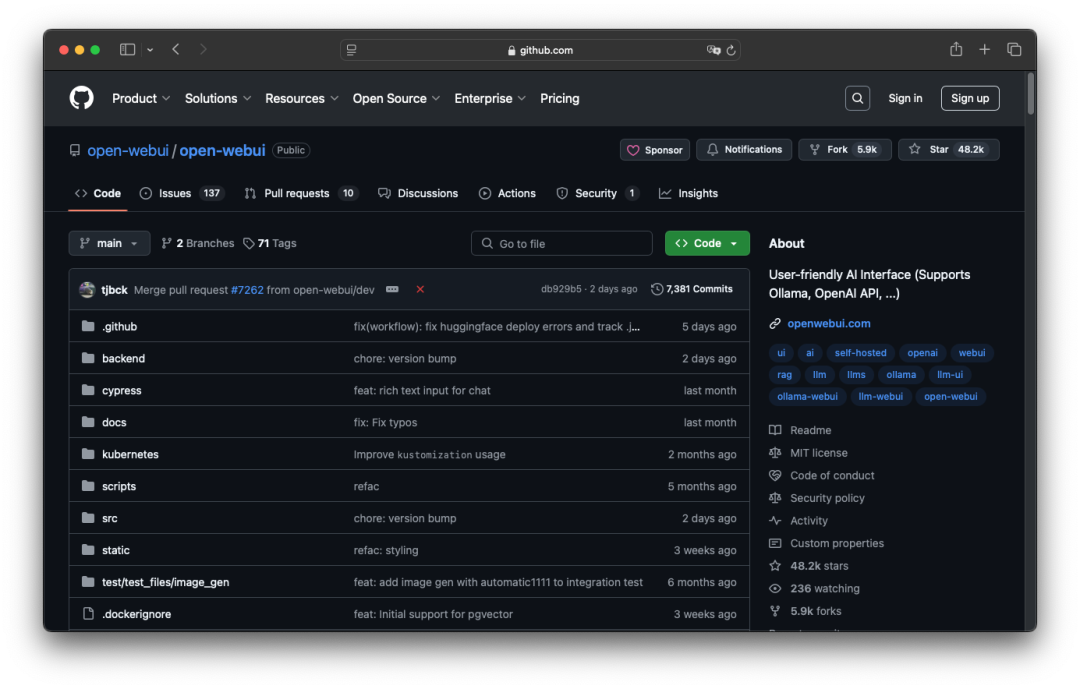
这里我们使用的是 open-webui 这个项目,GitHub 上有 48.2k 的 Star(意思就是很火爆)。

我本来以为这个对于小白用户可能稍微有点难度,但发现官方封装了 pip 包,而 macOS 又是自带了 Python,所以也很简单。
img

Github 地址: https://github.com/open-webui/open-webui

第四步,安装 open-webui,打开一个新终端窗口,执行以下命令:

pip install open-webui

这个命令需要下载一大堆依赖包,所以运行时间也比较长。

如果你的 macOS 比较干净,没有使用 brew 安装过一些基于 Python 的应用,应该会比较顺利。

安装完后,使用下面的命令运行即可:

    open-webui serve
    

运行后,默认是启动在 8080 端口,在浏览器中输入 http://127.0.0.1:8080 即可打开。
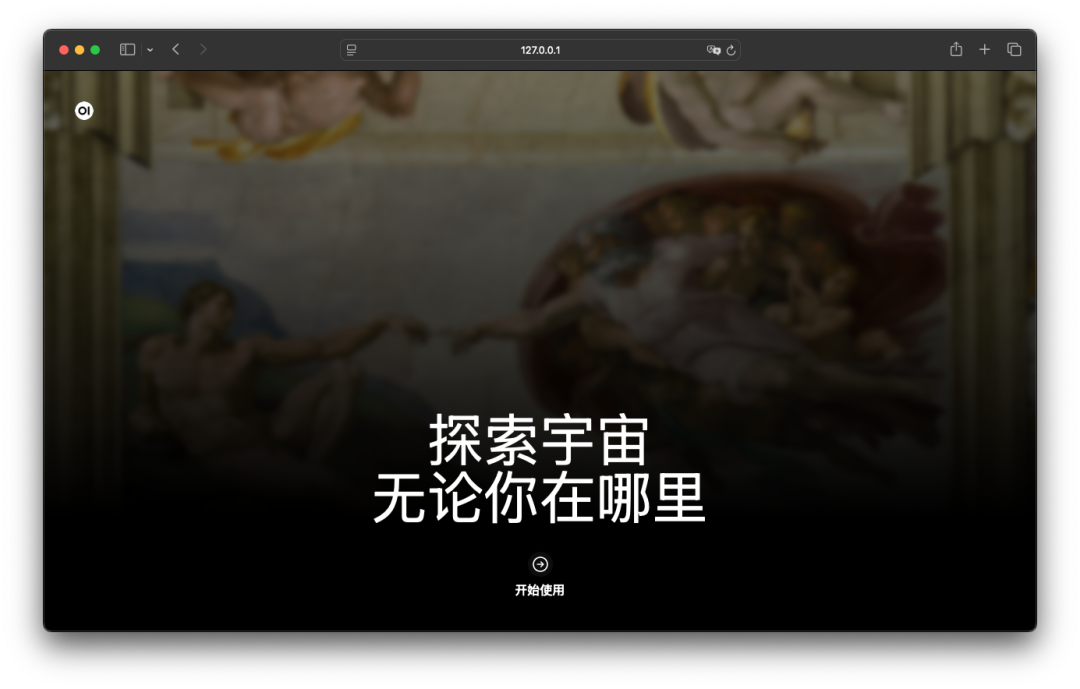
img

如果使用 pip 安装失败**,**就要考虑使用 docker 安装,否则一堆依赖搞环境要搞半天。

使用 docker 对于小白用户有点难度了,这里就不赘述了,有需要的直接到该项目的 GitHub 主页查看。

我就遇到了问题,所以直接使用 docker 运行了(下面的命令是使用 docker 连接本地的 ollama 跑,已经 pip 安装成功的请忽略):

docker run -d -p 3000:8080 \
    --add-host=host.docker.internal:host-gateway \
    -v open-webui:/app/backend/data \
    --name open-webui \
    --restart \
    always \
    ghcr.io/open-webui/open-webui:main

点击开始使用,配置管理员账号:
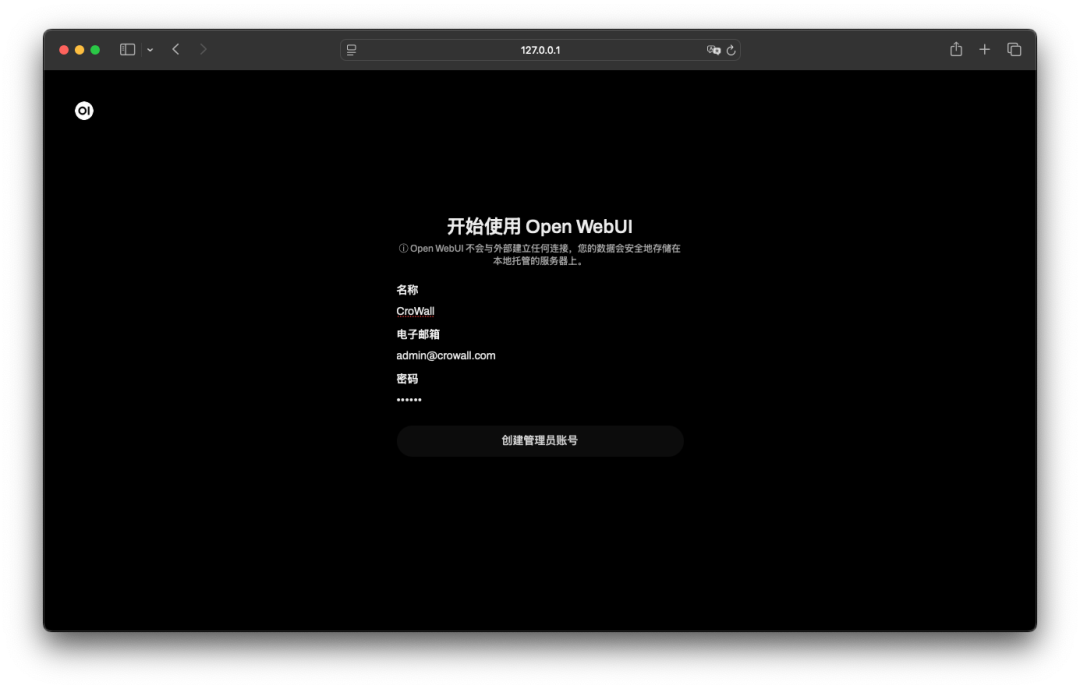
img

进入主页:

img

可以看到已经自动连接到了 Ollama,运行的 llama3.2 模型也已经可以直接使用了。
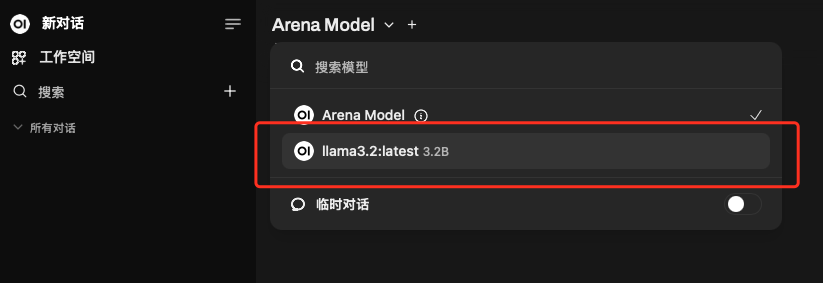
img

那么怎么看连接的 Ollama 呢?隐藏得比较深:

img

可以看到,你也可以在这里填入 OpenAI 的 API 密钥,这样也可以把它当作一个 ChatGPT 客户端了。

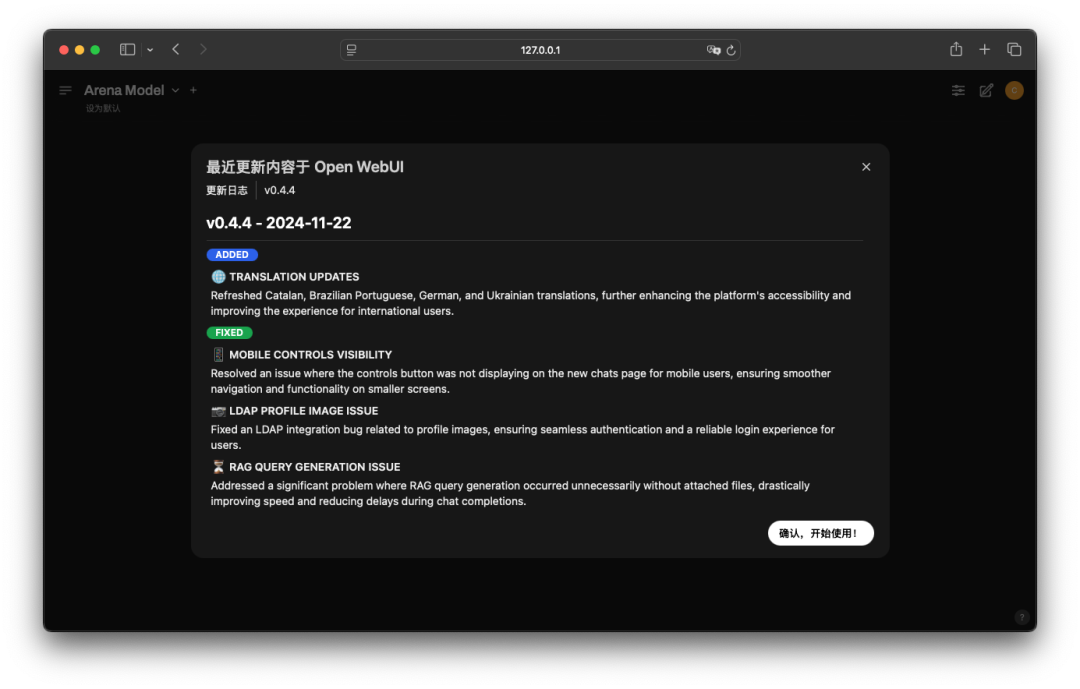
open-webui 网页端的使用效果:
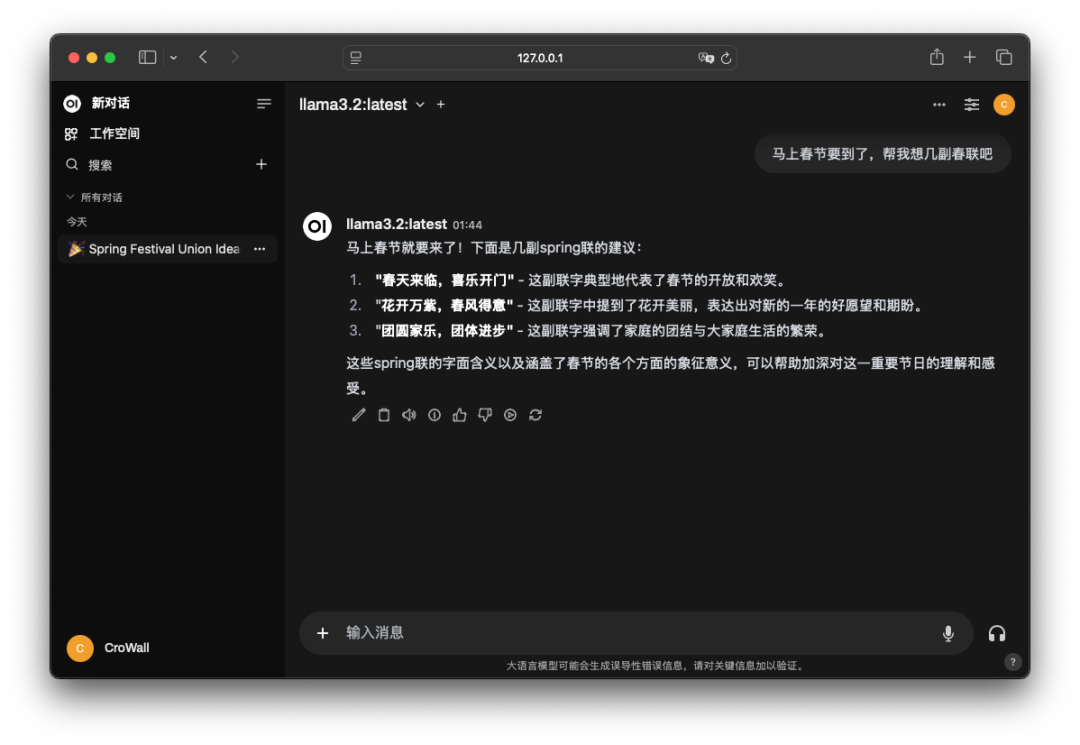
img

img

最后,如果你想获得更好的中文支持,可以到官网搜索一些中文的大模型,直接搜 Chinese 即可:

img

目前对阿里的通义千问支持也很好,有多个版本多个尺寸的模型可以选择,搜索 qwen 即可看到:
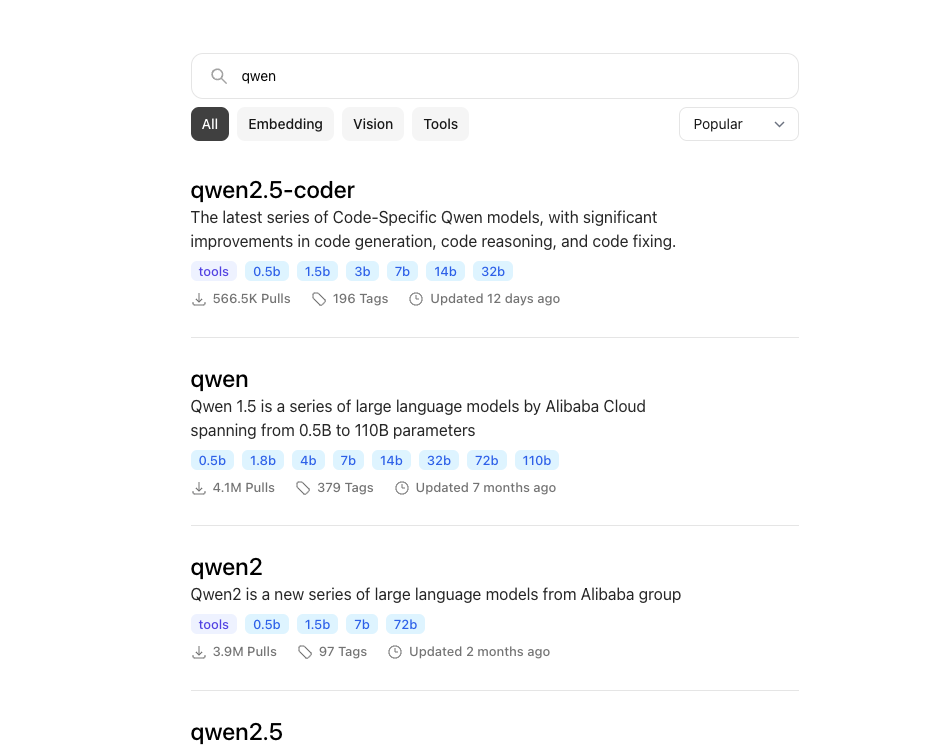
img

我看了下,对 qwen2.5-coder 这个模型比较感兴趣,毕竟说它擅长代码生成、代码推理和代码修复,以后没有网也可以开心写代码了。

不过这个就要让我的 JetBrains IDE 以及 Sublime 或 VS Code 直接连接到本地的 Ollama,这个今天就不研究了,下次继续搞。
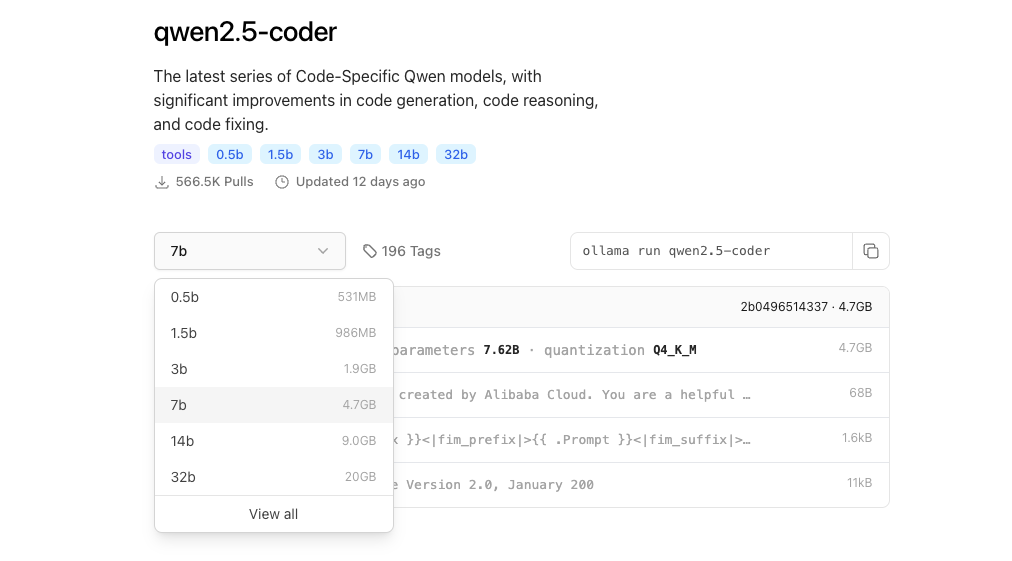
img

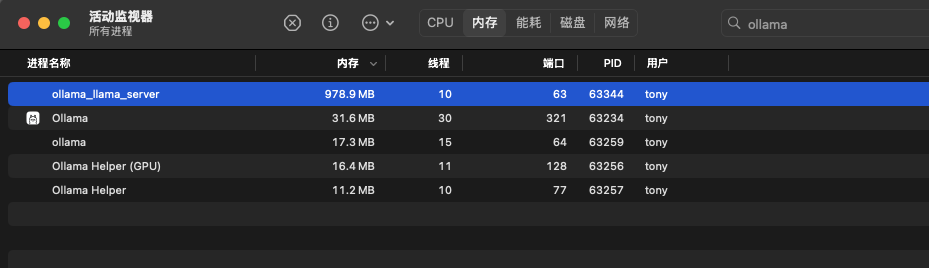
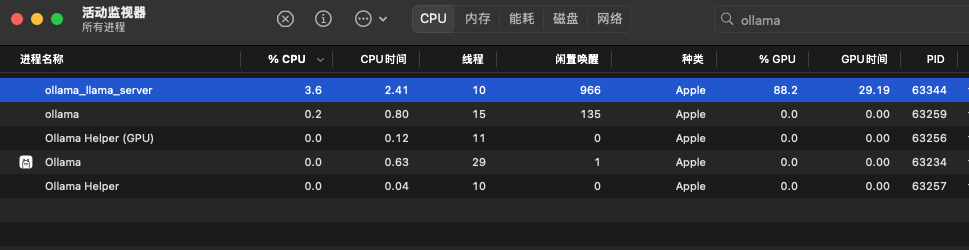
实际运行中,llama3.2 占用的内存还是蛮低的,1个G左右,跑推理的时候,GPU 几乎能跑满,占用可达 90%,不过毕竟我这是个 M2,可以理解,而且生成的速度也蛮快的。
img

img

img

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

用ollama本地部署Lamma3.1 ollama create 自定义模型名字 -f Modelfile。让lamma3.1写一个贪吃蛇小游戏,一次run成功。例如:ollama run llama3.1。例如:ollama run llama3.1。 阅读详情

相关推荐

Windows 中 利用 ollama 来搭建 deepseek R1

近年来,大模型凭借其强大的语言理解和生成能力,在自然语言处理、计算机视觉等领域取得了突破性进展。从GPT系列到国内的,文心一言、[Qwen]、,大模型已成为推动人工智能发展的核心力量。ollama作为新兴的大模型搭建工具,以其开源、高效、易于部署的特点,在人工智能开发者社区中崭露头角,为大模型的搭建和应用提供了新的解决方案。在当今数字化浪潮中,人工智能的发展可谓日新月异,而大模型作为其核心驱动力,正重塑着各个行业的格局。

一个专注于机器学习基础与实战的技术博客,内容涵盖算法推导、模型实现、数学原理与代码实践。用通俗的语言解析复杂概念,记录学习过程中的思考与总结,适合机器学习爱好者和从业者参考。 2554

使用 Ollama 本地运行各种 LLM

今天看看另外一个产品Ollama。Ollama 的安装非常简单,只需从官网(https://ollama.com/download)下载后解压缩,并在 Terminal 中运行脚本即可完成环境设置。我尝试运行 Llama3,虽然在运行时占用了大量电脑资源,使得其他应用运行变慢,但整体体验尚可。Ollama 支持多种大型语言模型(https://ollama.com/library)。

python123456_的博客 1736

Mac mini价格上涨背后:Swift开发实战与部署指南

在Apple生态开发中,硬件与工具链的匹配度往往决定开发效率。Swift作为iOS/macOS应用的核心语言,其编译性能与运行环境高度依赖Mac设备。而在网络层实现中,URLRequest的灵活运用与async/await并发模式能显著提升请求效率。同时,随着本地大模型部署需求增长,如何在Mac mini上高效运行模型推理成为开发者关注热点。本文从Swift开发基础出发,结合Mac mini从M1到M4的性能演进,分享网络请求封装、错误处理、并发编程、本地模型集成以及App上架全流程的实战经验。通过硬件选型

weixin_33754065的博客 259

AI大模型探索之路-基础篇5:GLM-4解锁国产大模型的全能智慧与创新应用

随着人工智能技术的飞速发展,大型预训练语言模型已成为推动行业进步的重要力量。它们在理解自然语言、生成文本、执行复杂任务等方面展现出惊人的能力。在此背景下,国产大模型GLM-4的问世,不仅展现了中国在AI领域的实力,也为国内外研究者和开发者提供了新的研究与应用平台。

寻道AI,探索AI无限可能! 8685

Mac上本地部署Qwen Coder实战:从选型到踩坑全指南

随着大模型技术普及,AI编程助手已从自动补全进化为能独立编写模块的智能体。本地部署大模型成为开发者兼顾数据安全与离线使用的关键方案。Ollama作为轻量级模型运行工具,配合Apple Silicon统一内存架构,让Mac用户能高效运行开源代码模型。Qwen Coder凭借多尺寸覆盖与OpenAI兼容API,成为本地AI编程的性价比之选。从模型选型、量化格式换算到VS Code集成,本文完整拆解Mac上部署Qwen Coder的实操流程,并分享内存Swap、输出截断、端口冲突等真实踩坑经验,帮助你绕过常见障碍

weixin_30952479的博客 76

Mac统一内存与Agent工作台:AI开发环境搭建实战

大语言模型的本地化部署已成为AI工程实践的热点,而硬件内存架构与软件工具链的协同直接决定了开发效率。Apple Silicon的统一内存架构打破了传统显存与内存分离的瓶颈,使本地运行中等规模模型成为可能。在此基础上,以Agent为中心的开发范式正逐渐取代传统IDE工作流,通过终端复用、模型管理工具(如Ollama)与多Agent编排,构建出一条从模型调用到任务执行的完整流水线。从选型逻辑出发,梳理基于Mac工作站的Agent工作台搭建过程,涵盖硬件配置建议、本地与云端模型的分工策略,以及实际运行中遇到的典型

weixin_30861459的博客 547

8GB内存Mac也能跑端侧模型:Ollama量化部署实战指南

大模型本地部署听起来总是与高配置强绑定,但通过量化技术与统一内存架构,8GB内存设备同样能获得流畅的端侧模型体验。量化将FP16权重压缩至4bit,使7B模型体积降到4GB左右,让低配硬件在本地推理中焕发新生。配合Ollama等轻量工具,Apple Silicon的Metal加速被天然利用,无需独立显存即可实现CPU-GPU共享内存的推理。无论是日常写作、批量文本处理还是知识库问询,本地部署带来的tokens自由与数据私密性,正成为开发者与内容创作者的新选择。本文从模型选型、量化档位权衡到工作流搭建,完整还

weixin_31499265的博客 97

本地模型与云端API统一调度:基于OpenAI兼容协议的网关实践

在AI应用开发中,API集成是连接模型能力与业务逻辑的关键环节。随着本地推理框架与云端大模型服务的并存,开发者常面临接口协议碎片化、调用方式不统一、成本与性能难以平衡等问题。OpenAI兼容协议凭借其简洁的HTTP接口约定,已成为事实上的行业标准,让不同模型供应商和本地推理框架能够以统一的请求格式对外服务。通过引入API网关或SDK封装层,可以实现对本地模型与云端API的统一纳管与自动路由,按需切换模型来源,兼顾成本、隐私与性能。这种模式广泛应用于RAG管线、智能体工具链及IDE插件配置中,有助于简化工程架

weixin_33951761的博客 383

[特殊字符] 别再盲目部署本地AI Agent了!你的电脑真的不配!——2026年深度硬件剖析与“骂醒式”决策指南

🔥 本地AI部署的硬件真相 这篇长文揭露了当前本地AI Agent部署热潮中的硬件陷阱,指出盲目跟风将导致严重的性能问题。文章从五个维度系统拆解了本地AI运行的真实硬件需求: 显卡是核心瓶颈:显存决定模型上限,RTX 3060 12GB仅是7B模型入门卡,13B模型需要16GB以上显存 内存需求被严重低估:16GB内存仅够7B模型勉强运行,13B模型需要32GB起步 存储性能至关重要:NVMe SSD是底线,机械硬盘会导致无法忍受的延迟 CPU作用常被忽视:需要8核以上标压处理器处理多任务调度 散热电源是

热爱技术与前沿创新,深耕科技领域,在科创中精进自我;探索技术乐趣,分享技术干货与成长心得,以技术为伴,热爱生活,在科创与生活中双向成长。 650

UCOS-III 系统移植

UCOSIII系统移植到GD32F303详细过程 工程代码:https://github.com/jslaobing/techIot_ucosiii_porting

TechIoT - 探索物联网与嵌入式系统 2088

【UOJ170】Picks loves segment tree VIII

【题目链接】 点击打开链接 【前置阅读】 【BZOJ4695】最假女选手 【BZOJ3064】【TYVJ1518】CPU监控【UOJ169】【UR #11】元旦老人与数列 【思路要点】 前置阅读中的前两题中,我们分别对线段树的区间取最大/最小值和线段树的历史最大/最小值进行了研究。本题中,两类问题同时出现,因此我们

cz_xuyixuan的博客 1264

51c大模型~合集110

为了解决这一问题,在稠密化过程中,我们对容易引起退化和梯度集中的具有极端延展率的高斯面片进行了筛选,并对其增殖过程进行了限制,从而在不牺牲性能的情况下有效稳定了训练过程,保障了优化过程的顺利进行。大规模场景的重建往往还意味着显著的训练开销,要重建 1.97 平方千米的区域会产生接近两千万的高斯点,这意味着 4.6G 的存储以及 31.5G 的显存开销,以及超过三小时的训练时长。站在 AI 研究者的角度,得到了《苦涩的教训》,意味着在总结教训的过程中明确了什么是「更好」的。第二类则瞄准了相对复杂的问题。

whaosoft~aiotの开发板商城 2604

FICO F.27 Customer statement 打印

需求,定制化打印,替换标准的F.27打印 类似于采购订单的打印,但是略有不同,查阅资料之后步骤如下: T-code F.27 is SAP standard program to produce customer/vendor correspondence (letter). Correspondence Type is used to specify the related printing program and form for the particular correspondence. SAP

IamRunjiang的博客 1969

智谱AI GLM4开源!快速上手体验

GLM-4-9B 是智谱 AI 推出的最新一代预训练模型 GLM-4 系列中的开源版本。在语义、数学、推理、代码和知识等多方面的数据集测评中,GLM-4-9B 及其人类偏好对齐的版本 GLM-4-9B-Chat 均表现出较高的性能。GLM-4-9B 模型具备了更强大的推理性能、更长的上下文处理能力、多语言、多模态和 All Tools 等突出能力。

IT大头的博客 4361

WebRTC Qos优化杂记

本文是笔者对WebRTC Qos性能研究、优化的一些思考,希望对有兴趣的读者有一些启发。

sonysuqin的专栏 6679

通俗易通解释SLAM问题的数学描述:运动方程和观测方程

高翔博士在他的《视觉SLAM十四讲》中把SLAM问题的数学描述抽象成了两个数学方程,以下对此做个总结,并且对此做一些通俗易懂的解释: 一、方程的总体形式 作为理性层次的描述,我们引入数学方程来描述SLAM过程,其中第一个方程叫做运动方程、第二个方程叫做观测方程,想象一下我们在研究SLAM的时候肯定需要观测机器人(无人汽车、无人机等都可以统称为机器人)的运动(画面感很强哈哈),这样很容易理解并且记忆这两个方程的名称和意义: 二、变量的含义 我们看到,这两个方程中有大量的英文字母作为变量存在其中,下面介绍一下

weixin_41855010的博客 7119

大模型学习路线(2025最新)从零基础入门到精通,看完这一篇就够了

以下为你详细介绍 2025 年从零基础入门到精通大模型的学习路线。

优快云_224022的博客 6023

2025年华为杯中国研究生数学建模竞赛A题 通用神经网络处理器下的核内调度问题 思路+代码

针对通用神经网络处理器下的核内调度问题,我们提出了一套基于分层优化框架的系统性解决方案。该方案首先通过缓存敏感的启发式拓扑排序算法生成最小峰值缓存占用的调度序列,在满足计算图依赖关系的前提下优先选择能够释放或减少缓存占用的节点;随后采用最佳适应算法进行精细化的缓存分配,结合LRU换出策略动态管理多级缓存空间,最小化额外数据搬运量;最后引入多目标遗传算法进行联合优化,在严格控制数据搬运量不显著增加的前提下,通过关键路径分析、流水线并行和数据预取等技术进一步优化总执行时间。

YOLO 786

ChatGLM4重磅开源! 连忙实操测试一波,效果惊艳,真的好用!

GLM-4-9B是智谱AI在24年6月5日推出的开源预训练模型,属于GLM-4系列。之前已开源chatglm1~chatglm3等多个版本。GLM4在语义理解、数学、推理、编程和知识等领域的测试中表现优异。GLM-4-9B-Chat是其人类偏好对齐版本,支持多轮对话、网页浏览、代码执行、自定义工具调用(function call)以及长文本推理(最大128K上下文)。该系列模型还支持26种语言,包括日语、韩语和德语,并推出了支持1M上下文长度(约200万中文字符)的版本。GLM-4-9B 系列模型主要包含:

2401_84206094的博客 2020

Vue3+Openlayers教程导航页【目录】

欢迎来到 Vue3+Openlayers 系列教程,这里是我在 优快云 编写的所有 Vue3+Openlayers 系列相关文章的索引页,适合初学者到进阶用户系统阅读。👀 更多教程正在持续更新中,欢迎关注我,一起探索 Openlayers 的强大魅力!

小彭的博客 1278

基于深度学习的人脸识别考勤管理系统,采用YOLOv11和Dlib算法实现人脸识别和考勤签到,前台人脸识别和签到系统 + 后台人脸和考勤管理系统,全网独发

基于深度学习的口罩人脸识别的考勤管理系统,采用YOLOv11和Dlib算法实现人脸识别和考勤签到,前台人脸识别和签到系统 + 后台人脸和考勤管理系统,全网独发

在职AI算法工程师,擅长计算机视觉,YOLO目标检测、分割等,擅长web、pyqt界面可视化,好内容持续更新中,来这里跟大家一起学习,共同进步 1829

2024最新最全【大模型学习路线规划】零基础入门到精通

目标:了解大模型的基本概念和背景。内容:人工智能演进与大模型兴起。大模型定义及通用人工智能定义。GPT模型的发展历程。目标:深入学习大模型的关键技术和工作原理。内容:算法的创新、计算能力的提升。数据的可用性与规模性、软件与工具的进步。生成式模型与大语言模型。Transformer架构解析。预训练、SFT、RLHF。目标:掌握大模型开发所需的编程基础和工具。内容:Python编程基础。Python常用库和工具。提示工程基础。目标:通过实战项目深化理论知识和提升应用能力。

m0_70486148的博客 2131

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

大模型学习路径(非常详细)零基础入门到精通,收藏这篇就够了_大模型语言的学习路径

在掌握机器学习之前,理解支撑这些算法的基本数学概念非常重要。:这是理解许多算法(特别是深度学习算法)的关键。主要概念包括向量、矩阵、行列式、特征值和特征向量、向量空间以及线性变换。:许多机器学习算法涉及到连续函数的优化,这需要理解导数、积分、极限和级数。多变量微积分以及梯度的概念也很重要。:这些知识对于理解模型如何从数据中学习并进行预测至关重要。主要概念包括概率理论、随机变量、概率分布、期望、方差、协方差、相关性、假设检验、置信区间、最大似然估计和贝叶斯推断。

HUANGXIN9898的博客 2459

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

大模型学习路线入门到精通,非常详细收藏我这一篇就够了!

理论其实就是一套描述和解决问题的方法论,只不过不同的技术有不同的方法,也就是理论。‍‍‍‍‍‍‍‍‍‍理论的发展有两种方式,一种是基于实践检验结果总结出来的经验;二种是以严谨的科学理论推导出逻辑自洽的解决某个问题的方法。‍‍‍‍‍‍‍比如说,火是人类生存和进化的重要条件之一,而在远古时期人类对于火的认知还比较浅显,因此那时关于火的理论也比较基础,比如它可以取暖,可以烤熟食物等;这就是基于经验的理论基础。‍‍‍‍。

jennycisp的博客 2513

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

打破小模型极限:Phi-4如何在推理任务中超越GPT-4 | Command R7B:小模型,大用途,企业AI的高效新选择

大模型领域的发展日新月异,每天都有许多有趣的论文值得深入品读。下面是本期的论文:1、打破小模型极限:Phi-4如何在推理任务中超越GPT-42、Command R7B:小模型,大用途,企业AI的高效新选择1、打破小模型极限:Phi-4如何在推理任务中超越GPT-4Phi-4:用高质量合成数据重新定义小模型能力Phi-4 是微软推出的最新14亿参数语言模型,专为推理任务设计。与传统模型依赖网络数据预训练不同,Phi-4 创新性地将高质量合成数据贯穿训练过程,并在关键阶段优化数据混合。

m0_59164304的博客 944

[大模型]GLM4-9B-chat Lora 微调

LoraConfig这个类中可以设置很多参数,但主要的参数没多少,简单讲一讲,感兴趣的同学可以直接看源码。task_type:模型类型:需要训练的模型层的名字,主要就是attention部分的层,不同的模型对应的层的名字不同,可以传入数组,也可以字符串,也可以正则表达式。rlora的秩,具体可以看Lora原理lora_alphaLora alaph,具体作用参见Lora原理Lora的缩放是啥嘞?当然不是r(秩),这个缩放就是, 在这个LoraConfig中缩放就是 4 倍。

FL1623863129的博客 4440
上一篇: 如何用 LangChain 实现一个Zero Shot智能决策器(附源码)
下一篇: 在 Kubernetes 上部署和管理 Ollama 模型:综合指南
少喝冰美式
博客等级 码龄3年 6847粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值