


在这篇文章中,我们将深入探讨 Transformer 的核心部分-多头注意力(Multi-head Attention)。
这个机制能让 Transformer 同时从多个角度理解数据,提高处理信息的能力和效率。
01、Transformer 中如何使用注意力机制
Transformer 在三个关键部分运用了注意力机制:
-
编码器的自注意力: 输入序列对自己进行聚焦。
-
解码器的自注意力: 目标序列对自己进行聚焦。
-
解码器的编码器 - 解码器注意力: 目标序列关注输入序列。
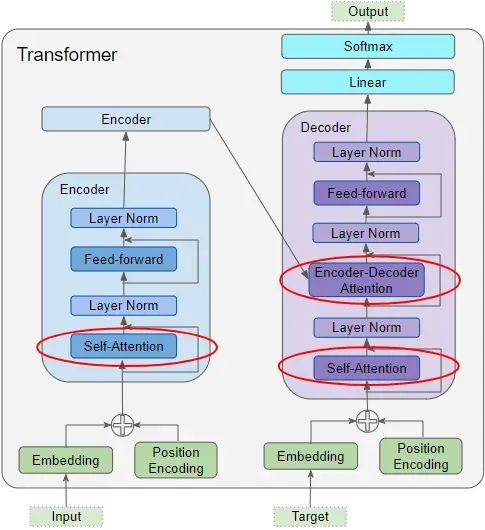
注意力机制的输入参数 —— 查询(Query),键(Key)和值(Value)
注意力层通过三个参数接收输入:查询(Query),键(Key)和值(Value)。这三个参数结构类似,序列中的每个词条都通过一个向量来表示。
(1)编码器自注意力
输入序列首先经过输入嵌入(Input Embedding)和位置编码(Position Encoding)处理,为序列中的每个词条生成了包含意义和位置信息的编码表示。
这些表示分别作为查询(Query),键(Key)和值(Value)的输入,送入第一个编码器中的自注意力模块。
自注意力模块基于这些输入,为输入序列中的每个词条生成一个新的编码表示,其中融合了相应的注意力得分。
随着序列通过编码器堆栈,每个编码器中的自注意力模块都会对词条表示进一步加入自己的注意力得分。
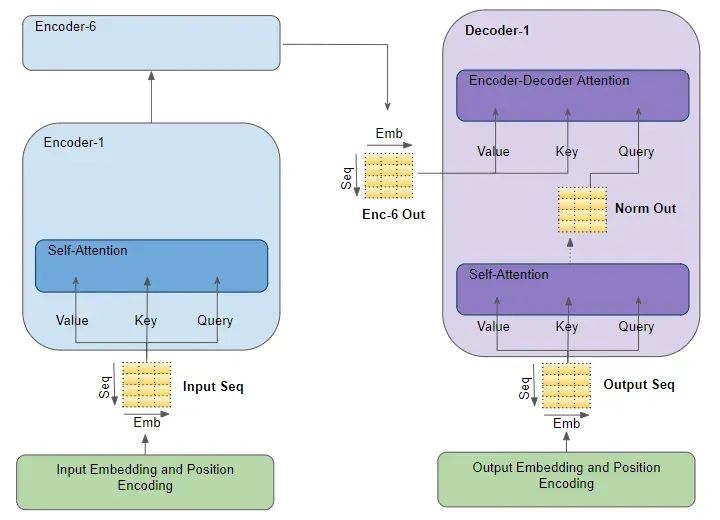
(2)解码器自注意力
在解码器部分,目标序列通过输出嵌入(Output Embedding)和位置编码(Position Encoding)处理后,为每个词生成了既包含意义又包含位置信息的编码表示。
这些表示作为查询(Query),键(Key),和值(Value)的输入,送入第一个解码器的自注意力模块中。
此模块针对目标序列中的每个词产生一个新的编码表示,其中也融入了相应的注意力得分。
通过层标准化(Layer Norm)处理后,这些表示被用作第一个解码器中的编码器 - 解码器注意力的查询(Query)参数。
(3)编码器 - 解码器注意力
同时,堆栈中最后一个编码器的输出被送入编码器 - 解码器注意力的值(Value)和键(Key)参数中。
因此,编码器 - 解码器注意力同时获得了来自解码器自注意力的目标序列表示和来自编码器堆栈的输入序列表示。
它进而产生了一种新的表示,这种表示不仅包含了目标序列每个词的注意力得分,也融合了来自输入序列的注意力得分。
随着序列通过解码器堆栈,每个自注意力和编码器 - 解码器注意力模块也会为每个词的表示增加自己的注意力得分。
02、多头注意力
在 Transformer 中,注意力模块会并行地重复进行多次计算,每一次计算都被称为一个 “注意力头”。
注意力模块将查询(Query),键(Key)和值(Value)参数分成 N 个部分,每部分独立通过一个注意力头进行处理。所有这些相似的注意力计算后来被合并,形成最终的注意力得分。
这种多头注意力机制赋予了 Transformer 强大的能力,能够对每个词条编码多种关系和细微的差别。
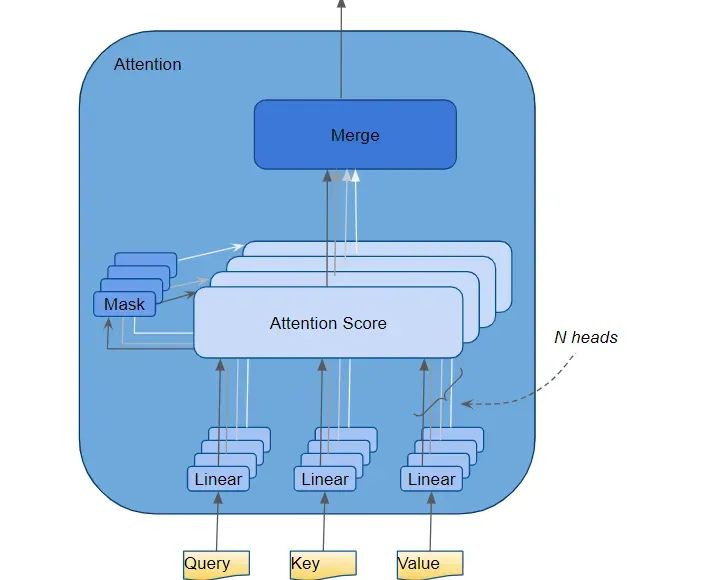
为了深入了解数据在 Transformer 内部是如何处理的,我们不妨具体看一看在训练 Transformer 进行翻译时,注意力模块是如何工作的。
以我们的训练数据中的一个样本为例,这个样本包括一个输入序列(英文的 “You are welcome”)和一个目标序列(西班牙语的 “De nada”)。
03、注意力机制的关键超参数
影响数据维度的有三个主要的超参数:
-
嵌入尺寸(Embedding Size): 这是嵌入向量的宽度,在我们的示例中为 6。这个维度在整个 Transformer 模型中保持一致,有时也被称为 “模型尺寸”。
-
查询尺寸(Query Size,与键(Key)和值(Value)的尺寸相同): 这是用于生成查询、键和值矩阵的三个线性层的权重尺寸,在我们的示例中为 3。
-
注意力头的数量: 在我们的示例中,我们使用了 2 个注意力头。
除此之外,还有一个批量大小(Batch size)参数,它表示样本的数量。
04、输入层
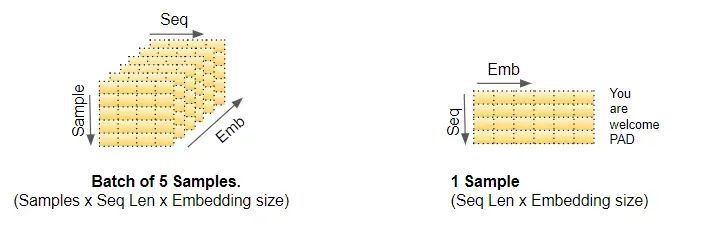
输入嵌入(Input Embedding)和位置编码(Position Encoding)层会生成一个形状为(样本数量,序列长度,嵌入尺寸)的矩阵。
这个矩阵随后被送入堆栈中第一个编码器的查询(Query),键(Key)和值(Value)。
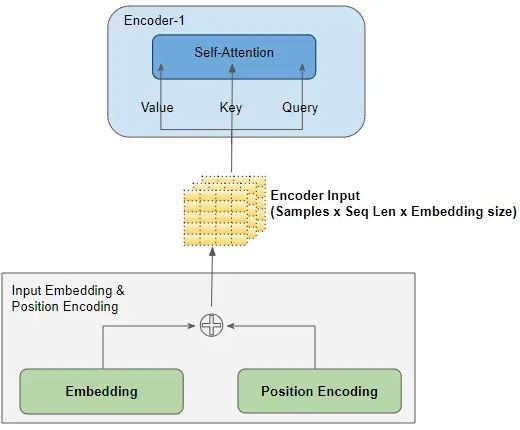
为了简化展示,我们在图示中将忽略批量尺寸,专注于其它维度。
05、线性层
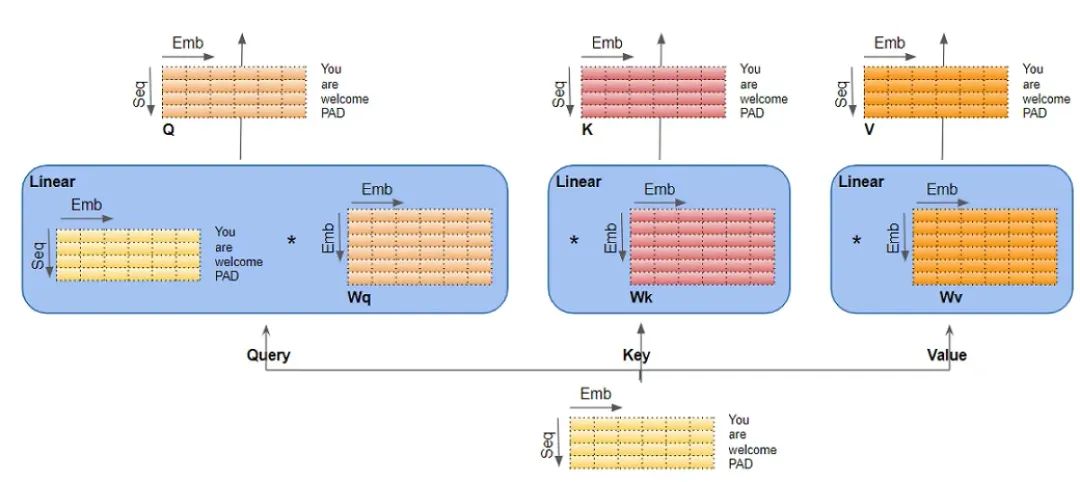
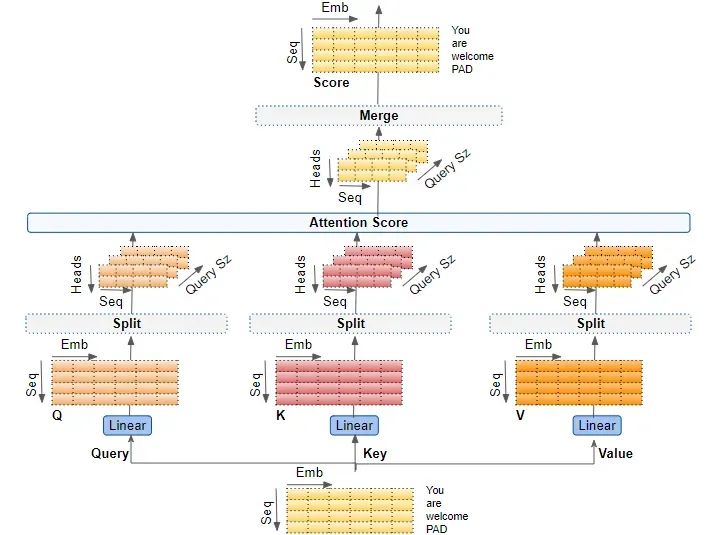
对于查询(Query),键(Key)和值(Value),有三个独立的线性层,每个层都有自己的权重。
输入数据通过这些线性层,生成 Q(查询),K(键)和 V(值)矩阵。
06、将数据分配到各个注意力头
现在,数据被分配到多个注意力头中,使每个头可以独立处理数据。
但需要理解的关键点是,这种分配只是在逻辑上进行的。查询、键和值并不会物理上分割成为每个注意力头一个的独立矩阵。
对于查询、键和值,分别使用单一的数据矩阵,其中每个注意力头逻辑上分配有矩阵的不同部分。
同样,也不存在为每个注意力头单独设置的线性层。所有的注意力头共享相同的线性层,但只操作于数据矩阵的 “各自” 的逻辑部分。
(1)按注意力头逻辑划分线性层的权重
通过在注意力头之间均匀分配输入数据和线性层权重,可以完成这种逻辑分割。
我们可以通过选择适当的查询尺寸来实现这一点:查询尺寸 = 嵌入尺寸 / 注意力头的数量。
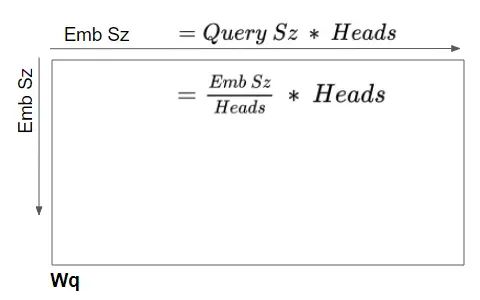
在我们的例子里,这就是为什么查询尺寸是 6 除以 2,即 3 的原因。尽管层的权重(和输入数据)是一个整体的矩阵,但我们可以想象它是每个注意力头的独立层权重 “组合在一起”。
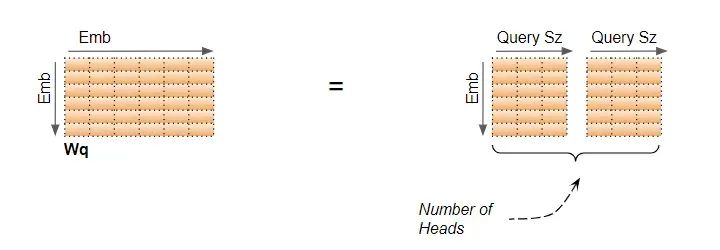
因此,所有注意力头的计算可以通过一个矩阵运算来完成,而无需多个独立的运算。
这不仅使计算更高效,还保持了模型的简洁性,因为它减少了需要的线性层的数量,同时依然实现了独立注意力头的强大功能。
(2)重塑 Q、K 和 V 矩阵
线性层输出的 Q、K 和 V 矩阵被重新整形,以包括一个明确的注意力头维度。现在,每一块 “切片” 都对应着每个头的一个矩阵。
接着,这个矩阵通过交换头维度和序列维度再次进行重塑。虽然在图示中没有表示批量维度,但 Q 的维度现在变成了(Batch、Head、Sequence、Query size)即(批量、头、序列、查询尺寸)。
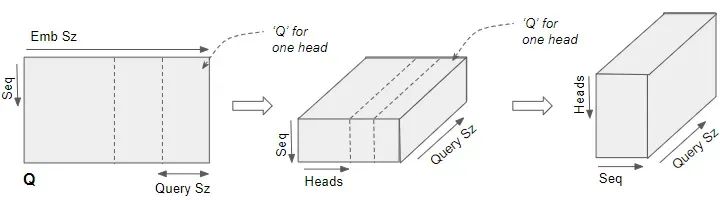
在下面的图示中,我们可以看到我们示例中的 Q 矩阵在经过线性层处理后分割的整个过程。
最后一个阶段主要用于可视化 —— 虽然 Q 矩阵是一个单一的矩阵,但我们可以将它理解为每个注意力头逻辑上分开的 Q 矩阵。
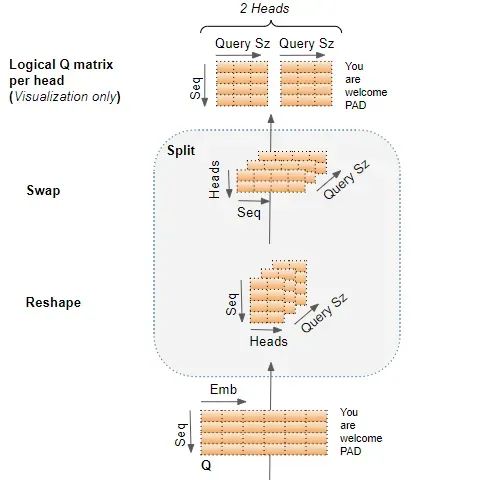
Q 矩阵划分为注意力头
现在我们可以开始计算注意力得分了。
07、为每个头计算注意力得分
目前我们有了三个矩阵:Q,K 和 V,它们分布在不同的注意力头上。这些矩阵将被用于计算注意力得分。
我们将展示单个注意力头的计算过程,这里只涉及最后两个维度(序列和查询尺寸),而忽略前两个维度(批量和头)。
从本质上讲,我们可以想象我们正在观察的计算过程在每个头和批量中的每个样本上都在进行(尽管实际上,它们是作为一个整体的矩阵操作进行的,而不是循环)。
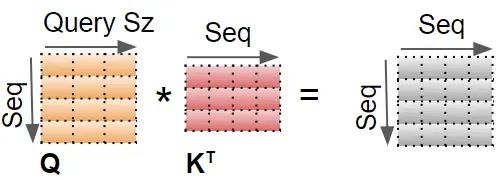
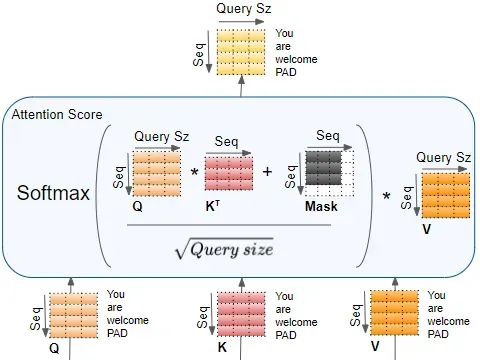
第一步是进行 Q 和 K 矩阵之间的矩阵乘法。
接着,向结果中加入一个掩码值。在编码器的自注意力机制中,这个掩码用于隐藏填充值,确保它们不参与注意力得分的计算。
在解码器的自注意力和编码器 - 解码器注意力中使用的掩码会有所不同,我们稍后将在过程中讨论这一点。
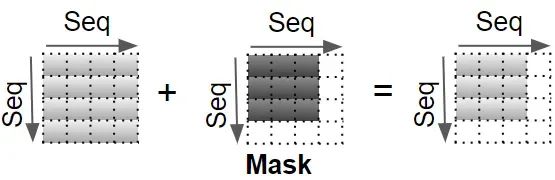
现在的结果通过除以查询尺寸的平方根来缩放,然后应用 Softmax 函数。
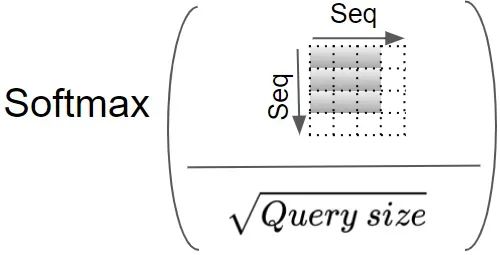
随后,进行 Softmax 输出和 V 矩阵之间的另一次矩阵乘法。
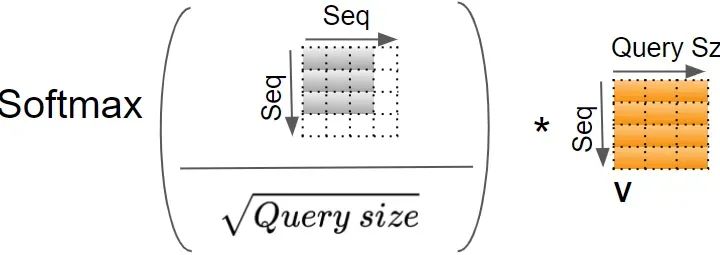
在编码器自注意力中,完整的注意力得分计算过程如下所示:
08、将每个头的注意力得分合并
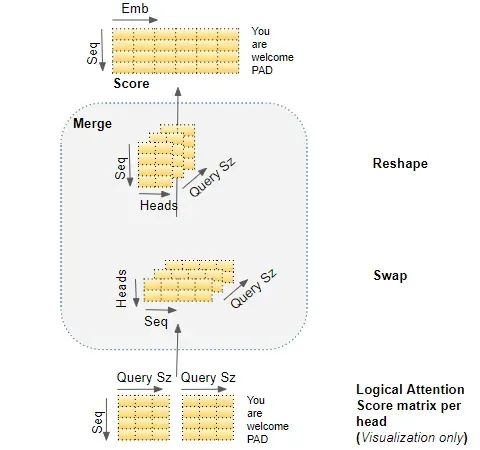
现在我们得到了每个注意力头的独立注意力得分,接下来需要将它们合并成一个统一的得分。这个合并操作实际上是分割操作的逆过程。
这个过程通过重新调整结果矩阵的形状来消除头维度。
具体步骤如下:
-
通过交换头维度和序列维度来重新调整注意力得分矩阵的形状。也就是说,矩阵的形状从(批量、头、序列、查询尺寸)转变为(批量、序列、头、查询尺寸)。
-
通过重塑为(批量、序列、头 * 查询尺寸)来折叠头维度,从而有效地将每个头的注意力得分向量串联成一个整体的注意力得分。
由于嵌入尺寸 = 头 * 查询尺寸,因此合并后的得分维度为(批量、序列、嵌入尺寸)。
在下图中,我们可以看到示例得分矩阵的合并过程:
09、端到端的多头注意力
综合这些步骤,我们得到了多头注意力机制的端到端流程。
10、多头分割促进更深层次的理解
嵌入向量用于捕捉单词的含义。在多头注意力机制中,我们看到输入(和目标)序列的嵌入向量在逻辑上分布在多个头中。这意味着什么呢?
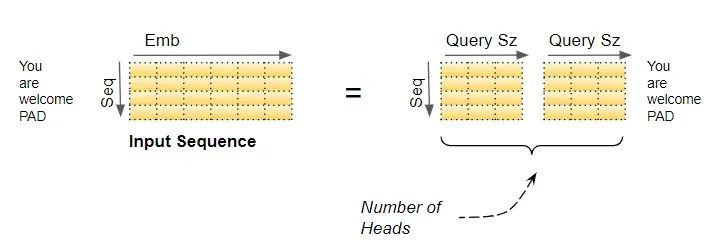
这意味着嵌入向量的不同部分可以学习每个单词的不同意义方面,尤其是它与序列中其他单词的关联。这使得 Transformer 能够更丰富、更深入地解读序列。
虽然这可能不是一个现实的例子,但它有助于我们建立一种直觉。比如说,嵌入向量的一个部分可能专注于捕捉名词的 “性别属性”(如男性、女性、中性),而另一个部分则可能关注名词的 “数目属性”(如单数与复数)。
这在翻译过程中是重要的,因为在很多语言中,动词的使用取决于这些因素。
11、解码器自注意力和掩蔽
解码器自注意力的工作原理与编码器自注意力类似,区别在于它作用于目标序列的每个单词上。
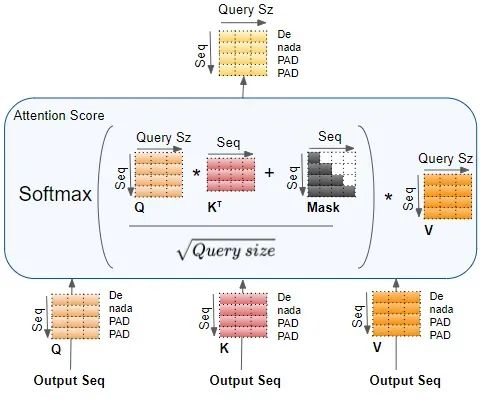
同样,掩蔽机制用于屏蔽目标序列中的填充词。
12、编码器 - 解码器注意力和掩蔽
编码器 - 解码器注意力从两个不同的来源接收输入。因此,不同于编码器自注意力仅计算输入词汇间的相互作用,以及解码器自注意力计算目标词汇间的相互作用,编码器 - 解码器注意力是计算每个目标词汇与每个输入词汇之间的相互作用。
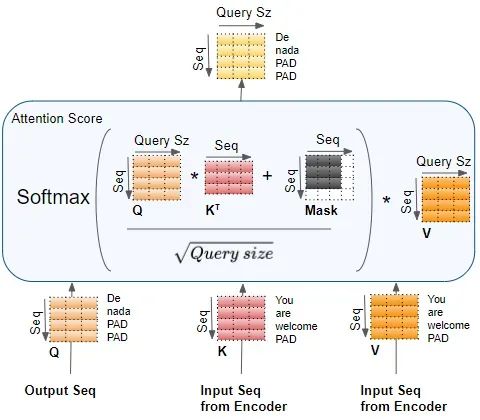
因此,在注意力得分结果中的每个单元都对应于一个 Q(即目标序列中的单词)与所有 K(即输入序列中的单词)和所有 V(即输入序列中的单词)之间的交互。
同样,掩蔽机制在目标输出中遮蔽了后续的单词,这一点在本系列的第二篇文章中已经有了详细的解释。
13、结论
希望这篇文章能帮助你对 Transformer 中注意力模块的作用有一个清晰的认识。当我们将其与前面介绍的 Transformer 的整体端到端流程结合起来时,我们就完整地理解了 Transformer 架构的详细操作。
我们现在已经明白理解了 Transformer 的功能。但我们还没有完全回答为什么 Transformer 的注意力机制会执行它所进行的计算。
为什么它要使用查询(Query),键(Key)和值(Value)这些概念,为什么它要进行我们刚才看到的矩阵乘法?
我们大致可以理解为 “它捕捉了每个单词与序列中其他单词之间的关系”,但这究竟意味着什么?它是如何使 Transformer 的注意力机制能够理解序列中每个单词的微妙之处的?
这是一个有趣的问题,一旦我们弄清楚了这个问题,我们就能真正理解 Transformer 架构的精妙之处了。
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

四、AI大模型商业化落地方案

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 6094


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


