


KGGPT
Accelerating Medical Knowledge Discovery through Automated Knowledge Graph Generation and Enrichment
摘要
知识图谱(KGs)作为组织和表示结构化知识的强大工具,广受认可。尽管它们的实用性广泛被认可,但在自动化和完整性方面仍面临挑战。尽管在自动化和利用专家创建的本体方面进行了努力,但KGs中仍然存在连接性不足的问题。为应对这些挑战,我们提出了一种创新的方法,称为“医学知识图谱自动化(M-KGA)”。M-KGA利用用户提供的医学概念,并通过BioPortal本体对其进行语义增强,从而通过集成经过预训练的嵌入增强知识图谱的完整性。我们的方法引入了两种不同的方法论来揭示知识图谱中的隐藏连接:基于集群的方法和基于节点的方法。通过对100个在电子健康记录(EHRs)中频繁出现的医学概念进行严格测试,我们的M-KGA框架显示出良好的结果,表明其有潜力解决现有知识图谱自动化技术的局限性。
https://arxiv.org/html/2405.02321v
1简介
虽然曾被视为早期人工智能(AI)研究的遗物,Smolensky(1987)知识图谱(KGs)近年来经历了显著的复兴。知识图谱作为符号AI的基础,包含有关医学、金融、商业和教育等多个领域的互联知识Zou(2020)。特别是在医学领域,KGs已经成为不可或缺的工具。
KGs相较于传统关系数据库提供了众多优势,主要源于其多样化的节点及其能够建立联系的能力。这种多功能性使其适用于从搜索引擎优化到推荐系统、知识发现和研究促进等多个应用。然而,构建KGs的过程本质上是 labor-intensive的,尤其是在复杂的医学领域,尽管其重要性深远。
KG本质上是一个多重图,其特征在于有向、带标签和多样的性质。KG的核心由事实组成,通常以三元组的形式表示Hogan et al.(2021),每个三元组由一个关系和两个节点构成。KGs由数百万到数十亿个这样的三元组组成,其聚合在信息发现、数据整合和有效管理方面具有巨大潜力。然而,特别是在医学领域,制作KGs面临着巨大的挑战,因为医学概念及其之间的关系复杂。此外,医学数据的非结构化普遍存在,进一步 complicating了KG的创建过程。
近年来,出现了多种图形创建方法,从自动化到半自动化和手动方法Hao et al.(2021)。虽然这些方法解决了一些挑战,但它们往往存在显著缺陷,例如缺乏标准化的平台或图形创建的代码,尽管提供了图形方法。此外,一些方法使用医院记录来生成节点和关系,但忽视了数据增强的潜在好处,导致图形不完整。此外,目前尚无可用于实时生成图形的有前景的技术,进一步阻碍了这一过程。
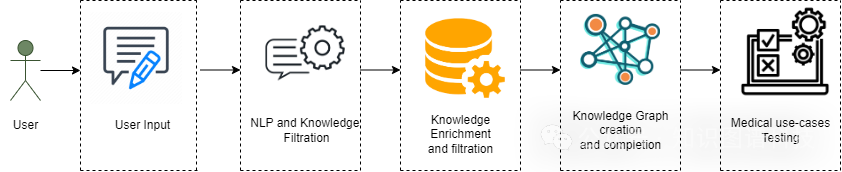 图1:提出的M-KGA框架的流程图
针对这些挑战,我们提出的医学知识图谱自动化(M-KGA)方法有效地解决了这些障碍,通过实时无缝处理结构化和非结构化数据。预处理步骤涉及基于命名实体识别(NER)的关键字提取,这些提取使用了专为科学和生物医学内容量身定制的SciSpacy库(Neumann等人,2019)。随后,知识过滤阶段消除重复和多余的术语,然后利用Neo4j的查询语言“Cypher”快速生成知识图谱。此外,我们利用Bioportal(Noy等人,2009)进行数据增强,通过整合元数据(如定义、同义词和层次结构)来在语义上丰富医学术语。在数据增强后,语义信息过滤阶段去除重复项和非英语术语,从而提高知识图谱的质量。
为了揭示医学术语之间隐含的联结和关联,我们利用了在MIMIC-III数据集上训练的预训练上下文词嵌入模型Clinical BERT(Alsentzer等人,2019)。这有助于在数据中发现有价值的见解,并有助于构建一个全面的知识图谱。我们提出了基于聚类和基于节点的比较方法,通过在知识图谱中利用Clinical BERT揭示隐藏的关系。
此外,我们提出的方法使用户能够轻松导航复杂的特征并生成自主的知识图谱。因此,用户可以根据输入数据高效生成知识图谱,消除了长时间等待的需求。此外,用户可以访问生成的文件以进行进一步的研究和分析。最终,通过我们的方法发现隐藏的连接,帮助临床医生更深入地理解患者症状。同时,它也帮助保险公司识别欺诈性索赔和审查不准确的医疗编码预测。
关于医疗保健领域机器学习的可推广洞见
总之,我们的研究做出了以下贡献:
\1. 提出了一个重要的方法来自动化构建医学知识图谱,称为医学知识图谱自动化(M-KGA)。
\2. 利用基于节点和基于聚类的比较进行知识图谱补全。
\3. 进行严格的评估,以证明我们技术的效率及其所生成的知识图谱。
此外,本文的结构如下:第二节讨论了医学及其他领域中的知识图谱自动化相关工作。第三节介绍了创建知识图谱的 proposed methodology。第四节描述了在多个医疗用例上进行的结果和评估。最后,在第五节中,我们全面呈现了局限性、未来方向和结论。
2相关工作
在过去几年中,许多知识图谱自动化技术在生活的各个方面出现,包括商业、医疗、金融和教育。大多数技术都是针对特定用例和问题提出的。考虑到其多样性、规模、速度和真实性,医疗行业的知识图谱创建比其他行业困难得多。此外,知识图谱补全方法虽然是通过使用机器学习评估大量数据来发现相关连接的有价值工具,但却很少被利用。除了这些限制之外,目前没有任何平台可以用来为医疗行业的任何细分领域提供自动化的完整知识图谱。
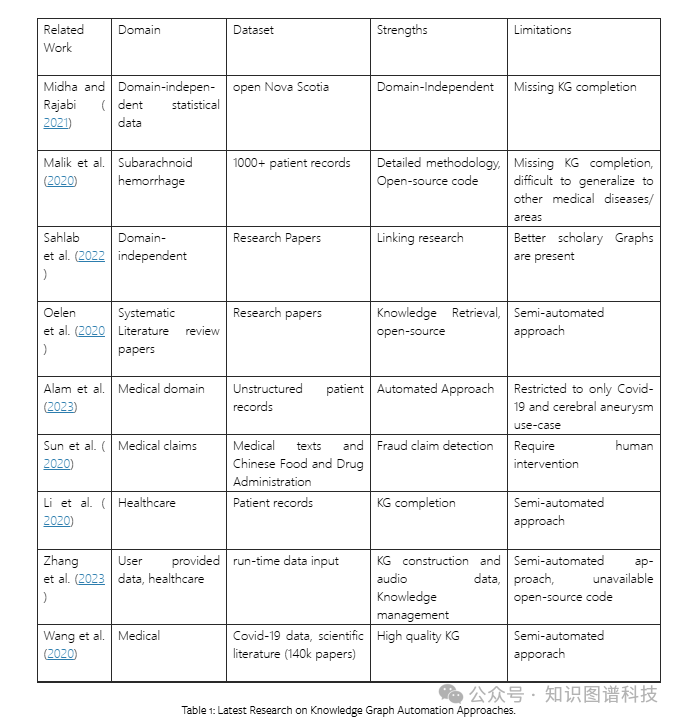
一些图自动化系统的有趣应用案例包括系统文献综述 Sahlab 等 (2022),其中从 IEEExplore、ACM、Springer Link、Wiley 和 ScienceDirect 等电子数据库中收集研究文章数据。利用这些数据,构建了一个知识图谱,从而通过提供更好的文章推荐来帮助系统文献综述。尽管链接研究数据的概念是合理的,但所提供的方法似乎未能产生特别有效的结果,因为可能很难确定论文的研究重点和内容。此外,已经存在更有效的知识图谱用于此目的,如 Hi-知识图谱、Microsoft Academic Graph、Papers with Code 图谱、Cooperation Databank 等。类似的方法涉及从综合文献综述中提取信息并将其纳入开放研究知识图谱平台作为知识图谱 Oelen 等 (2020)。在这种半自动化方法中,表格被用作数据源,从单个表格行生成多个三元组。这些创建的图谱不仅在医学领域中有用;它们也可能有助于在各个领域的事实发现。
医学知识图谱是使用多种方法构建的,包括人类、半自动和自动方法,以及现代和传统程序。一个重要的半自动图谱生成程序的例子是利用科学文献和现有数据集制作的 COVID-19 图谱 Wang 等 (2020)。采用分层球面嵌入、本体增强文本嵌入和跨媒体语义结构表示来进行证据挖掘、假设排名和关系提取。还设计了一种生成报告和回答查询的机制。最终的知识图谱包含 7,230 种疾病、9,123 种化学物质和 50,864 个基因。包括 1,725,518 种化学-基因关系、5,556,670 种化学-疾病关联和 77,844,574 种基因-疾病连接。
Midha 和 Rajabi (2021) 描述了从统计数据半自动创建知识图谱的四个步骤。这些过程包括数据收集/获取、知识提取、知识融合和知识存储。利用 DOID、Geonames、DBpedia 和其他资源,除了图谱创建外,还为公开可用的统计数据集创建了本体。数据没有限制在任何一个领域,并进行了大量的连接工作,以生成能够应用于高级数据分析的最终知识。作者提出的研究是创新的,但由于他们使用的数据来自多个领域,可能还有无数其他研究方向可供探索。尽管他们没有使用 KG Meddings 模型进行事实发现,但统计数据可以产生一些有趣的发现。由于其他数百人将能够检查相关数据并获取用于自己工作的图谱,研究人员应将其作为开源代码发布。
另一种创建医疗知识图谱的方法是可用的;它由八个模块组成,并利用3,767,198名患者的16,217,270条去标识临床就诊数据半自动地生成知识图 Li et al.(2020)。其中的过程包括实体识别、实体规范化、关系提取、属性计算、图清理、相关实体排名和图嵌入。为了在医疗图中存储额外的上下文,采用四元组形式代替传统的三元组。最终结果是一个包含22,508个实体和579,094个四元组的医疗知识图,具有九种不同的实体类型。
知识图谱在医学、诊断和信息获取等许多不同的背景中都很有用。另一个重要的应用案例是欺诈索赔的检测;保险公司聘请多名医疗编码员来确认索赔。为了使用中国医疗知识图识别欺诈索赔,开发了一个欺诈、浪费和滥用(FWA)检测系统 Sun et al.(2020)。在实体通过基于深度学习的技术提取后,图是在半自动的方式下创建的,人工干预用于确认图的合法性。关于疾病的信息来自医疗文本和药品标签,这些标签从中国食品药品监督管理局收集而来。最终图具有1,616,549个节点和5,963,444个关系,在检测欺诈索赔方面的准确率为70%。
由于文本数据占所有可用数据的近80%,知识图通常针对文本数据设计。半自动知识图谱构建与应用(SAKA)Zhang et al.(2023)是为知识图谱生成创建的一个引人入胜的用例。它使用听觉和结构化数据来创建图。语音活动检测(VAD)、说话人分离(SD)和医疗信息提取器(MIE)模型是音频基础的知识图谱信息提取(AGIE)技术中提取实体的方法。除了构建图之外,还创建了一个系统来接收用户查询并提取相关数据。知识管理模块持续验证数据的实时性和相关性。在LibriSpeech、VoxCeleb和医患对话数据集上测试该方法取得了可观的表现。
某一医疗领域的医学知识图谱实例:“蛛网膜下腔出血”涉及使用超过一千个病例记录 Malik et al.(2020)。通过利用适当的Bioportal本体增强医疗实体。图谱生成过程涉及多个层次,包括语义知识层、统计知识层、预测知识层和知识工厂层。尽管将源代码用于其他医学领域比较困难,但它是公开的。虽然看似切换本体会使其在其他背景下可行,但研究表明这并不简单,因为蛛网膜下腔的用例需要进行词嵌入的训练等工作。作者在此案例中也忽视了知识图谱完成任务,这可以帮助建立多个发现的链接。针对循证医学等用例开发了一种不同的自动化方法(Alam, 2023)。基于同行评审的本体,KG被自动构建用于脑动脉瘤和COVID-19。为了创建和完成图,使用了基于机器学习的聚类模型。此外,还使用了深度学习技术,如RNN、BioBERT等。结果在COVID和动脉瘤数据集上的准确率分别为93%和82%。
文献表明,大多数方法以手动或半自动的方式描述知识图谱创建过程。它们大多数是针对特定用例和医学领域量身定制的,且很少包含知识图谱完成技术,这可以利用大数据的潜力发掘事实。尽管生成的知识图在许多方面确实有用,但不能普遍应用。此外,目前没有平台能够处理用户请求,以验证特定用例并在几分钟或几秒内创建合适的知识图谱。我们的方法提供自动化,在于使用专家创作的本体生成一个完整和全面的知识图谱,同时满足用户对特定知识图谱生成的请求。人们可以在多种领域受益于这种方法,而我们的方法生成的知识图可以用于增强他人的研究。
3方式
我们提出的方法分为多个步骤。图2说明了医疗知识图谱自动化(M-KGA)的整个工作流程。该方法以两种格式获取数据:结构化和非结构化。然后应用各种自然语言处理(NLP)技术来处理这些数据。最初,使用Bioportal来识别和增强医学概念的语义信息。获取的数据被过滤并用于在知识图(KG)中创建节点及其关系。利用预训练的上下文单词嵌入模型Clinical BERT来发现KG补全的隐藏连接。最后,生成一个Cypher查询文件以便在Neo4j中创建KG。每个阶段的详细信息列在下面。
3.1用户输入
M-KGA技术允许用户以两种不同格式输入医疗数据:结构化和非结构化。当我们说“结构化”时,我们意味着用户精确地定义医疗术语。数据不包含任何相互关联的概念。以下是以结构化方式组织的文本示例:
Structured Input Example:
[‘fever’, ‘diarrhea’, ‘insomnia’, ’severe acute respiratory syndrome’, ‘diabetes’]
非结构化文本则是自由自然语言文本,易于人类理解但对计算机来说则不然。这是由医疗专业人员为患者诊断所写的文本,非结构化文本的一个例子是:
无结构输入示例:
如果你有一种叫做多尿的情况,那是因为你的身体产生的尿液比正常更多。成年人通常每天产生大约3升尿液。但如果是多尿的话,你每天可能产生多达15升尿液。这是糖尿病的一个经典标志。
开发的代码可以接受这两种格式的数据;如果需要结构化文本,它会多次询问数据。如果需要非结构化格式的文本,它会一次性接受所有内容并自行找出概念。
3.2基于NLP的知识过滤
我们提出了两种基于自然语言处理的知识过滤方法,包括 i) 基于命名实体识别的关键词提取和 ii) 知识过滤。基于命名实体识别的关键词提取旨在从非结构化文本中识别医学概念,并转化为结构化格式。随后,关键知识过滤过程用于过滤从前一步骤获得的最重要信息。每个过程将在下文中全面展示:
3.2.1基于实体识别的关键词提取
提供一个非结构化文档作为输入,以利用基于NER的关键词功能提取临床实体列表。这个过程对于填充医学知识图谱的节点至关重要,使得多种医学实体(如疾病、治疗和其他临床概念)的纳入成为可能。我们利用了SciSpacy库Alsentzer等(2019),这是一个针对科学和生物医学文本的流行spaCy自然语言处理框架的专业扩展。具体而言,该功能加载了en_core_sci_sm模型,旨在优化生物医学文本的处理。
基于NER的关键词提取功能需要非结构化的临床文本作为输入,因此临床概念将作为输出被提取。此外,该方法随后利用生物医学模型处理文本并提取临床实体,返回一个可以无缝集成到不断发展的医学知识图谱中的列表。
3.2.2知识过滤
随后,获取临床或医学概念的列表时,将应用知识过滤功能,只选择相关和突出的概念。之前提取的概念可能包含一些冗余。知识过滤通过模糊匹配查找数据中的重复项,并进一步过滤。此外,知识过滤还帮助医疗实践在决策时建立一个综合知识图谱,通过包含和排除某些概念来实现。在基于命名实体识别的关键字提取过程中提取的概念可能与当前问题、疾病诊断或治疗无关。通过将这些词映射到生物门户本体,进一步进行了过滤。
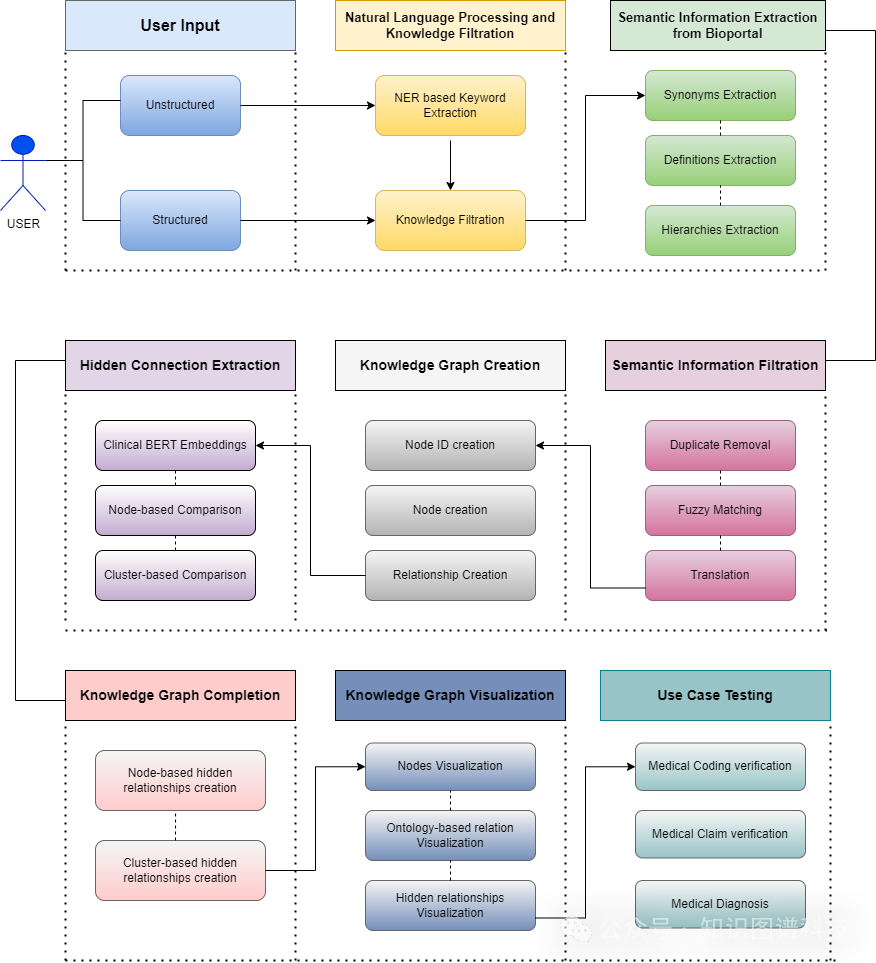 图2:医学知识图谱自动化方法(M-KGA)
3.3语义信息提取
经过组织、增强和筛选的材料用于语义信息提取步骤。将这些术语映射到专家创建的Bioportal本体Noy等人(2009)允许您使用Bioportal REST API检索语义丰富的信息。我们方法的优势在于M-KGA并不专属于任何特定的医疗条件或疾病。相反,它试图在不受特定本体限制的情况下丰富数据。
从本体中检索到不同种类的语义丰富信息。同义词是与被映射术语具有相同含义的单词、短语或语素。定义:一组提供更长描述的术语或短语,该描述指的是被映射的术语。在这个过程中,进行了两种类型的提取,下面展示了这一点。
3.3.1Semantic Knowledge Filtration 语义知识过滤
由于我们的方法不限于特定的医疗状况或问题 M-KGA 预计数据的多样性 变异性和冗余性非常高 在这一步骤中 通过多种技术过滤经过语义增强的数据 该方法试图将多种语言的数据翻译成英语 消除检索数据中的重复项 然后使用模糊匹配进一步过滤结果
3.3.2Translation:翻译
用于丰富阶段的数据是多语言的,来自许多本体。为了翻译这些材料,我们探索了图书馆。我们需要采取这一措施,因为如果没有翻译,我们将失去一些重要信息。我们确定的非英语文本被翻译成英语;如果语言无法识别或存在任何例外,则该文本将被删除。随后的阶段不包括这一删除部分。由于非英语文本无法在任何后续步骤中使用,因此已被移除。用于发现隐藏联系的预训练模型无法理解这些数据,这将导致问题。此外,这一步将解决Neo4j对Cypher节点ID创建施加的限制。
3.3.3Duplicate Removal: 去重
此步骤从前一阶段获取增强的数据,并尝试去除重复项。由于我们从1000多个Bioportal本体中提取数据,因此可能会出现大量的重复。在此步骤中,我们使用了语义信息,将所有同义词和定义改为小写,然后在Python中使用简单的集合操作来删除冗余项。
3.3.4Fuzzy Matching: 模糊匹配
重复删除过程的扩展是模糊匹配。某些增强数据可能包含语义上可比较的文本,这些文本无法通过设定程序进行删除。为了保持内容的唯一性,我们采用了这一策略。这也解决了ID创建阶段的问题,并在语言上重复项的移除方面提供了极大的帮助。
3.4知识图谱构建
创建知识图谱是一项具有挑战性的工作,因为在创建节点和交互时需要极其谨慎。知识图谱是用Neo4j的Cypher查询语言开发的。该格式有独特的限制。在Cypher中,节点ID应以字母而不是数字、特殊字符或非英语短语等开头。考虑到这些因素,我们制作了图形。以下步骤将对此进行进一步说明。
3.4.1Node ID creation: 创建节点ID
节点ID的开发是基于这样一种理解:节点之间必须建立数以百计的连接——包括隐藏的连接和本体提供的连接。我们通过遵循不同KG格式的ID要求,将节点内容或丰富数据转换为ID,以减少ID检索比较和连接形成所需的计算资源。正如之前所述,Cpyher中的节点ID仅接受英文格式的数据;不允许使用特殊字符等。通过这种方法,关于多尿的丰富数据被转换为如“excessive secretion of urine”的ID,这源于“excessive secretion of urine”的定义。因此,每当我们需要建立连接时,就不必再去寻找与该节点连接的ID。我们只需应用我们的功能,将内容转换为ID。
3.4.2Node Creation: 创建节点
此步骤根据之前概述的 ID 创建技术构建结构化和非结构化(转换为结构化)数据的节点,以及语义丰富的数据。已经创建了不同种类的节点。同义词、医学概念、定义等属于这些类别。根据其类型,图中的每个节点用不同的颜色表示。节点显示内容。所有知识图谱节点在此步骤中构建。
3.4.3Relationship/ Connection creation: 关系/连接创建
此步骤根据专家提供的或本体提供的连接来连接不同节点。每次迭代都会创建一个具有语义丰富性的节点,该步骤使用ID创建连接,并将节点与主要医学概念连接。所有语义丰富的数据也是如此。在这里,关系也有不同类型,例如同义词、定义等。关系是带标签和有方向的。
3.5隐藏链接提取
早期的过程收集用户数据,对其进行过滤,从专家产生的本体中获得丰富的数据,并生成知识图谱。除了专家提供的链接,我们的方法还寻找本体中缺失的隐性连接。这些本体提供了更丰富的医学术语,但可能很难确定这些概念是否相互关联。是否存在可以忽略的连接以改善医学数据的分析?我们制作了知识图谱,但我们如何才能完善它们?
为了解决这些问题,我们尝试使用KG嵌入来实现我们的方法,该方法可以根据KG三元组预测链接。然而,这些方法对于小型图谱并不有效。我们的方法可以根据用户请求创建大型和小型KG;然而,KG嵌入无法在小型网络上发挥作用,因为这些模型需要数千个三元组。因此,为了建立连接,我们利用词嵌入来确定一个词的含义及其与其他词的关系。值得强调的是,我们的方法寻求与其他医学概念及其丰富内容的连接,而不是试图与其语义丰富的节点建立连接,因为这些节点已经是互相连接的。
3.5.1Clinical BERT Embeddings:临床BERT嵌入:
我们利用Clinical BERT嵌入提取医学概念及其上下文元数据的向量表示。我们使用Clinical BERT嵌入,这些嵌入是在一个大型医学语料库上训练的,而不是创建我们自己的模型。医学信息市场重症监护III(MIMIC-III)用于训练模型。我们利用它们的预训练特性和开源特性来理解医学概念及其相互关系。我们计算了不同术语之间的相似度,并根据距离和用户定义的阈值构建了关系,从而实现知识图谱的补全。
3.5.2Cluster-based Comparison: 基于集群的比较
我们提供了两种方法来定位知识图谱中埋藏的链接。我们将每个医学概念及其语义丰富的数据视为一个集群,采用基于集群的方法。利用所有可用的语义信息,我们写了一段文字,然后使用临床BERT模型寻找嵌入。临床BERT的实现不可扩展,并且在大集群上引入了错误。为了改进此方法,我们将段落分割成若干块,处理例外情况,为每个块获取嵌入,然后再除以块的总数。集群根据用户定义的阈值与其他集群进行映射。阈值以及用户对特定或一般连接的要求程度是这里的关键因素。实际上,阈值是集群之间的分隔。为了确定集群之间是否存在强关系,用户可以选择低阈值。基于集群的比较或连接能够快速且低计算成本地实现知识图谱的补全。这一步引入了名为“embedding_match_cluster”的进一步关系在知识图谱中。图3是基于集群比较方法的一个例子。

图3:基于集群的医疗诊断用例比较
3.5.3Node-based Comparison:基于节点的比较
与基于聚类的方法相比,基于节点的技术寻找与聚类中其他节点的连接。使用词嵌入,这种方法将单个节点与每个聚类的节点进行比较。节点上缺乏大量的文本意味着可扩展性不是问题。此外,该方法需要大约 n2 的时间,并且计算成本较高,而与基于聚类的方法相比。由于基于节点的技术允许我们确定链接的准确匹配,因此更容易理解。在这里,连接也是根据用户指定的阈值建立的。根据图的大小,连接节点需要几分钟的时间。图 4 显示了该方法的结果描述。这在知识图中添加了名为“embedding_match_node”的关系。
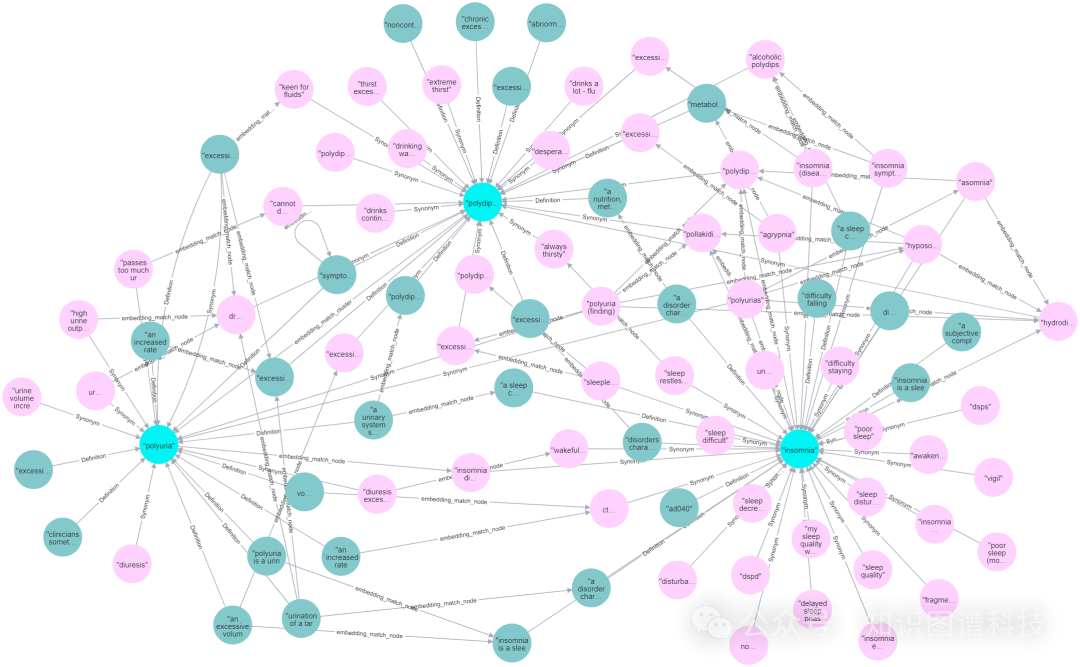 图4:基于节点的医疗诊断用例比较
3.6Use case Testing 用例测试
为了确定我们方法的有效性,我们进行了三个独立的用例分析。选定的三个用例是医疗索赔、医疗诊断和医疗编码。我们使用了名为CodiEsp的西班牙数据集来测试每一个用例。专家为CodiEsp数据添加了ICD-10代码。为了测试我们的策略,我们使用了出院总结及其注释。
3.6.1Medical coding and Claim verification: 医学编码和索赔审核
我们使用了几个摘要、医学术语和相关的医学编码。我们在将医学编码转换为描述后提取了描述中包含的医学术语。然后,我们使用了我们的医学知识图谱自动化技术(M-KGA)来查看将所有医学概念(例如出院总结或诊断编码描述)处理后产生的结果。我们在测试中使用了真正的阳性和真正的阴性案例。我们取出了摘要,对其注释应用了我们的方法,再次用虚构示例对摘要进行了注释,并重新测试了该方法。该方法通过可视化展示了它的有效性,并在所有情况下均证明令人满意。我们还进行了各种阈值的实验。
3.6.2Medical Diagnosis: 医学诊疗
我们还使用CodiEsp数据测试了这种医疗诊断方法。每个医疗摘要的知识图谱是利用从摘要中提取的概念构建的,这一过程使用了基于命名实体识别的关键词提取阶段。我们应用了基于节点和基于聚类的比较,并生成了一个完整的知识图谱。我们假设摘要中包含的任何医学观点都必须彼此相关;这种关系将确认我们的方法在补全图谱方面的有效性,并提供对从本体中提取的关系更深刻的理解。通过我们的基于节点和基于聚类的比较技术,该策略在所有实验中显示出显著性,并且大多数在同一摘要内的医学术语生成了链接。为了更好地理解该方法的运作,我们还对其进行了负例测试。
4Evaluation 评估
在本节中,我们展示了从实施和测试我们提出的医学知识图谱自动化(M-KGA)方法中获得的结果。评估旨在评估M-KGA在从用户提供的医学概念构建综合知识图谱方面的有效性和效率。我们使用一组100个不同的医学概念进行了实验,以评估我们的方法在医疗领域各个领域的性能。
在我们的评估中,我们将这100个医学概念分为两组:50个用于评估基于聚类的比较方法,另外50个用于评估基于节点的比较方法。每组进行了配对,利用GPT-3.5模型创建医学概念的对。这些配对被编制成Excel文件,以供人类医学专家进行注释。专家的任务是根据真实阳性(TP)、假阳性(FP)、真实阴性(TN)和假阴性(FN)等指标对每对进行注释,为我们方法的准确性和性能提供宝贵的见解。
在注释过程结束后,我们对医学概念对应用了基于聚类和基于节点的比较方法,阈值=4。利用这些方法,我们为每对构建了知识图谱,并分析它们是否成功识别出专家注释的连接。考虑到传统本体在某些医学概念之间通常难以找到连接,我们的目标是确定我们的方法是否能够发现可能会被忽视的隐藏连接。该分析旨在确认我们提出的方法在增强现有知识和揭示医学领域中之前未被识别的关系方面的有效性。
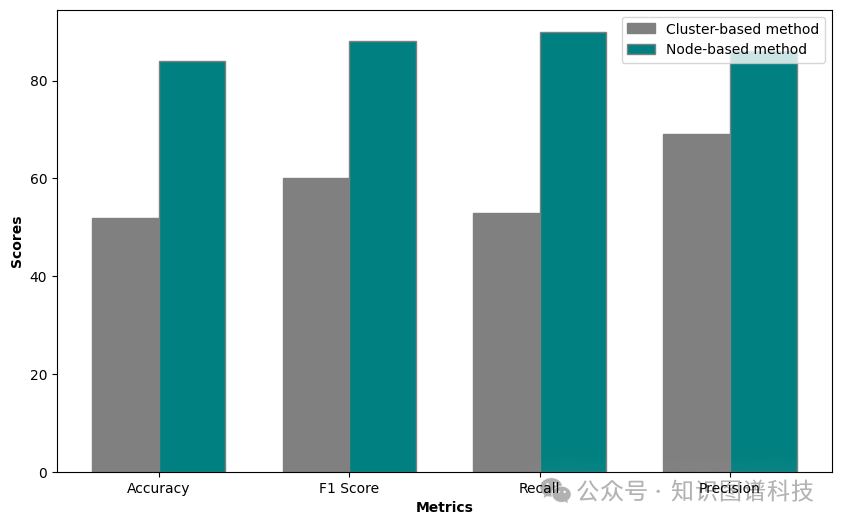 图5:基于节点的医疗诊断用例比较
在图5中,使用真正例(TP)、假正例(FP)、真负例(TN)和假负例(FN)构建的度量指标被呈现。我们的分析集中于基于这些指标评估准确性、F1得分、召回率和精确度。图中展示的比较突出节点基础和集群基础方法之间的性能差异。值得注意的是,节点基础方法显然是领先者,与集群基础方法相比,显示出显著更高的准确性、F1得分、召回率和精确度。这一观察强调了节点基础方法在准确捕捉知识图谱内连接方面的有效性,最终在所有评估的指标中表现优越。
观察到的基于聚类方法在准确性、F1分数、召回率和精准度方面的局限性可以归因于临床BERT的使用。虽然临床BERT是一个强大的预训练模型,但其有效性受到计算资源和样本大小限制等实际因素的制约。由于知识图谱中聚类的规模庞大,因此需要将其划分为更小、可管理的部分进行处理。然而,这种分割引入了一个挑战:在多个部分之间丧失了上下文的一致性。因此,从碎片化的聚类中得出的嵌入可能缺乏准确表示和推理所需的整体上下文,导致性能指标下降。这一现象强调了在设计和实施知识图谱构建方法时考虑预训练模型的能力和局限性的重要性。
除了评估措施之外 透明度和时间是评估M-KGA方法有效性的关键因素 如图3和图4所示 透明度指的是构建的知识图谱的清晰度和可理解性 基于节点的方法在透明度方面表现出色 通过在节点之间建立直接的连接 从而呈现出清晰且直观的关系表示 相比之下 基于聚类的方法可能显示出较少的透明度 因为它倾向于增加较少的关系 导致连接的描述不够明确
另一方面,时间涉及知识图谱构建过程的效率。基于聚类的方法在时间效率方面具有优势,相比于基于节点的方法,所需的计算资源和处理时间更少。然而,这种效率是有代价的,因为基于聚类的方法可能会牺牲之前讨论过的性能指标,例如准确性、F1分数、召回率和精确度。
总体而言,尽管基于集群的方法提供了更快的构建过程,但可能会妨碍透明性和性能。相反,基于节点的方法优先考虑透明性和性能,尽管代价是增加了计算复杂性和时间消耗。因此,在基于知识图谱应用的具体要求和优先事项之间,应该仔细考虑这两种方法的选择。
5结论和未来的工作
最终,本研究介绍了医疗知识图谱自动化(M-KGA)方法,旨在解决与自动构建知识图谱(KGs)及提升其完整性相关的挑战。M-KGA利用用户提供的医学概念和BioPortal本体,使用预训练嵌入丰富知识图谱的语义内容,从而促进更全面的结构化医学知识的表征。我们的方法结合了两种不同的技术,即基于聚类的方法和基于节点的方法,以揭示知识图谱中的隐藏关联。
通过对100个医学概念进行严格测试,我们的M-KGA框架显示出可喜的结果,展现了其克服现有知识图谱自动化技术局限性的潜力。本研究中提出的性能指标和图形可视化强调了我们的方法在提高知识图谱透明度和准确性方面的有效性,特别是在医学领域。
展望未来,后续工作将集中于解决与基于聚类的方法相关的可扩展性问题,旨在改善其性能。此外,我们计划探索与大型语言模型(LLMs)结合的检索增强生成(RAG)方法,用于知识图谱的开发以及与我们当前方法的性能比较。通过不断创新和完善我们的方法,我们旨在进一步推动知识图谱自动化领域的发展,为医疗领域更全面和准确的结构化知识表征做出贡献。
References
- Accelerating Medical Knowledge Discovery through Automated Knowledge Graph Generation and Enrichment (arxiv.org)、https://arxiv.org/html/2405.02321v
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

四、AI大模型商业化落地方案

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 262


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


