


1. 语音合成任务简介
1.1. 语音与文本
对比语音来说,NLP 技术在深度学习中更为普及。在介绍语音合成任务前,我们先来了解语音这一模态的特点,并将其与文本模态对比。
| 文本模态 | 语音模态 | |
|---|---|---|
| 表现方式 | 表示为离散的 token 序列 | 表示为连续值的序列 |
| 序列长度 | 短序列,例如每个句子 10-20 词 | 极长序列,如每句话 3s,16k 采样率,则每句话由 48000 个连续值的序列表示 |
| 信息密度 | 高度抽象,几乎每个词都包含语义信息,因此信息密度较高 | 信息密度极低,因此有短时不变性,可以从一个片段推测相邻片段的信号 |
语音 vs 文本:
- 语音是自然语言的超集,理想中的语音既包含自然语言中完整的文本内容(语义信息),也包含语音特有的音色、语气、韵律、情感等声学信息;
- 观察二者对比可以发现,语音中的总体信息多于文本,但信息密度极低,序列过长;
- 此外,语音用连续值表示,因此语音合成是回归任务,而非语言模型的分类任务。
回归任务,是对连续值进行预测(比如多少); 分类任务,是对离散值进行预测(比如是不是,属不属于,或者属于哪一类)
几个特点,使得 NLP 中的常用方法难以用于语音合成:1. 对于极长序列,难以使用自回归策略以及 seq2seq 的生成方案(并非不行,但效率低。梯度问题计算复杂度问题、内存问题等);
自回归模型(AutoRegressive Model,简称 AR 模型)是一种用于时间序列数据的统计模型。你可以想象它像是用过去的数据来预测未来的一种方法。自回归模型的核心思想是:今天的股票价格可能与昨天、前天甚至更早的价格有关。这个模型会尝试找出这种时间上的联系,确定它们之间的关系强度,并用这种关系来预测下一个时间点的价格。
- seq2seq解读 Seq2Seq(Sequence-to-Sequence)是一种神经网络架构,它用于处理序列到序列的任务,往往包括编码器和解码器两个部分:
- 编码器(Encoder):它的作用是读取并理解输入序列,将序列中的信息编码成一个固定大小的上下文向量(或称为隐藏状态)。这个向量旨在捕获输入数据的关键特征。
- 解码器(Decoder):它的作用是将编码器产生的上下文向量转换成输出序列。解码器逐步生成输出序列,每次生成序列的一个元素(比如一个词或一个字符),而且每次生成的同时会考虑前一次生成的元素
- 由于语音合成是回归任务,语言模型中许多常用的技术无法应用,而回归任务也比分类任务的稳定性更低。
1.2. 语音合成任务
在语音合成的相关任务中,我们主要关注文本语音合成(Text-to-Speech Synthesis, TTS),该任务旨在给定一段文本,合成与文本对应的语音。根据上文中的分析可以发现,从文本到语音的合成会面对三个问题:
- 长度差异大,语音信号长度是文本序列的上千倍,难以跨越这么大的长度差异,直接从文本合成语音;
- 模态差异大,主要是信息含量不同,文本中只包含语义信息,而语音包含语义信息和丰富的声学信息;
- 生成任务困难,基于回归任务的生成通常难于分类任务。基于前面的问题,TTS 任务难以实现端到端的合成,因此主流的 TTS 方法通常使用 pipeline 框架,使用声学特征作为中间表征,将模型分为三部分。
具体地,常见的 TTS 模型分为文本分析(Text Analysis), 声学模型(Acoustic Model)和声码器(Vocoder):
-
文本分析模块:
-
- 该模块主要负责将输入文本从字素 (Grapheme) 转为音素(Phoneme),音素是发音的最小单元,类似拼音或音标,是比文字本身更适合语音合成的输入形式;
- 此外,该模块还经常负责韵律、音调以及中文的分词等任务;
- 该模块被称作 TTS 的前端,并不是 TTS pipeline 的重点。
-
声学模型 (Acoustic Model, AM):
-
该模块主要负责通过音素预测 TTS 的中间表征,中间表征一般是某种手工声学特征,例如最常用的梅尔频谱 (Mel-Spectrogram, 后称 Mels) ;
梅尔频谱(Mel Spectrogram)是语音信号处理中常用的一种特征表示方式,它基于人类听觉感知的梅尔尺度(Mel Scale)来对频谱进行分析和编码。可以简单理解为将一段语音信号做一个编码
- 以 Mels 为例,如果每秒语音所对应的音素长度为 10,Mels 长度通常为 100-200,长度差异约为 1 + 个数量级,在可接受范围内;
- 声学模型主要对合成语音的语义质量负责,即决定合成出的语音是否符合输入文本,此外,语音中的情感、韵律等也现象也主要与声学模型有关。
- 声码器:
- 该模块主要负责将 Mels 等中间表征还原为音频,该模块主要决定合成语音的音质;
- 例如,在 16k 采样率下,声码器会将 100 + 长度的 Mels 还原为 16k 长度的语音,跨越约 2 个数量级;
- Vocoder 的训练不需要文本作为输入,因此可以使用 audio-only 的训练数据;但是,由于声学模型的预测 Mels 通常与真实 Mels 的特征空间存在差异,实际使用中需要将 vocoder 在 AM 的输出上 finetune 一遍效果才比较好,此时依然需要利用成对的文本 - 语音数据。
2. 主流声学模型介绍
接下来简单介绍一下当前主流的声学模型,不展开讲,只用来分析当前存在的问题
2.1. Tacotron (2017)
Tacotron 是比较早期的深度 TTS 模型了,介绍它主要是介绍一下自回归的 AM(Amplitude Modulation,幅度调制)思路,模型结构如下:
调制,就是把需要传递的信号,添加到载波上面,让载波包含需要传递的信息的特征,从而表达出信息。

- Tacotron 直接从文本生成 Mels,省去了前端转音素的步骤,而且使用了基于传统方法的声码器,在这个角度上算是 end-to-end 的语音合成;不过为了保证效果,需要使用更好的声码器,此时仍然是 pipeline;
- tacotron 的主体结构是一个 seq2seq 的模型,中间有一个 attention 模块负责对齐 mels 和文本,生成部分由一个 RNN 负责,RNN 每次同时生成 mels 中的若干帧,直到预测出全 0 向量停止;
- tacotron 的生成质量并不差,但问题是自回归太慢了,即使一次生成若干帧也很慢。
优化思路:
-
基于问题 1,最优解是找到合适的 end-to-end 生成方式,但当前的 end-to-end 策略都存在各种问题,尚待优化;退而求其次,可以放弃 Mels 这种传统特征,优化中间表征;
-
结合问题 1 和 2,不难想到,可以考虑将 TTS 的中间表征离散化:
-
- 将中间表征离散化,AM 的任务变为预测中间表征 tokens,此时是分类任务,任务难度更低、更稳定,且可以利用现有的 NLP 技术经验;
- 中间表征离散化后,可以保证 AM 的预测结果不会出现特征空间上的偏差,减小了 pipeline 的传播误差,vocoder finetune 的必要性降低,一方面简化工作量,另一方面也让 vocoder 可以利用更多 audio-only 数据;
- 作为习得的中间表征,效率和稳定性高于 Mels 等传统特征。
1.为什么需要离散化:在某些 TTS 系统的设计中,例如使用基于分类器的声码器(如 WaveNet),中间表征的离散化可以帮助模型更有效地学习和生成声音。离散化的声学特征可以作为分类任务的目标,而分类任务通常比回归任务更容易处理。此外,离散化的表征也可以减少信息的维度,简化学习过程,并有时能提高生成语音的稳定性和质量。
3. 中间表征的离散化
3.1. 语音预训练中的离散化
3.1.1. Wav2vec2.0
Wav2Vec 2.0 利用原始音频波形直接学习有用的特征表示,并且在训练中不依赖于标注的数据。这样,它能够在资源较少的语言或应用场景中大幅减小对标注数据的需求。Wav2Vec 2.0 模型的关键特点包括:
- Wav2vec2.0 的训练任务是 mask 帧的特征预测,训练目标基于对比学习,mask 帧的真实特征为正例,相邻帧的特征为负例;
- 对比损失:Wav2Vec 2.0 使用对比损失(contrastive loss)来区分掩码位置的真实音频表示和一系列负样本(其他错误的表示)。这一策略迫使模型学习区分和识别真实的特征表示。
3.1.2. HuBERT
3.2. 音频编码解码器 (Audio Codec)
上述几个模型利用离散化的语音表征,作为模型预训练过程的一部分,虽然没有直接将这些离散化的表征作为最终的特征, 但利用这些表征增加了预训练的效率和稳定性。那么,这些表征能否直接用于 TTS 呢?应该是不能的:1. 上述模型只做了基于上下文预测的预训练任务,因此,表征中主要是与上下文相关的语义信息;2. 相应地,这些表征中缺乏足够支持将特征还原为原始语音信号的声学信息。接下来将介绍另一种离散化的音频表征,这些表征来自音频编码解码器 (Audio Codec):
- Audio Codec 的基本任务是将一段音频压缩为向量或其他表征,并且根据这些表征可以还原音频——该任务本身类似 Auto Encoder, 但有两个重点,一是需要尽可能节约中间表征的比特数,达到低资源应用的目的,二是需要尽可能忠实地还原出原本的音频;
- 当前主流方法:
- 同样利用离散化的 codebook 获得离散 tokens,离散 tokens 对应的中间表征作为压缩后的表征;
- 对于每个离散 token,可以用一个整数 (或 one-hot 向量,等价) 表示,此时对于 N 大小的 codebook,只需要 logN 的比特数即可记录,压缩效率较高。
codebook 起到了一个量化器的作用,它包含了一组离散的向量,每个向量我们可以称之为一个 “码字”(codeword)
1.生成码字:在模型的训练阶段,会学习到一个 codebook,这个 codebook 包含了多个码字,每个码字都是潜在表示空间中的一个点。
2.编码过程:当有新的数据输入时,模型会先将其映射到潜在空间的连续表示。然后,这个连续表示会被映射到 codebook 中最近的码字上,这样就完成了从连续到离散的转换。
3.获取离散 tokens:通过将连续表示映射到最近的码字,模型实际上是在选择一个与之最相匹配的离散 token。这个离散 token 相当于是码字在 codebook 中的索引。
3.3. SoundStream
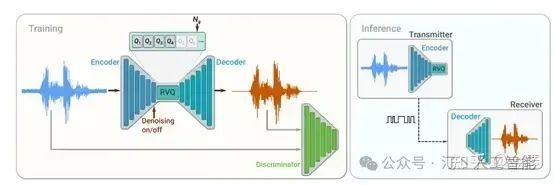
SoundStream 是目前性能较好的主流 Audio Codec 之一,其结构分为 Encoder、Vector Quantizer、Decoder 三部分:
- Encoder / Decoder 使用常规的卷积层和反卷积层,不详细介绍;
- Vector Quantizer 是该模型重点,具体细节不再介绍,主要是利用一些方法平衡了 codebook 编码和资源如何高效利用的一个问题。
3. 语音合成的步骤
3.1. 步骤 1:语素(文本)转音素
【Motivation】是不是可以直接用拼写作为模型的输入?如果是单词拼写与读音一致的语言(如拉丁语)这是可行的,但可惜大部分语言是不可行的,看下面的例子:
- though (和 go 里面的 o 类似)
- through (和 too 里面的 oo 类似)
- cough (和 offer 里面的 off 类似)
- rough (和 suffer 里面的的 uff 类似)即使有相同的拼写,但发音却完全不同。
如果 TTS 系统使用拼写作为其主要输入,会不可避免地会陷入困境。因此,需要使用稍微不同的表达方式,展示出更多的发音信息。音素正是这样的一样东西,我们发出来的声音由不同音素单位组成,将因素组合在一起,我们几乎可以重复发出任何单词的发音。比如:
- White Room - [W,AY1, T, ., R, UW1, M,.]
- Crossroads - [K,R, AO1, S, R, OW2, D, Z, .]上述例子源自于 CMU 的音素字典, 其中,音素旁边的 1,2 等数字表示应该发重音的位置,句号表示音间停顿。
【ProblemDescription】因此,语素转音素成为了步骤 1 的科学问题,具体如下:
- Input -“It was earky spring”
- Output -[IH1, T, ., W, AA1, Z, ., ER1, L, IY0, ., S, P, R, IH1, NG,.]
【Solutions】在大多数情况下,通过查询标准音素字典(比如 CMU 的音素字典),可以得到与输入文本一一对应的标签。数据形式如下:
- Input(X - 逐字的)[“It”, “was”,“early”, “spring”]
- 标签(Y)[[IH1, T, .],[W, AA1, Z, .], [ER1, L, IY0, .], [S, P, R, IH1, NG, .]]
对于音素字典里没有包含的新词,吴恩达在百度带领团队开发的 Deep Voice 系统,基于神经网络建立了一个回退机制来预测音素。
3.2. 步骤 2:预测持续时间
【Motivation】有了音素后,还需要估计在说话时,这些音素的发音时间。这也是一个有趣的问题,因为音素应该基于上下文来决定它们或长或短的持续时间。拿下面围绕音素 “AH N” 的单词举例:
- Unforgettable
- Fun 相比第二个单词,“AH N” 显然需要在第一个单词里发更长的发音时间。
【ProblemDescription】预测持续时间的问题描述如下:·
- Input -[IH1, T, ., W, AA1, Z, ., ER1, L, IY0, ., S, P, R, IH1, NG,.]
- Output -[IH1 (0.1s), T(0.05s),. (0.01s),…]
【Solutions】
可以利用训练系统做到这一点,能够理解每个音素,并预测它们的发音时长。一种有效的方法是使用分割模型,它将每个音素发声的场景进行匹配,从而获取其对应的音频分割片段和其在音频中的发声位置。
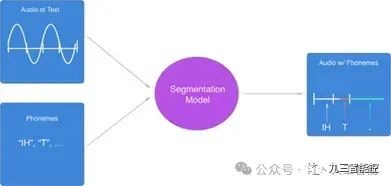
分割模型真正有趣的部分在于其预测的不是每个独立音素的位置,而实际是预测了每组音素对的位置。因为对独立单个的音素而言,给定语音对应某个音素的概率在语音的发声正中最大;而对成对的音素而言,概率最大值出现在两个音素交界点上,可以轻易的检测出两个音素发声的交界点,因此,使用音素对可以更简单地进行定位。
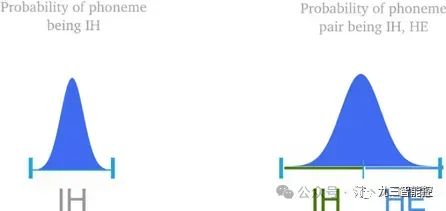
此外,这种模式是无监督的,因为我们事实上无法知道语音片段中语素对应的真正位置的标签信息。分割模型通过 CTC loss 模型来训练。数据形式如下:
- Input(X)“It was early spring” 的音频剪辑对应的音素 [IH1, T, ., W, AA1, Z, ., ER1, L, IY0, ., S, P, R, IH1, NG, .]
- Outputs(Y)音素对和它们在音频中的起始时间[(IH1, T, 0:00), (T, ., 0:01), (., W,0:02), (W, AA1, 0:025), (NG, ., 0:035)]
3.3. 步骤 3:基频预测
【Motivation】
为了让发音尽可能地接近人声,还需要预测出每个音素的音调和语调。这一点从多方面考量,对以汉语为代表的语言尤为重要,因为这些语言中,相同的声音,读出不同的音调和重音具有完全不同的含义。预测每个音素的基频有助于发好每一个音素,因为频率会告诉系统,什么音素该发什么音高和什么音调。此外,一些音素并不完全都发浊音,这意味着发这些音不需要每次都震动声带。例如,拿发音 “ssss” 和“zzzz”做例子,注意到前者是清音 (unvoiced),发音时声带没有振动,而后者是浊音 (voiced) ,发音时声带振动了。
【ProblemDescription】
基频预测的问题描述如下:
- Input -[IH1, T, ., W, AA1, Z, ., ER1, L, IY0, ., S, P, ., R, Ih1, NG,.]
- Output -[IH1(140hz),T(142hz),. (Not voiced),…]
【Solutions】
基于步骤 2 中的分割模型不仅可以得到音素的持续时间数据对,也可以得到音素的基频数据对,将这些数据对作为训练数据,就可以通过模型训练来预测新音素的数据。
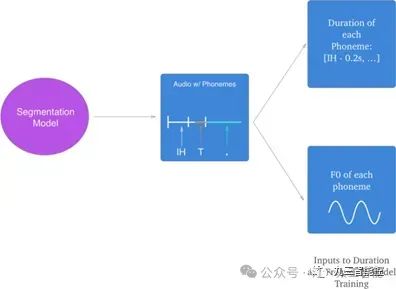
训练数据形式如下:
- Input(X)音素:[IH1, T,., W, AA1, Z, ., ER1, L, IY0, ., S, P, R, IH1, NG, .]
标签(Y)每个音素的持续时间和基频,通过分割模型获取:[(IH, 0.05s, 140 hz), (T, 0.07s, 141 hz), … ]
3.4. 步骤 4:音频合成
【Motivation】
生成语音的最后一步是,合并音素、持续时间和频率,输出声音。
【ProblemDescription】音频合成的问题描述如下:
- Input -[IH1(140hz,0.5s), T(142hz, 0.1s),. (Not voiced, 0.2s), W(140hz, 0.3s), …]
- Output - 录音
【Solutions】
直观的解决方案就是将之前的预测结果进行组合,合并音素、持续时间和频率,并转化成原始波形,输出声音。
这个过程现在也可以基于训练模型进行训练,以达到高度的声音还原,比如百度的 Deep Voice 和谷歌的 WaveNet。基于上述方法生成的原始波形,允许生成所有类型的声音,不同的口音、情绪、呼吸和人类语音的其他基本部分都能包含在内,这样的声音和人类的声音区别就非常小了。
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

四、AI大模型商业化落地方案

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 7175


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


