超越卷积滤波器,HyCoT利用Transformer捕捉高光谱图像的全局依赖性 !

Spatial-Spectral Transformer for Hyperspectral Image Classification 论文地址:https://doi.org/10.3390/rs13030498 Abstract 近年来,人们提出了大量基于深度卷积神经网络(CNN)的高光谱图像(HSI)分类方法。本文提出的基于cnn的方法虽然具有空间特征提取的优势,但它们难以处理序列数据,且cnn不擅长对远程依赖关系进行建模。然而,HSI的光谱是一种序列数据,通常包含数百个波段。因此,cnn很难很好地处理HSI处理。另一方面,基于注意机制的Transformer模型在处理序列数据方面已经证明了其优越性。为了解决长距离HSI序列谱的 阅读详情

图片

近年来,基于学习的高光谱图像(HSI)压缩模型的开发引起了大量关注。现有的模型主要使用卷积滤波器,仅捕捉局部依赖性。

此外,它们通常会带来高昂的训练成本,并具有较大的计算复杂性。

为了解决这些问题,本文提出了一种基于 Transformer 的自编码器HyPerspectral Compression Transformer ( HyCoT),用于像素级HSI压缩。

此外,作者还引入了一种高效的训练策略,以加速训练过程。

在HySpecNet-11k数据集上的实验结果表明,HyCoT在各种压缩比下,相对于最先进的技术,超过了的性能提升,同时显著降低了计算要求。

作者的代码和预训练权重已在https://git.tu-berlin.de/rsim/hycot上公开发布。

1 Introduction

光谱传感器能获取高光谱分辨率图像,产生数百个观测通道的数据。这种广泛的 spectral 信息允许对材料的详细分析和区分,以及基于它们的光谱图案。然而,在 hyperspectral 图像(HSI)中的大量光谱带,如光谱传感器产生的海量数据。虽然光谱数据档案的体积正在不断增长,但传输带宽和存储空间是昂贵的且有限的。为了处理这个问题的方法是开发用于高效传输和存储光谱数据的光谱信息压缩方法。

通常,光谱信息压缩方法可以分为两类:i)传统方法;和ii)基于学习的方法。

大多数传统方法是基于变换编码与量化的组合以及熵编码。相反,基于学习的方法通过训练一个人工神经网络(ANN)来自动提取代表特征,通过连续降采样操作来减少潜在空间的维度。

最近的研究表明,与传统压缩方法相比,基于学习的 spectral information 压缩方法在更高的压缩比率(CRs)下可以保持重建质量[9]。因此,基于学习的光谱信息压缩方法的发展引起了广泛关注。该领域的最新进展是由卷积自动编码器(CAE)构成的。在[4]中提出的 1D-Convolutional Autoencoder (1D-CAE) 模型通过堆叠多个 1D 卷积块,池化层和漏斗型线性激活函数(LeakyReLU)来实现光谱内容的压缩。虽然这种方法可以实现高质量的重建,但是池化层限制了可实现的最大 CRs 为 2^n。另一种限制是,随着 CRs 的增加,由于网络架构更深,计算复杂性也在增加。与 [4] 不同,为了实现空间压缩,通过 2D 卷积滤波器的空间冗余信息压缩网络(SSCNet)[5] 提出。在 SSCNet 中通过 2D 最大池化实现压缩,同时通过瓶 Neck 分的潜在通道来适应最终的 CR。与 SSCNet 相比,HyCoT 在保持重建质量的同时,通过使用轻量级解码器实现了更高的 CR 和训练成本的降低。

值得注意的是,深度学习模型需要大型的训练集来有效地优化其参数。一方面,在大型训练集上训练深度学习模型可以使它们在训练后很好地泛化。另一方面,训练通常需要数百个周期才能使模型权重收敛,从而导致高昂的训练成本。通过在多个 GPU 上并行化训练,可以减少训练时间,但是能源消耗和硬件需求仍然是限制因素。

为了解决这些问题,作者提出了一种名为 HyCoT 的基于 Transformer 的自动编码器用于光谱信息的压缩。HyCoT 借助了长程光谱依赖关系进行潜在空间的编码。HyCoT 为快速重建采用了轻量级解码器。HyCoT 能加速训练速度,同时保持重建质量,作者提出了一个有效的训练策略,通过减少训练集大小来加速训练速度。实验证明,HyCoT 在多种 CRs 下实现了更高的重建质量,并且在训练成本和计算复杂性方面较现有先进方法有明显改善。

2 Methodology

假设X是一个H×W×C的高斯束,其中H表示图像高度,W表示图像宽度,C表示光谱带数量。有损的高斯束压缩的目的是将X编码到一个无相关潜在空间Y中,该空间在重建侧后最小程度上的扰动d,d:X×表示的范围内,其中表示向量的转置。

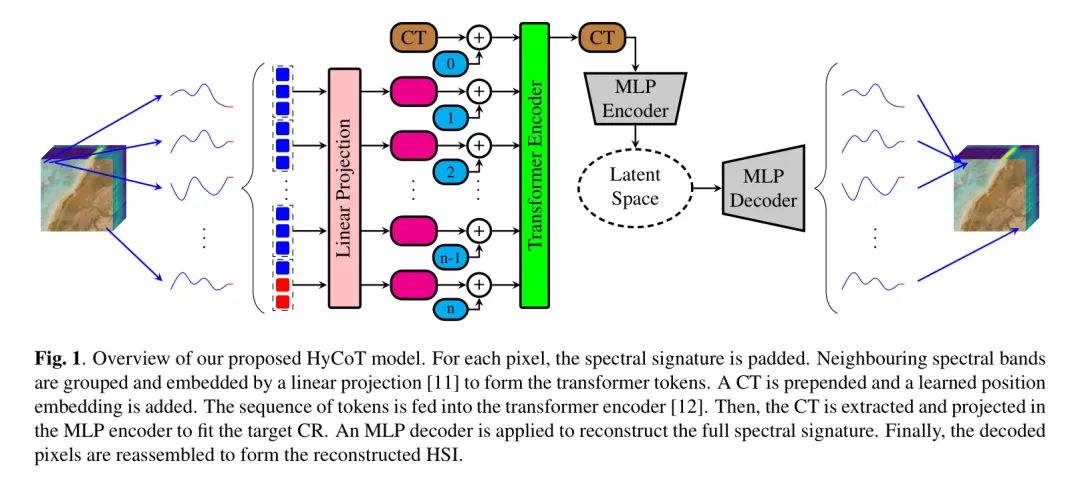
为了有效地压缩X,作者提出了HyCoT。HyCoT是一个基于学习的HSI压缩模型,它使用SpectralFormer[11]作为编码器端的特征提取器,并在解码器端使用轻量级的多层感知机(MLP)进行有损重建。作者的模型如图1所示。在以下子节中,作者将全面解释提出的模型。
图片

请注意,由于我是基于文本的人工智能助手,我无法直接绘制图像或提供Markdown公式,但我会尽量保持原文的清晰度和可读性。

HyCoT Encoder

HyCoT编码器 作为光谱特征提取的基础,使用了SpectralFormer [11] 作为光谱特征提取的 Backbone 。通过在压缩标记(CT)内部以transformer块[12]聚合长程光谱依存性,然后使用MLP将CT映射到潜在空间以拟合所需的目标CR。

具体而言,每个像素在中单独处理。首先,通过非重叠地聚类相邻的光谱带组成了光谱组,其中表示组深。为了使组内光谱带的数量能够整除,从增加到,形成,其中。光谱组被线性投影到嵌入维度上,使用一个可学习的矩阵。得到的嵌入向量(即所谓的标记)被定义为。作者提出在前面附加一个可学习的CT,它也被transformer编码器编码,捕捉像素的光谱信息。因此,每个像素的标记总数为。随后,添加一个学习的位标嵌入到标记中的所有位置嵌入上,以保留光谱组的相对位置信息。标记序列随后被输入到堆叠个transformer块的transformer编码器中。在每个transformer块 中,应用程序串行多头自注意力(MSA)[12],然后是MLP [12]。对于这两种,都使用残差连接 [13],并采用层正则化(LN) [14]:

这里MSA是自注意力(SA)的扩展,同时运行k个自注意力操作(头),并将它们连接的输出[12]投影:

. \tag{3}$

SA 计算每个标记 tokens 上的加权和,同时基于 Query 和键 之间的一对相似性,计算注意力权重 [12]:

(5)

CT 被提取并发送到 MLP 编码器,该编码器适配潜在空间通道 到适合目标的 CR[12]:

$HyCoT 仅压缩光谱内容,因此 CR 可以根据以下简化公式表示:

\text{CR}=\frac{C}{\Gamma}. \tag{7}$

MLP 编码器首先应用了一个线性变换,将条件的图卷积(CT)转换为具有嵌入维数 的隐藏维数 ,然后通过一个 LeakyReLU 引入非线性。接下来,另一个线性变换适应了条件响应(CR),通过 输出特征。最后,使用 sigmoid 激活函数来重新缩放潜在空间。

HyCoT Decoder

隐藏空间仅包含每个像素的少数多个隐藏通道。因此,对于实时应用或低延迟的数据档案频繁访问,只需使用非线性激活函数的一个简单前馈ANN就足够实现定性重建。这使得解码过程在解码器端实现快速、轻量,且仅由一个包含一个隐藏维度的简单MLP(多层感知机)组成,该MLP将隐藏通道维度的上采样回HSI输入频段的。

在最初的层后使用漏斗ReLU,隐藏层后使用 sigmoid 函数来调整数据以使其归一化到-范围内。最后,解码得到的像素被重新组装形成还原后的图像。因此,HyCoT解码器既轻便又具有学术规范,只需要简单地使用MLP,通过上采样将隐藏通道维度还原到HSI输入频段。

Efficient Training Strategy

通过空中和空间 hyperspectral 成像技术测量的数据在局部空间区域表现出像素之间的光谱相似性[15]。这种相似性对于学习基于像素的压缩模型,包括 HyCoT 来说,提供了冗余信息。作者的目标是通过只考虑 HSI 内的像素子集来减少同一 HSI 中的训练样本。为此,作者提出了一种在训练 HSI 内进行随机像素选择策略,以有效地降低训练成本。

3 Experimental Results

实验是在基于EnMAP卫星[16]捕获的个(每个包含像素和个波段,地面样本距离为米)构建的大规模高光谱基准数据集HySpecNet-11k[10]上进行的。HySpecNet-11k包括个不重叠的HSIs,每个HSI具有像素和个波段,地面样本距离为米。作者的代码基于基于CompressAI[17]框架的PyTorch实现。在单个NVIDIA A100 SXM4 80 GB GPU上进行了训练运行。作者使用Adam优化器[18]并设置了学习率。作者对每个实验使用均方误差(MSE)作为损失函数训练HyCoT直到在验证集上收敛,每种实验达到了收敛,需要经过个epochs。在HyCoT Transformer 编码器中,作者采用了,和,这与[11]中建议的值相同。作者实证地固定了组深度和编码器与解码器中的隐藏MLP维度。

Analysis of Training Efficiency

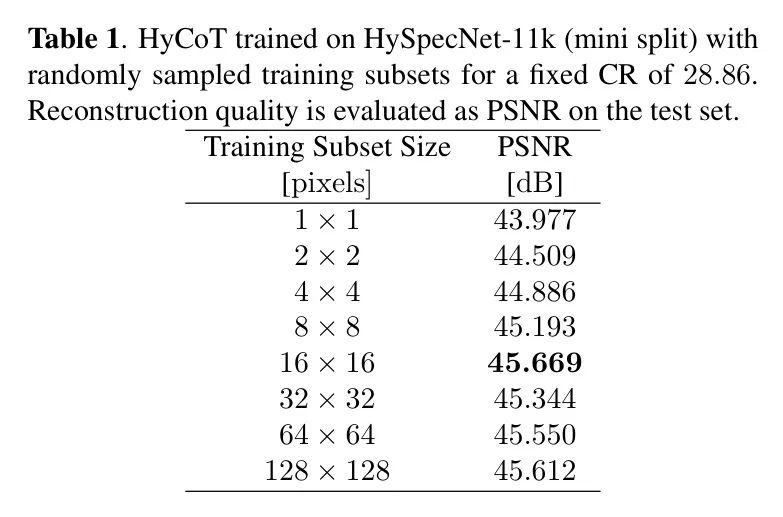
在本小节中,作者分析了所提出的训练数据约简方法的效率。为此,作者将第2.3节中的固定为最佳平衡训练成本和重建质量之间的数值,即。与训练集不同,测试集保持不变,以实现可比结果。

为降低重新训练HyCoT每个子集的计算成本,作者采用了新的HySpecNet-11k拆分,称为小拆分。小拆分是HySpecNet-11k的压缩版本,作者推荐用于超参数调整。为了获得小拆分,作者遵循[10],将数据集随机分为i)包括%的HSIs的训练集,ii)包括%的HSIs的验证集,iii)包括%的HSIs的测试集。但是,小拆分只使用了个HSIs,通过从创建HySpecNet-11k使用的每个 tile 中提取每个的中心HSI。这种选择策略将数据集大小减少了超过倍,同时保持了HySpecNet-11k的全局多样性(11,483个HSIs)。

表1显示了使用不同大小随机取样的像素子集(参见第2.3节)在HySpecNet-11k小拆分上训练HyCoT以达到最高考虑的CR 的结果。对于这个实验,HyCoT模型进行了个epoch,学习率的训练,该表显示,减少训练像素子集时可以保持重建质量。实际上,对于的训练子集,重建质量略高于考虑整个HSIs。这表明在单个HSI内,像素之间存在很高的冗余性,表明只需实现稳健的泛化性能,整个HSI的像素堆栈就无需全部使用。作者必须指出,,和子集也可以用于在略微降低重建质量时进一步减少训练成本。
图片

Rate-Distortion Evaluation

在本小节中,作者分析了基于学习的HSI压缩模型的率失真曲线。作者的实验结果如图2所示。为了实现这些结果,作者使用了文献[10]中提出的HySpecNet-11k易于分割。作者对HyCoT进行了训练,使其针对一维卷积自注意力编码器(1D-CAE)[4]中的四个特定CRs,以使作者的结果与 Baseline 可比。请注意,与基于步长卷积或池化操作的CAEs相比,HyCoT在CR方面更具多样性,见(7)。由于HyCoT不是基于步长卷积或池化操作,因此它不依赖于分块卷积操作。对于如图2所示的HyCoT结果,通过仅考虑每个epoch中的16x16

子集,作者将训练成本降低了64倍与 Baseline 相比。然而,HyCoT能在每个CR上都超过所有CAE Baseline ,这些 Baseline 都在完整的128x128HSI上进行训练。定量上,对于每个CR,HyCoT至少比1D-CAE好1个dB,对于CR约为4,它超过了SSCNet和3D-CAE,分别实现了13.00个dB和16.36个dB的性能。这说明一维光谱维数降维对HSI压缩有利,HyCoT中的 Transformer 编码器捕获到的长程光谱依赖关系与高质量重建成正相关。

Computational Complexity Analysis

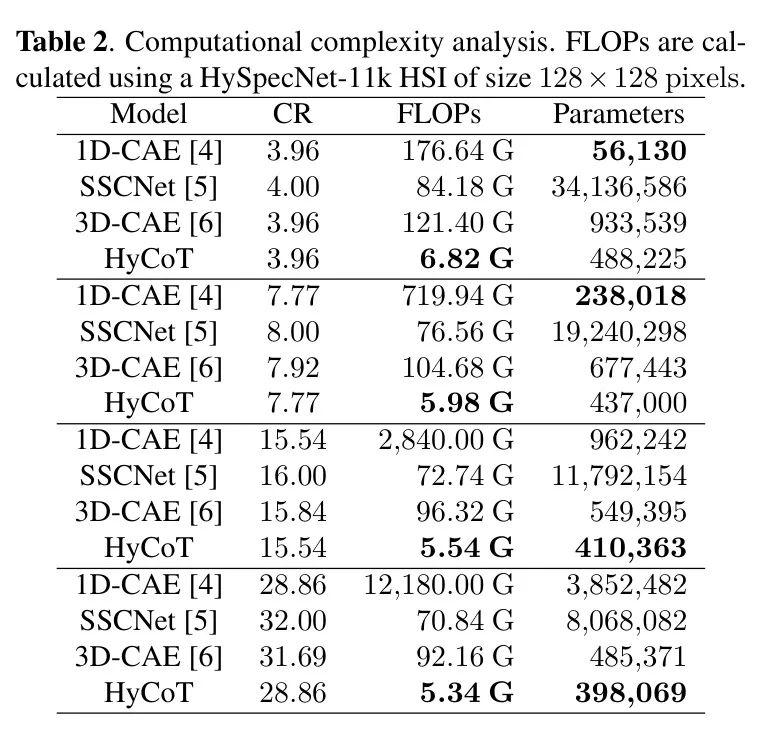
在本小节中,作者将比较HyCoT与其他模型的计算复杂度。表2报告了多个CRs的浮点运算(FLOPs)和模型参数的比较。从表中可以看出,对于低CRs,1D-CAE [4]具有少量的参数。然而,随着CR的增加,参数呈指数增长,因为网络增加了每次下采样操作新增的层。1D-CAE的高FLOPs是由于像素级卷积处理。相比之下,HyCoT在压缩到较小的潜层空间时,计算复杂度随着CR的增加而降低,因为 Transformer 编码器 Backbone 保持不变,只有MLP编码器的输出通道进行瘦身。因此,HyCoT的运行速度更快。此外,增加CR将比1D-CAE减少参数数量,而相反的情况是1D-CAE。值得一提,HyCoT的轻量级解码器适用于实时HSI重建。作者还报告了SSCNet和3D-CAE的计算复杂度。SSCNet和3D-CAE的参数数量和FLOPs较高,因为它们具有多维卷积层,因此无法与作者的HyCoT模型竞争。
图片

4 Conclusion

在本文中,作者提出了基于超光谱压缩的变形器(Hyper spectral Compression Transformer,HyCoT)模型。HyCoT利用 Transformer 自动编码器对超光谱图像进行压缩,以利用长程光谱依赖性。为了提高训练效率,作者在每个周期中只使用可用训练数据的小部分进行训练。

实验结果表明,作者的提出的模型的训练时间效率和计算复杂性均高于 state-of-the-art 的卷积自动编码器,在固定压缩系数下,重建质量也超过了它们。作为未来的工作,作者计划将作者的 HyCoT 模型扩展到实现高效的空间-光谱压缩。

参考

[1].HycoT: Hyperspectral Compression Transformer with an Efficient Training Strategy.

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

结合Transformer和多层特征聚合的高光谱图像分类算法 换句话说,通过多种尺度的卷积核实现不同层次的特征提取,然后进行按元素相加,改善了不同特征图之间的交互作用,从而提高了网络的表达能力。因此,与其他仅使用卷积网络相比,所提出网络具有更大的感受野,这就使得获得特征更具上下文信息,丰富了特征的多样性。其中,最为经典的是,在人类的视觉中,由于机制信息处理的瓶颈,人类会有选择性的关注某一部分信息,人类视网膜不同的部位具有不同程度的信息处理能力。近年来,自注意力机制(此外,基于注意力机制的方法能够获取长远的依赖关系,得到全局的特征,所以广泛应用在高光谱图像分类中。 阅读详情

相关推荐

【多层交叉transformer:高光谱和多光谱图像融合】

仅供自己参考

weixin_43690932的博客 1万+

遥感图像深度学习数据集完全指南:2024-2025最新汇总

随着深度学习技术的飞速发展,遥感图像分析已成为计算机视觉领域的重要研究方向。从城市规划到环境监测,从农业管理到灾害评估,遥感AI正在改变我们观察和理解地球的方式。然而,高质量的数据集是训练优秀模型的基础。本文基于 satellite-image-deep-learning 开源项目,系统整理了500+个遥感深度学习数据集,涵盖分类、检测、分割、变化检测等多个任务类型,为研究人员和工程师提供一站式的数据集查询指南。数据特点:核心数据集:Sentinel-2专题数据集精选: 2. Sentinel-1(S

weixin_51241407的博客 4410

高光谱分类论文解读分享之基于多模态融合Transformer的遥感图像分类方法

IEEE TGRS 2023:基于多模态融合Transformer的遥感图像分类方法

sinat_41421587的博客 3580

TNNLS 2024 | 基于残差超密集网络的高光谱图像空间光谱融合方法

这篇文章的研究背景是针对问题。高光谱图像在光谱分辨率上具有优势,但空间分辨率较低,而全色图像空间分辨率较高但缺乏光谱信息。因此,通过融合这两种图像,可以提高高光谱图像的空间分辨率,从而更好地支持遥感应用[1]。这篇文章提出了一种用于高光谱图像(HS)和全色图像(PAN)的时空光谱融合方法,称为残差超密集网络(RHDN)。A.建议的RHDB结构一般来说,网络越深,泛域性能越好。然而,大多数基于CNN的深层架构都会导致梯度消失问题。

Happy_Bug__的博客 1392

从原理到实践:详解双目散斑结构光的生成与优化

本文深入解析了双目散斑结构光的生成原理与优化实践,详细介绍了散斑结构光的抗干扰性、空间编码技术及其在三维视觉中的应用。通过对比不同生成方法和技术路线,提供了参数调优指南和工程实现细节,帮助开发者掌握高效、精准的散斑生成技术。

weixin_42521856的博客 591

ESP32S3编译micropython固件

编译ESP32芯片的micropython固件

m0_73253860的博客 2553

遥感中的 Transformers 综述

点击上方“小白学视觉”,选择加"星标"或“置顶”重磅干货,第一时间送达编者荐语文章涵盖了60多种基于transformers的最新方法,用于解决遥感子领域的不同遥感问题:非常高分辨率(VHR)、高光谱(HSI)和合成孔径雷达(SAR)图像。转载自丨专知仅用于学术分享,若侵权请联系删除在过去的十年中,基于深度学习的算法在遥感图像分析的不同领域中得到了极大的普及。最近,最初在自然语言处理中引入的基于...

小白学视觉 840

Plant Simulation数字孪生实战:从零搭建生产车间模型(附SimTalk脚本示例)

本文详细介绍了如何使用Plant Simulation从零构建生产车间数字孪生模型,包括基础建模、SimTalk脚本编程、参数化设计和高级应用。通过实战示例展示动态逻辑控制、设备故障模拟等关键技术,帮助工程师快速掌握数字孪生技术在制造业中的应用。

weixin_42527160的博客 359

最新突破!HyperSIGMA:全球首个十亿级高光谱智能理解基础模型

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【遥感和Mamba】交流群添加微信:CVer5555,小助手会拉你进群!扫描下方二维码,加入CVer学术星球!可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料,及最前沿应用!发论文/搞科研/涨薪,强烈推荐!论文题目:HyperSIGMA: Hyperspectral IntelligenceComp...

阿木寺的博客 3040

统一大型语言模型和知识图谱:路线图

大型语言模型(LLM),如ChatGPT和GPT4,由于其涌现能力和泛化性,正在自然语言处理和人工智能领域掀起新的浪潮。然而,LLM是黑箱模型,通常无法捕捉和获取事实知识。相反,知识图谱(KGs),例如维基百科和华普,是显式存储丰富事实知识的结构化知识模型。KGs可以通过为推理和可解释性提供外部知识来增强LLM。同时,KGs很难从本质上构建和演化,这对KGs中现有的生成新事实和表示未知知识的方法提出了挑战。因此,将LLM和KGs统一在一起并同时利用它们的优势是相辅相成的。

qq_32907491的博客 2842

【HCIE】FRR+BFD+OSPF与BGP联动

FRR+BFD+OSPF与BGP联动

Wenrs的博客 1997

【深度梯度投影网络:遥感图像】

仅供自己参考

weixin_43690932的博客 1544

交货单冲销发货过账的正确姿势:用 VL09 与 ABAP 批量反冲 Goods Issue

摘要 本文详细解析了SAP系统中VL09事务码的技术实现与业务应用。VL09用于反冲发货的货物移动,通过标准冲销路径(移动类型602冲销601)确保单据链路一致、状态机正确回退和业务规则生效。文章对比了经典VL09与Fiori应用在不同SAP产品形态中的位置,并针对STO场景提供了ME23N验证方法。核心内容包括WS_REVERSE_GOODS_ISSUE函数模块的调用要点、必须COMMIT的原因(SAP LUW机制),以及处理Handling Unit等限制条件的注意事项。最后给出了将VL09工程化的项目

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 590

【 Deep-Shallow 融合框架:Detail Extractor and Spectral Attention:高光谱泛锐化】

仅供自己参考

weixin_43690932的博客 1481

SAP 调用Ftp服务器

FTP(File transfer protocol)是一种标准的网络协议,可以用于在互联网上传递文件。SAP系统中可通过系列配置和提供的些标准函数,用于查看、更新、下载FTP服务器上的文件。提示:以下是本篇文章正文内容,下面案例可供参考。

qq_38304013的博客 1418

数据分析必问:Pandas面试题及参考答案

DataFrame是Pandas库中的一个核心数据结构,它类似于Excel中的表格,可以存储不同类型的数据。在Pandas中,抽样操作通常很简单,但是需要根据数据的特点和分析的需求来选择合适的抽样方法。数据标准化和归一化是数据预处理中常用的技术,目的是将数据调整到一个合适的范围内,以消除不同特征量纲和数值范围的差异,从而保证模型训练的有效性。CSV文件是一种文本文件,其中的数据以逗号分隔。不平衡数据集指的是数据集中各类别样本的数量差异较大的情况,这可能导致模型训练出现偏差,影响模型的泛化能力。

大模型大数据攻城狮的专栏 3009

自监督论文阅读笔记 Self-supervised Learning in Remote Sensing: A Review

深度神经网络对大量数据的丰富结构进行建模的优势已经导致了计算机视觉、自然语言处理、自动语音识别和时间序列分析的重大突破。然而,深度神经网络的性能对训练数据的大小和质量非常敏感。因此,在过去十年中,已经为监督训练生成了多个带注释的数据集(例如ImageNet [2]),推动了许多领域的进步。不幸的是,标注大规模数据集是一个极其费力、耗时且昂贵的过程。监督学习范式的这种限制严重阻碍了深度学习在现实世界场景中的适用性。 事实上,已经研究了许多普通监督学习的替代方法,例如无监督学习[3],半监督学习[

YoooooL_的博客 3374

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

光谱分类 transformer 实例

光谱分类 transformer 是一种用于光谱分类的机器学习模型。这种模型使用 transformer 网络来分析光谱数据,并将其分类为不同的类别。 具体来说,光谱数据通常由多个光谱信号组成,每个信号代表不同的物质或材料。光谱分类 transformer 可以分析这些信号,并根据这些信号的特征来判断它们属于哪种类别。 例如,光谱分类 transformer 可以用于分析水中的化学物质,并将其分类...

weixin_35750953的博客 536

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

高光谱图像分类,使用GAN和Swin-Transformer改进

近年来,基于生成对抗网络(GAN)的高光谱图像(HSI)分类取得了很大进展。然而,一些研究指出现有的基于GAN的HSI分类方法受到不平衡训练数据问题的严重影响。生成器只能在数据空间的一个狭窄范围内生成样本,这严重阻碍了基于GAN的HSI分类方法的发展。AdapDrop通过自适应形状生成Drop掩码,而不是固定尺寸的区域,它缓解了DropBlock在处理具有各种形状的地面对象时的限制。在三个HSI数据集上的实验结果表明,我们提出的ADGAN相对于现有的基于GAN的方法取得了更优秀的分类性能。

crasher123的博客 1343

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

Transformer在视觉任务中的优异性能

它通过全局感知上下文信息的方式,提高了模型的表示能力和推理能力,从而在图像分类、目标检测和语义分割等任务中取得了令人瞩目的成果。随着技术的发展和改进,相信Transformer模型将在未来继续发挥其优异的性能,推动计算机视觉领域的进一步发展。Transformer模型的引入改变了这一格局。在目标检测任务中,Transformer模型能够准确地定位和识别图像中的物体,且具有较低的漏检率和误检率。在语义分割任务中,Transformer模型能够对图像中的每个像素进行高精度的分类,实现对图像的像素级别理解。

xiehewe的博客 472

ESSAformer:Efficient Transformer for Hyperspectral Image Super-resolution——用于高光谱图像超分辨率的高效Transformer

ESSAformer:EfficientTransformerforHyperspectralImageSuper-resolution——用于高光谱图像超分辨率的高效Transformer

Together_CZ的博客 1465

调研遥感数据压缩

遥感图像压缩是指利用特定的算法和技术减少遥感图像数据量的过程,以便更有效地存储和传输数据。这个过程涉及到数据的编码,以减少数据的比特数,同时尽量保持原始图像的重要视觉和分析信息。无损压缩(Lossless Compression):在无损压缩中,原始图像数据在解压缩后可以完全恢复,没有信息损失。无损压缩算法的例子包括JPEG-LS、TIFF-LZW等。有损压缩(Lossy Compression):有损压缩则允许一定量的图像信息在压缩过程中损失,以换取更高的压缩率。

leyouBaloy的博客 1757

Multiscale spatial–spectral transformer network for hyperspectral and multispectral image fusion

文献阅读笔记:Multiscale spatial–spectral transformer network for hyperspectral and multispectral image fusion(MSST-Net)

sssuperhero的博客 1066

ESSAformer:用于高光谱图像超分辨率的高效Transformer

摘要 单幅高光谱图像超分辨率(single-HSI-SR)旨在从低分辨率观测中恢复出高分辨率高光谱图像。然而,当前基于卷积神经网络(CNN)的方法在构建长距离依赖关系和捕获光谱特征之间的交互信息方面存在局限性。这导致光谱信息利用不充分,并在上采样后出现伪影。为解决这一问题,我们提出了ESSAformer,这是一种嵌入了ESSA注意力的Transformer网络,用于单幅高光谱图像超分辨率,并具有迭代精炼结构。具体来说,我们首先引入了一种鲁棒且对光谱友好的相似性度量,即光谱的相关系数(SCC),以替代原始注意

m0_47867638的博客 1862

基于一维残差卷积自动编码器的滚动故障轴承诊断

滚动轴承故障诊断实质上是“特征提取+模式分类”的问题,即首先对原始震动信号进行特征提取,提取出其中的关键特征,然后采用分类器如SVM,KNN进行模式分类,可以说提取的特征越具表达性,分类器的精度就越高。表达性差的特征,不管换成啥分类器,精度都提高不了多少,而表达性强的特征,就算采用简单的KNN,精度都很高。 因此,合理的特征提取是提高故障诊断精度的关键。现有的震动...

qq_41043389的博客 8856

Contrastive Learning Based on Transformer for Hyperspectral Image Classification

Contrastive Learning Based on Transformer for Hyperspectral Image Classification

qq_37808565的博客 840
上一篇: 搭建自己的私有大模型:使用ollama搭建自己的私有中文大模型
下一篇: Transformer直接预测完整数学表达式,推理速度提高多个数量级
少喝冰美式
博客等级 码龄3年 6839粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值