史上最大多模态数据集诞生!!

智谱AI发布国产最强大模型GLM4,理解评测与数学能力仅次于Gemini Ultra和GPT-4,编程能力超过Gemini-pro,还有对标GPTs商店的GLMs 这是在智谱AI开发者大会上推出的新一代基座大语言模型,GLM4相比较此前最大的特点是三个变化:性能全面提升、上下文长度更长、支持更强的多模态能力。GLM4(GLM4)详细信息 | 名称、简介、使用方法,开源情况,商用授权信息 | 数据学习 (DataLearner) 阅读详情

目前最大的开源多模态数据集来了!

图片

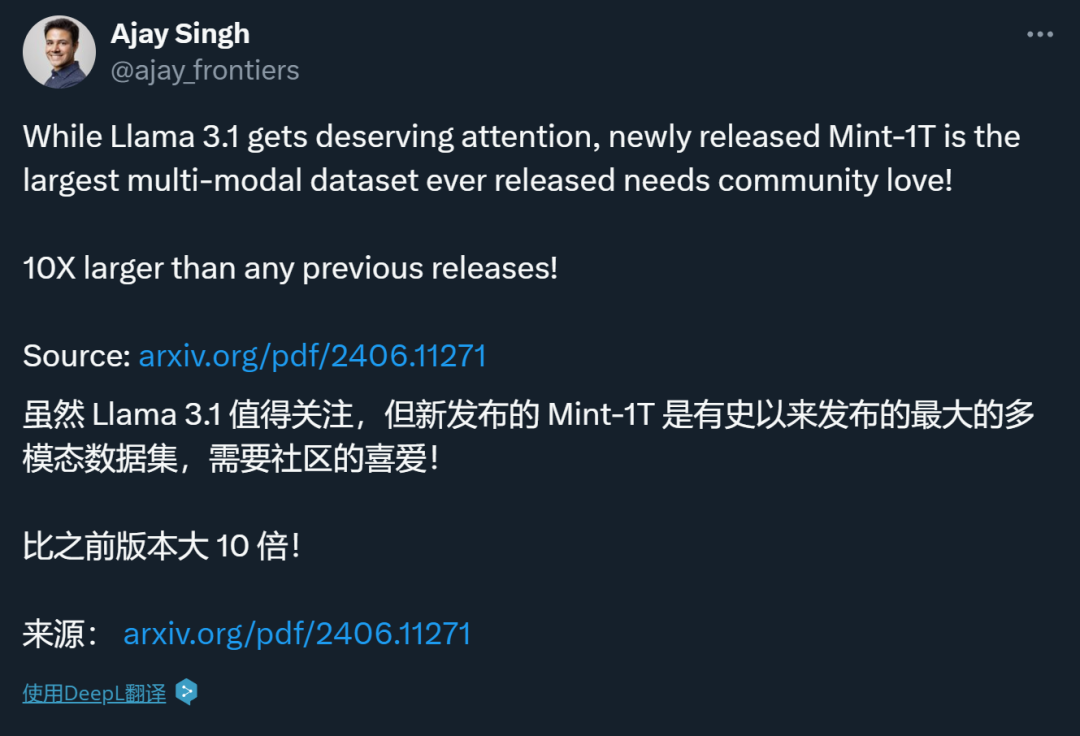
值此 Llama 3.1 占领各大头条之际,又突然冒出了另一个也非常重要的发布 —— 一个规模空前的开源多模态数据集。

对大模型来说,数据集的重要性无需多言,甚至可以说没有大型数据集就不可能有大模型。现在正是多模态大模型(LMM)发展正盛的时候,规模足够大的优质且开源的多模态数据集已经成为该领域的一大「刚需」。

不过,相比于开源的文本数据集,现有的开源多模态数据集都比较小、多样性也不足,并且来源基本都是 HTML 文档 —— 这就限制了数据的广度和多样性。这无疑限制了开源 LMM 的发展,让开源 LMM 与闭源 LMM 之间的差异变得非常大。

近日,华盛顿大学、Salesforce Research 和斯坦福大学等机构的联合团队填补了这一空白,构建了一个万亿 token 级的交织多模态的开源数据集 MINT-1T(Multimodal INTerleaved)。毫无疑问,这是目前最大的开源多模态数据集。
图片img

  • 数据集地址:https://github.com/mlfoundations/MINT-1T
  • 论文地址:https://arxiv.org/abs/2406.11271
  • 论文标题:MINT-1T: Scaling Open-Source Multimodal Data by 10x: A Multimodal Dataset with One Trillion Tokens

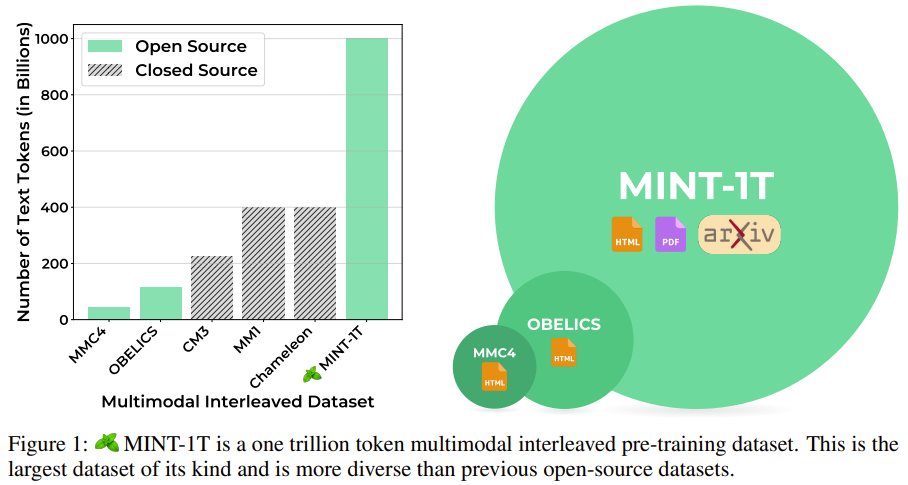
MINT-1T 共包含一万亿文本 token 和三十亿张图像,并且其有 HTML/PDF/ArXiv 等多种不同来源。在 MINT-1T 问世之前,该领域最大的开源数据集是 OBELICS,其包含 1150 亿文本 token 和 3.53 亿张图像,并且来源只有 HTML。图 1 比较了这些数据集。
图片img

数据集的构建

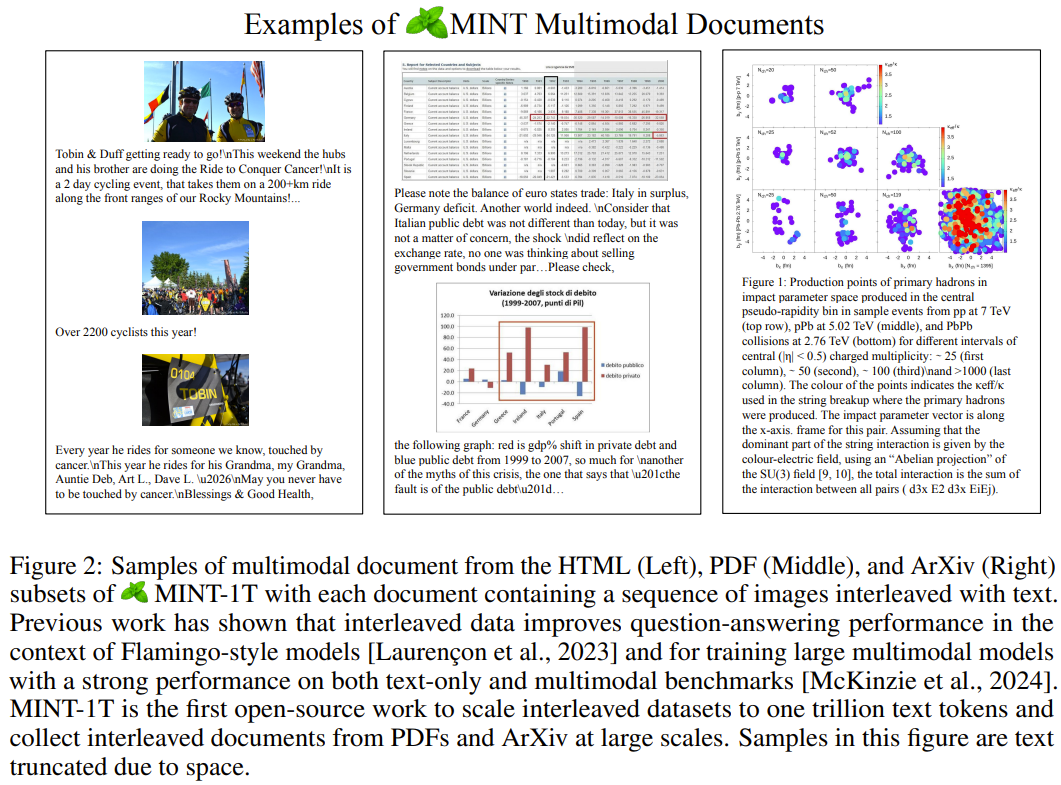
首先,该团队从多样化的来源(包括 HTML、PDF、ArXiv)收集了大量多模态数据,图 2 展示了这些不同来源的多模态文档样本。
图片img

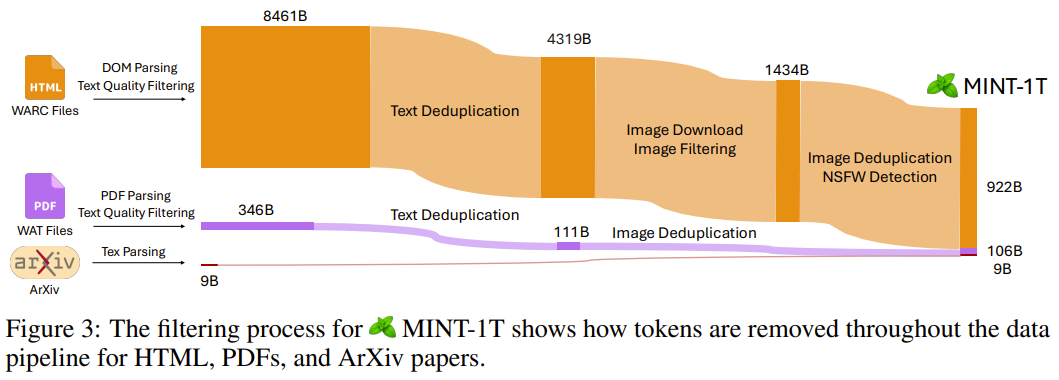
然后,为了提高数据质量和安全性,他们执行了文本质量过滤、图像过滤、安全过滤(包括去除 NSFW 图像和可识别个人身份的信息)以及去重。图 3 简要展示了这些数据过滤过程。
图片img

最终,他们得到的 MINT-1T 数据集包含 9220 亿 HTML token、1060 亿 PDF token 和 90 亿 ArXiv token。值得注意的是,整个数据处理过程耗费了大约 420 万 CPU 小时数。表 1 对比了一些常见的开源或闭源多模态数据集。

图片img

模型实验

该团队也实验了使用该数据集训练多模态模型的效果,并与其它数据集进行了比较。

他们使用的模型架构是 Salesforce 的 XGen-MM,评估的则是模型在数据集上学习之后的上下文学习和多图像推理能力。评估基准包括:视觉描述基准(COCO 和 TextCaps)、视觉问答基准(VQAv2、OK-VQA、TextVQA 和 VizWiz)、多图像推理基准(MMMU 和 Mantis-Eval)。

实验结果

在 HTML 文档上训练

该团队首先对比了 MINT-1T 的 HTML 部分与 OBELICS;因为 OBELICS 是之前领先的多模态数据集并且也是基于 HTML 文档,他们基于这两个数据集分别用 100 亿多模态 token 训练了两个模型,并评估了它们的上下文学习性能。

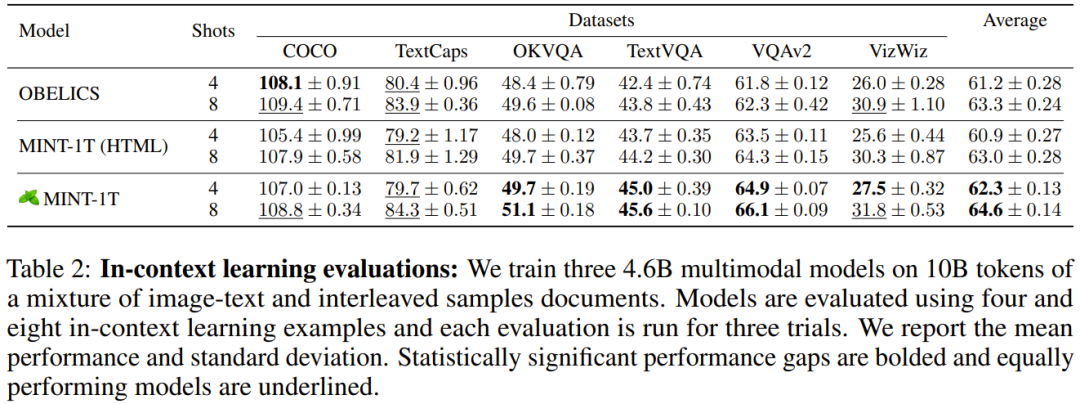
表 2 给出了在常见基准上的 4-shot 和 8-shot 性能。
图片img

可以看到,对于 VQA(视觉问答)任务,在 MINT-1T HTML 文档上训练的模型表现优于在 OBELICS 训练的模型,但前者在视觉描述任务上表现更差一些。平均而言,OBELICS 比 MINT-1T (HTML) 略好一点。

添加 PDF 和 ArXiv 文档

之后,该团队又在 MINT-1T 全数据集上进行了测试,即同时包含 HTML、PDF 和 ArXiv 文档。他们通常采样了 100 亿多模态 token,其中 50% 来自 HTML、45% 来自 PDF、5% 来自 ArXiv。

结果同样见表 2,可以看到在 MINT-1T 混合数据上训练的模型在大多数基准上都优于在 OBELICS 和 MINT-1T (HTML) 上训练的模型。

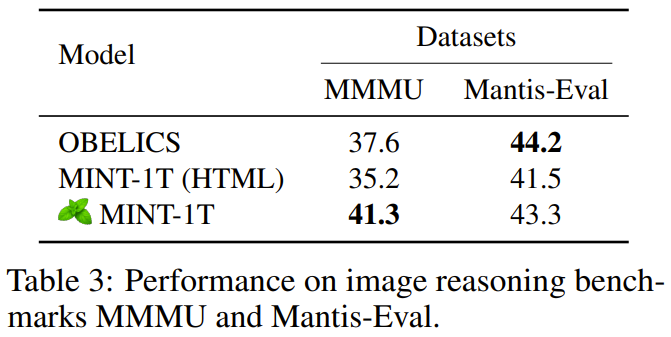
而在更为复杂的多模态推理任务上,如表 3 所示,用 MINT-1T 训练的模型在 MMMU 上优于用 OBELICS 训练的模型,但在 Mantis-Eval 基准上不及后者。
图片img

更细粒度的测试和模型架构的影响请参考原论文。

这个超大规模的开源多模态数据集能否成为一系列传奇的起点,最终造就一个类似 Llama 系列模型那样的多模态大模型系列呢?让我们拭目以待吧。
​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

用ollama本地部署Lamma3.1 ollama create 自定义模型名字 -f Modelfile。让lamma3.1写一个贪吃蛇小游戏,一次run成功。例如:ollama run llama3.1。例如:ollama run llama3.1。 阅读详情

相关推荐

Windows 中 利用 ollama 来搭建 deepseek R1

近年来,大模型凭借其强大的语言理解和生成能力,在自然语言处理、计算机视觉等领域取得了突破性进展。从GPT系列到国内的,文心一言、[Qwen]、,大模型已成为推动人工智能发展的核心力量。ollama作为新兴的大模型搭建工具,以其开源、高效、易于部署的特点,在人工智能开发者社区中崭露头角,为大模型的搭建和应用提供了新的解决方案。在当今数字化浪潮中,人工智能的发展可谓日新月异,而大模型作为其核心驱动力,正重塑着各个行业的格局。

一个专注于机器学习基础与实战的技术博客,内容涵盖算法推导、模型实现、数学原理与代码实践。用通俗的语言解析复杂概念,记录学习过程中的思考与总结,适合机器学习爱好者和从业者参考。 2554

使用 Ollama 本地运行各种 LLM

今天看看另外一个产品Ollama。Ollama 的安装非常简单,只需从官网(https://ollama.com/download)下载后解压缩,并在 Terminal 中运行脚本即可完成环境设置。我尝试运行 Llama3,虽然在运行时占用了大量电脑资源,使得其他应用运行变慢,但整体体验尚可。Ollama 支持多种大型语言模型(https://ollama.com/library)。

python123456_的博客 1734

VisualNews-Repository:构建高质量多模态新闻数据集的实践指南

多模态学习旨在让机器同时理解图像、文本等多种信息形式,其核心原理是通过深度学习模型将不同模态的数据映射到统一的语义空间,从而实现跨模态的关联与推理。这项技术对于推动人工智能在复杂场景下的感知与认知能力具有重要价值,尤其在新闻分析、内容检索和媒体理解等领域应用广泛。在实际工程中,构建一个高质量、结构化的多模态数据集是相关研究与应用得以开展的首要前提。VisualNews-Repository项目正是针对这一需求,提供了一个包含**图像-文本匹配**和**数据清洗**流程的开源解决方案。它系统化地解决了从主流新

weixin_27134143的博客 620

AI大模型探索之路-基础篇5:GLM-4解锁国产大模型的全能智慧与创新应用

随着人工智能技术的飞速发展,大型预训练语言模型已成为推动行业进步的重要力量。它们在理解自然语言、生成文本、执行复杂任务等方面展现出惊人的能力。在此背景下,国产大模型GLM-4的问世,不仅展现了中国在AI领域的实力,也为国内外研究者和开发者提供了新的研究与应用平台。

寻道AI,探索AI无限可能! 8679

【目标跟踪】Anti-UAV数据集:多模态挑战与评估标准深度解析

本文深度解析了Anti-UAV数据集在多模态目标跟踪领域的核心价值与技术突破。该数据集通过RGB-T双模态数据设计,有效应对光线变化、复杂背景干扰等挑战,并创新性地引入SA指标进行多维性能评估。文章详细探讨了数据标注体系的技术创新、典型应用场景及使用技巧,为无人机跟踪算法研究提供了重要参考。

weixin_29067143的博客 337

BasketHAR:多模态篮球动作识别数据集构建与模型训练全流程解析

人体动作识别是计算机视觉领域的基础任务,其核心原理在于从视频或传感器数据中提取时空特征,以理解和分类人体行为。这项技术的价值在于能将非结构化的视觉信息转化为可量化的数据,为自动化分析提供可能。在体育科学和智能训练等应用场景中,通用动作识别模型往往难以应对篮球等高动态、技术细节丰富的专项运动。针对此问题,BasketHAR数据集应运而生,它通过集成视觉、骨骼关键点和惯性测量单元等多模态数据,并采用层次化精细标注,为篮球动作识别提供了高质量的专项数据基础。本文以该数据集为例,深入解析了从数据采集、多模态同步、特

weixin_31304817的博客 881

万亿token!史上最大多模态数据集诞生

图 1 比较了这些数据集。不过,相比于开源的文本数据集,现有的开源多模态数据集都比较小、多样性也不足,并且来源基本都是 HTML 文档 —— 这就限制了数据的广度和多样性。可以看到,对于 VQA(视觉问答)任务,在 MINT-1T HTML 文档上训练的模型表现优于在 OBELICS 训练的模型,但前者在视觉描述任务上表现更差一些。而在更为复杂的多模态推理任务上,如表 3 所示,用 MINT-1T 训练的模型在 MMMU 上优于用 OBELICS 训练的模型,但在 Mantis-Eval 基准上不及后者。

2401_84033492的博客 1232

VTUAV数据集与HMFT基线:多模态无人机跟踪的挑战与解决方案

本文探讨了VTUAV数据集与HMFT基线在多模态无人机跟踪中的应用与突破。VTUAV数据集通过500个高分辨率RGB-T序列和分层标注体系,解决了数据稀缺与实战性不足的问题。HMFT基线采用三级融合策略(CIF、DFF、ADF),显著提升了跟踪精度,尤其在夜间和复杂场景中表现突出。这些创新为无人机目标跟踪技术提供了重要解决方案。

weixin_30576827的博客 466

一万亿token!34亿张图像,扩大10倍!史上最大开源多模态数据集MINT-1T发布!

众所周知,现在训练AI最需要的是什么?数据,数据,还是数据。——毕竟只有让AI学好了,AI才能好好地回答你的问题,否则就会答非所问。但是喂给AI的数据,现在和GPU一样,成了紧缺资源。前不久有人试图用AI自己造的数据来喂AI,结果发现这样的话AI越学越笨,最后连他亲妈来了都不忍直视的那种。MINT-1T是一个包含一万亿token的多模态预训练数据集,它是史上最大的同类数据集,并且比以前的开源数据集更加多样化。

夕小瑶科技说 1388

多模态表征—CLIP及中文版 Chinese-CLIP:理论讲解与代码微调

CLIP(对比语言-图像预训练)是一种通过对大量的图文对进行对比学习,从而获得图像和文本联合表征的模型。它可以将图像和文本映射到同一个向量空间,使得相似的图像和描述具有更高的相似度。本文详细介绍了 CLIP 和 Chinese-CLIP 的理论基础,并通过代码示例展示了如何进行模型的微调和应用。通过对多模态模型的掌握,能够更好地应对图像和文本之间的关联任务,为实际应用提供强有力的支持。

小蜗牛的珍贵百宝箱 1416

多模态大模型:技术原理与实战 BERT模型诞生之后行业持续摸索

多模态大模型:技术原理与实战 BERT模型诞生之后行业持续摸索 1. 背景介绍 1.1 问题的由来 随着深度学习技术的快速发展,尤其是Transformer架构的提出,自然语言处理(NLP)领域迎来了一次革命性的变

AI天才研究院 1178

SAM 3数据集揭秘:400万概念标注如何打造史上最大分割数据集

Meta Segment Anything Model 3(SAM 3)作为新一代图像分割模型,其核心优势来源于背后庞大而精细的数据集。本文将深入解析SAM 3数据集的构建奥秘,揭示400万概念标注如何支撑起这一史上最大分割数据集的开发,以及它如何为图像分割任务带来革命性突破。 ## 数据集规模与构成:400万概念的视觉盛宴 SAM 3数据集以其惊人的规模和多样性著称,包含超过400万的概念标

gitblog_02200的博客 400

差分逻辑电平——LVDS、CML、LVPECL、HCSL互连

首先了解差分逻辑电平结构,也包括单端逻辑电平常见的逻辑电平_常用的逻辑电平-优快云博客注:ECL >> PECL >> LVPECL演变而来;QDR(Quad Data Rate):四倍数据倍率本文章只涉及差分逻辑电平:LVDS 、LVPECL、CML (高速)(最常用)在任何给定的系统设计中,必须设计驱动器侧和接收器侧之间的时钟逻辑转换。通过在它们之间增加衰减电阻和偏置电路来将一个差分时钟转换为其他类型的差分逻辑,来衰减摆幅电平并重新偏置共模输入接收器。

weixin_45365488的博客 4万+

chatgpt是怎么诞生的,详解GPT1到GPT4的演化之路及相关背景知识

人工智能革命正在发生,我们是何其幸运的一代,能亲眼见证人类/机器智能的大爆发。本文将讨论chatgpt的诞生过程,串联起OpenAI发表的一系列重要论文,帮助读者更好的了解这场革命背后的原理。

m0_59931331的博客 1182

C#串口通讯实战:如何用SerialPort类搞定工业传感器数据采集(附完整代码)

本文详细介绍了如何使用C#的SerialPort类实现工业级传感器数据采集,涵盖串口通讯基础配置、数据帧处理、异常恢复机制及性能优化策略。通过实战代码示例,帮助开发者构建稳定可靠的工业数据采集系统,特别适合需要处理高频数据采集和复杂工业环境的场景。

weixin_42525551的博客 1086

c++实现异步线程池并详细分析线程池析构流程

多线程编程是提高程序性能和响应能力的关键技术之一,异步线程池作为多线程编程的一种有效实现方式,能够管理和复用线程资源,避免频繁创建和销毁线程带来的开销。在本文中,我们将深入探讨如何实现一个异步线程池。

2301_76564925的博客 1599

AVID:首个音视频不一致性数据集,挑战多模态AI的“挑刺”能力

在多模态人工智能领域,模型通常被训练来学习视觉与听觉信息的对齐与关联,例如将图像与对应的描述或声音进行匹配。其核心原理在于通过对比学习等方法,让模型建立跨模态的语义映射。这项技术的价值在于构建能够像人类一样综合理解世界的AI系统,广泛应用于内容审核、视频理解、人机交互和AIGC生成内容评估等场景。然而,现实世界的信息并非总是完美对齐,音视频之间常存在语义矛盾、时序错位或模态干扰,这构成了多模态理解的深层挑战。本文聚焦于AVID(Audio-VIsual Inconsistency Dataset)这一开创性

weixin_32771907的博客 333

从零构建:基于OpenCV与人体姿态分析的跌倒检测实战(附完整源码)

本文详细介绍了如何从零构建基于OpenCV与人体姿态分析的跌倒检测系统,包含完整源码与部署指南。通过MediaPipe实时检测33个人体关键点,结合多条件联合判断算法,实现高精度跌倒识别。文章还提供了性能优化技巧、常见问题解决方案以及家用与养老院两种部署方案,帮助开发者快速落地这一计算机视觉应用。

weixin_29085151的博客 240

Google更新最大的带注释图像数据集,添加本地化叙述

导语:对注释进行了极大的扩展 近日,Google AI 宣布发布 Open Images V6,和 V5 版本相比,它极大地扩展了 Open Images 数据集的注释,增加了大量新的视觉关系(例如,「狗抓飞盘」)、人类动作注释(例如,「女人跳跃」)和水平图像标签(例如,「paisley」)。 值得注意的是,该版本还添加了本地化叙述,这是一种全新的多模态注释形式,由同步的语音、文本和鼠标跟踪所...

喜欢打酱油的老鸟 574

大数据面试 逻辑题

逻辑题大致分为比较逻辑题、分析逻辑题、综合逻辑题、抽象逻辑题、概括逻辑题、推理逻辑题、论证逻辑题等,由于这类题比较考验综合素质,因此也一直是各大企业笔试、面试时经常喜欢考察的题目类型之一。很多童鞋认为逻辑题很难,其实不然。多做练习,打开思路,这类题还是可以轻易化解的。 下面为大家整理了网络上最全的75道逻辑判断测试题。在每道题目下方有答案,是用白色显示的,反选就可以看到啦~ 【1】假设有一个池...

zzq_0916s的博客 4422

R语言笔记十:独立性检验函数

1.独立性检验函数        独立性检验是根据频数信息判断两类因子彼此相关或相互独立的假设检验。所谓独立性就是指变量之间是独立的,没有关系。 独立性检验算法:卡方检验、Fisher检验、Cochran-Mantel-Haenszel检验 2.假设检验 假设检验(Hypothesis Testing)是数理统计学中根据一定假设条件由样本推断总体的一种方法。 原假设——没有发生 备择假设——发生了 具体做法:根据问题的需要对所研究的总体作

weixin_44384631的博客 4111

CH-SIMS数据集解析:细粒度多模态情感分析在中文场景下的实践与优化

本文深入解析了CH-SIMS数据集在中文细粒度多模态情感分析中的应用与优化。该数据集通过提供文本、音频、视频的独立及融合情感标签,为模型训练与诊断提供了精细工具。文章详细介绍了从特征提取、模型融合到多任务学习的全流程实践,并分享了针对中文场景的模态增强与鲁棒性设计等优化经验,助力开发者构建更精准、可解释的情感分析系统。

motor的博客 462

华为OD机试真题 新系统2026-04-01 C语言 实现【勇攀数字高峰】

请你在给定的数字地形图中寻找登山路径,数字代表当前位置的海拔高度,要求从最低海拔出发,不断攀登,最终到达最高山峰。你需要寻找所有满足条件的登山路径。地图已经保证最低海拔和最高山峰都只有一个。

MISAYAONE的博客 292
上一篇: “大胆 AI,我要你助我修行”——AI 助力产品经理山零基础写代码做开发| 近期思考
下一篇: 大视觉模型:举例,7个用例和2024年的挑战
少喝冰美式
博客等级 码龄3年 6839粉丝 517原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
