BitNet: 微软开源的 1-bit 大模型推理框架

微软大模型1B开源的 bitnet.cpp简介 微软开源的bitnet.cpp是一个针对1-bit大型语言模型(LLM)的推理框架,它能够在普通CPU上高效运行,无需依赖GPU。这个框架特别适合在资源受限的设备上运行大规模的模型,同时还能显著降低能耗和提高运行速度。bitnet.cpp。 阅读详情

GitHub:https://github.com/microsoft/BitNet

更多AI开源软件:发现分享好用的AI工具、AI开源软件、AI模型、AI变现 - 小众AI

微软专为 CPU 本地推理和极致压缩(低比特)大模型设计的推理框架。它支持对 1-bit/1.58-bit 量化模型进行高效、低能耗的推理,兼容 BitNet、Llama3-8B-1.58、Falcon3 等模型,适用于在本地或边缘设备上运行大模型推理任务,无需 GPU。

​

​

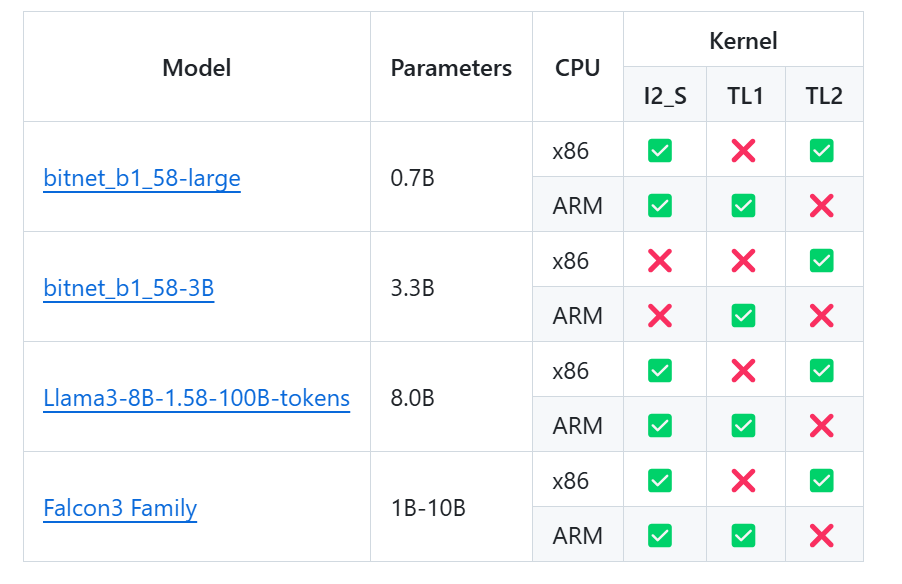
模型支持

​

​

安装

要求
  • python>=3.9

  • cmake>=3.22

  • clang>=18

    • 对于 Windows 用户,请安装 Visual Studio 2022。在安装程序中,至少打开以下选项(这也会自动安装所需的附加工具,如 CMake):

      • 使用 C++ 进行桌面开发
      • 适用于 Windows 的 C++-CMake 工具
      • 适用于 Windows 的 Git
      • 适用于 Windows 的 C++-Clang 编译器
      • LLVM 工具集 (clang) 的 MS-Build 支持
    • 对于 Debian/Ubuntu 用户,您可以使用自动安装脚本下载
      ​bash -c "$(wget -O - https://apt.llvm.org/llvm.sh)"​

  • conda (强烈推荐)

从源构建

重要

如果您使用的是 Windows,请记住始终使用 VS2022 的开发人员命令提示符/PowerShell 来执行以下命令。如果您发现任何问题,请参阅下面的常见问题解答。

  1. 克隆存储库
git clone --recursive https://github.com/microsoft/BitNet.git
cd BitNet
  1. 安装依赖项
# (Recommended) Create a new conda environment
conda create -n bitnet-cpp python=3.9
conda activate bitnet-cpp

pip install -r requirements.txt
  1. 生成项目
# Manually download the model and run with local path
huggingface-cli download microsoft/BitNet-b1.58-2B-4T-gguf --local-dir models/BitNet-b1.58-2B-4T
python setup_env.py -md models/BitNet-b1.58-2B-4T -q i2_s
usage: setup_env.py [-h] [--hf-repo {1bitLLM/bitnet_b1_58-large,1bitLLM/bitnet_b1_58-3B,HF1BitLLM/Llama3-8B-1.58-100B-tokens,tiiuae/Falcon3-1B-Instruct-1.58bit,tiiuae/Falcon3-3B-Instruct-1.58bit,tiiuae/Falcon3-7B-Instruct-1.58bit,tiiuae/Falcon3-10B-Instruct-1.58bit}] [--model-dir MODEL_DIR] [--log-dir LOG_DIR] [--quant-type {i2_s,tl1}] [--quant-embd]
                    [--use-pretuned]

Setup the environment for running inference

optional arguments:
  -h, --help            show this help message and exit
  --hf-repo {1bitLLM/bitnet_b1_58-large,1bitLLM/bitnet_b1_58-3B,HF1BitLLM/Llama3-8B-1.58-100B-tokens,tiiuae/Falcon3-1B-Instruct-1.58bit,tiiuae/Falcon3-3B-Instruct-1.58bit,tiiuae/Falcon3-7B-Instruct-1.58bit,tiiuae/Falcon3-10B-Instruct-1.58bit}, -hr {1bitLLM/bitnet_b1_58-large,1bitLLM/bitnet_b1_58-3B,HF1BitLLM/Llama3-8B-1.58-100B-tokens,tiiuae/Falcon3-1B-Instruct-1.58bit,tiiuae/Falcon3-3B-Instruct-1.58bit,tiiuae/Falcon3-7B-Instruct-1.58bit,tiiuae/Falcon3-10B-Instruct-1.58bit}
                        Model used for inference
  --model-dir MODEL_DIR, -md MODEL_DIR
                        Directory to save/load the model
  --log-dir LOG_DIR, -ld LOG_DIR
                        Directory to save the logging info
  --quant-type {i2_s,tl1}, -q {i2_s,tl1}
                        Quantization type
  --quant-embd          Quantize the embeddings to f16
  --use-pretuned, -p    Use the pretuned kernel parameters

实战演习

基本场景
# Run inference with the quantized model
python run_inference.py -m models/BitNet-b1.58-2B-4T/ggml-model-i2_s.gguf -p "You are a helpful assistant" -cnv
usage: run_inference.py [-h] [-m MODEL] [-n N_PREDICT] -p PROMPT [-t THREADS] [-c CTX_SIZE] [-temp TEMPERATURE] [-cnv]

Run inference

optional arguments:
  -h, --help            show this help message and exit
  -m MODEL, --model MODEL
                        Path to model file
  -n N_PREDICT, --n-predict N_PREDICT
                        Number of tokens to predict when generating text
  -p PROMPT, --prompt PROMPT
                        Prompt to generate text from
  -t THREADS, --threads THREADS
                        Number of threads to use
  -c CTX_SIZE, --ctx-size CTX_SIZE
                        Size of the prompt context
  -temp TEMPERATURE, --temperature TEMPERATURE
                        Temperature, a hyperparameter that controls the randomness of the generated text
  -cnv, --conversation  Whether to enable chat mode or not (for instruct models.)
                        (When this option is turned on, the prompt specified by -p will be used as the system prompt.)
基准测试

我们提供脚本来运行推理基准测试,从而提供模型。

usage: e2e_benchmark.py -m MODEL [-n N_TOKEN] [-p N_PROMPT] [-t THREADS]  
   
Setup the environment for running the inference  
   
required arguments:  
  -m MODEL, --model MODEL  
                        Path to the model file. 
   
optional arguments:  
  -h, --help  
                        Show this help message and exit. 
  -n N_TOKEN, --n-token N_TOKEN  
                        Number of generated tokens. 
  -p N_PROMPT, --n-prompt N_PROMPT  
                        Prompt to generate text from. 
  -t THREADS, --threads THREADS  
                        Number of threads to use. 

以下是每个参数的简要说明:

  • ​-m​, : 模型文件的路径。这是运行脚本时必须提供的必需参数。--model​
  • ​-n​, : 推理过程中要生成的 Token 数量。它是一个可选参数,默认值为 128。--n-token​
  • ​-p​, :用于生成文本的提示标记的数量。这是一个可选参数,默认值为 512。--n-prompt​
  • ​-t​, : 用于运行推理的线程数。它是一个可选参数,默认值为 2。--threads​
  • ​-h​, : 显示帮助消息并退出。使用此参数可显示使用信息。--help​

例如:

python utils/e2e_benchmark.py -m /path/to/model -n 200 -p 256 -t 4  

此命令将使用位于 的模型运行推理基准测试,利用 4 个线程从 256 个令牌提示符生成 200 个令牌。/path/to/model​

对于任何公共模型都不支持的模型布局,我们提供了脚本来生成具有给定模型布局的虚拟模型,并在您的机器上运行基准测试:

python utils/generate-dummy-bitnet-model.py models/bitnet_b1_58-large --outfile models/dummy-bitnet-125m.tl1.gguf --outtype tl1 --model-size 125M

# Run benchmark with the generated model, use -m to specify the model path, -p to specify the prompt processed, -n to specify the number of token to generate
python utils/e2e_benchmark.py -m models/dummy-bitnet-125m.tl1.gguf -p 512 -n 128

BitNet:1-bit大语言模型的高效推理框架详解 微软推出的BitNet是一款专为1-bit大语言模型设计的推理框架,基于llama.cpp构建并优化内核,支持CPU/GPU高效推理。该框架通过1.58比特量化技术,将模型权重大幅压缩至三元值(-1/0/+1),显著降低资源消耗。性能测试显示,BitNet在ARM和x86架构上分别实现1.37-5.07倍和2.37-6.17倍速度提升,能耗降低55%-82%,单CPU即可流畅运行百亿参数模型。框架支持模型转换、多线程推理及对话模式,为边缘计算和移动端部署提供了轻量化解决方案,推动AI技术向高效普惠方向发展。 阅读详情

相关推荐

【前沿解析】2026年3月15日:微软BitNet.cpp突破AI推理硬件枷锁——单CPU运行100B大模型,无损推理与能耗双重革新

技术突破1.58位量化方案:首次在百亿参数规模实现<1%精度损失多平台优化:统一架构支持ARM/x86,推理速度提升2.37-6.17倍无损推理机制:通过动态校准与残差补偿保持工业级精度工程价值硬件门槛革命:单CPU运行100B模型,降低部署成本94.7%能效比突破:推理能耗降低71.9-82.2%,支持边缘部署生态开放性:MIT开源协议,推动技术普惠化。

shao.bing的专栏 1982

BitNet——用单个比特进行推理的大语言模型,性能媲美全精度Transformer

本研究提出了一种基于单比特变换器的大规模语言模型。研究还全面比较了 BitNet 与传统量化方法和普通 Transformer,并讨论了它们之间的差异。结果表明,BitNet 可以实现比传统量化方法更高的效率和准确性。此外,其结果与普通 Transformer 的准确性不相上下,令人惊讶。未来,随着大规模语言模型变得更加庞大,研究模型量化方法的重要性预计会增加,而 BitNet 被认为有潜力成为这一领域的领导者。从这个意义上讲,我们期待着进一步讨论该模型的通用性和应用限制。

知来者逆的博客 2361

革命性的一比特语言模型:BitNet的崛起与未来

BitNet 是一种革命性的语言模型架构,它将传统需要大量存储和计算资源的大型语言模型(LLM)压缩到令人难以置信的程度 —— 仅使用 1.58 比特来表示模型参数。这就好比将一部百科全书的内容浓缩到一张明信片上,却依然保留了其核心知识和功能。BitNet 的出现犹如 AI 世界里的一场小革命。它证明了即使是最小的比特也能承载巨大的智能。随着技术的不断发展,我们期待看到更多像 BitNet 这样的创新,不断推动 AI 技术向着更高效、更普及、更智能的方向发展。

步子哥的博客 1420

AI大模型量化技术介绍(五)量化感知训练、1位大型语言模型的时代:BitNet

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

star_nwe的博客 1969

BitNet:让百万亿参数模型在你掌心飞驰

是的,就是这样一个小得可怜的单位,但它却拥有改变机器学习世界的潜力。bitnet.cpp的出现,让我们仿佛手持魔法棒,将庞大的语言模型压缩到1.58比特,依然能让它们高效运转。值得注意的是,bitnet.cpp的目标不仅仅是推理,它还希望在不久的将来推动1比特模型的大规模训练和发布。让我们展望一个不远的未来,在那里,1比特模型成为标准,设备不再需要强大的硬件,即使是小型设备,也能运行庞大的模型,提供实时的智能反馈。的推理,甚至能让你在个人设备上运行庞大的模型——是的,连1000亿参数的模型都能轻松驾驭。

步子哥的博客 1181

bitnet-chrome-app:北理工校园网登录器Chrome App版

bitnet-chrome-app ================= 北理工Chrome app版校园网登录器. Webstore地址: ScreenShots

【GitHub开源项目实战】 BitNet 实战解析:微软开源的 1-bit 量化推理模型全流程复盘

BitNet 是微软在低比特推理方向的重要突破,采用创新的 1-bit 量化 Transformer 架构,实现更高效的模型压缩与推理加速。相较于传统全精度模型,BitNet 在极端低比特率下依然保持了极强的语言建模能力,并显著降低了推理内存与能耗需求,具有极强的工程应用价值。本文围绕 BitNet 官方开源仓库展开,系统解析其模型设计逻辑、量化实现细节、训练推理策略与部署路径,重点展示如何从源码出发进行本地运行、性能验证与企业级集成,帮助工程团队全面理解 BitNet 的核心机制与优化空间。

努力分享一些人工智能、计算机视觉、影像等相关的知识干货! 1870

从零构建:毫米波雷达生命信号检测系统的Matlab仿真全流程解析

本文详细解析了毫米波雷达生命信号检测系统的Matlab仿真全流程,涵盖原理、信号处理链路设计及算法优化策略。通过FMCW雷达技术,实现非接触式呼吸心跳信号检测,结合Matlab代码示例展示距离FFT、相位提取与信号分离等关键步骤,为医疗监护和智能家居应用提供实用指南。

weixin_29303701的博客 355

1-bit LLM推理革命:BitNet框架在边缘计算中的突破性实践

BitNet作为微软推出的官方1-bit LLM推理框架,代表了大规模语言模型在边缘设备部署的技术前沿。通过创新的1.58-bit量化技术和优化的CPU/GPU推理内核,BitNet实现了在保持模型性能的同时,将推理速度提升1.15-6.17倍,能耗降低55.4%-82.2%的突破性进展。本文将从技术原理、性能优化到实战部署,全面解析BitNet如何重塑边缘AI推理的格局。 ## 🚀 技术架构

gitblog_00009的博客 790

滚动时域优化方法

滚动时域优化(Receding Horizon Optimization, RHO),也被广泛称为模型预测控制(Model Predictive Control, MPC),是一种用于动态系统优化和控制的。其核心思想是“在每个当前时刻k,控制器只考虑未来一个(称为“预测时域”或“优化时域”,长度N)内的系统行为。(通过测量或估计得到)。(描述状态如何随输入和干扰变化)。(如果有,可能基于历史数据或假设)。在这个有限的未来时域[k, k+N-1]上,求解一个。这个优化问题的目标是找到一个。

m0_69522810的博客 2293

Gartner《构建可扩展数据产品建设框架》心得

数据产品化:从概念到落地的实践指南 当前企业正从传统数据需求模式转向数据产品化新范式。本文系统阐述了数据产品的核心价值、定义分类和实施框架,指出成功关键是将数据包装为可复用、可扩展的产品。Gartner框架强调产品思维,提出4阶段12步实施路径,涵盖设计、工程、发布和监控全流程。文章特别提醒要避免7大常见误区,如简单重命名报表、忽视元数据治理等,建议采取MVP策略,90天内完成从价值验证到产品落地的闭环。实施中需平衡技术选型与业务需求,建立跨职能团队,并通过AARRR模型持续追踪产品价值。

2501_91410404的博客 1002

微软的重大突破:bitnet.cpp 开启 AI 本地CPU运行新时代

微软开源 bitnet.cpp 的这一举措,无疑为 AI 技术的发展注入了强大的新活力。它让我们真切地看到了在不依赖昂贵硬件的情况下,AI 模型仍然能够高效运行并为用户带来巨大价值的可能性。相信在未来,bitnet.cpp 将如同星星之火,逐渐形成燎原之势,为更多的开发者和用户带来前所未有的便利,推动 AI 技术在各个领域绽放出更加绚丽的光彩。让我们拭目以待,共同见证这一技术为我们的生活和工作带来的翻天覆地的改变。

寻道AI,探索AI无限可能! 4849

MoveIt2 Servo实战:解锁UR机械臂在ROS2中的实时遥操作与动态响应

本文深入探讨了MoveIt2 Servo在UR机械臂实时遥操作中的应用,展示了如何通过ROS2实现毫秒级动态响应。文章详细解析了Servo的核心价值、环境配置、控制器适配及高级调优技巧,特别适用于需要高精度控制的工业场景,如VR手术训练和汽车装配线。

weixin_29044157的博客 247

能在 CPU 上运行的开源大模型推理框架

如今,大模型的发展势头迅猛,而且,大模型的演进出现了两种分化趋势:一方面,开源大模型的规模不断扩大,从最初的数十亿参数迅速扩展到数千亿参数,照这个趋势,很快就会突破万亿级的超大规模。这类巨型模型通过引入更丰富的语义理解、复杂的推理能力和跨领域知识整合,展现出强大的智能。各大厂商开展军备竞赛,为了追求更高的准确率和更强的泛化能力,大模型的“无上限”扩展不断突破技术和硬件的边界。另一方面,模型也在向小...

云水木石 1889

华为手机连接Win11失败?内核隔离与驱动签名冲突的终极解决指南

在Windows操作系统中,驱动程序是硬件与系统通信的桥梁,其数字签名机制是保障系统内核安全的核心防线。基于虚拟化的安全技术通过强制验证驱动签名,能有效隔离恶意代码,提升系统抵御高级威胁的能力。然而,严格的签名策略有时会与部分硬件驱动产生兼容性问题,导致设备无法识别,直接影响文件传输、应用调试等核心工作流。本文聚焦于华为手机在开启Windows 11内核隔离功能时出现的连接故障,深入剖析驱动签名验证与Hypervisor保护的代码完整性原理,并提供从驱动更新、策略调整到无线替代方案的完整解决路径,帮助用户在

weixin_31309419的博客 352

逆向工程实战:如何用Frida和IDA破解AppleAccount的X-MMe-Nas-Qualify签名机制

本文通过逆向工程实战,详细解析了如何利用Frida动态Hook和IDA静态分析技术,破解AppleAccount服务中关键的X-MMe-Nas-Qualify签名机制。文章从环境搭建、动态追踪NSMutableURLRequest的签名注入点开始,逐步深入到AuthKit框架的静态剖析与算法还原,最终实现独立的签名生成,为安全研究和自动化测试提供了完整的技术路径。

bush的博客 696

微软开源爆火1.58bit大模型推理框架!千亿参数模型量化后单CPU可跑,速度每秒5-7个token

微软1bit大模型推理框架!现在1000亿参数大模型量化后单CPU可跑,速度可达每秒5-7个token。比如在新品上运行BitNet b1.58 3B模型,be like:就是今年爆火论文的官方代码实现,开源不到一周GitHub已揽获。传统大模型参数以16位浮点数(如FP16或BF16)形式的存储,而BitNet b1.58将其统统变成了,也就是。这里的“1.58 bit”指每个参数可以用1.58位的信息来表示。转换之后,

m0_59235699的博客 1309

基于YOLOv11的农作物病虫害检测系统设计与实现

我们使用公开的IP102病虫害数据集作为基础,该数据集包含102种病虫害类别,覆盖水稻、小麦、玉米等多种主要农作物。图像数量:75,222张类别数:102图像分辨率:从640×480到4000×3000不等标注格式:PASCAL VOC格式此外,我们还收集了部分田间实际拍摄的图像以增强模型泛化能力。

YOLO 595

如何实现5倍加速:BitNet 1-bit大模型边缘部署实战指南

BitNet是一个专为1-bit大语言模型优化的高效推理框架,能够在资源受限的边缘设备上实现快速、无损的模型推理。通过创新的量化技术和并行化优化,BitNet在CPU和GPU上都能显著提升推理速度,同时大幅降低能耗,为大模型在边缘设备的部署提供了完整的解决方案。 ## 边缘设备部署的核心挑战 随着AI技术的快速发展,大语言模型在边缘设备上的部署面临着多重挑战。**边缘设备**通常具有有限的计算

gitblog_00806的博客 965

【知识分享】IBIS 建模指南 05

本文详细阐述了IBIS模型创建过程中的关键技术和数据规范要求。主要内容包括:1. 数据完整性检查要点,强调I-V和V-T数据必须覆盖所有工艺角且匹配;2. 数据限制处理方法,介绍100/1000点限制下的两种数据筛选算法;3. 特殊数据处理技术,包括内部终端电阻调整和V-T表时间窗口选择;4. 高级关键字应用,涵盖[ModelSelector]、[Sub model]、[DiffPin]等复杂功能实现方法;5. 预加重缓冲器等特殊结构的建模方案。

一只豌豆象的博客 1594

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

微软开源爆火1.58bit大模型推理框架!千亿参数模型量化后单CPU可跑,速度每秒5-7个token...

西风 发自 凹非寺量子位 | 公众号 QbitAI微软开源1bit大模型推理框架!现在1000亿参数大模型量化后单CPU可跑,速度可达每秒5-7个token。比如在苹果M2新品上运行BitNet b1.58 3B模型,be like:就是今年爆火论文The Era of 1-bit LLMs的官方代码实现,开源不到一周GitHub已揽获7.9k Star。传统大模型参数以16位浮点数(如FP16或...

量子位 693

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

BitNet:1-bit量化大模型在CPU上的高效部署与实践

1-bit量化是深度学习模型压缩的前沿技术,通过将权重和激活值极端量化为±1,实现内存占用降低10-20倍的同时保留90%以上原始精度。其核心技术原理是将矩阵运算转化为位运算,并配合梯度裁剪、残差量化等创新训练策略。这种量化方法特别适合在CPU和边缘设备部署,使大语言模型能在消费级硬件上流畅运行。以微软开源的BitNet为例,7B参数模型仅需4GB内存,在树莓派等IoT设备中也能实现500ms内的低延迟推理。该技术为本地知识库问答、边缘AI等场景提供了新的可能性,推动了AI技术的民主化进程。

xpp02的专栏 521

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

微软开源1.58位大模型BitNet b1.58 2B4T:性能比肩全精度,CPU轻松跑!

BitNet 是微软专为 CPU 本地推理和极致压缩(低比特)大模型设计的推理框架。它支持对 1-bit/1.58-bit 量化模型进行高效、低能耗的推理,兼容 BitNet、Llama3-8B-1.58、Falcon3 等模型,适用于在本地或边缘设备上运行大模型推理任务,无需 GPU。

coderroad的博客 7690

CPU推理仅29ms,微软开源第一个原生 1 bit 大模型,内存只需Qwen 1.5B的1/15

微软研究院发布了第一个开源的、原生的 1 bit 大型语言模型(LLM):BitNet b1.58 2B4T:内存占用:BitNet b1.58 2B4T 的非嵌入层内存占用仅为0.4GB,远低于其他全精度模型。能耗:估计的解码能耗为0.028焦耳,远低于其他模型。解码延迟:在CPU上,BitNet b1.58 2B4T 的平均延迟为29ms,远低于其他模型。

2401_84204413的博客 870

Microsoft开源BitNet.cpp:单CPU跑千亿大模型的工程实践指南

BitNet.cpp为CPU推理提供了实用的工程解决方案。通过1-bit量化技术,大幅降低了AI模型部署的门槛。部署建议根据模型大小合理配置硬件资源使用容器化部署确保环境一致性实施监控告警,及时发现性能问题定期优化配置,适应业务增长性能调优要点内存配置是关键,确保足够的物理内存多线程优化可以显著提升吞吐量网络优化减少API调用延迟监控分析指导持续优化随着技术的不断成熟,CPU推理将在更多场景中发挥重要作用。开发者应该掌握这些工程实践,为未来的AI应用部署做好准备。

AI自动化工坊 1008

革命性突破:BitNet 1-bit模型推理效率实测

你是否还在为大模型推理时的高内存占用和缓慢速度而烦恼?当用户量激增时,服务器频繁崩溃;想要在边缘设备部署AI模型,却受限于硬件配置无法实现。这些问题不仅影响用户体验,还会增加企业运营成本。今天,我们将介绍BitNet带来的1-bit模型技术,它如何通过极致压缩实现推理效率的飞跃,以及普通用户如何轻松应用这项技术提升系统性能。读完本文,你将了解BitNet的核心优势、实测加速效果、适用场景及快速上手...

gitblog_01007的博客 757
上一篇: HowToCook: 程序员在家做饭指南
下一篇: codex: OpenAI 开源的轻量级编程助手
小众AI
博客等级 码龄25年 1290粉丝 143原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值