transformer理解及bert源码解读

Bert源码阅读 前言 对Google开源出来的bert代码,来阅读下。不纠结于代码组织形式,而只是梳理下其训练集的生成,训练的self-attention和multi-head实现,它的具体实现和论文里写的还是有很大差别的。 训练集的生成 主要实现在create_pretraining_data.py和tokenization.py两个脚本里。 输入文本格式举例,下面是两篇文章外加一篇空文章。两篇文章之间... 阅读详情

一、transformer

也就是encoder-decoder with attention的结构,

参考:

attentnion is all you need:https://arxiv.org/abs/1706.03762

【NLP】Transformer模型原理详解:https://zhuanlan.zhihu.com/p/44121378

详解Transformer (Attention Is All You Need):详解Transformer (Attention Is All You Need) - 知乎

个人理解:

1. 为什么用attention而不是rnn或者cnn

rnn不能并行计算,cnn卷积核只能考虑部分单元(虽然最后也能考虑全局),attention是一种巧妙的设计,将每个位置的输入转换为q,k,v,这样计算出来的输出考虑的全局的注意力,并且参数比较少,只需要学习Wq,Wk,Wv矩阵

2. decoder和encoder区别,以及decoder的解码过程

参考:举个例子讲下transformer的输入输出细节及其他 - 知乎

decoder比encoder多了一个encoder-decoder attention,

训练的时候:

decoder的输入是6层的encoder输出的K和V+decoder应该输出序列Q(mask矩阵),从而实现并行计算。

这个地方一个疑问: decoder是需要上一个序列的输入的,如何实现并行计算
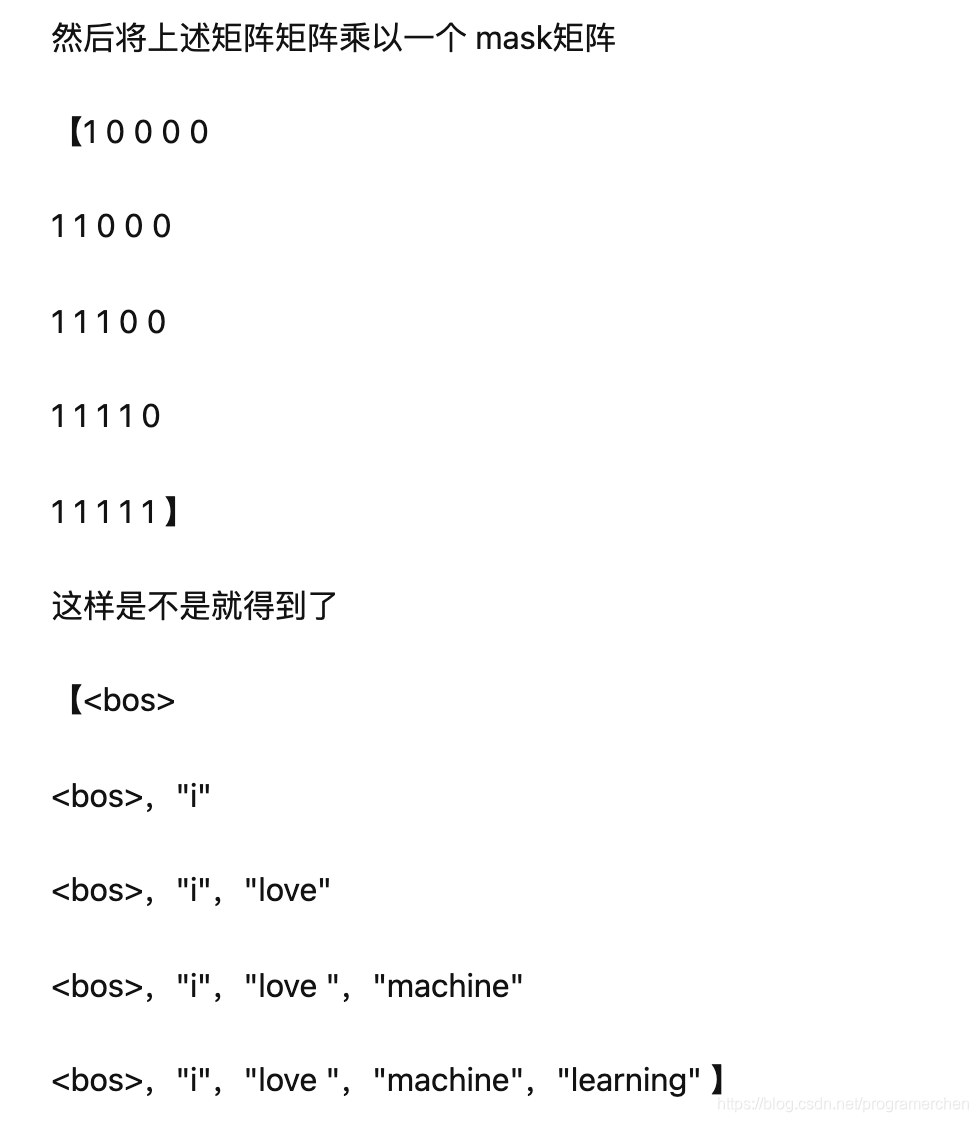
为什么说训练可以并行,因为训练本质上是要计算输入*参数矩阵的输出和实际输出的error,而这个,因为实际输出是知道的,每个位置的error对应的输入序列也是确定的,所以可以并行解决

预测的时候:

decoder输入是6层的encoder输出的K和V+decoder应该输出序列的前t-1个值,非并行的多次迭代,直到预测出<eos>标签就停止

3. 传统seq2seq模型参考

seq2seq模型详解及对比(CNN,RNN,Transformer) - 微笑sun - 博客园

二、 bert源码解读

bert一般是12层网络,512的序列,每个token是768维的向量
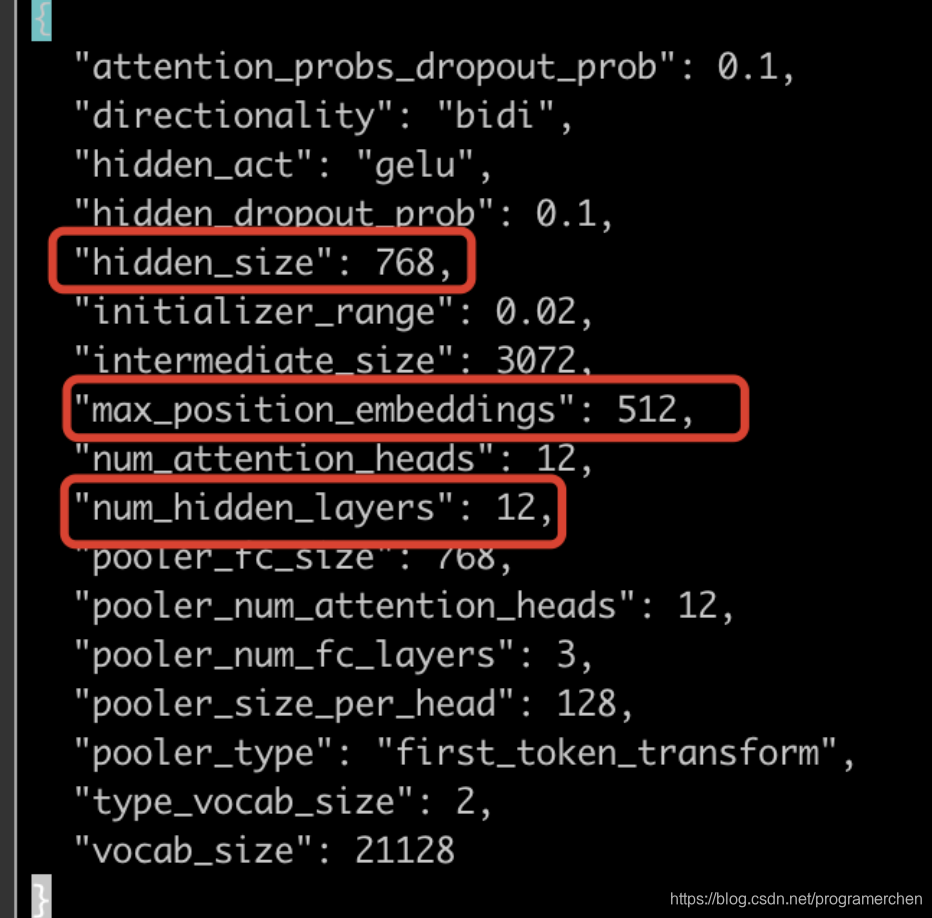
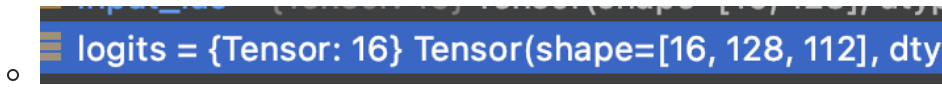
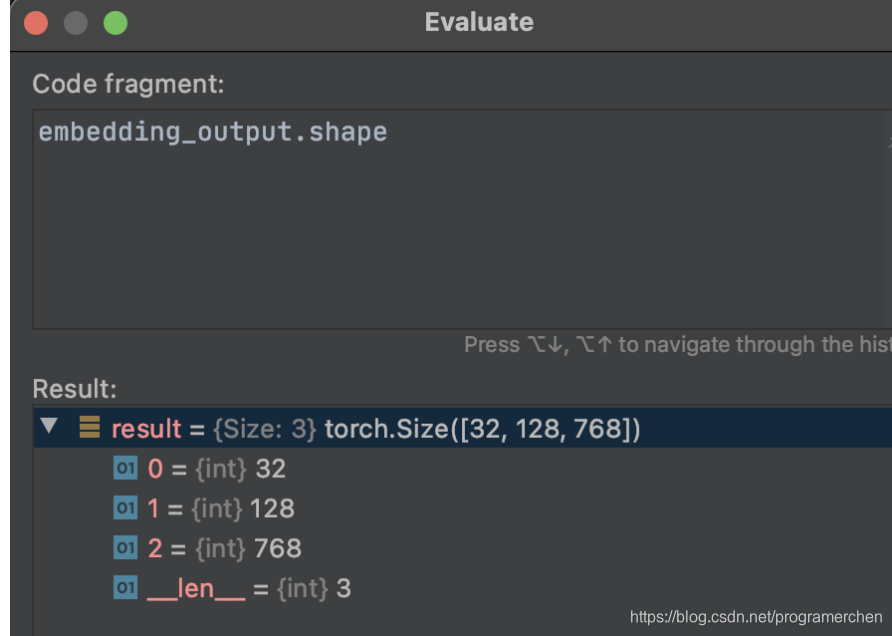
假设batch_size=16,max_seq_len=128:

输出层维度

假设labels维度是112
embeding层
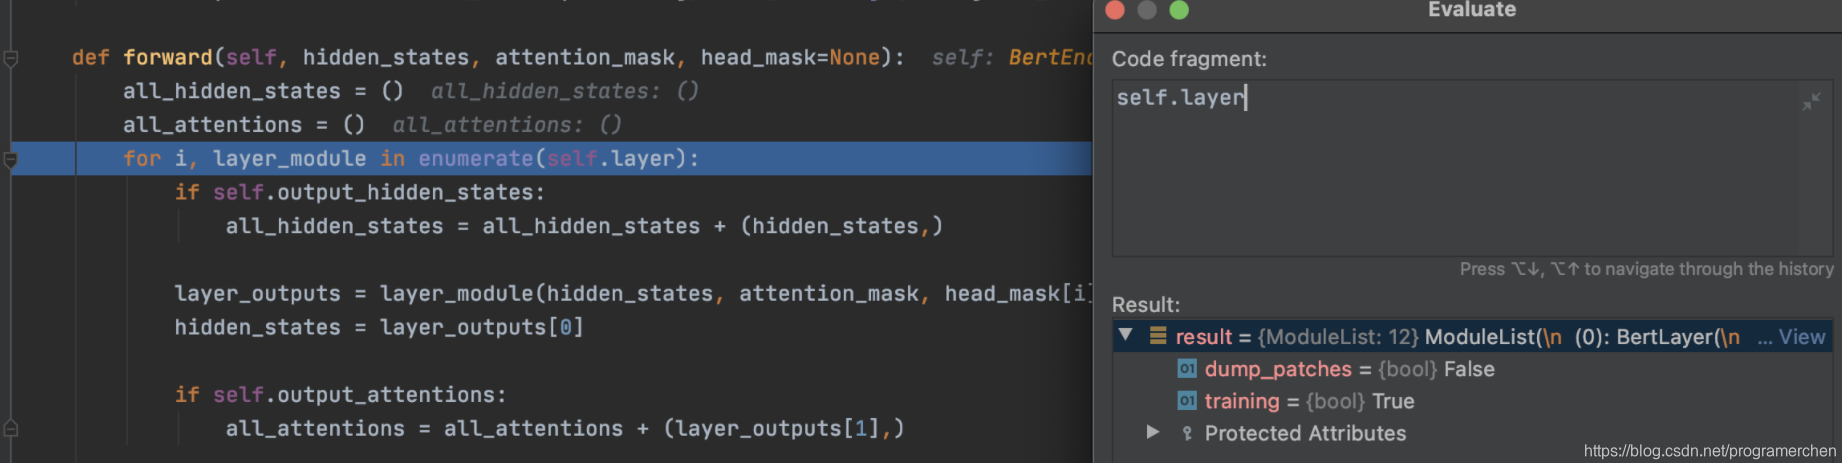
encoder12层
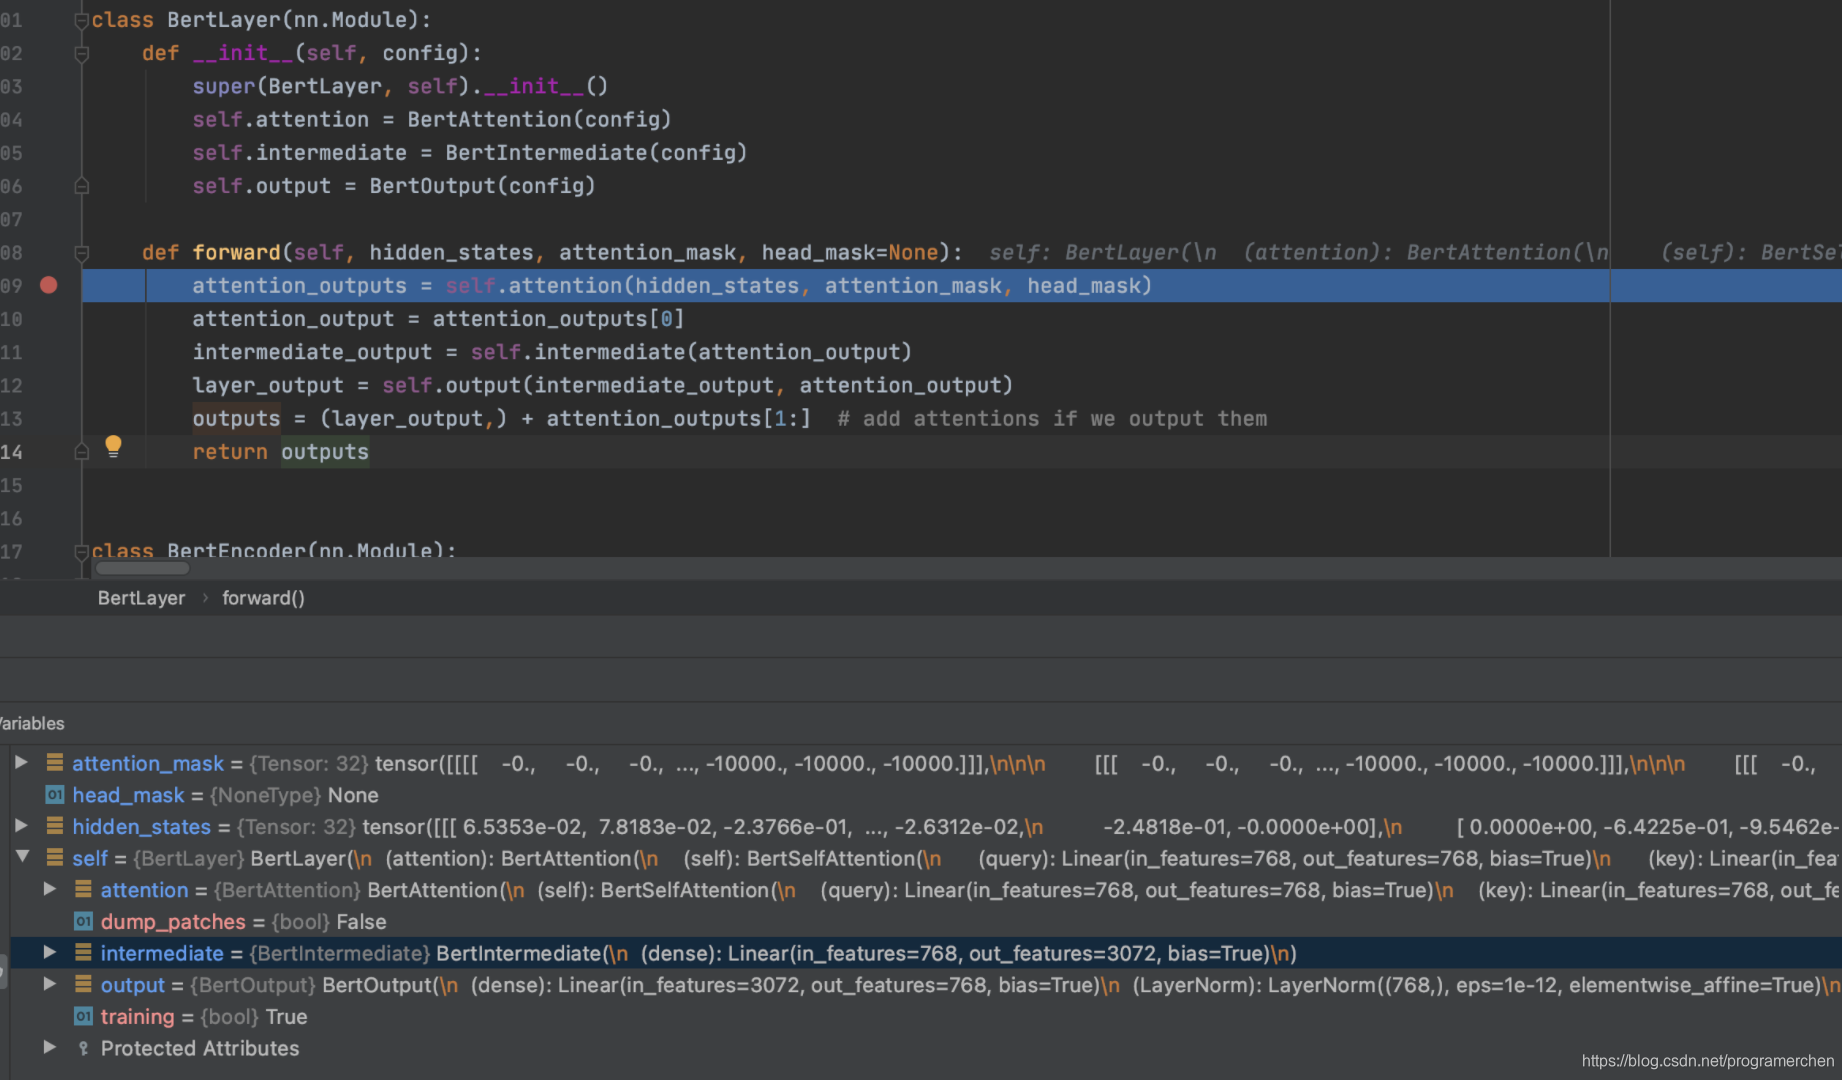
每层每一层的BertLayer进行的操作如下,接一个attention+intermediate+output+整合:
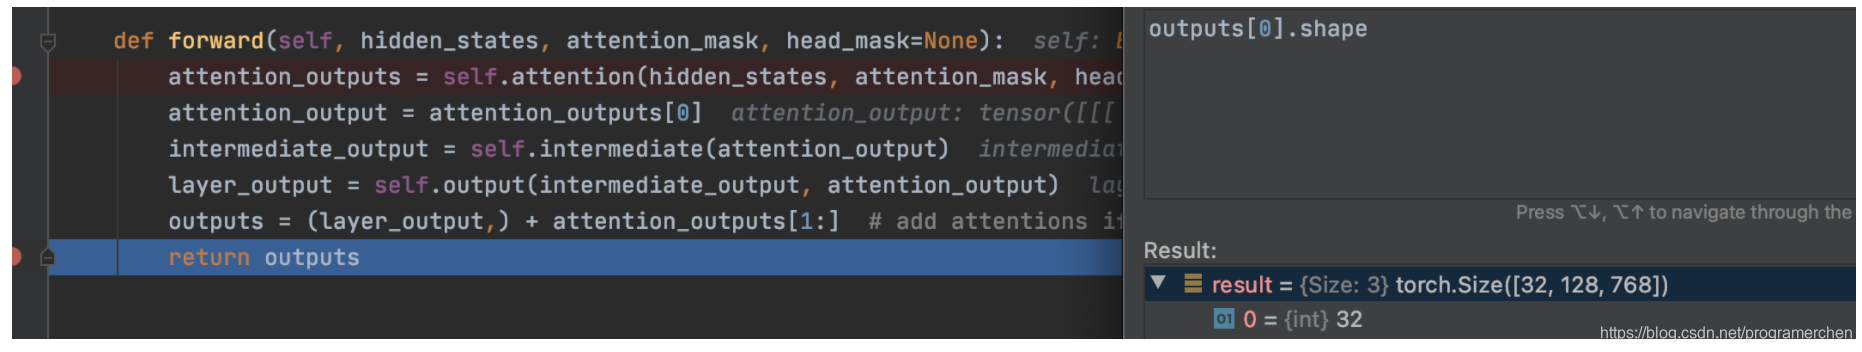
每一层输出也是128*768

BERT的代码实现 由于前馈网络的ffn_num_outputs = num_hiddens,没有初始化传入#__init__()里面的参数,是创建类的时候传入的参数#token_embeddings层#segment_embedding层 (传入两个句子,所以第0维为2)#pos_embedding层 :位置嵌入层是可以学习的, 用nn.Parameter()定义可学习的参数#设置Encoder_block的数量。 阅读详情

相关推荐

BERT+CRF实现中文命名实体识别(TensorFlow)

本篇解读了基于BERT+CRF做中文NER这篇文章中的代码,在该篇作者的GitHub上可以下载源码:源代码。这段代码对BERT模型的实现较为简洁,删掉了谷歌源代码中我们可能用不到的部分,保留了核心部分。对于那些想要快速上手BERT的同学是非常好的学习机会,在看懂这个之后再去学习谷歌的源代码会更加轻松。 BERT-CRF模型 之前有写过BERT模型和CRF模型的详解,建议往下看之前一定要了解这两个模型的原理:结合原理和代码来理解bert模型、结合原理与代码理解BiLSTM-CRF模型(pytorch)。B

Q_M_X_D_D_的博客 1万+

bert code阅读笔记

参考: 参数量计算 https://zhuanlan.zhihu.com/p/144582114 为什么bert中的设置为: size_per_head * num_heads = 768 https://github.com/google-research/bert/issues/316

cuixuange的博客 420

Bert源码解读

谈一谈自己的理解。 Transformer 讲的最好的一篇(我认为) 用pytorch一步步实现 他的multihead应该是错的,不应该吧embediing分开,而应该有多个Q,K,V 错误解决方案请看这篇,或者中文版,并且讲述了bert,吧所有head的output拼在一起,并训练WoW_oWo​使其回归到原来的大小 attention的输出是每一个词的embedding,somehow有其他词的attention。每个词是v1*attention_v1 + v2*attention_v2 … 第

chikeshi的博客 871

pytorch checkpoint_30分钟带你彻底掌握Bert源码(Pytorch),超详细!!不看后悔!!

微信公众号:NLP从入门到放弃我其他文章也还行(不要脸的说)Bert在生产环境的应用需要进行压缩,这就要求对Bert结构很了解,这个仓库会一步步解读Bert源代码(pytorch版本)。仓库地址在DA-southampton/Read_Bert_Code点star不迷路,仓库后期可能手撕bert代码,对bert的最新解读也会放在上面一定要打开这个仓库看看哦,大家可以按照步骤和我的讲解一步步调试代码...

weixin_39801202的博客 1234

Read_Bert_Code:Bert原始码阅读与讲解(Pytorch版本)

伯特源代码解读 Bert在生产环境的应用中需要进行压缩,这就要求对Bert结构很了解,这个仓库会一步一步理解Bert源代码(pytorch版本)。 代码和数据介绍 首先对代码来说,实质上的是这个 我直接把代码克隆过来,放到了本仓库,重新命名为bert_read_step_to_step。 我会使用这个代码,一步步运行bert关于文本分类的代码,然后同时记录下各种细节包括自己实现的情况。 运行之前,需要做两个事情。 准备预训练模型 一个是预训练模型的准备,我使用的是谷歌的中文预训练模型:chinese_L-12_H-768_A-12.zip,模型有点大,我就不上传了,如果本地不存在,就点击下载,或者直接命令行运行 wget https://storage.googleapis.com/bert_models/2018_11_03/chinese_L-12_H-768_A-12.zip 预训练

【大二组培训】2017年电子设计大赛H题总结(软件部分)

文章目录前言一、pandas是什么?二、使用步骤1.引入库2.读入数据总结 前言 例如:随着人工智能的不断发展,机器学习这门技术也越来越重要,很多人都开启了学习机器学习,本文就介绍了机器学习的基础内容。 一、pandas是什么? 示例:pandas 是基于NumPy 的一种工具,该工具是为了解决数据分析任务而创建的。 二、使用步骤 1.引入库 代码如下(示例): import numpy as np import pandas as pd import matplotlib.pyplot as plt im

HAIBARA的博客 3024

BERT代码解读

文章目录本文框架1. BERT定义2. BERT实现2.1 BERT输入2.1.1 Token Embeddings(input_ids)2.1.2. Segment Embeddings(token_type_ids)2.1.3 Position Embeddings(attention_mask)2.2 预训练2.2.1 获取序列的embeddings2.2.2 利用Transformer对序列进行编码3.我的做法4. 结果5. 下一步打算 本文框架 1. BERT定义 BERT全称Bidirecti

wangpan007的博客 6109

python123题目——个税计算器

类型:简单分支。

m0_62488776的博客 5806

【BERT】源码分析(PART I)

点击上方,选择星标或置顶,每天给你送干货!阅读大概需要25分钟跟随小博主,每天进步一丢丢来自:NewBeeNLP写在前面update@2020.02.10最近在看paddle相关,于是就...

zenRRan的博客 615

王爽《汇编语言》课程设计2(不涉及软盘版本)

assume cs:code,ds:data,ss:stack stack segment db 128 dup (0) stack ends data segment db 256 dup (0) data ends code segment start: mov ax,stack mov ss,ax mov sp,128 ...

weixin_41944412的博客 1179

EBS开发_离散工单创建API

--以下代码于20171213在TONY环境中实现 DECLARE     l_iface_rec    wip.wip_job_schedule_interface%ROWTYPE; --工单任务接口表     l_group_id     NUMBER;     l_returnstatus VARCHAR2(40);     l_errormsg     VARCHAR2(2000

蜗牛先生快跑的博客 2596

tensorflow/models NLP模型大全:BERT、Transformer等源码解读

还在为理解现代NLP模型的复杂架构而头疼吗?TensorFlow Models官方仓库提供了最完整的NLP模型实现,从经典的BERT到最新的Transformer变体,本文将带您深入源码,彻底掌握这些核心模型的实现细节。 通过阅读本文,您将获得: - BERT、Transformer等核心模型的完整架构解析 - 源码级别的实现细节和设计思想 - 模块化组件如何组合成完整模型 - 实际应用中的最...

gitblog_00897的博客 734

数字电路实验避坑指南:如何正确搭建主从JK触发器测试电路(附Proteus仿真)

本文详细解析了主从JK触发器的工作原理及实验搭建指南,重点解决了常见的Catching Problem现象,并提供了Proteus仿真优化方案。通过元器件选型、电路连接步骤和常见错误排查,帮助读者正确搭建测试电路,确保数字电路实验的稳定性和可靠性。

weixin_30790841的博客 471

【综述】CV和NLP领域的Transformer原理和实践

本教程包含BERT、ERNIE等20多个的Transformer类模型的原理讲解,同时配套10+基于Transformer类模型的案例实践,我们一起开始学习吧,相信一定会有很多收获。

m0_63642362的博客 527

《QGIS快速入门与应用基础》010:下载过程中常见问题(如网速慢、文件损坏)

针对QGIS下载过程中的常见问题提供了系统解决方案。主要解决下载速度慢(≤100KB/s)和文件损坏两大核心问题:通过切换国内镜像源(如清华大学、阿里云)、使用专业下载工具提升速度;采用MD5/SHA256校验确保文件完整性,并排查存储介质和杀毒软件干扰。文章还包含macOS权限问题、Linux依赖缺失等高频问题的速解方案,并附详细的排查流程图和预防技巧,帮助用户顺利完成QGIS下载。后续将详细介绍安装流程,适合零基础用户参考。

LuckyHanMo的博客 486

SAP BSIS:总账未清项表(Open Items)总账未清项 包含哪些业务 请给以举例说明

SAP总账未清项是指需要未来核销的会计行项目,仅适用于勾选"未清项管理"的总账科目。典型业务场景包括:供应商预付款(借方未清项)、员工备用金(借方未清项)、客户预收款(贷方未清项)和保险理赔(借方未清项)。系统通过表BSIS/BSAS跟踪未清项,支持明细追踪和账实核对。核心价值在于提供总账级别的明细管理能力,确保往来款项完整清账,简化对账流程,满足特殊业务管理需求。可通过FBL3N事务码查询和管理所有总账未清项。

金牌架构师 725

transformer代码精讲、bert三个embedding

今天看到了一个讲解transformer源码的(基于pytorch),颇为详细 https://zhuanlan.zhihu.com/p/375221936 关于attention,可参考 https://spaces.ac.cn/archives/4765/comment-page-1

weixin_37990514的博客 652

【Bug已解决】Auto mode cannot determine the safety of an action — Claude Code 自动模式安全判断失败解决方案

将已知安全的操作添加到白名单,分类器不再拦截这些操作。# 步骤 1:编辑 Claude Code 配置"Read","Write"EOF# 步骤 2:白名单中的操作将自动通过# 不在白名单中的操作仍需分类器判断# 步骤 3:重启 Claude Codeclaude方案适用场景推荐指数难度方案一:手动审批偶发回退,安全优先⭐⭐⭐⭐⭐低方案二:/compact 压缩上下文超限导致⭐⭐⭐⭐低方案三:拆分步骤复杂操作触发⭐⭐⭐⭐低方案四:跳过审批隔离环境,CI/CD。

博客 1万+

硅谷硬核Rasa课程、Rasa培训、Rasa面试系列之:Rasa 3.x部署安装初体验

课程关键词:NLP、Transformer、BERT、GPT、Bayesian、Rasa、Transfer learning、Conversational AI、Classifiers、 Policies、DialogueManagement、NER、Pre-training、Fine-tuning、DIET、TED、SimpleTOD、Bert-DST、ConveRT、Poly-Encoder、Chatbot、E2E、NLU、Policies、Microservices、GraphComponent、..

weixin_67216661的博客 540

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

BERT源码分析PART I

写在前面 BERT模型也出来很久了, 之前有看过论文和一些博客对其做了解读:NLP大杀器BERT模型解读,但是一直没有细致地去看源码具体实现。最近有用到就抽时间来仔细看看记录下来,和大家一起讨论。 注意,本系列阅读需要提前对NLP相关知识有所了解,比如attention机制、transformer框架以及python和tensorflow基础等,关于BERT的原理不是本文的重点。 附上关于BERT...

Kaiyuan_sjtu的博客 2万+

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

bert 源码解读(基于gluonnlp finetune-classifier)

文章目录Bert 论文概述Bert 模型结构embedding 结构attention 结构finetune classifier 结构Bert 模型源码解析tokenizeBERTembeddingencoderattentionpositionwise_ffn与 transformer 简单比较 Bert 论文概述 bert 是 Pre-training of Deep Bidirection...

sinat_34022298的博客 3098

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

bert模型简介、transformers中bert模型源码阅读、分类任务实战和难点总结

1、bert模型简介和原理回顾 2、bert模型源码理解 3、bert模型任务实战 4、bert模型一些难点

HUSTHY的博客 1万+

BERT-base-chinese源码解读:Transformer架构详解

本文介绍了基于星图GPU平台自动化部署bert-base-chinese预训练模型镜像的方法。该平台支持高效运行中文自然语言处理任务,用户可快速实现模型微调与AI应用开发。典型应用场景包括文本分类、语义相似度计算及中文文本特征提取,适用于智能客服、舆情分析等实际业务需求。

weixin_33812391的博客 1069

完全解析!Bert & Transformer 阅读理解源码详解

接上一篇:你所不知道的 Transformer!超详细的 Bert 文本分类源码解读 | 附源码中文情感分类单标签参考论文:https://arxiv.org/abs/1706.03762...

红色石头的专栏 1011

BERT模型实战之多文本分类(附源码)

写在前面 BERT模型也出来很久了,之前看了论文学习过它的大致模型(可以参考前些日子写的笔记NLP大杀器BERT模型解读),但是一直有杂七杂八的事拖着没有具体去实现过真实效果如何。今天就趁机来动手写一写实战,顺便复现一下之前的内容。这篇文章的内容还是以比较简单文本分类任务入手,数据集选取的是新浪新闻cnews,包括了[‘体育’, ‘财经’, ‘房产’, ‘家居’, ‘教育’, ‘科技’, ‘时尚’...

Kaiyuan_sjtu的博客 6万+

BERT详解(3)---源码解读[预训练模型]

2. 预训练模型 bert模型的预训练过程包含两个任务: 下一句预测(Next Sentence Prediction) 遮蔽词预测 主程序在run_pretraining.py中, 进入run_pretraining.py主函数main(_)中,首先看model_fn_builder函数, 该函数中主要有以下几部分:构建BERT模型、构建遮蔽词预测的损失函数、构建Next Sentence ...

orangerfun的博客 6606
上一篇: 火了一年后,知识图谱在哪些场景开始应用?
下一篇: 央行货币政策
programerchen
博客等级 码龄15年 3粉丝 8原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值