


本文没有特意区分它们之间的区别,仅仅是列出其中笔者认为好的设计思想,供后续设计参考。 目前笔者并没有深入代码研究其细节,如有不正确的地方,请斧正。
##概念和术语
- 消息,全称为Message,是指在生产者、服务端和消费者之间传输数据。
- 消息代理:全称为Message Broker,通俗来讲就是指该MQ的服务端或者说服务器。
- 消息生产者:全称为Message Producer,负责产生消息并发送消息到meta服务器。
- 消息消费者:全称为Message Consumer,负责消息的消费。
- 消息的主题:全称为Message Topic,由用户定义并在Broker上配置。producer发送消息到某个topic下,consumer从某个topic下消费消息。
- 主题的分区:也称为partition,可以把一个topic分为多个分区。每个分区是一个有序,不可变的,顺序递增的commit log
- 消费者分组:全称为Consumer Group,由多个消费者组成,共同消费一个topic下的消息,每个消费者消费部分消息。这些消费者就组成一个分组,拥有同一个分组名称,通常也称为消费者集群
- 偏移量:全称为Offset。分区中的消息都有一个递增的id,我们称之为Offset。它唯一标识了分区中的消息。
基本工作机制
架构示意
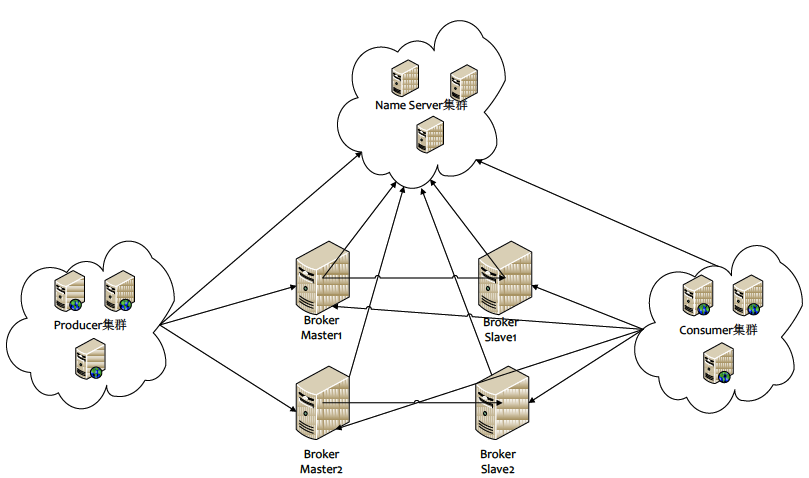
从上图可以看出,有4个集群。其中,Broker集群存在MASTER-SLAVE结构。
多台broker组成一个集群提供一些topic服务,生产者集群可以按照一定的路由规则往集群里某台broker的某个topic发送消息,消费者集群按照一定的路由规则拉取某台broker上的消息。
生产者,Broker,消费者处理消息过程
每个broker都可以配置一个topic可以有多少个分区,但是在生产者看来,一个topic在所有broker上的的所有分区组成一个分区列表来使用。
在创建producer的时候,生产者会从zookeeper上获取publish的topic对应的broker和分区列表。生产者在通过zk获取分区列表之后,会按照brokerId和partition的顺序排列组织成一个有序的分区列表,发送的时候按照从头到尾循环往复的方式选择一个分区来发送消息。
如果你想实现自己的负载均衡策略,可以实现相应的负载均衡策略接口。
消息生产者发送消息后返回处理结果,结果分为成功,失败和超时。
Broker在接收消息后,依次进行校验和检查,写入磁盘,向生产者返回处理结果。
消费者在每次消费消息时,首先把offset加1,然后根据该偏移量找到相应的消息,然后开始消费。只有在成功消费一条消息后才会接着消费下一条。如果在消费某条消息失败(如异常),则会尝试重试消费这条消息,超过最大次数后仍然无法消费,则将消息存储在消费者的本地磁盘,由后台线程继续做重试。而主线程继续往后走,消费后续的消息。
DFX
###顺序性
顺序性是指如果发送消息的顺序是A、B、C,那么消费者消费的顺序也应该是A、B、C。
在单线程内使producer把消息发往同一台服务器的同一个分区,这样就可以按照发送的顺序达到服务器并存储,并按照相同顺序被消费者消费。
###可靠性
Broker存储消息机制
写入磁盘,不意味着数据落到磁盘设备上,毕竟中间还隔着一层os,os对写有缓冲。通常有两个方法来保证数据落到磁盘上:根据处理频率(消息条数)或者时间间隔来force 数据写入到磁盘设备。
Broker灾备
类似mysql的同步和异步复制,将一台master服务器的数据完整复制到另一台slave服务器,并且slave服务器还提供消费功能。在kafka中,它是这样描述的"Each server acts as a leader for some of its partitions and a follower for others so load is well balanced within the cluster. ",简单翻译为,每个服务器充当它自身分区的leader并且充当其他服务器的分区的folloer,从而达到负载均衡。
理论上说同步复制能带来更高的可靠级别,异步复制因为延迟的存在,可能会丢失极少量的消息数据,相应地,同步复制会带来性能的损失,因为要同步写入两台甚至更多的broker机器上才算写入成功。在实际实践中,推荐采用异步复制的架构,因为异步复制的架构相对简单,并且易于维护和恢复,对性能也没有影响。而同步复制对运维要求相对很高,机制复杂容易出错,故障恢复也比较麻烦。异步复制加上磁盘做磁盘阵列,足以应对非常苛刻的数据可靠性要求。
第一次复制因为需要跟master完全同步需要耗费一定时间,你可以在数据文件的目录观察复制情况。
异步复制的slave可以参与消费者的消费活动,消息消费者可以从slave中获取消息并消费,消费者会随机从master和slaves中挑选一台作为消费broker。
性能
使用sendfile调用,减少字节复制开销和系统调用开销
使用 message set概念,进行批量处理,可以增加一次在网络中传输的内容,减少roundtrip开销;并可以带来顺序的磁盘操作和连续的内存块。还可以进行压缩,压缩比例比单次处理高。
异常处理
消息重复
消息的重复包含两个方面,生产者重复发送消息以及消费者重复消费消息。
针对生产者来说,有可能发生这种情况,生产者发送消息,等待服务器应答,这个时候发生网络故障,服务器实际已经将消息写入成功,但是由于网络故障没有返回应答。那么生产者会认为发送失败,则再次发送同一条消息,如果发送成功,则服务器实际存储两条相同的消息。这种由故障引起的重复,MQ是无法避免的,因为MQ不判断消息的data是否一致,因为它并不理解data的语义,而仅仅是作为载荷来传输。
针对消费者来说也有这个问题,消费者成功消费一条消息,但是此时断电,没有及时将前进后的offset存储起来,则下次启动的时候或者其他同个分组的消费者owner到这个分区的时候,会重复消费该条消息。这种情况MQ也无法完全避免。
###生产者的负载均衡和failover
在broker因为重启或者故障等因素无法服务的时候,producer通过zookeeper会感知到这个变化,将失效的分区从列表中移除做到fail over。因为从故障到感知变化有一个延迟,可能在那一瞬间会有部分的消息发送失败。
运维管理
参数维护
- Web管理平台,通过浏览器访问
- 提供restful api,可以参考这里
- 设置jmx端口,通过API或者jconsole等工具查看信息或者修改参数
磁盘空间管理
默认情况下,meta是会保存不断添加的消息,然后定期对“过期”的数据进行删除或者归档处理。可以选择在何时开始删除、备份数据,删除、备份多长时间之前的数据。
系统设计选型
为什么把Topic分成多个分区?
Topic分成多个分区分成多个文件,可以防止单个Topic的文件内容过大。每个分区只能被消费者群组里面的一个消费者消费。另外,还可以选择把Topic的部分分区复制到follower上,从而达到负载均衡和failover的目的。
为什么需要消费者群组
首先,传统上存在两种模型:queue和topic。queue保证只有一个消费者能够消费到内容;topic是广播给所有消费者,让它们消费。
在设计时约定,一个消息可以被不同的消费者群组消费,每个消费者群组只能消费一次。这样如果只有一个消费者群组,那么达到queue的语义;如果有多个消费者群组,那么达到topic的语义
为什么选择以页面缓存为中心的设计
节选自分布式发布订阅消息系统 Kafka 架构设计翻译: 线性写入(linear write)的速度大约是300MB/秒,但随即写入却只有50k/秒,其中的差别接近10000倍。线性读取和写入是所有使用模式中最具可预计性的一种方式,当代操作系统已经提供了预读(预先读取多个块,加载到内存里)和后写(合并一组小数据量写,然后一次写入)的技术。
现代操作系变得越来越积极地将主内存用作磁盘缓存。所有现代的操作系统都会乐于将所有空闲内存转做磁盘缓存,即时在需要回收这些内存的情况下会付出一些性能方面的代价。所有的磁盘读写操作都需要经过这个统一的缓存。想要舍弃这个特性都不太容易,除非使用直接I/O。
因此,对于一个进程而言,即使它在进程内的缓存中保存了一份数据,这份数据也可能在OS的页面缓存(pagecache)中有重复的一份,结构就成了一份数据保存了两次。同时,注意到,Java对象的内存开销(overhead)非常大,往往是对象中存储的数据所占内存的两倍(或更糟)。Java中的内存垃圾回收会随着堆内数据不断增长而变得越来越不明确,回收所花费的代价也会越来越大。
由于这些因素,使用文件系统并依赖于页面缓存要优于自己在内存中维护一个缓存或者什么别的结构 —— 通过对所有空闲内存自动拥有访问权,我们至少将可用的缓存大小翻了一倍,然后通过保存压缩后的字节结构而非单个对象,缓存可用大小接着可能又翻了一倍。这么做下来,在GC性能不受损失的情况下,我们可在一台拥有32G内存的机器上获得高达28到30G的缓存。而且,这种缓存即使在服务重启之后会仍然保持有效,而不象进程内缓存,进程重启后还需要在内存中进行缓存重建(10G的缓存重建时间可能需要10分钟),否则就需要以一个全空的缓存开始运行(这么做它的初始性能会非常糟糕)。这还大大简化了代码,因为对缓存和文件系统之间的一致性进行维护的所有逻辑现在都是在OS中实现的,这事OS做起来要比我们在进程中做那种一次性的缓存更加高效,准确性也更高。如果你使用磁盘的方式更倾向于线性读取操作,那么随着每次磁盘读取操作,预读就能非常高效使用随后准能用得着的数据填充缓存(这也就是offset的递增顺序读取,能够大量读IO的性能)。
Push vs. Pull
消费者主动从Broker上面拉取消息还是Broker主动把消息推送给消费者?其实是各有利弊。
基于push机制的系统很难控制把数据下发给不同消费者的速度。有可能会导致消费者过载。这方面,pull做的比较好。消费者可以自己控制处理数据的速度。
另外,pull-based 消费者可以批量获取数据。push-base的broker就比较难处理,是每次发送单个消息还是批量发送?如果是批量发送,每次发送多少个?
Pull不好的是,如果broker没有数据的话,pull-based 消费者可能会忙等。这个问题可以通过"long poll"机制来解决(相当于Java的Future.get)。
消费者位置
大部分消息使用元数据来记录哪些Broker的消息被消费了。也就是说,当消息传递给消费者后,Broker记录下或者等待消费者的acknowledge后再记录。但是这里存在很多问题。如果当消息通过网络传递给消费者,而此时如果消费者没有来得及处理就宕机了,但是Broker却记录了该消息已被消费,那么该消息将被丢失。为了避免这种情况,很多消息消息系统会增加一个acknowledge特性,标识该消息被成功消费。然后消费者将acknowledge发送给Broker,而Broker不一定能够获得这个acknowledge,进而导致消息被重复消费。其次这种方法还导致网络开销以及服务器端必须维护消息的处理状态。
在类Kafka系统中,主题是由多个有序的分区组成的。每个分区在任意时刻只能被一个消费者消费。这意味着,每个分区里面的消费者位置仅仅是个整数,标识下一个被消费消息的offset。这样维护哪些消息被消费就简单多了,比如通过定期的设置检查点。
消息分发语义
类Kafka在分发消息时,有3类保障:
- 至多一次(At most once):消息可能丢失,但是不会被重发
- 至少一次(At least once):消息不可能丢失,但是可能被重发
- 几乎一次(Exactly one):消息被分发一次并且仅仅一次
可以将问题分为两类:消息发送的持久化保障和消息消费的持久化保障
这个其实没有完美的办法来处理。当生产者发送消息时,可以通过在消息上面设置主键,然后万一失败时尝试再次发送,Broker可以回复相应的确认消息。
当消费者消费消息时,分为3种情况:
- 读取消息,保存offset,处理消息。然后处理消息时崩溃。针对“至多一次”场景。
- 读取消息,处理消息,保存offset。然后保存offset崩溃。针对“至少一次”场景。
- 经典的做法是在保存offset和处理消息这两个环节采用two-phase commit(2PC)。在Kafka中,一种简单的方法就是可以把offset和处理后的结果一起存储。
复制
Kafka可以把每个主题的分区复制到若干个服务器上(参数可配)。很多消息系统如果要提供复制相关的特性,担心复制会影响到吞吐量,所以一般需要繁琐的手工配置。而在Kafka中,它默认提供了复制特性--用户可以把复制银子设置成1,则相当于是不复制。
每个分区有1个leader和0或者多个followers。
节点处于“alive”由以下两个条件组成:
- 必须和zk存在session 2.如果该节点是slave,那么它必须保证写复制距离leader不远。
leader保存了所有正在进行同步的节点列表。如果follower死了,或者离leader太远,leader将把它从节点中remove掉。“离leader太远”这个定义可以通过延迟的消息数和延迟的时间参数来定义。
一个消息,只有当所有in-sync复制节点完成了复制后,才能标记为“commited”。只有处于“commited”的消息才能够被消费。另一方面,生产者可以权衡延迟和持久化这两个因素,设置是否等待消息被commit或者等待多少个ack。
###采用pull模型,消息的实时性有保证吗?
消息的实时性受很多因素影响,不能简单地说实时性一定会降低,主要影响因素如下
- broker上配置的批量force消息的阈值,force消息的阈值越大,则实时性越低。
- 消费者每次抓取的数据大小,这个值越大,则实时性越低,但是吞吐量越高。
- Topic的分区数目对实时性也有较大影响,分区数目越多,则磁盘压力越大,导致消息投递的实时性降低。
- 消费者重试抓取的时间间隔,越长则延迟越严重。
- 消费者抓取数据的线程数
###消息的存储结构
在Kafka中,消息格式是如下
/**
 * A message. The format of an N byte message is the following:
 *
 * If magic byte is 0
 *
 * 1. 1 byte "magic" identifier to allow format changes
 *
 * 2. 4 byte CRC32 of the payload
 *
 * 3. N - 5 byte payload
 *
 * If magic byte is 1
 *
 * 1. 1 byte "magic" identifier to allow format changes
 *
 * 2. 1 byte "attributes" identifier to allow annotations on the message independent of the version (e.g. compression enabled, type of codec used)
 *
 * 3. 4 byte CRC32 of the payload
 *
 * 4. N - 6 byte payload
 *
 */
磁盘上消息格式如下:
message length : 4 bytes (value: 1+4+n)
"magic" value  : 1 byte
crc            : 4 bytes
payload        : n bytes
Metaq的消息格式如下
message length(4 bytes),包括消息属性和payload data
checksum(4 bytes)
message id(8 bytes)
message flag(4 bytes)
attribute length(4 bytes) + attribute,可选
payload
其中checksum采用CRC32算法计算,计算的内容包括消息属性长度+消息属性+data,消息属性如果不存在则不包括在内。消费者在接收到消息后会检查checksum是否正确。
以下节选自Metaq文档
同一个topic下有不同分区,每个分区下面会划分为多个文件,只有一个当前文件在写,其他文件只读。当写满一个文件(写满的意思是达到设定值)则切换文件,新建一个当前文件用来写,老的当前文件切换为只读。文件的命名以起始偏移量来命名。看一个例子,假设meta-test这个topic下的0-0分区可能有以下这些文件:
- 00000000000000000000000000000000.meta
- 00000000000000000000000000001024.meta
- 00000000000000000000000000002048.meta
- ……
其中00000000000000000000000000000000.meta表示最开始的文件,起始偏移量为0。第二个文件00000000000000000000000000001024.meta的起始偏移量为1024,同时表示它的前一个文件的大小为1024-0=1024。同样,第三个文件00000000000000000000000000002048.meta的起始偏移量为2048,表明00000000000000000000000000001024.meta的大小为2048-1024=1024。
以起始偏移量命名并排序这些文件,那么当消费者要抓取某个起始偏移量开始位置的数据变的相当简单,只要根据传上来的offset二分查找文件列表,定位到具体文件,然后将绝对offset减去文件的起始节点转化为相对offset,即可开始传输数据。例如,同样以上面的例子为例,假设消费者想抓取从1536开始的数据1M,则根据1536二分查找,定位到00000000000000000000000000001024.meta这个文件(1536在1024和2048之间),1536-1024=512,也就是实际传输的起始偏移量是在00000000000000000000000000001024.meta文件的512位置。
对zookeeper的使用
Broker Node Registry
/brokers/ids/[0...N] --> host:port (ephemeral node) [0...N]表示是broker id,每个broker id 必须唯一。在broker启动时就完成注册。 含义是每个broker对应的host:port
Broker Topic Registry
/brokers/topics/[topic]/[0...N] --> nPartions (ephemeral node) 含义是每个broker id 对应主题的分区数
Consumer Id Registry
消费者群组含有多个消费者,不同消费者名称不同。每个消费者含有一个group id属性。
/consumers/[group_id]/ids/[consumer_id] --> {"topic1": #streams, ..., "topicN": #streams} (ephemeral node)
含义是每个消费者群组下面的消费者所消费的topic列表。
Consumer Offset Tracking
/consumers/[group_id]/offsets/[topic]/[broker_id-partition_id] --> offset_counter_value ((persistent node)
每个消费者群组对某个主题的服务器id-分区id消费的offset_counter_value
Partition Owner registry
/consumers/[group_id]/owners/[topic]/[broker_id-partition_id] --> consumer_node_id (ephemeral node)
含义是某消费者群组的某个consumer_node_id对某个主题的服务器id-分区id消费
Broker node registration
当新borker加入是,它注册在broker节点下,value是hostname和port。它同时也注册它含有的topic列表和topic的分区情况。新主题被创建时会自动注册到zk上。
Consumer registration algorithm
当消费者启动时:
- 把自己注册到某个消费者群组
- 在consumer id下,注册监听change事件(新消费者离开或者加入),每次变化会重新计算该群组下的消费者负载。
- 在broker id下,注册监听change事件(新borker离开或者加入),每次变化会重新计算所有消费者群组的消费者负载。
- 如果某个消费者使用了topic filter机制,那么它会在broker topic下注册change事件(新主题加入),每次变化会重新计算相关联的topic的消费者的负载。
- 当自己加入后,重新计算消费者群组的消费者负载。
Consumer rebalancing algorithm
一个分区只能被一个消费者消费,这样可以避免不必要的同步机制。具体算法如下:
- For each topic T that C<sub>i</sub> subscribes to
- let P<sub>T</sub> be all partitions producing topic T
- let C<sub>G</sub> be all consumers in the same group as C<sub>i</sub> that consume topic T
- sort P<sub>T</sub> (so partitions on the same broker are clustered together)
- sort C<sub>G</sub>
- let i be the index position of C<sub>i</sub> in C<sub>G</sub> and let N = size(P<sub>T</sub>)/size(C<sub>G</sub>)
- assign partitions from i*N to (i+1)*N - 1 to consumer C<sub>i</sub>
- remove current entries owned by C<sub>i</sub> from the partition owner registry
- add newly assigned partitions to the partition owner registry (we may need to re-try this until the original partition owner releases its ownership)
中文伪码如下:
        set $topicList = $consumer.subscrbe
        for each $topic in $topicList //针对某个消费者订阅的所有主题
	set $partitionList = $topic.partitions //获得主题的所有分区
	set $comsumerList = ($topic.comsumers and $consumser.group.consumsers )//获得消费该主题的所有消费者并且这些消费者均是与当前消费者是同一个群组的
	$partitionList.sort() //like broker0-p0,broker0-p1 ,broker1-p0,broker1-p1
	$comsumerList.sort()
	set $consumerIndex =  $comsuserList.getIndex($consumser) //获得当前消费者在群组里面的索引
	set $N = $partitionList.size()/$comsuserList.size()//获得分区数除以消费者数的商
	//好吧,后面几句话实在没看懂,估计要看源码,郁闷。//TODO
RocketMQ的简单介绍
由于目前RocketMQ的系统性介绍文档不是很全,且由于笔者时间有限,仅仅是粗略翻了下。发现有几个值的一说的地方。
消息过滤
支持Broker端消息过滤,在Broker中,按照Consumer的要求做过滤,优点是减少了对于Consumer无用消息的网络传输。缺点是增加了Broker的负担,实现相对复杂。
支持Consumer端消息过滤。这种过滤方式可由应用完全自定义实现,但是缺点是很多无用的消息要传输到Consumer端。
零拷贝选型
Consumer消费消息过程,使用了零拷贝,零拷贝包含以下两种方式
- 使用mmap + write方式 优点:即使频繁调用,使用小块文件传输,效率也很高 缺点:不能很好的利用DMA方式,会比sendfile多消耗CPU,内存安全性控制复杂,需要避免JVM Crash问题。
- 使用sendfile方式 优点:可以利用DMA方式,消耗CPU较少,大块文件传输效率高,无内存安全新问题。 缺点:小块文件效率低于mmap方式,只能是BIO方式传输,不能使用NIO。 RocketMQ选择了第一种方式,mmap+write方式,因为有小块数据传输的需求,效果会比sendfile更好。
服务发现
Name Server是专为RocketMQ设计的轻量级名称服务,代码小于1000行,具有简单、可集群横向扩展、无状态等特点。将要支持的主备自动切换功能会强依赖Name Server。
后记
如果不阅读源码,总感觉少了些什么的。
对英文的翻译还是比较生硬
核心是对独到的模型设计,对zookeeper的运用非常巧妙,以及对众多细节的考虑。的确是个非常优秀的MQ。
下一个坑,完成对zk源码的阅读。
 767


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


