工作流编排平台深度分析:Apache Airflow vs. Apache DolphinScheduler

DolphinScheduler vs Airflow:大数据任务调度工具选型指南 本文深度对比了DolphinScheduler与Airflow两大主流大数据任务调度工具,从核心架构、工作流定义、企业级功能、运维监控、扩展性等多个维度进行详细分析。DolphinScheduler凭借其分布式无中心化设计、可视化DAG构建和强大的企业级功能,在高吞吐量、低延迟场景下表现优异,特别适合需要处理超大规模任务流的企业。 阅读详情

引言

在现代数据技术栈中,工作流编排平台是实现复杂数据管道自动化、调度和监控的核心组件。在众多开源解决方案中,Apache Airflow 和 Apache DolphinScheduler 已成为两个最引人注目的领导者。然而,它们代表了两种截然不同的设计哲学和架构范式。本报告旨在对这两个平台进行详尽的比较分析,为技术领导者、数据工程经理和解决方案架构师在选择最适合其组织需求的工具时提供一个明确、深入的决策依据。

本次分析的核心在于两大平台根本性的哲学分歧:Airflow 坚定地奉行“工作流即代码”(Workflow-as-Code)的理念,而 DolphinScheduler 则倡导“可视化优先、低代码”的方法。这一分歧不仅仅是用户界面的差异,它深刻地影响了平台的架构设计、目标用户、可扩展性模式、治理模型以及企业级功能的实现方式。

  • 核心差异综述:

    • 架构与可扩展性:Airflow 采用基于组件的集中式架构,其可扩展性高度依赖于所选的执行器(Executor);而 DolphinScheduler 采用原生分布式、去中心化的多 Master/多 Worker 架构,通过 ZooKeeper 实现协调,天生具备高可用性。

    • 用户体验与开发模式:Airflow 是一个以开发者为中心的平台,要求用户具备 Python 编程能力,以代码形式定义、版本化和测试工作流。DolphinScheduler 则通过其强大的拖拽式图形界面,极大地降低了使用门槛,旨在实现数据管道创建的“民主化”,让数据分析师和科学家也能参与其中。

    • 企业级功能:DolphinScheduler 在多租户、资源隔离和工作流版本控制等企业级功能上提供了更完善的开箱即用支持。而在 Airflow 中,实现同等级别的功能通常需要复杂的配置、自定义开发和严格的平台工程实践。

    • 社区与生态系统:Airflow 拥有一个更庞大、更成熟的社区和极其丰富的第三方集成生态系统,这使其在解决问题和对接多样化服务方面具有显著优势。DolphinScheduler 的社区虽然规模较小,但增长迅速,并专注于大数据生态系统的深度集成。

本报告将从基础哲学、架构设计、用户体验、功能特性、企业级能力以及社区生态等多个维度展开详细论述,并最终提供一个战略性的决策框架,帮助组织根据其自身的技术栈、团队技能、治理需求和扩展目标,做出最明智的选择。

表 1:高级功能比较矩阵
特性/维度 Apache Airflow Apache DolphinScheduler
核心哲学 工作流即代码 (Workflow-as-Code),强调编程的灵活性和可扩展性。 可视化优先,低代码/无代码,旨在降低使用门槛,实现数据大众化。
主要用户 数据工程师、具备 Python 技能的开发者。 数据工程师、数据分析师、数据科学家、运维人员。
核心架构 集中式调度器(2.x后支持多调度器),组件化设计,可插拔执行器。 去中心化,多 Master/多 Worker,基于 ZooKeeper 协调的原生分布式架构。
高可用性 (HA) 通过配置冗余组件(如多调度器、多Webserver)和高可用元数据数据库实现。 架构原生支持,通过 ZooKeeper 实现 Master 自动故障转移和选举。
工作流定义 纯 Python 代码(DAG 文件),支持动态生成。 主要通过 Web UI 拖拽创建,同时支持 Python SDK 和 YAML 定义。
多租户 原生不支持,实现成本高,需通过复杂配置(如K8s Executor)或多实例部署达成。 原生支持,提供租户、用户、Worker 组等多层级隔离。
资源管理 通过资源池(Pools)限制并发,通过队列(Queues)将任务路由到特定 Worker。 通过 Worker 组将任务绑定到特定机器,提供更强的物理资源隔离。
社区规模 极其庞大且成熟,拥有海量的贡献者和第三方资源。 规模较小但增长迅速,尤其在亚太地区非常活跃。
生态系统广度 极广,拥有数百个官方和社区贡献的提供商(Providers),覆盖各类SaaS和云服务。 较集中,深度集成主流大数据组件(Spark, Flink, Hive等),第三方集成较少。

第一部分:基础哲学与核心概念

选择一个工作流编排工具,远不止是选择一系列功能,更是选择一种构建、管理和治理数据管道的哲学。Apache Airflow 和 Apache DolphinScheduler 在这一点上展现了截然不同的理念,这些理念从根本上塑造了它们的每一个方面。

A. Apache Airflow:“工作流即代码”的范式
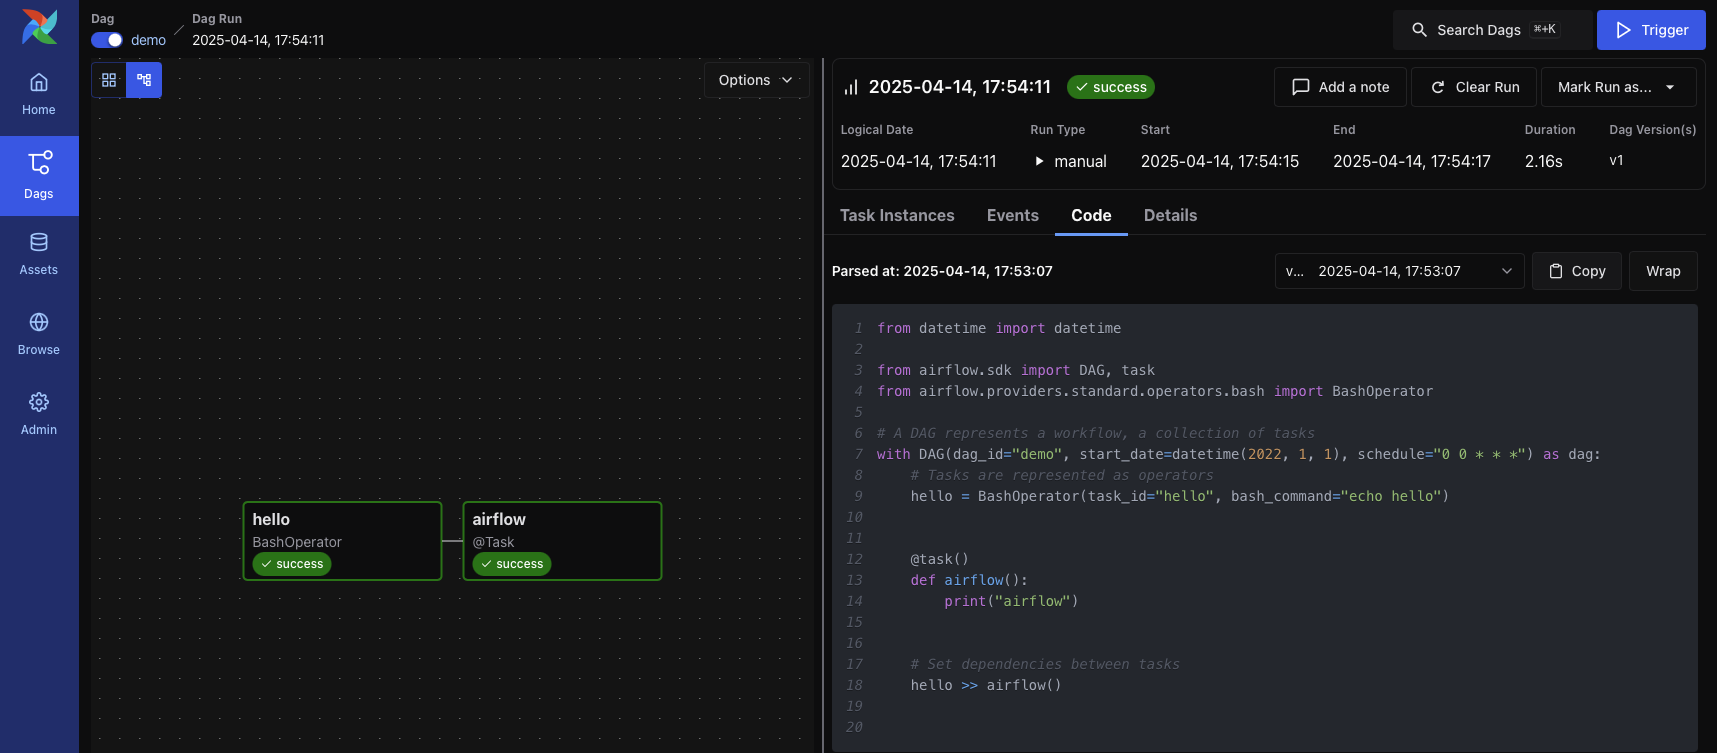
Apache Airflow 的核心身份是一个用于以编程方式创作、调度和监控工作流的平台。其最根本的信条是将数据管道定义为代码,具体来说是 Python 代码。这一原则赋予了工作流前所未有的动态性、灵活性和可维护性。开发者可以利用 Python 的全部功能,如循环、条件判断、类继承等,来动态生成复杂的任务流,这超越了静态配置文件所能达到的极限。

这种“工作流即代码”的方法带来了软件工程最佳实践在数据工程领域的应用。数据管道可以像任何其他软件一样被版本控制(例如使用 Git)、进行代码审查、编写单元测试和集成测试,从而极大地提高了数据管道的健壮性和协作效率。

在 Airflow 的世界里,核心概念紧密围绕代码展开:

  • DAG (Directed Acyclic Graph):有向无环图是 Airflow 工作流的蓝图。它是一个 Python 文件,定义了一个由任务组成的集合,以及这些任务之间的依赖关系和执行顺序。

  • Operator:算子是预定义的任务模板,封装了执行特定工作的逻辑,例如 BashOperator 用于执行 Bash 命令,PythonOperator 用于执行 Python 函数。它们是构成 DAG 的基本构建块,决定了“做什么”。

  • Task:任务是 Operator 在 DAG 中被实例化的一个节点。一个 Operator 类可以被多次实例化,从而在同一个 DAG 中创建多个具有不同参数的任务。

B. Apache DolphinScheduler:可视化优先、低代码的方案
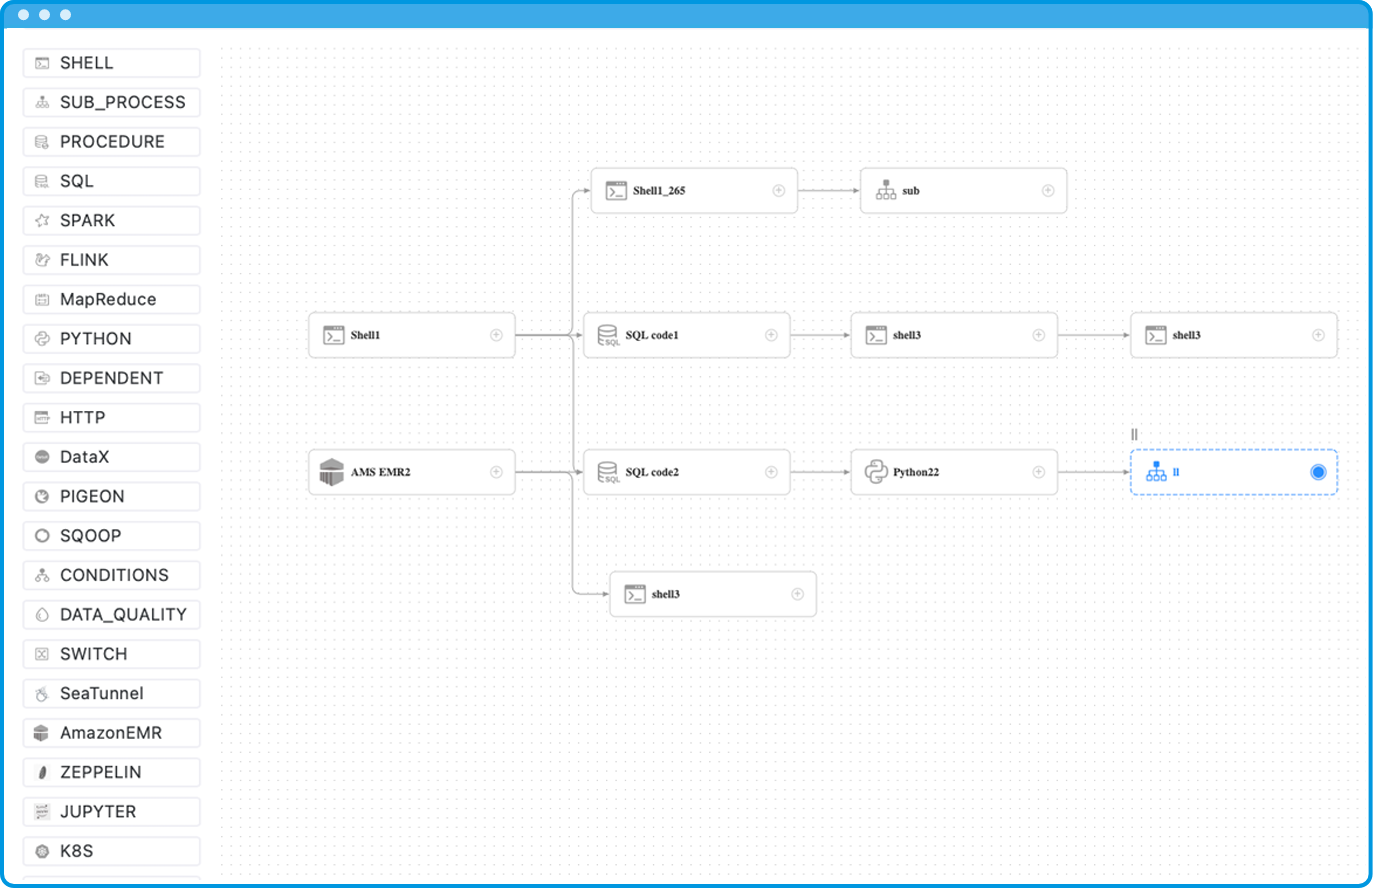
Apache DolphinScheduler 的诞生,很大程度上是对 Airflow 等代码优先工具所带来的高学习曲线和复杂性的一种回应。它的核心目标是通过提供一个强大的可视化 DAG 界面,来解决复杂的数据任务依赖问题,使得非专业开发者也能轻松上手。

DolphinScheduler 的首要交互方式是其基于 Web 的拖拽式画布。用户可以从工具面板中选择不同的任务类型(如 Shell、SQL、Spark),将它们拖到画布上,然后通过连接线来定义它们之间的依赖关系。这种方式极其直观,对于构建标准化的 ETL 流程,几乎不需要任何编码知识,从而极大地提高了效率并降低了出错的可能性。这种设计理念旨在“民主化”数据管道的创建过程,让数据分析师、数据科学家甚至业务人员都能参与到工作流的构建中来。

然而,DolphinScheduler 并非仅限于可视化操作。它深刻理解工程师对于代码控制和自动化(CI/CD)的需求,因此提供了强大的 PyDolphinScheduler Python SDK 和对 YAML 文件定义的支持。这使得开发者依然可以采用“工作流即代码”的模式,将工作流定义纳入版本控制和自动化部署流程,实现了两种模式的互补。

C. 核心抽象的比较分析

尽管两个平台都以 DAG 作为工作流的基础模型,但它们对这一核心抽象的实现和管理方式却大相径庭,这直接反映了它们的设计哲学。

  • DAG/工作流的本质:在 Airflow 中,DAG 本身就是一个 Python 对象。调度器通过扫描指定的目录,动态地发现并解析这些 Python 文件来加载 DAG。DAG 的定义和它的代码表示是同一的。而在 DolphinScheduler 中,工作流(在旧版本中称为“流程定义”)的本质是一个存储在元数据数据库中的配置实体,通常是一个 JSON 对象。这个实体可以通过多种途径创建:UI 上的可视化操作、调用 API 接口,或是通过 PyDolphinScheduler SDK 提交。这种架构上的差异意味着,Airflow 的工作流定义是“文件系统驱动”的,而 DolphinScheduler 是“数据库驱动”的。这一根本区别对系统的架构、扩展性和状态管理产生了深远影响。例如,DolphinScheduler 的 Worker 节点在执行任务时是无状态的,它们不需要访问整个 DAG 的定义文件,只需从 Master 接收具体的任务指令即可,这简化了 Worker 节点的扩展。

  • 任务/算子的交互:Airflow 的生态系统以其丰富的 Ope

Apache Airflow、DolphinScheduler 和 Temporal 是三种不同的分布式任务调度和工作流管理系统 Apache Airflow、DolphinScheduler 和 Temporal 是三种不同的分布式任务调度和工作流管理系统,各自的设计理念和适用场景不同。以下是对它们从功能、架构、优势和使用场景等方面的详细对比。 阅读详情

相关推荐

Apache DolphinScheduler对比Azkaban、Airflow

  DolphinScheduler Azkaban Airflow 稳定性       单点故障 去中心化的多Master和多Worker 是 单个Web和调度程序组合节点 是 单一调度程序 HA额外要求 不需要(本身就支持HA) DB Celery / Dask / Mesos + L...

d66380022的专栏 9834

DolphinScheduler vs Airflow:大数据调度工具选型指南(2024最新对比)

本文深度对比了2024年大数据调度工具DolphinScheduler与Airflow的架构设计、核心功能、性能表现及企业级特性,帮助企业在复杂工作流场景下做出最优选型决策。重点分析了DolphinScheduler的去中心化双集群架构优势,以及Airflow的Python DSL灵活性,并提供了金融风控和实时推荐等典型场景的配置示例。

weixin_29306011的博客 357

大数据5V特征深度解析:从理论到实战的技术架构与工程挑战

大数据技术体系的核心在于应对海量、高速、多样、低价值密度和真实性要求的数据处理挑战。其基本原理是通过分布式存储与计算架构,如Hadoop HDFS和Spark,实现数据的水平扩展与并行处理,从而突破单机性能瓶颈。这一技术架构的价值在于能够将原始数据转化为可支持实时决策与深度分析的资产,广泛应用于物联网实时监控、电商用户行为分析和企业数据仓库构建等场景。本文聚焦于大数据5V特征(Volume, Velocity, Variety, Value, Veracity),结合分布式计算和数据质量监控等关键技术,深入

weixin_30920513的博客 390

upsql:基于文件上传的即时SQL查询工具设计与实现

在数据处理领域,SQL作为结构化查询语言,是访问和分析数据库的核心技术。其原理是通过声明式语法对数据进行操作,技术价值在于高效、灵活地处理结构化数据,广泛应用于数据分析、报表生成等场景。随着数据来源多样化,如何快速对零散的Excel、CSV等文件进行即时查询成为常见需求。联邦查询技术允许跨异构数据源执行SQL,而临时表管理则是实现数据暂存和快速访问的关键机制。本文聚焦的upsql工具,正是将文件上传与SQL查询深度结合,通过自动类型推断和智能临时表管理,实现了“即传即查”的轻量级解决方案,有效提升了数据探索

技术百科 698

基于XGBoost与Spark的新能源汽车市场预测系统实战指南

数据挖掘是从海量数据中提取有价值信息的关键技术,其核心原理在于通过算法发现数据中的模式与规律。机器学习作为实现数据挖掘的重要工具,通过构建模型学习数据特征并进行预测,在商业分析领域展现出巨大技术价值。XGBoost作为高效的梯度提升算法,凭借其出色的预测精度和处理复杂特征的能力,成为结构化数据预测任务的首选。结合大数据平台Spark的分布式计算优势,能够高效处理多源、高维的市场数据。本文聚焦新能源汽车行业,详细解析如何运用XGBoost算法与Spark平台,构建端到端的市场分析与需求预测系统,涵盖从数据采集

weixin_34354173的博客 430

【信息科学与工程学】【数据中心】第二十四篇 数据中心DaaS场景及算法

Flink, Kafka Streams, 时序数据库。Flink, Kafka Streams, 流处理引擎。Presto, ClickHouse, 查询加速引擎。Presto, ClickHouse, 查询加速引擎。延迟<50ms,可用性>99.99%,QPS>10K。REST API, GraphQL, API网关。Tableau, Power BI, 自助BI。Tableau, Power BI, 可视化库。Spark, Hadoop, 分布式计算框架。Spark, Hadoop, 分布式计算。

weixin_49199313的博客 1089

【信息科学与工程学】【数据科学】数据科学领域-第十一篇 数据集成算法01

​​降低维护成本​​:通过抽象通用流程(如),当需要修改故障注入逻辑(如更换混沌工具)时,只需修改一处代码,无需修改所有测试用例;​​提升扩展性​​:通过参数化故障场景(如),可快速生成新的故障用例(如针对新服务的延迟故障),适应系统迭代需求;​​增强场景真实性​​:通过组合混沌操作(如),模拟真实生产环境中的复杂故障链(如“网络延迟+服务宕机”),更准确地验证系统韧性;​​提高分析效率​​:通过自动化结果分析(如),快速获取MTTR、错误率等关键指标,减少人工分析时间。

weixin_49199313的博客 957

【信息科学与工程学】【解决方案体系】【系统工程】 第三十五篇 AI + ICT + 云计算 + 网络解决方案​ 的软件配置清单01

AI + ICT + 云计算 + 网络解决方案​ 的软件配置清单。需要说明:结合当前主流通用 CAE、数学建模、AI 框架、云原生与网络仿真工具整理出的推荐软件栈。软件 / 平台功能说明Kubernetes (K8s)​容器编排,承载 AI 训练、仿真任务调度、微服务化网络功能(CNF)OpenStack / 云管平台​私有云 IaaS 底座,提供虚拟机、GPU 算力、VPC 网络Slurm / Altair PBS​HPC 集群作业调度,支撑大规模电磁 / CFD / 光子仿真Docker / Singu

weixin_49199313的博客 415

【信息科学与工程学】计算机科学与自动化 第二百零一十一 软件开发模型01

编号类型模型领域模型中的知识点/因素/参数关联知识和法律法规1传统顺序模型瀑布模型 (Waterfall)通用软件开发、硬件紧密耦合系统、政府/军工项目、需求稳定的传统信息系统严格线性阶段:可行性研究→需求分析(SRS,含功能/非功能/接口/约束,使用IEEE 830模板)→系统设计(概要设计HLD:架构、模块划分、数据库ER图;详细设计LLD:伪代码、类图、接口定义)→实现(编码规范、代码审查、静态分析工具SonarQube)→测试(单元测试JUnit、集成测试、系统测试、验收测试UAT,测试计划提前编写

weixin_49199313的博客 175

【信息科学与工程学】计算机科学与自动化-——第十五篇云计算 12 公有云里的“多Region + 多AZ“ 02 运营算法01

算法逐步思考推理思考(含数学方程式、对象、资源、任务、进程/协程/线程及对应的代数、约束、目标函数/传递函数/依赖函数、参数及参数的数值范围及边界条件、逐步推理的数学方程式列表、上下文切换、并发/串行/随机/乱序/顺序)算法逐步思考推理思考(含数学方程式、对象、资源、任务、进程/协程/线程及对应的代数、约束、目标函数/传递函数/依赖函数、参数及参数的数值范围及边界条件、逐步推理的数学方程式列表、上下文切换、并发/串行/随机/乱序/顺序)云厂商提高闲置资源利用率。算法复杂度为O(N),N为实例数量。

weixin_49199313的博客 287

别再踩坑了!手把手教你用EB Tresos Studio创建Autosar MCAL工程(含模块配置避坑指南)

本文详细介绍了使用EB Tresos Studio创建Autosar MCAL工程的完整流程,包括工程创建前的关键准备、模块配置的避坑指南以及工程验证与代码生成的实用技巧。通过实战案例和黄金准则,帮助开发者高效完成MCAL工程创建,避免常见错误,提升开发效率。

weixin_42536058的博客 447

python blp模型 估计_随机系数Logit模型及Stata实现

欢迎投稿(荐稿)计量经济圈,计量相关都行邮箱:econometrics666@sina.cn作者:北京交通大学经济管理学院博士生,王琦珀。欢迎你加入计量经济圈社群,一起探讨前沿计量理论和实证方法。一、随机系数Logit模型1.背景实证产业组织(Empirical Industrial Organization,EIO)是目前产业组织理论的前沿,其中又以Ariel Pakes为带头人,其近期工作论文...

weixin_42298927的博客 2643

保姆级教程:用再生龙Clonezilla Live给Ubuntu系统做全盘备份与恢复(含BIOS设置避坑)

本文提供了一份详细的Clonezilla Live教程,指导Ubuntu用户如何轻松完成全盘备份与恢复。从启动盘制作、BIOS设置避坑到备份参数解析和恢复操作,涵盖了所有关键步骤和常见问题解决方案,帮助用户高效保护系统数据。

weixin_42116058的博客 646

用户行为数据分析 User Behavior Data from Taobao for Recommendation

一、提出问题 二、理解数据 数据来源 阿里云天池数据集:(https://tianchi.aliyun.com/dataset/dataDetail?dataId=649) 本文选取的数据集为UserBehavior.csv,共有5242880条数据。数据的具体类别如下表所示: 用户行为种类有四种,如下表所示 对于数据维度的说明如下: 在本文选取的2017年11月25日到2017年12月3日的时间范围内,不重复的用户数量为10202,不重复的商品ID数为412369,不重复的商品类目ID数为5859,

cccxxxqq的博客 5207

opencode : 无法将“opencode“项识别为 cmdlet、函数、脚本文件或可运行程序的名称 解决方案

opencode命令识别问题与openclawcodexgemini确保的路径在 PATH 中。这个知识对所有 npm 全局工具通用。

一键难忘的博客 4526

《囚徒健身》 六艺,十式

文章目录《囚徒健身》 六艺,十式1、六艺,十式2、优缺点3、手臂和上半身 《囚徒健身》 六艺,十式 1、六艺,十式 1、俯卧撑: 2、深蹲: 3、举腿: 4、引体向上: 5、桥: 6、倒立撑: 十式就是每个动作分拆为十个不同的动作等级,进行训练 每一式里面,又根据做的组数和个数,分成三层,初级,中级,高级 依次循序渐进,每完成上一个动作的高级,则向下一个动作前进 2、优缺点 优点 : 六个动作都是很常见的,日常的动作,不太需要依赖什么器械,随时随地都可以练习,很方便 这些动作可以覆盖到全身大部分

简简单单Onlinezuozuo 4567

车载以太网-ARP 动态 静态

车载以太网-ARP 动态 静态

天赐好车的博客 410

【kubernetes】kubernetes kubeadm init 错误了 怎么回退?

因为虚拟机设置问题首先报错:然后我根据文章修改了核数。重启后,查看VIP运行所在机器,发现机器没有变化然后重新执行初始化后面报错了根据提供的信息,问题主要集中在 kubelet 未能成功启动控制平面组件,导致初始化过程超时。以下是可能的原因及相应的排查步骤:原因 1:kubelet 未运行或运行状态异常正如错误提示所指出,kubelet 可能未运行或处于不健康状态。请按照提示执行以下命令检查 kubelet 的状态和服务日志:根据输出结果,判断 kubelet 是否正常运行。后续一大堆错误。

九师兄 121

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

上一篇: MCP驱动的AI应用在大数据平台的集成指南
下一篇: 一文了解MLOps与LLMOps
piekill
博客等级 码龄6年 56粉丝 12原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

piekill

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
