【论文精读(李沐老师)】BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding

[论文精读]BERT BERT论文精读, 详细解释翻译 阅读详情

1 Abstract

我们介绍了一个新的语言表示模型BERT,这个名字来自于双向的transformer编码器表示。和最近语言表示的模型不同(ELMo、GPT),BERT是被训练深的双向表示,用的是没有标号的数据,然后再连接左右的上下文信息。因为我们的设计,导致我们训练好的BERT只需要额外的加一个输出层,就可以使得在很多nlp的任务上得到一个不错的结果,比如问答、语言推理,且不需要对任务做一些特别的架构上的改动。
BERT在概念上更加简单,在实验上更加好。他在11个NLP的任务上得到了新的最好的结果。

2 Introduction

语言模型预训练可以有效提升很多自然语言的任务。比如句子层面的任务:获得两个句子之间的关系,词元(token)层面的任务:实体命名。
在使用预训练模型做特征表示的时候一般有两类策略:基于特征的和基于微调的。基于特征的代表作是ELMo,在预训练好的这些表示,它作为一个额外的特征和输入会一起输入模型中。基于微调的方法是GPT,把训练好的模型放在下游任务时,不需要改太多,这个模型预训练好的所有参数会在下游任务上再进行一下微调。这两个方法在预训练中都使用了相同的目标函数,都是使用了一个单向的语言模型。
我们认为当前的技术限制了预训练表征的能力,尤其是微调方法。主要限制是标准语言模型是单向的,这限制了可以在预训练期间使用的体系结构的选择。例如,在 OpenAI GPT 中,作者使用从左到右的架构,其中每个标记只能关注 Transformer 的自我注意层中的先前标记(Vaswani 等人,2017)。这样的限制对于句子级任务来说是次优的,并且在将基于微调的方法应用于标记级任务(例如问答)时可能非常有害,因为在这些任务中,从两个方向结合上下文是至关重要的。
在本文中,我们通过提出BERT:来自变形器的双向编码器表示法来改进基于微调的方法。BERT通过使用受Cloze任务(Taylor, 1953)启发的 “带掩码的语言模型”(MLM)预训练目标,缓解了之前提到的单向性约束。这个带掩码的语言模型随机遮住输入的一些token,其目的是根据上下文信息预测被遮住的原始词汇。与从左到右预训练语言模型不同,MLM目标使表征融合了左、右语境,这使我们能够预训练一个深度的双向transformer。除了带掩码的语言模型,我们还使用了一个 "下一句预测 "任务,共同预训练文本对表征。我们的论文的贡献如下:
(1)展示了双向信息的重要性;
(2)预先训练的表示法减少了对许多工程繁重的特定任务体系结构的需求。BERT是第一个基于微调的表示模型,它在一大套句子级和词元级任务上实现了最先进的性能,表现优于许多特定于任务的体系结构;
(3)BERT的代码。

3 Conclusion

最近由于语言模型的迁移学习而带来的经验改进表明,丰富的、无监督的预训练是许多语言理解系统的组成部分。特别是,这些结果使即使是低资源的任务也能从深度单向架构中受益。我们的主要贡献是将这些发现进一步推广到深度双向体系结构,允许相同的预训练模型成功地处理广泛的NLP任务。

4 Related Work

非监督的基于特征的方法

非监督的基于微调的方法

在有标号的数据上做迁移学习

5 BERT模型

介绍一下BERT的细节。主要有两个工作:预训练和微调。在预训练中,这个模型是在一个没有标号的数据上训练的。在微调时,同样使用一个BERT模型,但其权重初始化时为我们预训练时得到的权重,所用的权重在微调时都会参与训练且用的是有标号的数据。每一个下游任务都会创建一个新的BERT模型,虽然都是用已训练好的模型做初始化,但是对每一个下游任务都会根据自己的数据训练好自己的模型。见图一。
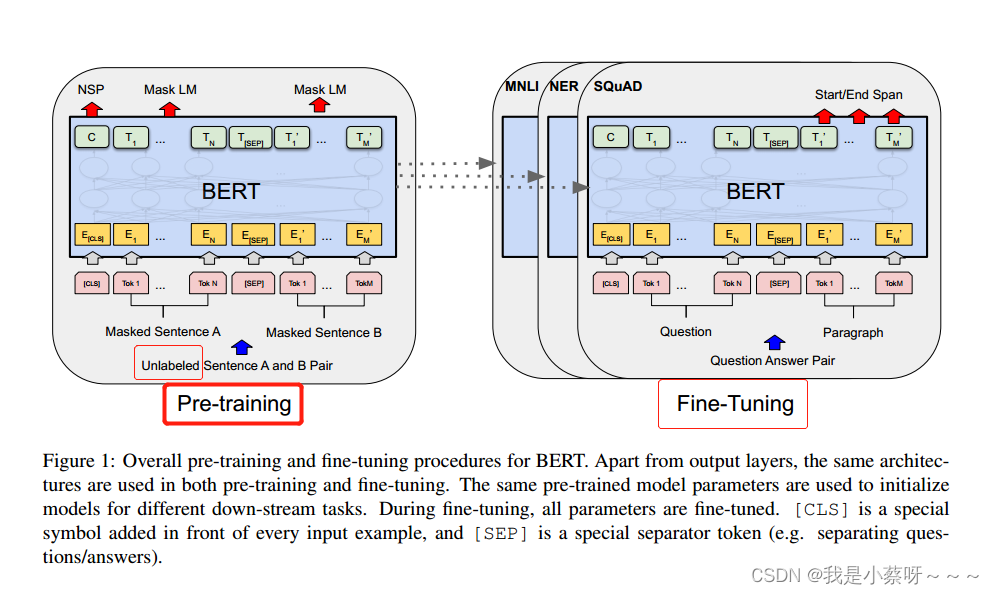
在这里插入图片描述

Model Architecture

BERT模型就是一个多层的双向transformer的编码器,直接基于原始的论文和代码。
在本文工作中,调了transformer的个数L,隐藏层大小H,多头自注意力机制的头数A。我们有两个模型:BERT base(L=12, H=768, A=12, Total Parameters=110M) ,BERT(L=24, H=1024,A=16, Total Parameters=340M)。
BERT base和GPT模型的数量差不多,可以做一个比较公平的比较。

Input/Output Representations

对于下游任务,有时输入是一个/一对句子,为了使BERT能够处理这些情况,其输入可以是一个/一对句子。一个句子的意思是一段连续的文字,不一定是真正语义上的一个句子。对于BERT,一个序列有可能是一个/两个句子。
我们使用WordPiece(如果一个词出现的概率不大,那么切开看其子序列,类似词根,子序列出现概率比较大的话,只保留这个子序列)得到一个3w的词典(从而可以表示一个比较大的文本)。这个序列的第一个词永远是一个特殊的记号([CLS]),BERT的最后输出希望是代表一个句子的信息。句子对被打包成一个句子,我们有两个方法来区分:(1)在每一个句子后面放一个特殊的词[SEP];(2)学习一个嵌入层来表示是第一个/第二个句子。见图一。
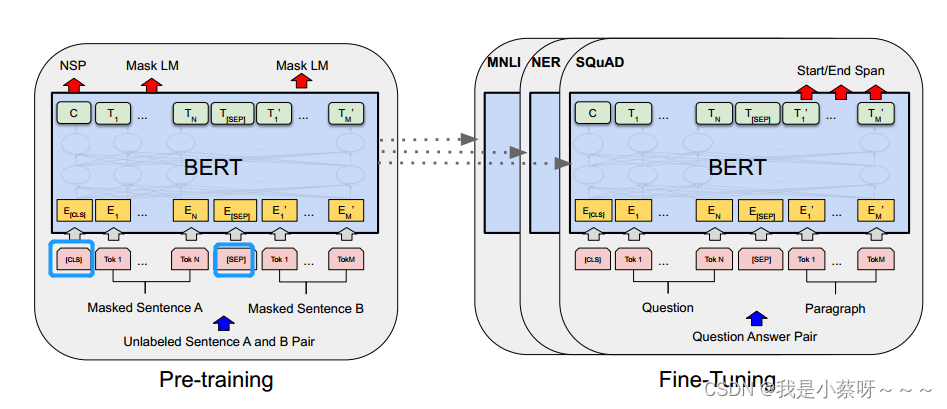
在这里插入图片描述
对于每个词元,进入BERT的向量表示为:词元本身的embedding+在哪一个句子的embedding+位置的embedding。见图2。
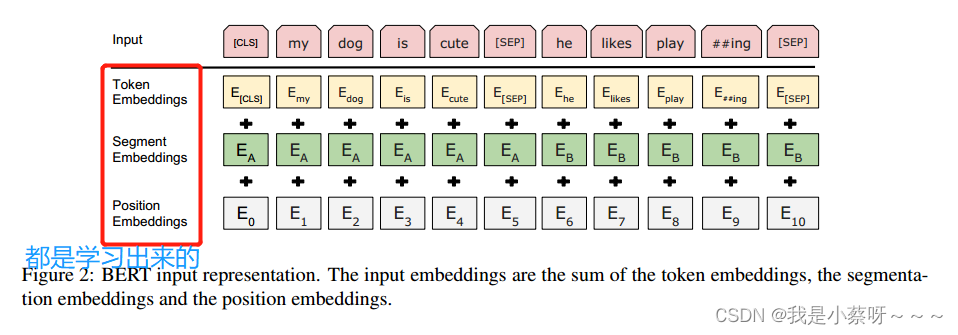
在这里插入图片描述

Pre-training BERT

Task #1:Masked LM

带掩码的语言模型,对于一个token序列,如果每一个token都是由WorkPiece生成,会有15%的概率随机替换成一个掩码。但是对于特殊的词元,就不做替换了。
但是也会有一些问题,因为在做掩码的时候,会把词元替换成一个特殊的token:[mask],在预训练的时候会看到15%的mask,但是在微调的时候没有这个东西,从而导致在预训练和微调时候的数据会有一些不一样。
解决措施:被选中15%的词(1)有80%的概率真的被替换(2)10%的概率被替换成一个随机的词元(3)10%的概率不做改变。
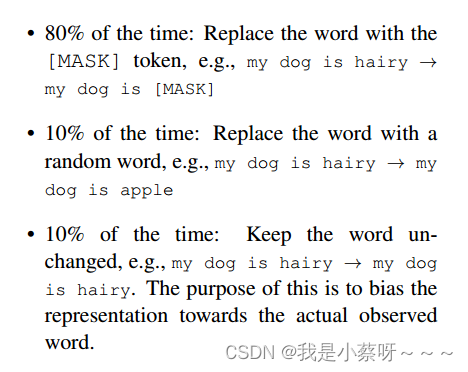
在这里插入图片描述

Task #2:Next Sentence Prediction(NSP)

预测下一个句子。
很多重要的下游任务如QA、NLI都是一个句子对,所以需要学一些句子层面的信息。具体来说,我们的输入序列有两个句子A和B,有50%的概率B在原文中间、A之后;50%的概率B是随机从一个地方选取出来的一个句子。(意味着50%为正例,50%为负例)。
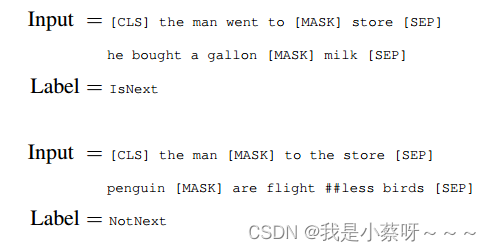
在这里插入图片描述

Pre-training data

其用了两个数据集,给一些文本(是一片一片的文章,而不是随机打乱的句子)效果会好一些。

Fine-tuning BERT

BERT和一些基于编码器-解码器结构的不同:因为BERT把整个句子对都放进去了,self-attention能够在两端之间互相看,但是encoder-decoder这个架构中,编码器一般是看不到解码器的东西,所以说BERT在这块会好一些,但是不能像transformer一样做机器翻译。
在做下游任务的时候,会根据不同的任务,设计任务相关的输入和输出。具体实验小结。

Experiments

GLUE

句子层面的任务

QA

SWAG

判断两个句子之间的关系

Ablation Studies
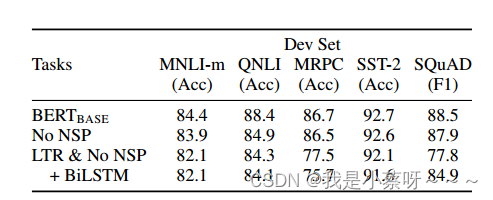
在这里插入图片描述

李沐论文精读:BERT 《BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding》 李沐论文精读:BERT BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding 阅读详情

相关推荐

李沐动手学深度学习V2-BERT微调和代码实现

load_pretrained_model函数用于加载预先训练好的BERT参数。

flyingluohaipeng的博客 5695

李沐动手学深度学习V2-bert和代码实现

BERT通过使用预训练的Transformer编码器,能够基于其双向上下文表示任何词元,在下游任务的监督学习过程中,BERT在两个方面与GPT相似。。

flyingluohaipeng的博客 2981

LLM 系列——BERT——论文解读

BERT是单模态“小”语言模型,是一个“Bidirectional Encoder Representations fromTransformers”的缩写,是一个语言预训练模型,通过随机掩盖一些词,然后预测这些被遮盖的词来训练双向语言模型(编码器结构)。可以用于句子分类、词性分类等下游任务,本身旨在提供一个预训练的基础权重。

TigerZ*的博客 2024

BERT 论文逐段精读【论文精读】-跟李沐学AI

视频链接:BERT 论文逐段精读【论文精读】_哔哩哔哩_bilibili BERT: 近 3 年 NLP 最火 CV: 大数据集上的训练好的 NN 模型,提升 CV 任务的性能 —— ImageNet 的 CNN 模型 NLP: BERT 简化了 NLP 任务的训练,提升了 NLP 任务的性能 BERT 如何站在巨人的肩膀上的?使用了哪些 NLP 已有的技术和思想?哪些是 BERT 的创新? 1标题 + 作者  01:34  BERT: Pre-training of Deep ...

qq_42014059的博客 4945

Oracle入门——基础语法篇

ROWID是Oracle中的一个伪列,用于唯一标识数据库中的每一行。在查询中,可以使用ROWID来定位和操作特定的行,例如,删除特定的行或更新特定的行。在Oracle中,子查询是指嵌套在另一个查询内部的查询语句,它可以作为主查询的一部分,用于提供额外的过滤条件、计算或数据源。在Oracle中,连接查询是通过使用JOIN子句将两个或多个表中的数据合并在一起,以获取满足特定条件的结果集。在Oracle数据库中,ROWID和ROWNUM都是用于对行进行标识和定位的伪列,它们在查询中的使用有一些不同之处。

麦当当的博客 3089

用UDP协议在dos命令行里模拟一个聊天程序

/* 需求: 在dos命令行里模拟一个聊天程序 有收数据的部分,和发数据的部分,这两部分需要同时执行。 那就需要用到多线程技术。 一个线程控制收,一个线程控制发。 */ import java.io.*; import java.net.*; class C

s_x_x的记录 1956

BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding

自然语言处理过去几年最重要的文章之一,NLP领域在BERT之前一直没有一个深的神经网络训练好之后应用在其他任务上面,很多时候都是每个人对自己的任务训练一个网络,BERT出现之后,NLP领域可以在一个比较大的数据集上,训练好一个比较深的神经网络,然后应用在很多NLP任务上面,既简化了训练过程,又提升了性能,使得NLP领域得到质的飞跃。

KeepLearning1的博客 876

ABAP BAPI_PRODORD_CHANGE函数详解:如何高效重读生产订单主数据

本文深入解析ABAP BAPI_PRODORD_CHANGE函数在生产订单主数据高效处理中的应用。通过详细讲解函数架构、主数据重读机制及实战代码示例,帮助开发人员掌握生产订单数据的精准读取与更新技术,提升SAP系统集成与自动化处理效率。

weixin_29207149的博客 469

【论文精读】BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding

预训练语言模型BERT:把两个最好的结合起来!

学习记录,厚积薄发 4135

Unity新手必看:5分钟搞定TextMeshPro中文乱码,告别小方块(附7000+常用字库)

本文详细介绍了Unity中TextMeshPro中文乱码问题的解决方案,包括快速生成中文字体的步骤和优化技巧。通过使用支持中文的.ttf字体文件和自定义字符集,开发者可以在5分钟内解决TMP显示小方块的问题,提升游戏或应用的文本显示效果。

weixin_33095355的博客 363

把 MCP Server 直接装进 SAP ABAP:用 Unlimited Display Tools 打通 Agentic SDK 与 SAP ECC / S/4HANA 的最后一公里

摘要:AI与SAP集成的MCP解决方案 企业在AI集成中面临工具链复杂、数据对接繁琐的挑战。Model Context Protocol (MCP)通过标准化工具与数据暴露方式,将集成复杂度从N×M降至N+M。在SAP生态中,MCP Server for SAP直接部署于ABAP层,利用DDIC/CDS视图对接各类Agent SDK,避免中间件风险。 MCP核心包含三类对象: Tools:带元数据的可执行动作 Resources:结构化上下文数据 Prompts:可参数化提示模板 ABAP层实现MCP Se

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 688

BERT:Pre-training of Deep Bidirectional Transformers forLanguage Understanding深度双向Transformer理解预训练

BERT:Pre-training of Deep Bidirectional Transformers forLanguage Understanding深度双向Transformer理解预训练

Together_CZ的博客 1976

《从底层结构开始学习FPGA》目录与传送门

《从底层结构开始学习FPGA》目录与传送门

孤独的单刀 16万+

BERT:用于语言理解的深度双向Transformer预训练【简单分析】

BERT采用多层双向Transformer编码器架构,允许令牌在所有层中同时条件化左右上下文。 该模型使用两个新颖的无监督任务进行预训练:掩码语言模型(MLM)用于实现深度双向性,下一句预测(NSP)用于理解句子关系。 在大型语料库上预训练后,整个模型通过添加最小的任务特定输出层进行微调,以适应特定的下游自然语言处理任务,使其适用于各种应用。

专注于AI领域前沿技术学习与分享:目标检测、图像修复、超分重建、AI工程化 1181

赛豆科技 AIVA 汽车智能体架构演进面试题与答案

摘要 赛豆科技AIVA汽车智能体架构从座舱AI演进到整车智能体,最终实现自进化的超级智能体。其核心是"先有AI再有车"的理念,将AI作为产品主轴而非附加功能。架构设计采用端-边-云协同,确保低延迟响应;整车智能体通过Planner、Tool Registry等关键组件实现自主决策;自进化机制结合车端个性化学习和云端群体学习,并设置多重安全验证。多域协作采用分层架构,关键安全功能仍由确定性逻辑控制。该架构实现了从被动响应到主动服务的范式转变,使车辆能够持续进化。

AI天才研究院 123

AUTOSAR进阶图解==>AUTOSAR_SWS_CANNetworkManagement

本文介绍了AUTOSAR架构中的CAN网络管理(CanNm)模块,主要内容包括: 模块概述:CanNm是协调CAN网络节点状态转换的基础组件,采用去中心化设计,通过周期性发送网络管理PDU保持网络活跃状态,支持网络唤醒、睡眠和部分网络功能。 架构设计:CanNm位于AUTOSAR中间层,连接上层通信管理器(ComM)和底层CAN接口(CanIf),包含状态管理、PDU处理和定时器管理等子组件。 状态机设计:定义了三种主要模式(总线睡眠、准备睡眠和网络模式)及其转换逻辑,网络模式又包含重复消息、正常操作和准备

一名留德华的,康德的信徒的,专注于汽车电子领域的博客 2041

【自然语言处理 | BERT】BERT:Pre-training of Deep Bidirectional Transformers for Language Understanding论文讲解

【自然语言处理 | BERT】BERT:Pre-training of Deep Bidirectional Transformers for Language Understanding论文讲解

wzk4869的博客 2471

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

【论文阅读笔记】BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding

BERT的出现使我们终于可以在一个大数据集上训练号一个深的神经网络,应用在很多NLP应用上面。 BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding 深的双向Transformer 摘要(Abstract):与别的文章的区别是什么?效果有多好? 与ELMo的区别:ELMo基于RNN,双向,在运用到下游的任务时需要做出一些调整。BERT基于Transformer,只需要改最上层。 与GPT的

ymk1998的博客 1083

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

论文笔记:BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding

论文地址: BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding 前言 Google在2018年10月发表的一篇文章。 Abstract BERT 表示来自 Transformer 的双向编码器表示(Bidirectional Encoder Representations from Tra...

vivian_ll的博客 1743

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

【六】BERT:Pre-training of Deep Bidirectional Transformers forLanguage Understanding

本课首先解释了预训练模型:是什么、为什么,引出了bert这个可知语义信息的模型 bert自监督学习,资料分为两部分,自己跟自己学,自己产生label bert通过transformer无限制的self-attention考虑整个序列,给多少内容就能看多少上下文,预测的内容被mask所以不用担心模型会偷看到,目标是预测被盖住的内容。预训练模型往往非常大,很多参数需要存下来,所以只调adaptor的部分 预训练模型经过任务的针对性有标记资料的微调之后,可以解决各种下游NLP任务:情感分析、词性标注、NLI、问答

云淡风轻_的博客 1809

BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding学习

一、什么是BERT模型? 谷歌团队的Thang Luong直接定义:BERT模型开启了NLP的新时代 BERT这个模型与ELMo和OpenAI的fine-tune transformer的不同的是,它在训练双向语言模型时以减小的概率把少量的词替成了Mask或者另一个随机的词。 我个人感觉这个目的在于使模型被迫增加对上下文的记忆。 BERT模型具有以下两个特点: 第一,是这个模型非常的深,...

沐埜专栏 1810

【NAACL 2019预训练论文解读】BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding

简介:Transformer主要用在机器翻译这个小的领域上。BERT可以针对一般的语言理解任务。之前CV里面有预训练的CNN模型,那BERT出现后使得NLP也有了预训练模型。

捡起一束光的博客 1275

基于pytorch的文本分类

目录结构 text │ run.py │ train_eval.py │ utils.py │ utils_fasttext.py │ ├─models │ │ TextCNN.py │ │ TextRNN.py │ │ │ └─__pycache__ │ TextCNN.cpython-36.pyc │ TextRNN.cpython-36.pyc │ ├─THUCNews │ ├─data │ │ class.txt │ │

码python的Vinsmoke 2465

【文献精读】BERT: Pre-training of Deep Bidirectional Transformers forLanguage Understanding

本文介绍了BERT模型的核心技术与应用效果。BERT通过双向Transformer架构和两个预训练任务(遮蔽语言编码和下一句预测)实现文本深度双向表征。实验表明,BERT在11项NLP任务中取得突破性进展,包括GLUE基准提升7.7%、SQuAD问答F1值提高1.5-5.1分。研究验证了双向表征优于单向模型,并证明预训练+微调模式的有效性。BERT的成功展示了无监督预训练对语言理解系统的重要价值,特别是其双向架构能适应各类NLP任务。

m0_65047928的博客 1675

BERT :Pre-training of Deep Bidirectional Transformers for Language Understanding论文阅读笔记(NAACL 2019)

BERT:用于语言理解的深度双向Transformer预训练

learn more,have more 620

【李沐论文精读】BERT精读

BERT(BEncoderRTransformer,双向Transformer编码器)。与最近的语言表示模型(ELMo,GPT)不同,BERT的所有层旨在通过联合训练左右上下文的方式从未标注文本中预训练深层的双向表征。BERT是基于EMLo和GPT(单向的Transformer编码器)的。BERT:设计用来训练深的双向表示,使用没有标号的数据,再联合左右的上下文信息。

Emily的博客 1634
上一篇: 【动手学习深度学习】数据预处理
下一篇: 【动手学习深度学习】线性代数代码实现
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

我是小蔡呀~~~

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
