python爬虫对网页进行数据抓取

如何用Python爬取网页数据,Python爬取网页详细教程 阅读详情

1,拿到网页源代码

1.1 先看网址,和请求方式
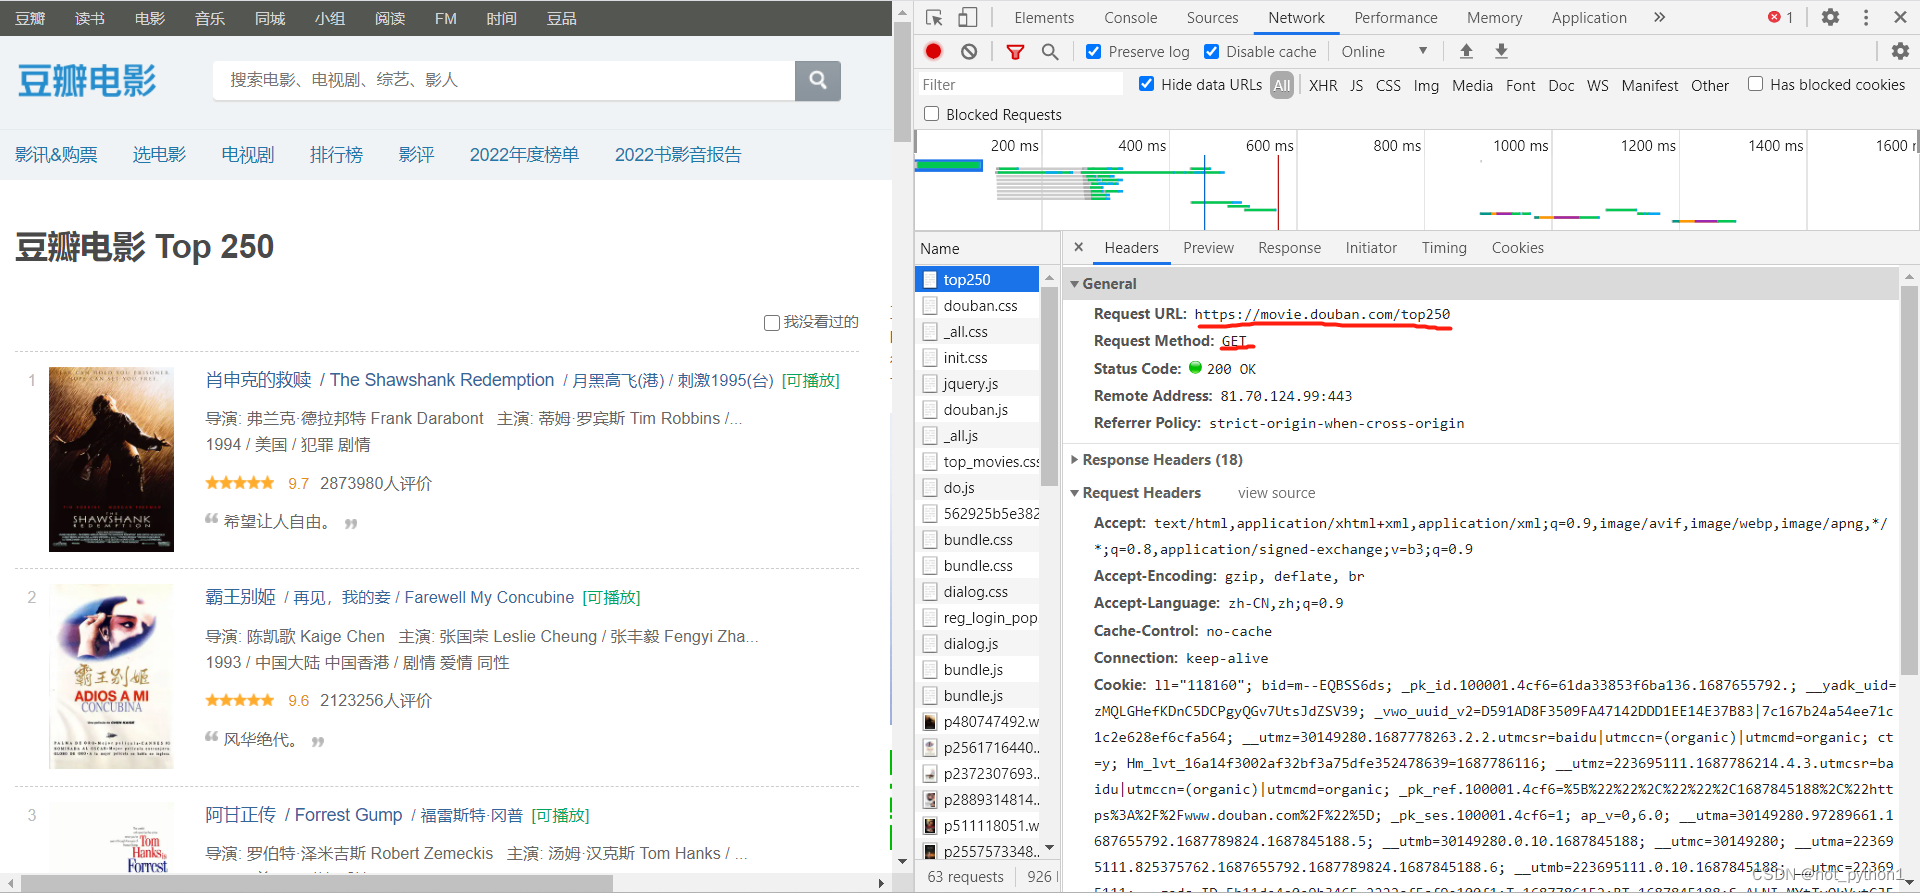
 1.2导入requests模块
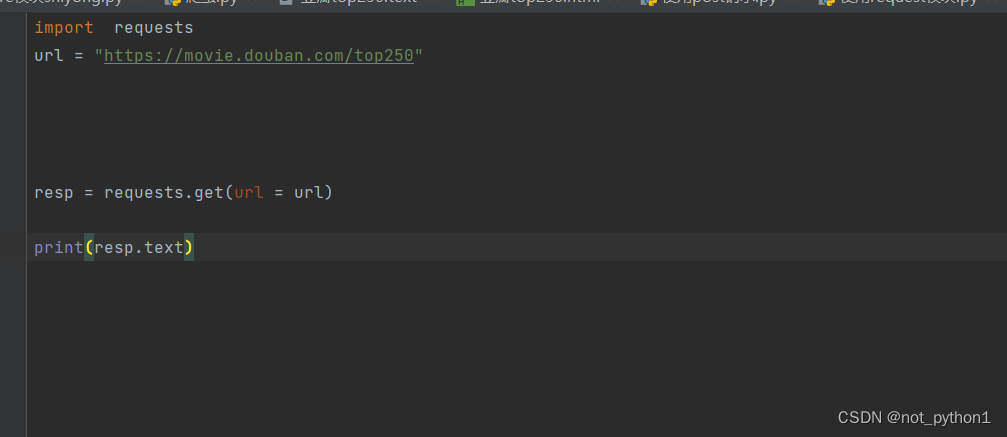
 1.3 发现爬不出来,是因为豆瓣做了伪装
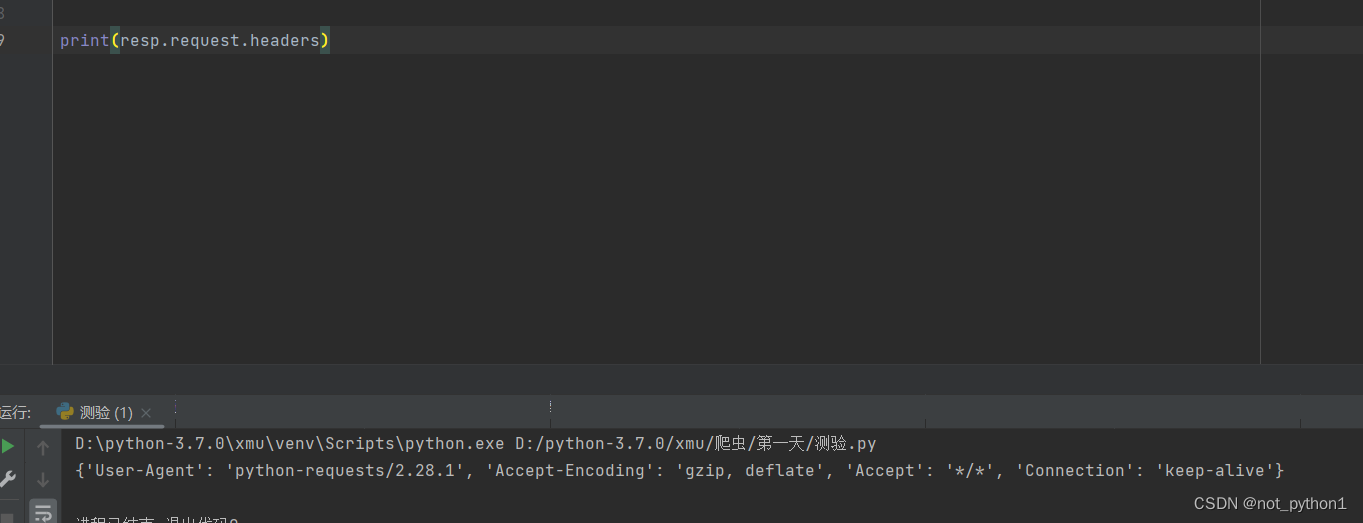
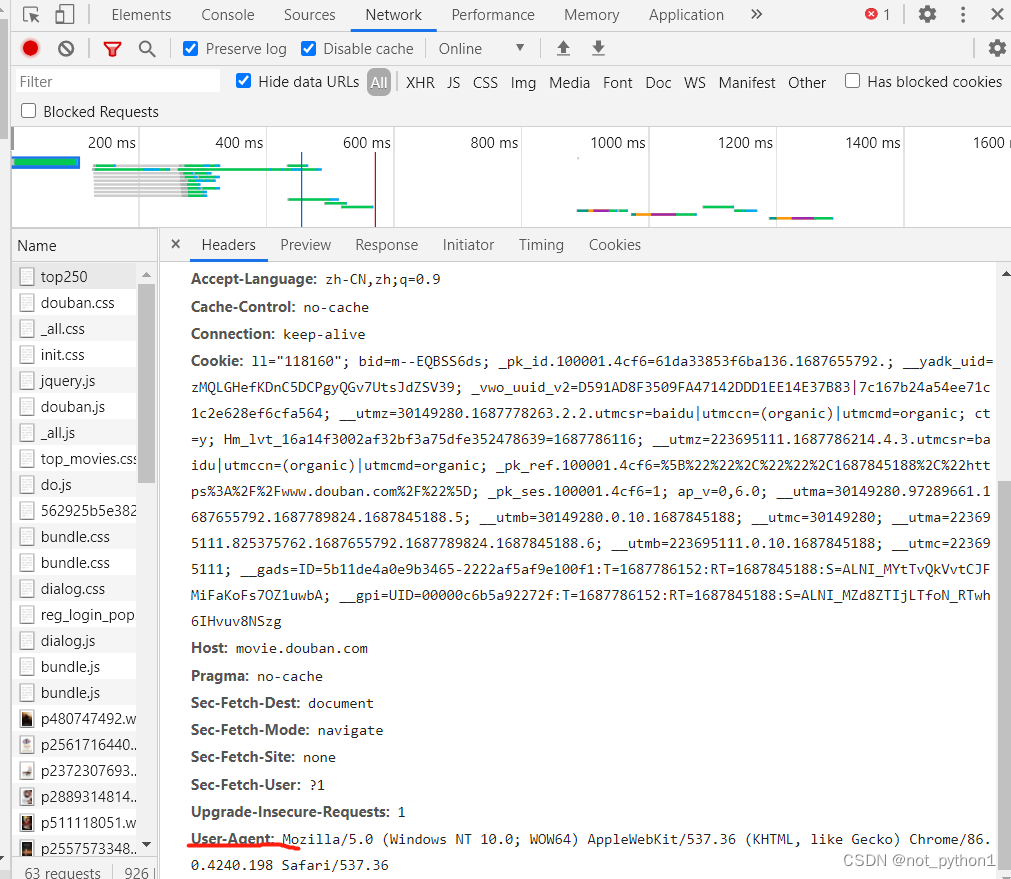
 1.3需要更换头部

 

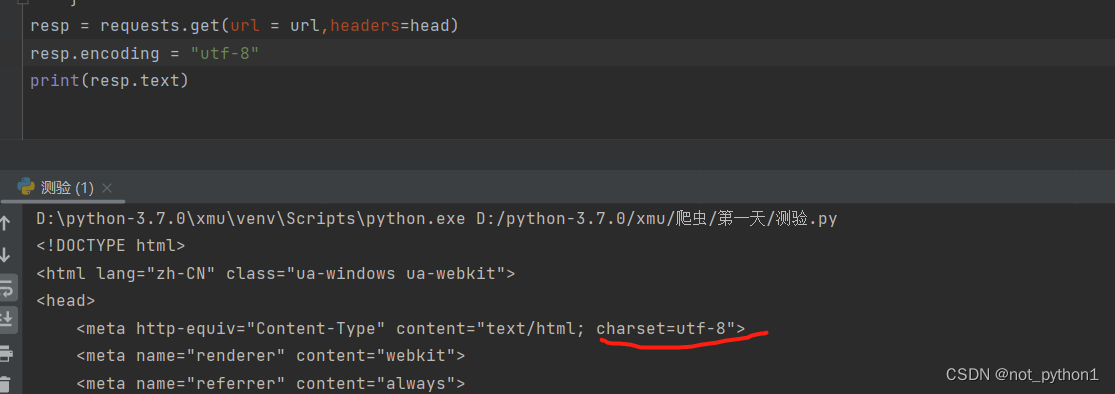
1.4需要设置utf-8,要不然会乱码2,提取想要的数据
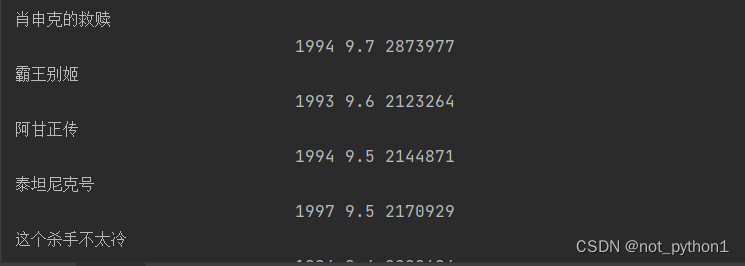
2.1,加载re模块,并且进行预加载

2.2,用正则法.*?

 

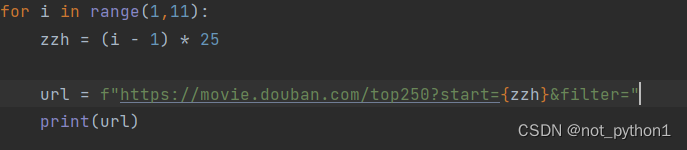
 2.1,循环网页

 爬取1-10页面需要加循环


 自己存储就行

下面是全部代码

import requests
import re

for i in range(1,11):
    zzh = (i - 1) * 25

    url = f"https://movie.douban.com/top250?start={zzh}&filter="
    obj = re.compile(
        r'<div class="item">.*?<span class="title">(?P<mz>.*?)</span>.*?<br>(?P<sj>.*?)&nbsp.*?<span class="rating_num" property="v:average">(?P<pf>.*?)</span>.*?<span>(?P<pl>.*?)人评价</span>',
        re.S)# re.S 让.跳过换行符
    head = {
        'User-Agent': "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.198 Safari/537.36"
    }
    resp = requests.get(url, headers=head)
    resp.encoding = "utf-8"
    xx = obj.finditer(resp.text)
    for itme in xx:
        mz = itme.group("mz")
        sj = itme.group("sj")
        pf = itme.group("pf")
        pl = itme.group("pl")

        print(mz, sj, pf, pl)

Python 爬虫:获取网页数据的 5 种方法 requests:适用于简单的静态网页抓取,易于使用。requestslxml:适合需要高效解析大规模网页内容的情况,支持 XPath 和 CSS 选择器。Selenium:适用于动态网页(JavaScript 渲染)的抓取,模拟浏览器行为获取动态数据。Scrapy:强大的爬虫框架,适合大规模的网页抓取任务,支持异步请求和高级功能。PyQuery:基于 jQuery 语法,适合快速开发,提供简洁的 CSS 选择器语法。 阅读详情

相关推荐

Python网页抓取教程

​— Python网页抓取教程:循序渐进 — 抓取网页入门其实挺简单的。在之前的文章中我们介绍了怎么用C#和JAVA两种方法来抓取网页,这一期给大家介绍一种更容易,也是使用最广泛的一种抓取方法,那就是Python。 说起Python,大家应该并不陌生,它是目前入门最简单的一种方法了,因为它是一种面向对象的语言。Python的类和对象比任何其他语言都更容易使用。此外,Python存在许多库,因而在Python中构建用于网页抓取的工具轻而易举。 在这篇Python网络抓取教程中,我们将分步骤讲解如何利..

candice931020的博客 1万+

Python3 注释

Python3 注释

xiqng17111342931的博客 2222

网络爬虫基础教程:使用 Python 的 requests 库进行网页数据抓取

网络爬虫是一种自动化程序,用于从互联网上抓取数据。无论是用于数据分析、市场研究、学术研究,还是搜索引擎的网页索引,爬虫技术都在现代互联网应用中发挥着重要作用。本文将通过 requests来讲解如何进行基本的网页数据抓取。requests是 Python 中一个简单易用的库,它通过封装 HTTP 请求,简化了网络请求的过程,是实现网络爬虫的理想选择。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 1027

python爬虫入门,轻松爬取网页上的数据(非常详细)

随着网络的普及和信息爆炸式增长,我们可以通过网络来获取各种各样的数据。而Python作为一门强大而灵活的编程语言,可以帮助我们快速地从HTML网页中提取数据。本文将介绍Python爬虫的入门知识,并详细讲解如何使用Python爬虫来爬取HTML网页上的数据。1.了解HTML和网页结构2.安装和导入相关依赖库3.发送http请求获取网页内容4.解析HTML网页内容5.定位内容和提取数据6.保存抓取的数据在开始编写爬虫之前,了解HTML和网页的结构是非常重要的。

优快云_430422的博客 11万+

文章五:Python 网络爬虫实战:使用 Beautiful Soup 和 Requests 抓取网页数据

在Python中,可以使用。在实际应用中,可以尝试实现更复杂的功能,如自动翻页、数据清洗和存储、分布式爬取等。数据清洗和分析:对抓取到的数据进行清洗、整理和分析,使用Pandas、NumPy等库进行数据处理,使用Matplotlib、Seaborn等库进行数据可视化。遵守爬虫道德规范:在编写网络爬虫时,要遵守爬虫道德规范和网站的robots.txt文件规定,避免对目标网站造成过大的访问压力。数据存储:将抓取到的数据存储到数据库中,如SQLite、MySQL、MongoDB等,方便进一步处理和分析。

斌擎科技 1566

初级文章【西门子】字符拼接成字符串

针对S7-400极其以下PLC,1200往上据说有专门的块了呢,首先,我是不用库的,需要什么函数会自己写,OK进入正题。 首先,我们有一个DB块,里面有14个char,一个14位的char数组和一个14位的string。如下图。 我们的目的是将char1-char10拼接成一个string。 第一种方式:第一步,将char放进数组。 ​​​​​​​ 相信大家都能看明白,但是我还是要解释解释 L取值2 T赋值到临时变量DBNO(INT) OPN DB [#DBNO]获取DB块,这一句.

NS_Speak(IVAV) 1万+

【论文投稿】Python 网络爬虫:探秘网页数据抓取的奇妙世界

在当今数字化信息呈爆炸式增长的时代,网络爬虫宛如一把神奇的钥匙,开启了通往海量数据宝藏的大门。无论是商业领域的市场情报搜集、科研工作中的资料聚合,还是个人兴趣驱动下的信息整合,网络爬虫都展现出了无与伦比的价值。今天,就让我们一同走进 Python 网络爬虫的精彩世界,探索其中的奥秘。Python 网络爬虫为我们打开了一扇通往无限数据世界的大门,在商业、科研、生活等各个领域释放出巨大能量。通过掌握requestsScrapy等核心工具和框架,我们能够披荆斩棘,克服重重挑战,从网页的海洋中挖掘出珍贵的数据宝藏。

2509_92430413的博客 2285

ESP32水墨屏日历实战:低功耗自动更新与HTTPS数据解析

本文详细介绍了ESP32水墨屏日历项目的开发实践,重点讲解了低功耗自动更新与HTTPS数据解析的实现方法。通过ESP32的自动休眠功能和水墨屏的零功耗特性,结合HTTPS请求安全获取网络数据,实现了高效节能的桌面日历应用。项目代码开源,适合物联网开发者参考。

xx56789的博客 774

Python网络爬虫技术:静态网页数据抓取实践与心得

我在学习Python网络爬虫技术的过程中,对静态网页数据抓取有了深刻的理解和实践经验。本文将分享我在课程学习中的心得体会,包括基础概念、实战代码、常见问题及解决方案等。import requests # 发送HTTP请求from bs4 import BeautifulSoup # HTML解析import re # 正则表达式import pandas as pd # 数据处理通过这门课程的学习,我掌握了静态网页数据抓取的基本技能,并能够将这些技术应用到实际项目中。

2301_80925040的博客 1742

GIS国土工具实战:从地类分析到坐标转换,一站式解决项目难题

本文详细介绍了GIS国土工具在国土整治项目中的高效应用,涵盖地类分析、坐标转换、影像加载等核心功能。通过实战案例展示如何利用该工具快速处理shp与txt文件转换、智能比对三调二调数据,以及优化影像加载策略,显著提升项目效率。特别适合需要处理复杂国土数据的专业人员使用。

weixin_28732953的博客 334

基于stm32开发的红外循迹小车

2.L298N电机驱动模块:分别是5V,12V,GND,可以通过外加电源给驱动模块供电,IN1,IN2,IN3,IN4,EN1,EN2,通过给IN口不同的电平,可以达到控制电机正反转,EN口为使能口,可以通过给EN口不同的PWM波,来达到控制小车速度,1.红外循迹模块:检测黑线的原理是向外发射红外线,当没有遇到黑线的时候,返回回来,之后返回高电平,当遇到黑线的时候,红外被吸收,返回高电平,读取相应IO口的电平就可以知道小车此时的大致位置;模块有四个输入接口,分别连接四个TT马达,驱动小车运动;

2301_81374681的博客 1万+

python网络爬虫抓取动态网页并将数据存入数据库MySQL

简述以下的代码是使用python实现的网络爬虫,抓取动态网页 http://hb.qq.com/baoliao/ 。此网页中的最新、精华下面的内容是由JavaScript动态生成的。审查网页元素与网页源码是不同。 以下是网页源码 以上是审查网页元素 所以此处不能简单的使用正则表达式来获取内容。 以下是完整的获取内容并存储到数据库的思路及源码...

weixin_30846599的博客 403

【图像去噪】论文精读:AKDT: Adaptive Kernel Dilation Transformer for Effective Image Denoising

论文题目:AKDT: Adaptive Kernel Dilation Transformer for Effective Image Denoising —— AKDT:用于有效图像去噪的自适应核膨胀Transformer图像去噪是一项基本但具有挑战性的任务,特别是在处理高分辨率图像和复杂的噪声模式时。大多数现有方法依赖于标准的 Transformer 架构,该架构通常计算复杂度高,并且对不同噪声水平的适应性有限。在本文中,我们介绍了自适应核膨胀Transformer(AKDT)

主要更新底层视觉(去噪、超分等)相关的科研内容,形式为【论文精读】+【论文复现】 1044

PYTHON 网络爬虫:抓取网页数据并存储到CSV文件

PYTHON 网络爬虫:抓取网页数据并存储到CSV文件

安 706

C#实战大华智能安防系统:从SDK封装到视频流与智能报警的全链路落地

本文将介绍C#集成大华SDK开发安防系统的实战经验,重点解决多路视频预览卡顿和报警延迟问题。文章通过三层架构设计(SDK封装层、业务服务层、应用层)实现解耦,详细分析线程安全封装、高效解码显示和智能事件联动等核心技术。针对16路摄像头同时预览时CPU占用率过高的问题,提出使用子码流拉流与异步解码的优化方案,并总结8个常见开发陷阱的解决方案。文中还提供了大华智能安防系统的完整架构图,展示从设备层到应用层的交互流程,特别强调业务服务层中视频流服务和智能报警服务的核心功能设计。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 427

YOLOv11 改进 - C2PSA | C2PSA融合Mask Attention掩码注意力,可学习掩码矩阵破解低分辨率特征提取难题 | 2025 预印

本文提出了用于低分辨率图像分割的MaskAttn - UNet框架,并将其核心的掩码注意力机制集成到YOLOv11中。传统U - Net类模型难以捕捉全局关联,Transformer类模型计算量大,而掩码注意力机制通过可学习的掩码,让模型选择性关注重要区域,融合了卷积的局部效率和注意力的全局视野。其工作流程包括特征适配、掩码生成、定向注意力计算和特征融合。我们将掩码注意力机制代码集成到YOLOv11中。

魔改工程师的博客 403

用 Python 写你的第一个网络爬虫:从零开始,轻松抓取网页数据

本文介绍如何使用Python编写第一个网络爬虫,从零开始抓取网页数据。首先需要安装Python环境及requests和BeautifulSoup4库。教程以quotes.toscrape.com网站为例,详细讲解分析网页结构、发送HTTP请求获取网页内容、使用BeautifulSoup解析HTML以及提取目标数据四个关键步骤。通过简单代码示例,帮助读者理解爬虫基本原理,掌握数据抓取的核心技能,为后续深入学习Python爬虫技术打下基础。

weixin_42636075的博客 2868

【即插即用模块】Transformer篇 | CVPR 2025 | D2T:双域特征融合,完美适配缺陷检测/小目标检测和分割等频域细节敏感的任务!

本文提出了一种基于小波和原型增强的双域Transformer(WPFormer)用于像素级表面缺陷检测。该模型通过Dual-domain Transformer (D2T)模块融合频域和空间域特征:小波增强交叉注意力(WCA)分解高低频特征并加权平衡,增强缺陷细节捕捉;原型引导注意力(PCA)生成全局原型向量强化关键信息聚合。实验表明,该模块在缺陷检测任务中性能优于现有方法,通过频域细节增强和全局依赖建模有效提升了复杂场景下的检测效果。代码已开源,适用于对频域敏感的目标检测和分割任务。

主要更新底层视觉(去噪、超分等)相关的科研内容,形式为【论文精读】+【论文复现】 1374

Python网络爬虫抓取动态网页并将数据存入数据库MySQL

以下的代码是使用python实现的网络爬虫,抓取动态网页。此网页中的最新、精华下面的内容是由JavaScript动态生成的。审查网页元素与网页源码是不同。以上是网页源码以上是审查网页元素所以此处不能简单的使用正则表达式来获取内容。以下是完整的获取内容并存储到数据库的思路及源码。

Python_trys的博客 820

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

Python网络爬虫抓取动态网页并将数据存入数据库MYSQL

简述以下的代码是使用python实现的网络爬虫,抓取动态网页hb.qq.com/baoliao/。此网页中的最新、精华下面的内容是由JavaScript动态生成的。审查网页元素与网页源码是不同。本人对于Python学习创建了一个小小的学习圈子,为各位提供了一个平台,大家一起来讨论学习Python。欢迎各位到来Python学习群:960410445一起讨论视频分享学习。Python是未来的发展方向,...

weixin_34357962的博客 544

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

易语言网络爬虫:抓取网页数据,不用 Python 也能轻松实现

第一步是环境搭建,需安装易语言 5.9 以上版本,并下载 “精易模块”(可在精易论坛获取),将模块文件复制到易语言安装目录的 “lib” 文件夹下,启动软件后通过 “工具→支持库配置” 勾选所需模块,确保开发环境中包含网络、文本处理等基础组件。第三步是编写核心代码,双击 “开始抓取” 按钮进入代码编辑区,首先通过 “编辑框 1. 内容” 获取用户输入的网址,然后使用 “网页_访问 ()” 命令发送请求,代码如下:​。网址数组 = { “url1”, “url2”, ..., “url10” }​。

2509_93051135的博客 1197

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Python 爬虫之多进程

网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。本文主要介绍Python中多进程爬虫。

m0_60105488的博客 263

Python网页处理与爬虫实战:使用Requests库进行网页数据抓取

request 库支持非常丰富的链接访问功能,包括:国际域名和 URL 获取、HTTP 长连接和连接缓存、HTTP 会话和Cookie 保 持、浏览器使用风格的SSL 验证、基本的摘要认证、有效的键 值对Cookie 记录、自动解压缩、自动内容解码、文件分块上传 、HTTP(S) 代理功能、连接超时处理、流数据下载等。except 语句。Robots 排除协议重点约定不希望爬虫获取的内容,如果没有该文件则表示网 站内容可以被爬虫获得,然而,Robots 协议不是命令和强制手段,只是国际 互联网的。

Srlua的博客 3455

python抓取网页数据库_python网络爬虫抓取动态网页并将数据存入数据库MySQL

简述以下的代码是使用 python 实现的网络爬虫,抓取动态网页 http://hb.qq.com/baoliao/ 。此网页中的最新、精华下面的内容是由 JavaScript 动态生成的。审查网页元素与网页源码是不同。 以上是网页源码 以上是审查网页元素所以此处不能简单的使用正则表达式来获取内容。以下是完整的获取内容并存储到 数据库 的思路及源码。实现思路:抓取实际访问的动态页面的url–...

weixin_39789979的博客 227
上一篇: python 计算复活节日期1900-2099
下一篇: 下载爬取到的图片链接
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值