决定 AI Agent 生死的,不是模型,是 Harness 和 Loop

别再只盯着大模型了!真正决定AI Agent生死的,是它外面那层 Harness 2026年了,AI 圈最卷的不再是争论"谁家模型参数更大"。 真正决定你死我活的,是——谁的「Harness」架构搭得更稳。 阅读详情

去年秋天,OpenAI 一个三人小组做了一件有点“反常”的事。

他们打开一个空仓库,接着就没再手写一行代码。三个人只做一件事——调整 Agent 的运行环境、约束条件和反馈策略。半年后,这个仓库长到了一百多万行代码。

差不多同一时间,Anthropic 的工程师在内部做了个实验:让一个 AI Agent 从零搭建一款 2D 复古游戏引擎。起初只用单独一个 Agent,产出的东西“技术上能跑起来,但基本是废的”。后来他们把 Agent 拆成三个——Planner 定方案,Generator 写代码,Evaluator 独立验证——同样任务、同样模型,结果从“勉强跑通”跳到了“功能完整且附带单独 Agent 从未尝试过的特性”。

然后,2026 年春天,两家公司各自发了一篇工程博客。OpenAI 那篇叫“Harness Engineering: Leveraging Codex in an Agent-First World”。Anthropic 那篇叫“Effective Harnesses for Long-Running Agents”。发布时间差不超过七天。Martin Fowler 随后也跟进写了一篇分析。

这不是一次巧合。这是一条正在成型的共识。

当 AI 从“回答问题”变成“做事”,决定最终产出的,早已不是模型本身。而是模型运行在其中的那套控制系统。

这套系统有两个维度,缺一不可。一个叫 Harness Engineering,管的是 Agent 的运行时环境和治理架构。一个叫 Loop Engineering,管的是 Agent 怎么在迭代中观察结果、修正方向、闭合反馈。

这篇文章把两个概念拆开讲清楚。
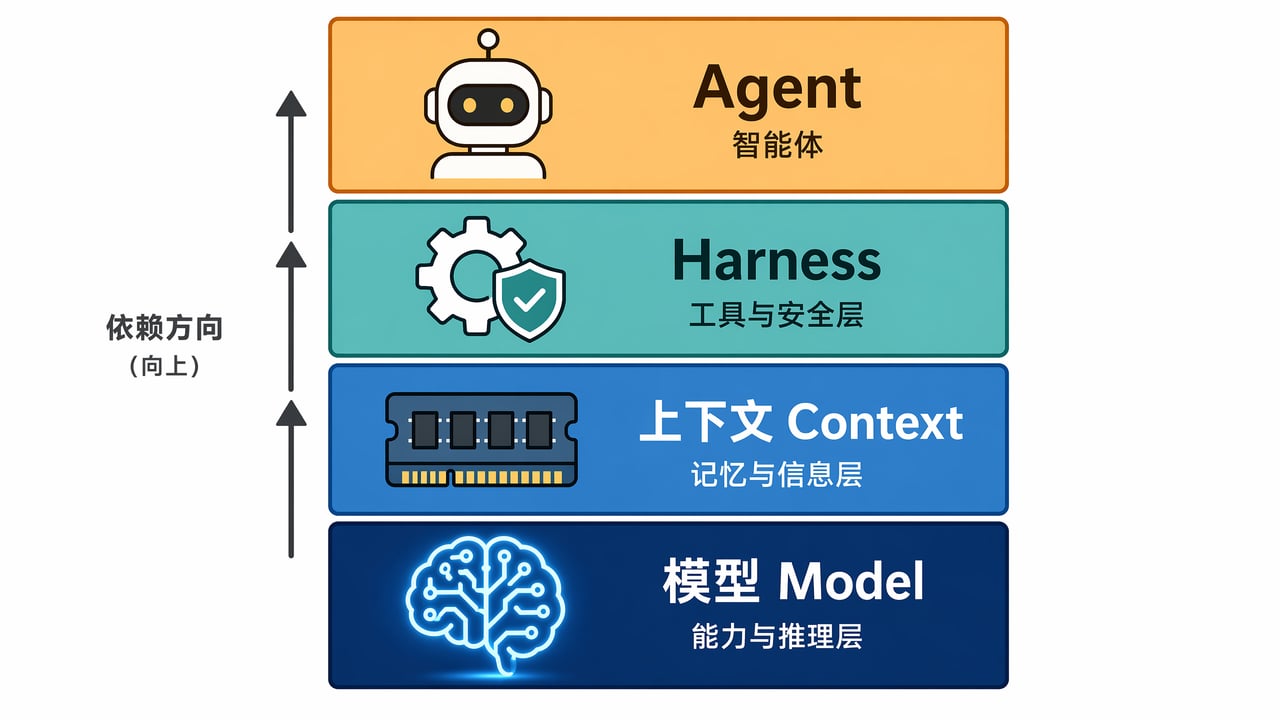
模型 → 上下文窗口 → Harness → Agent,四层架构一目了然

1

先说 Harness.

这个词在英文里是“挽具”——套在马身上、让骑手能驾驭那副力量的东西。用这个比喻来理解 AI 系统非常到位:模型是智力引擎,Harness 是决定这台引擎能做什么、不能做什么、每一步怎么走的软件层。

Cobus Greyling 今年 3 月给了一个很干净的四层架构图:

  • 模型:原始处理能力。它是“大脑”。

  • 上下文窗口:有限的工作内存。它是“短期记忆”。

  • Harness:操作系统。它管工具调度、安全检查、状态持久化、错误恢复。

  • Agent:应用程序。它跑在 Harness 之上。

这个分工画了一条很重要的边界:模型负责“想”,Harness 负责“管”。混在一起,两个都做不好。
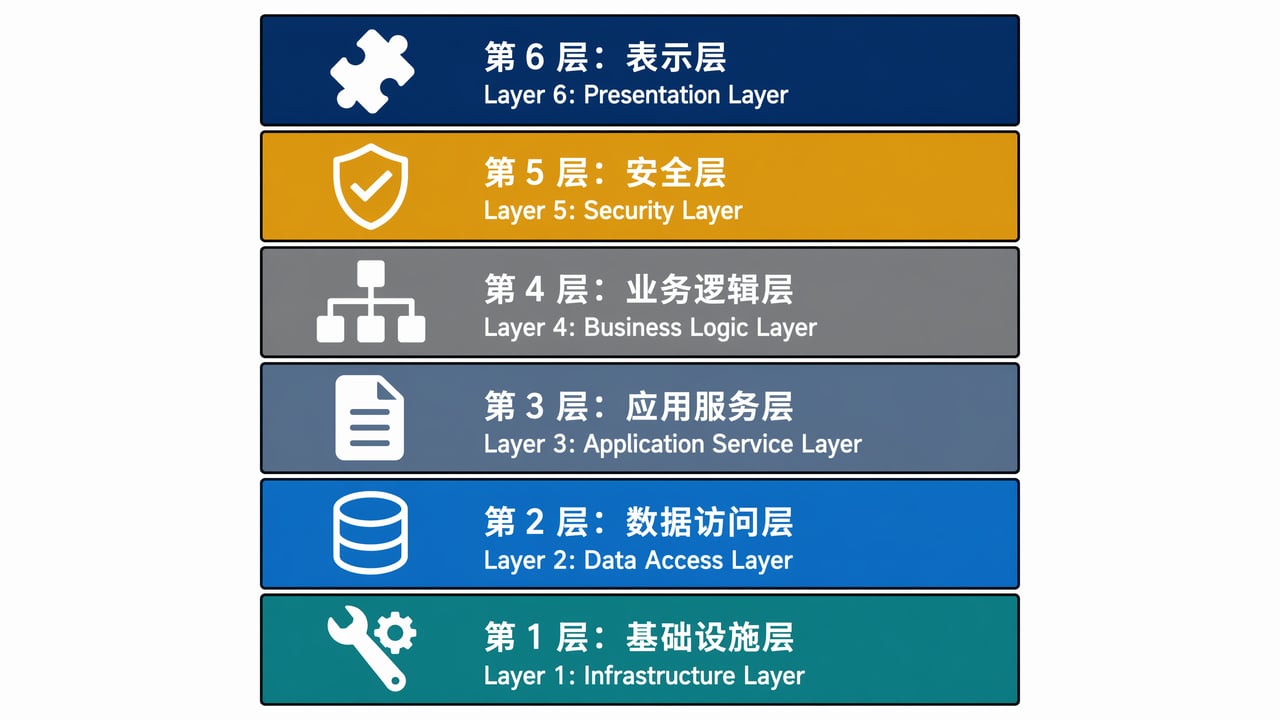
Harness 六层组件:工具集成、状态管理、上下文工程、规划分解、验证护栏、模块化

今年 4 月 arXiv 上的一篇综述文章对当时主流的 Agent 项目做了系统分析,识别出五个反复出现的设计维度:子 Agent 架构、上下文管理、工具系统、安全机制、编排逻辑。从产业实践往回看,一个生产级 Harness 目前公认有六个组件层:

第一层:工具集成。 Harness 通过 MCP 协议或直接 API 把模型连接到外部世界——文件系统、Shell、浏览器、数据库、代码执行环境。每个工具的注册表定义了权限边界、速率限制和失败语义。没有“万能权限”这回事。

第二层:内存与状态管理。 单次模型调用是无状态的,但 Agent 任务可能跑好几个小时。Harness 负责在多轮调用之间保持连续性——git 快照、JSON 进度文件、结构化的 Handoff Artifact。这块做不好,Agent 就会“失忆”。

第三层:上下文工程。 不是静态 prompt 模板。是根据当前任务状态,动态决定哪些信息需要进入模型的注意力窗口。遇到新错误?Harness 判断是把尝试历史压缩摘要、引入新源码文件、还是刷新项目约定。

第四层:规划与分解。 模型提方向,Harness 拆成可执行步骤。一步失败,触发重新规划而不是硬推。

第五层:验证与护栏。 自动化测试、格式校验、安全策略过滤。Agent 跑偏了不是人的问题,是 Harness 没拦住。

第六层:模块化。 工具、内存策略、验证逻辑都是可替换的独立组件。不会因为一个护栏升级就得重写整个 Harness。

OpenAI 那个百万行代码的仓库是这么运作的:Agent 卡住了,团队不碰代码,改的是 Harness 配置——上下文策略收了什么文件、架构约束严到什么程度、多久跑一次清理 Agent。Anthropic 的三 Agent Harness 也是同一个思路:Evaluator 拥有浏览器自动化和运行时测试能力,独立核查 Generator 的产出。用的模型没变,变的是“模型怎么被管”。

2

如果说 Harness 是操作系统,Loop Engineering 就是 Agent 的工作方法。

Loop Engineering 的命题很简单:Agent 做了一件事,怎么让它看到结果、理解结果、基于结果改进下一步?

听起来容易,做到很难。

Loop Engineering 的学术根基是 2022 年普林斯顿和 Google 提出的 ReAct 模式——Reason + Act,推理和行动交替。但 Loop Engineering 把“交替”扩展成了完整的闭环。kilo.ai 的定义比较精确:五个阶段构成一个回合,多个回合构成一个任务。

这五个阶段是:意图 → 上下文获取 → 执行动作 → 观察结果 → 调整计划。
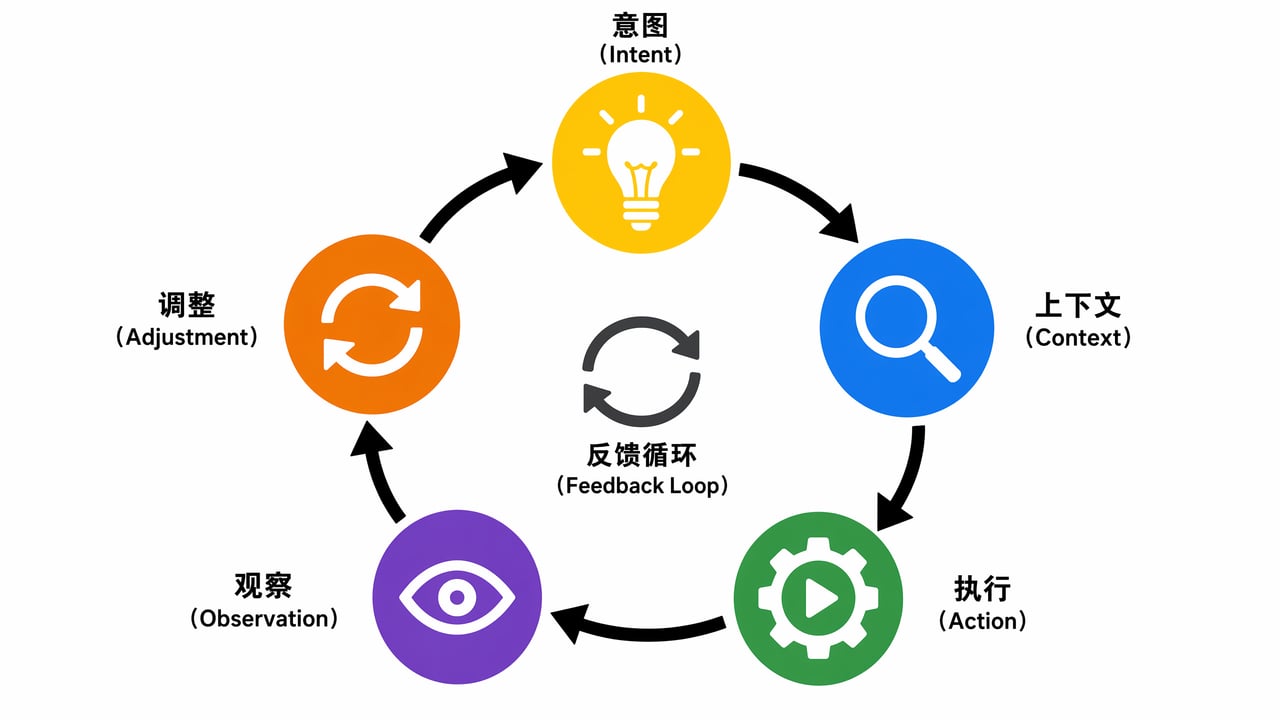
Loop 五阶段循环:意图 → 上下文 → 执行 → 观察 → 调整,形成闭环

第五步是整个循环的试金石。一个差劲的循环在失败后原样重试,一模一样的方法,期待不同结果。一个好的循环会分析失败信号,改策略,换工具,缩小范围,然后再试。

MindStudio 的分析文章里举了一个例子,很能说明差距。

任务:“修 Bug——保存账单设置时公司名带撇号会失败。”

弱循环怎么做?它猜一个 SQL 转义问题,直接去打补丁。强循环怎么做?先找表单、API 路由、校验 schema、数据库更新路径。复现失败。观察错误到底出在前端校验、后端校验、序列化还是 SQL 层。然后只改最小相关的代码路径,跑一次定向回归测试。

同样的模型。差十倍的效率。差距全在循环设计。

Loop 和 Prompt 的分工很清晰。Prompt Engineering 优化模型的第一版输出。Loop Engineering 优化最终的交付结果。 前者的反馈源主要是人的评估,后者的反馈源是测试结果、编译器报错、diff 对比、日志、review 评论、再加上人的判断。

一个能出漂亮答案的模型,第一版输出可能就让人满意。但在生产级代码里,真正重要的信号往往在第一次行动之后才会出现——类型检查挂了、import 缺了一个、测试崩溃了、UI 截图暴露了布局问题、reviewer 指出了一个边缘 case。Loop Engineering 把这些信号纳入了工作流本身,而不是当作事后收拾。

常见的 Loop 模式有四种:

  • Retry Loop:原子任务,有清晰的 pass/fail 标准。每次失败换策略。

  • Plan-Execute-Verify Loop:多步任务,步骤顺序敏感。先定计划,执行一步、验证一步,发现计划错了就改计划。

  • Explore-Narrow Loop:调试未知错误、探索不熟悉的 API。多条路径并行探索,快速剪枝收敛。

  • Human-in-the-Loop:需求无法事前写死,或错误代价太高。Agent 跑到关键决策点,暂停,等人说“继续”或“换方向”。

循环设计最常出问题的不是模型质量,而是终止条件。没有成功出口——“所有测试通过且无 lint 错误”——Agent 会无休止地打磨。没有失败出口——“10 次迭代无进展则升级到人”——Agent 会原地空转,烧 token,没有产出。

3

Harness 和 Loop 是什么关系?

Loop Engineering 是工艺流程。Harness Engineering 是生产线。

或者换个更好懂的类比:Loop 是建筑工法——砌一层、检查垂直度、修正、再砌一层。Harness 是脚手架、安全带、物料通道和监理制度。没有人会只用其中一个盖房子。

在实践中,两者交叠很深。Loop 的每一次迭代都需要 Harness 来管理工具调用、上下文更新、安全检查。如果 Harness 的工具调用超时没人管、上下文窗口溢出了、安全检查太宽松放过了危险操作——那设计再好的 Loop 也跑不满一轮。
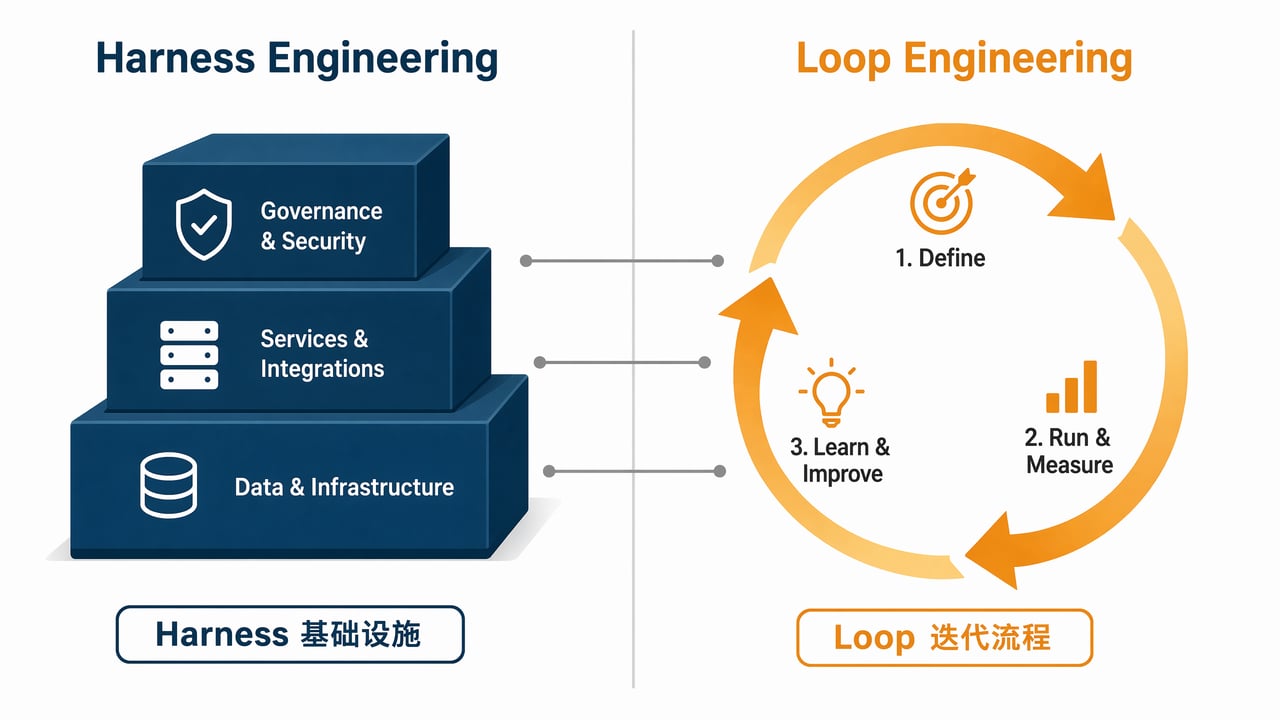
左:Harness 结构化基础设施 | 右:Loop 动态迭代流程 | 两者协同工作

arXiv 上一篇关于终端 AI 编码 Agent 的论文揭示了一个很少被谈的实现细节:不同 LLM 提供者的工具调用机制完全不同——Anthropic 用 tool_use content blocks 加 extended thinking,OpenAI 用 function calling 加 structured output。这意味着同一套 Harness 必须在 Prompt 渲染层写互斥的条件分支,按运行时 provider 动态替换系统 prompt 的结构。

这个细节说出了一个更大的事实:Harness 和 Loop 的工程难度并不主要来自模型的能力天花板,而是来自模型接口的碎片化、工具行为的不确定性,以及真实环境中那些不可预测的失败方式。

4

概念讲完了,说点真的。

今年 4 月,Anthropic 发了一份 Claude Code 质量报告,坦率得少见。起因是一次质量下降,追溯下来,原因是三个 Harness 层面的改动:默认推理强度下调,一个缓存优化 Bug 持续丢弃思考历史,以及一个过于激进的 verbosity 限制 system prompt。

三个改动,没有一个碰过模型权重。但合在一起的效应足以触发用户投诉。

这件事同时说明了两面:Harness 层面有巨大的杠杆效应——它可以直接、显著地改变 Agent 的行为质量。但当前的可观测性和回滚机制还不够成熟——你改了一个“不涉及模型”的配置,三周后才发现产出质量降了。

OpenAI 和 Anthropic 在 4 月的博客里还共同描述了一个趋势:框架层的消解。

过去开发者用框架管理 Agent 定义、消息路由、任务生命周期、依赖调度。但现在模型原生的编排能力已经覆盖了其中大约八成。剩下的两成——持久化、确定性重放、成本控制、可观测性、错误恢复——正是 Harness 要接管的。

Cobus Greyling 的总结很准:框架层不是在消失,而是在分裂。智能部分回归模型,基础设施部分下沉到 Harness。

Loop Engineering 这一侧同样有硬的边界。

哈佛和 Google DeepMind 的研究者在今年 3 月的 HITL 综述中说得直白:人类反馈的可扩展性是这个范式最根本的瓶颈。任务越复杂,需要的人类判断就越频繁,但人类的时间、注意力和判断一致性并不会随任务规模线性增长。

RLTHF 这类工作尝试了一个思路:用 AI 标注替代九成以上的人类标注,只对最难判的那 6-7% 样本引入人工纠偏。结果在 HHH-RLHF 和 TL;DR 数据集上达到了全人工标注级别的对齐效果。但这是训练阶段的改进,不直接解决运行时 Loop 中的人类介入瓶颈——你不可能只靠更好标注来让 Agent 在运行时不问人。

Loop Engineering 最常见的几个失效模式,多个来源反复提到:无休止的重复循环(换了策略但换汤不换药)、过早终止(做了六成就停了,因为“看起来差不多了”)、上下文膨胀(多分支探索时 token 窗口爆炸)、错误归因(把失败归给最后一步操作,而真正的问题出在初始计划)。这四个都不是模型问题,是循环设计问题。

5

有几个争议和未解的问题值得摆出来。

第一个是自主性程度的“安全甜蜜点”在哪。

Harness 的护栏设太严,Agent 什么都不敢做。设太松,出事了才后悔。OWASP 在 2025 年专门新增了 LLM06 风险项“Excessive Agency”——Agent 权限过度授予。但具体怎么审计?除了“遵循最小权限原则”这种谁都同意却没法直接落地的大纲之外,可操作的安全 checklist 还在成形过程中。

第二个是人的角色变了,但没人在教人怎么变。

当 Agent 能自主完成多文件重构、测试修复和部署脚本时,开发者的工作重心从“写代码”转向“审查 Agent 的决策”。但决策审查对理解深度的要求比直接编码更高——你不光要知道代码应该做什么,还要能在脑子里跑 Agent 为什么选了方案 A 而不是方案 B。

MindStudio 的实践建议是“自动化证据收集和机械性修复,保留架构和产品决策给人类”。这句话在理论上没毛病,但在真实项目里,证据收集和架构决策之间的那条线经常模糊得一塌糊涂。

第三个是评估标准的缺失。

那篇 2026 年 arXiv 的综述直接点破了一个尴尬:研究者缺少一套共享词汇来描述和比较不同 Harness 的架构。没有共享词汇,就没法系统地验证“语言决定架构”或“能力增长自然带来治理成熟度”这类常见假设。这意味着今天绝大多数的 Harness 设计决策是经验性的,没有经过严格的比较验证。Anthropic 的三 Agent 对照实验是少数例外,但一个实验远远撑不起一个学科的知识体系。

第四个是 Harness 本身会不会变成新的技术债务。

OpenAI 和 Anthropic 的 SDK 正在以惊人的速度把 Harness 的原语——工具注册、多 Agent 编排、护栏层、持久化——变成平台默认功能。2024 到 2025 年间开发者手写的定制化 Harness 代码,相当一部分已经被 SDK 以更稳健的方式取代了。

但平台接管底层基础设施的另一面,是差异化从何而来的问题。当所有人的 Harness 基础能力趋同,能拉开差距的地方只剩多 Agent 编排的巧思、领域专属护栏的精度,以及真正长周期工作流的设计——这些都还需要“真正的设计”。

最后

Harness Engineering 和 Loop Engineering 这两个概念的共同指向,其实很简单:把 AI Agent 的工程焦点从“模型有多强”拉回到“我们怎么用模型”。

在模型能力持续爬升、基础能力趋同的当下,这件事比“你用的是哪个模型”重要太多了。

OpenAI 和 Anthropic 在 2026 年春天不约而同说出同一句话,不是因为他们互相看了对方的博客。

是因为他们都从生产环境里得到了同一个教训。

AI Agent Runtime 架构三件套:Session、Harness 与 Sandbox AI Agent 不是新概念,而是现代分布式系统在 LLM 时代的工程重演。其核心挑战在于状态管理、执行隔离与安全可控——这直接指向 session 作为事件日志的持久化设计、harness 作为无状态执行引擎的函数式抽象,以及 sandbox 作为一次性计算牢笼的强隔离机制。这些模式脱胎于二十年来微服务、Serverless 和可信执行环境(TEE)的演进经验,本质是将 LLM 降级为可插拔组件,而非系统中心。当前主流平台如 Anthropic Managed Agents、AWS Bedrock Age 阅读详情

相关推荐

Agent Runtime三层架构:Session、Harness与Sandbox解耦实践

Agent Runtime 是大模型应用落地的核心基础设施层,其本质是为智能体提供可信赖的执行环境——涵盖状态持久化、无状态调度与安全沙箱隔离。它源于对传统LLM应用中上下文脆弱、状态丢失、凭证泄露等工程痛点的系统性重构,技术价值在于将非功能需求(可观测性、可审计性、合规性、灾备能力)标准化、服务化。典型应用场景包括企业级知识助手、销售线索分发、PR自动生成等需高可靠工作流的AI系统。本文深入剖析Anthropic Managed Agents所倡导的Session事件日志化、Harness无状态化、San

weixin_34379433的博客 390

从 Harness 到 Loop:不是多一层概念,而是多一套控制关系

这篇文章不是从一个新概念开始的,而是从一次会议室白板讨论开始。 我们一开始问的是一个很具体的问题:如果一个 Agent Harness 里面已经有目标、状态、QA、工具和停止条件,那么 Loop 到底比 Harness 多了什么?

m0_59235945的博客 349

Agent Runtime 三层抽象:Session-Harness-Sandbox 架构解析

Agent 运行时(runtime)是大模型应用落地的核心瓶颈,其本质是解决状态管理、工具执行与安全隔离三大基础问题。传统方案依赖 LLM 上下文窗口暂存状态,导致 context overflow、trace 断链与审计不可靠;而现代 runtime 通过 Session(不可变事件日志)、Harness(无状态协议执行器)和 Sandbox(microVM 级隔离环境)实现分层解耦。这一架构不仅规避了上下文长度的物理限制,更原生支持可观测性、合规审计与弹性伸缩,成为 AI 应用从 PoC 走向高可用生产

weixin_30892763的博客 452

一文搞懂Loop 工程、Harness 工程、FDE——Agentic Engineering 的三个层次

2026 年,AI 圈最火的词是 Agentic Engineering。 Karpathy 在 2 月给了这个时代一个名字: "你 99% 的时间不在写代码。你在编排 Agent,充当监督者。" 3 月 7 日,他把这件事推到了极致——推送了一个 630 行的 Python 脚本,然后去睡觉了。第二天早上,Agent 跑了 50 个实验,发现了更好的学习率,自己提交了代码。没有人类干预。 这个项目叫 AutoResearch,发布后 21,000 个 GitHub Star,860 万次观看。

m0_59164520的博客 589

Agent运行时层的标准化:Session、Harness与Sandbox解耦实践

Agent运行时(Agent Runtime)正经历类似操作系统抽象硬件的关键演进,其核心是将会话管理、执行调度与安全沙箱解耦为可独立演进的稳定接口。这一分层设计源于对context window溢出、凭证泄露、状态丢失等生产级问题的系统性回应,技术价值在于提升可观测性、故障恢复确定性与多租户隔离能力。典型应用场景覆盖金融尽调、医保政策匹配、跨时区客服等长周期、高合规要求的AI工作流。Anthropic Managed Agents通过Session作为持久化事件日志、Harness作为无状态执行器、San

liangqilang的专栏 463

Agent Runtime 正在成为 AI 时代的操作系统内核

Agent runtime 不是新概念,而是 AI 工程化演进中必然出现的基础设施层——它将模型执行、状态管理、安全凭证、可观测性等能力从应用逻辑中剥离,抽象为可标准化、可替换、可审计的底层服务。其核心原理在于‘会话即事件日志’:通过结构化、持久化、带因果链的 event stream 替代脆弱的 prompt context,解决上下文截断、状态不一致、调试不可追溯等生产级痛点。这一设计直接支撑金融风控、合规审计、跨系统协同等高要求场景,并推动 runtime 层走向 commoditization。当前

corg81763的博客 486

一文看懂 Harness 与 Loop Engineering

文章摘要: AI Agent在长任务中崩溃的四大主因(上下文溢出、工具调用雪崩、子代理失控、状态丢失)本质是工程层缺陷,需通过**Harness(运行时)和Loop(自主循环)**双层架构解决。Harness核心通过分层记忆(L1临时/L2稳定/L3核心)、验证闭环(执行与校验分离)、状态持久化等机制保障系统不崩;Loop则通过目标→步骤→执行→检查→修正的自动化流程替代人工触发。实践表明,普通模型+优秀循环的产出稳定性远胜于顶级模型+脆弱流程。建议从最小闭环(如定时笔记扫描)起步,逐步构建可累积的工程资产

weixin_66295112的博客 905

AI Agent Runtime 层正在归零:从沙箱到事件日志的工程范式迁移

AI Agent 运行时(runtime)是支撑智能体持续交互、状态管理与安全执行的基础层,其核心在于会话状态持久化、工具调用隔离与上下文生命周期控制。随着 Anthropic Managed Agents 将 Session 定义为只读、可查询、追加式事件日志,AWS AgentCore 以 microVM + eBPF 策略引擎实现深度治理,Runtime 正从自研基础设施转向云原生标准化服务。这一演进背后,是工程重心从‘如何运行 agent’向‘如何审计、管控、追溯 agent 行为’的根本转移。事件

anheku1562的博客 526

【AI·Coding】AI 从 Harness 到 Loop 工程的跃迁:2026 年 AI Agent 工程范式完全实践指南

摘要: 2026年AI工程范式已从Prompt Engineering演进至Loop Engineering,核心突破在于Harness(模型外系统)的优化。Harness包含六层架构(信息边界、工具系统、执行编排等),通过管理流程、纠偏和观测,显著提升模型表现。例如,仅优化Harness即可让LLM任务通过率从52.8%升至66.5%。最新阶段Loop Engineering实现系统自进化,如自动拆解冗余组件。AI工程师需优先构建AGENTS.md、分层上下文管理等基础框架,以支撑长链路任务的稳定执行。模

weixin_42260382的博客 964

AI Agent Harness Engineering 伦理:当机器拥有自主权

过去5年,我们见证了AI领域从大语言模型(LLM)到多模态通用AI Agent的跨越:不再是只能处理单任务的「工具人助手」,而是能感知环境、制定长期目标、自主调用资源/工具、甚至在模糊场景下主动权衡取舍的「决策者」。电商Agent可以根据用户画像自主选择供应商、调整价格、处理售后纠纷;医疗Agent可以根据实时监测数据自主调整胰岛素剂量、甚至推荐手术优先级;自动驾驶Agent(虽然尚未完全落地L5,但L3+已具有「限定场景自主决策权」)可以在遇到突发障碍物时自主选择「撞向护栏还是行人」;

软件工程实践的博客 148

Agent Runtime 正在成为AI时代的操作系统底座

Agent runtime 是支撑大模型智能体稳定运行的底层执行环境,其核心原理在于将状态管理、工具调用与权限控制从模型上下文解耦,转向事件日志驱动、凭证隔离和无状态执行器架构。这一技术演进显著提升了AI应用的可审计性、可恢复性与生产安全性,为金融、医疗、客服等高合规要求场景提供工程化保障。随着 Anthropic Managed Agents、AWS AgentCore 等主流平台推动 runtime 标准化与托管化,开发者正从重复造轮转向聚焦 Trace Store、Policy Governance

congli3478的博客 409

从 Agent Harness 到 Scenario Loop

Ooder Agent 系统设计采用三层结构:宿主层处理外部请求并转换为内部上下文,编排核作为核心决策中心,能力面统一适配异构步骤为同一接口。其运行回路由五大场景组构成,根据意图动态调整执行流程,支持质量校验与人工介入。这种设计将 NLP、DSL、代码生成等能力统一编排,克服了传统 Agent 框架在强结构性任务中的局限。

wenzhangli的博客 261

AI Agent Runtime 层的归零时刻:从托管服务到安全操作系统

AI Agent Runtime 是支撑智能体执行的核心抽象层,其本质是将模型推理、工具调用、状态管理与安全策略进行工程化封装。随着 Anthropic Managed Agents 等方案采用 Harness-Sandbox-Vault 三权分立架构,Runtime 正加速走向标准化、轻量化与云原生化——这既是技术成熟的标志,也预示着其商业价值正被压缩为接近零的基础设施成本。在此背景下,真正的技术价值已向上迁移至 Trace Store(可审计的行为黑匣子)、Policy Engine(可编程的治理宪法)

562

从Prompt Engineering到AI Agent:构建自主循环与工程化实践

大型语言模型(LLM)的应用开发已从静态的Prompt Engineering演进到动态的AI Agent系统。Prompt Engineering本质是与LLM进行高效通信的接口设计,通过角色定义、任务结构化等手段减少歧义、对齐意图。当任务复杂度提升,单次交互无法满足需求时,需要引入上下文管理和循环工程(Loop Engineering),构建感知、规划、执行、观察的自主循环。这一过程依赖工具调用、记忆系统和规划器等核心组件,将AI能力组织成可控的工作流。为确保系统稳定运行,必须建立基础设施层(Harne

weixin_30247307的博客 458

CANoe开发入门到精通读书笔记(2)——CAPL编程

CAPL函数的语法跟C语言很类似,但也包含一些C语言所不具备的功能大部分CAPL支持的数据类型都可以直接声明为函数参数, 例如,整型、浮点型、枚举、结构、定时器以及它们的引用。但有一些类型不能被直接声明,而需要加上*号(注意该符号并不是C语言中 指针的意思)。例 如 : signal * s 、 envvarInt * ev 、 sysvarFloat * sv 、 diagRequest * dr、diagResponse * dr、int matrix[][],以及。

weixin_66275497的博客 6459

INCA_ProF脚本教程

一、首先INCA软件是当前主流标定开发软件之一,尤其在动力系统控制器的标定中应用非常广泛;与此同时ProF编程脚本是INCA软件提供各种实用功能之一,使用者可根据需求编写ProF脚本语言对ECU闪存编程等各种自定义操作。 二、然而ProF脚本语言在ETAS的官网或其他网络上并没有专门的使用教程,通常只有ETAS技术支持人员提供的ProF Documentation文档或少量可参考的Demo案例,然而ProF Documentation文档仅涉及ProF语言的函数的操作说明,没有从全局的框架上介绍Pro

weixin_29389627的博客 1万+

阿里 AI 云诊断系统 Loop Engineering 实战:实现从日志扫描到预发部署的全自主闭环

AI加速了代码开发,却难以解决低效的人工运维循环?阿里云落地Loop Engineering生产级闭环方案,实现日志扫描、Bug修复到预发部署全自动化,线上错误量暴跌96%。一文读懂AI工程范式升级,助力工程师从“手动搬砖”转向“设计智能循环”。

2301_80289431的博客 753

Python爬虫实战:逆向解析央视频加密参数(附完整代码)

本文详细解析了央视频加密体系的技术实现,通过Python逆向工程实战演示如何解密动态密钥、AES加密和自定义哈希算法等核心组件。文章提供完整代码示例,涵盖GUID生成、参数构造和异步请求处理,帮助开发者掌握现代视频平台的反爬机制破解方法。

weixin_42532473的博客 1130

AI第四次范式转移:从Prompt到Loop,普通人如何落地循环机制

最近有个词在开发者圈子里火了——Loop。🎤 黄仁勋说"Prompt正在过时,Loop才是新范式"。Claude Code的创始人Boris Cherny说他早就不自己写提示词了,全让一堆Loop替他干活。OpenClaw的创始人Peter Steinberger一条关于Loop的推文,浏览量直接冲到150万。这不是什么新概念硬炒,而是AI编程正在经历第四次范式转移——从Prompt到Context,到Harness,再到Loop。

人工智能AI技术 433

python 抖音采集_python爬取抖音视频的实例详解

import requestsimport jsonimport reimport osfrom pprint import pprint as ppimport queueclass DouYin:header = {'accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*...

weixin_35795675的博客 1864

二阶锥松弛在配电网最优潮流计算中的应用(IEEE33节点配电网最优潮流算例matlab程序)(yalmip+cplex)

文献[7]建立了以支路潮流计算为基础的OPF模型,针对OPF中的非凸性约束,采用SOCR技术将其松弛为二阶锥约束,整个 OPF 模型则被转化为二阶锥规划( Second Order Cone Programming,SOCP)问题,对其求解可以得到全局最优解。其次结合辐射型配电网潮流特点建立支路潮流约束,并考虑配电网中的可控单元,包括分布式电源和离散、连续无功补偿装置,建立其出力约束,该模型为非凸非线性模型;式中,αj,t和βij,t分别为t时段内节点i电压的二次方和支路ij电流的二次方。

weixin_47365903的博客 1万+

构建可靠AI Agent的11个核心工程组件:超越提示词的智能体驾驭框架

在人工智能领域,大语言模型(LLM)作为核心推理引擎,为智能体(Agent)提供了强大的认知能力。然而,LLM本质上是无状态的,其输出具有非确定性,若直接应用于复杂业务场景,常面临可靠性差、易失控等问题。这背后涉及的是系统工程挑战,需要一套完整的驾驭框架(Harness)来管理其工作流、状态与工具调用。从技术原理看,一个成熟的Agent系统需通过工作流与状态管理组件充当中央处理器,为LLM提供上下文与执行剧本;通过工具执行器安全地连接外部能力;通过记忆系统实现短期与长期的信息保持。其技术价值在于将LLM的思

weixin_34331102的博客 344

恭喜,恭喜,iMouse爱鼠XP版全面发布测试,苹果手机自动化测试必须

电脑控制苹果手机,免越狱,免签名,自动化测试

qq_41057894的博客 1063

AI Agent工程化落地:从概念到生产系统的挑战与实战

大语言模型(LLM)和检索增强生成(RAG)作为当前人工智能的核心技术,其原理在于通过海量数据训练获得强大的语言理解和生成能力,并结合外部知识库进行信息增强。这些技术的核心价值在于能够构建具备复杂推理和任务执行能力的智能体(AI Agent),从而在自动化流程、智能决策等场景中释放巨大潜力。然而,要将实验室中表现惊艳的AI原型转化为稳定可靠的生产系统,面临着可靠性驯服、成本控制、效果评估等严峻的工程化挑战。本文聚焦于**AI Agent**的**工程化落地**实践,深入探讨如何通过多层验证、模型分级、智能编

conghuang7343的博客 426

使用 Simulink + Simscape Electrical 实现一个变压器耦合式单相全波整流器的仿真模型

本文介绍了基于Simulink的变压器耦合式单相全波整流器建模与仿真方法。详细说明了从项目创建、模块添加、电路搭建到参数配置的完整建模过程,重点分析了整流器的效率与损耗特性,包括变压器损耗和二极管导通损耗。通过仿真展示了输入输出波形特征,并提出了选用高效元件、优化变压器设计等改进建议。该案例为电力电子系统建模提供了实用参考,有助于深入理解整流电路工作原理和性能优化方法。

amy_mhd的博客 187

Amazon Skills:51个AI技能赋能亚马逊运营,从选品到广告全链路分析

在电商运营领域,数据分析和自动化工具正成为提升效率的关键。其核心原理在于将专业经验转化为结构化指令,使AI能够执行标准化流程。这种技术价值体现在降低专业门槛、提升决策效率,尤其适用于亚马逊这类数据驱动的电商平台。通过将选品、关键词研究、FBA费用计算、PPC广告优化等运营框架编码为可执行指令,AI助手能够模拟专家思维进行市场分析。Amazon Skills项目正是这一理念的实践,它提供51个覆盖运营全链路的技能模块,让卖家在自然对话环境中获得专业分析支持,实现从市场研究到利润核算的自动化工作流。

weixin_27134143的博客 1304
上一篇: SDD:让 AI 写代码,先写一份好「剧本」
mxpan
博客等级 码龄18年 176粉丝 42原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

mxpan

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值