语音即表情:音频驱动说话人脸生成的技术演进

AI数字人:语音驱动面部模型及超分辨率重建Wav2Lip-HD 数字人打造中语音驱动人脸和超分辨率重建两种必备的模型,它们被用于实现数字人的语音和图像方面的功能。通过Wav2Lip-HD项目可以快速使用这两种模型,完成高清数字人形象的打造。 阅读详情
AI摘要

在计算机视觉与多模态生成领域,音频驱动的说话人脸生成需求日益增长,但面临诸多挑战。随着深度生成模型发展,该技术取得突破性进展,如ControlTalk、Ditto等方法。本文深入探讨其最新进展、技术瓶颈,展示创新方法,以提升系统自然度、实时性与通用性。

在计算机视觉与多模态生成领域,音频驱动的说话人脸生成(Audio-driven Talking Face Generation)是一项极具前沿性的研究任务,旨在根据输入语音驱动静态图像或视频中的人脸做出自然、同步的说话动作。随着虚拟人、数字主播、影视制作和实时交互等应用场景的快速扩展,该技术的实际需求日益增长,并成为构建高保真数字人系统的关键组成部分。然而,该任务面临诸多挑战,包括面部表情与语音节奏的同步、头部运动的自然性、跨语言的泛化能力,以及在不同身份下保持高一致性的面部结构。此外,实时性和可控性也是制约其落地的重要因素。为了应对这些难题,研究者们提出了一系列具有创新性的模型结构与训练策略。近年来,随着深度生成模型,尤其是扩散模型(Diffusion Models)与可控生成技术的发展,音频驱动人脸生成取得了突破性进展。例如,ControlTalk 通过轻量化的适配策略和预训练渲染器,统一了图像与视频输入下的表情建模流程,支持精细的嘴形控制;Ditto 引入了去VAE化的显式运动空间,在保证实时性能的同时,实现了可控的高质量生成;而 MuseTalk 和 Talking-Gaussian 等方法,则分别从高效的推理结构和三维辐射场建模出发,进一步提升了生成的真实感与一致性。这些前沿技术共同推动了音频驱动说话人脸生成的发展,使其更加贴近真实人类交流的表现力,并为下一代智能交互系统奠定了坚实基础。

 我们将深入探讨该方向的最新进展,分析当前所面临的技术瓶颈,并展示具有代表性的创新方法,进一步探索如何通过多模态深度学习技术,提升说话人脸生成系统的自然度、实时性与通用性。

论文1:
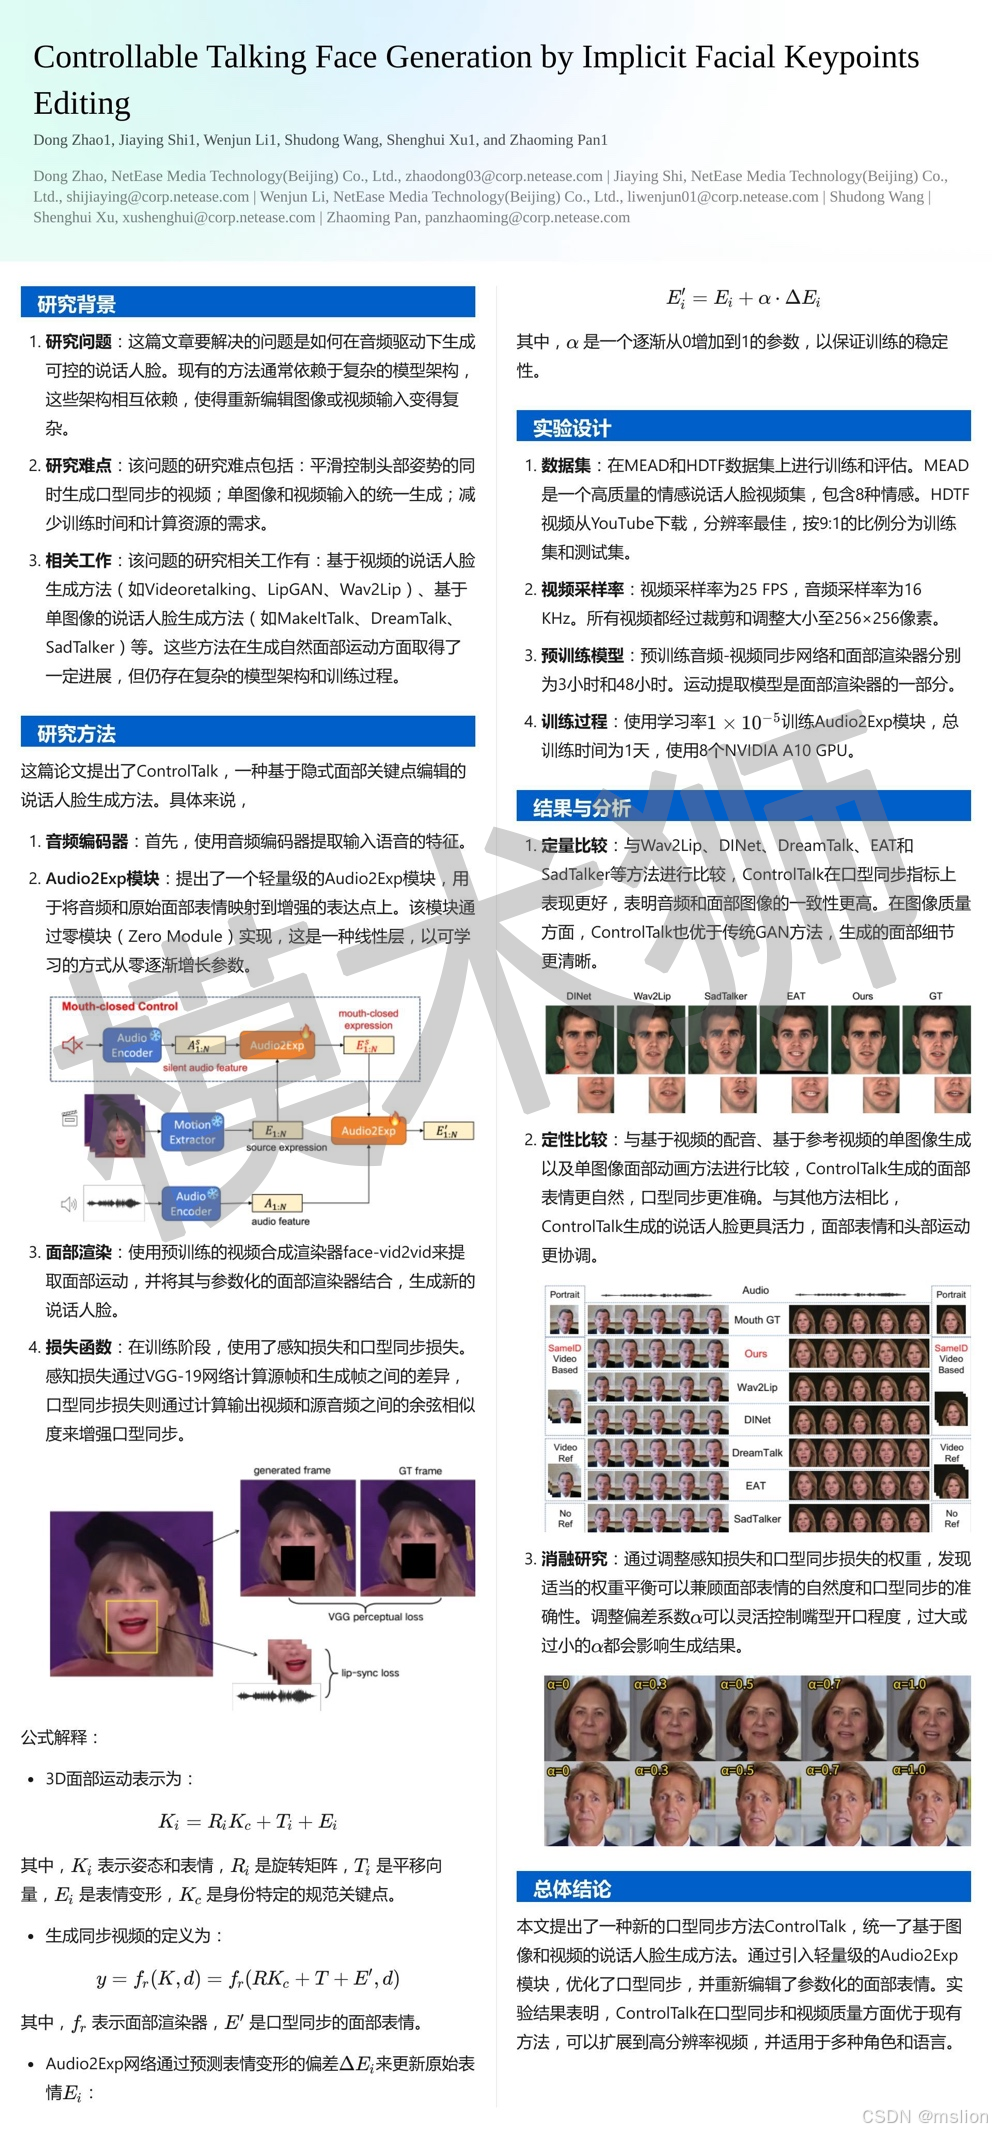
优点与创新:

  1. 提出了一个新的基于变形的框架TalkingGaussian,通过在持久的头结构上应用变形来合成高质量的3D说话头视频,避免了由于不准确的外观预测导致的“面部失真”问题。
  2. 提出了Face-Mouth Decomposition模块,通过分解冲突的学习任务来简化变形建模,从而提供准确的嘴部重建和唇形同步。
  3. 采用了3D高斯散点(3DGS)来保持头部的稳定几何结构和不变的外观,简化了面部运动的建模难度。
  4. 通过增量采样策略优化变形学习,避免了梯度消失问题,提高了生成视频的平滑性和真实性。
  5. 在自重建设置和唇形同步设置中均表现出色,特别是在跨性别和跨语言情况下展示了良好的泛化能力。

论文2:
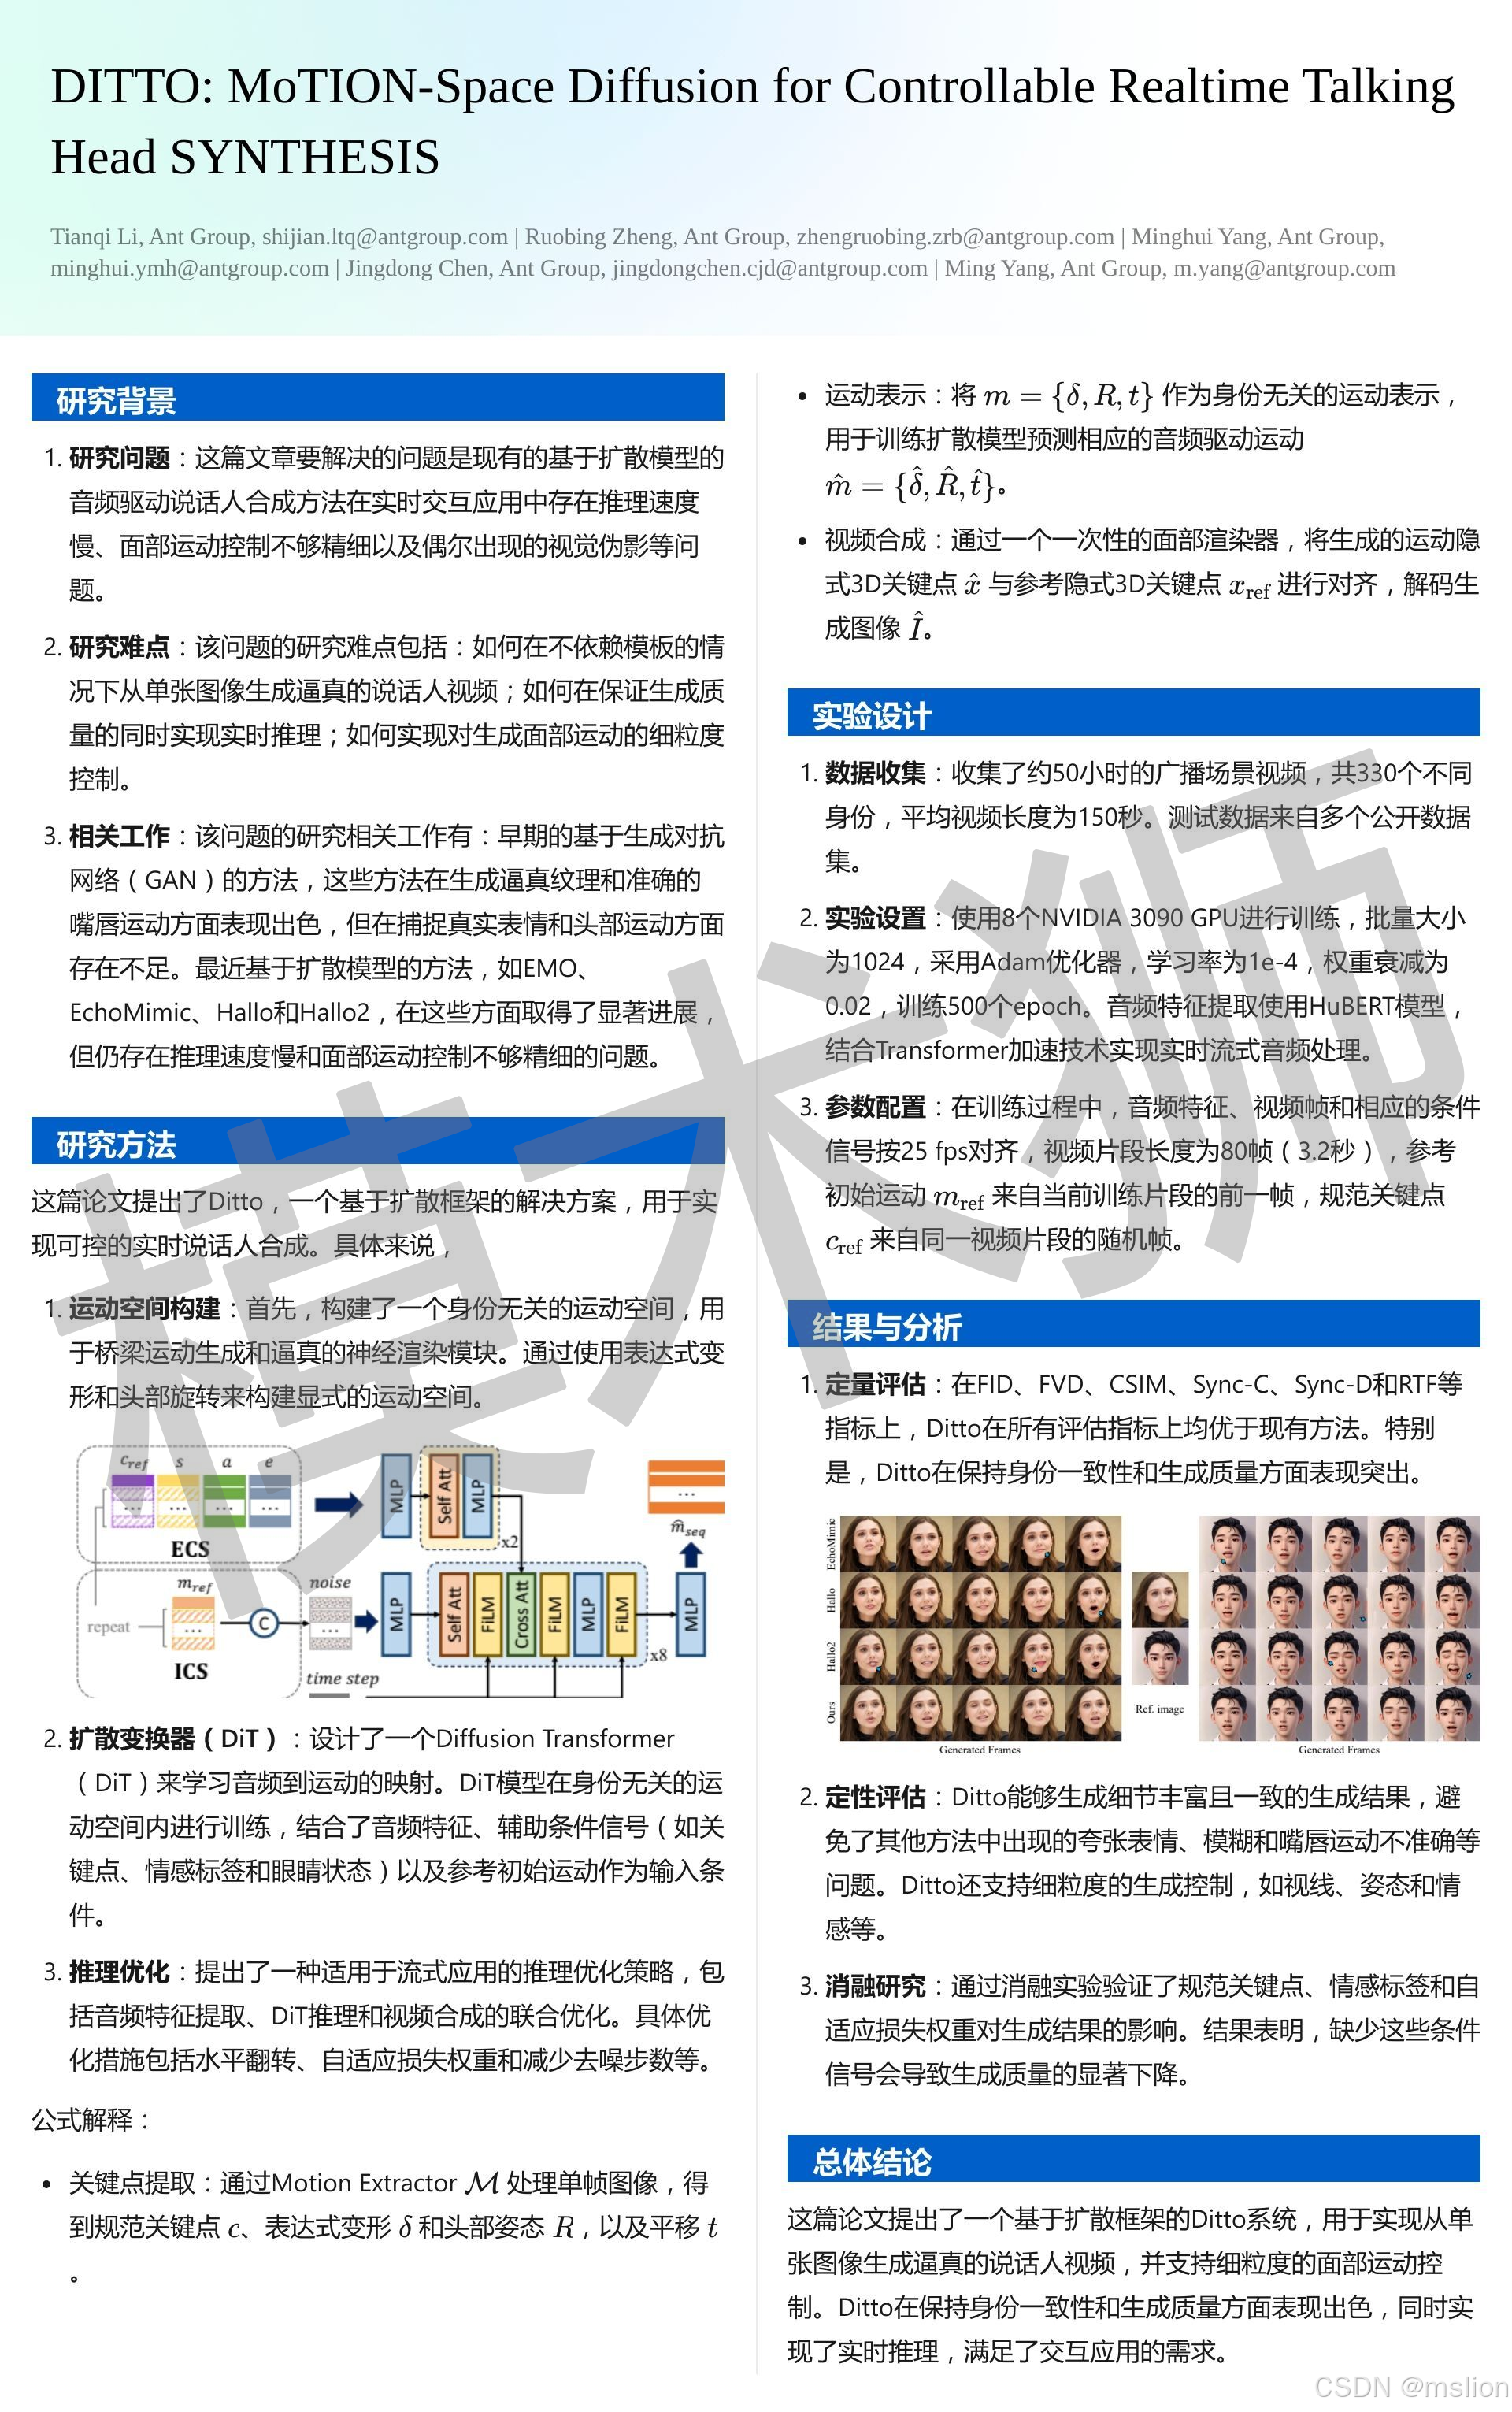
优点与创新:

  1. ​Ditto通过显式的身份无关运动空间桥接了运动生成和逼真的神经渲染,替代了传统的VAE表示,显著降低了扩散学习的复杂性,同时实现了对合成说话头的精确控制。
  2. ​提出了一种推理策略,联合优化音频特征提取、运动生成和视频合成三个关键组件,实现了流处理、实时推理和低首帧延迟,满足了交互应用(如AI助手)的功能性要求。
  3. ​通过显式运动空间,Ditto能够实现对面部运动的细粒度控制,包括区域控制和幅度控制,提升了生成视频的真实感和细节表现。
  4. ​ Ditto在保持高质量生成的同时间,实现了实时推理,显著优于现有方法在运动控制和实时性能方面的表现。
  5. ​在音频条件的基础上,结合了关键点、情感标签和眼睛状态等多种辅助条件,提高了生成结果的一致性和可控性。

论文3:
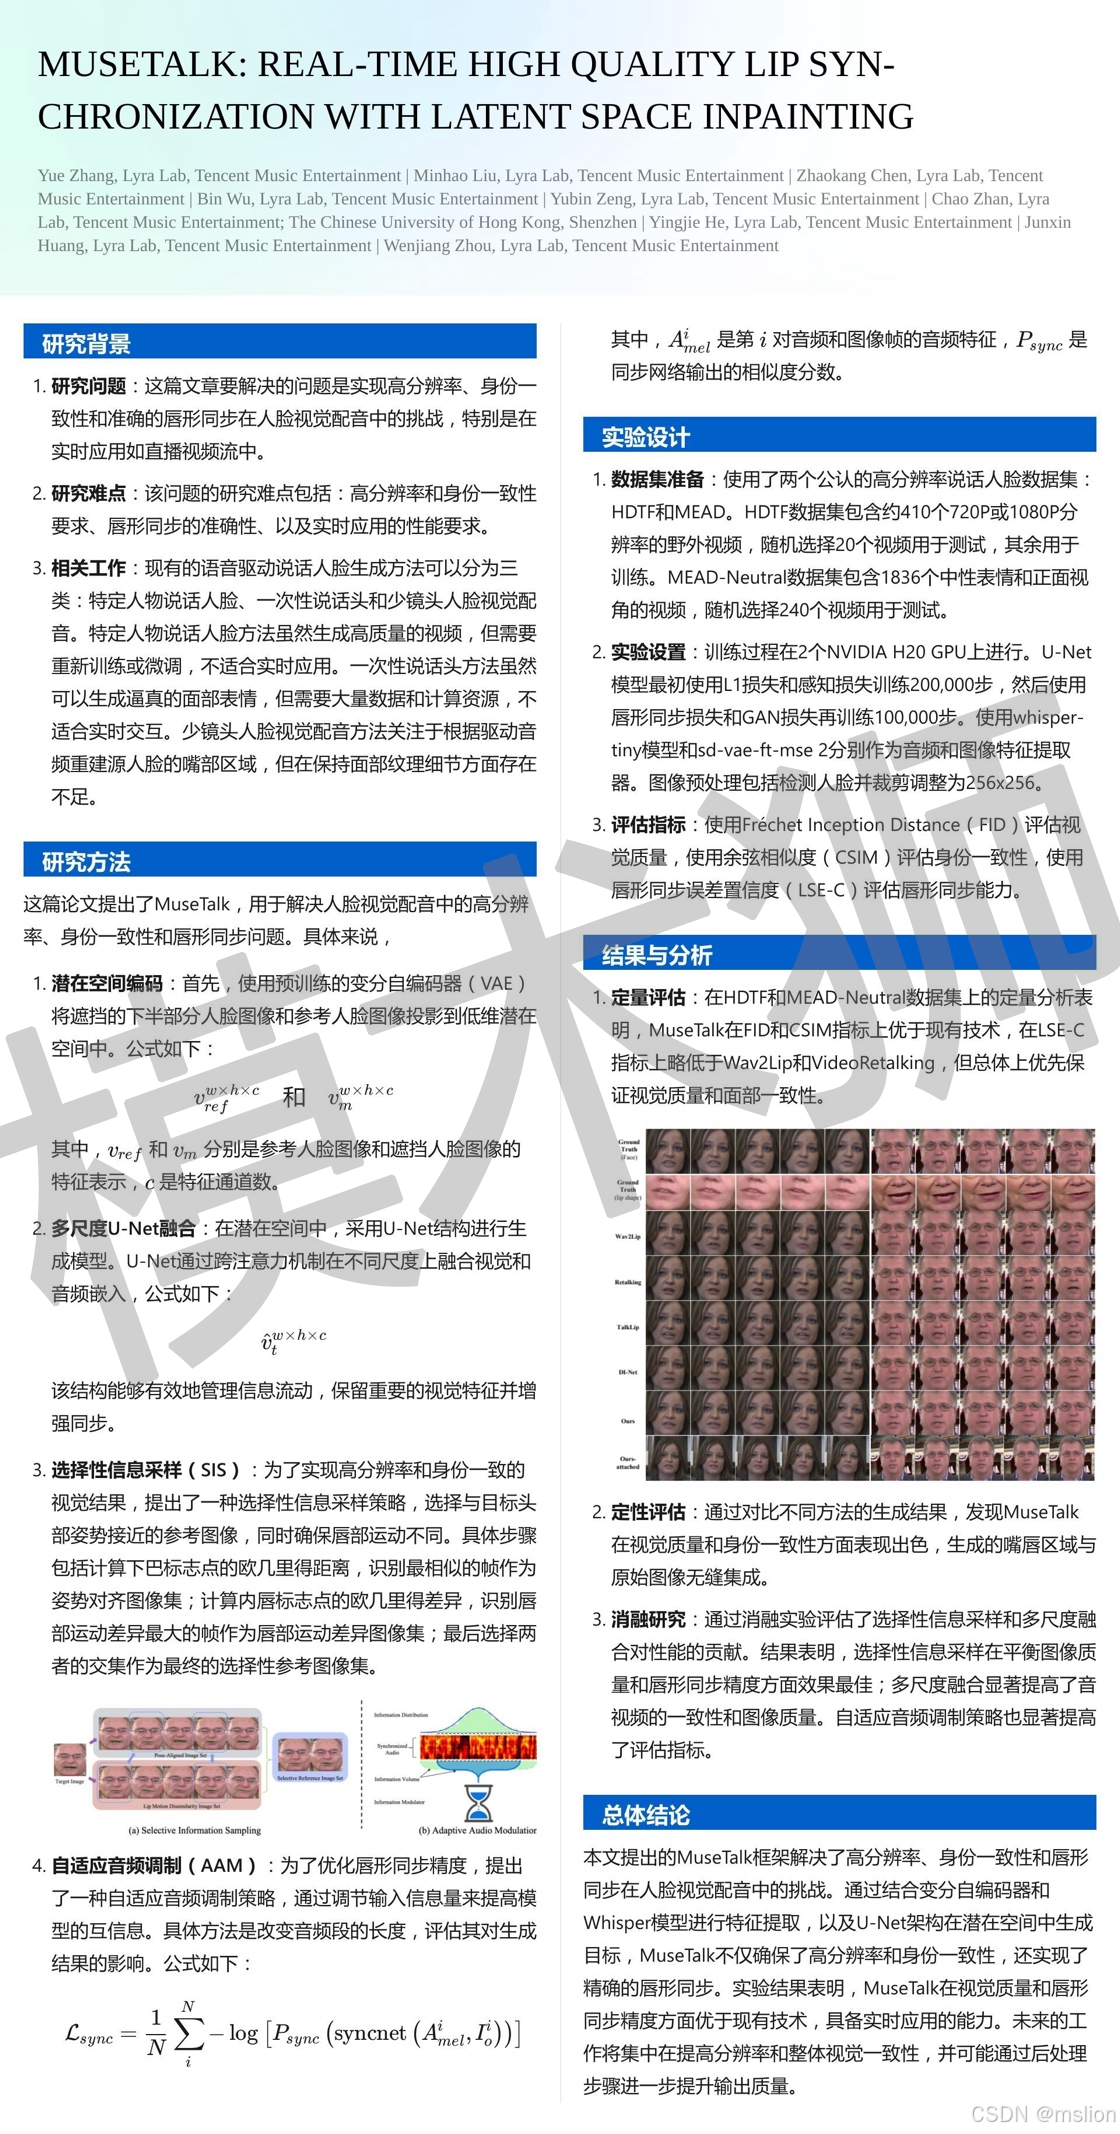
优点与创新

  1. MuseTalk能够在保证实时推理能力的情况下生成256x256的高分辨率人脸图像。
  2. ​通过变分自编码器(VAE)在潜在空间中生成口型同步目标,保持了高质量和快速推理。
  3. ​采用U-Net结构在不同尺度上融合音频和视觉特征,提高了信息流动效率,保留了重要的视觉特征并增强了同步效果。
  4. ​提出了一种新的采样策略,选择与目标头部姿势最接近的参考图像,确保模型专注于精细的嘴唇纹理。
  5. ​通过调制输入信息量,优化了唇形同步精度,增强了音频和视觉之间的互信息。
  6. ​在视觉保真度和唇形同步精度方面显著优于现有技术,为更高级的音频驱动视觉配音应用铺平了道路。
  7. ​支持在NVIDIA Tesla V100上以超过30 FPS的速度在线生成256x256的人脸图像,具备实时应用的能力。

论文4:
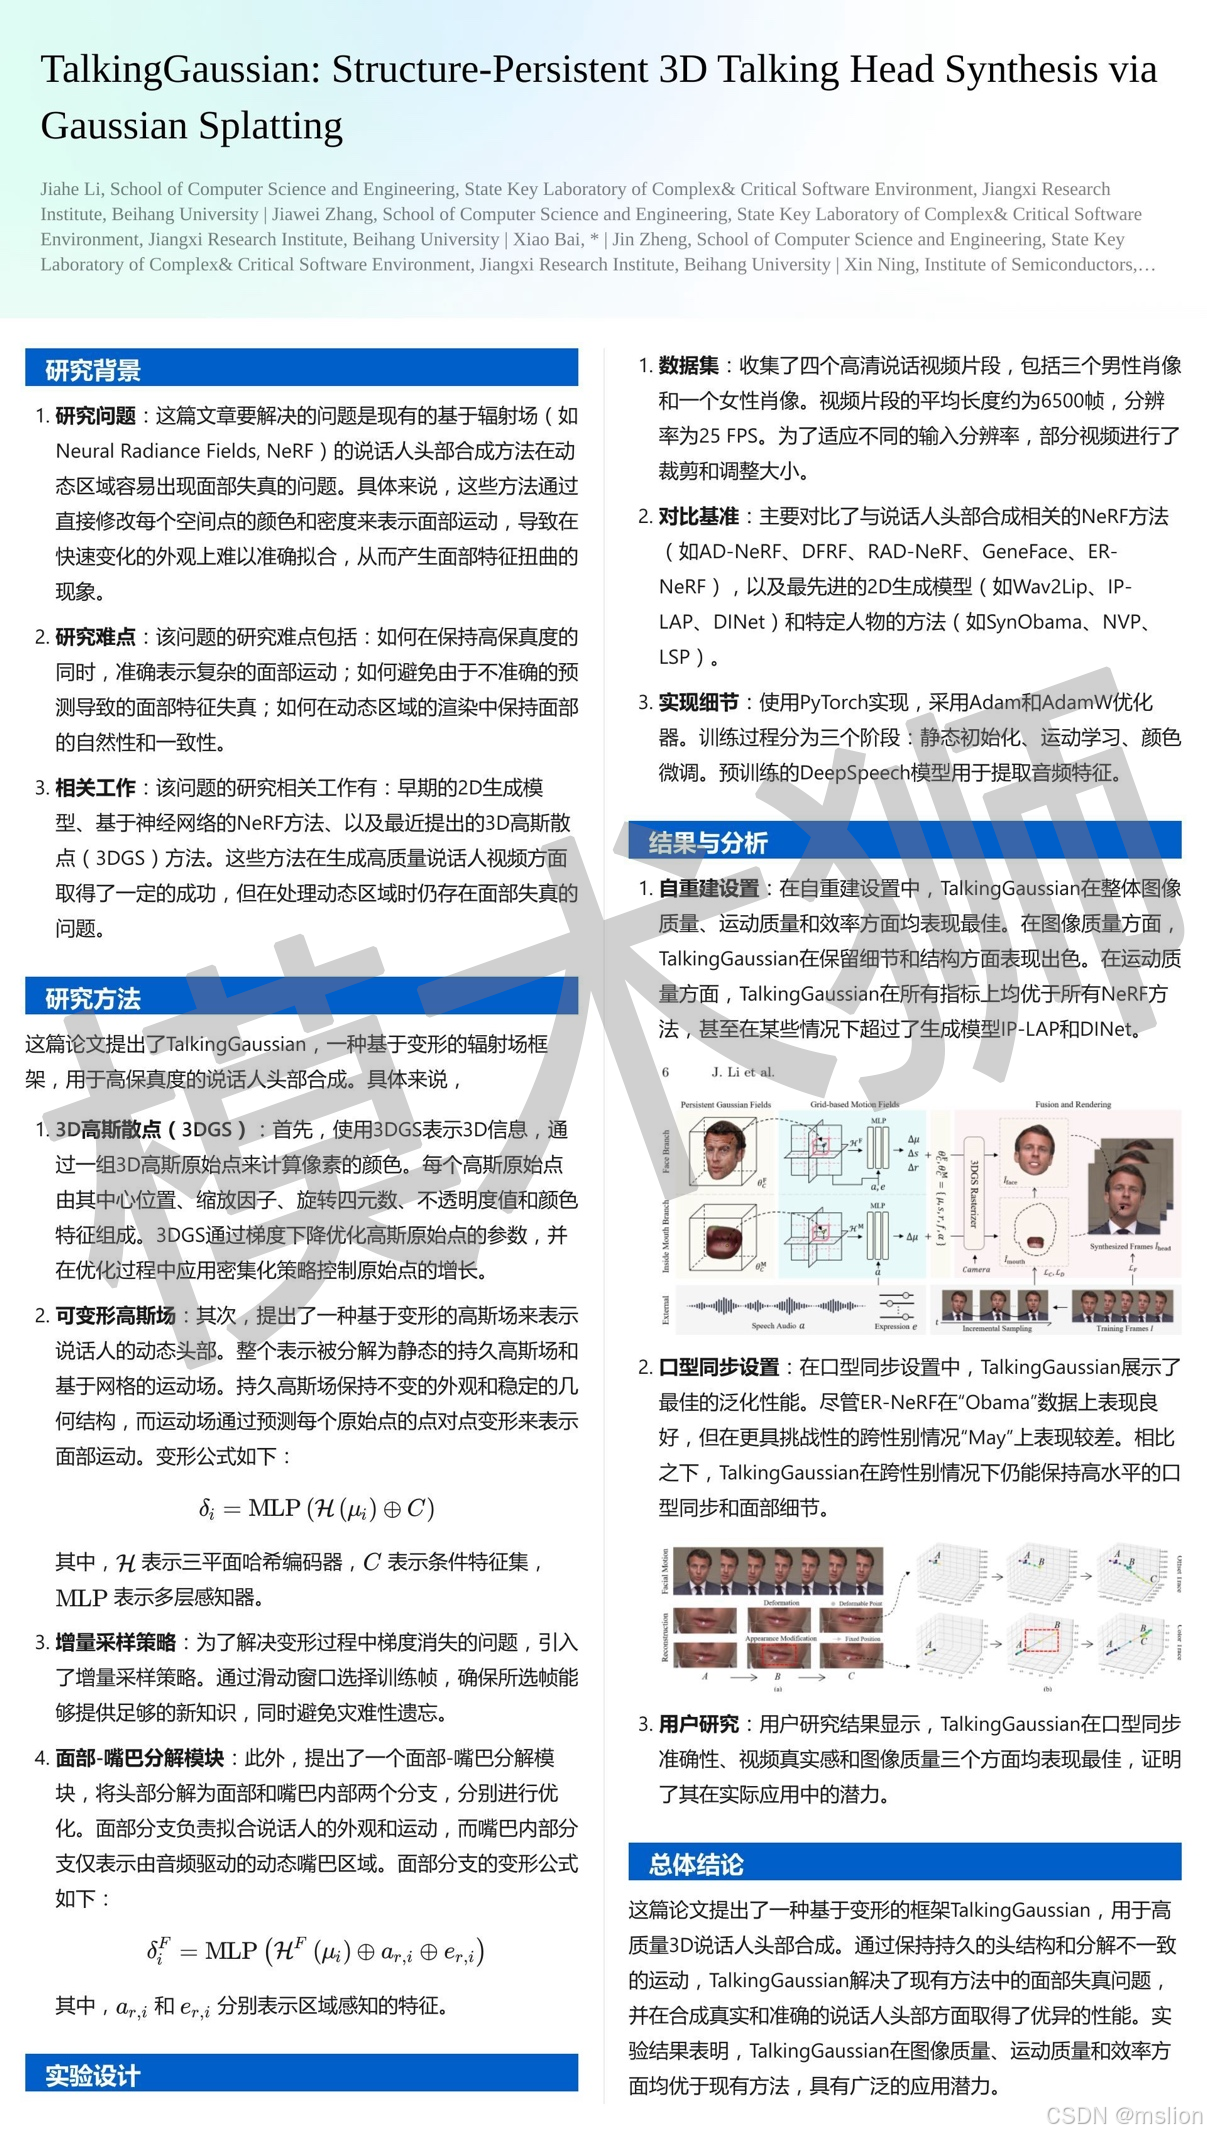
优点与创新

  1. 提出了一个新的基于变形的框架TalkingGaussian,通过在持久的头结构上应用变形来合成高质量的3D说话头视频,避免了由于不准确的外观预测导致的“面部失真”问题。
  2. 提出了Face-Mouth Decomposition模块,通过分解冲突的学习任务来简化变形建模,从而提供准确的嘴部重建和唇形同步。
  3. 采用了3D高斯散点(3DGS)来保持头部的稳定几何结构和不变的外观,简化了面部运动的建模难度。
  4. 通过增量采样策略优化变形学习,避免了梯度消失问题,提高了生成视频的平滑性和真实性。
  5. 在自重建设置和唇形同步设置中均表现出色,特别是在跨性别和跨语言情况下展示了良好的泛化能力。
跨模态情感迁移技术:AI语音驱动面部表情的突破 跨模态学习是人工智能领域的重要研究方向,通过建立不同模态数据间的映射关系实现信息互补。在语音与视觉的跨模态应用中,情感特征迁移技术能够将语音中的情感信息转化为对应的面部表情变化,解决了传统方法依赖预设标签或大量标注数据的问题。这项技术的核心在于设计高效的跨模态特征提取与对齐算法,如对比学习和Transformer架构,在保持唇部同步精度的同时显著提升情感表达的准确性。在虚拟数字人、远程教育等场景中,该技术可实现更自然的AI人机交互体验,其中语音情感识别与面部动作生成的协同优化是关键突破点。 阅读详情

相关推荐

基于机器学习的语音驱动人脸动画方法

语音与唇动面部表情的同步是人脸动画的难点之一.综合利用聚类和机器学习的方法学习语音信号和唇动面部表情之间的同步关系,并应用于基于MEPG-4标准的语音驱动人脸动画系统中.在大规模音视频同步数据库的基础上,利用无监督聚类发现了能有效表征人脸运动的基本模式,采用神经网络学习训练,实现了从含韵律的语音特征到人脸运动基本模式的直接映射,不仅回避了语音识别鲁棒性不高的缺陷,同时学习的结果还可以直接驱动人脸网格.最后给出对语音驱动人脸动画系统定量和定性的两种分析评价方法.实验结果表明,基于机器学习的语音驱动人脸动画不仅能有效地解决语音视频同步的难题,增强动画的真实感和逼真性,同时基于MPEG-4的学习结果独立于人脸模型,还可用来驱动各种不同的人脸模型,包括真实视频、2D卡通人物以及3维虚拟人脸.

Ditto-talkinghead:实时可控说话人头合成的动态度扩散技术

Ditto-talkinghead 是一项基于动态度扩散(Motion-Space Diffusion)技术的实时可控说话人头合成项目。该项目由 Ant Group 开发,旨在通过先进的深度学习模型,实现高逼真度的说话人头动态生成,为虚拟现实、在线教育、远程通讯等领域提供强大的技术支持。 ## 项目技术分析 Ditto-talkinghead 利用了一种新颖的动态度扩散模型,该模型在生成对抗网

gitblog_00039的博客 1269

奥比中光Gemini335L SDK实战:从标定参数到3D点云转换

本文详细介绍了奥比中光Gemini 335L深度相机的SDK实战应用,重点讲解如何跳过繁琐的棋盘格标定,直接调用出厂预标定参数实现高效的3D点云转换。通过解析内参、外参获取及四种核心坐标转换模式,并结合OpenCV等工具,指导开发者快速将相机集成到机器人抓取、三维测量等项目中,实现开箱即用的3D视觉解决方案。

raspberrypi5的博客 641

ditto-talkinghead 的安装和配置教程

`ditto-talkinghead` 是一个开源项目,旨在提供一个基于机器学习的实时人脸动画解决方案。该项目允许用户将任意人脸图像转化为具有说话功能的3D头像。项目的主要编程语言是 Python,这是一种易于学习和使用的语言,非常适合快速开发和原型设计。 ## 2. 项目使用的关键技术和框架 该项目使用了一系列先进的技术和框架,包括但不限于以下内容: - **TensorFlow**: 一

gitblog_00108的博客 569

深入解析磁盘性能测试:vdbench与fio的实战对比

本文深入对比了磁盘性能测试两大工具vdbench与fio的核心定位与实战应用。vdbench擅长多客户端、可编排的存储系统集成测试,而fio则以灵活的单机深度定制见长,是测试硬件极限和模拟特定应用IO模型的利器。文章通过安装指南、参数解析和典型场景对比,帮助读者根据需求选择合适工具,精准评估磁盘性能。

weixin_29300931的博客 330

SDI-12协议与STM32 进行uart通信

其中DIR_OUT_SDI是一个IO引脚,控制UART_TX_SDI是否使能,U10是三态门IC,即拉低DIR_OUT_SDI使能stm32输出,拉高DIR_OUT_SDI失能输出,串口配置8位数据位,偶校验,1位停止位,1200波特率。示波器测试得到传感器的应答信号如下:第一个是唤醒信号,拉高电平13毫秒,之后保持20毫秒低电平,第二个数据帧是激活信号,即ascii码: "0!",第三个是传感器的应答信号:"0\r\n"

weixin_42186805的博客 4404

Ditto-Talkinghead:阿里巴巴数字人技术新突破 [特殊字符]️

阿里巴巴推出了一项新的数字人技术,名为 Ditto-Talkinghead。这项技术主要用于生成由音频驱动的说话头,也就是我们常说的“数字人”。这些问题很大程度上是由于依赖变分自编码器(VAE)产生的隐式潜在空间造成的。

2401_86439035的博客 731

从Simulink仿真到DSP28335真机部署:PID闭环控制快速移植指南

本文详细介绍了如何将Simulink中的PID闭环控制算法快速移植到DSP28335嵌入式平台。通过模型与代码映射、浮点与定点数选择、定时器中断配置、物理输出实现以及调试技巧五个关键步骤,帮助工程师高效完成从仿真到真机部署的全过程,特别适合需要实现精确控制的嵌入式开发者。

weixin_42521843的博客 363

Ditto-Talkinghead让数字人“开口说话”像真人一样自然!

为了解决这些问题,引入了 Ditto,这是一个基于扩散的框架,可实现可控的实时说话头合成。然而,这些方法面临着推理速度慢、对面部运动的精细控制不足以及偶尔出现的视觉伪影,这主要是由于变分自动编码器 (VAE) 衍生的隐含潜在空间造成的,这阻碍了它们在实时交互应用中的采用。除了精确的嘴唇同步之外,基于扩散的方法还擅长生成与音频信号完美对齐的微妙表情和自然的头部运动。也许不久的将来,每个人都能拥有自己的“数字分身”,而这一天,可能比想象中来得更快。:在视频通话中,用户可以选择个性化的说话人头,增强沟通体验。

Jonathan.Wei的专栏 1100

华为OD机试真题 新系统2026-04-08 Python&JS 实现【配置操作失败数量统计】

模拟一个系统的命令行配置,包含添加、修改、删除三项操作,详情如下: 添加操作命令:add_rulerule_id=1rule_index = 18 修改操作命令: mod_rule rule_id= 1rule_index = 100 删除操作命令:del_rulerule_id=1

MISAYAONE的博客 586

扩充两个三维体积:ITK实现

在医学图像处理中,经常需要进行 3D 体积的操作,比如合并、分割等。而 ITK (Insight Segmentation and Registration Toolkit) 是一个常用的开源库,可以用于实现各种医学图像处理算法。这篇文章将介绍如何使用 ITK 实现扩充两个三维体积的操作。不过以上代码已经足够简单明了地演示了如何使用 ITK 实现扩充两个三维体积的操作。首先,我们需要准备两个三维体积的数据。这里假设这两个体积大小相同,并且已经加载到内存中了。来读取和保存体积数据,使用了。

CodeVorter的博客 205

终极指南:SadTalker音频驱动说话人脸动画技术架构深度解析

SadTalker是CVPR 2023会议上发布的一项突破性技术,它能够通过单张静态人像和音频文件生成逼真的说话人脸动画视频。这项技术将音频特征转化为3D面部运动系数,实现高质量、自然流畅的嘴唇同步和面部表情动画效果。 ## 🎯 SadTalker核心技术架构 ### 音频到表情映射系统 SadTalker的核心在于其精心设计的音频到表情映射架构。系统通过[Audio2Exp模型](htt

gitblog_00668的博客 481

MVDR算法: 自适应波束形成在信号处理领域中扮演着重要的角色。本文将介绍MVDR(最小方差无失真响应)算法,并提供相应的Matlab源代码实现。

MVDR算法是一种用于抑制干扰信号并增强感兴趣信号的自适应波束形成算法。它的基本思想是通过对干扰信号进行空间滤波,使其在感兴趣信号方向上的输出功率最小化。这种方法可以提高信号的质量和可辨识度,特别是在存在多个干扰源的复杂环境中。本文将介绍MVDR(最小方差无失真响应)算法,并提供相应的Matlab源代码实现。使用MVDR算法,我们可以通过对观测信号进行波束形成来抑制干扰信号并增强感兴趣信号。以上是MVDR算法的Matlab实现。的每一列代表一个阵列元素的观测信号。表示期望的波束指向,即感兴趣信号的方向。

HackWhisper的博客 1246

VividTalk:当声音遇见脸庞,AI如何让静态照片“开口说话“?

你是否曾幻想过,让一张普通的照片突然"活"过来,不仅能动,还能跟着你的声音说话、微笑、眨眼?这不再是科幻电影的情节,而是VividTalk正在实现的技术革命。这个开源项目正在重新定义"音频驱动人脸生成"的边界,让AI真正理解声音与表情之间的微妙联系。 ## 从静态到动态:一场视觉语言的革命 在数字内容爆炸的时代,我们每天接触着海量的图片和视频。但你是否注意到,大多数内容创作仍然需要复杂的拍摄设

gitblog_00288的博客 1170

ZYNQ工业级串口方案:AXI UART 16550扩展RS-485实战(自动方向控制+Linux驱动)

可以轻松扩展出多路工业级串口。但常规方案需要手动控制收发方向(DE/RE引脚),存在实时性差、CPU占用高等痛点。本文从硬件逻辑设计到Linux驱动开发,完整实现了ZYNQ平台的RS-485工业通信方案。,解决了传统方案实时性差的痛点。所有代码均经过实际项目验证,可直接用于生产环境。:尝试将此设计扩展为多协议兼容接口(支持RS-422/RS-232切换)!等特性,依然是现场总线通信的首选。,通过硬件逻辑+Linux驱动协同设计,实现零延迟切换。在工业自动化、能源电力等场景中,RS-485凭借。

QQ_778132974的博客 830

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

CVPR 2024 人脸技术全景:从3D头像重建到情感驱动的面部合成

本文深度解析了CVPR 2024在人脸技术领域的最新突破。核心趋势是3D头像重建技术正走向普及,单张照片即可生成高质量数字分身。同时,情感驱动的面部合成技术让数字人表情更富感染力,而基于神经辐射场(NeRF)的可编辑3D生成与实时渲染技术,正推动虚拟形象创作进入高效、可控的新阶段。

p1q2r的博客 794

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

从静态肖像到动态表达:揭秘SadTalker音频驱动人脸动画的技术奥秘

当数字内容创作进入AI时代,一个核心挑战摆在开发者面前:如何让单张静态肖像"活"起来,根据音频自然生成逼真的说话动画?传统的语音驱动面部动画技术往往需要复杂的3D建模或大量训练数据,而**SadTalker**以其创新的技术架构,为这一难题提供了优雅的解决方案。 ## 技术挑战与解决方案概述 想象这样一个场景:您手头只有一张人物肖像照片和一段语音录音,却需要制作一段自然的说话视频。传统方法面临

gitblog_00093的博客 350

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

AIGC数字人核心技术解析:语音、表情、动作如何实现?

AIGC(AI-Generated Content)数字人作为人机交互的终极形态,正在重塑教育、电商、影视、客服等领域的用户体验。本文聚焦数字人语音、表情、动作三大核心模块的技术实现,覆盖从算法原理到工程落地的全流程,帮助开发者理解数字人“会说话、有表情、能动作”的底层逻辑。核心概念定义数字人技术边界;分模块解析语音、表情、动作的生成原理;数学公式与代码示例详解关键算法;实战案例演示端到端数字人系统搭建;总结未来趋势与挑战。AIGC数字人。

AI 原生应用开发的博客 2122

FaceFusion支持语音同步表情吗?未来功能路线图曝光

FaceFusion目前尚不支持语音驱动的表情同步,但其插件式架构为集成Audio2Face技术提供了可能。通过结合音频特征提取与面部动作迁移模型,未来有望实现唇形、表情与语音的自然匹配,推动其从换脸工具向数字人引擎演进。

weixin_42579969的博客 613

揭秘:如何让Blender听懂语音并让角色自动开口说话

想象一下这样的场景:你正在为一个动画项目制作角色对话镜头,传统方法需要逐帧调整口型、表情和头部动作,这个过程可能要耗费数小时甚至数天。但现在,有了SadTalker这项CVPR 2023的开源技术,你只需要一张角色图片和一段语音,就能在几分钟内生成自然的面部动画。更棒的是,我们可以将这项AI能力直接集成到Blender中,让动画制作流程实现质的飞跃。 ## 从语音到表情:理解SadTalker的

gitblog_00070的博客 647

腾讯混元语音数字人模型:让静态头像“开口说话“的技术革命

想象一下这样的场景:您手头只有一张人物照片和一段录音,能否让照片中的人物"活"过来,配合录音内容做出自然的唇形动作和表情变化?腾讯混元实验室开源的HunyuanVideo-Avatar模型,正是这样一个能将想象变为现实的技术利器。 ## 技术核心:多模态融合的智能生成引擎 HunyuanVideo-Avatar采用创新的多模态扩散Transformer架构,构建了一个完整的音频驱动视频生成系统

gitblog_00286的博客 1148

CVPR 2023 SadTalker:从单张图片到语音驱动面部动画的技术实践

想象这样一个场景:你手中有一张精美的角色肖像,需要为它配上语音并生成自然的说话动画。传统方案需要动画师逐帧调整口型、表情和头部姿态,耗时数小时甚至数天。而SadTalker将这个过程缩短到几分钟内,通过深度学习模型实现了"图片+音频=说话视频"的魔法转换。 我们面对的不仅是技术实现,更是创作效率的革命。无论是虚拟主播、数字人创作、教育内容制作,还是游戏角色动画,SadTalker都提供了一套完整

gitblog_00294的博客 445

语音驱动面部动画技术:基于SadTalker的单图生成解决方案

在数字内容创作领域,动画师常面临角色口型与语音同步的挑战,传统逐帧调整需耗费数小时。SadTalker作为CVPR 2023开源项目,通过深度学习技术实现单张肖像图片与音频的自然面部动画生成,将动画制作效率提升10倍以上。该项目采用模块化架构设计,将音频特征提取、3D运动系数预测和面部渲染流程解耦,为开发者提供了灵活可扩展的语音驱动动画生成框架。 ## 架构设计与核心原理 SadTalker的

gitblog_01149的博客 739

SadTalker深度解析:基于3D运动系数的音频驱动数字人动画实战指南

SadTalker的核心技术架构基于3D Morphable Model(3DMM)和深度学习融合,实现了从音频信号到面部表情系数的端到端映射。系统采用多阶段处理流程,将音频特征转化为3D面部运动参数,最终生成逼真的说话人脸动画。 ### 音频特征提取与编码 系统首先通过Mel频谱图提取音频的时序特征,这些特征包含了语音的韵律、音调和情感信息。在`src/audio2exp_models/au

gitblog_00349的博客 826

从研究到落地:Sonic数字人模型的技术演进路径

Sonic是腾讯与浙大联合研发的轻量级语音驱动数字人口型同步模型,仅需一张静态人像和一段音频即可生成自然说话视频。通过深度学习直接建立声音到嘴部动作的映射,结合ComfyUI实现分钟级视频生成,在电商、教育、政务等场景中大幅降低内容生产成本。

weixin_36235398的博客 813

AI人脸动画革命:从静态照片到生动对话的技术突破

还在为制作虚拟主播内容而烦恼吗?想让人物照片开口说话却担心效果生硬?今天我们就来深度剖析当前最值得关注的AI人脸动画技术,帮你找到最适合的解决方案。 ## 痛点直击:传统动画制作的三大困境 在传统动画制作中,我们常常面临这样的困扰: - 制作周期长,一个简单的口型动画就需要数小时 - 技术要求高,需要专业的3D建模和动画技能 - 成本投入大,软件许可和人力成本居高不下 AI人脸动画技术的出现

gitblog_00685的博客 427
上一篇: 跨域自监督学习:打破数据壁垒的创新突破
下一篇: 开放词汇语义分割新突破:无需训练的测试时自适应方法全解析
mslion
博客等级 码龄2年 427粉丝 39原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值