Spark-读取Parquet-为什么task数量会多于Row Group的数量

Flink与Spark读写parquet文件全解析 Parquet介绍 Parquet 是一种开源文件格式,用于处理扁平列式存储数据格式,可供 Hadoop 生态系统中的任何项目使用。 Parquet 可以很好地处理大量复杂数据。它以其高性能的数据压缩和处理各种编码类型的能力而闻名。与基于行的文件(如 CSV 或 TSV 文件)相比,Apache Parquet 旨在实现高效且高性能的平面列式数据存储格式。 Parquet 使用记录粉碎和组装算法,该算法优于嵌套命名空间的简单展平。 Parquet 经过优化,可以批量处理复杂数据,并具有不同的方式来实现高效的 阅读详情

翻译这篇文章的目的是为了让读者们更好的理解spark读取parquet的原理
一个row group 是读取parquet的不可分的最小单元,并且你会以为由spark创建的task数量不会多于在parquet数据源中的row groups的数量 但是spark却可以创建出多余row groups个数的task,让我们看看怎么回事

任务计划

一般来说,为了知道有多少个task数量,我们就必须去每一个parquet文件的footer以便于知道row groups的个数,但是这种操作是比较昂贵的,尤其是在云存储中,如,在运行任务之前,需要从S3中打开读取3000到5000个parquet文件的footer,这在任务启动之前将会是持续好几分钟。
但是为了加速任务的执行,我们采用了估算task的任务数,这样就无需读取parquet footer。
首先,spark先列举data source的文件数,获取总的大小,虽然在云存储中文件列举不是很快,但是至少比打开读取每个文件要快很多:

totalBytes = sum(fileSize + conf("spark.sql.files.openCostInBytes"))

注意,spark添加了spark.sql.files.openCostInBytes(默认是4M)到每个文件的大小中。
然后定义能够并行处理多少字节,并且考虑默认的并行度:

bytesPerCore = totalBytes / conf("spark.default.parallelism")

最后,spark把spark.sql.files.maxPartitionBytes和bytesPerCore的最小值作为每个任务的可以运行的数据大小:

maxSplitBytes = min(conf("spark.sql.files.maxPartitionBytes"), bytesPerCore)

并且spark会输出计算出的数据大小日志,如下:

logInfo(s"Planning scan with bin packing, max size: $maxSplitBytes bytes, " +
    s"open cost is considered as scanning $openCostInBytes bytes.")

这样,spark获取到maxSplitBytes,并且通过这个值在所有文件的迭代计算从而分配task的数量。
例如,假如有三个parquet文件(只有4个row groups):

  file1.parquet   368,565,268  (with 2 row groups)
  file2.parquet    46,584,043  (with 1 row group)
  file3.parquet   107,315,179  (with 1 row group)

这样,

 totalBytes = 368,565,268 + 46,584,043 + 107,315,179 + 3 * 4,194,304 = 535,047,402
 
  -- 2 executor instances with 4 cores means default parallelism is 8 in my test
  bytesPerCore = totalBytes / 8 = 66,880,925

  maxSplitBytes = min(134,217,728; 66,880,925) = 66,880,925  

在spark driver端会有只有的日志:

21/03/07 17:03:58 main INFO FileSourceScanExec: Planning scan with bin packing, 
max size: 66880925 bytes, open cost is considered as scanning 4194304 bytes.

这样将会分配9个task:

21/03/07 17:03:58 dag-scheduler-event-loop INFO DAGScheduler: Got job 0 
(performDistributedWrite at SqlWrapper.scala:70) with 9 output partitions

21/03/07 17:03:58 dag-scheduler-event-loop INFO YarnScheduler: 
Adding task set 0.0 with 9 tasks

为什么是9个task呢?Spark迭代所有的文件,并且检查在 每个文件上根据maxSplitBytes来分配task的数量:

  file1.parquet   368,565,268 - 6 tasks
  file2.parquet    46,584,043 - 1 task
  file3.parquet   107,315,179 - 2 tasks

通过以上可以看到spark无需读取parquet文件,无需知道数据源中的实际的row groups的任务,就可以计算出task的数量

默认的并行度

我们可以注意到task的数量不仅仅依赖于数据源的大小,也依赖于默认的并行度。
在yarn下,假如没有指定(–conf spark.default.parallelism),默认的并行度取决于executor的实例数和core数:

  default_parallelism = conf("spark.executor.instances") * conf("spark.executor.cores")

例如,当我们显示指定 --conf spark.default.parallelism=30,对于同样的三个parquet source文件,我们将会得到30任务

21/03/08 15:31:52 main INFO FileSourceScanExec: Planning scan with bin packing, 
max size: 17834913 bytes, open cost is considered as scanning 4194304 bytes.

21/03/08 15:31:52 dag-scheduler-event-loop INFO YarnScheduler: 
Adding task set 0.0 with 30 tasks

注意maxSplitBytes变成了17,834,913字节

row group的分配和空任务

好了,无论多少个任务被创建了出来,这个row group一直是parquet读取的最小单元,多个任务不能同时处理同一个row group。
并且每个任务需要知道每个文件中实际parquet row group的边界(offset和length),而不是通过以上计算出来的抽象的边界。
就像我们之前注意到的一样,在我们的测试中,这里将会有9个task去读取3个parquet文件:

21/03/19 05:23:49 INFO YarnScheduler: Adding task set 0.0 with 9 tasks
21/03/19 05:23:49 INFO TaskSetManager: Starting task 0.0 in stage 0.0 (executor 1, partition 0, ...)
21/03/19 05:23:49 INFO TaskSetManager: Starting task 1.0 in stage 0.0 (executor 2, partition 1, ...)
21/03/19 05:23:49 INFO TaskSetManager: Starting task 2.0 in stage 0.0 (executor 1, partition 2, ...)
21/03/19 05:23:49 INFO TaskSetManager: Starting task 3.0 in stage 0.0 (executor 2, partition 3, ...)
21/03/19 05:23:49 INFO TaskSetManager: Starting task 4.0 in stage 0.0 (executor 1, partition 4, ...)
21/03/19 05:23:49 INFO TaskSetManager: Starting task 5.0 in stage 0.0 (executor 2, partition 5, ...)
21/03/19 05:23:49 INFO TaskSetManager: Starting task 6.0 in stage 0.0 (executor 1, partition 6, ...)
21/03/19 05:23:49 INFO TaskSetManager: Starting task 7.0 in stage 0.0 (executor 2, partition 7, ...)
21/03/19 05:23:55 INFO TaskSetManager: Starting task 8.0 in stage 0.0 (executor 1, partition 8, ...)

观察Spark的Executor日志,我们能够看到文件的范围分配:

21/03/19 05:23:53 Executor task launch worker for task 2 INFO FileScanRDD: 
  Reading File path: s3://cloudsqale/data/file1.parquet, range: 133761850-200642775
21/03/19 05:23:53 Executor task launch worker for task 4 INFO FileScanRDD: 
  Reading File path: s3://cloudsqale/data/file1.parquet, range: 267523700-334404625
21/03/19 05:23:53 Executor task launch worker for task 6 INFO FileScanRDD: 
  Reading File path: s3://cloudsqale/data/file2.parquet, range: 0-46584043
21/03/19 05:23:53 Executor task launch worker for task 0 INFO FileScanRDD: 
  Reading File path: s3://cloudsqale/data/file1.parquet, range: 0-66880925
21/03/19 05:23:55 Executor task launch worker for task 8 INFO FileScanRDD: 
  Reading File path: s3://cloudsqale/data/file1.parquet, range: 334404625-368565268

Executor 2:

21/03/19 05:23:53 Executor task launch worker for task 1 INFO FileScanRDD: 
  Reading File path: s3://cloudsqale/data/file1.parquet, range: 66880925-133761850
21/03/19 05:23:53 Executor task launch worker for task 7 INFO FileScanRDD:
  Reading File path: s3://cloudsqale/data/file3.parquet, range: 66880925-107315179
21/03/19 05:23:53 Executor task launch worker for task 3 INFO FileScanRDD: 
  Reading File path: s3://cloudsqale/data/file1.parquet, range: 200642775-267523700
21/03/19 05:23:53 Executor task launch worker for task 5 INFO FileScanRDD: 
  Reading File path: s3://cloudsqale/data/file3.parquet, range: 0-66880925

但是在Spark UI中我们确只能看到4个task在处理数据(在我们的测试中,3个文件只有4个row group),而其他的只是读取0个记录:
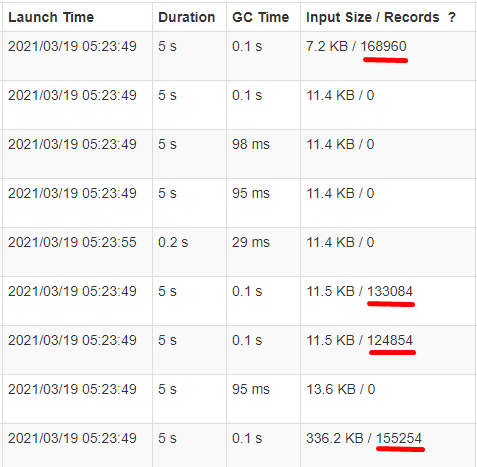
原因是在每个任务读取分配的parquet文件的footer的时候,会获取都一个row groups的列表,并且去检查这个任务分配的数据是否覆盖了row group的中点:
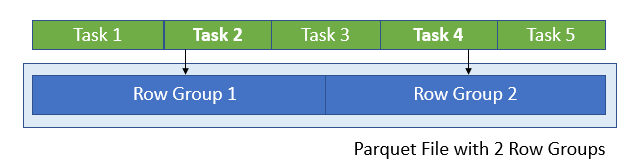
在以上例子中,5个任务被分配去读取一个有2个row groups的parquet文件,但是只有任务2和任务4读取数据,因为他们的数据范围覆盖了row group的中点。
更多的细节,可以参考ParquetFileFormat和 ParquetInputSplit以及org.apache.parquet.format.converterParquetMetadataConverter的filterFileMetaDataByMidpoint方法
所以虽然任务的数量多于row group的数量,但是这些冗余的任务实际上并不读取数据,但是他们都会去读取Parquet文件的footers,从而增加了IO操作,所以理想情况下,task的数量应该不要多于row groups的数量。

本文翻译自Spark – Reading Parquet – Why the Number of Tasks can be Much Larger than the Number of Row Groups


Apache Spark实战指南:从核心概念到生产环境调优 在大数据处理领域,分布式计算框架是处理海量数据的核心技术。其核心原理在于将计算任务分解并分发到多台机器上并行执行,从而突破单机性能瓶颈。这种技术价值在于能够高效处理TB甚至PB级的数据,广泛应用于数据分析、机器学习、实时流处理等场景。Apache Spark作为其中的杰出代表,凭借其内存计算和DAG调度引擎,显著提升了处理性能。本文聚焦于Spark的实战应用,深入探讨RDD、DataFrame等核心抽象,并结合性能调优与数据倾斜等常见工程挑战,提供从环境搭建到生产部署的完整解决方案。 阅读详情

相关推荐

数据科学平台演进:从VM到裸金属再到Serverless Spark

Serverless Spark是云原生数据工程的关键范式,其本质是将计算资源抽象从物理层(裸金属)、虚拟层(VM)跃迁至语义层——以声明式API驱动弹性调度与自动优化。它依托Spark成熟的DataFrame API和AQE自适应执行引擎,解决批流一体场景下的开发效率、运维负担与成本控制三重矛盾。相比Flink的强流式导向、Dask的轻量但不可控、Polars的单机局限,Spark在数据科学家熟悉度、状态管理能力、Serverless生态成熟度上形成独特优势。典型落地价值体现在小时级特征上线、零配置生产运

weixin_34214500的博客 422

Spark读写parquet

spark的parquet介绍 列式存储布局可加速查询,只检查需要的列并对执行计算,也就是只读取一个数据文件或表的小部分数据。 Parquet 支持灵活的压缩选项,可以显著减少磁盘上的存储。 转换需要时间,时间长了一些。 查询性能的提升在某些情况下可能达到 30 倍或更高,存储的节省可高达 75%。 如果在 HDFS 上拥有基于文本的数据文件或表,而且正在使用 Spark SQL 对它们执行查...

思过留痕 5325

Spark核心原理与实战:从内存计算到分布式数据处理

在大数据领域,分布式计算框架是处理海量数据的核心技术。其核心原理在于通过并行化计算任务,将数据分片处理,以突破单机性能瓶颈。内存计算技术通过减少磁盘I/O,将中间结果缓存在内存中,显著提升了迭代计算和交互式查询的性能,这是Spark相比早期MapReduce的关键突破。该技术的价值在于统一了批处理、流处理、机器学习和图计算等多种数据处理范式,极大地提升了开发效率和系统性能。其应用场景广泛,包括大规模ETL、实时数据分析、机器学习模型训练等。本文以Apache Spark为例,深入解析其弹性分布式数据集(RD

weixin_34159110的博客 314

大数据系列之:读取parquet文件统计数据量

大数据系列之:读取parquet文件统计数据量

zhengzaifeidelushang的博客 1718

多维聚合实战:从GROUP BY失效到实时立方体优化

多维聚合是OLAP分析的核心能力,本质是在高维空间中动态定义分组粒度与计算基准。其底层原理超越简单SQL分组,涉及维度建模、立方体存储、窗口函数调度及数据拓扑约束。技术价值在于支撑灵活钻取、动态占比、跨维对比等关键业务指标;典型场景涵盖电商销售分析、金融风控报表、实时用户行为热力图等。当维度数超过3个或存在高基数、动态标签、时间错位等问题时,传统GROUP BY必然失效,需结合向量化引擎(如DuckDB)、MPP查询(如Trino+Iceberg)与流式增量聚合(如Flink)协同解决。本文聚焦真实生产中的

chuozhi7142的博客 663

DuckDB数据工程实战:嵌入式列式数据库如何重塑ETL效率

列式数据库是一种面向分析型负载(OLAP)优化的数据存储范式,通过按列组织数据实现高效压缩、谓词下推与列裁剪;向量化执行则利用CPU SIMD指令批量处理数据块,显著降低每行计算开销。这类技术组合赋予DuckDB在GB-TB级单机数据分析场景中远超传统分布式引擎的吞吐与确定性延迟。其核心价值在于填补数据工程中的‘灰色地带’——即无需分布式扩展、但又超出Pandas/SQLite能力边界的批处理、数据验证与报表预计算任务。本文聚焦DuckDB作为生产级嵌入式SQL引擎的落地实践,覆盖Parquet加速、S3直

dianxi0949的博客 504

Parquet文件是怎么被写入的-Row Groups,Pages,需要的内存,以及flush操作

翻译该文的目的是为了让读者能够更好的理解Parquet文件的写入原理 Parquet文件是最流行的列式文件格式之一,它被用在很多工具上,如Apache Hive,Spark,Presto,Flink等。 对于在各种工作场景下,我们怎么深入的调优Parquet文件写入呢?(此文针对于Parquet 1.10.0,但是很多概念在以后的版本中也适用) Parquet文件格式结构 一个Parquet文件由一个或者多个Row Groups组成,一个Row Groups由包含每一列的数据块组成,每个数据块包含了一个或者

monkeyboy_tech的博客 4549

网约车大数据分析实战:基于Spark的数据处理、建模与性能调优

大数据处理的核心在于如何高效、可靠地从海量数据中提取价值。Apache Spark作为主流的分布式计算框架,凭借其内存计算、批流一体和丰富的生态,成为处理复杂业务场景的首选。其技术价值在于能够将数据处理的性能提升数个量级,同时通过SQL、DataFrame等高级API降低开发门槛。在应用场景上,Spark尤其适合处理像网约车这类数据规模大、实时性要求高、分析维度多的业务,例如进行供需分析、用户画像和需求预测。本文以网约车大数据分析项目为例,深入剖析了如何利用Spark构建从数据采集、实时处理、ETL清洗到机

diaoqu4574的博客 408

Spark 实战 - 3.一文搞懂 parquet

parquet 文件常见于 Spark、Hive、Streamin、MapReduce 等大数据场景,通过列式存储和元数据存储的方式实现了高效的数据存储与检索,下面主要讲parquet 文件在 spark 场景下的存储,读取与使用中可能遇到的坑。......

BITDDD小栈 3078

多维聚合数据操作:从GROUP BY到GROUPING SETS的工程实践

多维聚合是OLAP分析的核心能力,本质是将业务维度组合(如部门×产品×时间)映射为高效执行的计算指令。其技术原理远超SQL语法层面,涉及集合代数建模、内存结构优化与NULL语义治理。关键价值在于平衡实时性与性能——通过ROLLUP表达层次关系、CUBE覆盖正交组合、GROUPING SETS实现精准控制,避免维度爆炸与结果歧义。典型应用场景包括BI报表下钻、用户行为归因、财务多维分析及IoT时序切片。本文聚焦真实生产环境中的空值处理、稀疏性应对与跨引擎适配,结合ClickHouse、Doris等主流引擎的执

weixin_30363509的博客 518

小白学习微信小程序的图像识别和文字识别技术

其中,type参数指定了识别的类型,imageUrl参数指定了图片的地址,success回调函数用于处理识别成功的结果,fail回调函数用于处理识别失败的情况。其中,type参数指定了识别的类型,imageUrl参数指定了图片的地址,success回调函数用于处理识别成功的结果,fail回调函数用于处理识别失败的情况。下面,我们来实现一个文字识别的应用案例,可以识别一张图片中的文字,并将识别结果显示到小程序的页面上。在小程序中,也可以使用微信提供的文字识别接口,实现文字识别的功能开发。

qq_67153941的博客 1643

Spark SQL中数据存储格式与压缩格式

描述数据的字段名、类型、默认值等,人类可读。

qq_37771475的博客 614

数据标注的下一代SOP,可能不是Word,而是一段Prompt

再给几个反例:“这个只是正常纹理,不算。真正用于数据生产的Prompt,可能至少包含:任务定义、正例、反例、边界案例、优先级、输出格式、验收逻辑。一个项目100个人,如果100个人对这句话有100种理解,最后返工的就不是一个框,而可能是几十万帧数据。一个项目启动以后,项目经理先研究SOP,培训组长,组长再培训标注员,最后几百个人按照同一套规则干活。实际上一个成熟的项目经理,最重要的能力之一,就是:把客户的业务语言翻译成生产规则。真正让项目难交付的,从来不是80%的普通数据,而是那20%的长尾数据。

AI数据标注猿 295

spark sql多维分析优化——提高读取文件的并行度

知识技术不能留盲点,尤其是正在用的关键技术。盲点、死穴,不花时间去研究,总会绊你一脚。主动学习,保持激情,不断提高~

xiaoluobutou的专栏 1800

Web自动化神操作:如何用OpenCV 破解滑块验证码?

验证码作为一种安全机制,可以有效防止暴力破解密码、发帖、灌水、刷票等,大家在做 Web 自动化的时候应该有碰到验证码这个难题,一般我们可以和开发沟通请求他们的帮助:去掉验证码或者设置一个万能验证码,而如果开发不帮忙我们该如何去解决呢? 本篇文章以 Java 语言为例教你怎么破解验证码。 现在大多数网址会采用滑块验证码的方式,下面以腾讯的滑块验证码为例,先来看看破解的效果: 要破解滑块验证码,我们一般采取的思路如下: 获取滑块到背景缺口图的距离 通过 selenium 的 Actio

不喝枸杞的程序员 2035

基于simulink构建一个完整的航空航天器姿态控制与导航仿真模型

航空航天器的姿态控制与导航系统是确保飞行器稳定运行和精确执行任务的核心技术。其目标是通过传感器获取飞行器的状态信息,并利用控制器调整飞行器的姿态,使其按照预定轨迹飞行。基于MATLAB/Simulink平台进行航空航天器姿态控制与导航系统的建模与仿真,可以帮助研究者验证算法性能并优化系统的动态响应。本项目旨在构建一个完整的航空航天器姿态控制与导航仿真模型,包括飞行器动力学建模、传感器模块设计、控制器实现以及导航算法仿真,并通过仿真分析其性能。

xiaoheshang_123的博客 272

多维聚合不止GROUP BY:四层数据操作实战框架

多维聚合是BI分析、报表开发和数据中台建设中的核心能力,其本质并非简单的SQL分组计算,而是涵盖数据清洗、维度对齐、上下文控制与结果重塑的系统性工程。理解聚合前的数据质量干预、聚合时的窗口函数动态上下文、以及聚合后的结构化交付,是解决‘数字对不上’‘钻取就崩’等业务痛点的关键。尤其在使用Pandas、Spark SQL或DAX进行多维分析时,必须主动管理空值填充、层级展开、跨组引用等操作,而非依赖GROUP BY隐式行为。本文围绕真实场景中的数据操作动词(filtering、pivoting、windowi

dihuangxiu8828的博客 321

基于 STM32 的手持式安检金属探测器设计与实现

【代码】基于 STM32 的手持式安检金属探测器设计与实现。

weixin_42300449的博客 899

【PySpark 学习笔记 二】内核探秘:Spark 架构与执行原理

摘要 PySpark代码通过懒执行机制构建执行计划,直到遇到写入等Action操作时才触发计算。Driver将逻辑计划转化为物理计划,拆分为Job、Stage和Task层级。数据按Partition分布,Task在Executor上并行处理。Shuffle是跨节点数据重分布的关键环节,性能开销最大。生产环境优先选用DataFrame API以获得最佳性能优化。整个流程从代码解析到分布式执行,体现了Spark高效处理大数据的核心原理。

MaoLin Tian's Blog 804

YOLOv8-pose姿态估计模型从训练到RK3588部署:让边缘端骨骼识别速度突破60FPS

本教程从“模型训练-转换-边缘部署”全链路拆解了YOLOv8-pose姿态估计方案在RK3588上的落地过程,每一步都经过实战验证。无论是智能健身的动作实时纠正,还是工业设备的关键部件姿态检测,这套流程都能让你以最低成本实现高精度、高实时性的姿态估计应用。如果你在实践中遇到模型转换报错、部署性能不达标等问题,可聚焦某一环节深入优化——毕竟,让AI在边缘端“精准捕捉每一个关键点”,才是技术驱动场景创新的核心。

know_F0727的博客 189

从零开始学习PX4源码0(固件下载及编译)

本节主要记录从零开始学习PX4源码1(固件下载)的过程,欢迎批评指正!!!下载固件主要分为两个版本,之前稳定版本和最新官网发布版本,为什么要下载两个版本,主要是说明两个版本有一定的差异(开发环境及源码文件格式等),我们是从之前版本开始学习,为什么不从最新的?因为之前版本代码文件格式还是固定的,最新的变化很大,不利于初学者学习,apm和px4不好的地方就是之前版本v1.7.2和最新版本v1.14.0有些文件总是在变化,这样很不好。

陌城烟雨 4615

基于Spark的气象大数据处理:架构设计、性能优化与实战应用

大数据处理技术已成为应对海量、多源、非结构化数据挑战的核心解决方案。其核心原理在于通过分布式计算框架,将计算任务分解并并行处理,从而突破单机在存储和计算上的瓶颈。在技术价值层面,它不仅极大地提升了数据处理效率,还为实现实时分析、复杂模型训练等高级应用提供了可能。Apache Spark作为主流的大数据计算引擎,凭借其内存计算、统一的编程模型和丰富的生态,在数据清洗、特征工程、流处理及机器学习等场景中发挥着关键作用。本文聚焦于气象领域这一典型应用场景,深入探讨了如何利用Spark构建高效的数据管道,应对气象数

weixin_34262482的博客 307

基于YOLOv8的违规抽烟/打电话检测系统:从数据集构建到部署实战

模型优点缺点精度高速度慢(5 FPS)SSD速度快小目标检测差YOLOv5平衡性好官方支持停止YOLOv8最新、最快、最准需要PyTorch环境YOLOv8相比前代:骨干网络升级(C2f模块)无锚框检测(Anchor-Free)动态任务对齐分配(TaskAlignedAssigner)支持分类/检测/分割/姿态估计。

YOLO 97

Spark分布式计算原理与生产调优实战指南

分布式计算是现代大数据处理的基石,其核心在于突破单机瓶颈,通过协同调度实现数据与计算的高效匹配。其底层逻辑受制于内存、磁盘与网络的三级性能鸿沟,而Spark通过内存计算、DAG执行模型和统一API重构了这一范式。相比传统MapReduce,Spark以Shuffle优化、智能缓存(如MEMORY_AND_DISK_SER)和Catalyst优化器显著提升迭代计算与混合负载效率。在电商用户分析、金融反欺诈等PB级场景中,合理配置spark.sql.adaptive.enabled、Kryo序列化与AQE机制,

baichuan9723的博客 459

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

阿里云EMR Serverless Spark集成Ray:构建统一AI数据处理平台

在分布式计算领域,数据处理与机器学习工作负载的融合已成为技术演进的重要方向。传统批处理框架在处理异构数据流和实时AI任务时面临架构复杂与性能瓶颈。通过底层架构的深度集成,Spark的批处理能力与Ray的分布式Python及AI负载专长形成互补,实现了计算范式的统一。这种融合不仅提升了资源利用率,还通过高效的数据交换机制(如Arrow内存格式)降低了序列化开销,为构建实时化、AI化的数据处理平台提供了技术基础。其应用场景广泛,特别适合多模态特征提取、流批一体AI推理等复杂工作流。本文以阿里云EMR Serve

weixin_33797791的博客 324

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

Spark随机采样三大坑:样本量浮动、数据倾斜、不可复现

Spark中的随机采样并非传统意义上的均匀抽样,其底层采用分区级伯努利采样机制,导致样本量服从二项分布、受分区数据量不均显著影响,并天然对key倾斜敏感。这种设计以可扩展性换取全局精确性,使得fraction参数仅表示期望概率而非确定比例。技术价值在于零shuffle开销与线性时间复杂度,适用于TB级数据的快速探查、AB测试分流和模型子集构建等场景。但当面临金融风控、广告归因等强一致性要求时,必须通过sampleBy实现分层采样、用repartition稳定分区结构、结合limit控制精确样本量——这些正是

weixin_30252709的博客 322

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

上一篇: Spark hiveUDF 不要定义static成员变量
下一篇: Parquet文件是怎么被写入的-Row Groups,Pages,需要的内存,以及flush操作
鸿乃江边鸟
博客等级 码龄6年 3746粉丝 235原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
