


五种常见数据类型
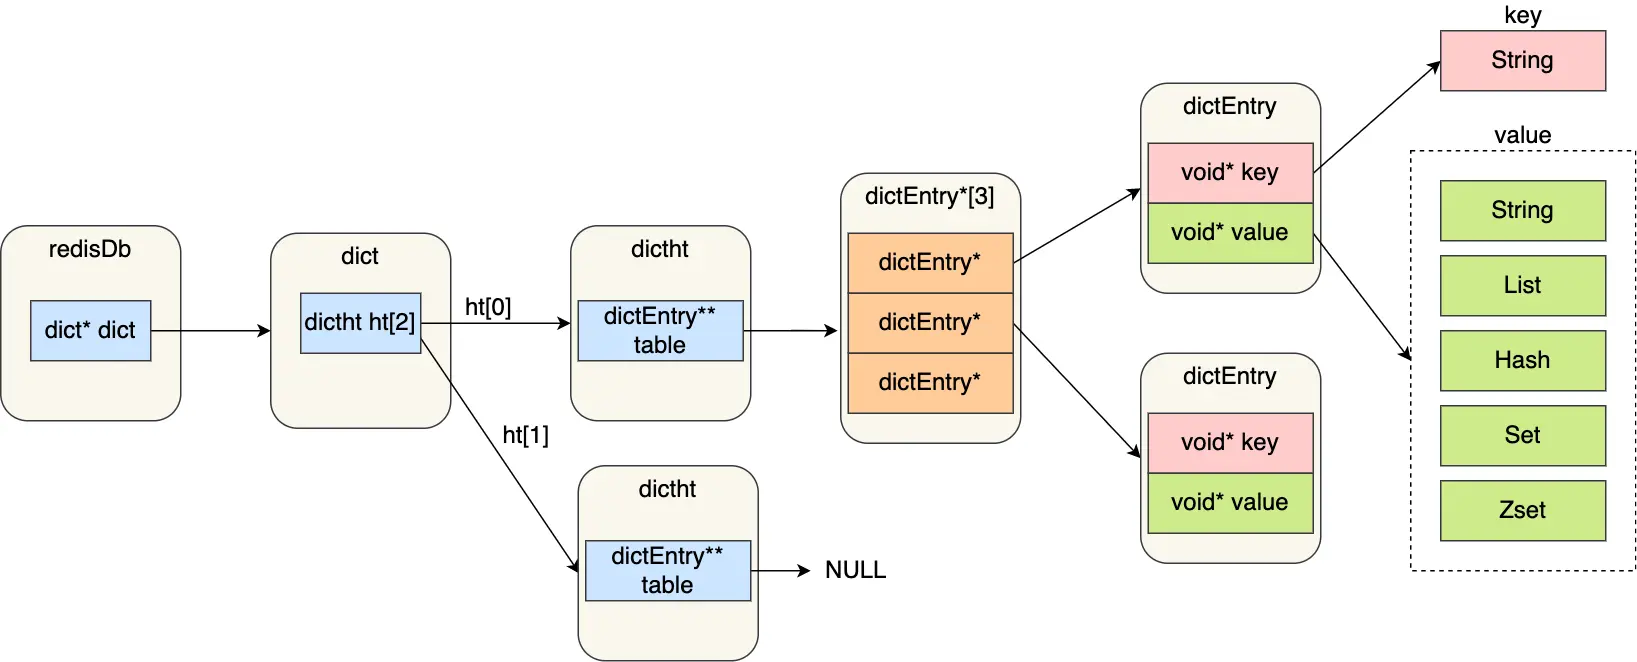
Redis中的数据类型指的是 value存储的数据类型,key都是以String类型存储的,value根据场景需要,可以以String、List等类型进行存储。
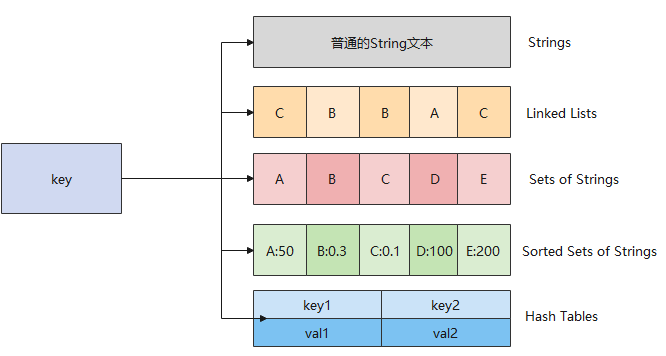
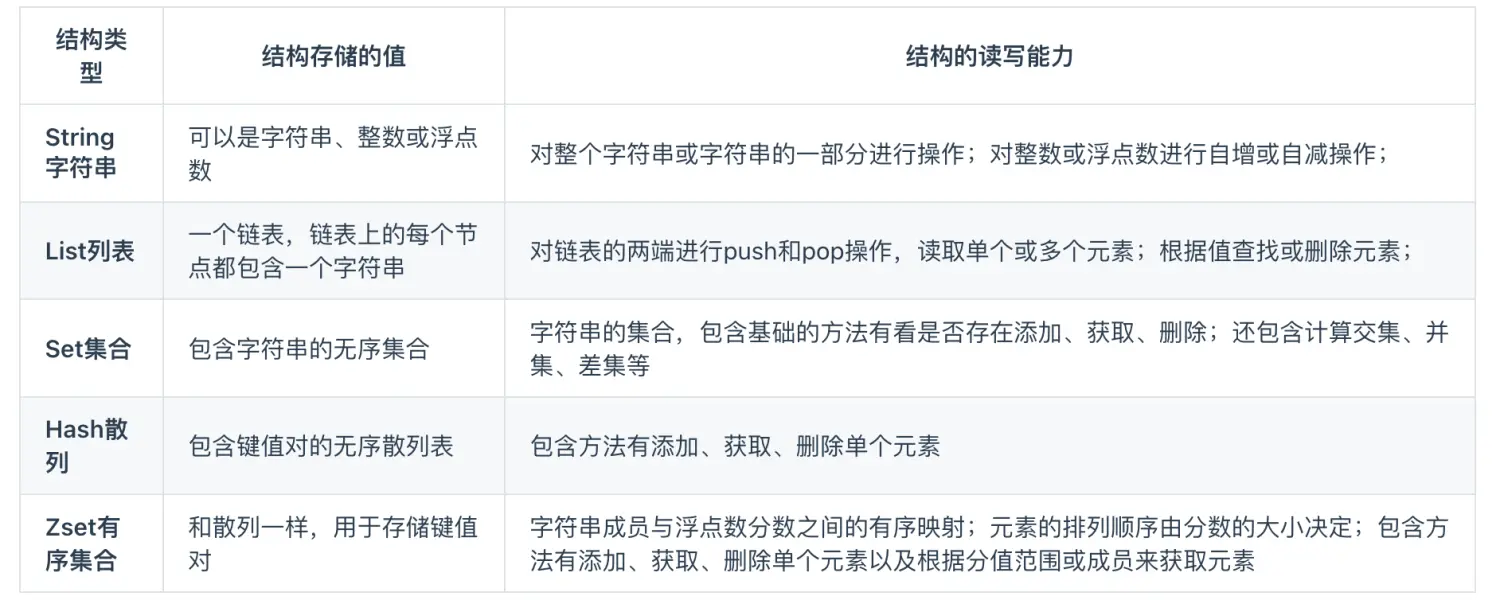
各数据类型介绍:
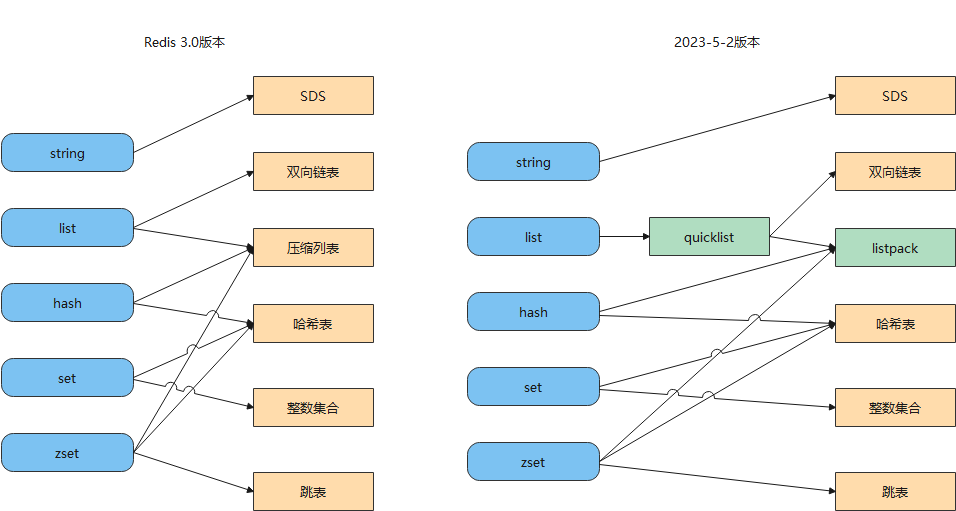
Redis数据类型对应的底层数据结构
String 类型的应用场景
常用命令
-
存放键值:set key value [EX seconds] [PX milliseconds] [NX|XX]
-
[NX|XX] :
-
nx:如果key不存在则建立
-
xx:如果key存在则修改其值,也可以直接使用setnx/setex命令
-
-
-
获取键值:get key
-
值递增/递减:incr key
- 如果字符串中的值是数字类型的,可以使用incr命令每次递增,不是数字类型则报错。
- 一次想递增N用incrby命令,如果是浮点型数据可以用incrbyfloat命令递增。
- 同样,递减使用decr、decrby命令。
-
批量存放键值:mset key value [key value ...]
-
批量获取键值:mget key [key ...]
-
获取值长度:strlen key
-
追加内容:append key value
-
获取部分字符:getrange key start end
缓存对象
使用 String 来缓存对象有两种方式:
- 直接缓存整个对象的 JSON,命令例子: SET user:1 '{"name":"seven", "age":18}'。
- 采用将 key 进行分离为 user:ID:属性,采用 MSET 存储,用 MGET 获取各属性值,命令例子: MSET user:1:name seven1 user:1:age 18 user:2:name seven2 user:2:age 20
常规计数
比如计算访问次数、点赞、转发、库存数量等等。
highlighter- Markdown
# 初始化文章的阅读量
> SET aritcle:readcount:1001 0
OK
#阅读量+1
> INCR aritcle:readcount:1001
(integer) 1
#阅读量+1
> INCR aritcle:readcount:1001
(integer) 2
分布式锁
之所以采用Redis来作为分布式锁,可以有几方面理由:
- redis足够的快
- redis提供了
setnx + expire的机制,完全契合分布式锁的实现要点 Redisson客户端的流行,使得基于redis的分布式锁更加简单
SET 命令有个 NX 参数可以实现「key不存在才插入」,可以用它来实现分布式锁:
- 如果 key 不存在,则显示插入成功,可以用来表示加锁成功;
- 如果 key 存在,则会显示插入失败,可以用来表示加锁失败。
一般而言,还会对分布式锁加上过期时间,分布式锁的命令如下:
highlighter- SQL
SET lock_key unique_value NX PX 10000
- lock_key 就是 key 键;
- unique_value 是客户端生成的唯一的标识;
- NX 代表只在 lock_key 不存在时,才对 lock_key 进行设置操作;
- PX 10000 表示设置 lock_key 的过期时间为 10s,这是为了避免应用在运行过程中发生异常而无法释放锁。
共享 session 信息
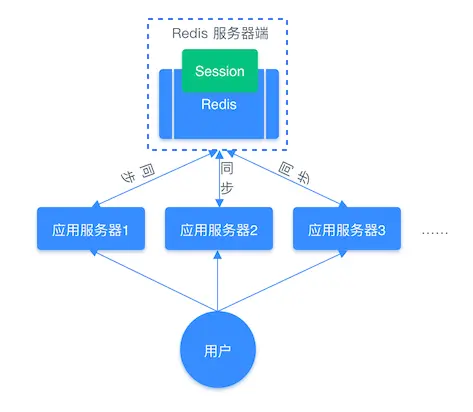
通常情况下可以使用session信息保存用户的登录(会话)状态,由于这些 Session 信息会被保存在服务器端,如果用户一的 Session 信息被存储在服务器一,但第二次访问时用户一被分配到服务器二,这个时候服务器并没有用户一的 Session 信息,就会出现需要重复登录的问题。如下:
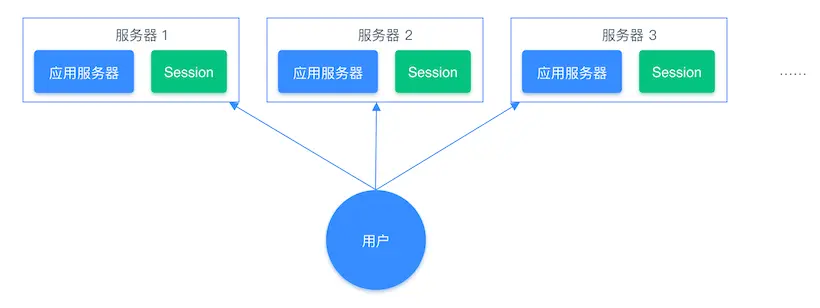
可以借助 Redis 对这些 Session 信息进行统一的存储和管理,这样无论请求发送到那台服务器,服务器都会去同一个 Redis 获取相关的 Session 信息,这样就解决了分布式系统下 Session 存储的问题。
List 类型的应用场景
常用命令
-
存储值:
- 左端存值:lpush key value [value ...]
- 右端存值:rpush key value [value ...]
- 索引存值:lset key index value
-
弹出元素:
- 左端弹出:lpop key
- 右端弹出:rpop key
-
获取元素个数:llen key
-
获取列表元素:
- 两边获取:lrange key start stop
- 索引获取:lindex key index
-
删除元素:
- 根据值删除:lrem key count value
- 范围删除:ltrim key start stop
消息队列
- 消息保序:使用 LPUSH + RPOP,对队列进行先进先出的消息处理;满足消息队列的保序性
- 阻塞读取:使用 BRPOP;阻塞读取队列中的数据,避免消费者不停地调用 RPOP 命令带了不必要的性能损失
- 重复消息处理:生产者实现全局唯一 ID;满足消息队列的处理重复消息的能力
- 消息的可靠性:使用 BRPOPLPUSH让消费者程序从一个 List 中读取消息,同时,Redis 会把这个消息再插入到另一个 List(可以叫作备份 List)留存;这样一来,如果消费者程序读了消息但没能正常处理,等它重启后,就可以从备份 List 中重新读取消息并进行处理了。满足消息队列的可靠性
但是有两个问题:
- 生产者需要自行实现全局唯一 ID;
- 不能以消费组形式消费数据
Hash 类型
常用命令
-
存放值:
- 单个:hset key field value
- 多个:hmset key field value [field value ...]
- 不存在时:hsetnx key field value
-
获取字段值:
- 单个:hget key field
- 多个:hmget key field [field ...]
- 获取所有键与值:hgetall key
- 获取所有字段:hkeys key
- 获取所有值:hvals key
-
判断是否存在:hexists key field
-
获取字段数量:hlen key
-
递增/减:hincrby key field increment
-
删除字段:hdel key field [field ...]
缓存对象
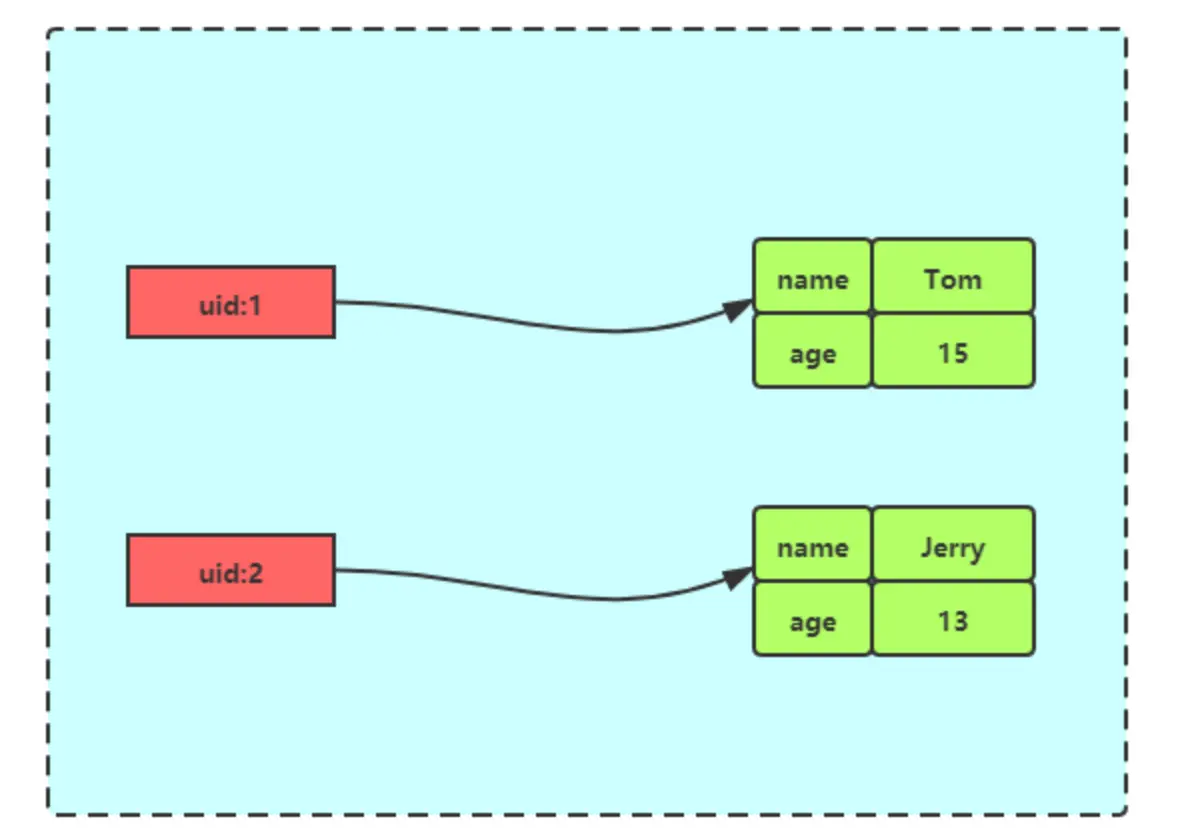
一般对象用 String + Json 存储,对象中某些频繁变化的属性可以考虑抽出来用 Hash 类型存储。
购物车
以用户 id 为 key,商品 id 为 field,商品数量为 value,恰好构成了购物车的3个要素,如下图所示。
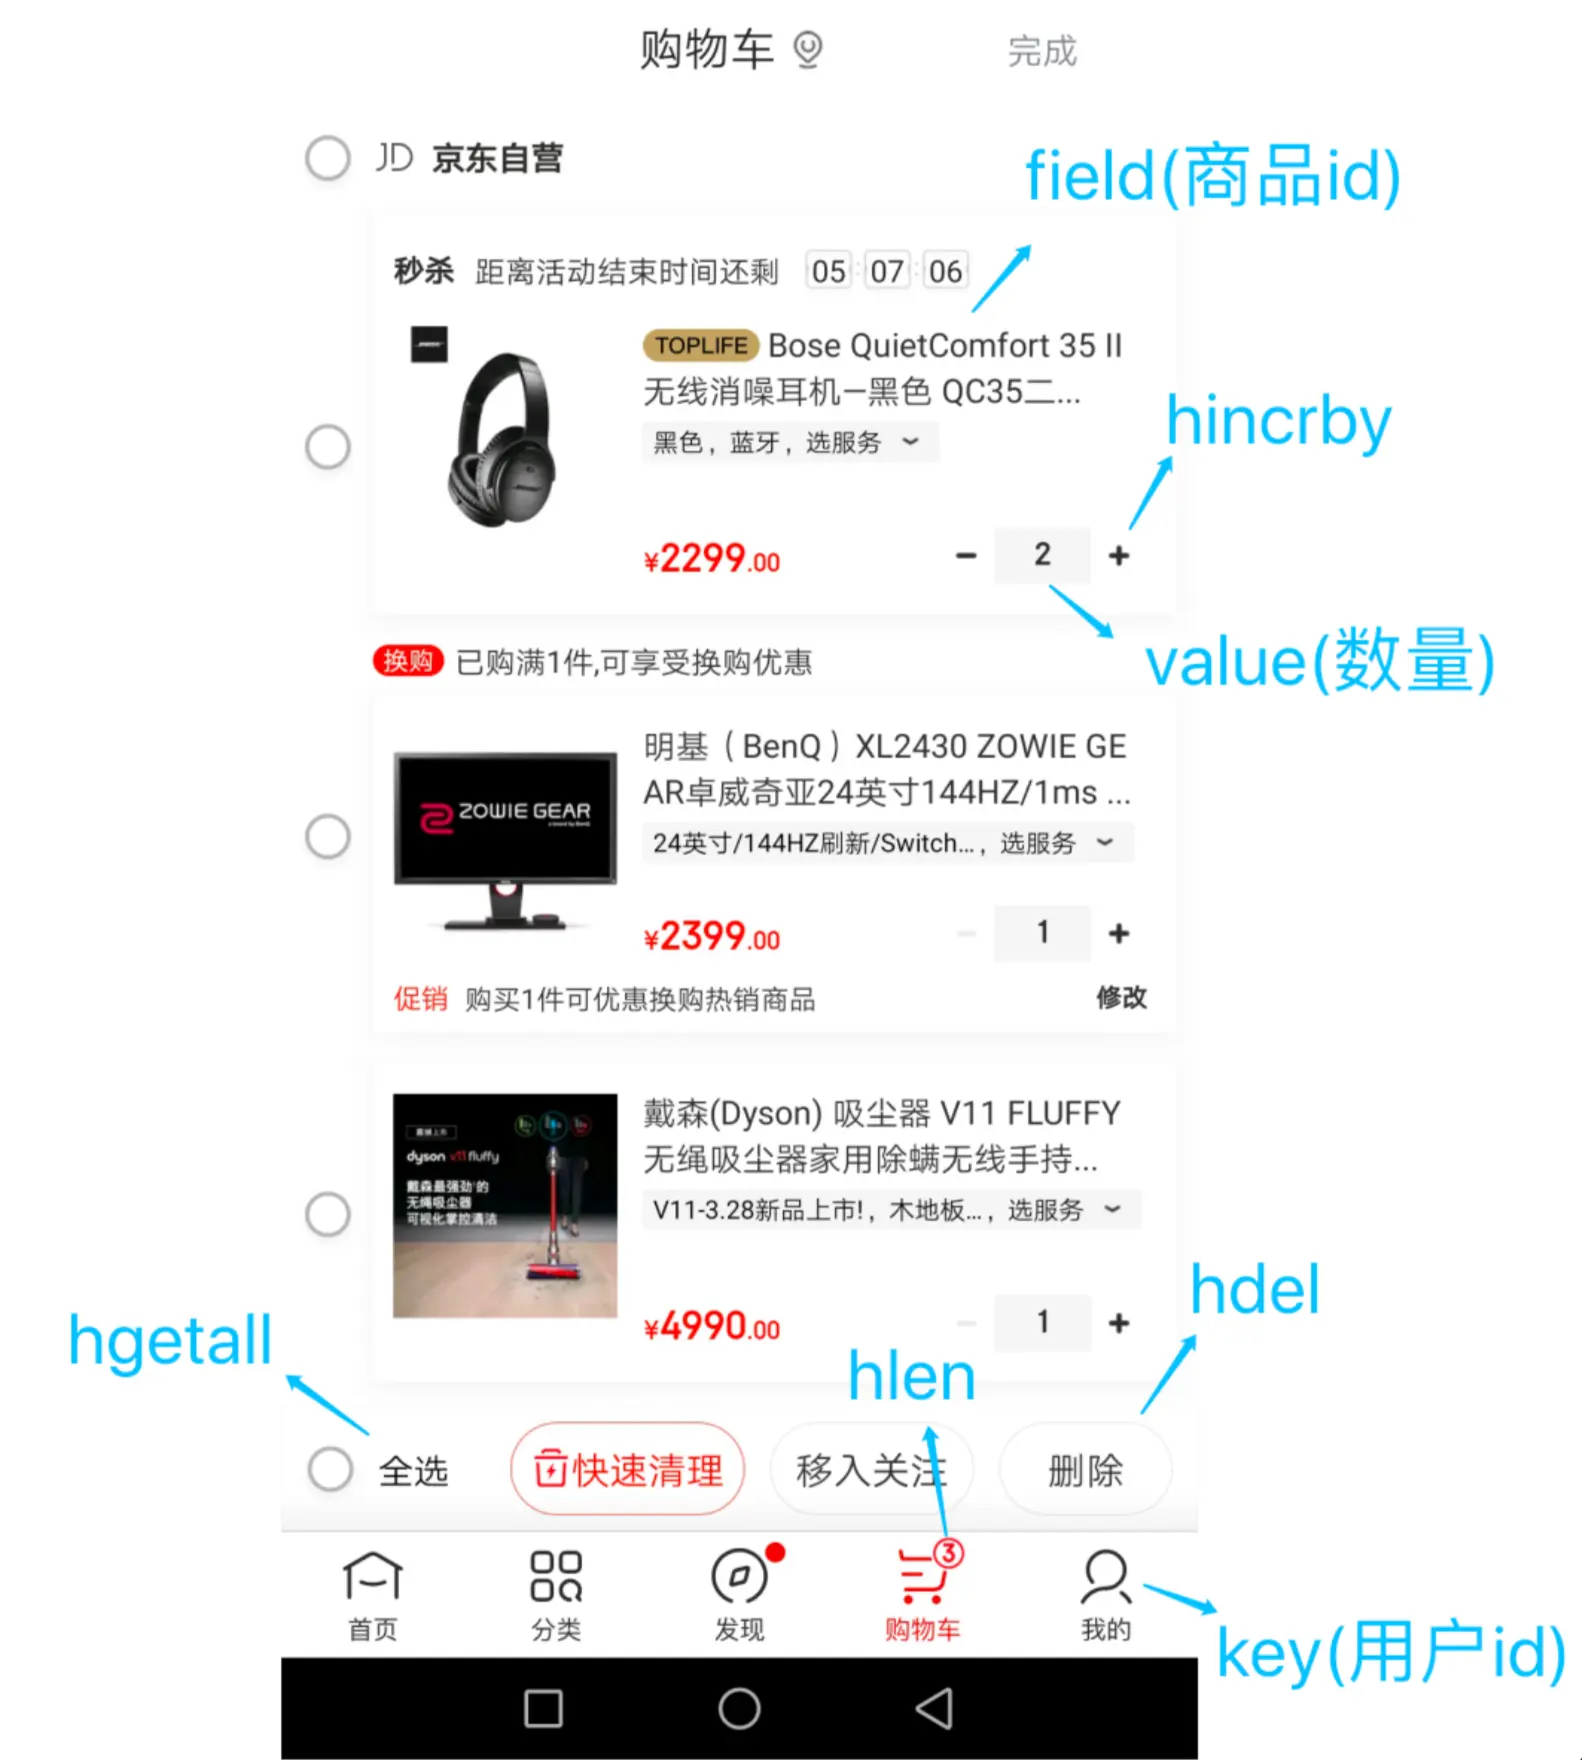
涉及的命令如下:
- 添加商品:HSET cart:{用户id} {商品id} 1
- 添加数量:HINCRBY cart:{用户id} {商品id} 1
- 商品总数:HLEN cart:
- 删除商品:HDEL cart:
- 获取购物车所有商品:HGETALL cart:
Set 类型
聚合计算(并集、交集、差集)场景,比如点赞、共同关注、抽奖活动等。
常用命令
-
存储值:sadd key member [member ...]
-
获取所有元素:smembers key
-
随机获取:srandmember langs count
-
判断是否存在某member:sismember key member
-
获取集合中元素个数:scard key
-
删除集合元素:srem key member [member ...]
-
弹出元素:spop key [count]
点赞
可以保证一个用户只能点一个赞,已经点赞过的用户不能再点赞
highlighter- Bash
# uid:1 用户对文章 article:1 点赞
> SADD article:1 uid:1
(integer) 1
# uid:2 用户对文章 article:1 点赞
> SADD article:1 uid:2
(integer) 1
# uid:3 用户对文章 article:1 点赞
> SADD article:1 uid:3
(integer) 1

# uid:1 取消了对 article:1 文章点赞。
> SREM article:1 uid:1
(integer) 1

# 获取 article:1 文章所有点赞用户 :
> SMEMBERS article:1
1) "uid:3"
2) "uid:2"

# 获取 article:1 文章的点赞用户数量:
> SCARD article:1
(integer) 2
共同关注
Set 类型支持交集运算,所以可以用来计算共同关注的好友、公众号等。
key 可以是用户id,value 则是已关注的公众号的id。
highlighter- Bash
# uid:1 用户关注公众号 id 为 5、6、7、8、9
> SADD uid:1 5 6 7 8 9
(integer) 5
# uid:2  用户关注公众号 id 为 7、8、9、10、11
> SADD uid:2 7 8 9 10 11
(integer) 5

# 获取共同关注
> SINTER uid:1 uid:2
1) "7"
2) "8"
3) "9"

# 给 uid:2 推荐 uid:1 关注的公众号:在uid:1中有但是uid:2中没有的
> SDIFF uid:1 uid:2
1) "5"
2) "6"

# 验证某个公众号是否同时被 uid:1 或 uid:2 关注:
> SISMEMBER uid:1 5
(integer) 1 # 返回0,说明关注了
> SISMEMBER uid:2 5
(integer) 0 # 返回0,说明没关注
抽奖活动
存储某活动中中奖的用户名 ,Set 类型因为有去重功能,可以保证同一个用户不会中奖两次。
shell
# key为抽奖活动名,value为员工名称,把所有员工名称放入抽奖箱 :
>SADD lucky Tom Jerry John Sean Marry Lindy Sary Mark
(integer) 5

# 如果允许重复中奖,可以使用 SRANDMEMBER 命令。
# 抽取 1 个一等奖:
> SRANDMEMBER lucky 1
1) "Tom"
# 抽取 2 个二等奖:
> SRANDMEMBER lucky 2
1) "Mark"
2) "Jerry"
# 抽取 3 个三等奖:
> SRANDMEMBER lucky 3
1) "Sary"
2) "Tom"
3) "Jerry"

# 如果不允许重复中奖,可以使用 SPOP 命令。
# 抽取一等奖1个
> SPOP lucky 1
1) "Sary"
# 抽取二等奖2个
> SPOP lucky 2
1) "Jerry"
2) "Mark"
# 抽取三等奖3个
> SPOP lucky 3
1) "John"
2) "Sean"
3) "Lindy"
Zset 类型
排序场景,比如排行榜、电话和姓名排序等。
常用命令
- 存储值:zadd key [NX|XX] [CH] [INCR] score member [score member ...]
- 获取元素分数:zscore key member
- 获取排名范围:zrange key start stop [WITHSCORES]
- 获取指定分数范围排名:zrangebyscore key min max [WITHSCORES] [LIMIT offset count]
- 增加指定元素分数:zincrby key increment member
- 获取集合元素个数:zcard key
- 获取指定范围分数个数:zcount key min max
- 删除指定元素:zrem key member [member ...]
- 获取元素排名:zrank key member
Zset结构
highlighter- Java
typedef struct zset {
    dict *dict;//哈希表
    zskiplist *zsl;//跳表
} zset;
zset 结构体里有两个数据结构:一个是跳表,一个是哈希表。这样的好处是既能进行高效的范围查询(如 ZRANGEBYSCORE 操作,利用了跳表),也能进行高效单点查询(如 ZSCORE 操作,利用了hash表)。
排行榜
五篇博文,分别获得赞为 200、40、100、50、150。
highlighter- Bash
# arcticle:1 文章获得了200个赞
> ZADD user:seven:ranking 200 arcticle:1
(integer) 1
# arcticle:2 文章获得了40个赞
> ZADD user:seven:ranking 40 arcticle:2
(integer) 1
# arcticle:3 文章获得了100个赞
> ZADD user:seven:ranking 100 arcticle:3
(integer) 1
# arcticle:4 文章获得了50个赞
> ZADD user:seven:ranking 50 arcticle:4
(integer) 1
# arcticle:5 文章获得了150个赞
> ZADD user:seven:ranking 150 arcticle:5
(integer) 1

# 获取文章赞数最多的 3 篇文章, ZREVRANGE 命令(倒序获取有序集合 key 从start下标到stop下标的元素)
# WITHSCORES 表示把 score 也显示出来
> ZREVRANGE user:seven:ranking 0 2 WITHSCORES
1) "arcticle:1"
2) "200"
3) "arcticle:5"
4) "150"
5) "arcticle:3"
6) "100"

# 获取 100 赞到 200 赞的文章,ZRANGEBYSCORE 命令(返回有序集合中指定分数区间内的成员,分数由低到高排序)
> ZRANGEBYSCORE user:xiaolin:ranking 100 200 WITHSCORES
1) "arcticle:3"
2) "100"
3) "arcticle:5"
4) "150"
5) "arcticle:1"
6) "200"
电话,姓名排序
电话排序
highlighter- Bash
# 将电话号码存储到 SortSet 中,然后根据需要来获取号段:
> ZADD phone 0 13100111100 0 13110114300 0 13132110901
(integer) 3
> ZADD phone 0 13200111100 0 13210414300 0 13252110901
(integer) 3
> ZADD phone 0 13300111100 0 13310414300 0 13352110901
(integer) 3

# 获取所有号码
> ZRANGEBYLEX phone - +
1) "13100111100"
2) "13110114300"
3) "13132110901"
4) "13200111100"
5) "13210414300"
6) "13252110901"
7) "13300111100"
8) "13310414300"
9) "13352110901"

# 获取 132 号段的号码:
> ZRANGEBYLEX phone [132 (133
1) "13200111100"
2) "13210414300"
3) "13252110901"

# 获取132、133号段的号码:
> ZRANGEBYLEX phone [132 (134
1) "13200111100"
2) "13210414300"
3) "13252110901"
4) "13300111100"
5) "13310414300"
6) "13352110901"
姓名排序
highlighter- Bash
> zadd names 0 Toumas 0 Jake 0 Bluetuo 0 Gaodeng 0 Aimini 0 Aidehua
(integer) 6

# 获取所有人的名字:
> ZRANGEBYLEX names - +
1) "Aidehua"
2) "Aimini"
3) "Bluetuo"
4) "Gaodeng"
5) "Jake"
6) "Toumas"

# 获取名字中大写字母A开头的所有人:
> ZRANGEBYLEX names [A (B
1) "Aidehua"
2) "Aimini"

# 获取名字中大写字母 C 到 Z 的所有人:
> ZRANGEBYLEX names [C [Z
1) "Gaodeng"
2) "Jake"
3) "Toumas"
BitMap(2.2 版新增):
介绍
适用于二值状态统计的场景。
签到
只记录签到(1)或未签到(0)
highlighter- Markdown
# 记录用户 4 月 3 号已签到
SETBIT uid:sign:100:202304 2 1

# 检查该用户 6 月 3 日是否签到
> GETBIT uid:sign:100:202306 3
1

# 统计用户在 6 月份的签到次数
> BITCOUNT uid:sign:100:202206
1

# 统计这个月首次打卡时间;BITPOS key bitValue [start] [end],start end 表示要检测的范围
BITPOS uid:sign:100:202206 1
判断用户登陆状态
key = login_status 表示存储用户登陆状态集合数据, 将用户 ID 作为 offset,在线就设置为 1,下线设置 0。通过 GETBIT判断对应的用户是否在线。 5000 万用户只需要 6 MB 的空间。
highlighter- Bash
# 表示ID = 10086 的用户已登陆
SETBIT login_status 10086 1

# 检查该用户是否登陆,返回值 1 表示已登录
GETBIT login_status 10086

# 登出,将 offset 对应的 value 设置成 0。
SETBIT login_status 10086 0
连续签到用户总数
把每天的日期作为 Bitmap 的 key,userId 作为 offset,若是打卡则将 offset 位置的 bit 设置成 1。key 对应的集合的每个 bit 位的数据则是一个用户在该日期的打卡记录。
那就可以设置 7 个 Bitmap,对这 7 个 Bitmap 的对应的 bit 位做 『与』运算。那么当一个 userID 在 7 个 Bitmap 对应对应的 offset 位置的 bit = 1 就说明该用户 7 天连续打卡。结果保存到一个新 Bitmap 中,我们再通过 BITCOUNT 统计 bit = 1 的个数便得到了连续打卡 7 天的用户总数了。
HyperLogLog(2.8 版新增)
海量数据基数统计的场景,提供不精确的去重计数。但要注意,HyperLogLog 的统计规则是基于概率完成的,不是非常准确,标准误算率是 0.81%。因此适用于海量数据的场景。
HyperLogLog 的优点是,在输入元素的数量或者体积非常非常大时,计算基数所需的内存空间总是固定的、并且是很小的。在 Redis 里面,每个 HyperLogLog 键只需要花费 12 KB 内存,就可以计算接近 2^64 个不同元素的基数,和元素越多就越耗费内存的 Set 和 Hash 类型相比,HyperLogLog 就非常节省空间。
百万级网页 UV 计数
在统计 UV 时,可以用 PFADD 命令(用于向 HyperLogLog 中添加新元素)把访问页面的每个用户都添加到 HyperLogLog 中。
highlighter- Markdown
PFADD page1:uv user1 user2 user3 user4 user5

# 可以用 PFCOUNT 命令直接获得 page1 的 UV 值,获取统计结果
PFCOUNT page1:uv
GEO(3.2 版新增)
存储地理位置信息的场景
Redis GEO 操作方法有:
- geoadd:添加地理位置的坐标。
- geopos:获取地理位置的坐标。
- geodist:计算两个位置之间的距离。
- georadius:根据用户给定的经纬度坐标来获取指定范围内的地理位置集合。
- georadiusbymember:根据储存在位置集合里面的某个地点获取指定范围内的地理位置集合。
- georadius:以给定的经纬度为中心, 返回键包含的位置元素当中, 与中心的距离不超过给定最大距离的所有位置元素。
GEORADIUS方法参数:
highlighter- SQL
GEORADIUS key longitude latitude radius m|km|ft|mi [WITHCOORD] [WITHDIST] [WITHHASH] [COUNT count] [ASC|DESC] [STORE key] [STOREDIST key]
参数说明:
- m :米,默认单位。
- km :千米。
- mi :英里。
- ft :英尺。
- WITHDIST: 在返回位置元素的同时, 将位置元素与中心之间的距离也一并返回。
- WITHCOORD: 将位置元素的经度和维度也一并返回。
- WITHHASH: 以 52 位有符号整数的形式, 返回位置元素经过原始 geohash 编码的有序集合分值。这个选项主要用于底层应用或者调试, 实际中的作用并不大。
- COUNT 限定返回的记录数。
- ASC: 查找结果根据距离从近到远排序。
- DESC: 查找结果根据从远到近排序。
滴滴叫车
假设车辆 ID 是 33,经纬度位置是(116.034579,39.030452),可以用一个 GEO 集合保存所有车辆的经纬度,集合 key 是 cars:locations。
highlighter-
GEOADD cars:locations 116.034579 39.030452 33
当用户想要寻找自己附近的网约车时,LBS 应用就可以使用 GEORADIUS 命令。
例如,LBS 应用执行下面的命令时,Redis 会根据输入的用户的经纬度信息(116.054579,39.030452 ),查找以这个经纬度为中心的 5 公里内的车辆信息,并返回给 LBS 应用。
highlighter- SQL
GEORADIUS cars:locations 116.054579 39.030452 5 km ASC COUNT 10
附近的人
nearbyPeople 是一个总的 key,user_1 和 user_2 是相当于 nearbyPeople 里面的两个元素以及他们对应的经纬度,这个例子就是把 user_1 和 user_2 的经纬度存在了 nearbyPeople 这个 key 中
highlighter- Bash
redis> GEOADD nearbyPeople 13.36 38.11 "user_1" 15.08 37.50 "user_2"
(integer) 2
获取 nearbyPeople 中的元素 user_1 和 user_2 这两个元素的经纬度,当然如果之前没有 geoadd 相对应元素的经纬度的话,会返回 nil
highlighter- Java
redis> GEOPOS nearbyPeople user_1 user_21) 1) "13.36138933897018433" 2) "38.11555639549629859"2) 1) "15.08726745843887329" 2) "37.50266842333162032"
获取 nearbyPeople 中 user_1 和 user_2 这两个节点之间的距离,距离单位可以指定,如下所示:
- m :米,默认单位。
- km :千米。
- mi :英里。
- ft :英尺。
highlighter- Java
redis> GEODIST nearbyPeople user_1 user_2"166274.1516"redis> GEODIST nearbyPeople user_1 user_2 km"166.2742"redis> GEODIST nearbyPeople user_1 user_2 mi"103.3182"
把 nearbyPeople 中的 距离经纬度(15,37)200km 以内的元素都找出来,而且带上距离:
highlighter- Java
redis>GEORADIUS nearbyPeople 15 37 200 km WITHDIST
1) 1) "user_1"
   2) "190.4424"
2) 1) "user_2"
   2) "56.4413"
Stream(5.0 版新增)
消息队列,解决了基于 List 类型实现的消息队列中存在的两个问题。
可以自动生成全局唯一消息ID,并支持以消费组形式消费数据。


 476


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


