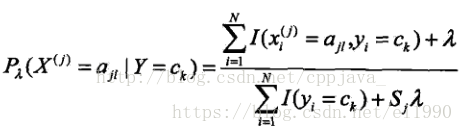朴素贝叶斯常见面试题

机器学习之朴素贝叶斯算法详解 1-1 基本流程 朴素贝叶斯公式: P(A|B)=P(A)P(B|A)P(B)P(A|B)=P(A)P(B|A)P(B) P(A|B) = \frac{P(A)P(B|A)}{P(B)} 一、概率基础知识: 条件概率是指事件A在另外一个事件B已经发生条件下的发生概率。 条件概率表示为: P(A|B), 读作“在B条件下A的概率”。 若只有两个事件A, B, 那么: P(AB)=P... 阅读详情
  • NB的原理
    朴素贝叶斯法是基于贝叶斯定理与特征条件独立假设的分类方法。对于给定的待分类项xxx,通过学习到的模型计算后验概率分布,即:在此项出现的条件下各个目标类别出现的概率,将后验概率最大的类作为xxx所属的类别。

  • 朴素贝叶斯朴素在哪里?
    在计算条件概率分布P(X=x∣Y=ck)P\left( X=x|Y=c_k\right)P(X=x∣Y=ck​)时,NB引入了一个很强的条件独立假设,即,当YYY确定时,XXX的各个特征分量取值之间相互独立。

  • 怎么理解朴素贝叶斯中的“朴素”?
    因为它假定所有的特征在数据集中的作用是独立同分布的,但这个假设在现实生活中很不真实,因此很“朴素”。

  • 为什么引入条件独立性假设?
    为了避免贝叶斯定理求解时面临的组合爆炸、样本稀疏问题。假设条件概率分为P(X=x∣Y=ck)=P(X(1)=x(1),...,x(n)=x(n)∣Y=ck)P\left( X=x|Y=c_k\right) = P\left( X^{(1)}=x^{(1)},...,x^{(n)}=x^{(n)}|Y=c_k\right)P(X=x∣Y=ck​)=P(X(1)=x(1),...,x(n)=x(n)∣Y=ck​)其中x(j)x^{(j)}x(j)可能取值有SjS_jSj​个,j=1,2,...,nj=1,2,...,nj=1,2,...,n,YYY可能取值有KKK个,那么参数个数为K∏j=1nSjK\prod_{j=1}^nS_jK∏j=1n​Sj​个,这就导致条件概率分布的参数数量为指数级别。

  • 在估计条件概率P(X∣Y)P(X|Y)P(X∣Y)时出现概率为0的情况怎么办?
    解决这一问题的方法是采用贝叶斯估计。简单来说,引入λ\lambdaλ,当λ=1\lambda=1λ=1时,就是普通的极大似然估计;当λ=1\lambda=1λ=1时称为拉普拉斯平滑。

  • 为什么属性独立性假设在实际情况中很难成立,但朴素贝叶斯仍能取得较好的效果?

    • 人们在使用分类器之前,首先做的第一步(也是最重要的一步)往往是特征选择,这个过程的目的就是为了排除特征之间的共线性、选择相对较为独立的特征;
    • 对于与分类任务来说,只要各类别的条件概率排序正确,无需精准概率值就可以导致正确分类;
    • 如果属性间依赖对所有类别影响相同,或依赖关系的影响能相互抵消,则属性条件独立性假设在降低计算复杂度的同时不会对性能产生负面影响。
  • 为什么要后验概率最大化?
    等价于期望风险最小化。假设选取0-1损失函数,即分类正确取1,错误取0,这时的期望风险最小化为
    在这里插入图片描述

  • 朴素贝叶斯的优缺点

    • 优点
      • 朴素贝叶斯模型发源于古典数学理论,有着坚实的数学基础,以及稳定的分类效率;
      • 对小规模数据表现很好,能够处理多分类任务,适合增量式训练;
      • 适用于文本分类任务,对待预测样本进行预测时,过程简单速度快(想想邮件分类的问题,预测急救室分词后进行概率乘积,在log域直接做加法更快)。
    • 缺点
      • 特征条件独立性假设在实际应用中往往是不成立的,在属性个数比较多或者属性之间相关性较大时,分类效果不好。而在属性相关性较小时,朴素贝叶斯性能最为良好;
      • 需要计算先验概率,而先验概率很多时候取决于假设,假设的模型可以有很多种,因此在某些时候会由于假设的先验模型的原因导致预测效果不佳;
      • 对输入数据的表达形式很敏感(离散、连续、值极大极小之类的)。
  • 朴素贝叶斯与LR的区别?
    (1)简单来说:

    • 朴素贝叶斯是生成模型,根据已有样本进行贝叶斯估计学习出先验概率P(Y)和条件概率P(X|Y),进而求出联合分布概率P(XY),最后利用贝叶斯定理求解P(Y|X), 而LR是判别模型,根据极大化对数似然函数直接求出条件概率P(Y|X);
    • 朴素贝叶斯是基于很强的条件独立假设(在已知分类Y的条件下,各个特征变量取值是相互独立的),而LR则对此没有要求;
    • 朴素贝叶斯适用于数据集少的情景,而LR适用于大规模数据集。

    (2)进一步说明:前者是生成式模型,后者是判别式模型,二者的区别就是生成式模型与判别式模型的区别。

    • 首先,Navie Bayes通过已知样本求得先验概率P(Y), 及条件概率P(X|Y), 对于给定的实例,计算联合概率,进而求出后验概率。也就是说,它尝试去找到底这个数据是怎么生成的(产生的),然后再进行分类。哪个类别最有可能产生这个信号,就属于那个类别。
      • 优点: 样本容量增加时,收敛更快;隐变量存在时也可适用。
      • 缺点:时间长;需要样本多;浪费计算资源
    • 相比之下,Logistic回归不关心样本中类别的比例及类别下出现特征的概率,它直接给出预测模型的式子。设每个特征都有一个权重,训练样本数据更新权重w,得出最终表达式。梯度法。
      • 优点:直接预测往往准确率更高;简化问题;可以反应数据的分布情况,类别的差异特征;适用于较多类别的识别。
      • 收敛慢;不适用于有隐变量的情况。
  • 算法问题
    实际项目中,概率值往往是很小的小数,连续微小小数相乘容易造成下溢出使乘积为0.
    解决方法:对乘积取自然对数,将连乘变为连加。
    另外需要注意:给出的特征向量长度可能不同,这是需要归一化为通长度的向量(这里以文本分类为例),比如说是句子单词的话,则长度为整个词汇量的长度,对应位置是该单词出现的次数。

  • 先验条件概率的计算方法

    • 离散分布时:统计训练样本中每个类别出现的频率。若某一特征值的概率为0会使整个概率乘积变为0(称为数据稀疏),这破坏了各特征值地位相同的假设条件。
      • 解决方法一:采用贝叶斯估计(λ=1 时称为拉普拉斯平滑):
        在这里插入图片描述
      • 解决方法二:通过聚类将未出现的词找出系统关键词,根据相关词的概率求平均值。
    • 连续分布时:假定其值服从高斯分布(正态分布)。即计算样本均值与方差。

参考资料:
https://www.cnblogs.com/zhibei/p/9394758.html
https://blog.youkuaiyun.com/dinkwad/article/details/78842338
https://blog.youkuaiyun.com/han_xiaoyang/article/details/50629608

微信关注博主:挑灯看剑王知事
在这里插入图片描述

19. 机器学习——朴素贝叶斯 贝叶斯分类是一类分类算法的总称,这类算法均以贝叶斯定理为基础,故统称为贝叶斯分类。而朴素朴素贝叶斯分类是贝叶斯分类中最简单,也是常见的一种分类方法。朴素贝叶斯(Naive Bayes)是一种基于贝叶斯定理和特征条件独立性假设的分类算法。它通过统计特征在不同类别下的条件概率,来进行分类任务。参考回答朴素贝叶斯是一个基于特征条件独立假设和贝叶斯原理的一种分类算法。朴素贝叶斯通过训练数据得到 X 与 y 的联合分布;之后对于要预测的 X,根据贝叶斯公式,输出后验概率最大的 y。朴素贝叶斯是一种生成式。 阅读详情

相关推荐

智能垃圾桶改造指南:树莓派+垃圾分类模型部署全记录(含数据集获取)

本文提供了一份详尽的智能垃圾桶DIY改造指南,核心是利用树莓派部署轻量化的YOLOv8垃圾分类模型。内容涵盖从数据集获取、模型训练与OpenVINO量化优化,到硬件组装、电路连接及软件集成的全流程,旨在帮助创客和爱好者以低成本实现一个能自动识别垃圾并分类的AIoT原型系统。

k6l7m8n9的博客 508

朴素贝叶斯(NaïveBayes)

Author: Silly_0903; Datawhale NaïveBayes简介 基于贝叶斯方法,通过先验概率,计算并选择最大的后验概率。 核心公式 P(Y∣X)=P(X∣Y)P(Y)P(X)P(Y|X)=\frac{P(X|Y)P(Y)}{P(X)}P(Y∣X)=P(X)P(X∣Y)P(Y)​ 其中: P(Y)为先验概率(prior); P(X|Y)为在样本为Y的前提下,X的条件概...

Datawhale 1283

用AI免费制作30分钟电影:完整工作流与实操解析

AI视频生成技术正大幅降低影视创作门槛,但真正制作一部完整电影并非一键生成,而是涉及剧本、分镜、画面、配音、剪辑的复杂流水线。理解其基本原理,是将文本转化为连续视觉叙事的关键。对于创作者而言,掌握角色一致性控制、素材批量管理、免费额度合理分配等技术价值,能有效避免生成结果崩坏与资源浪费。该能力可广泛应用于短视频创作、独立电影预演、教学演示等场景。本文以30分钟AI电影制作为例,拆解从工具选择到成片输出的全流程,重点分析免费方案下的时间与积分成本,以及最容易翻车的环节,并给出基于实践验证的排查与优化策略。

weixin_29056865的博客 317

机器学习课后习题 --- 朴素贝叶斯

机器学习之课后习题

qq_63976098的博客 4977

《统计学习方法》——李航 学习大纲

最近在学习李航写的统计学习方法概论, 每一章都用xmind理清了思路,括号里是书里的公式,第一次写博文,敬请指教~~~~ 第一章 统计学习方法论 第二章 感知机 每个方法其实只需要着重掌握三要素和输入输出就可以了,主要看模型、策略和算法。 感知机主要是二类分类的线性分类模型。 看到后面会注意感知机和支持向量机的区别。 第三章 k近

wjy619251334的博客 1万+

STM32中断实战:用ITR9606红外传感器DIY转速计数器(附完整代码)

本文详细介绍了如何使用STM32中断机制和ITR9606红外传感器DIY高精度转速计数器。从传感器选型、中断配置到抗干扰设计,提供完整的实战指南和优化代码,特别适合嵌入式开发者和硬件工程师快速实现工业级转速检测系统。

weixin_29159613的博客 288

朴素贝叶斯 vs 逻辑回归:哪个更适合你的数据集?

1.背景介绍 随着数据量的增加,机器学习算法的选择和优化成为了关键。在这篇文章中,我们将讨论两种常见的分类算法:朴素贝叶斯和逻辑回归。我们将讨论它们的核心概念、算法原理、数学模型、实例代码和未来发展趋势。 2.核心概念与联系 2.1朴素贝叶斯 朴素贝叶斯是一种基于贝叶斯定理的概率模型,它假设特征之间相互独立。这种假设使得朴素贝叶斯模型的计算变得更加简单,同时也使其在处理高维数据集时具有较好...

AI天才研究院 1910

Pytorch学习笔记(III)——提取特征

目录一、引言二、具体步骤1、参数模型2、网络结构3、参数载入4、特征提取器5、读取图片三、完整代码 一、引言   深度学习在许多任务中主要充当着特征学习的作用,而学习完的特征才是后续应用的一个关键。本文将主要介绍,如何提取任意目标层的特征图。   本文以输入数据为图片为例。 二、具体步骤 1、参数模型 博主使用了ResNet50训练了一个人脸识别的网络   训练完成的深度学习模型,我们会保存一...

lockonlxf的博客 2642

大数据分类算法——朴素贝叶斯算法

一、摘要 贝叶斯分类是一类分类算法的总称,这类算法均以贝叶斯定理为基础,故统称为贝叶斯分类。本文作为分类算法的第一篇,将首先介绍分类问题,对分类问题进行一个正式的定义。然后,介绍贝叶斯分类算法的基础——贝叶斯定理。最后,通过实例讨论贝叶斯分类中最简单的一种:朴素贝叶斯分类。   二、分类问题综述  对于分类问题,其实谁都不会陌生,说我们每个人每天都在执行分类操作一点都不夸张,只是

没有什么不可能 4877

Python爬虫实战:公共资源交易平台招标数据采集实战 - 从零构建企业情报系统(附CSV导出 + SQLite持久化存储)!

我长期专注 Python 爬虫工程化实战,主理专栏 👉 《Python爬虫实战》:从采集策略到反爬对抗,从数据清洗到分布式调度,持续输出可复用的方法论与可落地案例。内容主打一个“能跑、能用、能扩展”,让数据价值真正做到——抓得到、洗得净、用得上。

喵手的博客 1286

AD9613操作控制

输出250M时钟给AD9613,过FPGA ILA逻辑分析仪将AD9613采集的两个通道ADC数据250M数据显示出来。其中AD9613输出的是LVDS数据,通过select IO核转为并行数据。 一,搜索IP核:selectIO interface wizad ,并双击配置 配置为input,DDR模式,数据位宽为12bit,IO类型为差分,这里配置的是12对数据差分对。然后配置外部差分时钟。 将tap setting 设置为13,将时钟的边沿对准数据的中间,以免数据出错 二,

wangjie36的博客 4047

朴素贝叶斯分类

朴素贝叶斯模型是一组非常简单快速的分类算法,通常适用于维度非常高的数据集。因为运行速度快,而且可调参数少,因此非常适合为分类问题提供快速粗糙的基本方案。 1、基本原理 朴素贝叶斯分类器建立在贝叶斯分类方法的基础上,其数学基础是贝叶斯定理(Bayes’s theorem)——一个描述统计量条件概率关系的公式。 在贝叶斯分类中,我们希望确定一个具有某些特征的样本属于某类标签L的概率,通常记为 P (L |特征 )。贝叶斯定理告诉我们,可以直接用下面 的公式计算这个概率 (我们举个例子吧,比如我们标签L为国籍,特

weixin_53344209的博客 3716

56、Cortex - M33处理器浮点单元(FPU)的使用与优化

本文详细介绍了Cortex-M33处理器浮点单元(FPU)的使用与优化方法,涵盖单双精度浮点计算的选择、编译器命令行配置、ABI模式对比、特殊FPU模式设置(如Flush-to-Zero、Default NaN)、浮点异常处理机制以及FPU电源管理策略。结合代码示例和流程图,提供了在不同应用场景下的最佳实践建议,并总结了常见问题及解决方案,帮助开发者提升嵌入式系统中浮点运算的性能、精度与能效。

bread的博客 152

数据分析面试【机器学习】总结之-----朴素贝叶斯常见面试题整理

阅读之前看这里????:博主是正在学习数据分析的一员,博客记录的是在学习过程中一些总结,也希望和大家一起进步,在记录之时,未免存在很多疏漏和不全,如有问题,还请私聊博主指正。 博客地址:天阑之蓝的博客,学习过程中不免有困难和迷茫,希望大家都能在这学习的过程中肯定自己,超越自己,最终创造自己。 目录1、朴素贝叶斯原理2、朴素贝叶斯为什么“朴素naive”?3、朴素贝叶斯属于生成式模型,与判别式模型(LR)区别是?4、写出全概率公式&贝叶斯公式5、最大似然估计和最大后验概率的区别?6、朴素贝叶斯的工作

天阑之蓝的博客 2269

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

朴素贝叶斯算法面试问题汇总

自己救自己系列,不然我这个渣渣就要没工作了。 我只是个木得感情的搬运机器,以下内容都附有原链接地址,你不想我搬运的话,可以联系我删除好勒。 红色加粗是我见了好多次,感觉经常会考得点。 1、朴素贝叶斯介绍 朴素贝叶斯我看的时候各种奇怪的名词晕乎乎的,后来发现主要把握住他的流程即可。 1)由数据T, 求的先验概率。简单说就是每一类占所有样本比重。 2)求条件概率分布。即情况下,x每个属性对应的概率。 3) 求联合概率分布, 通过上面两式...

longshaonihaoa的博客 3639

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

数据挖掘面试题之:朴素贝叶斯

数据挖掘面试题之:朴素贝叶斯本文为数据茶水间群友原创,经授权在本公众号发表。关于作者:DD-Kylin,一名喜欢编程与机器学习的统计学学生,勤学好问,乐于钻研,期待跟大家...

木东居士 5637

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

【机器学习面试题】——朴素贝叶斯

文章目录1.简述朴素贝叶斯算法原理和工作流程2. 条件概率、先验概率、后验概率、联合概率、贝叶斯公式的概念3.为什么朴素贝叶斯如此“朴素”?4.什么是贝叶斯决策理论?5.朴素贝叶斯算法的前提假设是什么?6.为什么属性独立性假设在实际情况中很难成立,但朴素贝叶斯仍能取得较好的效果?7.什么是朴素贝叶斯中的零概率问题?如何解决?8.朴素贝叶斯中概率计算的下溢问题如何解决?9.当数据的属性是连续型变量时...

Heitao5200的博客 2338

机器学习面试题——朴素贝叶斯

1)大厂笔试选择题经常考贝叶斯公式和朴素贝叶斯 2)没事尝尝回顾一下这些八股文

weixin_46838716的博客 1374

7道常见的数据分析面试题

InfoQ 内容来自极客时间《数据分析实战 45 讲》 数据分析师近几年在国内互联网圈越来越火,很多开发都因为薪资和发展前景,希望转行到数据分析岗。今天,我们就来聊聊面试数据分析师的那些事。 其实,数据分析能力是每个互联网人的必备技能,哪怕你没有转行数据分析师的计划,也推荐你看看这个专题,提升你的数据能力。 数据分析的能力要求 与数据分析相关的工作有一个特质,就是对数字非常敏感,同时也要求对数据具...

liqiuman180688的博客 5万+

五、朴素贝叶斯面试题总结

朴素贝叶斯面经,面试题总结

Anthony_hit的博客 2160

机器学习面试题之朴素贝叶斯(九)

转自木东居士的数据挖掘面试题之:朴素贝叶斯 1.什么是贝叶斯决策论? 贝叶斯决策论是概率框架下实施决策的基本方法。要了解贝叶斯决策论,首先得先了解以下几个概念:先验概率、条件概率、后验概率、误判损失、条件风险、贝叶斯判别准则。 先验概率: 所谓先验概率,就是根据以往的经验或者现有数据的分析所得到的概率。如,随机扔一枚硬币,则p(正面) = p(反面) = 1/2,这是我们根据已知的知识所知道的信...

jaffe507的博客 5279

最全#私藏项目实操分享# Java实现基于朴素贝叶斯的情感词分析,kafka常见的面试问题

虽然面试套路众多,但对于技术面试来说,主要还是考察一个人的技术能力和沟通能力。不同类型的面试官根据自身的理解问的问题也不尽相同,没有规律可循。上面提到的关于这些JAVA基础、三大框架、项目经验、并发编程、JVM及调优、网络、设计模式、spring+mybatis源码解读、Mysql调优、分布式监控、消息队列、分布式存储等等面试题笔记及资料。

2301_82243799的博客 645

机器学习 | 朴素贝叶斯

朴素贝叶斯学习笔记

happylls666的博客 2024

python高频面试题_02-27 朴素贝叶斯

https://www.cnblogs.com/nickchen121/p/11686958.html朴素贝叶斯朴素贝叶斯是基于贝叶斯公式与特征条件独立假设的分类方法(注:贝叶斯公式是数学定义,朴素贝叶斯是机器学习算法)。朴素贝叶斯基于输入和输入的联合概率分布,对于给定的输入,利用贝叶斯公式求出后验概率最大的输出yy。即可以总结为以下三点已知类条件概率密度函数表达式和先验概率利用贝叶斯公式转换成后...

weixin_33544435的博客 375

75道常见AI面试题,看看你的知识盲点在哪?(附解析)

整理 | AI科技大本营 出品 | AI科技大本营(公众号id:rgznai100) 程序员转行学什么语言? https://edu.youkuaiyun.com/topic/ai30?utm_source=csdn_bw 【导语】正值求职、跳槽季,无论你是换工作还是找实习,没有真本事都是万万不行的,可是如何高效率复习呢?之前我们给大家推荐了一份 Python 面试宝典,收藏了近 300...

AI科技大本营 1万+
上一篇: 剑指offer题目归类
下一篇: 决策树常见的面试点整理
Manduner_TJU
博客等级 码龄9年 157粉丝 131原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值