Spark环境搭建与测试

(超详细) Spark环境搭建(Local模式、 StandAlone模式、Spark On Yarn模式) Spark环境搭建 JunLeon——go big or go home 目录 Spark环境搭建 一、环境准备 1、软件准备 2、Hadoop集群搭建 3、Anaconda环境搭建 二、Spark Local模式搭建 1、Spark下载、上传和解压 2、配置环境变量 3、配置Spark配置文件 4、测试 5、补充:spark-shell、spark-submit 三、Spark Standone模式搭建 1、Hadoop集群与Spark集群节点规划 2、三台虚拟机分别安 阅读详情

概述:本文主要介绍CentOS 6.5下基于Hadoop的Spark环境搭建过程,并实现塞缪尔·厄尔曼《青春》的词频统计,Spark的具体搭建过程如下:

1、下载并解压Spark源码

https://archive.apache.org/dist/spark/spark-2.4.3/spark-2.4.3.tgz

2、编译Spark

如果需要获取适配Hadoop的spark版本,可在Linux中对spark源码进行编译,详细信息参考官网或慕课网手记

(1)编译

假设安装的Hadoop版本为3.1,支持Hive操作,则编译命令如下

./build/mvn -Pyarn -Phadoop-hadoop-3.1 -Phive -Phive-thriftserver -Dhadoop.version=hadoop-3.1 -DskipTests clean package
​
#或在解压后的spark根路径下执行下述命令
./dev/make-distribution.sh --name 3.1-cdh5.7.0 --tgz -Pyarn -Phadoop-3.1 -Phive -Phive-thriftserver
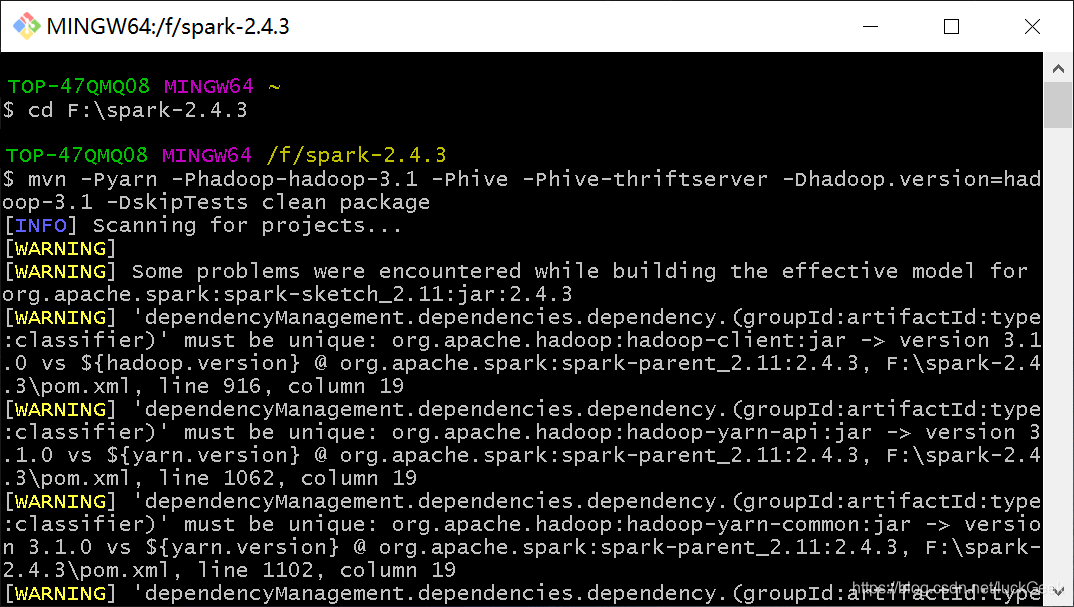
 

说明:Windows下编译Spark,可在Git Bash中进行,耗时较长,最终生成的压缩包为:

spark-2.4.3-bin-3.1-cdh5.7.0.tgz

(2)免编译

直接下载与hadoop对应的spark版本,如spark-2.4.2,Hadoop版本2.6 https://archive.apache.org/dist/spark/spark-2.4.2/spark-2.4.2-bin-hadoop2.6.tgz

3、解压编译后的Spark

tar -zxvf software/spark-2.4.2-bin-hadoop2.6.tgz -C app/
#新增环境变量
vi .bash_profile
#内容为
export SPARK_HOME=/root/app/spark-2.4.2-bin-hadoop2.6
export PATH=$SPARK_HOME:PATH
#使环境变量生效
source .bash_profile

4、修改配置

将下载好的免编译Spark压缩包直接解压,然后修改相应配置文件

#在spark conf路径下
cp spark-env.sh.template spark-env.sh
vi spark-env.sh
#添加如下内容(Standalone模式)
export JAVA_HOME=/root/app/jdk1.8.0_201
export HADOOP_HOME=/root/app/hadoop-2.6.0-cdh5.7.0
SPARK_MASTER_HOST=hadoop
SPARK_WORKER_CORES=2
SPARK_WORKER_MEMORY=2g
SPARK_WORKER_INSTANCES=2
​
#sbin下启动
./start-all.sh
#查看日志
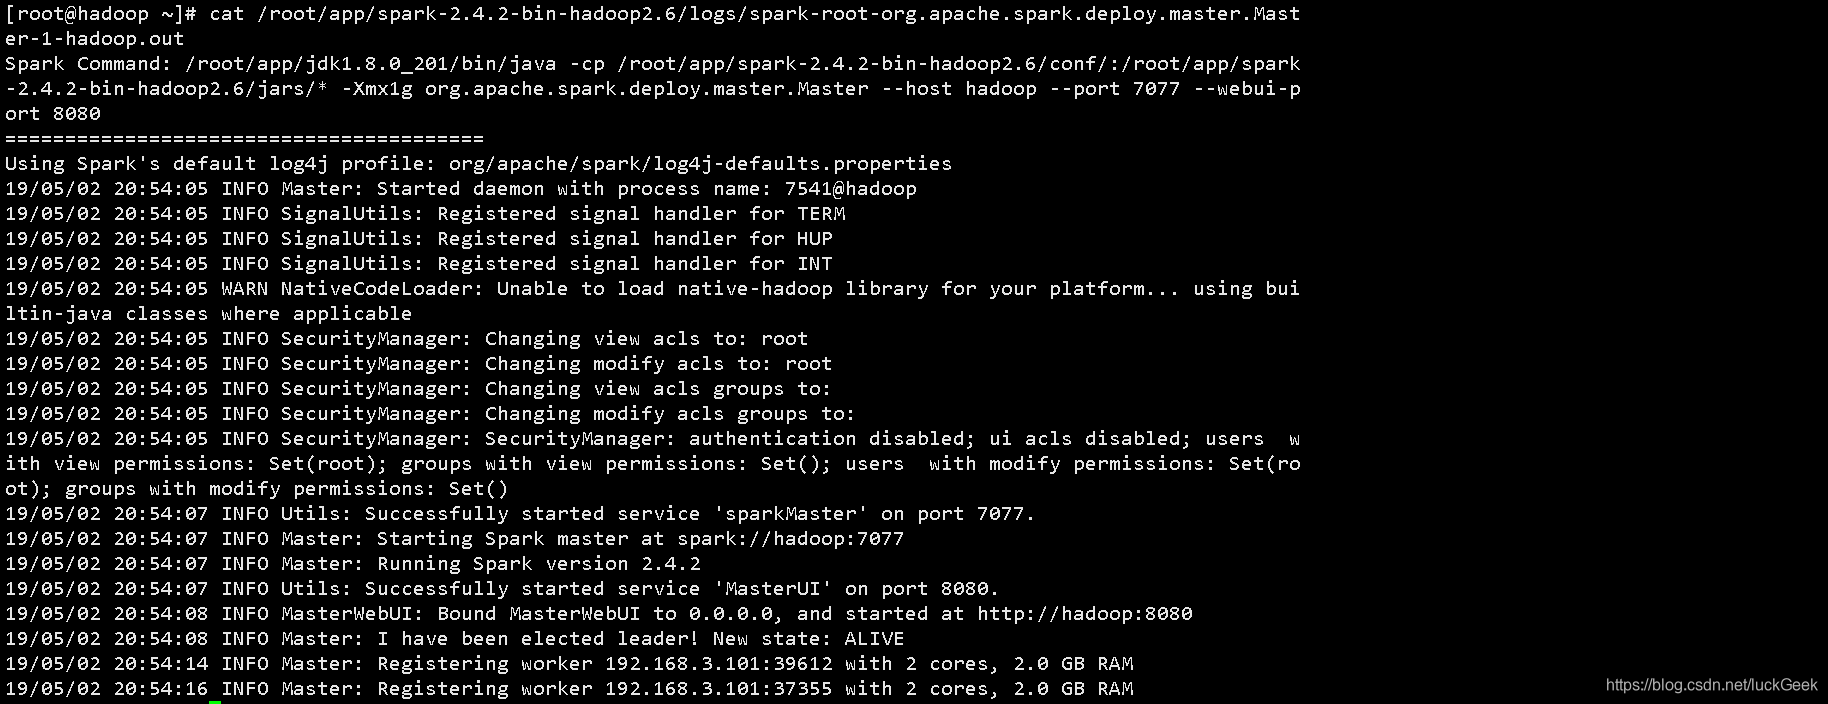
cat /root/app/spark-2.4.2-bin-hadoop2.6/logs/spark-root-org.apache.spark.deploy.master.Master-1-hadoop.out

如果没有报错,日志类似如下:

5、Spark词频统计

val file=sc.textFile("file:///root/app/hadoop-2.6.0-cdh5.7.0/bin/Youth.txt")
val wordCounts = file.flatMap(line => line.split(" ")).map(word => (word,1)).reduceByKey(_+_)
wordCounts.collect()
wordCounts.foreach(println)
​
#或使用以下两种方式读取文件

#读取本地文件
sc.textFile("file:///root/app/hadoop-2.6.0-cdh5.7.0/bin/Youth.txt").flatMap(line => line.split(" ")).map(word => (word,1)).reduceByKey(_+_).collect().foreach(println)
​
#读取HDFS文件
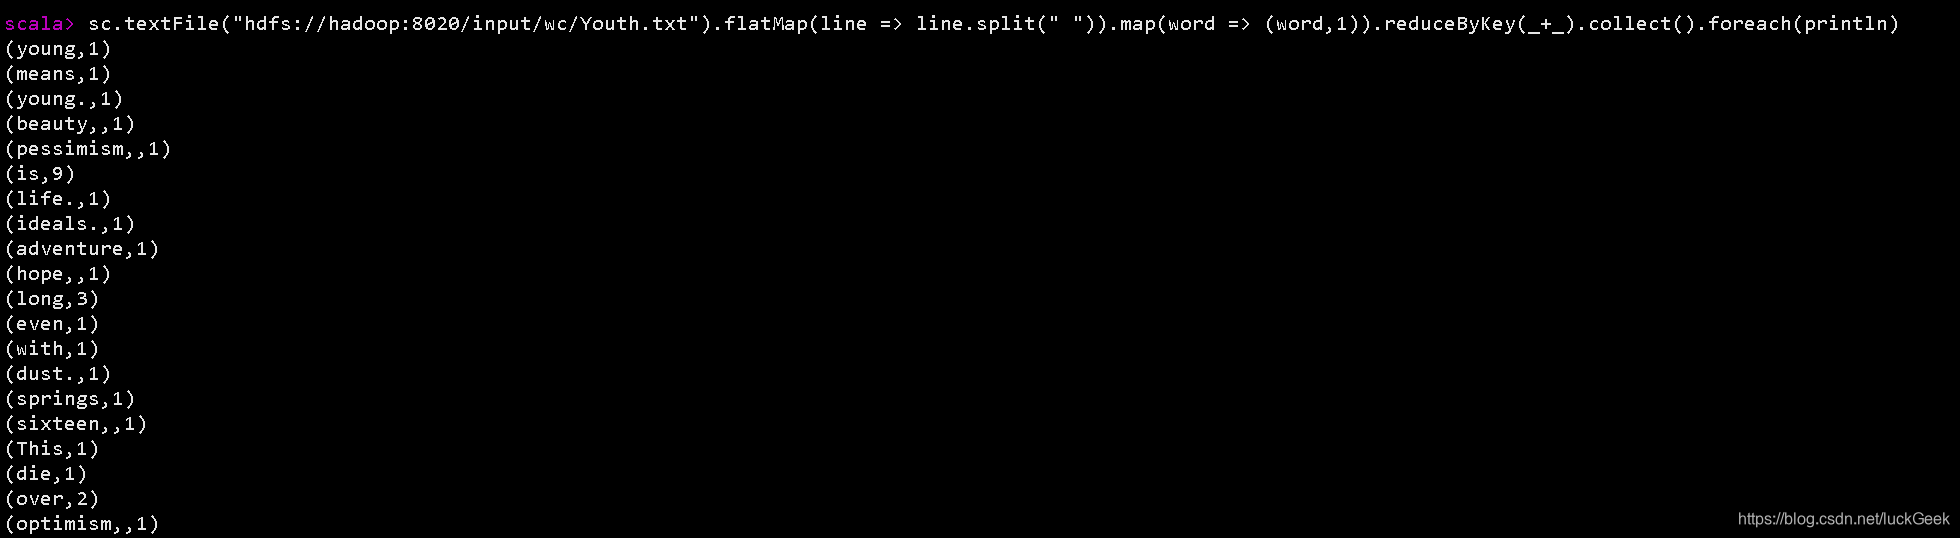
sc.textFile("hdfs://hadoop:8020/input/wc/Youth.txt").flatMap(line => line.split(" ")).map(word => (word,1)).reduceByKey(_+_).collect().foreach(println)

结果如下:

spark 环境搭建及几种模式测试 spark安装部署标签(空格分隔): sparkhadoop,spark,kafka交流群:224209501, spark on yarn;spark standalone;spark hadoop。 阅读详情

相关推荐

Spark分布式测试环境搭建与优化指南

分布式计算作为大数据处理的核心技术,通过将任务分解到多台机器并行执行,显著提升了数据处理效率。其核心原理在于资源调度、数据分片和网络通信的协同工作,典型实现如Apache Spark框架。在工程实践中,搭建可靠的测试环境是验证分布式系统行为的关键环节,涉及集群配置、性能调优和异常处理等技术要点。本文以Spark 3.3.1为例,详细讲解如何配置高可用的测试集群,包括硬件要求、网络设置、内存管理等实战经验,特别针对Shuffle优化和动态资源分配等企业级需求提供解决方案。适用于需要验证分布式计算逻辑的大数据开

weixin_29044157的博客 336

windows安装spark3.2,并使用pycharm测试

windows安装spark3.2,并使用pycharm测试

BugAngel的博客 2461

分布式Spark测试环境搭建与性能调优实战

分布式计算作为大数据处理的核心技术,通过将任务分解到多台机器并行执行来提升处理能力。Apache Spark凭借其内存计算和DAG调度优势,已成为分布式计算的事实标准。在实际工程中,从单机开发转向分布式部署时,测试环境搭建和性能调优是关键挑战,涉及集群配置、网络通信优化和数据分区策略等技术要点。本教程基于赫兹威客平台实战经验,详细讲解如何构建生产级Spark测试环境,覆盖硬件规划、软件配置、容错测试等全流程,特别针对数据倾斜和GC停顿等高频问题提供解决方案,帮助开发者提前发现分布式场景下的典型问题。

weixin_29056781的博客 243

云计算技术 实验九 Spark的安装和基础编程

得到这些单词的集合之后,开始使用键值对的方式对出现的单词进行计数,每出现一次就使用键值对计算一次。之后遍历文件中的内容,对每个单词进行切分归类,后面使用flatMap命令为的是得到一个关于单词的集合。在进行打包的时候需要进行等待软件包下载好,否则再次进行打包的时候会产生数据的流失。为海量的数据提供了存储,则MapReduce为海量的数据提供了计算。进行打包的时候需要对路径进行判断,防止路径错误导致的数据文件的丢失。首先加载本地的文件,这些本地的文件是自带的spark测试文件。

m0_53227534的博客 2025

Spark平台搭建最详细最完美详解

这是一个大数据主流平台SPARK搭建的完美教程,特别适合零基础者。

倍福 MODBUS TCP/IP通信

(*默认字符串80字节,此处声明为255字节,可以一次性传42个UINT数据.5位整数加一个空格,即每个数据6字节*)(*---------------------------------------- 以下为用户程序 ----------------------------------------*)(*读回并换算后的值*)(*准备写到PLC的值*)(*用于比较两次读回的值相差多少,以估计通讯的速度, Act_CalcDiff*)(*用于切换读和写,Act_Protocal*)

qq_33280096的博客 1368

Spark环境搭建(保姆级教程)

Spark 是一个大规模数据处理的统一分析引擎 本文主要介绍Spark的相关配置,以及各种模式的代码提交,包括Local,Standalone,YARN。 文末有相应资源下载网盘链接。

tangyi2008的专栏 6万+

电路方案分析(十二)USB Type-C PD 移动电源参考设计方案

TPD8S300为USB Type-C连接器的CC1,CC2,SBU1和SBU2引脚集成了四个通道的20v短到vbus和过压保护。TPD8S300集成了八个IEC61000-4-2ESD保护通道,用于USB Type-C连接器的CC1、CC2、SBU1、SBU2、DP_T (顶侧D-) 、DM_T (顶侧D-) 、DP_B (底侧D-) 引脚。当电源组是接收器并为其自身的电池充电时,该芯片会对电池充电,而在电源模式期间,该芯片充当DC-DC转换器以生成VBUS。

小幽余生不加糖 2万+

Spark环境搭建

Spark作为一个数据处理框架和计算引擎,被设计在所有常见的集群环境中运行, 在国内工作中主流的环境为Yarn,不过逐渐容器式环境也慢慢流行起来。接下来,我们就分别看看不同环境下Spark的运行。

weixin_44213009的博客 764

Flutter + shorebird 热更新+自定义cdn下载

本文介绍了如何优化Flutter热更新方案Shorebird在国内网络环境下的使用体验。Shorebird默认使用海外CDN存在下载慢、连接不稳定等问题,建议将补丁包上传至国内CDN(如阿里云OSS)。文章详细讲解了Shorebird环境配置、项目集成、构建发布流程,并重点说明了如何修改客户端代码实现自定义补丁下载逻辑。通过替换默认下载器,将补丁下载地址指向国内CDN,可显著提升下载速度和稳定性。这种方案既保留了Shorebird的热更新能力,又解决了国内网络环境下的痛点,适合国内企业部署使用。

sir_Hu的博客 772

jira的详细使用教程

​jira的详细使用教程,1,Jira- 是一款缺陷管理软件工具,用其进行缺陷的管理和跟踪。(是B/S架构的软件) 2,主要涉及的角色: 3,具体工作流 添加工作流 1.点击项目设置

计算机毕业论文源码,学生个人网页制作html源码。贴近用户做网络推广和互联网优化。 3296

Spark Local环境搭建及测试

Spark单机版的搭建,常用于本地开发测试Spark使用Scala语言编写,运行在Java虚拟机(JVM)当中,故在安装前检查下本机的Java虚拟机环境。用命令查询当前Java版本是否为6以上。

默默发展,无声壮大~ 4806

大数据面试必考题:Spark数据倾斜问题总结和优化措施

在Spark分布式计算环境中,

大模型大数据攻城狮的专栏 1467

Spark SQL上下文创建与测试环境搭建

Spark SQL上下文创建与测试环境搭建 版权声明:本文为博主原创文章,未经博主允许不得转载。 手动码字不易,请大家尊重劳动成果,谢谢 作者:http://blog.youkuaiyun.com/wang_wbq Spark SQL上下文创建 这篇文章主要介绍Spark SQL,因此默认各位已经有一个搭建好的Spark开发环境了。 需要先引入和spark版本一致的sp...

wang_wbq的博客 1413

华为OD机考双机位C卷 - 虚拟理财游戏(Java & Python& JS & C/C++ & GO )

华为OD机考双机位C卷 - 虚拟理财游戏(OD上机考试双机位C卷)。提供Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。

算法大师! 670

Autosar配置——导入DBC后配置SecOC同步报文和同步请求报文

在Autosar中,安全性是一个重要的考虑因素,而SecOC(Secure On-Board Communication)是一种用于保护通信数据完整性和安全性的安全机制。在上述示例中,我们配置了同步报文和同步请求报文的属性。接下来,我们需要在Autosar中配置同步报文和同步请求报文。同步报文用于在通信双方之间同步SecOC状态,而同步请求报文用于请求SecOC的状态信息。通过以上配置,我们成功地导入了DBC文件,并在Autosar系统中配置了SecOC同步报文和同步请求报文。希望以上信息对您有所帮助!

CyberSphinx的博客 651

HDFS-Spark-Hudi环境的搭建及测试

由于需要进行Hudi的详细选型,本文从0开始搭建一个Spark+Hudi的环境,并进行简单使用。1)假设在Linux进行环境安装,操作系统选择Ubuntu 22.04 LTS版本。2)Ubuntu的源配置清华源。3)JDK安装完毕(当前是1.8版本,1.8.0_333)。 2.2 localhost免密登录 3. Hadoop安装 Hadoop安装的是单节点伪分布式环境,版本选择和后继的Spark选择有关联。例如:Hadoop 3.2.3Hudi当前支持的是Spark3.2,对应的Spark也是3.2。1

老张的哲学 1443

JavaFX 概述

要从 JavaFX 中充分受益,了解 JavaFX 的设计方式以及对 JavaFX 包含的功能有一个很好的概述是很有用的。本文的目的是为您提供 JavaFX 概述。本文将首先介绍一般的 JavaFX 设计,然后介绍 JavaFX 中的各种特性。如果您熟悉 Flash/Flex,您会发现 JavaFX 在某种程度上受到了 Flash/Flex 的启发。JavaFX 中也有一些相同的想法。一般来说,JavaFX 应用程序包含一个或多个对应于窗口的阶段。每个阶段都有一个场景。

2012年开始工作,全栈开发老兵,目前已是一个老师,分享这么多年的心得体会 408

window本地搭建spark测试环境!

本篇文章也是我参照着网上和自己的一些搭建过程来总结的一些步骤,小白新手大佬勿喷。希望分享一下自己的一下成长过程每天记录一点平常做过的一些事情。 一 . 首先我们安装一个软件我们肯定要有它的安装包,我给个网站Apache的一个资源库:http://archive.apache.org/dist/spark/spark-2.2.2/ 这个是下载spark2.2.2版本的,这个版本需要jdk1.8 和 ...

蛋蛋淡淡定的庄园 1931

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Spark集群环境搭建并测试

不在此处介绍spark了,直接上步骤, spark环境需要jdk 、Scala环境 、下载hadoop 和是spark,jdk的安装十分简单,下面介绍其他三个步骤。 环境介绍 三台虚拟机 hadoop1 192.168.46.129 centos 2g hadoop2 192.168.46.128 centos 2g hadoop3 192.168.46.130 ...

make__It的博客 1380

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

Spark Standalone环境搭建及测试

Apache Spark是目前最流行的大数据处理框架之一,可用于分布式数据处理和分析。在Standalone模式下搭建Spark集群是学习和开发Spark应用程序的良好起点。

默默发展,无声壮大~ 3207

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

carbondata+spark环境搭建及测试

0x0 介绍Carbondata:Apache CarbonData is an indexed columnar data format for fast analytics on big data platform, e.g. Apache Hadoop, Apache Spark, etc.carbondata是一种带索引的列型数据格式,用于大数据快速分析平台例如:hadoop、spark等。

gx304419380的博客 3219

Spark编程进阶(一、搭建/安装与测试python环境)

本文介绍了在Ubuntu系统上搭建和测试Python环境的三种方法:PySpark交互式、Jupyter Notebook和PyCharm。首先,通过命令行安装PySpark和Jupyter Notebook,并测试了PySpark的基本功能,如创建SparkContext和并行化数据集。接着,在Jupyter Notebook中初始化PySpark环境,并执行类似的操作。最后,通过PyCharm IDE配置SparkSession,并运行简单的Spark任务。这些步骤帮助用户在不同开发环境中顺利使用PyS

2502_90817102的博客 409

spark学习十二 hive on spark 环境搭建及测试

安装概览 整体的安装过程分为以下几步 搭建Hadoop集群 (整个cluster由3台机器组成,一台作为Master,另两台作为Slave)编译Spark 1.0,使其支持Hadoop 2.4.0和Hive运行Hive on Spark的测试用例 (Spark和Hadoop Namenode运行在同一台机器) Hadoop集群搭建 创建虚拟机 创建基于kvm的虚拟机,

西红柿炒土豆 1157

搭建Spark开发环境

搭建spark开发环境(spark-2.1.2 + jdk1.8.0_171 + hadoop-2.7.3 + scala-2.11.8) 一、安装jdk(jdk1.8.0_171) 1、解压 tar -zxvf 文件 -C 指定文件夹 2、添加到环境变量 vim /etc/profile export JAVA_HOME=/root/home/myapp/java/jdk1.8.0_1...

lfy9477的博客 304
上一篇: Spark SQL数据源操作
下一篇: Spark On YARN
JeeThink
博客等级 码龄9年 12粉丝 23原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值