实操手册-OpenClaw长任务超时无响应的解决

Codex重连卡死?一行request_timeout配置让长任务自动恢复 开发工具在长任务运行中经常遇到网络波动、连接老化或环境切换,导致请求静默挂起、界面假死。这类现象的本质,是应用层等待响应时缺少合理的超时止损机制。HTTP请求通常包含连接超时、读超时和写超时三类参数,其中读超时(如request_timeout)决定了请求发出后最多等待多久。若该值被默认配置设为近似无限,重连流程就会在底层TCP未判定失败前一直干等,最终表现为十几分钟甚至更久的卡顿。合理设置请求超时上限,如15~30秒,可让请求快速失败并触发重试,显著缩短恢复时间。此配置常用于编码智能体、自动化任务、无人值 阅读详情

一、 适用场景

OpenClaw 开发任务(代码生成、文件操作、长推理)时频繁遇到 Request timed out 错误,无论是通过飞书(Lark)还是 openclaw tui 调用。


二、 问题描述

在日常的工作中,当我们的任务有一定复杂度时,就会频繁出现以下提示:

LLM request failed.
Request timed out before a response was generated. Please try again, or increase agents.defaults.timeoutSeconds in your config.

如图:
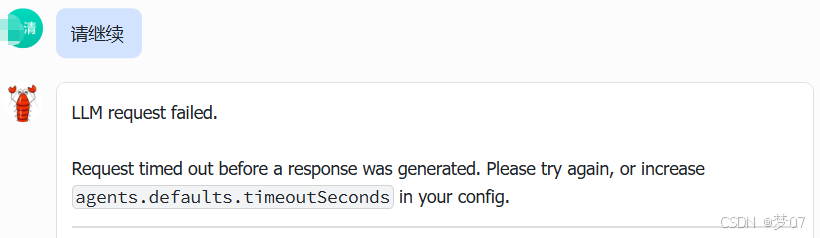
日常使用中遇到的问题

按照提示修改agents.defaults.timeoutSeconds后,问题依旧。这是因为 OpenClaw 的超时体系是分层级的,只改一个地方往往不够。


三、 根因分析

OpenClaw 的超时控制并非单一配置,而是由三个层级共同决定:

层级配置位置控制范围默认值是否常被忽略
Provider 级 ⭐models.providers.<id>.timeoutSeconds单个 LLM 的 HTTP 请求(连接 + 首字节 + 流传输)~60s✅ 最常见原因
Agent 级agents.defaults.timeoutSeconds整个 Agent 回合(含工具调用、上下文组装)48h提示中提到的
CLI/命令级openclaw agent --timeoutCLI 命令等待网关响应600sTUI/CLI 场景

为什么只改 agents.defaults.timeoutSeconds 不够?

大多数超时发生在 Provider 级 HTTP 请求阶段:模型推理或首 token 生成超过约 60 秒时,OpenClaw 的 HTTP 客户端会主动断开连接。此时 Agent 级的 48 小时超时根本来不及触发。

对于本地模型(Ollama / LM Studio / llama.cpp),冷启动时的首 token 延迟(Time to First Token) 可能长达 30~60 秒甚至更久,极易触发 Provider 级超时。


四、解决方案

Step 1:设置 Provider 级超时(最关键)

# 修改前,可以先查看一下当前的配置
openclaw config get models.providers.<provider-id>.timeoutSeconds
# 将 <provider-id> 替换为你的实际 provider 名称
openclaw config set models.providers.<provider-id>.timeoutSeconds 300

如何确认 provider ID?

openclaw models list

输出参考:

Model                                      Input      Ctx         Local Auth  Tags
qwen/deepseek-v4-flash                     text       200k        no    yes   default,configured
qwen/qwen3.7-plus-2026-05-26               text       200k        no    yes   fallback#1,configured
qwen/kimi-k2.7-code                        text       200k        no    yes   fallback#2,configured
qwen/glm-5.2                               text       200k        no    yes   fallback#3,configured
qwen/qwen3.8-max                           text       200k        no    yes   fallback#4,configured
qwen/qwen3.5-plus                          text+image 1000k       no    yes   
qwen/qwen3.6-plus                          text+image 1000k        no    yes   

第一列 Model 字段格式为 ProviderID/ModelID,取 / 之前的字符串作为 Provider‑ID,如上例中的qwen

Step 2:设置 Agent 级超时

openclaw config set agents.defaults.timeoutSeconds 1800

查看配置方法参考上一个命令,不再此重复。

Step 3:重启并验证

# 重启网关使配置生效
openclaw gateway restart

⚠️ 飞书渠道特别注意:旧会话会缓存旧的超时配置,必须新建飞书对话才能生效。或执行:

openclaw sessions prune --days 0

TUI 渠道:完全退出后重新执行 openclaw tui 即可。


五、不同场景的推荐配置

场景 A:本地模型(Ollama / LM Studio)

本地模型冷启动慢,建议将 Provider 超时设长:

# 保持模型常驻内存(Ollama 示例)
export OLLAMA_KEEP_ALIVE=-1

# 配置超时
openclaw config set models.providers.ollama.timeoutSeconds 600
openclaw config set agents.defaults.timeoutSeconds 1800

# 重启
openclaw gateway restart

场景 B:云端模型(Kimi / OpenAI / Claude)

云端模型响应快,但复杂开发任务(多文件操作、长代码生成)仍可能超时:

openclaw config set models.providers.kimi.timeoutSeconds 300
openclaw config set agents.defaults.timeoutSeconds 1800
openclaw gateway restart

场景 C:飞书渠道

飞书会话配置持久化,修改后务必新建对话:

openclaw config set models.providers.<id>.timeoutSeconds 300
openclaw config set agents.defaults.timeoutSeconds 1800
openclaw gateway restart
# 然后在飞书中开启新对话

场景 D:TUI 渠道

TUI 每次启动都是新会话,重启即可:

openclaw config set models.providers.<id>.timeoutSeconds 300
openclaw config set agents.defaults.timeoutSeconds 1800
# 按 Ctrl+C 退出 TUI,重新执行 openclaw tui

六、验证配置是否生效

# 查看 Agent 默认配置
openclaw config get agents.defaults

# 示例输出
{
  "timeoutSeconds": 1800,   # ← 关键字段:Agent 级超时(整个回合)
  "maxIterations": 20,
  "model": "kimi"
}

# 查看 Provider 配置
openclaw config get models.providers

# 示例输出
{
  "ollama": {
    "baseUrl": "http://127.0.0.1:11434",
    "timeoutSeconds": 600    # ← 关键字段:Provider 级超时(HTTP 请求)
  },
  "kimi": {
    "baseUrl": "https://api.moonshot.cn/v1",
    "timeoutSeconds": 300    # ← 关键字段:Provider 级超时(HTTP 请求)
  }
}

# 查看完整配置
openclaw config get

确认输出中包含你设置的 timeoutSeconds 值。


七、一键配置模板

#!/bin/bash
# OpenClaw 超时修复脚本
# 使用前请将 PROVIDER_ID 替换为你的实际 provider 名称

PROVIDER_ID="ollama"  # <-- 修改这里

# 1. Provider 级超时(HTTP 请求)
openclaw config set models.providers.${PROVIDER_ID}.timeoutSeconds 300

# 2. Agent 级超时(整个回合)
openclaw config set agents.defaults.timeoutSeconds 1800

# 3. 重启网关
openclaw gateway restart

echo "✅ 配置完成,请新建飞书对话或重启 TUI"

八、已知问题

如果使用的是 OpenClaw 2026.4.1 ~ 2026.4.8 版本,存在一个已知问题:

agents.defaults.timeoutSeconds 和 Provider 级超时在某些情况下会被忽略,存在硬编码的约 60 秒 HTTP fetch timeout。

建议:
升级到 2026.5.x 及以上版本或临时将两个超时都设为相同较大值(如 1800 秒)作为 workaround


九、总结

问题根因解决
LLM request timed outProvider 级 HTTP 超时(~60s)修改 models.providers.<id>.timeoutSeconds
提示改 agents.defaults.timeoutSeconds 无效只改了 Agent 级,没改 Provider 级两者都要改
飞书改了仍超时旧会话缓存旧配置新建飞书对话或清理 sessions
TUI 改了仍超时未完全退出重启Ctrl+C 后重新 openclaw tui
本地模型频繁超时冷启动首 token 延迟高Provider 超时设为 600s + OLLAMA_KEEP_ALIVE=-1

核心原则:
Provider超时管请求,Agent超时管回合。两者都改才靠谱,重启会话要记牢。


如果你也遇到了这个问题,欢迎收藏本文并分享给同样在使用 OpenClaw 的开发者。

OpenClaw异步任务队列设计:并发控制与长任务处理实践 异步架构是构建高可用AI Agent服务的基础。当个人或团队将OpenClaw用于微信、钉钉等多渠道接入时,任务排队、并发限制与长耗时管理成为影响体验的核心。从任务抽象与状态机出发,理解消息网关、调度器与Worker解耦的原理,能帮助设计出稳定响应的异步体系。内存队列在轻量级场景下价值显著,结合会话隔离、优先级调度和超时重试机制,可有效避免请求拥堵与资源竞态。实际部署中,OpenClaw常遇到文件占用、Control UI启动失败或审批记录迁移等坑,掌握排查方法能显著提升运维效率。这些技术不仅适用于Open 阅读详情

相关推荐

【问题解决】大模型调用报错 `API Connection Error/401/429`,OpenAI/文心一言通用修复

本文针对大模型API调用中常见的连接错误(APIConnectionError)、认证错误(401)和限流错误(429)问题,提供了三种通用解决方案。对于连接问题,实现带重试机制的会话管理;针对认证错误,提供API Key验证和测试方法;针对限流错误,给出请求频率控制策略。这些方法适用于OpenAI、文心一言等多种大模型API,包含完整代码示例和错误处理机制,可有效提升API调用的稳定性和可靠性。

博客 701

【Python LLM 调用踩坑】Connection error 终极解决方案!npm 代理导致阿里云通义千问接口连接失败

最近用Python在搞 LLM 客户端,通过 OpenAI 接口、调用阿里云通义千问模型,本以为是简单的 API 调用,结果卡了1小时的 Connection error,排查了 API Key、代码语法、网络环境,最后才发现——罪魁祸首是我之前安装 OpenClaw 时,通过 npm 设置的全局代理!

qq_37502791的博客 1849

【Bug已解决】OpenClaw Agent Task 卡死/死循环解决方案

方案适用场景推荐指数通过日志判断问题类型排查的第一步,决定后续处理方向⭐⭐⭐⭐⭐重新审视任务目标矛盾性真正死循环场景的根本修复⭐⭐⭐⭐⭐检查超时配置假性卡死场景的关键排查点⭐⭐⭐⭐⭐强制终止命令快速释放卡死任务的应急手段⭐⭐⭐⭐配置预防性超时机制长期预防同类问题的措施⭐⭐⭐⭐OpenClaw Agent Task 卡死的本质可能是真正的死循环(任务目标存在矛盾导致反复尝试失败)或假性卡死。

博客 7554

工具调用格式不兼容导致请求失败

排查步骤关键检查点预期结果/修复措施1. 基础连接网关模型配置(providerendpointapiKey确认配置正确,API密钥有效且有权调用目标模型。2. 技能定义SKILL.md的描述清晰度与index.ts的函数签名确保描述准确,参数类型匹配,函数返回。3. 日志分析启用DEBUG级别日志,查看网关和智能体的出入请求从日志中直接看到被拒绝的请求体,对比服务商API文档。4. 模型兼容性针对特定模型(如GLM-5)检查工具调用格式调整工具Schema或查阅该模型特定的工具调用格式要求。

weixin_42804214的博客 2506

【Bug已解决】OpenClaw Gateway 启动后无响应 gateway.mode 未配置 解决方案

执行 openclaw gateway start 后进程无响应,报 gateway.mode is not configured,本质是网关运行模式必填项被遗漏。文中给出显式配置 gateway.mode、诊断命令排查、官方模板初始化等完整解决方案。

博客 1万+

避坑指南:海康MV_CC_SetIntValue接口的7个典型报错解决方案

本文深度解析海康工业相机SDK中MV_CC_SetIntValue接口的典型报错,提供7个实战解决方案。针对MV_E_CALLORDER、MV_E_PARAMETER等高频错误码,从设备状态、参数值域、依赖关系等核心约束入手,给出清晰的诊断流程与根治代码,帮助开发者构建健壮的参数设置模块,提升开发效率。

y2z3a4b5c的博客 1078

dify连接vllm本地部署模型connection error问题

问题:在dify页面添加 OpenAI-API-compatible部分,填写API endpoint URL,点击保存后,报connection error问题。,找到docker对应的网关IP“IPAM”->“Config”->“Gateway”,把API endpoint URL的host部分替换成这个就OK了。解决方法:dify在docker中,大模型部署在主机上,因此需要在服务器终端输入。

weixin_43844113的博客 1490

【ESP32】ESP32连接JY61P并通过WIFI发送给电脑

ESP32S连接JY61P并通过WIFI把姿态数据发送给电脑1.采用Arduino IDE编译器;需要安装ESP32的开发板管理器;2.电脑接受数据是基于python的;

Doudou_Nai的博客 1131

Openclaw请求本地大模型时间太长无响应的解决办法

文章摘要: OpenClaw配置调整可优化LLM会话响应,尤其针对低配硬件(如32GB内存+GTX1050Ti 4G显存)。早期版本通过agents.defaults.llm.idleTimeoutSeconds 0禁用空闲超时,但2026.4.26版后需改用models.providers.ollama.timeoutSeconds 900(值需>0)。2026.3.31版默认60秒超时可能导致响应中断,设为0可禁用限制。 补充建议: 调整Ollama的OLLAMA_KEEP_ALIVE环境变量(如

经验之谈,不做搬运工 1498

生成式引擎优化(GEO)- 搜索引擎优化

生成式引擎优化(GEO)是针对AI内容生成平台(如ChatGPT)的新型优化策略,旨在提升品牌内容在AI生成答案中的引用率,与传统SEO存在显著差异。GEO通过优化内容权威性、结构化和语义关联,适应AI的RAG技术架构,采用3C原则(可爬性、网络共识、反馈校正)提升内容可见性。其核心区别在于目标(引用率vs排名)、技术(语义优化vs关键词)及算法透明度(封闭vs开放)。适用场景包括商业决策、行业权威建设及公共知识服务,帮助品牌在AI时代占据信息主导权。

解锁AI流量新红利!🚀 GEO优化(生成引擎优化)助您掌控AI搜索,让AI成为您的品牌最佳代言人! 1399

【YOLOv11】070、YOLOv11异常检测:正常数据训练下的异常目标识别

本文探讨了如何利用YOLOv11模型进行工业异常检测,重点介绍了仅使用正常样本训练模型的创新方法。文章首先通过产线误报案例引出异常检测的核心问题,阐述了YOLOv11作为特征提取器的改造思路,包括正常数据训练、特征空间构建和异常度量等关键步骤。实战部分提供了精简代码示例,强调数据增强控制、特征层选择和自编码器应用等技巧。作者还总结了容易出错的细节,如特征选择、阈值设定和计算效率优化等,并给出实用建议:从简单方法入手、重视可视化、确保数据质量、部署时设置复核机制等。最后指出该方法虽能减少对异常样本的依赖,但需

企鹅码农的专属播客,分享10多年的实战案例和经验解读,包含YOLO、RT-DETR、AI等各个工作领域。 235

OpenClaw任务监控:GLM-4.7-Flash长流程执行的保障方案

本文介绍了如何在星图GPU平台上自动化部署【ollama】GLM-4.7-Flash镜像,实现长流程任务的可靠监控与执行。该方案通过心跳检测、状态持久化等机制,特别适用于技术文档翻译等复杂自动化场景,显著提升任务成功率与稳定性。

weixin_32099703的博客 390

B站评论情感分析实战:Python批量爬取+BERT正负向分类,精准度92%(附完整代码)

用技术手段自动化挖掘用户真实情感,比人工分析更高效、更客观。这套方案的精度能稳定在90%左右,完全满足实际应用需求。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1026

Olares 上运行 OpenClaw 的常见问题排查与解决指南

本文整理了在 Olares 上运行自托管 OpenClaw 智能体时最常见的故障场景,覆盖升级后的认证迁移报错、容器化环境下无法用 CLI 重启网关、长任务被超时终止、ClawHub 限流、本地模型首响应延迟,以及彻底重装应用等实战问题。读完本文,你将掌握每类问题的根因定位思路、对应的命令行修复与图形界面操作路径,并能结合仓库中的 [OpenClaw 系列文档](https://link.gitc

gitblog_01136的博客 650

智能制造之物料详解

制造业业务系统中的物料流转贯穿需求、采购、生产到交付全流程,各系统协同实现精准追踪。需求阶段由CRM/ERP/PLM生成物料计划;采购入库阶段SCM/WMS/QMS完成采购质检;生产阶段MES/APS协调领料加工;成品交付阶段WMS/SCM处理出库物流。整个流程以BOM为蓝图,ERP为调度中心,通过数据联动实现物料状态、位置和数量的全链路可追溯。

cdfunlove的博客 654

ONVIF协议简介与协议测试工具使用详解

Onvif协议及协议测试工具使用详解

dvlinker的技术专栏 3万+

OpenClaw问题排查大全:Qwen3-32B接口超时等10类错误解决

本文介绍了在星图GPU平台上自动化部署Qwen3-32B镜像的方法,并针对OpenClaw对接该模型时常见的接口超时等问题提供解决方案。通过优化maxTokens等关键参数配置,可显著提升大语言模型在长文本生成、多轮对话等场景下的稳定性和响应速度。

weixin_42611310的博客 257

基于龙虾Claw的会议纪要自动提取与重点内容总结办公场景实践

本文介绍如何使用龙虾Claw构建会议纪要自动提取与重点内容总结系统,实现会议内容的智能处理。

一键难忘的博客 253

Openclaw 请求本地大模型超时无响应?把 endpoint 改到 TaoToken 的排查与配置

Openclaw 请求本地大模型超时无响应,先查 timeoutSeconds 与 ollama keep_alive。本文给出可复制配置片段,把 endpoint 统一到 TaoToken 官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end ,并逐条排查 401、reading choices 等报错,恢复 agent 稳定调用。

weixin_35750747的博客 69

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

OpenClaw 对话无响应问题深度排查分析

摘要:本文详细记录了OpenClaw对话功能失效问题的系统性排查过程。通过检查服务状态、测试API连接、分析会话记录和网络请求,最终发现是Node.js无法验证API服务器SSL证书导致HTTPS请求失败。解决方案包括修改Gateway配置文件添加SSL环境变量并重启服务。文章还提供了验证修复的方法、预防措施、快速修复指南以及从该问题中总结的经验教训,强调系统性排查和技术环境差异的重要性,为类似问题提供了完整的排查思路和解决方案参考。(150字)

wangdonghello的专栏 2万+

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

OpenClaw调试技巧:百川2-13B-4bits量化模型任务失败排查手册

本文介绍了如何在星图GPU平台上自动化部署百川2-13B-对话模型-4bits量化版 WebUI v1.0镜像,实现高效AI对话功能。该镜像特别适用于自动化文档整理场景,通过OpenClaw工具可快速处理文件操作任务,显著提升办公效率。文章还提供了任务失败时的详细排查手册,帮助用户解决常见部署问题。

weixin_42581003的博客 399

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

OpenClaw故障排查大全:GLM-4.7-Flash接口超时解决方案

本文介绍了在星图GPU平台上自动化部署【ollama】GLM-4.7-Flash镜像的方法,并针对OpenClaw接口超时问题提供系统化解决方案。该镜像特别适用于文件整理自动化等任务场景,通过优化网络配置、调整超时参数等技术手段,可显著提升大模型应用的稳定性与响应效率。

weixin_35696112的博客 272

OpenClaw接入钉钉全场景踩坑解决方案:从无响应到报错全搞定

OpenClaw接入钉钉常见问题解决方案 本文总结了OpenClaw接入钉钉时常见的6类问题及解决方案: 机器人无响应:检查钉钉应用发布状态、消息接收地址URL格式,自建测试群并核对AppFlow连接流配置 仅显示"处理中":验证大模型API Key、重启OpenClaw网关、修正连接流模型配置 Web UI无法访问:修改钉钉插件代码以放行非钉钉请求 连接被拒绝:修正公网地址格式、配置服务器安全组、添加钉钉IP白名单 参数无效:避免使用"运行一次"功能,核对连接流关键

Honmaple的博客 1万+

解决Openclaw+Ollama+Qwen WebUI无响应问题

大语言模型本地部署时,组件间通信异常是常见的技术挑战。以Openclaw+Ollama+Qwen架构为例,其核心原理是通过REST API实现WebUI与模型服务的交互。在工程实践中,版本兼容性、服务端口配置和模型加载是三个关键环节,直接影响系统的可用性。特别是在国内网络环境下,还需考虑镜像源配置和证书验证等本地化问题。通过系统日志分析、API接口测试和资源监控等方法,可以快速定位无响应问题的根源。本文提供的解决方案已在实际生产环境中验证,适用于Ubuntu/CentOS等主流Linux发行版,能有效解决因

weixin_33393017的博客 160

OpenClaw任务调试技巧:gemma-3-12b-it执行失败排查手册

本文介绍了如何在星图GPU平台上自动化部署gemma-3-12b-it高性能开源大语言模型(LLM)WebUI镜像,实现智能文档处理功能。通过该平台,用户可快速搭建AI文档摘要环境,应用于自动整理项目文档、提取关键信息等场景,显著提升工作效率。

weixin_35982453的博客 340

解决OpenClaw API超时问题的实践指南

API超时是分布式系统开发中的常见挑战,特别是在对接大语言模型(LLM)服务时。超时机制本质上是客户端设置的等待阈值,涉及网络传输、服务处理等多个环节。合理配置超时参数能显著提升系统可靠性,在SpringCloud微服务、阿里云部署等场景尤为关键。本文以OpenClaw平台为例,详解从网络层诊断到服务端优化的全链路解决方案,包含Python/Java客户端的超时配置模板、指数退避重试实现,以及针对微信机器人等特殊场景的异步处理技巧。通过Prometheus监控和阿里云专项调优,开发者可构建高可用的LLM集成

weixin_33290540的博客 289
上一篇: 实操手册-openclaw升级
下一篇: 实操手册-2G 内存云服务器跑起港大 DeepTuto
青木私享
博客等级 码龄19年 111粉丝 29原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

青木私享

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值