


OpenAI 提示词工程指南
OpenAI在官方的文档里上线了Prompt engineering,也就是提示词工程指南,其中OpenAI有提到写提示词的6条大的原则,它们分别是:
(1)Write clear instructions(写出清晰的指令)
(2)Provide reference text(提供参考文本)
(3)Split complex tasks into simpler subtasks(将复杂的任务拆分为简单的子任务)
(4)Give the model time to "think"(给模型时间“思考”)
(5)Use external tools(使用外部工具)
(6)Test changes systematically(系统地测试变更)
写出清晰的指令
1. 把话说详细:尽量多的提供任何重要的详细信息和上下文。
用一个段落总结会议记录。然后写下演讲者的 Markdown 列表以及他们的每个要点。最后,列出发言人建议的后续步骤或行动项目(如果有)。
2. 让模型充当某个角色:把大模型想象成一个演员,告诉他饰演的角色。
充当一个喜欢讲笑话的喜剧演员,每当我请求帮助写一些东西时,你会回复一份文档,其中每个段落至少包含一个笑话或有趣的评论。
3. 使用分隔符指示输入的不同部分
三引号、XML 标签、节标题等分隔符可以帮助划分要区别对待的文本节。可以帮助大模型更好的理解文本内容。
用50个字符总结由三引号分隔的文本。"""在此插入文字"""。
4. 指定完成任务所需的步骤
将任务拆解为一系列步骤,明确地写出这些步骤,让模型更容易去实现它们。
5. 提供示例:few-shot
请按以下内容的风格来书写文章:"""落霞与孤鹜齐飞,秋水共长天一色。渔舟唱晚,响穷彭蠡之滨"""。
6. 指定内容输出长度
可以要求模型生成给定目标长度的输出。目标输出长度可以根据单词、句子、段落、要点等的计数来指定。但是不是精确的答案。
用两个段落、100个字符概括由三引号分隔的文本。"""在此插入文字"""。
提供参考文本
1. 让模型使用参考信息作答
使用提供的由三重引号引起来的文章来回答问题。如果在文章中找不到答案,请回答“找不到答案”。"""<在此插入文档>""","""<在此插入文档>"""。
问题:<在此插入问题>
2. 让模型通过引用参考文本来回答
可以要求模型通过引用所提供文档中的段落来为其答案添加引用。可以提高正确性,增加可验证性。
您将获得一份由三重引号和一个问题分隔的文档。您的任务是仅使用提供的文档回答问题,并引用用于回答问题的文档段落。如果文档不包含回答此问题所需的信息,则请回答:“信息不足”。如果提供了问题的答案,则必须附有引文注释。使用以下格式引用相关段落({“引用”:…})。
"""<在此插入文档>"""
问题:<在此插入问题>
将复杂的任务拆分为简单的子任务
1. 使用意图分类来识别与用户查询最相关的指令
2. 对于对话中的历史记录,总结或过滤之前的对话
3. 分段总结长文档并递归构建完整总结
章节摘要可以连接和总结,生成摘要的摘要。这个过程可以递归地进行,直到总结整个文档。 https://openai.com/research/summarizing-books
给模型时间“思考”
链式思考(CoT),Chain-of-Thought Prompting,think step by step。
1. 让模型在给出结论之前找出自己的解决方案
2. 使用内心独白来隐藏模型的推理过程
3. 询问模型在之前的过程中是否遗漏了什么内容
如果源文档很大,模型通常会过早停止并且无法列出所有相关信息。在这种情况下,通过使用后续的promtp让模型查找之前传递中错过的任何相关信息,通常可以获得更好的性能。例如根据文档来列出这个问题在文档中的相关片段:“北京烤鸭到底好吃在哪”,然后让他用JSON格式输出
{"相关片段":"..."},
在输出停止以后,可以再问一句:
还有更多相关片段吗?注意不要重复摘录。还要确保相关片段包含解释它们所需的所有相关上下文 - 换句话说,不要提取缺少重要上下文的小片段。
使用外部工具
1. 使用基于嵌入的搜索实现高效的知识检索
检索增强生成 (RAG),Retrieval Augmented Generation,常见步骤:加载文件 -> 读取文本 -> 文本分割 -> 文本向量化 -> 问句向量化 -> 在文本向量中匹配出与问句向量最相似的top k个 -> 匹配出的文本作为上下文和问题一起添加到prompt中 -> 提交给大模型生成回答。
2. 使用代码执行来进行更准确的计算或调用外部API
3. 给模型提供特定的功能
通过 API 请求,传递一系列特定的函数描述。告诉模型哪些函数是可用的,以及这些函数的参数应该是什么样的。然后模型模可以生成相应的函数参数,这些参数随后会以 JSON 格式通过 API 返回。拿到JSON数组,跟数据库交互,做数据查询、数据处理等等。
处理完以后再返回一个JSON数组给大模型,让大模型变成人类语言输出给用户。
系统地测试变更
主要是帮助开发者判断更改Prompt(例如新指令或新设计)是否使系统变得更好或更差。
https://platform.openai.com/docs/guides/prompt-engineering/strategy-test-changes-systematically
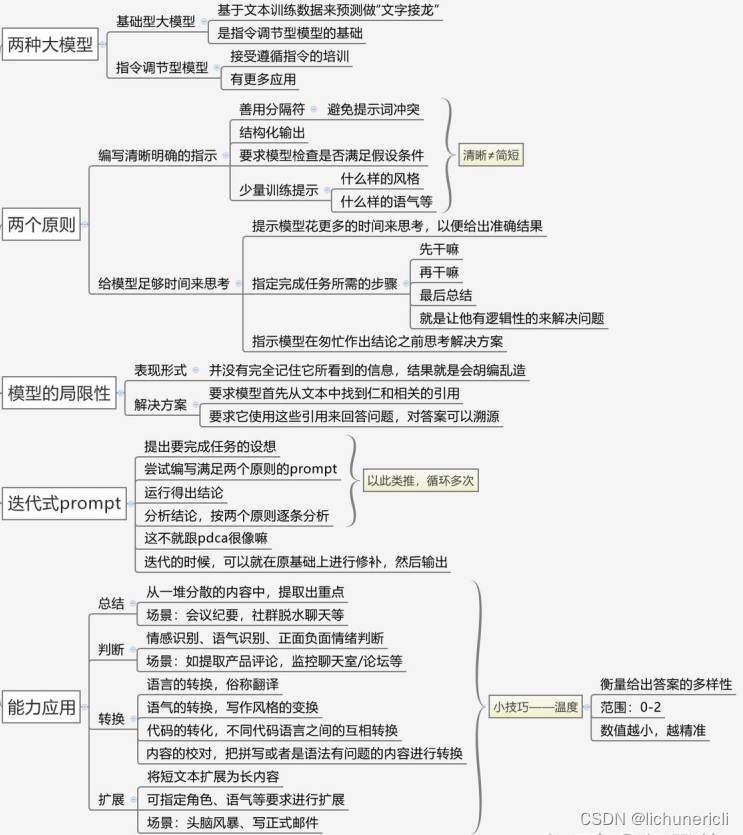
吴恩达提示词课程笔记

CRISPE 高级提示词方式
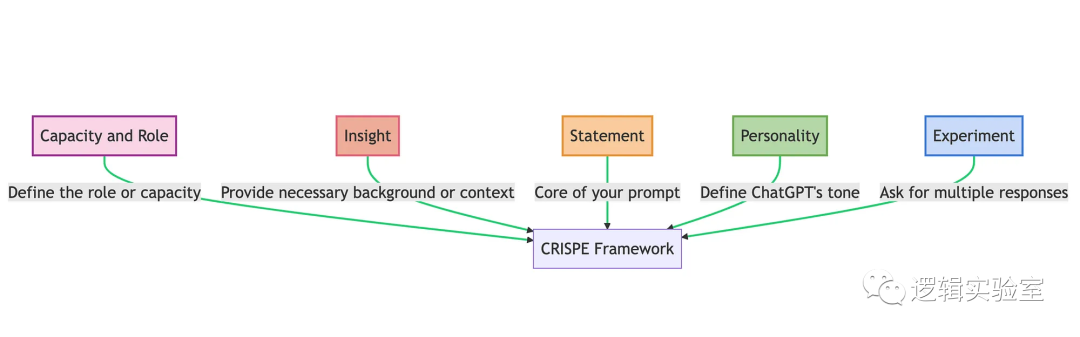
如图所示。所谓CRISPE框架,指的是:
- CR:Capacity and Role(能力与角色)。你希望 ChatGPT 扮演怎样的角色。
- I:Insight(洞察),背景信息和上下文。
- S:(陈述),你希望 ChatGPT 做什么。
- P:Personality(个性),你希望 ChatGPT 以什么风格或方式回答你。
- E:Experiment(实验),要求 ChatGPT 为你提供多个答案。
如果我们要定义一个翻译诗词的 GPT 。我们可以这么写:
| CR | 你是一个擅长中文和英文的AI 工程师和数据科学家,擅长中文和英文相关的 AI 技术文章编写和翻译。 |
| I | 需要翻译的英文段落: Spending lots of time thinking about different possible future scenarios and their probabilities might be captivating, but I suggest an absolutely different approach — to try to build your prototype yourself. First, it’s rather challenging and fun. Second, it will help us to look at our work in a more structured way. Third, it will give us an opportunity to try in practice one of the most cutting-edge approaches — LLM agents. |
| S | 请将下面的英文翻译成中文, |
| P | 要求语言生动活泼,简洁优雅。 |
| E | 给我三个结果。 |
Zero-shot
只是使用CRISPE,不增加示例样本,就是 zero-shot 。下面是这个任务的 zero-shot prompt:
你是一个擅长中文和英文的AI工程师和数据科学家,擅长中文和英文相关的 AI 技术文章编写和翻译。
请将下面的英文翻译成中文,要求语言生动活泼,简洁优雅。
需要翻译的英文段落:《见上面英文段落》
给我三个结果。
请输出翻译后的结果:
ChatGPT 3.5 输出:
花费大量时间思考不同可能的未来情景及其概率可能会吸引人,但我建议采取完全不同的方法——尝试自己建立原型。首先,这是相当具有挑战性和有趣的。其次,它将有助于我们以更有结构的方式审视我们的工作。第三,它将给我们一个机会实践最先进的方法之一——LLM代理。
花费大量时间思考不同可能的未来情景及其概率可能会引人入胜,但我建议采取一种完全不同的方法——尝试自己构建原型。首先,这是相当具有挑战性和有趣的。其次,它将帮助我们以更有结构的方式审视我们的工作。第三,它将为我们提供一个实践最尖端方法的机会——LLM代理。
花费大量时间思考不同可能的未来情景及其概率可能会令人着迷,但我建议尝试完全不同的方法——自己构建原型。首先,这非常具有挑战性和有趣。其次,它将帮助我们以更有结构的方式审视我们的工作。第三,它将为我们提供实践最先进方法之一——LLM代理的机会。
Few-shot
有的时候,我们如果给他一个示范,可能会有更好的效果。将示例加入 Prompt 的做法,就是 few-shots,few 可以是 1,2,3,4,5 。比如,我提供一个样本,就是 1-shot 。
你是一个擅长中文和英文的AI 工程师和数据科学家,擅长中文和英文相关的技术文章编写和翻译。
请将下面的英文翻译成中文,要求语言生动活泼,简洁优雅。
请参考我给出的示例:
<example>
英文原文:
As ChatGPT gets “lazy,” people test “winter break hypothesis” as the cause
中文翻译:
ChatGPT变懒原因:正在给自己放寒假!已被网友测出🧐
</example>需要翻译的英文段落:《见上面英文段落》
请输出3个翻译后的结果:
ChatGPT 3.5 输出:
- 花费大量时间思考不同可能的未来情景和它们的概率可能会吸引人,但我建议一个完全不同的方法——尝试自己建立原型。首先,这是相当具有挑战性和有趣的。其次,它将帮助我们以更有结构的方式看待我们的工作。第三,它将给我们一个机会实践最前沿的方法之一——LLM代理。
- 对未来情景进行大量思考,以及它们的概率,可能会吸引人,但是我建议采取完全不同的方法——尝试自己建立原型。首先,这是相当具有挑战性和有趣的。其次,这将帮助我们以更有结构的方式审视我们的工作。第三,这将为我们提供一个实践最尖端方法之一的机会——LLM代理。
- 花费大量时间思考不同可能的未来情景及其概率可能会引人入胜,但我建议采取完全不同的方法——尝试自己构建原型。首先,这相当具有挑战性和有趣。其次,它将帮助我们以更有结构的方式审视我们的工作。第三,它将为我们提供一个实践最尖端方法之一的机会——LLM代理。
COT
效果似乎有所提升。我们再试试 COT,也就是思维链。他是将要执行的任务拆解为多个步骤,按步骤执行。
我们更新后的 Prompt 是:
你是一个擅长中文和英文的AI工程师和数据科学家,擅长中文和英文相关的 AI 技术文章编写和翻译。
请将下面的英文翻译成中文,要求语言生动活泼,简洁优雅。
你需要两个步骤来执行这个任务:
1. 将英文直接翻译为中文,主要考虑意思表达的准确性
2. 将步骤 1 直译的中文翻译成更简洁优雅通顺的中文标题,主要考虑中文的语言表达习惯
需要翻译的英文文章标题:《见上面英文段落》
请步骤 1 和步骤 2 结果:
ChatGPT 3.5 输出:
步骤1翻译结果:
花费大量时间思考不同可能的未来场景及其概率可能会令人着迷,但我建议采取完全不同的方法——尝试自己构建原型。首先,这相当具有挑战性和趣味性。其次,它将有助于我们以更有结构性的方式审视我们的工作。第三,它将为我们提供一个实践最先进方法之一——LLM代理的机会。
步骤2翻译结果:
摒弃“花费大量时间思考不同未来场景和概率”的想法,来试着亲自构建原型吧!这不仅具有挑战性和趣味性,还能使我们更有条理地审视工作。同时,这也是尝试最先进方法——LLM代理的机会。
可以看到,现在这个结果明显更好了。
COT+SC
COT 通过分步骤加大了 LLM 的深度。SC 则是在增加深度的基础上再增加宽度。
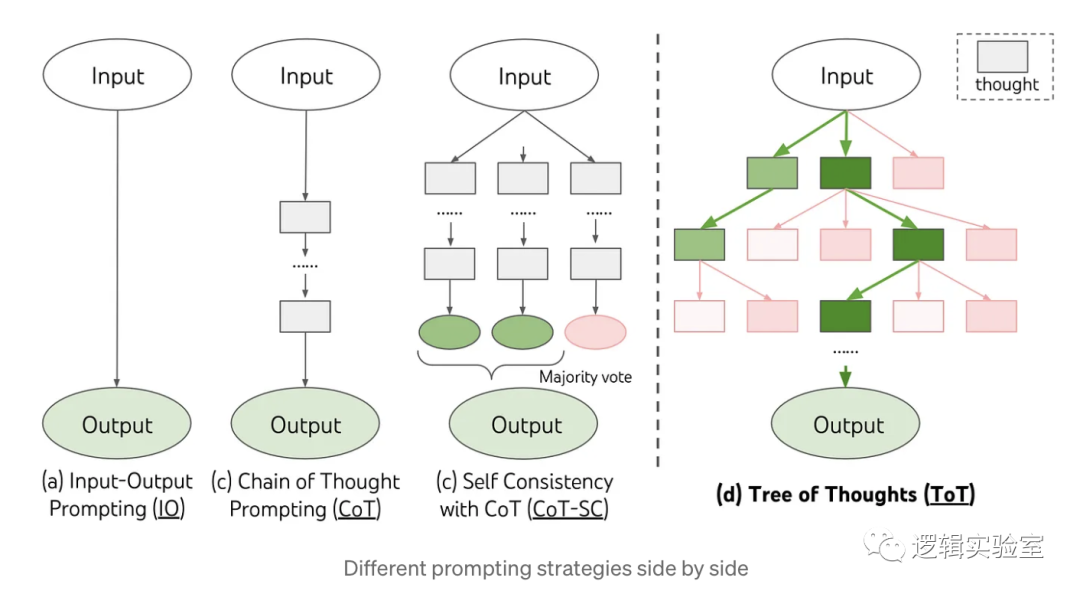
我们用 COT+ SC 的方法再来写一个Prompt:
你是一个擅长中文和英文的AI工程师和数据科学家,擅长中文和英文相关的 AI 技术文章编写和翻译。
请将下面的英文翻译成中文,要求语言生动活泼,简洁优雅。
你需要3个步骤来执行这个任务:
1. 将英文直接翻译为中文,主要考虑意思表达的准确性,请给出 3个结果
2. 将步骤 1 直译的3个中文翻译成更简洁优雅通顺的中文,主要考虑中文的语言表达习惯
3. 审视步骤 2 提供的 3 个结果,整合出一个最好的结果,作为最终结果输出
需要翻译的英文段落:
《见上面英文段落》
分别输出步骤 1 的 3 个结果、步骤 2 的 3 个结果,和步骤 3 的最终结果:
ChatGPT 3.5 输出结果:
步骤 1 结果:
1. 花费大量时间思考不同可能的未来情景及其概率可能是迷人的,但我建议采取完全不同的方法——尝试亲自建立你的原型。首先,这相当具有挑战性和有趣。第二,它将帮助我们以更有结构的方式看待我们的工作。第三,它将给我们一个机会来实践最前沿的方法——LLM代理。
2. 投入大量的时间思考不同可能的未来情景及其概率可能会十分吸引人,但我建议采取完全不同的方法——尝试亲自建立你的原型。首先,这是相当具有挑战性和有趣的。第二,它将帮助我们以更有结构的方式审视我们的工作。第三,它将为我们提供一个实践最尖端方法之一——LLM代理的机会。
3. 投入大量时间思考不同可能的未来情景及其概率可能会引人入胜,但我建议采取完全不同的方法——尝试亲自建立你的原型。首先,这是相当具有挑战性和有趣的。第二,它将帮助我们以更有结构的方式审视我们的工作。第三,它将给我们一个机会来实践最前沿的方法之一——LLM代理。
步骤 2 结果:
1.虽然沉浸于思考各种可能出现的未来情景及其概率是令人着迷的,但我建议采取绝然不同的方式——亲自尝试建立你的原型。首先,这样做既具有挑战性又有趣。其次,它能够以更有结构的方式审视我们的工作。第三,它让我们有机会实践最尖端的方法之一——LLM代理。
2. 虽然沉浸于思考各种可能出现的未来情景及其概率是令人着迷的,但我建议采取绝然不同的方式——亲自尝试建立你的原型。首先,这样做既具有挑战性又有趣。其次,它能够以更有结构的方式审视我们的工作。第三,它给我们提供了实践最尖端方法之一——LLM代理的机会。
3. 虽然沉浸于思考各种可能出现的未来情景及其概率是引人入胜的,但我建议采取绝然不同的方式——亲自尝试建立你的原型。首先,这样做既具有挑战性又有趣。其次,它能够以更有结构的方式审视我们的工作。最后,它让我们有机会实践最尖端的方法之一——LLM代理。
步骤 3 结果:
1. 虽然沉浸于思考各种可能出现的未来情景及其概率是引人入胜的,但我建议采取绝然不同的方式——亲自尝试建立你的原型。首先,这样做既具有挑战性又有趣。其次,它能够以更有结构的方式审视我们的工作。最后,它让我们有机会实践最尖端的方法之一——LLM代理。
TOT
TOT 与 COT+SC 类似,也是先分步骤,然后每个步骤多个结果,不同的是,COT+SC 是并列输出多个结果。而 TOT 是在每一步的多个结果中进行选择,然后再进行下一步,输出多个结果。
我们继续修改 Prompt:
你是一个擅长中文和英文的AI工程师和数据科学家,擅长中文和英文相关的 AI 技术文章编写和翻译。
请将下面的英文翻译成中文,要求语言生动活泼,简洁优雅。
你需要3个步骤来执行这个任务:
1. 将英文直接翻译为中文,主要考虑意思表达的准确性,请给出 3个结果
2. 从步骤 1 的结果中选择一个意思表达更恰当的给出 1 个结果
3. 将步骤 2 的结果润色为更简洁优雅通顺的中文,主要考虑中文的语言表达习惯,输出 3 个结果
4. 审视步骤 3 提供的 3 个结果,整合出一个最好的结果,作为最终结果输出
需要翻译的英文段落:
《见上面英文段落》
分别输出步骤 1 的 3 个结果、步骤 2 的 1 个结果、步骤 3 的 3 个结果,和步骤 4 的最终结果:
ChatGPT 3.5 输出结果:
步骤 1 的 3 个结果:
花费大量时间思考各种可能的未来情景和它们的概率可能是令人着迷的,但我建议采取完全不同的方法——尝试亲自建立你的原型。首先,这是相当具有挑战性和有趣的。第二,它将帮助我们以更有结构的方式看待我们的工作。第三,它将给我们一个机会在实践中尝试最前沿的方法之一——LLM代理。
花费大量时间思考不同可能的未来情景及其概率可能是引人入胜的,但我建议采取完全不同的方法——尝试自己构建原型。首先,这非常具有挑战性和有趣。其次,这将帮助我们更有条理地看待我们的工作。第三,这将为我们提供一个实践的机会,尝试最尖端的方法之一——LLM代理。
花费大量时间思考各种可能的未来情景及其概率可能是吸引人的,但我建议采取完全不同的方法——尝试自己建立原型。首先,这是相当具有挑战性和有趣的。其次,这将帮助我们以更有结构的方式看待我们的工作。第三,这将为我们提供一个实践的机会,尝试最前沿的方法之一——LLM代理。
步骤 2 的 1 个结果:
花费大量时间思考各种可能的未来情景及其概率可能是吸引人的,但我建议采取完全不同的方法——尝试自己建立原型。这不仅具有挑战性和有趣,还能以更有结构的方式审视我们的工作,并实践尝试最前沿的方法之一——LLM代理。
步骤 3 的 3 个结果:
花费大量时间思考各种可能的未来情景及其概率可能很吸引人,但我建议采取一种截然不同的方法——尝试亲自建立原型。首先,这既具有挑战性又有趣。其次,它将帮助我们以更有条理的方式审视我们的工作。第三,它将给我们提供一个实践的机会,尝试最尖端的方法之一——LLM代理。
花费大量时间思考各种可能的未来情景及其概率可能很吸引人,但我建议采取完全不同的方法——尝试亲自建立原型。首先,这非常具有挑战性和有趣。其次,它将帮助我们以更有结构的方式看待我们的工作。第三,它将给我们一个实践的机会,尝试最前沿的方法之一——LLM代理。
花费大量时间思考各种可能的未来情景及其概率可能很吸引人,但我建议采取完全不同的方法——尝试亲自构建你的原型。首先,这非常具有挑战性和有趣。其次,它将帮助我们以更有结构的方式审视我们的工作。第三,它将给我们一个实践的机会,尝试最尖端的方法之一——LLM代理。
步骤 4 的最终结果:
花费大量时间思考各种可能的未来情景及其概率可能很吸引人,但我建议采取完全不同的方法——尝试亲自建立原型。这不仅具有挑战性和有趣,还能以更有结构的方式审视我们的工作,并实践尝试最前沿的方法之一——LLM代理。
Step-Back
通俗的讲,Step-Back 就是在写 Prompt 的时候,往后退一步,想想在回答这个问题之前需要先回答什么问题。网上很多 Step-Back 都是通过变成的方法把问题拆成多个 Chain 来做的。但我试了一下,用一条纯粹的 Prompt 也是可以实现的。
还是相同的任务,我们写这样一条 Prompt:
你是一个擅长中文和英文的AI工程师和数据科学家,擅长中文和英文相关的 AI 技术文章编写和翻译。
请将下面的英文翻译成中文,要求语言生动活泼,简洁优雅。
需要翻译的英文段落:《见上面英文段落》
请按照一下步骤输出结果:
1. 要想得到通顺优雅简洁的翻译文章,你需要知道哪些前提问题
2. 这些前提问题的答案分别是什么
3. 基于这个前提问题,对于给出英文的翻译结果
ChatGPT 3.5 输出结果:
要想得到通顺优雅简洁的翻译文章,你需要知道哪些前提问题?在进行翻译之前,需要了解以下前提问题:
- 目标受众是谁?
- 文章的语气和风格是什么?
- 是否有特定的行业或领域术语需要考虑?
这些前提问题的答案分别是什么?
- 目标受众是中文读者,可能包括普通读者、专业领域读者或技术人员。
- 文章的语气应该是生动活泼的,以吸引读者的注意力。
- 文章的风格应该简洁优雅,使读者易于理解。
- 可能需要考虑AI、工程、数据科学等领域的术语。
- 基于这个前提问题,对于给出英文的翻译结果:
- 花费大量时间思考不同可能的未来场景及其概率可能会引人入胜,但我建议采用完全不同的方法——尝试自己建立原型。首先,这是相当具有挑战性和有趣的。其次,这将帮助我们以更有结构的方式看待我们的工作。第三,它将为我们提供尝试最前沿方法之一——LLM智能体的实践机会。
这样翻译结果既生动活泼,又简洁优雅。
CRISPE Prompt 模式总结
下面我们对同一个输出在相同的模型 ChatGPT 3.5 Turbo 上的翻译结果:
| Prompt 模式 | 结果 | 主观评分 |
| Zero-Shot | 花费大量时间思考不同可能的未来情景及其概率可能会令人着迷,但我建议尝试完全不同的方法——自己构建原型。首先,这非常具有挑战性和有趣。其次,它将帮助我们以更有结构的方式审视我们的工作。第三,它将为我们提供实践最先进方法之一——LLM代理的机会。 | 3.5 |
| Few-Shots | 花费大量时间思考不同可能的未来情景及其概率可能会引人入胜,但我建议采取完全不同的方法——尝试自己构建原型。首先,这相当具有挑战性和有趣。其次,它将帮助我们以更有结构的方式审视我们的工作。第三,它将为我们提供一个实践最尖端方法之一的机会——LLM代理。 | 3.5 |
| COT | 摒弃“花费大量时间思考不同未来场景和概率”的想法,来试着亲自构建原型吧!这不仅具有挑战性和趣味性,还能使我们更有条理地审视工作。同时,这也是尝试最先进方法——LLM代理的机会。 | 5 |
| COT+SC | 虽然沉浸于思考各种可能出现的未来情景及其概率是引人入胜的,但我建议采取绝然不同的方式——亲自尝试建立你的原型。首先,这样做既具有挑战性又有趣。其次,它能够以更有结构的方式审视我们的工作。最后,它让我们有机会实践最尖端的方法之一——LLM代理。 | 4 |
| TOT | 花费大量时间思考各种可能的未来情景及其概率可能很吸引人,但我建议采取完全不同的方法——尝试亲自建立原型。这不仅具有挑战性和有趣,还能以更有结构的方式审视我们的工作,并实践尝试最前沿的方法之一——LLM代理。 | 4.5 |
| Step-Back | 花费大量时间思考不同可能的未来场景及其概率可能会引人入胜,但我建议采用完全不同的方法——尝试自己建立原型。首先,这是相当具有挑战性和有趣的。其次,这将帮助我们以更有结构的方式看待我们的工作。第三,它将为我们提供尝试最前沿方法之一——LLM智能体的实践机会。 | 3. 75 |
总结来说:
- 对于同样的模型,同样的任务,使用不同的 Prompt,输出的结果也有不小的差异
- 一般来说,使用Prompt技巧的结果会比不使用任何技巧要好
- 对于简单的任务并不是叠加所有的技巧就会更好,到达一定结果后。再叠加技巧不会提升效果
- 这是一个让大家理解 Prompt 编写技巧的小教程,所以采用了同一个任务方便对比,但是有些复杂技巧适合与更难的任务,只有在更难的任务上才能看出差异
Reference
- 思维线索(Thread of Thought,ThoT)
- Chain of Note,CoN
- Chain of Verification,CoVe
- Emotion Prompt
- Expert Prompting
从这些论文中可以看出,提示策略在减少RAG应用中的幻觉方面起到了关键作用。
- 首先,ThoT(思维线索)通过细致的上下文理解和CoN(链式注释)强大的注释生成功能,解决了混乱上下文和无关数据检索的难题。
- 其次,CoVe(链式验证)引入了系统验证机制,通过迭代改进提高了回答的正确性。
- 而Emotion Prompt则利用情感刺激,不断提升LLM的性能,尤其是在大型模型中表现出色。
- 最后,Expert Prompting通过其身份切换技巧,展示了更高的回答质量,并在性能上超越了ChatGPT。
这些策略不仅增强了LLM的理解和处理能力,还为未来的研究和应用提供了新的视角和方法。
 1199


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


