前端迎新风口!从界面交互到智能Agent,能力升级就在眼前!

地图打印与 GeoTIFF 导出:框选区域、矢量标绘、一键出图 空间智能实验室 Vol.19:地图打印与 GeoTIFF 导出:框选区域、矢量标绘、一键出图 「把这块区域导成一张带地理坐标的高清图」是个很朴素的需求,但朴素不等于简单。你要在浏览器里框一个框、画几个箭头标个文字、叠一层 阅读详情

过去几年,前端开发一直在变化。

从 jQuery 到 Vue、React,从页面切图到工程化,从组件库到低代码,从移动端适配到跨端框架。每一次变化,看起来都是“又要学新东西”,但本质上,前端一直在做同一件事:

把复杂的系统能力,变成普通用户能理解、能操作、能完成任务的产品体验。

所以当 Agent 开始出现时,很多前端同学第一反应是:这是不是又一个新概念?是不是后端、算法、Python 工程师更有优势?前端是不是只能做个聊天窗口?

我的判断刚好相反。

Agent 开发不是前端的边缘机会,而是前端能力的一次升级。它不是让前端放弃原来的经验,而是把过去做页面、做交互、做产品体验的能力,延伸到“帮用户完成任务”的层面。

以前我们做的是界面。

现在要做的是:一个能理解目标、能调用工具、能处理流程、能反馈结果的智能系统。

这件事,前端其实很适合切进去。


一、先说清楚:Agent 开发到底在开发什么?

很多人一听 Agent,就容易想到一个“会聊天的机器人”。

但真正的 Agent 开发,不只是接一个大模型接口,然后把用户输入丢进去,再把回答展示出来。

更准确地说,Agent 是一个围绕目标工作的执行系统。它通常包含几部分:

  • 能理解用户想做什么
  • 能拆解任务步骤
  • 能调用外部工具,比如搜索、数据库、文件、接口、浏览器、代码仓库
  • 能根据执行结果继续判断下一步
  • 能把过程和结果以用户能接受的方式呈现出来

举个简单例子。

用户不是说:“帮我解释一下这个报错。”

而是说:“帮我定位这个线上问题,看看是不是最近一次发布导致的。”

一个普通聊天机器人可能会给你一段排查建议。

一个 Agent 则可能会继续做这些事:

  1. 读取错误日志
  2. 查看最近发布记录
  3. 对比相关代码变更
  4. 找到可疑提交
  5. 总结原因
  6. 给出修复建议
  7. 必要时生成补丁或创建工单

这才是 Agent 的关键:它不是只回答问题,而是参与完成任务。

从这个角度看,Agent 开发并不神秘。它依然是工程开发,只是开发对象从“页面流程”变成了“任务流程”。


二、前端为什么适合转 Agent 开发?

很多前端同学低估了自己的优势。

做 Agent,当然需要理解模型、接口、上下文、工具调用、服务端能力,但这并不意味着前端没有位置。相反,前端过去积累的很多能力,在 Agent 产品里非常关键。

1. 前端最懂“用户意图”和“交互路径”

前端长期面对的是用户。

一个按钮放哪里,表单怎么拆,错误提示怎么写,加载状态怎么处理,空状态怎么引导,这些看似细碎的经验,本质上都在训练一件事:

理解用户在什么场景下,需要什么反馈。

Agent 产品也是一样。

用户输入一句话,背后可能有真实目标,也可能表达得很模糊。Agent 什么时候直接执行,什么时候追问,什么时候提示风险,什么时候给出多个选项,这些都不是模型自己能完全解决的。

它需要产品判断,也需要交互设计,更需要工程实现。

这正是前端擅长的地方。

2. 前端熟悉状态管理,而 Agent 本质上也是状态机

前端做复杂应用,经常要处理状态:

  • 当前页面状态
  • 表单状态
  • 请求状态
  • 权限状态
  • 异常状态
  • 多步骤流程状态

Agent 也有状态。

它要知道当前任务进行到哪一步,已经调用了哪些工具,用户之前说过什么,哪些信息可信,哪些结果需要确认,哪些操作不能直接执行。

如果把 Agent 看成一个“会调用大模型的任务状态机”,前端同学会更容易理解它。

过去我们管理的是 UI 状态,现在要管理的是任务状态、上下文状态和执行状态。

思路并没有断,只是层级变高了。

3. 前端更容易做出“可用”的 Agent 产品

很多 Agent Demo 看起来很厉害,但真正给用户用的时候,问题不少:

  • 不知道它正在做什么
  • 等待时间太长,没有过程反馈
  • 失败后只丢一句报错
  • 调用了什么工具不透明
  • 用户无法中断、修改或确认
  • 最终结果很长,但没有重点

这些问题不是模型能力问题,而是产品体验问题。

前端在这方面有天然敏感度。

一个好用的 Agent,不应该只是一个输入框加一段回复。它可能需要任务进度、步骤卡片、引用来源、操作确认、结果预览、错误恢复、人工接管。

这些都是前端可以发挥价值的地方。

4. 前端离业务更近

很多公司里,前端经常是最了解业务流程的一批工程师。

因为页面就是业务的显性表达:订单怎么创建,审批怎么流转,权限怎么控制,数据怎么筛选,异常怎么提示,前端都接触过。

Agent 真正落地,不是写一个通用助手,而是进入具体业务场景。

比如:

  • 客服工单 Agent
  • 数据分析 Agent
  • 运营配置 Agent
  • 内部知识库 Agent
  • 代码审查 Agent
  • 报表生成 Agent
  • 流程审批 Agent

这些场景都需要理解业务流程。前端如果能把业务理解、交互经验和 Agent 能力结合起来,会比只懂模型调用的人更容易做出可落地的东西。


三、前端转 Agent 开发,不是从零开始

很多人一想到转型,就觉得要重新学一整套东西。

其实不必。

前端转 Agent 开发,更像是在原有能力上补几块短板。

你原来会写 React、Vue、TypeScript,会调接口,会处理状态,会做工程化,会关注用户体验,这些都还在。

要补的是:

  • 大模型的基本工作方式
  • Prompt 和上下文管理
  • 工具调用机制
  • 服务端开发能力
  • 数据存储和检索能力
  • Agent 工作流设计
  • 基础的 Python 或 Node 后端能力

不需要一开始就冲进复杂论文,也不需要上来就训练模型。大多数业务里的 Agent 开发,本质上还是应用层工程。

更直白一点:

你不是去造大模型,而是学会把大模型接进业务系统里,让它稳定、可控、可用。


四、需要补哪些知识?

下面这些内容,建议按优先级来学。

1. 先理解大模型的使用方式

不需要先研究模型结构,但要理解几个基本概念:

  • Token 是什么
  • 上下文窗口是什么
  • System Prompt、User Prompt、Assistant Message 分别做什么
  • Temperature、Top P 这类参数大概影响什么
  • 为什么模型会幻觉
  • 为什么同一个问题多问几次结果会不一样
  • 流式输出是怎么回事
  • 多轮对话为什么需要历史消息

这些概念会直接影响你设计 Agent。

比如上下文窗口有限,就不能把所有历史记录一股脑塞进去;模型可能幻觉,就要让它引用来源;模型输出不稳定,就要用结构化输出、校验和重试来兜底。

2. 学会写 Prompt,但不要迷信 Prompt

Prompt 很重要,但它不是魔法。

一个好的 Prompt,通常不是一句“你是一个专业的某某专家”,而是要说明:

  • 角色是什么
  • 目标是什么
  • 可以使用哪些信息
  • 输出格式是什么
  • 遇到不确定情况怎么办
  • 哪些事情不能做
  • 判断标准是什么

不过,真正做 Agent 时,不能把所有希望都压在 Prompt 上。

能用代码约束的,就不要只靠 Prompt 约束;能用数据校验的,就不要只相信模型输出;需要权限控制的,就不要让模型自由决定。

Prompt 是方向盘,不是安全带。

3. 掌握工具调用

工具调用是 Agent 和普通聊天机器人的分水岭。

没有工具调用,模型只能“说”。有了工具调用,模型才能“做”。

工具可以是:

  • 调用业务 API
  • 查询数据库
  • 读取文件
  • 搜索知识库
  • 操作浏览器
  • 创建工单
  • 发送通知
  • 执行代码

前端同学可以把工具调用理解成另一种接口编排。

以前是用户点按钮,前端调用接口。

现在是用户表达目标,Agent 判断该调用哪个工具,再把结果继续交给模型或展示给用户。

这里最重要的不是“能不能调”,而是“能不能安全地调”。

比如删除数据、发消息、改配置、提交代码这类操作,一定要有确认机制、权限校验和审计记录。

4. 补服务端能力

前端转 Agent 开发,服务端能力是绕不开的。

原因很简单:Agent 往往要处理密钥、权限、数据库、任务队列、文件、第三方接口,这些不适合都放在浏览器里。

如果你以前只写前端,建议至少补这些内容:

  • HTTP 接口设计
  • Node.js 服务端开发
  • 鉴权和权限控制
  • 数据库基础
  • 日志和错误处理
  • 队列和异步任务
  • 文件上传、解析和存储
  • 环境变量和密钥管理

语言上,前端同学可以先从 Node.js / TypeScript 入手,因为迁移成本最低。

如果后续要做更多 AI 工程生态,比如 LangChain、LlamaIndex、数据处理、模型评估,也可以补 Python。

5. 学一点 RAG 和向量检索

很多业务 Agent 都离不开企业内部知识。

比如产品文档、接口文档、历史工单、会议纪要、规范制度、代码说明。如果只是把这些资料直接塞给模型,很快就会遇到上下文限制。

这时就需要 RAG,也就是检索增强生成。

简单说,它的流程是:

  1. 把文档切成片段
  2. 转成向量
  3. 存到向量数据库
  4. 用户提问时先检索相关内容
  5. 把检索结果交给模型生成回答

前端不需要一开始就把向量数据库研究得很深,但要理解这个流程。因为很多 Agent 的质量,不是差在模型,而是差在知识检索和上下文组织。

6. 学会设计 Agent 工作流

真实业务里,Agent 很少是“一问一答”就结束。

它经常需要流程:

  • 收集信息
  • 判断意图
  • 检索资料
  • 调用工具
  • 等待用户确认
  • 执行操作
  • 生成结果
  • 保存记录

这些流程可以用代码写,也可以用工作流框架做。

但不管用什么工具,核心都是把任务拆清楚。

不要一上来就让模型“全权处理”。更稳的方式是:

  • 哪些步骤由代码控制
  • 哪些步骤交给模型判断
  • 哪些步骤必须用户确认
  • 哪些步骤失败后可以重试
  • 哪些步骤要留下日志

Agent 不是越自由越好。越接近真实业务,越需要边界。


五、需要学哪些语言?

前端转 Agent 开发,不需要同时学很多语言。

建议按这个顺序来。

第一阶段:继续用 TypeScript

这是最现实的选择。

你已经熟悉 TypeScript,就可以先用它做:

  • 前端交互界面
  • Node.js 后端接口
  • 大模型 API 调用
  • 工具调用封装
  • 流式输出
  • 简单 Agent 工作流

用熟悉的语言进入新领域,能减少很多不必要的挫败感。

第二阶段:补 Python

Python 在 AI 工程生态里仍然很重要。

你不一定要一开始就写得很深入,但至少要能看懂和改动:

  • 数据处理脚本
  • 文档解析脚本
  • RAG 示例代码
  • LangChain / LlamaIndex 相关代码
  • 简单的 FastAPI 服务
  • 模型评估脚本

如果你未来想更深入 AI 应用工程,Python 基本绕不开。

第三阶段:了解 SQL

很多 Agent 最终都要和业务数据打交道。

不会 SQL,很容易停留在“调用模型”的层面;会 SQL,才能把 Agent 接到真实业务里。

至少要掌握:

  • 基础查询
  • 多表关联
  • 聚合统计
  • 索引基本概念
  • 数据权限意识
  • 避免直接让模型拼 SQL 执行

尤其最后一点很重要。

让模型直接生成 SQL 并执行,风险很高。更稳妥的方式是给它受控的数据查询工具,或者只允许读取经过权限和范围限制的数据。


六、可以怎么开始?一条比较稳的路径

前端转 Agent 开发,不建议一开始就做很大的系统。

更好的方式是从小场景开始,把链路跑通。

第一步:做一个带流式输出的 AI 对话页面

先熟悉最基本的模型调用。

重点不是页面多漂亮,而是搞清楚:

  • 前端如何发起请求
  • 服务端如何调用模型
  • 如何做流式返回
  • 如何处理中断
  • 如何展示生成过程
  • 如何保存对话记录

这个阶段做完,你会知道 AI 产品的基本交互是什么样。

第二步:加入结构化输出

不要只让模型返回一段自然语言。

可以让它返回固定 JSON,比如:

  • 用户意图
  • 任务类型
  • 置信度
  • 需要追问的问题
  • 下一步动作

然后用代码去消费这个结果。

这一步很关键,因为 Agent 开发不能完全依赖自由文本。结构化输出越稳定,后面的工具调用和流程控制越容易做。

第三步:接入一个真实工具

选一个低风险工具,比如:

  • 查询天气
  • 查询内部文档
  • 搜索知识库
  • 查询某个接口数据
  • 读取一份本地文件

让模型判断什么时候调用工具,工具返回结果后,再让模型总结给用户。

这时你就已经从聊天机器人进入 Agent 的门槛了。

第四步:做一个垂直场景 Agent

不要做“大而全助手”。

选择一个具体场景,比如:

  • 前端报错排查助手
  • 项目文档问答助手
  • 需求拆解助手
  • 接口联调助手
  • 代码 Review 辅助助手
  • 周报生成助手

垂直场景更容易做出价值,也更容易控制质量。

第五步:补上权限、日志和确认机制

如果 Agent 会调用真实业务系统,就必须加工程边界。

至少要有:

  • 用户身份识别
  • 工具调用权限
  • 高风险操作二次确认
  • 调用日志
  • 错误兜底
  • 结果可追溯

这一步决定它是 Demo,还是能进业务系统的产品。


七、前端转 Agent 开发,最容易踩的几个坑

1. 把 Agent 做成“万能助手”

万能助手听起来很酷,但落地最难。

因为它什么都想做,最后往往什么都做不稳。

更好的方式是先做窄场景:目标明确、数据明确、工具明确、评价标准明确。

Agent 不怕小,怕没有边界。

2. 只关注模型,不关注系统

很多人做 Agent,第一反应是换更强的模型。

模型当然重要,但系统同样重要。

上下文怎么组织,工具怎么设计,结果怎么校验,失败怎么恢复,用户怎么确认,这些往往比模型参数更影响体验。

一个普通模型加上好的工程设计,可能比一个强模型加上混乱流程更好用。

3. 让模型直接决定高风险操作

比如删除数据、修改配置、发送消息、提交代码、付款审批,这些都不能让模型直接执行。

模型可以建议,可以生成方案,可以准备参数,但最终执行前要有规则、权限和确认。

Agent 的能力越强,边界越重要。

4. 忽视评估

传统前端功能好不好,打开页面点一遍基本能知道。

Agent 不一样。

同一个问题,模型可能每次回答都不同。你需要准备一些测试用例,反复看它在不同问题下表现是否稳定。

比如:

  • 回答是否引用了正确资料
  • 工具是否调用正确
  • 不知道时会不会承认不知道
  • 有没有编造不存在的信息
  • 高风险操作有没有要求确认
  • 输出格式是否稳定

没有评估,就很难持续改进。


八、前端原有能力不会过时,但需要升级

有些同学担心 Agent 出现后,前端会不会不重要。

我觉得不会。

只是前端的价值会从“把页面做出来”,逐渐变成“把智能能力变成可用产品”。

页面仍然重要,但页面不再是全部。

以后很多产品的核心交互,可能不再是菜单、表格和表单,而是对话、任务、卡片、步骤、确认、自动执行和人工接管。

这不是前端价值变小,而是前端要处理的问题更复杂了。

过去前端连接的是用户和接口。

未来前端连接的是用户、模型、工具、数据和业务流程。

这对前端的要求更高,但机会也更大。


最后唠两句

为什么AI大模型成为越来越多程序员转行就业、升职加薪的首选

很简单,这些岗位缺人且高薪

智联招聘的最新数据给出了最直观的印证:2025年2月,AI领域求职人数同比增幅突破200% ,远超其他行业平均水平;整个人工智能行业的求职增速达到33.4%,位居各行业榜首,其中人工智能工程师岗位的求职热度更是飙升69.6%。

AI产业的快速扩张,也让人才供需矛盾愈发突出。麦肯锡报告明确预测,到2030年中国AI专业人才需求将达600万人,人才缺口可能高达400万人,这一缺口不仅存在于核心技术领域,更蔓延至产业应用的各个环节。

那0基础普通人如何学习大模型 ?

深耕科技一线十二载,亲历技术浪潮变迁。我见证那些率先拥抱AI的同行,如何建立起效率与薪资的代际优势。如今,我将积累的大模型面试真题、独家资料、技术报告与实战路线系统整理,分享于此,为你扫清学习困惑,共赴AI时代新程。

我整理出这套 AI 大模型突围资料包【允许白嫖】:

  • ✅从入门到精通的全套视频教程
  • ✅AI大模型学习路线图(0基础到项目实战仅需90天)
  • ✅大模型书籍与技术文档PDF
  • ✅各大厂大模型面试题目详解
  • ✅640套AI大模型报告合集
  • ✅大模型入门实战训练

这份完整版的大模型 AI 学习和面试资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

①从入门到精通的全套视频教程

包含提示词工程、RAG、Agent等技术点

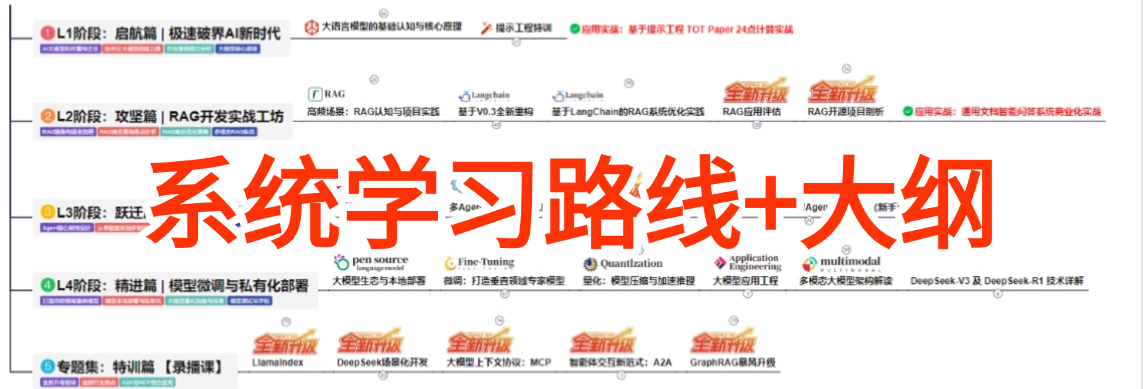
② AI大模型学习路线图(0基础到项目实战仅需90天)

全过程AI大模型学习路线
③学习电子书籍和技术文档

市面上的大模型书籍确实太多了,这些是我精选出来的
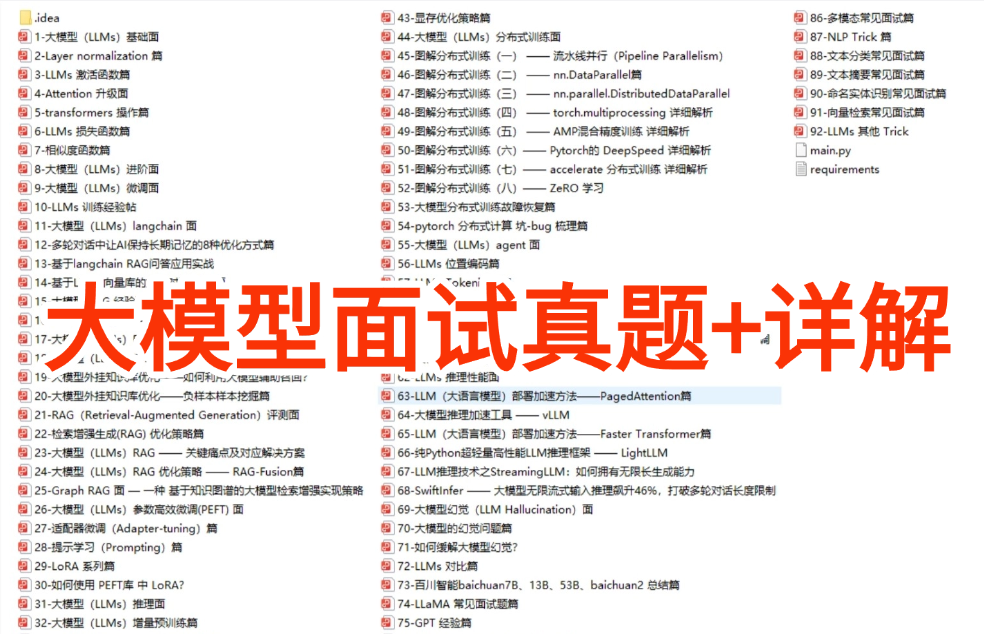
④各大厂大模型面试题目详解
⑤640套AI大模型报告合集
⑥大模型入门实战训练
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!

应届毕业生‌:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能 ‌突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

👉获取方式:
有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓

在这里插入图片描述

Wireshark抓包实战:5个CTF比赛中高频出现的流量分析技巧(附真实案例) 本文分享了Wireshark在CTF比赛和实战渗透中的五个核心流量分析技巧。内容涵盖从宏观统计概览锁定可疑目标、深度解析ICMP与HTTP等协议、追踪重组完整会话流,到利用字符串搜索和命令行工具进行自动化分析。掌握这些高阶技巧能显著提升分析海量网络流量的效率与精准度。 阅读详情

相关推荐

数字电路复位信号设计(异步复位、同步释放)笔记详解

复位信号设计(异步复位、同步释放)笔记详解 1 时序设计 1.1 复位信号设计(异步复位、同步释放) 1.1.0 复位恢复时间和清除时间 首先解释一下恢复时间(recovery time)和清除时间(removal time):(以复位信号低电平有效为例) 复位恢复时间(recovery time):撤销复位时,复位信号无效到时钟有效沿来临之间需要维持的最小的时间,类似于同步时钟的建立时间setup time; 复位清除时间(removal time):复位时,在时钟有效沿来临之后复位信号还需要保持复位

weixin_42294124的博客 1万+

Jackson 序列化 / 反序列化注解 完整版笔记

Jackson 序列化 / 反序列化注解 完整版笔记

handsome_sai的博客 280

DEV-C++调试设置

       昨天用C/C++去考了CSP,结果用DEV-C++调试总是闪退,按照我的记忆打开了调试参数,迷迷糊糊搞了一通,还是没办法调试,难受了几个小时。所以今天痛下决心,一定要写下DEV-C++设置调试的过程,警示自己! 解决步骤 1.打开DevC++找到上方工具栏 2.点击选择编译选项,再按下图所示设置即可

懒羊羊的快乐小屋 1029

【项目推荐】基于 SpringBoot3 + Spring AI 的游泳馆管理系统:Agent + RAG + Function Calling 一次学全

它不是玩具 Demo,而是一个「业务 + AI」双主线交织的真实系统——预约业务在跑,AI 客服在旁边实时查库作答,两条线通过 Function Calling、RAG、站内消息串成一体。面试官问「你做过什么 AI 项目」时,你能从业务场景讲到架构取舍,从 RAG 切分参数讲到降级兜底——这和「我调了一下 ChatGPT 的 API」是完全不同的两个段位。项目已包含完整的建表 SQL、初始化数据、部署文档,克隆下来就能跑。获取方式:见文末说明 / 后台回复关键词获取。—— 完 ——

深耕开发,专注编程实战。分享源码解析、项目搭建、问题排查笔记,沉淀技术,持续更新。 347

众灵科技24路舵机控制器二次开发实战(1)-STM32串口指令控制详解

本文详细介绍了如何通过STM32单片机对众灵科技24路舵机控制器进行二次开发,实现串口指令控制。文章从硬件连接、通信协议解析到STM32代码实战,手把手指导开发者打通控制链路,并重点讲解了如何调用预设动作组驱动六足机器人,为后续集成传感器、无线遥控等高级功能奠定基础。

weixin_29188997的博客 484

汽车OTA安全启动:ECU双验签机制与实战排障指南

汽车OTA升级中的安全启动,本质是基于密码学的信任建立过程,其核心在于ECU上电时对固件镜像的可信验证。该机制依托硬件信任根(Secure Boot ROM),通过RSA/ECDSA等非对称算法完成签名验签,确保升级包未被篡改且来源可信。技术价值体现在防止恶意固件注入、支撑功能安全(ASIL)与信息安全(ISO/SAE 21434)合规。典型应用场景包括4S店远程升级、BMS控制器固件更新及多ECU协同启动。实践中,验签名失败往往源于证书链断裂、Flash布局错位或KeyUsage字段不匹配等底层工程细节,

weixin_29314405的博客 77

Web 版翻译者资料库

本项目是桌面版《翻译者资料库》的 Web 移植版,基于 Spring Boot 3.3、Thymeleaf、Bootstrap 5.3 与 MySQL 8.0 构建。它面向翻译写作提供资料、词汇、句库、文本工具、对照制作、查找、备份恢复及旧库迁移等功能,完整继承桌面版核心业务规则,支持一键启动与离线访问。

howard2005的专栏 144

用PyTorch复现经典:手把手教你用Double DQN训练AI玩转打砖块(附完整代码与调参心得)

本文详细介绍了如何使用PyTorch实现Double DQN算法,训练AI智能体玩转经典雅达利游戏Breakout(打砖块)。从环境配置、帧预处理到网络架构设计和经验回放机制,全面解析了强化学习在游戏AI中的应用。文章还提供了关键调参技巧和实战优化方案,帮助开发者快速掌握Double DQN的核心实现与性能优化方法。

weixin_30596165的博客 229

MCP 协议会成为前端 AI 工程的标准接口吗?

MCP(Model Context Protocol)正在成为连接 AI 模型与外部工具、数据源的一层通用协议。本文从 MCP 的核心机制出发,分析它在浏览器与前端工程中的落地边界,讨论它能否成为前端 AI 工程的标准接口,并给出当下更务实的架构选择建议。

m0_62937412的博客 358

《网络安全自学教程》- 802.1x协议

802.1x协议架构,工作原理/认证流程,认证方式,MAB认证,触发认证的三种方式,EAP报文格式,EAPOL报文格式

wangyuxiang946的博客 2万+

基于YOLOv8的违规抽烟/打电话检测系统:从数据集构建到部署实战

模型优点缺点精度高速度慢(5 FPS)SSD速度快小目标检测差YOLOv5平衡性好官方支持停止YOLOv8最新、最快、最准需要PyTorch环境YOLOv8相比前代:骨干网络升级(C2f模块)无锚框检测(Anchor-Free)动态任务对齐分配(TaskAlignedAssigner)支持分类/检测/分割/姿态估计。

YOLO 98

LangGraph 本地 build 频频翻车,最终在服务器跑通流式对话

先说结论:我本地那个,一次都没成功过。三次,三次,全挂在拉镜像上。而顺得像刚上过油。这就很像我高中那辆自行车:骑着能走,一上锁就坏。那天晚上我盯着终端里那行红字看了很久,想的不是技术方案,想的是——为什么同一个工具,可以一边让我觉得自己很行,一边让我觉得自己不太行。

人工智能AI技术 116

Google Earth Engine(GEE)——使用归一化燃烧指数 (NBR) 绘制地表烧伤严重程度图

归一化燃烧指数(Normalized Burn Ratio, NBR)是一种遥感指标,用于评估野火或烧伤地面后的植被恢复情况。NBR能增强较大范围的火灾区域,如大于200公顷。它是通过比较远红外波段 (SWIR) 和近红外波段 (NIR) 的反射率来计算的。SWIR波段测量烧伤地面的反射率,NIR波段测量没有受到烧伤影响的植被的反射率。NBR的计算公式为:NBR =(NIR-SWIR)/(NIR + SWIR)。其中,NIR为近红外波段,SWIR为短波红外波段。

此星光明博客 3464

海外平台频繁弹验证?从 DNS、WebRTC 到浏览器指纹的环境异常排查清单

在运营多地区海外平台账号时,即使代理节点通畅、TCP 握手成功,仍可能遇到频繁人机验证、地区限制、播放失败等异常。核心结论是:这类问题往往不在网络传输层,而在浏览器环境参数与网络出口之间的逻辑自洽性。本文从 DNS 泄漏、WebRTC 穿透、时区与语言匹配、Canvas/WebGL 指纹、TLS 特征五个维度,给出一份可复现的环境异常排查清单,并对比个人手动配置与工程化环境管理方案的适用边界。适用于跨境运营、多账号运维团队。

P1Browser【p1指纹浏览器】的博客 184

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

信号链电路怎么选运放?奥特四款信号链运放解析【选型参考】

在模拟电路设计中,运放作为信号链的“第一道门槛”,其微小误差往往决定了整个系统的成败。

naNa_1120的博客 191

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

智能问诊的流程

本文介绍基于FastAPI构建的医疗多Agent系统MediAgent,通过症状分析、诊断推理与治疗建议等模块协同,实现从问诊到报告生成的完整工作流。系统采用前后端分离架构,结合MySQL、RabbitMQ与Docker实现工程化部署,支持异步化验结果接入。虽当前状态暂存于内存,但已具备可扩展性,未来可通过Redis持久化、消息队列联动及医疗安全机制完善,应用于慢病管理、辅助决策等场景,推动AI在医疗流程中的落地应用。

Joey 的工作空间~ 774

流式输出 SSE:实现 AI 对话打字机效果后端开发

摘要解决传统 HTTP 请求在 LLM 长文本生成时导致的客户端长时间阻塞与 TTFT 极高的问题。适用于需为 AI 应用提供打字机效果、优化交互体验的后端开发工程师。读完可获得基于 FastAPI 与 SSE(Server-Sent Events)技术的流式响应实现代码、协议规范及生产环境避坑指南。关键词SSE、流式输出、FastAPI、打字机效果、TTFT、大模型推理背景与问题大模型(LLM)生成完整回复通常耗时数秒至数十秒,传统请求-响应模型导致用户界面长时间无响应,体验极差。

2402_85729970的博客 183

基于 YOLOv8 的森林火灾检测系统(Web 版)

本项目面向林区早期火情识别场景,使用YOLOv8完成火焰(Fire)与烟雾(Smoke)两类目标的检测模型训练,并以FastAPI构建 Web 检测平台,把模型能力封装为可直接登录使用的系统。平台除常规的图片、批量、视频、摄像头检测外,还提供同图多权重对比、数据集浏览与标注核对、模型热切换,以及把训练搬到网页上的能力:可在浏览器配置超参数发起真实训练,训练中在线调整学习率、查看进度与动态曲线,训练完成后下载产物或直接应用到检测。

Michael_Jay的博客 64

身份验证漏洞专题(三):持久登录、密码重置与密码修改中的凭据绑定缺陷

密码登录与双因素认证是身份验证的主干流程,但一个完整的认证体系还依赖三类辅助机制:持久登录("记住我")、密码重置、密码修改。这三类机制的共同特征是:它们同样携带或验证凭据,同样直接决定认证状态的归属,但实现时获得的防护强度往往远低于登录页面本身。攻击者绕不开登录接口时,常常可以从这些辅助入口进入。

2401_85321170的博客 632

二进制木马免杀-Python 分离免杀与 Web 挂马

二进制木马免杀-Python 分离免杀与 Web 挂马

2503_94637398的博客 268

Vue 前端开发 AI 对话页面:流式消息渲染、文件上传

关键点是不能手动设置 Content-Type 为 multipart/form-data,必须由浏览器自动生成带有 boundary 的请求头,否则后端无法解析。思路:将对象序列化为 JSON 字符串,作为 FormData 的一个普通字段(如 formData.append(‘payload’, JSON.stringify(data))),后端接收该字段后再反序列化。若上传大文件(>10MB),需实现独立的分片上传接口,在提交对话前先获取文件 id 或 url,再随文本发送引用。移除输入框的禁用态;

2402_85729970的博客 390

在Open-WebUI中提升向量化速度

让Open-WebUI AI聊天的向量化过程不超过10秒,而不是默认的20+分钟……

xyzzklk的博客 579

Writeup 4 0xGame 2021 · command (WEB)

前端限制不可信:永远不要相信前端的任何限制(如disabled按钮、JS 验证等)。攻击者可以直接构造 HTTP 数据包绕过前端校验,所有的安全限制必须在后端实现。命令执行/注入(RCE):Web 应用如果直接调用系统命令且未对输入进行严格过滤,攻击者可以利用;||等符号拼接恶意命令。绕过技巧:在 CTF 中,如果遇到命令执行被过滤,常见的绕过方式包括:${IFS}$IFS$9等。。cat /fla?或cat /fl*。Linux 基础。

hengdonghui的博客 131

使用HTML+CSS+JavaScript实现文件上传弹窗

使用HTML+CSS+JavaScript实现文件上传弹窗

bjzhang75的博客 236

ArkWeb 混合开发的内存清理与桥接陷阱

起初我以为是 H5 内部的定时器没有清理,结果接了 DevEco Studio 的 Profiler 一看,全是 ArkTS 侧的原生对象没有释放。改用 RESIZE 后,键盘弹出只会压缩窗口高度,底部的输入框会自适应滚动到可视区域,页面顶部的元素则岿然不动。综上所述,混合开发绝不是简单的拼接,管好桥接的生命周期,做好跨域兜底,才是稳定运行的前提。如果不去主动干预,它会把你的原生内存吃得连骨头都不剩。在 H5 的输入框打字时,软键盘一弹出来,整个 Web 页面就被顶得飞起,连顶部的原生导航栏都不见了。

2502_91284977的博客 235

热工测点布线改造难题?IDCB 远程 I/O 采集前端简化现场布线

IDCB智能数据采集前端基于Modbus-RTU协议,支持热电偶、热电阻、直流信号多类型混采,单设备多通道接入,减少模块选型压力。双总线冗余设计保障数据连续性,适配锅炉、窑炉等高可靠性工况。采用总线式布线替代点对点接线,大幅减少电缆用量,配合组态软件或LCD面板,实现远程监控与现场调试便捷化。适用于脱硫脱硝、就地监控及系统改造项目,具备抗干扰、隔离保护、掉电存参等特性,有效提升热工测点采集系统的稳定性与运维效率。

wxyzzdh200988的博客 192

Web用例管理:维护步骤、定位器与版本

和。漏掉引用校验的后果是:删掉一个还在被 3 条用例使用的定位器,平台不报错,等到某天跑用例才报「元素找不到」。漏掉版本关联的后果是:上周那条通过的运行记录,这周改了用例之后再打开,已经没法说明当时到底跑的是什么。这篇把整条链路走通并给出可运行代码:用例的三段结构、动作白名单、引用反查、用例版本号、运行快照、版本差异。环境:本机 Windows / Python 3.11.8 / Playwright 1.62.0 / Chromium 151.0.7922.34。测试页面/steps。

weixin_62798930的博客 212
上一篇: 从纯前端到AI Agent高薪转型!我踩过的3个坑+4条血泪建议,纯干货分享!
下一篇: 后端转Agent进腾讯?别只学框架了!这5个能力才是王道!
智泊AI官方
博客等级 码龄6年 8638粉丝 2667原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值