


0 一些基础术语
- 大模型:一般指1亿以上参数的模型,但是这个标准一直在升级,目前万亿参数以上的模型也有了。大语言模型(Large Language Model,LLM)是针对语言的大模型。
- 175B、60B、540B等:这些一般指参数的个数,B是Billion/十亿的意思,175B是1750亿参数,这是ChatGPT大约的参数规模。
- 强化学习:(Reinforcement Learning)一种机器学习的方法,通过从外部获得激励来校正学习方向从而获得一种自适应的学习能力。
- 基于人工反馈的强化学习(RLHF):(Reinforcement Learning from Human Feedback)构建人类反馈数据集,训练一个激励模型,模仿人类偏好对结果打分,这是GPT-3后时代大语言模型越来越像人类对话核心技术。
- 涌现:(Emergence)或称创发、突现、呈展、演生,是一种现象。许多小实体相互作用后产生了大实体,而这个大实体展现了组成它的小实体所不具有的特性。研究发现,模型规模达到一定阈值以上后,会在多步算术、大学考试、单词释义等场景的准确性显著提升,称为涌现。
- 泛化:(Generalization)模型泛化是指一些模型可以应用(泛化)到其他场景,通常为采用迁移学习、微调等手段实现泛化。
- 微调:(FineTuning)针对大量数据训练出来的预训练模型,后期采用业务相关数据进一步训练原先模型的相关部分,得到准确度更高的模型,或者更好的泛化。
- 指令微调:(Instruction FineTuning),针对已经存在的预训练模型,给出额外的指令或者标注数据集来提升模型的性能。
- 思维链:(Chain-of-Thought,CoT)。通过让大语言模型(LLM)将一个问题拆解为多个步骤,一步一步分析,逐步得出正确答案。需指出,针对复杂问题,LLM直接给出错误答案的概率比较高。思维链可以看成是一种指令微调。
1 大模型(LLMs)基础
1.1 目前 主流的开源模型体系 有哪些?
LLM,从模型架构上主要分为三种:Only-encoder, Only-Decoder, Encoder-Decoder三种模型架构
Only-encoder:例如bertBERT(Bidirectional Encoder Representations from Transformers):由Google发布的一种基于Transformer架构的双向预训练语言模型。BERT模型通过在大规模无标签文本上进行预训练,然后在下游任务上进行微调,具有强大的语言理解能力和表征能力。
RoBERTa:由Facebook发布的一种基于Transformer架构的预训练语言模型。RoBERTa模型在BERT的基础上进行了改进,通过更大规模的数据和更长的训练时间,取得了更好的性能。Only-Decoder:例如GPT
GPT(Generative Pre-trained Transformer)系列:由OpenAI发布的一系列基于Transformer架构的语言模型,包括GPT、GPT-2、GPT-3等。GPT模型通过在大规模无标签文本上进行预训练,然后在特定任务上进行微调,具有很强的生成能力和语言理解能力。
Encoder-Decoder:例如T5
T5(Text-to-Text Transfer Transformer):由Google发布的一种基于Transformer架构的多任务预训练语言模型。T5模型通过在大规模数据集上进行预训练,可以用于多种自然语言处理任务,如文本分类、机器翻译、问答等。
Casual LM:
XLNet:由CMU和Google Brain发布的一种基于Transformer架构的自回归预训练语言模型。XLNet模型通过自回归方式预训练,可以建模全局依赖关系,具有更好的语言建模能力和生成能力。
prefix LM:ChatGLM-6B
causal LM:LLaMA-7B
1.2 prefix Decoder 和 causal Decoder 和 Encoder-Decoder 区别是什么?
Prefix LM(前缀语言模型)和Causal LM(因果语言模型)是两种不同类型的语言模型,它们的区别在于生成文本的方式和训练目标。
Prefix LM:前缀语言模型是一种生成模型,它在生成每个词时都可以考虑之前的上下文信息。在生成时,前缀语言模型会根据给定的前缀(即部分文本序列)预测下一个可能的词。这种模型可以用于文本生成、机器翻译等任务。
Causal LM:因果语言模型是一种自回归模型,它只能根据之前的文本生成后续的文本,而不能根据后续的文本生成之前的文本。在训练时,因果语言模型的目标是预测下一个词的概率,给定之前的所有词作为上下文。这种模型可以用于文本生成、语言建模等任务。
总结来说,前缀语言模型可以根据给定的前缀生成后续的文本,而因果语言模型只能根据之前的文本生成后续的文本。它们的训练目标和生成方式略有不同,适用于不同的任务和应用场景。
前缀解码器(prefix decoder):前缀解码器结构修正了因果编码器的掩码机制,以使其能可对前缀标记执行双向注意力,并仅对生成的标记执行单向注意力。这样,与encoder-decoder类似,可以双向编码前缀序列并自回归低逐个预测输出标记,其中在编码和解码阶段共享相同的参数。现在前缀编码器的大模型包括U-PaLM、GLM-130B等。
因果解码器(causal decoder,当前主流):因果解码器架构采用单向注意力掩码,以确保每个输入标记只能关注过去的标记和它本身。输入和输出标记通过解码器以相同的方式进行处理。
chatGPT等
因果编码器:GPT,BLOOM,Gopher等。编码器-解码器(encoder-decoder):传统 Transformer 模型是建立在编码器-解码器架构上的 ,由两个 Transformer 块分别作为编码器和解码器。编码器采用堆叠的多头自注意层对输入序列进行编码以生成其潜在表示,而解码器对这些表示进行交叉注意并自回归地生成目标序列。目前,只有少数大语言模型是基于编码器-解码器架构构建的例如 Flan-T5。
相同:都是大模型注意力的decoder关注encoder的方式
不同点:关注的方式不同。attention mask不同,prefix和encoder的prefix部分和encoder的token互相能看到,后者严格遵守只有后面的token才能看到前面的token的规则。

1.3 大模型LLM的 训练目标 是什么?
大型语言模型(Large Language Model)是指通过训练大规模的数据集(通常是海量的文本数据)来生成具有语言理解和生成能力的人工智能模型。这些模型的目标是理解人类语言的含义、语法和语境,并能够生成与之相符合的连贯文本。
大型语言模型通常使用深度学习模型(如 Transformer 模型)来对输入文本进行建模和预测。这些模型通过预训练和微调的方式来提高其语言理解和生成的能力。预训练阶段通过大规模的无监督学习来学习语言的统计规律和潜在的语义,微调阶段则通过特定的监督学习任务(如问答、翻译等)来进一步提高模型的性能和适应性。
大型语言模型已广泛应用于自然语言处理领域,如机器翻译、文本摘要、对话系统等。它们可以帮助生成自然、连贯的文本,回答问题,提供建议等。然而,由于这些模型需要大量的计算资源和数据来训练和推断,因此在实际应用中,需要权衡性能和成本之间的平衡。
1.4 涌现能力是啥原因?
涌现:(Emergence)或称创发、突现、呈展、演生,是一种现象。许多小实体相互作用后产生了大实体,而这个大实体展现了组成它的小实体所不具有的特性。研究发现,模型规模达到一定阈值以上后,会在多步算术、大学考试、单词释义等场景的准确性显著提升,称为涌现。
大语言模型(LLM)的原始训练目标是为了生成自然、连贯的文本,因为其本身接受了大量的文本进行预训练,所以根据提示补全和创造文本这其实只是模型的原生能力。在原生能力范畴下,LLM模型具备文本创造能力,如写小说、新闻、诗歌。然而,仅仅能进行文本创造,并不足以让大语言模型掀起新的一轮技术革命,引爆这一轮技术革命的真正原因是:大语言模型的涌现能力。
针对这些在小模型上没有出现,但是在大模型上出现的不可预测的能力,就被称为涌现能力。大型语言模型具有从原始训练数据中自动学习并发现新的、更高层次的特征和模式的能力。这些特征和模式可能与文本分析无关,或者超出了模型的设计目标。涌现能力可以让LLM在没有额外训练或微调的情况下,完成一些之前无法完成或者很难完成的任务。
大模型的涌现能力主要是由以下几个原因造成的:
数据量的增加:随着互联网的发展和数字化信息的爆炸增长,可用于训练模型的数据量大大增加。更多的数据可以提供更丰富、更广泛的语言知识和语境,使得模型能够更好地理解和生成文本。
计算能力的提升:随着计算硬件的发展,特别是图形处理器(GPU)和专用的AI芯片(如TPU)的出现,计算能力大幅提升。这使得训练更大、更复杂的模型成为可能,从而提高了模型的性能和涌现能力。
模型架构的改进:近年来,一些新的模型架构被引入,如Transformer,它在处理序列数据上表现出色。这些新的架构通过引入自注意力机制等技术,使得模型能够更好地捕捉长距离的依赖关系和语言结构,提高了模型的表达能力和生成能力。
预训练和微调的方法:预训练和微调是一种有效的训练策略,可以在大规模无标签数据上进行预训练,然后在特定任务上进行微调。这种方法可以使模型从大规模数据中学习到更丰富的语言知识和语义理解,从而提高模型的涌现能力。
综上所述,大模型的涌现能力是由数据量的增加、计算能力的提升、模型架构的改进以及预训练和微调等因素共同作用的结果。这些因素的进步使得大模型能够更好地理解和生成文本,为自然语言处理领域带来了显著的进展。
LLM的涌现能力主要包含以下几个方面:
- In Context Learning(“Few-Shot Prompt”),即用户给出几个例子,LLM不需要调整模型参数,就能够处理好任务。例如,用户给出几个情感计算的例子,LLM就能够根据文本判断情感倾向。
- Augmented Prompting Strategies,即用户使用一些特殊的手段来引导或激发LLM的涌现能力。例如,用户使用多步推理(chain-of-thought prompting)来让LLM进行复杂的逻辑推理;用户使用指令(instructions)来描述任务,而不使用少量示例(few-shot exemplars)来让LLM进行指令跟随(instruction following);用户使用程序语言(programming language)来让LLM进行程序执行(program execution)。
- Zero-Shot or Few-Shot Learning,即LLM能够在没有任何或极少量的训练数据的情况下,解决一些从未见过或者很少见过的问题。例如,LLM能够根据表情符号解码电影名;LLM能够模拟Linux计算机终端并执行一些简单的数学计算程序。
LLM的涌现能力的激活方法主要有以下几种(提示工程和微调):
- 增加模型的规模,即增加模型中参数的数量和复杂度。这可以让模型更好地建立单词之间的联系,更接近人类语言的水平。一般来说,模型规模越大,涌现能力越强。
- 增加数据的规模,即增加模型训练所用的文本数据的数量和质量。这可以让模型学习到更多的知识和信息,更全面地覆盖各种领域和场景。一般来说,数据规模越大,涌现能力越广。
- 改进模型的架构和训练方法,即使用更先进和有效的神经网络结构和优化算法来构建和训练模型。这可以让模型更灵活和高效地处理各种任务和问题。一般来说,模型架构和训练方法越优秀,涌现能力越稳定。
- 使用合适的提示(prompt)和反馈(feedback),即根据任务和问题的特点,设计合理和有效的输入输出格式和内容,以及及时和准确的评估指标和反馈机制。这可以让模型更容易和准确地理解用户的意图和需求,并给出满意的回答。一般来说,提示和反馈越合适,涌现能力越明显。
一直在更新,更多的大模型学习和面试资料已经上传带到优快云的官方了,有需要的朋友可以扫描下方二维码免费领取【保证100%免费】👇👇
1.5 为何现在的大模型大部分是Decoder only结构?
LLM之所以主要都用Decoder-only架构,除了训练效率和工程实现上的优势外,在理论上是因为Encoder的双向注意力会存在低秩问题,这可能会削弱模型表达能力,就生成任务而言,引入双向注意力并无实质好处。而Encoder-Decoder架构之所以能够在某些场景下表现更好,大概只是因为它多了一倍参数。所以,在同等参数量、同等推理成本下,Decoder-only架构就是最优选择了。
众所周知,Attention矩阵一般是由一个低秩分解的矩阵加softmax而来,具体来说是一个 n × d 的矩阵与 d × n 的矩阵相乘后再加softmax(n ≫ d ),这种形式的Attention的矩阵因为低秩问题而带来表达能力的下降,具体分析可以参考《Attention is Not All You Need: Pure Attention Loses Rank Doubly Exponentially with Depth》。而Decoder-only架构的Attention矩阵是一个下三角阵,注意三角阵的行列式等于它对角线元素之积,由于softmax的存在,对角线必然都是正数,所以它的行列式必然是正数,即Decoder-only架构的Attention矩阵一定是满秩的!满秩意味着理论上有更强的表达能力,也就是说,Decoder-only架构的Attention矩阵在理论上具有更强的表达能力,改为双向注意力反而会变得不足。
详细参考链接:
1.6 简单 介绍一下 大模型【LLMs】?
LLM(Large Language Model,大型语言模型)是指基于大规模数据和参数量的语言模型。具体的架构可以有多种选择,以下是一种常见的大模型LLM的架构介绍:
Transformer架构:大模型LLM常使用Transformer架构,它是一种基于自注意力机制的序列模型。Transformer架构由多个编码器层和解码器层组成,每个层都包含多头自注意力机制和前馈神经网络。这种架构可以捕捉长距离的依赖关系和语言结构,适用于处理大规模语言数据。
自注意力机制(Self-Attention):自注意力机制是Transformer架构的核心组件之一。它允许模型在生成每个词时,根据输入序列中的其他词来计算该词的表示。自注意力机制能够动态地为每个词分配不同的权重,从而更好地捕捉上下文信息。
多头注意力(Multi-Head Attention):多头注意力是自注意力机制的一种扩展形式。它将自注意力机制应用多次,每次使用不同的权重矩阵进行计算,得到多个注意力头。多头注意力可以提供更丰富的上下文表示,增强模型的表达能力。
前馈神经网络(Feed-Forward Network):在Transformer架构中,每个注意力层后面都有一个前馈神经网络。前馈神经网络由两个全连接层组成,通过非线性激活函数(如ReLU)进行变换。它可以对注意力层输出的表示进行进一步的映射和调整。
预训练和微调:大模型LLM通常采用预训练和微调的方法进行训练。预训练阶段使用大规模无标签数据,通过自监督学习等方法进行训练,使模型学习到丰富的语言知识。微调阶段使用有标签的特定任务数据,如文本生成、机器翻译等,通过有监督学习进行模型的微调和优化。
需要注意的是,大模型LLM的具体架构可能会因不同的研究和应用而有所不同。上述介绍的是一种常见的架构,但实际应用中可能会有一些变体或改进。
1.7大模型【LLMs】后面跟的 175B、60B、540B等 指什么?
175B、60B、540B等:这些一般指参数的个数,B是Billion/十亿的意思,175B是1750亿参数,这是ChatGPT大约的参数规模。
1.8 大模型【LLMs】具有什么优点?
1.9 大模型【LLMs】具有什么缺点?
DeepMind众多学者综合了计算机科学、语言学和社会科学的专业知识和文献,确定了大规模语言模型应用的21种风险,这些风险分为六个大类:歧视、负面言论;信息危害;错误信息危害;信息的恶意使用;人机交互危害,以及环境和社会经济的危害。在讨论每一种风险时,又区分了“现已观察到的”风险和“预期的”风险。对于已经在LLMs中观察到的风险,讨论了导致危害的因果机制、相关证据和风险的缓解方法。对于尚未产生但基于对自然语言处理技术的评估认为其可能存在的风险,在前瞻性、风险评估和缓解方面,进行阐释,以期让LLMs的提供者做出负责任的决策。
详细请参考:大规模语言模型 (LLMs) 的六大风险分析
2 大模型(LLMs)进阶
2.1 LLMs 复读机问题
2.1.1 什么是 LLMs 复读机问题?
LLMs复读机问题指的是大型语言模型(LLMs)在生成文本时出现的一种现象,即模型倾向于无限地复制输入的文本或者以过度频繁的方式重复相同的句子或短语。这种现象使得模型的输出缺乏多样性和创造性,给用户带来了不好的体验。
2.1.2 为什么会出现 LLMs 复读机问题?
- 数据偏差:大型语言模型通常是通过预训练阶段使用大规模无标签数据进行训练的。如果训练数据中存在大量的重复文本或者某些特定的句子或短语出现频率较高,模型在生成文本时可能会倾向于复制这些常见的模式。
- 训练目标的限制:大型语言模型的训练通常是基于自监督学习的方法,通过预测下一个词或掩盖词来学习语言模型。这样的训练目标可能使得模型更倾向于生成与输入相似的文本,导致复读机问题的出现。
- 缺乏多样性的训练数据:虽然大型语言模型可以处理大规模的数据,但如果训练数据中缺乏多样性的语言表达和语境,模型可能无法学习到足够的多样性和创造性,导致复读机问题的出现。
2.1.3 如何缓解 LLMs 复读机问题?
- 多样性训练数据:在训练阶段,尽量使用多样性的语料库来训练模型,避免数据偏差和重复文本的问题。
- 引入噪声:在生成文本时,可以引入一些随机性或噪声,例如通过采样不同的词或短语,或者引入随机的变换操作,以增加生成文本的多样性。
- 温度参数调整:温度参数是用来控制生成文本的多样性的一个参数。通过调整温度参数的值,可以控制生成文本的独创性和多样性,从而减少复读机问题的出现。
- 后处理和过滤:对生成的文本进行后处理和过滤,去除重复的句子或短语,以提高生成文本的质量和多样性。
- Beam搜索调整:在生成文本时,可以调整Beam搜索算法的参数。Beam搜索是一种常用的生成策略,它在生成过程中维护了一个候选序列的集合。通过调整Beam大小和搜索宽度,可以控制生成文本的多样性和创造性。
- 后处理和过滤:对生成的文本进行后处理和过滤,去除重复的句子或短语,以提高生成文本的质量和多样性。可以使用文本相似度计算方法或规则来检测和去除重复的文本。
- 人工干预和控制:对于关键任务或敏感场景,可以引入人工干预和控制机制,对生成的文本进行审查和筛选,确保生成结果的准确性和多样性。
需要注意的是,缓解LLMs复读机问题是一个复杂的任务,没有一种通用的解决方案。不同的方法可能适用于不同的场景和任务,需要根据具体情况进行选择和调整。此外,解决复读机问题还需要综合考虑数据、训练目标、模型架构和生成策略等多个因素,需要进一步的研究和实践来提高大型语言模型的生成文本多样性和创造性。
2.2 llama 系列问题
2.2.1 llama 输入句子长度理论上可以无限长吗?
这里引用苏神(RoPE作者)在群里的回复。
限制在训练数据。理论上rope的llama可以处理无限长度,但问题是太长了效果不好啊,没训练过的长度效果通常不好。而想办法让没训练过的长度效果好,这个问题就叫做“长度外推性”问题。
所以接受2k的长度限制吧。
理论上来说,LLMs(大型语言模型)可以处理任意长度的输入句子,但实际上存在一些限制和挑战。下面是一些相关的考虑因素:
1.计算资源:生成长句子需要更多的计算资源,包括内存和计算时间。由于LLMs通常是基于神经网络的模型,计算长句子可能会导致内存不足或计算时间过长的问题。
2. 模型训练和推理:训练和推理长句子可能会面临一些挑战。在训练阶段,处理长句子可能会导致梯度消失或梯度爆炸的问题,影响模型的收敛性和训练效果。在推理阶段,生成长句子可能会增加模型的错误率和生成时间。
3. 上下文建模:LLMs是基于上下文建模的模型,长句子的上下文可能会更加复杂和深层。模型需要能够捕捉长句子中的语义和语法结构,以生成准确和连贯的文本。尽管存在这些挑战,研究人员和工程师们已经在不断努力改进和优化LLMs,以处理更长的句子。例如,可以采用分块的方式处理长句子,将其分成多个较短的片段进行处理。此外,还可以通过增加计算资源、优化模型结构和参数设置,以及使用更高效的推理算法来提高LLMs处理长句子的能力。
值得注意的是,实际应用中,长句子的处理可能还受到应用场景、任务需求和资源限制等因素的影响。因此,在使用LLMs处理长句子时,需要综合考虑这些因素,并根据具体情况进行选择和调整。
2.2.1 什么情况用Bert模型,什么情况用LLaMA、ChatGLM类大模型,咋选?
选择使用哪种大模型,如Bert、LLaMA或ChatGLM,取决于具体的应用场景和需求。下面是一些指导原则:
- Bert模型:Bert是一种预训练的语言模型,适用于各种自然语言处理任务,如文本分类、命名实体识别、语义相似度计算等。如果你的任务是通用的文本处理任务,而不依赖于特定领域的知识或语言风格,Bert模型通常是一个不错的选择。
- LLaMA模型:LLaMA(Language Model for the Medical Domain)是专门针对医学领域的预训练语言模型。如果你的应用场景涉及医学领域,例如医学文本的理解、医学问答系统等,LLaMA模型可能更适合,因为它在医学领域的知识和术语上进行了专门的训练。
- ChatGLM模型:ChatGLM是一个面向对话生成的语言模型,适用于构建聊天机器人、智能客服等对话系统。如果你的应用场景需要模型能够生成连贯、流畅的对话回复,并且需要处理对话上下文、生成多轮对话等,ChatGLM模型可能是一个较好的选择。
在选择模型时,还需要考虑以下因素:
- 数据可用性:不同模型可能需要不同类型和规模的数据进行训练。确保你有足够的数据来训练和微调所选择的模型。
- 计算资源:大模型通常需要更多的计算资源和存储空间。确保你有足够的硬件资源来支持所选择的模型的训练和推理。
- 预训练和微调:大模型通常需要进行预训练和微调才能适应特定任务和领域。了解所选择模型的预训练和微调过程,并确保你有相应的数据和时间来完成这些步骤。
最佳选择取决于具体的应用需求和限制条件。在做出决策之前,建议先进行一些实验和评估,以确定哪种模型最适合你的应用场景。
2.2.2 各个专业领域是否需要各自的大模型来服务?
各个专业领域通常需要各自的大模型来服务,原因如下:
- 领域特定知识:不同领域拥有各自特定的知识和术语,需要针对该领域进行训练的大模型才能更好地理解和处理相关文本。例如,在医学领域,需要训练具有医学知识的大模型,以更准确地理解和生成医学文本。
- 语言风格和惯用语:各个领域通常有自己独特的语言风格和惯用语,这些特点对于模型的训练和生成都很重要。专门针对某个领域进行训练的大模型可以更好地掌握该领域的语言特点,生成更符合该领域要求的文本。
- 领域需求的差异:不同领域对于文本处理的需求也有所差异。例如,金融领域可能更关注数字和统计数据的处理,而法律领域可能更关注法律条款和案例的解析。因此,为了更好地满足不同领域的需求,需要专门针对各个领域进行训练的大模型。
- 数据稀缺性:某些领域的数据可能相对较少,无法充分训练通用的大模型。针对特定领域进行训练的大模型可以更好地利用该领域的数据,提高模型的性能和效果。
尽管需要各自的大模型来服务不同领域,但也可以共享一些通用的模型和技术。例如,通用的大模型可以用于处理通用的文本任务,而领域特定的模型可以在通用模型的基础上进行微调和定制,以适应特定领域的需求。这样可以在满足领域需求的同时,减少模型的重复训练和资源消耗
2.2.3 如何让大模型处理更长的文本?
- 分块处理:将长文本分割成较短的片段,然后逐个片段输入模型进行处理。这样可以避免长文本对模型内存和计算资源的压力。在处理分块文本时,可以使用重叠的方式,即将相邻片段的一部分重叠,以保持上下文的连贯性。
- 层次建模:通过引入层次结构,将长文本划分为更小的单元。例如,可以将文本分为段落、句子或子句等层次,然后逐层输入模型进行处理。这样可以减少每个单元的长度,提高模型处理长文本的能力。
- 部分生成:如果只需要模型生成文本的一部分,而不是整个文本,可以只输入部分文本作为上下文,然后让模型生成所需的部分。例如,输入前一部分文本,让模型生成后续的内容。
- 注意力机制:注意力机制可以帮助模型关注输入中的重要部分,可以用于处理长文本时的上下文建模。通过引入注意力机制,模型可以更好地捕捉长文本中的关键信息。
- 模型结构优化:通过优化模型结构和参数设置,可以提高模型处理长文本的能力。例如,可以增加模型的层数或参数量,以增加模型的表达能力。还可以使用更高效的模型架构,如Transformer等,以提高长文本的处理效率。
需要注意的是,处理长文本时还需考虑计算资源和时间的限制。较长的文本可能需要更多的内存和计算时间,因此在实际应用中需要根据具体情况进行权衡和调整。
6 大模型(LLMs)推理
6.1 大模型(LLMs)推理面
6.1.1 为什么大模型推理时显存涨的那么多还一直占着?
大语言模型进行推理时,显存涨得很多且一直占着显存不释放的原因主要有以下几点:
- 模型参数占用显存:大语言模型通常具有巨大的参数量,这些参数需要存储在显存中以供推理使用。因此,在推理过程中,模型参数会占用相当大的显存空间。
- 输入数据占用显存:进行推理时,需要将输入数据加载到显存中。对于大语言模型而言,输入数据通常也会占用较大的显存空间,尤其是对于较长的文本输入。
- 中间计算结果占用显存:在推理过程中,模型会进行一系列的计算操作,生成中间结果。这些中间结果也需要存储在显存中,以便后续计算使用。对于大语言模型而言,中间计算结果可能会占用较多的显存空间。
- 内存管理策略:某些深度学习框架在推理时采用了一种延迟释放显存的策略,即显存不会立即释放,而是保留一段时间以备后续使用。这种策略可以减少显存的分配和释放频率,提高推理效率,但也会导致显存一直占用的现象。
需要注意的是,显存的占用情况可能会受到硬件设备、深度学习框架和模型实现的影响。不同的环境和设置可能会导致显存占用的差异。如果显存占用过多导致资源不足或性能下降,可以考虑调整模型的批量大小、优化显存分配策略或使用更高性能的硬件设备来解决问题
6.1.2 大模型在gpu和cpu上推理速度如何?
大语言模型在GPU和CPU上进行推理的速度存在显著差异。一般情况下,GPU在进行深度学习推理任务时具有更高的计算性能,因此大语言模型在GPU上的推理速度通常会比在CPU上更快。
以下是GPU和CPU在大语言模型推理速度方面的一些特点:
GPU推理速度快:GPU具有大量的并行计算单元,可以同时处理多个计算任务。对于大语言模型而言,GPU可以更高效地执行矩阵运算和神经网络计算,从而加速推理过程。
CPU推理速度相对较慢:相较于GPU,CPU的计算能力较弱,主要用于通用计算任务。虽然CPU也可以执行大语言模型的推理任务,但由于计算能力有限,推理速度通常会较慢。
使用GPU加速推理:为了充分利用GPU的计算能力,通常会使用深度学习框架提供的GPU加速功能,如CUDA或OpenCL。这些加速库可以将计算任务分配给GPU并利用其并行计算能力,从而加快大语言模型的推理速度。
需要注意的是,推理速度还受到模型大小、输入数据大小、计算操作的复杂度以及硬件设备的性能等因素的影响。因此,具体的推理速度会因具体情况而异。一般来说,使用GPU进行大语言模型的推理可以获得更快的速度。
6.1.3 推理速度上,int8和fp16比起来怎么样?
在大语言模型的推理速度上,使用INT8(8位整数量化)和FP16(半精度浮点数)相对于FP32(单精度浮点数)可以带来一定的加速效果。这是因为INT8和FP16的数据类型在表示数据时所需的内存和计算资源较少,从而可以加快推理速度。
具体来说,INT8在相同的内存空间下可以存储更多的数据,从而可以在相同的计算资源下进行更多的并行计算。这可以提高每秒推理操作数(Operations Per Second,OPS)的数量,加速推理速度。
FP16在相对较小的数据范围内进行计算,因此在相同的计算资源下可以执行更多的计算操作。虽然FP16的精度相对较低,但对于某些应用场景,如图像处理和语音识别等,FP16的精度已经足够满足需求。
需要注意的是,INT8和FP16的加速效果可能会受到硬件设备的支持程度和具体实现的影响。某些硬件设备可能对INT8和FP16有更好的优化支持,从而进一步提高推理速度。
综上所述,使用INT8和FP16数据类型可以在大语言模型的推理过程中提高推理速度,但需要根据具体场景和硬件设备的支持情况进行评估和选择。
6.1.4 大模型有推理能力吗?
是的,大语言模型具备推理能力。推理是指在训练阶段之后,使用已经训练好的模型对新的输入数据进行预测、生成或分类等任务。大语言模型可以通过输入一段文本或问题,然后生成相应的回答或补全文本。
大语言模型通常基于循环神经网络(RNN)或变种(如长短时记忆网络LSTM或门控循环单元GRU)等结构构建,通过学习大量的文本数据,模型可以捕捉到语言的规律和模式。这使得大语言模型能够对输入的文本进行理解和推理,生成合理的回答或补全。
例如,GPT(Generative Pre-trained Transformer)模型是一种大型的预训练语言模型,它通过预训练的方式学习大规模的文本数据,然后可以在推理阶段生成连贯、合理的文本。这种模型可以用于自然语言处理任务,如文本生成、机器翻译、对话系统等。
需要注意的是,大语言模型的推理能力是基于其训练数据的统计规律和模式,因此在面对新颖、复杂或特殊的输入时,可能会出现推理错误或生成不准确的结果。此外,大语言模型的推理能力也受到模型的大小、训练数据的质量和数量、推理算法等因素的影响。
6.1.5 大模型生成时的参数怎么设置?
在大语言模型进行推理时,参数设置通常包括以下几个方面:
- 模型选择:选择适合推理任务的模型,如循环神经网络(RNN)、长短时记忆网络(LSTM)、门控循环单元(GRU)或变种的Transformer等。不同的模型在推理任务上可能有不同的效果。
- 模型加载:加载预训练好的模型参数,这些参数可以是在大规模文本数据上进行预训练得到的。预训练模型的选择应根据任务和数据集的特点来确定。
- 推理算法:选择合适的推理算法,如贪婪搜索、束搜索(beam search)或采样方法等。贪婪搜索只考虑当前最有可能的输出,束搜索会考虑多个候选输出,采样方法会根据概率分布进行随机采样。
- 温度参数:在生成文本时,可以通过调整温度参数来控制生成的文本的多样性。较高的温度会增加生成文本的随机性和多样性,而较低的温度会使生成文本更加确定和一致。
- 推理长度:确定生成文本的长度限制,可以设置生成的最大长度或生成的最小长度等。
其他参数:根据具体任务和需求,可能还需要设置其他参数,如生成的起始文本、生成的批次大小等。以上参数设置需要根据具体任务和数据集的特点进行调整和优化。通常情况下,可以通过实验和调参来找到最佳的参数组合,以获得较好的推理效果。同时,还可以通过人工评估和自动评估指标来评估生成文本的质量和准确性,进一步优化参数设置。
6.2 省内存的大语言模型训练/微调/推理方法
6.2.1 有哪些省内存的大语言模型训练/微调/推理方法?
有一些方法可以帮助省内存的大语言模型训练、微调和推理,以下是一些常见的方法:
- 参数共享(Parameter Sharing):通过共享模型中的参数,可以减少内存占用。例如,可以在不同的位置共享相同的嵌入层或注意力机制。
- 梯度累积(Gradient Accumulation):在训练过程中,将多个小批次的梯度累积起来,然后进行一次参数更新。这样可以减少每个小批次的内存需求,特别适用于GPU内存较小的情况。
- 梯度裁剪(Gradient Clipping):通过限制梯度的大小,可以避免梯度爆炸的问题,从而减少内存使用。
- 分布式训练(Distributed Training):将训练过程分布到多台机器或多个设备上,可以减少单个设备的内存占用。分布式训练还可以加速训练过程。
- 量化(Quantization):将模型参数从高精度表示(如FP32)转换为低精度表示(如INT8或FP16),可以减少内存占用。量化方法可以通过减少参数位数或使用整数表示来实现。
- 剪枝(Pruning):通过去除冗余或不重要的模型参数,可以减少模型的内存占用。剪枝方法可以根据参数的重要性进行选择,从而保持模型性能的同时减少内存需求。
- 蒸馏(Knowledge Distillation):使用较小的模型(教师模型)来指导训练较大的模型(学生模型),可以从教师模型中提取知识,减少内存占用。
- 分块处理(Chunking):将输入数据或模型分成较小的块进行处理,可以减少内存需求。例如,在推理过程中,可以将较长的输入序列分成多个较短的子序列进行处理。
这些方法可以结合使用,根据具体场景和需求进行选择和调整。同时,不同的方法可能对不同的模型和任务有不同的效果,因此需要进行实验和评估。
6.2.2 如何 估算模型所需的RAM?
6.2.3 Fp16-mixed precision
6.2.4 Int8-bitsandbytes
6.2.5 LoRA
6.2.6 Gradient Checkpointing
6.2.7 Torch FSDP+CPU offload
6.3.1 如何让大模型输出合规化
要让大模型输出合规化,可以采取以下方法:
- 数据清理和预处理:在进行模型训练之前,对输入数据进行清理和预处理,以确保数据符合合规要求。这可能包括去除敏感信息、匿名化处理、数据脱敏等操作。
- 引入合规性约束:在模型训练过程中,可以引入合规性约束,以确保模型输出符合法律和道德要求。例如,可以在训练过程中使用合规性指标或损失函数来约束模型的输出。
- 限制模型访问权限:对于一些特定的应用场景,可以通过限制模型的访问权限来确保输出的合规性。只允许授权用户或特定角色访问模型,以保护敏感信息和确保合规性。
- 解释模型决策过程:为了满足合规性要求,可以对模型的决策过程进行解释和解释。通过提供透明的解释,可以使用户或相关方了解模型是如何做出决策的,并评估决策的合规性。
- 审查和验证模型:在模型训练和部署之前,进行审查和验证以确保模型的输出符合合规要求。这可能涉及到法律专业人士、伦理专家或相关领域的专业人士的参与。
- 监控和更新模型:持续监控模型的输出,并根据合规要求进行必要的更新和调整。及时发现和解决合规性问题,确保模型的输出一直保持合规。
- 合规培训和教育:为使用模型的人员提供合规培训和教育,使其了解合规要求,并正确使用模型以确保合规性。
需要注意的是,合规性要求因特定领域、应用和地区而异,因此在实施上述方法时,需要根据具体情况进行调整和定制。同时,合规性是一个动态的过程,需要与法律、伦理和社会要求的变化保持同步。
6.3.2 应用模式变更
大语言模型的应用模式变更可以包括以下几个方面:
- 任务定制化:将大语言模型应用于特定的任务或领域,通过对模型进行微调或迁移学习,使其适应特定的应用场景。例如,将大语言模型用于自动文本摘要、机器翻译、对话系统等任务。
- 个性化交互:将大语言模型应用于个性化交互,通过对用户输入进行理解和生成相应的回复,实现更自然、智能的对话体验。这可以应用于智能助手、在线客服、社交媒体等场景。
- 内容生成与创作:利用大语言模型的生成能力,将其应用于内容生成和创作领域。例如,自动生成新闻报道、创意文案、诗歌等内容,提供创作灵感和辅助创作过程。
- 情感分析与情绪识别:通过大语言模型对文本进行情感分析和情绪识别,帮助企业或个人了解用户的情感需求和反馈,以改善产品、服务和用户体验。
- 知识图谱构建:利用大语言模型的文本理解能力,将其应用于知识图谱的构建和更新。通过对海量文本进行分析和提取,生成结构化的知识表示,为知识图谱的建设提供支持。
- 法律和合规应用:大语言模型可以用于法律和合规领域,例如自动生成法律文件、合同条款、隐私政策等内容,辅助法律专业人士的工作。
- 教育和培训应用:将大语言模型应用于教育和培训领域,例如智能辅导系统、在线学习平台等,为学生提供个性化的学习辅助和教学资源。
- 创新应用场景:探索和创造全新的应用场景,结合大语言模型的能力和创新思维,开拓新的商业模式和服务方式。例如,结合增强现实技术,实现智能导览和语音交互;结合虚拟现实技术,创建沉浸式的交互体验等。
应用模式变更需要充分考虑数据安全、用户隐私、道德和法律等因素,确保在合规和可持续发展的前提下进行应用创新。同时,与领域专家和用户进行密切合作,不断优化和改进应用模式,以满足用户需求和市场竞争。
7 大模型(LLMs)预训练面
大模型(LLMs)增量预训练篇
为什么要增量预训练?
进行 增量预训练 需要做哪些准备工作?
增量预训练 所用 训练框架?
增量预训练 训练流程 是怎么样?
点击查看答案
8 大模型(LLMs)评测面
8.1 大模型怎么评测?
大语言模型的评测通常涉及以下几个方面:
- 语法和流畅度:评估模型生成的文本是否符合语法规则,并且是否流畅自然。这可以通过人工评估或自动评估指标如困惑度(perplexity)来衡量。
- 语义准确性:评估模型生成的文本是否准确传达了所需的含义,并且是否避免了歧义或模棱两可的表达。这需要通过人工评估来判断,通常需要领域专家的参与。
- 上下文一致性:评估模型在生成长篇文本时是否能够保持一致的上下文逻辑和连贯性。这需要通过人工评估来检查模型生成的文本是否与前文和后文相衔接。
- 信息准确性:评估模型生成的文本中所包含的信息是否准确和可靠。这可以通过人工评估或与已知信息进行对比来判断。
- 创造性和多样性:评估模型生成的文本是否具有创造性和多样性,是否能够提供不同的观点和表达方式。这需要通过人工评估来判断。
评测大语言模型是一个复杂的过程,需要结合人工评估和自动评估指标来进行综合评价。由于大语言模型的规模和复杂性,评测结果往往需要多个评估者的共识,并且需要考虑到评估者的主观因素和评估标准的一致性。
8.2 大模型的honest原则是如何实现的?
大语言模型的"honest"原则是指模型在生成文本时应该保持诚实和真实,不应该编造虚假信息或误导用户。实现"honest"原则可以通过以下几种方式:
- 数据训练:使用真实和可靠的数据进行模型的训练,确保模型学习到的知识和信息与真实世界相符。数据的来源和质量对于模型的"honest"性非常重要。
- 过滤和审查:在训练数据中,可以通过过滤和审查来排除不真实或不可靠的内容。这可以通过人工审核或自动筛选算法来实现,以确保训练数据的可信度。
- 监督和调整:对模型的生成结果进行监督和调整,及时发现和纠正可能的误导或虚假信息。这可以通过人工审核、用户反馈或者自动监测来实现。
- 透明度和解释性:提供模型生成文本的解释和可追溯性,使用户能够了解模型生成文本的依据和过程。这可以通过展示模型的输入数据、模型的结构和参数等方式来实现。
- 遵循道德和法律准则:确保模型的设计和使用符合道德和法律的准则,不违背伦理和法律规定。这需要在模型的开发和应用过程中考虑到社会和伦理的因素。
需要注意的是,尽管大语言模型可以尽力遵循"honest"原则,但由于其是基于训练数据进行生成,仍然存在可能生成不准确或误导性的文本。因此,用户在使用大语言模型生成的文本时,仍需保持批判性思维,并结合其他信息和验证渠道进行判断。
8.3 模型如何判断回答的知识是训练过的已知的知识,怎么训练这种能力?
大语言模型判断回答的知识是否为训练过的已知知识,通常可以通过以下几种方式来实现:
- 训练数据:在训练大语言模型时,可以使用包含已知知识的真实数据。这些数据可以来自于可靠的来源,如百科全书、学术文献等。通过训练模型时接触到这些知识,模型可以学习到一定的知识表示和模式。
- 监督学习:可以使用人工标注的数据来进行监督学习,将已知知识标注为正确答案。在训练模型时,通过最大化与标注答案的匹配程度,模型可以学习到回答问题的知识表示和模式。
- 开放域知识库:可以利用开放域知识库,如维基百科,作为额外的训练数据。通过将知识库中的信息与模型进行交互,模型可以学习到知识的表示和检索能力。
- 过滤和筛选:在训练数据中,可以通过过滤和筛选来排除不准确或不可靠的信息。这可以通过人工审核或自动筛选算法来实现,以提高模型对已知知识的准确性。
训练这种能力需要充分的训练数据和有效的训练方法。同时,还需要进行模型的评估和调优,以确保模型能够正确理解和回答已知的知识问题。此外,定期更新训练数据和模型,以跟进新的知识和信息,也是保持模型知识更新和准确性的重要步骤。
8.4 如何衡量大模型水平?
8.5 大模型评估方法 有哪些?
8.6 大模型评估工具 有哪些?
9 大模型(LLMs)agent 面
9.1 如何给LLM注入领域知识?
给LLM(低层次模型,如BERT、GPT等)注入领域知识的方法有很多。以下是一些建议:
- 数据增强:在训练过程中,可以通过添加领域相关的数据来增强模型的训练数据。这可以包括从领域相关的文本中提取示例、对现有数据进行扩充或生成新的数据。
- 迁移学习:使用预训练的LLM模型作为基础,然后在特定领域的数据上进行微调。这样可以利用预训练模型学到的通用知识,同时使其适应新领域。
- 领域专家标注:与领域专家合作,对模型的输出进行监督式标注。这可以帮助模型学习到更准确的领域知识。
- 知识图谱:将领域知识表示为知识图谱,然后让LLM模型通过学习知识图谱中的实体和关系来理解领域知识。
- 规则和启发式方法:编写领域特定的规则和启发式方法,以指导模型的学习过程。这些方法可以是基于规则的、基于案例的或基于实例的。
- 模型融合:将多个LLM模型的预测结果结合起来,以提高模型在特定领域的性能。这可以通过投票、加权平均或其他集成方法来实现。
- 元学习:训练一个元模型,使其能够在少量领域特定数据上快速适应新领域。这可以通过在线学习、模型蒸馏或其他元学习方法来实现。
- 模型解释性:使用模型解释工具(如LIME、SHAP等)来理解模型在特定领域的预测原因,从而发现潜在的知识缺失并加以补充。
- 持续学习:在模型部署后,持续收集领域特定数据并更新模型,以保持其在新数据上的性能。
多任务学习:通过同时训练模型在多个相关任务上的表现,可以提高模型在特定领域的泛化能力。
9.2 如果想要快速体验各种模型,该怎么办?
如果想要快速体验各种大语言模型,可以考虑以下几种方法:
- 使用预训练模型:许多大语言模型已经在大规模数据上进行了预训练,并提供了预训练好的模型参数。可以直接使用这些预训练模型进行推理,以快速体验模型的性能。常见的预训练模型包括GPT、BERT、XLNet等。
- 使用开源实现:许多大语言模型的开源实现已经在GitHub等平台上公开发布。可以根据自己的需求选择合适的开源实现,并使用提供的示例代码进行快速体验。这些开源实现通常包含了模型的训练和推理代码,可以直接使用。
- 使用云平台:许多云平台(如Google Cloud、Microsoft Azure、Amazon Web Services等)提供了大语言模型的服务。可以使用这些云平台提供的API或SDK来快速体验各种大语言模型。这些云平台通常提供了简单易用的接口,可以直接调用模型进行推理。
- 使用在线演示:一些大语言模型的研究团队或公司提供了在线演示平台,可以在网页上直接体验模型的效果。通过输入文本或选择预定义的任务,可以快速查看模型的输出结果。这种方式可以快速了解模型的性能和功能。
无论使用哪种方法,都可以快速体验各种大语言模型的效果。可以根据自己的需求和时间限制选择合适的方法,并根据体验结果进一步选择和优化模型。
最后
我在一线科技企业深耕十二载,见证过太多因技术卡位而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。
我整理出这套 AI 大模型突围资料包:
- ✅AI大模型学习路线图
- ✅Agent行业报告
- ✅100集大模型视频教程
- ✅大模型书籍PDF
- ✅DeepSeek教程
- ✅AI产品经理入门资料
一直在更新,更多的大模型学习和面试资料已经上传带到优快云的官方了,有需要的朋友可以扫描下方二维码免费领取【保证100%免费】👇👇
为什么说现在普通人就业/升职加薪的首选是AI大模型?
人工智能技术的爆发式增长,正以不可逆转之势重塑就业市场版图。从DeepSeek等国产大模型引发的科技圈热议,到全国两会关于AI产业发展的政策聚焦,再到招聘会上排起的长队,AI的热度已从技术领域渗透到就业市场的每一个角落。
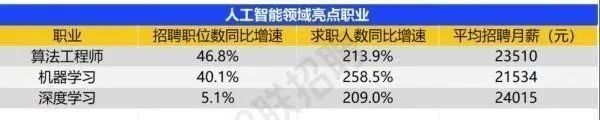
智联招聘的最新数据给出了最直观的印证:2025年2月,AI领域求职人数同比增幅突破200% ,远超其他行业平均水平;整个人工智能行业的求职增速达到33.4%,位居各行业榜首,其中人工智能工程师岗位的求职热度更是飙升69.6%。
AI产业的快速扩张,也让人才供需矛盾愈发突出。麦肯锡报告明确预测,到2030年中国AI专业人才需求将达600万人,人才缺口可能高达400万人,这一缺口不仅存在于核心技术领域,更蔓延至产业应用的各个环节。
资料包有什么?
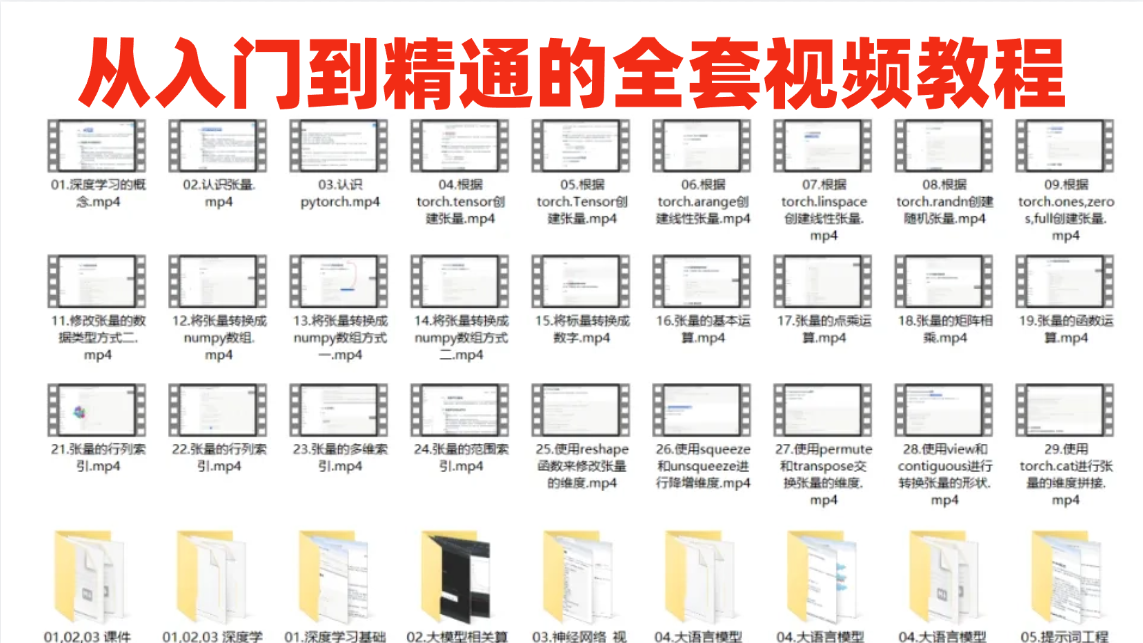
①从入门到精通的全套视频教程
包含提示词工程、RAG、Agent等技术点
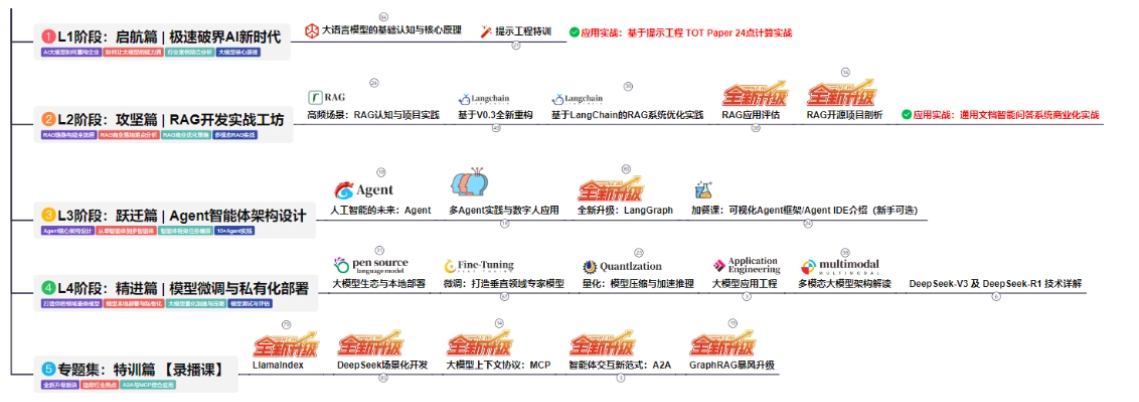
② AI大模型学习路线图(还有视频解说)
全过程AI大模型学习路线
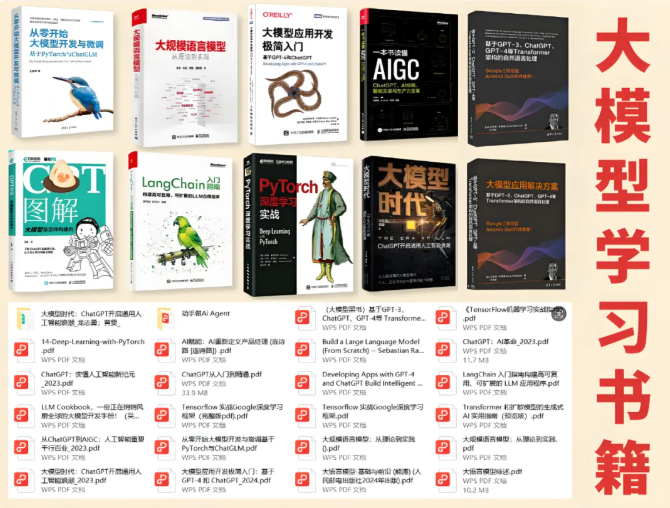
③学习电子书籍和技术文档
市面上的大模型书籍确实太多了,这些是我精选出来的
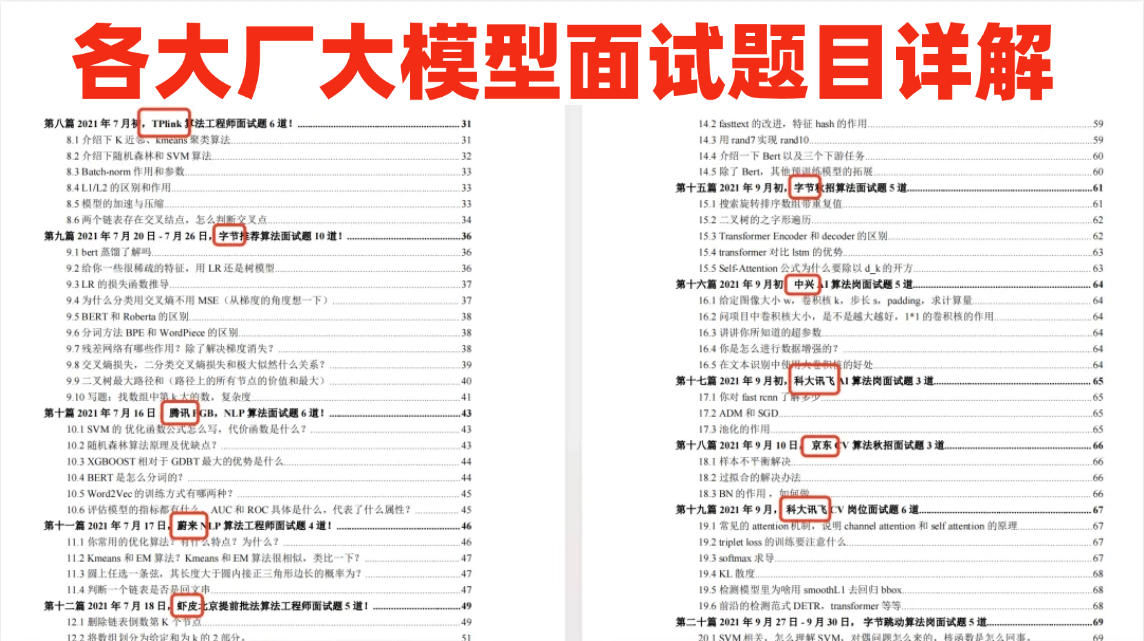
④各大厂大模型面试题目详解
⑤ 这些资料真的有用吗?
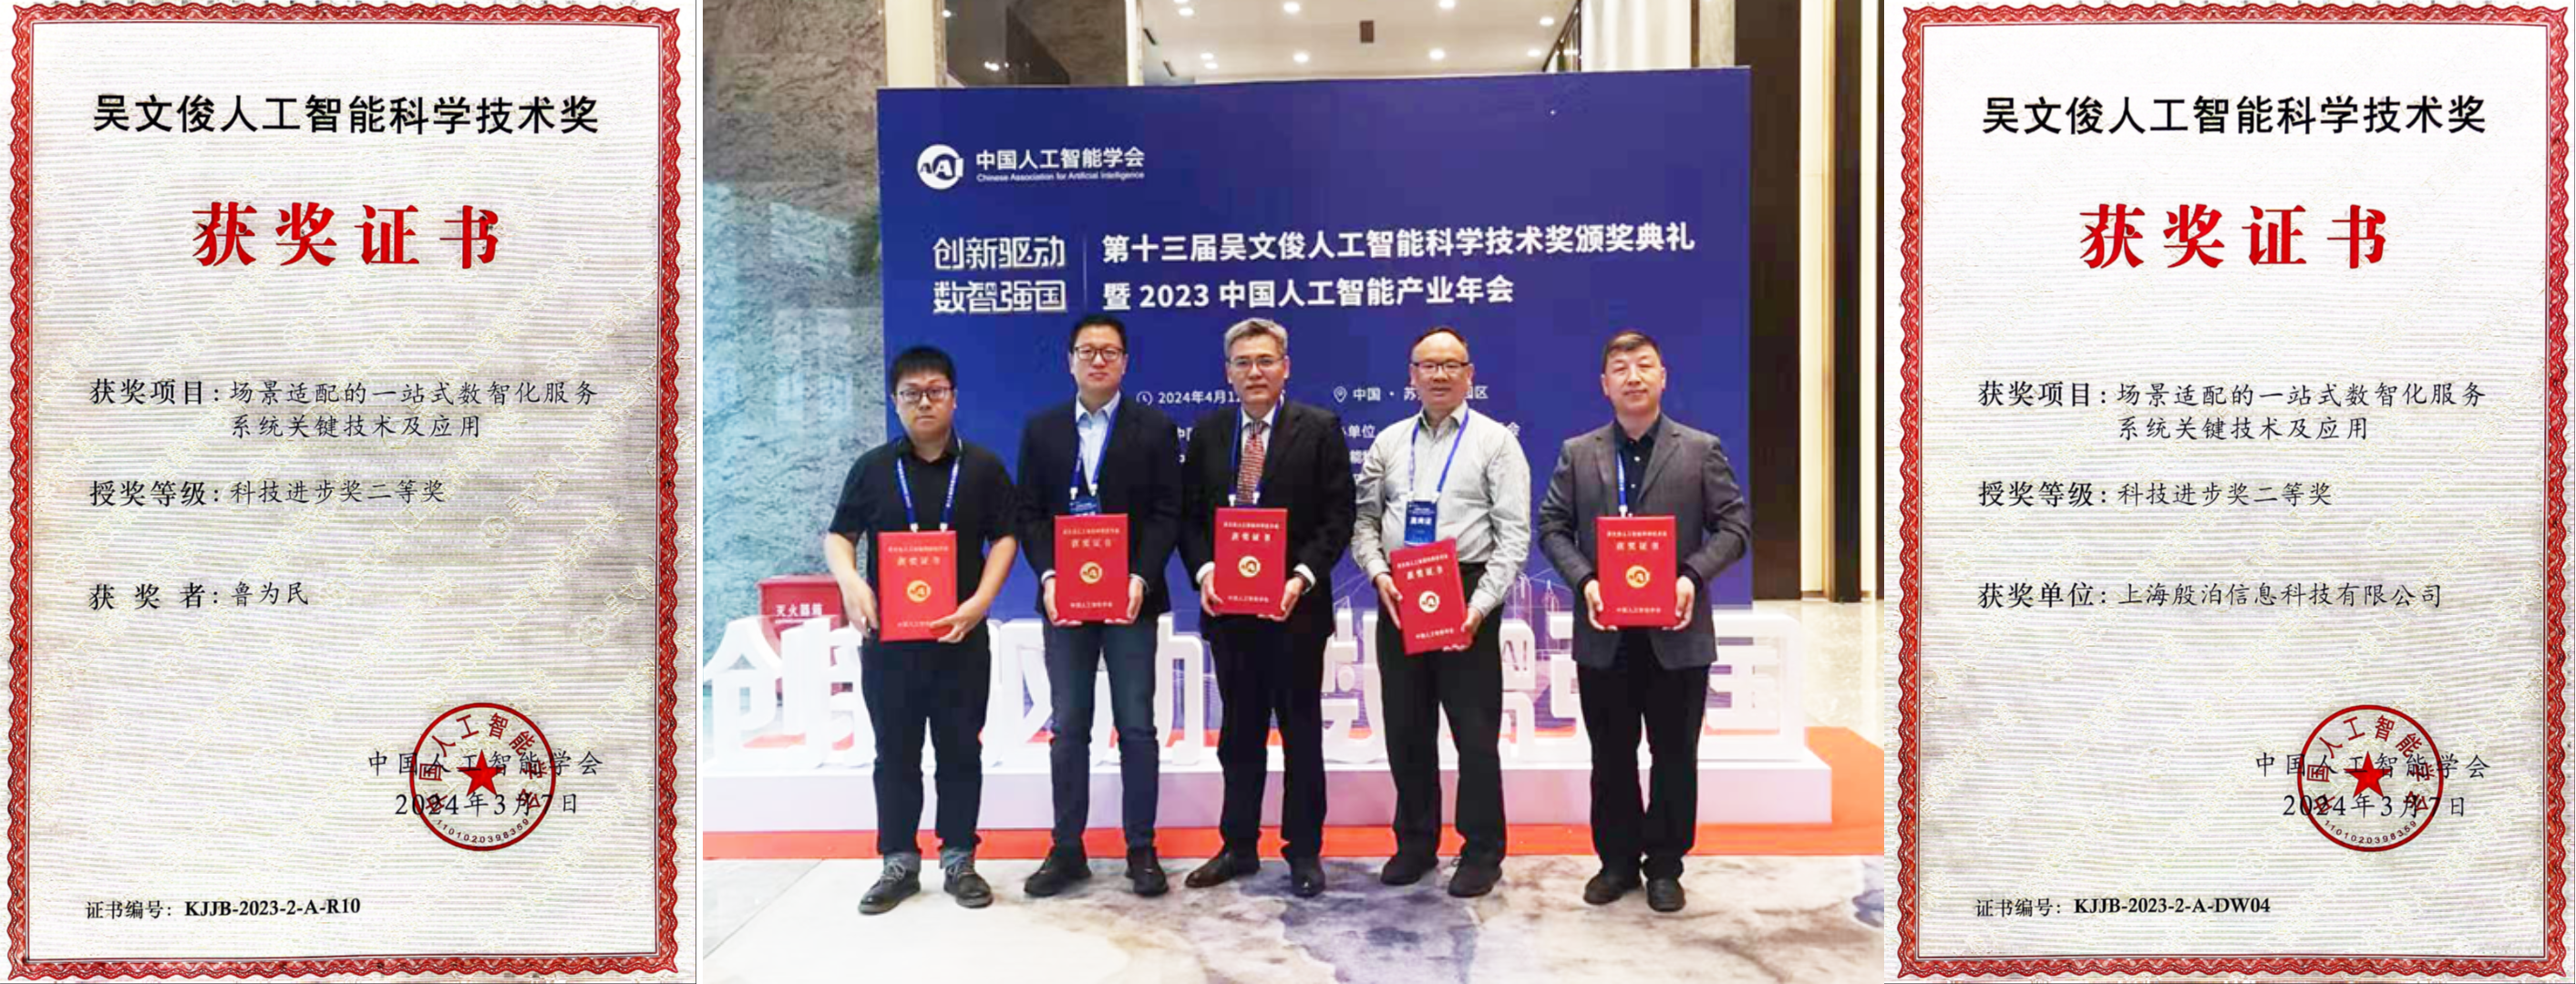
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。
所有的视频教程由智泊AI老师录制,且资料与智泊AI共享,相互补充。这份学习大礼包应该算是现在最全面的大模型学习资料了。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
智泊AI始终秉持着“让每个人平等享受到优质教育资源”的育人理念,通过动态追踪大模型开发、数据标注伦理等前沿技术趋势,构建起"前沿课程+智能实训+精准就业"的高效培养体系。
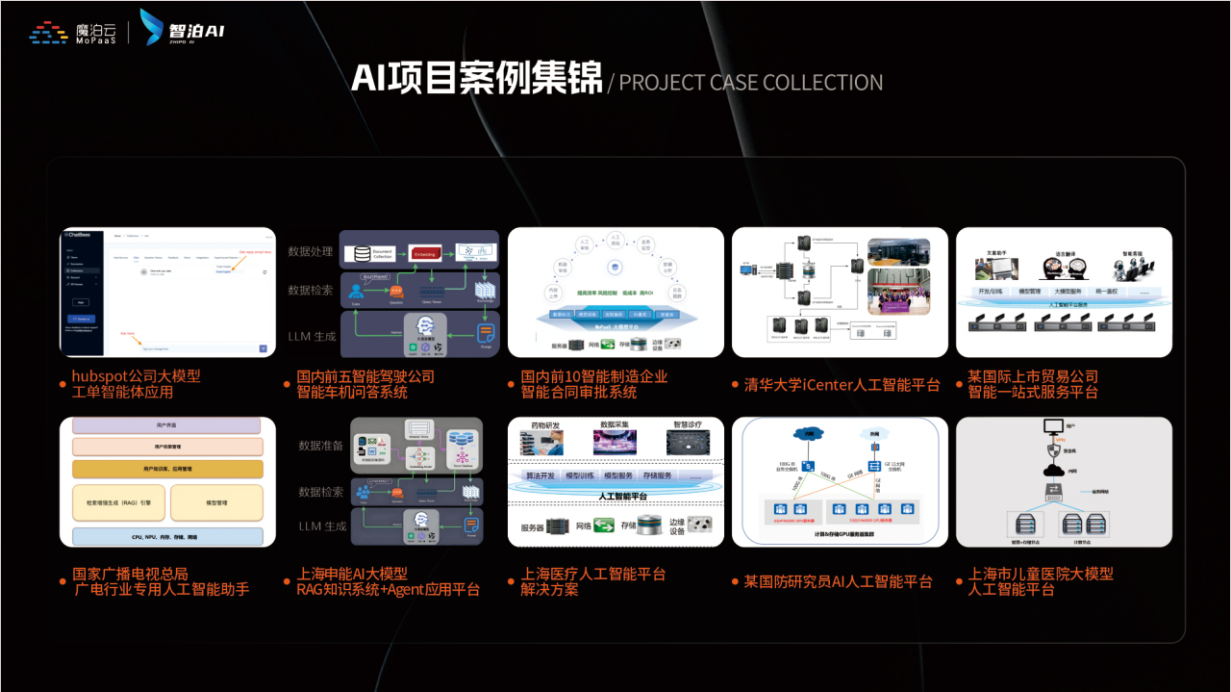
课堂上不光教理论,还带着学员做了十多个真实项目。学员要亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!
应届毕业生:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能 突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓**
 3467


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


