


在人工智能蓬勃发展的当下,大模型算法工程师已成为推动技术创新与行业变革的核心力量。想要成为一名优秀的大模型算法工程师,扎实备考是关键。下面为你详细介绍大模型算法工程师备考攻略,涵盖核心知识点、实战技巧以及备考计划。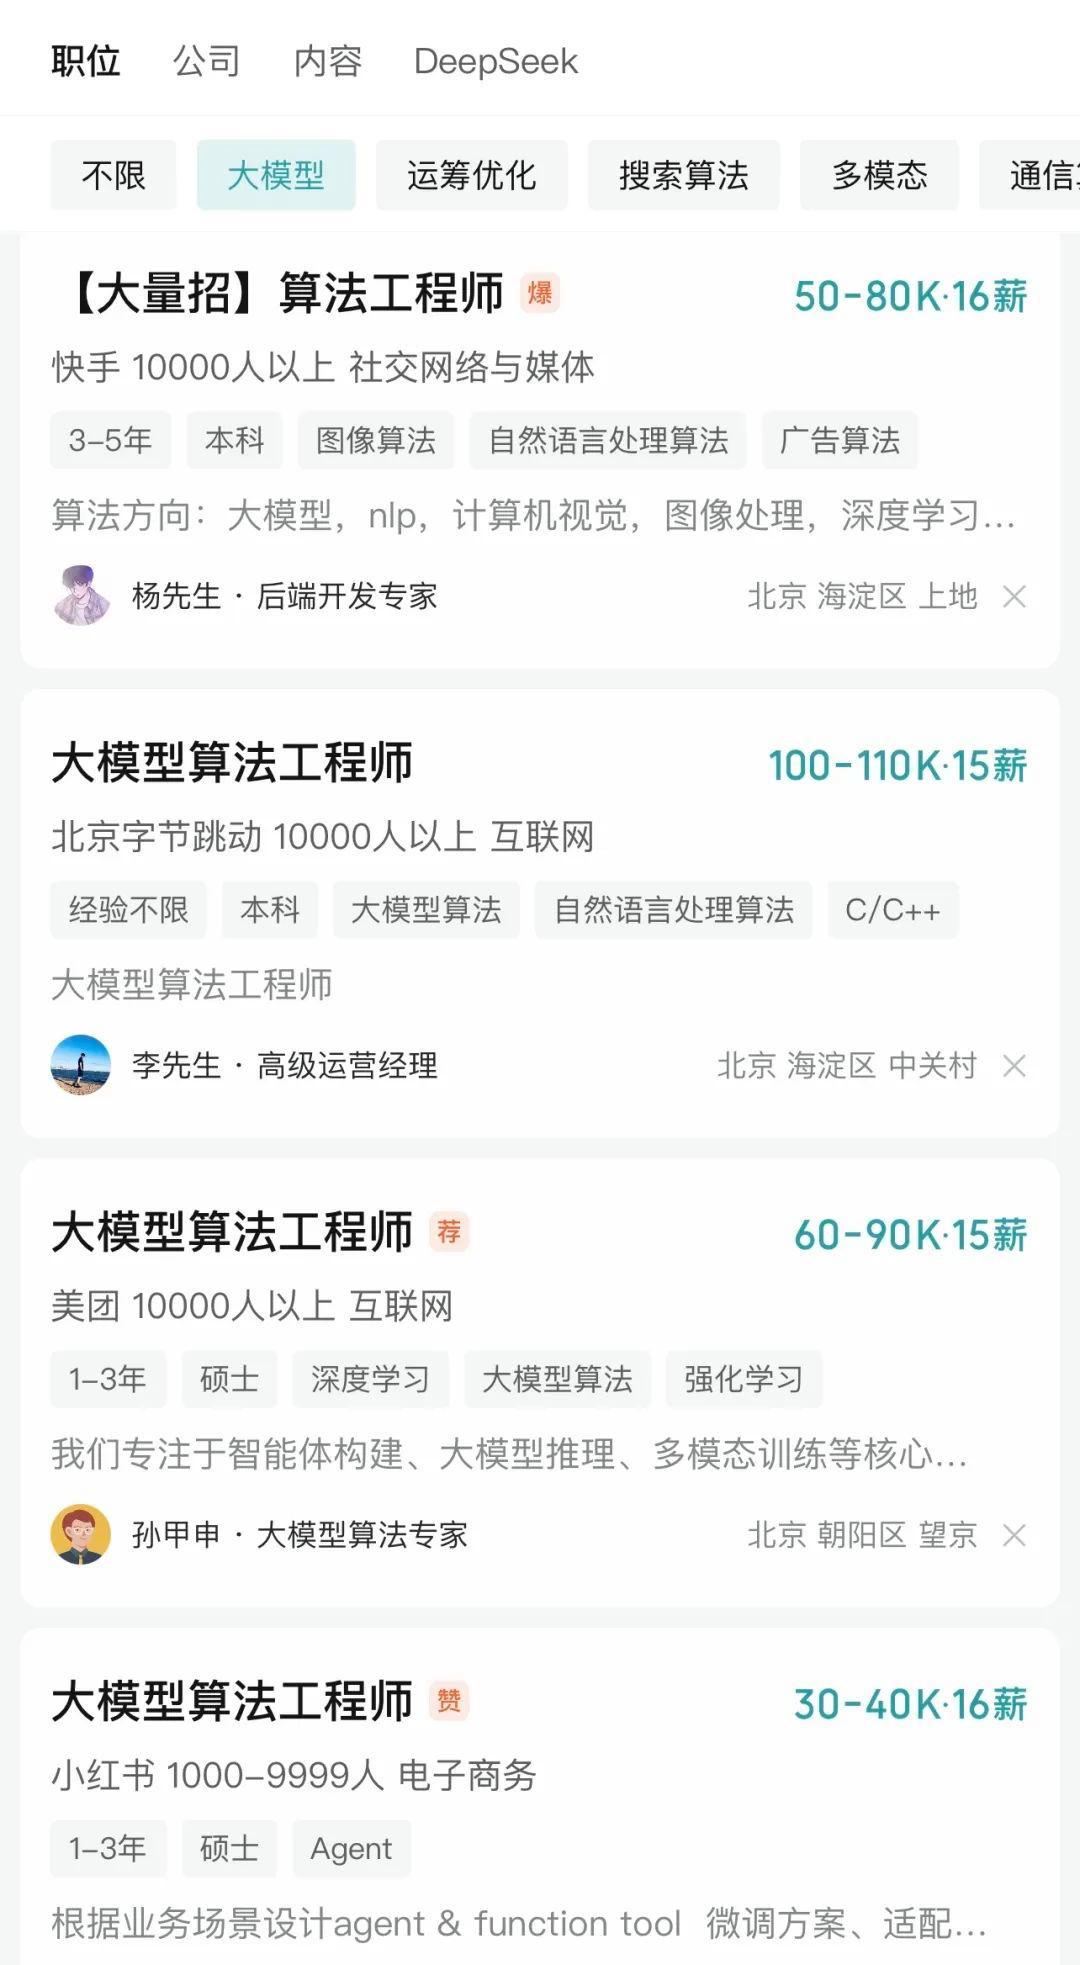
一、核心知识点
(一)数学基础
-
线性代数:是深度学习的核心数学工具。神经网络中每一层的计算都可看作矩阵运算,像矩阵乘法、加法、转置等是神经网络前向传播和反向传播的基础。特征值分解与 SVD 可用于理解数据结构和降维技术,如 PCA 降维。张量运算则用于处理高维数据表示,如图像和视频数据。例如在 LLAMA - 2 70B 模型参数压缩中,当奇异值保留率 > 95% 时,压缩比可达 4:1,显著降低计算资源需求。
-
概率论与统计学:为生成式模型提供理论基础。贝叶斯推断是构建概率图模型的基础,最大似然估计(MLE)是模型参数估计的核心方法,高斯分布是扩散模型和变分自编码器(VAE)的基础分布。语言模型本质上就是通过对大量文本的学习,预测下一个单词出现的概率,从而生成连贯文本。
-
优化理论:直接指导模型训练过程。梯度下降及其变种(SGD、Adam 等),二阶优化方法如自然梯度用于处理海量数据和参数,分布式优化算法应对大规模模型训练。损失函数 Hessian 矩阵的最大特征值决定最优学习率:η<2/λ_max,这一原理在大模型调参中至关重要。
-
信息论:为 AI 系统中的信息表示、传输和压缩提供理论基础。熵量化随机变量的不确定性,应用于决策树算法和特征选择;KL 散度衡量概率分布差异,是 VAE 和 GAN 等生成模型的核心;互信息是特征选择和表示学习的重要指标。
(二)机器学习与深度学习基础
-
机器学习基础:理解监督学习、无监督学习、半监督学习等基本概念和常见算法,如决策树、支持向量机、朴素贝叶斯等。这些传统机器学习算法在数据预处理、特征工程以及一些简单任务中仍发挥重要作用。
-
神经网络基础:熟悉神经元模型、多层感知机(MLP)的结构与原理。掌握前向传播和反向传播算法,理解如何通过反向传播算法计算梯度并更新神经网络的参数,这是深度学习模型训练的核心机制。
-
深度学习框架:熟练掌握至少一种深度学习框架,如 PyTorch 或 TensorFlow。了解框架的基本使用方法,包括构建模型、数据加载、模型训练与评估等操作。以 PyTorch 为例,其动态计算图特性使得调试更加友好,丰富的 NN 模块库方便构建各种复杂模型,并且得到了 Hugging Face 的原生支持,在大模型开发中应用广泛。
(三)大模型相关技术
-
Transformer 架构:Transformer 架构是当前大模型的基础架构,其核心的自注意力机制是理解文本语义和捕捉长距离依赖关系的关键。自注意力机制可分解为查询 - 键矩阵乘法(计算相似度得分)、Softmax 归一化(转化为概率分布)、值加权求和(生成新的表示)三个数学操作,完美融合了线性代数(矩阵运算)和概率论(Softmax)的知识。需要深入理解 Transformer 的整体架构,包括编码器和解码器的结构与功能,以及位置编码等技术细节。
-
预训练技术:了解大模型的预训练过程,包括预训练目标(如语言模型预训练中的掩码语言模型目标等)、预训练数据集的处理和使用。知道如何利用大规模无监督数据对模型进行预训练,使其学习到通用的语言或其他领域知识。
-
微调技术:掌握全参数微调和部分参数微调等不同的微调策略。根据任务需求和计算资源,选择合适的微调方法,并合理设置超参数(如学习率、批次大小等)。通过多次实验找到最优的超参数组合,提升模型在特定任务上的准确性和效率。例如,在一些对计算资源要求较高的场景下,可以采用部分参数微调的方式,减少计算量的同时保持较好的模型性能。
-
提示工程:理解提示工程的概念和作用,学会设计有效的提示来引导大模型生成符合需求的输出。例如在文本生成任务中,通过精心设计的提示可以控制生成文本的风格、主题等。
一直在更新,更多的大模型学习和面试资料已经上传带到优快云的官方了,有需要的朋友可以扫描下方二维码免费领取【保证100%免费】👇👇
01.大模型风口已至:月薪30K+的AI岗正在批量诞生
二、实战技巧
(一)数据处理技巧
-
数据清洗:在拿到训练数据后,首先要进行数据清洗,去除噪声和错误数据。这一步骤对于提高模型性能至关重要,因为错误的数据可能会误导模型的学习。可以使用数据可视化工具,如 Matplotlib、Seaborn 等,直观地观察数据的分布情况,发现异常值和噪声点。
-
数据标注:准确的数据标注为模型提供正确的学习目标。在进行数据标注时,要制定清晰明确的标注规范,确保标注的一致性和准确性。对于一些复杂的标注任务,可以采用多人交叉标注、审核的方式,提高标注质量。
-
数据增强:通过数据增强技术扩充数据集规模,提高模型的泛化能力。在文本处理任务中,可以采用同义词替换、句子重组、随机删减或添加词语等方式增加数据的多样性;在图像领域,则可以进行图像翻转、缩放、裁剪、添加噪声等操作。例如在图像分类任务中,使用数据增强技术可以显著提升模型在不同场景下的识别准确率。
(二)模型训练技巧
-
超参数调优:超参数的设置对模型性能有着重要影响。可以采用网格搜索、随机搜索、贝叶斯优化等方法来寻找最优的超参数组合。在实际操作中,要合理设置搜索空间和搜索策略,避免过度搜索导致计算资源的浪费。同时,可以利用学习曲线等工具观察模型在训练过程中的性能变化,判断超参数设置是否合理。
-
模型监控与评估:在模型训练过程中,要实时监控模型的训练状态,包括损失值、准确率等指标的变化。可以使用 TensorBoard 等工具对训练过程进行可视化,直观地了解模型的训练情况。同时,要定期在验证集上对模型进行评估,根据评估结果调整训练策略,如调整学习率、增加训练轮数等。
-
模型优化与加速:为了提高模型的训练效率和推理速度,可以采用一些优化技术,如混合精度训练、模型并行和数据并行、剪枝和量化等。混合精度训练利用半精度浮点数进行计算,在不损失太多精度的前提下提高计算速度;模型并行和数据并行则可以将模型的计算任务分配到多个设备上同时进行,加速训练过程;剪枝和量化技术可以减少模型的参数数量和存储需求,提高推理速度。
(三)问题解决技巧
-
分析训练失败原因:当模型训练出现问题,如损失值不下降、准确率无法提升等,要能够分析可能的原因。可能是数据质量问题、模型结构不合理、超参数设置不当或者训练过程中出现了过拟合或欠拟合等情况。通过逐步排查,找到问题的根源并加以解决。
-
利用开源资源和社区:在实际工作中,遇到问题不要独自摸索,可以充分利用开源资源和社区的力量。例如在 GitHub 上有大量的开源大模型项目和相关代码,可以参考这些项目的实现方式来解决自己遇到的问题。同时,像 Stack Overflow、知乎等社区平台上也有很多专业人士分享的经验和解决方案,可以通过搜索相关问题获取帮助。
三、备考计划
(一)基础阶段(1 - 2 个月)
-
数学知识学习:学习线性代数、概率论与统计学、优化理论、信息论等相关数学知识。可以参考经典教材,如《线性代数及其应用》(Gilbert Strang)、《概率论与随机过程》(Sheldon Ross)、《Convex Optimization》(Boyd & Vandenberghe)等,结合在线课程,如 MIT 18.06 线性代数(公开课)、Stanford CS229 机器学习(数学基础部分)进行学习。同时,使用 NumPy/PyTorch 实现一些简单的矩阵运算和优化算法实验,加深对数学知识的理解。
-
机器学习与深度学习基础学习:阅读《机器学习》(西瓜书)全面入门机器学习基础理论,阅读《深度学习》(花书)涵盖神经网络基础、概率模型、优化算法等核心理论。结合《神经网络与深度学习》(邱锡鹏)这本中文教材,从理论与实践结合的角度进行学习。在学习过程中,通过编码实现一些简单的机器学习和深度学习模型,如线性回归、逻辑回归、多层感知机等,加深对模型原理的理解。
(二)进阶阶段(1 - 2 个月)
-
大模型相关技术学习:深入学习 Transformer 架构,阅读《Attention Is All You Need》这篇原始论文,理解自注意力机制。参考《Hands - On Machine Learning with Scikit - Learn, Keras, and TensorFlow》中关于 Transformer 架构与实现的章节进行实战学习。学习大模型的预训练、微调、提示工程等技术,阅读相关的论文和技术博客,了解最新的研究进展和应用案例。
-
深度学习框架实践:选择 PyTorch 或 TensorFlow 其中一个框架进行深入学习,掌握框架的高级功能和应用技巧。通过实际项目,如使用 Hugging Face Transformers 库进行大模型的微调,实现一些自然语言处理或计算机视觉任务,如文本分类、图像分类等,提高对框架的熟练程度。
(三)实战阶段(1 - 2 个月)
-
参与实战项目:积极参与智能客服、医疗诊断、金融风控等多场景的实战项目,可以在开源平台上寻找相关项目资源,或者参加一些线上的竞赛活动。在实战项目中,将所学的知识应用于解决实际问题,根据不同场景的特点调整模型和训练策略,不断积累实践经验。
-
项目总结与反思:在完成每个实战项目后,对项目过程进行总结和反思。分析项目中遇到的问题和解决方案,总结成功经验和不足之处。通过不断总结和反思,提高自己解决实际问题的能力和项目经验。
(四)冲刺阶段(1 个月)
-
复习与巩固:对之前学习的核心知识点进行全面复习,查漏补缺。重点复习在实战项目中经常用到的知识点和容易遗忘的知识点,强化记忆。
-
模拟考试与面试准备:进行模拟考试,检验自己的学习成果,熟悉考试形式和题型。同时,从面试官的角度准备可能会问到的问题,如大模型的工作原理、实际工作中的技术要求、遇到的问题及解决方案等。可以参考一些大模型面试题汇总资料,并结合自己的实际经验进行准备。
四、大模型部署与运维
(一)部署环境搭建
-
硬件选择:根据大模型的规模和应用场景,选择合适的硬件设备。对于中小型模型,可采用单 GPU 服务器,如 NVIDIA A100、V100 等;对于超大规模模型,如千亿参数级别的模型,则需要多 GPU 集群或专用的 AI 加速芯片,如 Google TPU。同时,要考虑硬件的内存容量、计算性能和通信带宽等因素,确保模型能够高效运行。
-
软件环境配置:搭建稳定的软件环境是大模型部署的基础。需要安装操作系统(如 Linux)、深度学习框架(如 PyTorch、TensorFlow)、CUDA 和 cuDNN 等加速库,以及相关的依赖包。可以使用 Docker 容器技术,将模型及其依赖环境打包成容器,实现环境的快速部署和一致性管理,避免不同环境之间的兼容性问题。
(二)模型部署策略
-
离线部署:适用于对实时性要求不高,且数据量较大的场景。将训练好的模型部署到本地服务器或终端设备上,通过批处理的方式处理数据。例如,在文本分析任务中,定期对大量文本进行处理和分析,生成分析报告。
-
在线部署:满足实时响应的需求,如智能客服、实时翻译等应用。将模型部署到云端服务器,通过 API 接口提供服务,用户可以通过网络实时调用模型进行推理。为了提高在线服务的性能和可用性,需要采用负载均衡、缓存等技术,确保服务的稳定运行。
(三)运维与监控
-
性能监控:实时监控模型的推理性能,包括响应时间、吞吐量、资源利用率(如 CPU、GPU、内存等)。可以使用 Prometheus、Grafana 等监控工具,设置性能指标的阈值,当指标超过阈值时及时发出告警,以便及时排查和解决问题。
-
模型更新与迭代:随着数据的不断积累和业务需求的变化,需要对模型进行更新和迭代。制定合理的模型更新策略,如定期重新训练模型、采用增量学习等方法,确保模型的性能始终满足业务需求。同时,要对更新后的模型进行测试和验证,避免引入新的问题。
-
故障排查与恢复:当模型部署和运行过程中出现故障时,要能够快速定位故障原因并进行恢复。建立完善的故障排查流程,通过日志分析、监控数据等手段,找出故障的根源。对于常见的故障,如服务器宕机、网络故障等,要制定相应的应急预案,确保能够快速恢复服务。
五、前沿技术跟踪
(一)学术研究动态
-
顶会论文跟踪:关注国际顶级人工智能学术会议,如 NeurIPS、ICML、ICLR、ACL 等,及时了解大模型领域的最新研究成果。这些会议上发表的论文往往代表了该领域的前沿技术和研究方向,通过阅读论文,学习新的模型架构、训练方法和应用场景,拓宽自己的学术视野。
-
研究机构成果关注:关注国内外知名的人工智能研究机构,如 DeepMind、OpenAI、Google Brain、百度研究院、华为诺亚方舟实验室等的研究动态。这些机构在大模型领域不断推出新的技术和产品,跟踪他们的成果可以及时了解行业的发展趋势。
(二)产业应用进展
-
行业案例分析:了解大模型在不同行业的应用案例,如金融、医疗、教育、交通等。分析这些案例中模型的选型、实现方式和取得的效果,从中汲取经验,为自己的项目实践提供参考。例如,在金融领域,大模型用于风险预测和投资决策,提高了金融服务的效率和准确性。
-
技术产品发布:关注各大科技公司发布的大模型相关技术产品,如开源模型、开发工具、云服务等。这些产品可以降低大模型的应用门槛,提高开发效率。例如,Hugging Face 提供了丰富的开源模型和工具库,方便开发者快速构建和部署大模型应用。
六、面试高频问题解析
(一)理论知识类
-
Transformer 与 RNN 的区别:Transformer 采用自注意力机制,能够并行处理序列数据,更好地捕捉长距离依赖关系;而 RNN 是递归结构,处理序列数据时具有时序性,难以并行计算,且在长序列上容易出现梯度消失或爆炸问题。Transformer 的编码器和解码器结构使得其在机器翻译等任务上的性能远超 RNN。
-
预训练模型的微调原理:预训练模型在大规模无标注数据上学习到了通用的知识和特征,微调则是在预训练模型的基础上,使用特定任务的标注数据进行训练,调整模型的参数,使模型适应特定任务。通过微调,可以充分利用预训练模型的知识,减少特定任务的训练数据量,提高模型的性能和训练效率。
(二)实战经验类
-
如何解决大模型训练中的过拟合问题:可以采用增加训练数据量、数据增强、正则化(如 L1、L2 正则化、Dropout)、早停等方法。增加数据量和数据增强可以提高模型的泛化能力;正则化通过对模型参数施加约束,防止模型过度拟合训练数据;早停则是在模型在验证集上的性能开始下降时停止训练,避免模型过拟合。
-
在资源有限的情况下,如何训练一个高性能的大模型:可以采用模型压缩技术,如剪枝、量化、知识蒸馏等,减少模型的参数数量和计算量;选择合适的小批量大小,提高计算资源的利用率;使用混合精度训练,在不损失太多精度的前提下加快训练速度;合理选择预训练模型,利用预训练模型的知识,减少训练成本。## 四、大模型部署与运维
(一)部署环境搭建
-
硬件选择:根据大模型的规模和应用场景,选择合适的硬件设备。对于中小型模型,可采用单 GPU 服务器,如 NVIDIA A100、V100 等;对于超大规模模型,如千亿参数级别的模型,则需要多 GPU 集群或专用的 AI 加速芯片,如 Google TPU。同时,要考虑硬件的内存容量、计算性能和通信带宽等因素,确保模型能够高效运行。
-
软件环境配置:搭建稳定的软件环境是大模型部署的基础。需要安装操作系统(如 Linux)、深度学习框架(如 PyTorch、TensorFlow)、CUDA 和 cuDNN 等加速库,以及相关的依赖包。可以使用 Docker 容器技术,将模型及其依赖环境打包成容器,实现环境的快速部署和一致性管理,避免不同环境之间的兼容性问题。
(二)模型部署策略
-
离线部署:适用于对实时性要求不高,且数据量较大的场景。将训练好的模型部署到本地服务器或终端设备上,通过批处理的方式处理数据。例如,在文本分析任务中,定期对大量文本进行处理和分析,生成分析报告。
-
在线部署:满足实时响应的需求,如智能客服、实时翻译等应用。将模型部署到云端服务器,通过 API 接口提供服务,用户可以通过网络实时调用模型进行推理。为了提高在线服务的性能和可用性,需要采用负载均衡、缓存等技术,确保服务的稳定运行。
(三)运维与监控
-
性能监控:实时监控模型的推理性能,包括响应时间、吞吐量、资源利用率(如 CPU、GPU、内存等)。可以使用 Prometheus、Grafana 等监控工具,设置性能指标的阈值,当指标超过阈值时及时发出告警,以便及时排查和解决问题。
-
模型更新与迭代:随着数据的不断积累和业务需求的变化,需要对模型进行更新和迭代。制定合理的模型更新策略,如定期重新训练模型、采用增量学习等方法,确保模型的性能始终满足业务需求。同时,要对更新后的模型进行测试和验证,避免引入新的问题。
-
故障排查与恢复:当模型部署和运行过程中出现故障时,要能够快速定位故障原因并进行恢复。建立完善的故障排查流程,通过日志分析、监控数据等手段,找出故障的根源。对于常见的故障,如服务器宕机、网络故障等,要制定相应的应急预案,确保能够快速恢复服务。
五、前沿技术跟踪
(一)学术研究动态
-
顶会论文跟踪:关注国际顶级人工智能学术会议,如 NeurIPS、ICML、ICLR、ACL 等,及时了解大模型领域的最新研究成果。这些会议上发表的论文往往代表了该领域的前沿技术和研究方向,通过阅读论文,学习新的模型架构、训练方法和应用场景,拓宽自己的学术视野。
-
研究机构成果关注:关注国内外知名的人工智能研究机构,如 DeepMind、OpenAI、Google Brain、百度研究院、华为诺亚方舟实验室等的研究动态。这些机构在大模型领域不断推出新的技术和产品,跟踪他们的成果可以及时了解行业的发展趋势。
(二)产业应用进展
-
行业案例分析:了解大模型在不同行业的应用案例,如金融、医疗、教育、交通等。分析这些案例中模型的选型、实现方式和取得的效果,从中汲取经验,为自己的项目实践提供参考。例如,在金融领域,大模型用于风险预测和投资决策,提高了金融服务的效率和准确性。
-
技术产品发布:关注各大科技公司发布的大模型相关技术产品,如开源模型、开发工具、云服务等。这些产品可以降低大模型的应用门槛,提高开发效率。例如,Hugging Face 提供了丰富的开源模型和工具库,方便开发者快速构建和部署大模型应用。
六、面试高频问题解析
(一)理论知识类
-
Transformer 与 RNN 的区别:Transformer 采用自注意力机制,能够并行处理序列数据,更好地捕捉长距离依赖关系;而 RNN 是递归结构,处理序列数据时具有时序性,难以并行计算,且在长序列上容易出现梯度消失或爆炸问题。Transformer 的编码器和解码器结构使得其在机器翻译等任务上的性能远超 RNN。
-
预训练模型的微调原理:预训练模型在大规模无标注数据上学习到了通用的知识和特征,微调则是在预训练模型的基础上,使用特定任务的标注数据进行训练,调整模型的参数,使模型适应特定任务。通过微调,可以充分利用预训练模型的知识,减少特定任务的训练数据量,提高模型的性能和训练效率。
(二)实战经验类
-
如何解决大模型训练中的过拟合问题:可以采用增加训练数据量、数据增强、正则化(如 L1、L2 正则化、Dropout)、早停等方法。增加数据量和数据增强可以提高模型的泛化能力;正则化通过对模型参数施加约束,防止模型过度拟合训练数据;早停则是在模型在验证集上的性能开始下降时停止训练,避免模型过拟合。
-
在资源有限的情况下,如何训练一个高性能的大模型:可以采用模型压缩技术,如剪枝、量化、知识蒸馏等,减少模型的参数数量和计算量;选择合适的小批量大小,提高计算资源的利用率;使用混合精度训练,在不损失太多精度的前提下加快训练速度;合理选择预训练模型,利用预训练模型的知识,减少训练成本。
七、如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
一直在更新,更多的大模型学习和面试资料已经上传带到优快云的官方了,有需要的朋友可以扫描下方二维码免费领取【保证100%免费】👇👇
01.大模型风口已至:月薪30K+的AI岗正在批量诞生
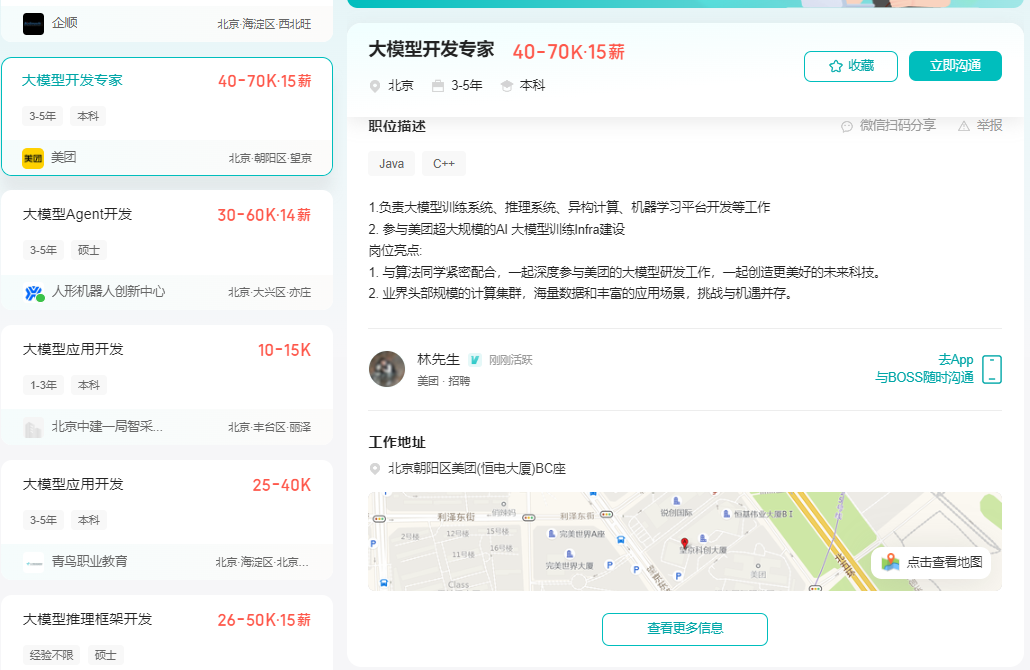
2025年大模型应用呈现爆发式增长,根据工信部最新数据:
国内大模型相关岗位缺口达47万
初级工程师平均薪资28K(数据来源:BOSS直聘报告)
70%企业存在"能用模型不会调优"的痛点
真实案例:某二本机械专业学员,通过4个月系统学习,成功拿到某AI医疗公司大模型优化岗offer,薪资直接翻3倍!
02.大模型 AI 学习和面试资料
1️⃣ 提示词工程:把ChatGPT从玩具变成生产工具
2️⃣ RAG系统:让大模型精准输出行业知识
3️⃣ 智能体开发:用AutoGPT打造24小时数字员工
📦熬了三个大夜整理的《AI进化工具包》送你:
✔️ 大厂内部LLM落地手册(含58个真实案例)
✔️ 提示词设计模板库(覆盖12大应用场景)
✔️ 私藏学习路径图(0基础到项目实战仅需90天)

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 294


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


