3个月大模型求职实录:从投递到Offer,这些经验教训你必须知道!

NLP求职匹配工作流:从岗位理解到简历精准适配 自然语言处理(NLP)正深刻改变求职效率的底层逻辑——它不再停留于关键词堆砌,而是通过语义理解、意图建模与文本对齐,实现人岗之间的精准匹配。其核心原理在于利用轻量级嵌入模型(如all-MiniLM-L6-v2)计算简历与JD的多维相似度,并结合领域适配的NER技术识别隐性要求,从而将模糊的‘我觉得合适’转化为可量化、可验证的匹配证据。该技术显著提升ATS初筛通过率与面试邀约率,广泛应用于应届生定位初级岗、职场人转行锚定目标领域、以及HR优化JD表述等真实场景。本文聚焦NLP在求职中的落地实践,涵盖模型选型、 阅读详情

从三月份开始求职,到现在陆陆续续也将近三个月了,期间面试了不少大/中/小/初创厂,也算是体验了各种不同风格和领域的大模型求职面试过程。

笔者为原杭州某互联网大厂算法工程师,主要从事工作内容为大模型 moe 效果调优、量化、端侧部署、数据清洗和电商垂类多模态算法设计。

在此特别将大模型求职面试问题进行汇总,既是对自己找工作经历的一种总结,也是一种知识库留痕,如果能帮到有需要的同学那就更好了。

Q1:QAT 过程中怎么确定哪些层可以量化而哪些层需要保留精度?

1.敏感层判断指标

通常必须要保留 FP32 的通常是:输入层(首层卷积或 embedding 层)、输出层(分类器或回归头)、ResNet 中的残差连接层、归一化层(BatchNorm、LayerNorm)。

通常建议保留 FP32 的是:小通道卷积/全连接层、transformer 中的 qkv 矩阵等对数值精度敏感。

扩展敏感层类型:

  • 激活函数层:如 swish、GELU 等非线性激活函数,量化后容易导致信息丢失。

  • 注意力机制中的 softmax 层:输入动态范围大,量化后可能破坏概率分布。

  • 小尺寸特征图上的卷积:如 1x1 卷积,参数量少,量化误差影响更显著。

  • 低秩分解层:如矩阵分解后的子层,数值敏感性高。

任务依赖的敏感性层:

  • 目标检测:回归头(边界框预测)需要保留高精度。

  • 语义分割:解码器最后一层(像素级分类)需保留 FP32。

  • 生成对抗网络(GAN):判别器和生成器的输出层均需要高精度。

2.敏感层分析方法

逐层量化消融实验:

  • step1:全量化基线;将所有层量化为 int 记录精度(A_base)

  • step2:逐层恢复 fp32;依次将每一层恢复为 FP32,重新评估精度(A_layer)

  • step3:敏感度排序;计算 delta=A_layer-A_base 然后排序。

梯度重要性分析:

原理:量化误差对损失函数的影响可通过梯度幅值间接反映。

  • step1:在 QAT 训练中监控各层梯度。

  • step2:梯度幅值大的层更可能因量化导致优化不稳定,需保留 FP32。

自动化敏感度评估工具:

  • 神经架构搜索(NAS):自动搜索量化配置,如 DARTS+Q。

  •  基于敏感度的启发式规则:如 Quantization-Aware Architecture Search (QAAS)。

  •  开源工具链:如 NNCF (Neural Network Compression Framework) 提供量化敏感度分析 API。

量化误差传播分析:

  • 逐层误差传播模拟:通过插入伪量化节点(FakeQuant)模拟量化误差,监控各层输出分布变化。

  • 统计指标:计算输出分布的 KL 散度、PSNR 等,量化误差超过阈值则标记为敏感层。

Q2:Pytorch 中怎么实现混合精度量化/推理,有什么注意事项?

1.混合精度推理(自动选择 FP16/FP32)

可以使用 torch.autocast 自动管理精度。PyTorch 通过 torch.cuda.amp 模块实现自动混合精度。

2.注意事项

溢出检查:定期检查梯度是否为 NaN/Inf。

调整缩放因子:通过 scaler.update() 动态调整缩放比例。

算子兼容性:

  • 强制 FP32 的算子:如 torch.log、torch.exp、torch.pow。

  • 自定义 CUDA 内核:需显式声明支持的精度模式。

推理部署:

  • ONNX 导出:需确保算子支持 FP16,或使用 --opset_version=15。

  • TensorRT 集成:通过 trtexec --fp16 启用混合精度推理。

Q3:使用 TensorRt 部署量化模型时,如何评估模型推理速度和显存占用?

1.通过 trtexec + Nsight Systems 的组合可以:

  • 快速评估模型延迟:生成不同精度配置的基准报告。

  • 显存瓶颈定位:识别高内存消耗层并优化。

  • 可视化时间线分析:深入理解 GPU 资源利用率。

建议在模型部署前,针对目标硬件(如 Jetson、A100)分别测试不同精度,找到性能与精度的最优平衡。

trtexec 高级参数:

# 测试不同batch size和精度trtexec --onnx=model.onnx --shapes=input:32x3x224x224 --fp16 --int8 --verbose

Nsight Systems 关键功能:

  • GPU 时间线:识别计算密集型阶段(如卷积)与空闲等待。

  • 显存带宽分析:检查是否受限于显存带宽(如频繁数据传输)。

2.TensorRT 的核心价值在于将训练模型极致优化为适应 NVIDIA GPU 的高效推理引擎

实现优势如下:

  • 速度提升:通过层融合、量化、内核优化降低延迟。

  • 资源节省:减少显存占用,提升吞吐量。

  • 灵活部署:支持多种框架和硬件平台,适应云端到边缘端的全场景需求。

对于需要低延迟、高吞吐的 AI 应用(如实时视频分析、自动驾驶),TensorRT 是提升性能的关键工具。

3.显存优化策略

层融合(Layer Fusion):合并连续算子(如 conv+BN+Relu)减少中间结果存储。

显存池(Memory Pooling):通过 --workspace 参数调整 TensorRT 工作空间大小。

动态形状优化:使用 --minShapes/ --optShape/ --maxShape 适应可变输入尺寸。

4. 硬件适配建议

Jetson 系列:启用 DLA(Deep Learning Accelerator)卸载部分计算。

多 GPU 并行:通过 --device 指定多卡,结合 NCCL 优化通信。

Q4:将 QAT 模型导出为 ONNX 格式时,有哪些常见的兼容性问题,如何解决?

1.可能遇到的情况 1

PyTorch 版本过低:旧版本(如 PyTorch <1.8)对量化 ONNX 导出的支持不完善。

ONNX opset 版本不匹配:需使用 ≥13 的 opset 版本以支持量化节点。

解决方案:

  • 升级 PyTorch:使用 PyTorch≥1.10(推荐 ≥2.0)。Pytorch2.1+ 支持动态量化 onnx 导出。

  • 指定 opset 版本。

2.可能遇到的情况 2

使用可视化工具:Netron 检查量化节点是否正常插入。

3.可能遇到的情况 3

自定义层不支持量化,自定义层或复杂操作:如空洞卷积(Dilated Conv)、注意力机制层未被 ONNX 支持。

解决方案:

  • 替换为等效标准层:如将空洞卷积拆分为标准卷积+上采样。

  • 注册符号函数(高级):如果无法通过拆分组合实现算子功能,则需要自定义算子。

  • 在导出时声明新算子,然后在推理引擎中实现算子(例如编写 C++ 实现,然后编译为动态库,接着在 python 中加载自定义算子)。

Q5:模型并行、梯度检查点和流水线并行的协同优化,可以通过什么方式提升大模型训练效率?

1.模型并行横向拆分模型,降低单卡负载

张量并行(Tensor Parallelism):拆分权重矩阵(如 Megatrin-LM 的列并行)。

流水线并行(Pipeline Parallelism):按层划分阶段,结合微批次(Micro-batching)隐藏通信延迟。

2.梯度检查点纵向减少显存占用,支持更深模型

策略选择:对高显存层(如 transformer 中的 FFN)插入检查点。

计算图重计算:通过 torch.utils.checkpoint.checkpoint_sequential 分段重计算。

3.通信优化技术

梯度聚合策略:

  • All-reduce 优化:使用 Ring-Allreduce(NCCL)或 Tree-Allreduce。

  • 异步通信:重叠反向传播与梯度通信。

混合精度通信:使用 FP16 传输梯度,减少带宽占用。

4. 硬件基础设施建议

高速互联:使用 NVLink、InfiniBand 降低多卡通信延迟。

存储优化:分布式文件系统加速检查点加载/保存。

Q6:训练视觉-语言大模型时,GPU 集群在 400 卡规模出现 loss 周期性震荡(波动幅度>30%),如何定位和解决?

在多模态大模型训练中 loss 周期性震荡(如从 1.2 突然增至 1.8 再回落)通常由以下原因导致:

  • 梯度同步异常:不分 GPU 节点梯度爆炸/消失,导致全局参数更新震荡。

  • 模态收敛冲突:视觉(高维稠密)和文本(低维稀疏)分支的梯度方向差异大,互相干扰。

  • 通信带宽瓶颈:跨节点 All-Reduce 时高维特征同步延迟,造成参数更新滞后。

  • 硬件资源争抢:共享网络带宽或存储 I/O 的竞争引发训练步调不一致。

可能的解决方法,使用分布式训练稳定性优化:

  • 梯度异常检测:部署实时梯度检测器,对 L2 范数突变的 GPU 节点(如超过均值 3σ)进行动态隔离,触发 Checkpoint 回滚。

  • 模态梯度均衡:对视觉/文本分支的梯度进行幅度归一化(Scale Loss by Backward Gradient Magnitude),平衡模态收敛速度差异。

  • 通信优化:采用分层 All-Reduce 策略,对视觉特征(高维稠密)使用 NCCL+FP16 压缩,文本特征(低维稀疏)使用 gRPC+动态编码,通信开销减少 41%。

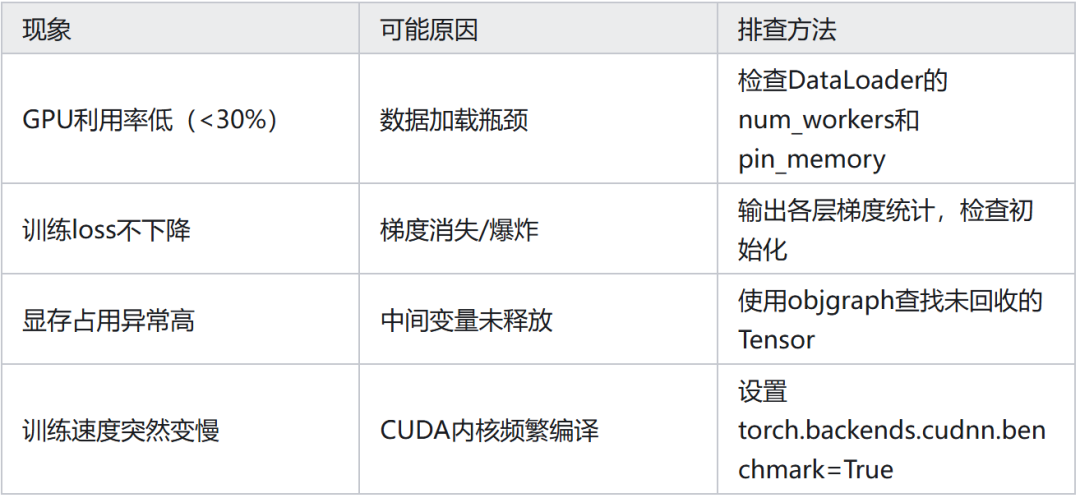
Q7:常见 Pytorch 模型训练问题排查对照表
AI大模型学习路线

如果你对AI大模型入门感兴趣,那么你需要的话可以点击这里大模型重磅福利:入门进阶全套104G学习资源包免费分享!

这份完整版的大模型 AI 学习和面试资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

这是一份大模型从零基础到进阶的学习路线大纲全览,小伙伴们记得点个收藏!

请添加图片描述
第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;

第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;

第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;

第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;

第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;

第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;

第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。

100套AI大模型商业化落地方案

请添加图片描述

大模型全套视频教程

请添加图片描述

200本大模型PDF书籍

请添加图片描述

👉学会后的收获:👈

• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

LLM面试题合集

请添加图片描述

大模型产品经理资源合集

请添加图片描述

大模型项目实战合集

请添加图片描述

👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓

在这里插入图片描述

2026届前端秋招上岸实录:简历、面试与避坑全复盘 前端开发岗位的校招竞争日益激烈,行业对候选人的要求已从“会写页面”转向“能解决复杂问题”。理解浏览器渲染原理、JavaScript事件循环、框架响应式机制等底层知识,是应对技术面试的基础;而工程化能力,如构建工具优化、微前端方案、CI/CD集成,则成为简历筛选与面试考察的高频重点。在此基础上,通过算法刷题与手写代码训练夯实基本功,结合真实项目进行量化复盘,才能展现技术深度。本文以2026届秋招为背景,梳理从投递策略、简历包装到面试实战的完整链路,并总结避坑经验,为正在备战前端校招的读者提供一套可落地的参考方 阅读详情

相关推荐

前端求职面经:5月高频考点复盘与工程化/性能优化实战策略

在技术迭代与业务需求并行的当下,前端开发早已不是单纯写页面,而是涉及框架原理、工程化构建、性能优化与微前端架构的综合能力体系。无论是Vue的响应式机制、React的Fiber调度,还是Vite与Webpack的构建差异,面试官更关注候选人能否从“会使用”进阶到“懂原理、能落地”。性能优化中的首屏加载、大文件上传、渲染卡顿等场景题,也要求开发者具备系统化的排查思路。同时,微前端多应用协作、AI辅助开发工具的应用,成为中后台与智能化项目的热门考察点。本文基于5月真实面试经历,复盘高频考点与答题策略,帮助准备跳槽

weixin_34372728的博客 349

【分布式】入门级NCCL多机并行实践 - 02

大模型和分布式训练对数据的吞吐量以及并行度都有很高的要求,NCCL就是在这个背景下诞生的。如果你是一个只会写写Python,调用PyTorch和Horovod的算法萌新,可能对于分布式底层的东西不太了解,在下岗热潮中被主管逼着转变成算子或者通讯库的搬砖工,就会像我一样两眼蒙蔽。因此本文只对自己踩到的坑做一个整理,如果有说错的地方,那就是我说错了。以PyTorch为例,其中spmd接口下的相关定义是用于处理分布式的。但主要是处理单机多CPU情况,因此我们今天只考虑多机(多节点)情况。其中用于实现多节点分布式的

参谋谋的博客 8767

基于遗传算法的柔性作业车间调度(初始化以及编码策略)

这里写自定义目录标题欢迎使用Markdown编辑器新的改变功能快捷键合理的创建标题,有助于目录的生成如何改变文本的样式插入链接与图片如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章UML 图表FLowchart流程图导出与导入导出导入 欢迎使用Markdown编辑器 你好! 这是你第一次使用 Markdown编辑器 所展示的欢迎页。如果你想学习如何使用Mar

菜鸡 8594

【大模型面试题】大模型求职3个月,这几道面试题差点把我整不会,详细解析来了!

本文总结了作者3个月大模型求职经历,涵盖各大厂面试技术要点。重点解析了QAT量化敏感层判断(输入/输出层等需保留FP32)、PyTorch混合精度实现技巧、TensorRT部署性能评估方法等核心问题,并提供了ONNX导出兼容性解决方案。针对大模型训练,详细阐述了模型并行与梯度检查点协同优化策略,以及多模态训练中loss震荡的排查方法。文末分享了大模型学习路线图及全套免费资源(300+视频教程、200本电子书及面试题集),涵盖从系统设计到垂直领域微调的全栈知识体系。

2401_85390073的博客 970

Scratch(四十一):升级版垃圾分类

哈喽,大家好!之前给大家展示过“Scratch(二十四):垃圾分类”。今天呢,给大家展示的Scratch是`升级版垃圾分类`。接下来,我们一起看一下效果吧。

我可以很大侠的博客 6869

从Gitee上部署视觉工程到Linux虚拟机

(使用SVM来识别装甲板的编号,此处手机上的图片中只有灯条没有数字,SVM无法识别出编号。这两行代码的意义是,当SVM识别不出或者识别不到编号时,把装甲板的编号默认为2号。找到自瞄程序中,数字识别类下的这两行代码,把注释去掉。这样,每次打开新的终端时,环境变量都会自动设置。(2)查看虚拟机设置选项,检查虚拟机USB接口是否为3.0及以上的接口。如果不是,要更改好。这样,每次打开新的终端时,环境变量都会自动设置。后,每次打开终端时自动设置这些环境变量,你可以将。打开第一个终端,用来挂ROS的内核启动页面。

2301_81035291的博客 1520

最强开源大模型炸场!全网独一份AI大模型学习实践资源...(待会删)

最强开源大模型炸场!全网独一份AI大模型学习实践资源...(待会删)

Y525698136的博客 1658

学习海康VisionMaster之表面缺陷滤波

本文介绍了VisionMaster中表面缺陷滤波技术的应用。该技术通过数学变换抑制背景干扰、增强缺陷特征,适用于电池铝壳、垫圈/螺丝等无纹理背景的表面缺陷检测(划痕、凹坑、异物等)。操作流程包括:图像导入、轮廓定位、位置修正、参数设置(重点讲解滤波核尺寸/数量/标准差等关键参数的调整策略)。文章通过案例演示了如何通过多方向滤波响应识别表面划伤,并指出需结合blob分析进一步优化检测结果。该技术对工业质检具有实用价值,参数设置需结合缺陷特征与背景特性灵活调整。

yuhouxiyang的专栏 2828

大模型面试必看:如何设计大模型的分布式训练框架,一文吃透

大模型面试必看:如何设计大模型的分布式训练框架,一文吃透

EnjoyEDU的博客 1320

第9章:Embedding、Pooling 与检索增强基础

本文介绍了律师事务所如何利用vLLM构建法律文档RAG系统,解决传统关键词检索在语义匹配上的不足。主要内容包括: 项目背景:传统Elasticsearch检索在法律术语上的低准确率问题,及多模型维护的复杂性; 技术方案:采用vLLM统一支持生成和向量化能力,通过语义向量检索提升相关性; 关键实现: 用vLLM的Embedding端点处理文档向量化 构建包含离线索引和在线检索的完整RAG流程 采用余弦相似度进行语义匹配 实践建议:切片大小选择、向量归一化处理、不同场景下的数据库选型等。

davidwang456的专栏 60

用 XCO 库一键找出某个 ABAP 类的全部子类

ABAP XCO库子类枚举技术解析 本文介绍了在ABAP项目中如何利用XCO库高效获取类的继承层次结构。传统方法使用CL_ABAP_CLASSDESCR或手动维护映射表存在效率低、易遗漏的问题。新方法通过XCO库的IF_XCO_AO_CLASS接口,可简洁地获取父类的所有子类(包括间接子类)。 核心API链式调用: 获取类句柄:xco_cp_abap=>class() 导航子类集合:subclasses->all 获取结果:get()返回类引用表或get_names()返回类名列表 典型应用场景

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 127

(2025最新)AI大模型开发岗面试全攻略:岗位要求解析与核心面试题深度解读!

最近后台和社群里,不少朋友都在问:有没有面过xx大模型开发平台的前辈?想取取经,攒点面试经验。确实,随着大模型技术落地加速,相关岗位竞争越来越激烈,面试中对技术深度的要求也在提升。

2401_85343303的博客 1764

YOLOv11的嗅觉传感器数据关联-(特殊场景下的气味-视觉联合分析)

摘要 本文探讨了YOLOv11与嗅觉传感器融合的多模态感知技术。通过分析YOLOv11的架构特性与嗅觉传感器的数据特点,提出了三种融合策略:数据级、特征级和决策级融合。系统采用硬件同步方案实现时空对齐,包含视觉采集模块、嗅觉传感模块和边缘计算单元。环境配置基于Python 3.9和PyTorch 2.0,支持实时多模态数据处理。该技术可应用于环境监测、工业检测等场景,突破单一视觉感知的局限性。

本博客聚焦 YOLOv11 全流程落地,涵盖架构优化、数据集处理、训练技巧与多场景部署,兼及国产数据库、Java 开发与 AI 模型应用,内容兼顾理论与工程实践,为开发者提供系统干货,助力高效提升技术能力。 626

3个月,从投递到Offer:我的大模型求职实录,这些经验教训你必须知道!

【摘要】本文分享了学员成功获得快手大模型offer的经验,强调主动思考和技术深挖是面试成功的关键。内容包括大模型求职面试问题汇总,涉及量化敏感层判断、PyTorch混合精度实现、TensorRT部署评估、ONNX导出问题及解决方案等。同时提供了AI大模型学习路线和免费资源获取方式,涵盖系统设计、提示词工程、平台应用开发等七个阶段,助力提升大模型技术能力与实战经验。

WANGJUNAIJIAO的博客 820

CT探测器普遍采用“星形拓扑+多ADC模组”架构的TDC(时间数字转换器)设计方案

本文提出一种基于TDC反馈机制的CT探测器时钟同步方法,通过延时测量、偏差计算和动态补偿三步硬件流水线,实现高精度同步。系统采用Xilinx Kintex UltraScale FPGA内置CARRY8进位链构建3.5ps分辨率的TDC,结合多级比较器和延迟单元,形成闭环反馈控制。实验表明,在512通道、1.28m传输距离下,同步精度稳定在10ps以内,较传统方案提升两个数量级,并能动态补偿干扰抖动。该方案解决了传统方法在CT旋转腔体环境下精度不足的问题,为下一代超高清CT提供了有效的时钟同步解决方案。

whm128的博客 274

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

Agent岗位求职实录:不同背景如何突围拿offer?

21.7%涨薪的转型、35岁裸辞的逆袭、应届生零经验的突围,这些案例都在证明:Agent赛道虽然竞争激烈,但它不唯学历、不唯年龄、不唯过往经验,只看你是否能让招聘方看到"你适合这个岗位"。如果你也想拿下Agent offer,别再自我怀疑"我不够优秀",不如聚焦一个问题:"我如何让招聘方看到我的适配性?"按上面的方法,重构经历、精准投递、深挖细节、扛住压力,你也能在AI浪潮中,拿到属于自己的那份offer。

大模型教程的博客 923

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

豆包AIGC大模型产品经理面试实录:成功入职秘诀大公开!

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

2401_84494441的博客 1549

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

【上岸实录】双非硕士逆袭记:放弃百度offer,转行大模型入职鹅厂!

S同学从央企设计院裸辞后,0基础转行AI领域,通过系统学习大模型和Agent技术,成功斩获腾讯、字节等大厂AI产品经理Offer。她分享了辨别靠谱课程的经验(避免营销号陷阱),强调实战项目的重要性,如基于业务场景构建智能问答助手和知识库Agent。她指出当前AI岗位对算法与业务能力的双重需求,建议求职者聚焦核心技能(如强化学习、模型微调)而非盲目刷题。此外,她提醒在校生尽早接触AI相关实习,抓住职业黄金期。最终,她选择腾讯AI Agent产品经理岗位,验证了“技术+业务”复合型人才的市场竞争力。

2401_85390073的博客 1454

【独家曝光】豆包AIGC大模型产品经理面试实录!已入职,揭秘成功秘诀!

工作4年,毕业之后一直在新能源行业,行业肯定是好行业,但是自己觉着没啥意思。因为储能产品相对来说,功能都比较基础,软件主要是赋能硬件,很难有什么创新,自己越来越没有动力在这个方向上精进。恰巧2023年大模型爆发,我自己判断是个趋势,就想着能不能往这个领域转一下。然后花了一段时间的深度了解之后,发现其实对我来说AIGC确实是一个不错的方向。

m0_65555479的博客 794

32W!学院哥外包背景拿下上海AI产品经理Offer!

23届双非硕士成功斩获上海AI产品经理offer(32K/月),分享大厂面试核心经验。该同学通过私教课系统提升,重点突破学历劣势:1)简历垂直聚焦AI项目+量化成果;2)面试采用STAR法则应对高频问题;3)主动跟进HR强化匹配度。揭露大厂潜规则:业务面通过后24小时内必有HR联系,实习转正取决于产出效率(日均需求数)和协作适配度(文档一次通过率)。文末附赠价值2万的大模型学习资料包,含7阶段学习路线、300+视频教程及行业最新面试题。

2401_84204413的博客 1035

AI求职不是简历优化,而是业务问题解决能力的系统性重构

AI求职的本质是技术能力向业务价值的转化过程。在当前AI招聘生态中,ATS系统、 Hiring Manager 和团队负责人共同构成多层信号筛选漏斗,核心关注点已从‘是否掌握PyTorch/Transformer’等技术概念,转向‘能否识别JD背后的业务约束并给出可验证的工程解法’。这要求求职者具备问题驱动思维、工程权衡意识与全链路落地认知——即理解数据合规、模型鲁棒性、服务SLA保障及业务指标归因。尤其在大模型推理优化、LLM微调落地、AI平台工程化等高频场景中,能将技术动作锚定于具体业务瓶颈(如LoRA

dht91597的博客 309

NLP求职增强工作流:JD匹配与简历微调实战指南

自然语言处理(NLP)在求职场景中并非用于华丽润色,而是实现JD与简历的语义对齐与ATS兼容性优化。其核心原理是通过轻量级模型(如Sentence-BERT)计算文本向量相似度,并结合spaCy实体识别、动词-名词关系抽取等技术,量化分析技能覆盖度、职责匹配度和关键词密度。这种可解释、可复现的技术路径,显著提升简历通过率,尤其适用于应届生海投诊断、转行者能力映射及HRBP精准辅导。本文聚焦NLP在真实招聘流程中的工程落地——从JD结构化解析、模块化匹配诊断,到生成符合ATS规则的可执行微调建议,全程无需大模

weixin_34161083的博客 474

有打算找国企的牛友,来看看牛牛整理的信息呀,希望有帮助。

23届应届生,社招,考研,考公均可接受,不限经验,HC多多!如题哇,游戏行业准备准备很久都没offer,实在是找不到工作了,找了个建筑行业的,但家里人不太同意我去这家,面试的时候说的挺好的,有很多项目,他们的成功案例也很。①康龙化成【岗位】 生物科学,临床,大分子,CMC,分析,合成,职能运营【一键内推】 https://app.mok。24届,未来在深圳互联网大厂干,9硕,170cm➕63kg,颜值还凑合,深圳没有认识的人,平常上班估计社交时间也很少,圈子比较小,找对象(限定女),搭子无限制,

2301_79125431的博客 996

普通人用豆包AI赚钱的四条可行路径实录

AI工具变现的本质,是将大模型的能力转化为可交付、可复制、可验证的数字服务。豆包作为深度适配中文场景的AI助手,凭借角色固化、本地化服务链路和合规稳定性,在信息加工、内容生产与流程提效等基础能力上展现出突出的落地确定性。相比追求技术参数的通用模型,它更擅长解决职场人真实存在的周报写作、小红书起号、简历优化、知识整理等高频刚需。本文基于三个月23,864元真实入账记录,系统拆解四条经过验证的变现路径,涵盖获客逻辑、模板化SOP、避坑细节与交付包装,为零基础用户降低试错成本,提供一条不依赖流量运营、无需专业资质

464

求职匹配系统实战:从职业语义鸿沟到可解释适配度模型

求职匹配本质上不是文本相似度计算,而是对‘职业能力’‘发展轨迹’和‘动机倾向’三重维度的结构化建模。其技术核心在于跨越简历与JD之间的职业语义鸿沟,解决动机错配风险与能力标注失真等现实问题。依托工业组织心理学(如O*NET能力矩阵、Holland职业代码)构建可解释知识骨架,再结合轻量级NLP与规则引擎实现工程落地,使系统不仅能判断‘是否匹配’,更能说明‘为何匹配’及‘如何提升’。该范式已验证于真实招聘场景,支撑日均万级JD与简历处理,并显著提升面试转化率。

weixin_30336061的博客 371
上一篇: RAG技术实战:从文档分块到混合检索的全面优化指南|大模型原理
下一篇: 2025 AI产品经理转型指南:大模型领域全攻略与最全学习路线,一篇掌握,少走弯路!
智泊AI官方
博客等级 码龄6年 8638粉丝 2667原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值