Pandas实现Excel中浮点数float转时间datetime

【C】01 浮点数转换成日期时间格式 文章目录1 需求分析1.1 时间的表示规则1.2 Excel中浮点数与日期时间的相互转换2 程序设计2.1 调试环境2.2 源码3 运行结果 1 需求分析 1.1 时间的表示规则 C语言中,把日期和时间表示成一个浮点数(小数),便于日期计算。 正如 @阁云 在 日期的原型是浮点数 这篇博客中介绍的那样,参照时间为 1900/01/01 00:00:00。 比如 39819.440972222219 的整数部分 39819 表示当前日期距参照时间1900/01/01 的天数,而小数部分则表示不满一天,将其乘以 阅读详情

详细教程及源代码

场景:

在很多时候我们读取 Excel 文件后,得到的 df 中,时间日期列有很多浮点数,原因是在 Excel 中,时间会被当成序列数储存,如果设置的格式不当,或者在 Excel 清除了格式,时间就换变为序列数,例如:
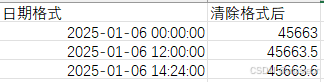
在 pandas 读取这样的 Excel 后,并不能直接转换为 datetime,我们可以应用一下代码,对数据进行格式化:

def convert_to_datetime(value):
    try:
        # 检测传入的是否为数字
        if pd.api.types.is_number(value):
            # 处理 Excel 序列号中的特殊日期
            if value < 60:
                return pd.to_datetime(value - 1, origin='1900-01-01', unit='D')
            else:
                # 考虑到1900年2月29日这个不存在的日期在excel会正确显示,所以让1900-2-29显示为1900-02-28
                # 即当数字为60时,实际的时间是1900-2-28,当数字为59时,日期也为1900-2-28
                return pd.to_datetime(value - 1, origin='1899-12-31', unit='D')
        else:
            # 尝试直接转换为 datetime
            return pd.to_datetime(value)
    except (ValueError, OverflowError):
        # 当非序列数时应返回原来的内容
        return value

这里给代码做出解释,Excel 在计算日期时,会将日期转化为序列数,1900-01-01 记为 1,1900-01-02 记为 2,以此类推;

但是为了兼容之前版本的软件和其他软件,Excel 会错误的认定 1900 年为闰年,即 1900-02-29 是有效日期,Excel 关于 1900 年闰年解释,但在 pandas 和其他软件中,没有 1900-02-29,所以我在转换代码中检测当,序列数小于 60 时,第一天为 1900-01-01,;当序列数大于等于 60 时,开始日期则为 1899-12-31,在转换时就可以转为正确的日期。

应用示例:

import pandas as pd
 
 
def convert_to_datetime(value):
    try:
        # 检测传入的是否为数字
        if pd.api.types.is_number(value):
            # 处理 Excel 序列号中的特殊日期
            if value < 60:
                return pd.to_datetime(value - 1, origin='1900-01-01', unit='D')
            else:
                # 考虑到1900年2月29日这个不存在的日期在excel会正确显示,所以让1900-2-29显示为1900-02-28
                # 即当数字为60时,实际的时间是1900-2-28,当数字为59时,日期也为1900-2-28
                return pd.to_datetime(value - 1, origin='1899-12-31', unit='D')
        else:
            # 尝试直接转换为 datetime
            return pd.to_datetime(value)
    except (ValueError, OverflowError):
        # 当非序列数时应返回原来的内容
        return value
 
# 示例数据列表
example_values = [
    44562.75,  # 这是一个Excel浮点数表示的日期,对应于2022-01-01 18:00
    "2023-04-05",  # 这是一个字符串形式的日期
    60,         # Excel中的特殊日期,应该返回1900-02-28
    59,         # 同样,这应该返回1900-02-28
    "not a date",  # 非日期格式的字符串
    1,          # Excel序列号1对应于1900-01-01
]
 
# 将示例数据转换为日期
converted_dates = [convert_to_datetime(val) for val in example_values]
 
for original, converted in zip(example_values, converted_dates):
    print(f"Original: {original}, Converted to datetime: {converted}")

Excel转JSON不是格式转换,而是数据语义建模 Excel与JSON分属不同数据范式:前者是面向人眼的二维报表,后者是面向机器的结构化契约。理解这一本质差异,是实现可靠数据交换的前提。其核心在于将Excel中的工作表、列、合并单元格等隐式结构,映射为JSON中的对象、嵌套字段、数组及类型约束,完成从‘表格快照’到‘语义模型’的跃迁。该过程涉及日期标准化、大数精度保护、空值语义统一、中文编码兼容等关键技术挑战,广泛应用于Web API对接、前端数据集成、AI训练数据准备及低代码平台接入等场景。本文聚焦真实生产环境中的语义锚定方法与七类高频陷阱应对策略。 阅读详情

相关推荐

Pandas read_excel()函数全解析:从Excel数据导入到DataFrame处理实战

在Python数据分析与自动化办公领域,数据导入是数据处理流程的首要环节。Pandas库作为Python数据分析的核心工具,其read_excel()函数提供了将Excel文件高效转换为DataFrame数据结构的标准化接口。该函数通过整合openpyxl、xlrd等底层引擎,实现了对.xlsx和.xls格式文件的统一读取,支持复杂表头、数据类型指定、分块读取等高级功能,显著提升了数据处理的自动化程度与准确性。在数据清洗、报表自动化、机器学习预处理等应用场景中,掌握read_excel()的参数配置与性能优

weixin_34138056的博客 341

pandas时间处理实战:从datetime64到.dt accessor的业务化应用

时间类型是数据分析中最易被低估的基础概念,其本质是承载业务逻辑、合规要求与用户行为的时间坐标系统。理解datetime64[ns]的纳秒整数底层原理,是实现可计算、可比较、可审计时间操作的前提;而.dt accessor则将日历知识封装为直觉化属性,使年月日、ISO周、财季、月末标识等业务维度得以一键提取。结合pd.to_datetime()的鲁棒解析、Timedelta与DateOffset的语义化偏移、以及resample()的频率转换能力,数据分析师才能跨越‘字符串日期’陷阱,在销售归因、合规报告、周

张沈鹏,在路上 ... 874

官方推荐:6种Pandas写入Excel的方法

本文详细介绍了6种Pandas写入Excel的高效方法,包括基础写入、多Sheet写入、大数据集优化、样式控制、多数据源合并及高级技巧。通过to_excel()函数和ExcelWriter的灵活应用,帮助开发者提升数据处理效率,特别适合数据分析师和Python开发者。

weixin_30466039的博客 303

浮点数转日期

double 浮点转日期

稀里糊涂的专栏 1091

Python自动化Excel:openpyxl与pandas库实战指南

在数据处理与办公自动化领域,Python凭借其丰富的库生态成为高效工具。其核心原理是通过编程接口操作文件与数据,实现流程自动化,从而将人力从重复性劳动中解放出来,提升工作效率与准确性。这一技术价值在数据处理、报表生成等场景中尤为突出。具体到Excel文件操作,Python社区提供了多个成熟库来满足不同需求。其中,openpyxl库专精于现代.xlsx格式文件的读写与精细样式控制,适合生成复杂格式报表;而pandas库则以DataFrame为核心,专注于数据的快速读取、清洗与分析,是数据交换和批量处理的利器。

weixin_34208185的博客 426

利用图层自动识别算法实现CAD到Revit BIM模型的高效转换 - VS2022与AutoCAD2024开发环境配置指南

本文详细介绍了如何配置VS2022与AutoCAD2024开发环境,并利用图层自动识别算法实现CAD图纸到Revit BIM模型的高效自动化转换。通过解析CAD图层的规律性,该算法能智能识别并分类墙、门、窗等构件,提取几何信息并驱动Revit自动创建三维模型,从而将传统繁琐的人工“翻模”工作转化为高效、准确的自动化流程,大幅提升BIM模型创建效率。

Apple的专栏 1126

python中把float类型转换成日期

从excel的某一格式中读出日期时,发现是一个float类型,但它在显示的时候却是一个日期,这个就要在代码中处理了,如下进行转换: # 44152.0146412037 DateObj = datetime(year=1900, month=1, day=1) DateObj += timedelta(days=dateTime) # 转换datetime格式,这里的datetime就是float,值为上面注释的 dateTime = DateObj.strftime("%Y/%m/%d %H:%

jszj的专栏 1万+

Windows下高效部署llama.cpp:从环境配置到模型量化的完整指南

本文提供了一份详尽的Windows系统下部署llama.cpp的完整指南。内容涵盖从Python环境配置、使用CMake与MinGW编译工具链的搭建,到编译llama.cpp项目、获取并转换模型为GGUF格式,以及执行模型量化和基础推理测试的全过程。指南旨在帮助开发者在普通Windows电脑上,无需高端显卡,仅凭CPU即可高效运行大语言模型,并重点解决了部署过程中常见的环境与编译错误。

weixin_28841265的博客 882

将float类型的日期转换为Datetime类型的日期

解决办法1:select (Datename(YEAR ,DataTime)+'-'+Datename(MONTH ,DataTime)+'-'+Datename(DAY,DataTime)+' '+DATENAME(HOUR,DataTime)+':'+DATENAME(MINUTE,DataTime)+':'+DATENAME(SECOND,DataTime) ) 时间 from “表名” o...

wentijieda的博客 1万+

通达信强龙趋势幅图指标 - 精准捕捉趋势,把握强势行情,多角度分析个股,强弱一目了然

STICKLINE(趋势>0 AND SJTJ,4.8,5.8,1.5,0),COLORYELLOW;STICKLINE(资金>0 AND SJTJ,1.2,2.2,1.5,0),COLOR0080FF;STICKLINE(异动>0 AND SJTJ,0,1,1.5,0),COLORFF0080;STICKLINE(异动=0 AND SJTJ,0,1,1.5,1),COLORGRAY;

Q1809330692的博客 5632

AI视频生成提示词工程:结构化公式与实战案例详解

在实际使用 AI 生成视频或图像时,最常遇到的困惑是:为什么我的提示词(Prompt)生成的画面总是不理想?是模型能力不足,还是我的描述有问题?答案往往是后者。提示词工程(Prompt Engineering)并非简单的“翻译”需求,而是一门需要结构化思维和精准描述的技能。它决定了 AI 能否准确理解你的意图,并生成符合预期的视觉内容。 本文将通过两个核心案例,深入拆解提示词的构建逻辑。第一个案例聚焦于“文生视频”,我们将学习如何将一个简单的想法,如“小猫在雪地里玩雪球”,通过结构化公式扩展为一段富有细节和

weixin_30800987的博客 563

excel插入一列日期 pandas_Pandas.dataframe.read_excel 读取excel 日期格式

慕神8447489老铁, 可以使用datetime库import datetimedef time_convert(time_str):time_obj = datetime.datetime.strptime(str(time_str), '%Y-%m-%d %H:%M:%S')time_converted = time_obj.strftime('%Y/%m/%d')return time_c...

weixin_39769703的博客 1396

蛋白质组学进阶指南 | (八)差异蛋白筛选与功能解析实战

本文是蛋白质组学差异蛋白筛选与功能解析的实战指南。详细讲解了如何利用R语言的limma包进行差异表达分析,结合FDR校正和差异倍数设定筛选关键蛋白,并通过火山图可视化结果。进一步介绍了使用clusterProfiler进行GO与KEGG功能富集分析,以及利用STRING数据库和Cytoscape构建蛋白互作网络以识别枢纽分子,最终串联分析形成可验证的生物学假说。

weixin_29208077的博客 742

为什么pandas读Excel日期列全是浮点数字?

Pandas读取Excel时日期列变为浮点数的问题源于Excel内部使用浮点数存储日期(整数部分为1900年后的天数,小数部分为时间比例)。解决方案包括: parse_dates参数:直接指定日期列,但需确保Excel列格式为日期类型; 手动转换:通过基准日期(1899-12-30)加上浮点数的天数差值转为Python日期; 更换引擎:openpyxl对xlsx格式的日期识别更优,而xlrd需额外检测日期列。 注意事项:处理混合类型(文本/浮点数)、空值(NaN)及时区问题。

扛锄头的农民 477

CUDA系列-Stream-1

This section describes static aspects of the CUSW_UNIT_STREAM unit’s architecture.和stream相关的其它Unit主要有Channel,Sync,Memmgr A CUDA stream is a software FIFO queue that allows commands like kernel launch and memcpy to be enqueued in it. The enqueued commands

weixin_43360707的博客 734

多源异构数据融合(Kaggle+Google Trends联合分析)

本文详细介绍了如何利用Python实现多源异构数据融合,以Kaggle电商销售数据与Google Trends搜索指数为例,展示了数据清洗、预处理、时间对齐、数据合并、相关性分析、回归建模和可视化全过程。数据预处理与内存优化通过分块加载、数据类型转换和缺失值处理,有效降低了大规模数据在内存中的占用,并确保数据质量。时间对齐与数据融合策略采用重采样与内连接方法对齐不同数据源的时间维度,实现了高质量数据的融合,为后续联合分析奠定基础。模型构建与分析。

闲人编程的博客 1016

Python读取Excel数据转NumPy数组:从Pandas到高性能计算的完整指南

在数据科学和机器学习项目中,数据预处理是构建可靠模型的基础环节。NumPy作为Python科学计算的核心库,提供了高效的多维数组对象和向量化运算能力,是进行矩阵运算和数值分析的标准工具。其技术价值在于通过底层C语言实现和连续内存存储,实现了比纯Python列表快数十倍的计算性能,为大规模数据处理和复杂算法提供了基础支持。在实际应用中,数据常以Excel格式存储,因此将Excel数据高效转换为NumPy数组成为数据流水线的关键步骤。通过Pandas库的read_excel函数,可以一站式完成数据读取、类型转换

weixin_33938733的博客 291

wflow模型hbv

毛管水的处理 😄 快速流的处理 K4是为了产生基流的 找到了令人激动的kenematic模块 😄

m0_46268055的博客 778

Python Pandas实现Excel数据比对:从原理到实战的完整指南

在数据处理领域,集合运算是识别数据差异的核心原理,它通过交集、并集和差集操作高效定位数据异同。Python的Pandas库基于NumPy向量化计算实现了这一原理,其DataFrame结构为数据比对提供了强大的技术基础。这一技术价值在于能够自动化处理海量数据,将人工从繁琐的Excel手动比对中解放出来,显著提升数据核对与验证的效率。其典型应用场景包括财务对账、客户名单更新、系统数据迁移验证等需要精确识别数据增删改的场合。本文聚焦于使用Pandas的merge函数进行Excel文件比对,详细解析了如何通过数据预

weixin_34187862的博客 1714

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

pandas-时间序列与日期用法(二)

本节介绍时间戳 1.时间戳是最基本的时间序列数据,用于把数值与时点关联在一起。Pandas 对象通过时间戳调用时点数据。 2.大多数情况下,用时间段改变变量更自然。Period表示的时间段更直观,还可以用日期时间格式的字符串进行推断。 3.Timestamp与Period可以用作索引。作为索引的Timestamp与Period列表则被强制转换为对应的 DatetimeIndex与PeriodIndex Pandas 可以识别这两种表现形式,并在两者之间进行转化。Pandas 后...

qq_14815199的博客 945

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

Excel转JSON实战:解决合并单元格、中文乱码与日期格式三大痛点

Excel转JSON是企业数据集成中的高频基础任务,本质是将非结构化表格数据映射为严格契约化的JSON树形结构。其核心难点在于Excel固有的‘人本设计’(如合并单元格、视觉编码、公式残留)与JSON的‘机器友好’语义之间存在根本性冲突。技术实现需跨越数据清洗、类型强转、时区归一、特殊字符转义等关键环节,尤其要应对中文路径解析失败、NaN/NaT误输出、换行符导致JSON解析崩溃等典型故障。本文聚焦Python生态下的pandas、openpyxl与excel2json-3三大工具链,提供可落地的鲁棒转换方

weixin_30755393的博客 403

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

pandas read_excel参数详解:精准读取Excel的工程实践指南

Excel文件读取是Python数据分析的关键入口,其底层涉及openpyxl、xlrd、pyxlsb等解析引擎与.xlsx、.xlsb等格式的深度适配。理解read_excel的工作原理,本质是掌握文件格式生态、引擎兼容性及dtype推断机制的技术逻辑。它决定数据是否完整加载、类型是否准确保留、空值是否合理识别,进而影响后续清洗、建模与BI输出的可靠性。典型应用场景包括财务多级表头解析、超大.xlsb文件加载、含前导零ID字段保真、混合格式金额列清洗等。本文聚焦企业级实战中高频出现的引擎选型、sheet_

weixin_34199405的博客 410

Python精准读取Excel指定行列:pandas与openpyxl高效协同实战

在数据处理领域,Excel文件是常见的数据存储格式,其结构化特性使得数据读取成为关键环节。数据读取的核心原理在于解析文件结构并提取目标信息,这直接关系到处理效率与资源消耗。精准读取技术通过指定行列范围,避免了全量加载,显著提升了处理速度并降低了内存占用,尤其适用于大型报表和定期生成的数据模板。在实际应用场景中,财务分析、运营报表等需要从海量数据中快速提取子集的任务尤为受益。本文聚焦于pandas与openpyxl的协同使用,深入探讨了如何通过usecols、skiprows等参数实现高效读取,并针对合并单元

weixin_30788239的博客 274

Pandas to_excel数据写入全攻略:从基础到高级实战技巧

在数据处理与分析的工作流中,数据持久化是确保分析成果可交付、可复用的关键环节。其核心原理是将内存中的结构化数据通过特定编码与格式转换,写入到外部存储介质。这一过程的技术价值在于,它不仅实现了数据的长期保存,更通过格式控制、性能优化等手段,直接影响下游系统对接、报告可读性与协作效率。在实际应用场景中,无论是生成业务报表、导出分析结果,还是构建自动化数据管道,高效、准确的数据写入能力都至关重要。本文将聚焦于Python数据分析中常用的pandas库,深入解析其to_excel方法,涵盖多表操作、格式美化、大数据

weixin_34124651的博客 471

Pandas to_excel与ExcelWriter深度解析:从基础导出到专业报表实战

在数据处理与自动化办公领域,数据导出是连接分析结果与实际应用的关键环节。其核心原理在于将内存中的结构化数据序列化为特定格式的文件,以实现数据的持久化与交换。这一过程的技术价值在于提升工作效率、确保数据一致性并支持复杂报表的自动化生成。在Python生态中,Pandas库的`to_excel`函数及其背后的`ExcelWriter`引擎是实现Excel文件读写的标准工具,广泛应用于数据分析、业务报表自动化、数据交付等场景。针对实际应用中遇到的性能瓶颈、多表操作困难以及格式控制不精细等问题,深入理解`to_ex

weixin_30552811的博客 480

数维杯B题实战:pandas时间清洗与共享单车建模全流程

时间序列建模是数学建模的核心基础能力,其关键在于将原始杂乱的时间字段准确解析为可计算的datetime类型。原理上需理解Excel序号机制、时区转换逻辑与不规则采样重构方法;技术价值体现在避免因NaT、时区偏移或周期错位导致的模型系统性偏差;典型应用场景包括城市交通调度、共享出行需求预测及物联网设备轨迹分析;本文聚焦数维杯B题真实赛题环境,以pandas 2.0+为唯一依赖,深度拆解Excel时间字段清洗、GPS点云特征工程与LightGBM业务建模闭环,特别强化数学建模中‘数据即逻辑’的工程思维。

weixin_34007906的博客 343
上一篇: Wordpress修改固定连接后404
下一篇: 清华大学《DeepSeek:从入门到精通》手册
mxsleon
博客等级 码龄3年 88粉丝 8原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值