音频知识解答:为什么投屏内录的声音会比正常speaker播放的声音小?

FTViewSE利用VB脚本制作简易日报表 罗克韦尔SE用VB做的简单的报表 阅读详情

背景:

以前经常发现系统投屏在内录声音时候,传递的音频数据声音明显比正常情况下手机的声音小很多,当然为了测试方便也可以不需要投屏场景,大家可以考虑直接手机对声音进行内录,然后进行播放,在同一个设备上进行对比更加明显。那么这个
到底是为什么呢?学了audio框架课程的音量调节后我们来分析一下相关的原因。

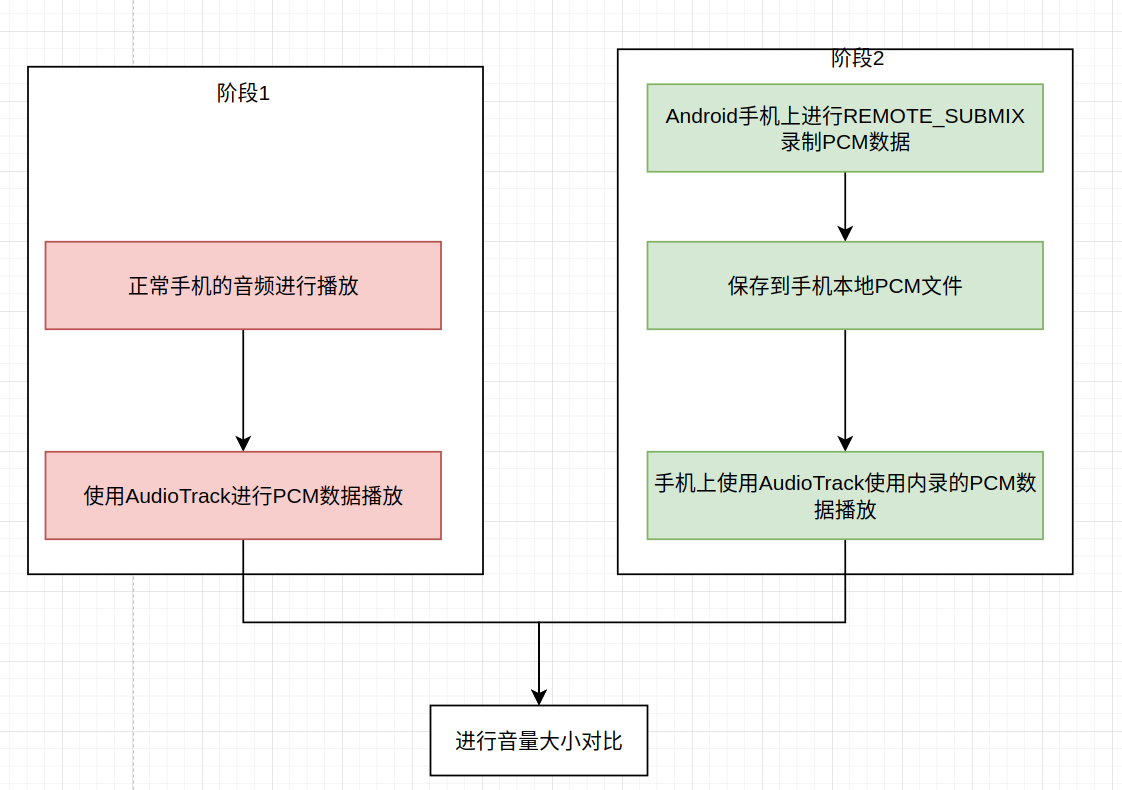
所以我们的分析该问题首先复现该问题思路流程如下:
在这里插入图片描述
测试复现过程中注意:大家播放时候一定要都是使用自己写的代码AudioTrack播放,切勿使用一个阶段mp3,另一个阶段使用AudioTrack播放pcm,让二者这块本身有差异,导致可能播放的OutputThread等都不一致。

原因调研剖析

正常播放情况:

Output thread 0x6ffbca0880, name AudioOut_15, tid 1874, type 0 (MIXER):
  I/O handle: 21
  Standby: no
  Sample rate: 48000 Hz
  HAL frame count: 1920
  HAL format: 0x1 (AUDIO_FORMAT_PCM_16_BIT)
  HAL buffer size: 7680 bytes
  Channel count: 2
  Channel mask: 0x00000003 (front-left, front-right)
  Processing format: 0x1 (AUDIO_FORMAT_PCM_16_BIT)
  Processing frame size: 4 bytes
  Pending config events: none
  Output devices: 0x2 (AUDIO_DEVICE_OUT_SPEAKER)
  Input device: 0 (AUDIO_DEVICE_NONE)
  Audio source: 0 (AUDIO_SOURCE_DEFAULT)
  Timestamp stats: n=4670 disc=28 cold=0 nRdy=0 err=13 rate=0.999998 jitterMs(ave=3.11586e-05 std=0.214696 min=-2.34047 max=2.15641) localSR(48000, 1.14338e-10) correctedJitterMs(ave=0.000355236 std=0.0181433 min=-0.465468 max=0.145208)
  Timestamp corrected: no
  Last write occurred (msecs): 49
  Process time ms stats: ave=1.42371 std=1.03049 min=0.491511 max=6.29083
  Hal write jitter ms stats: ave=-0.001908 std=0.847754 min=-4.07609 max=4.02198
  Threadloop write latency stats: ave=146.958 std=1.37849 min=140.084 max=148.385
  Master volume: 1.000000
  Master mute: off
  Mixer channel Mask: 0x3 (front-left, front-right)
  Normal frame count: 1920
  Total writes: 4694
  Delayed writes: 0
  Blocked in write: yes
  Suspend count: 0
  Fast track availMask=0xfe
  Standby delay ns=3000000000
  AudioStreamOut: 0x6e92e66110 flags 0x8 (AUDIO_OUTPUT_FLAG_DEEP_BUFFER)
  Frames written: 9012480
  Suspended frames: 0
  Thread throttle time (msecs): 572
  AudioMixer tracks: 86 98 
  Master mono: off
  Master balance: 0.000000 (balance 0 channelCount 2 volumes: 1 1)
  No FastMixer
Bluetooth latency modes are not enabled
HAL does not support Bluetooth latency modes
Supported latency modes: { }
  Stream volumes in dB: 0:-16, 1:-14, 2:-13, 3:0, 4:-4.8, 5:-8.7, 6:-inf, 7:-14, 8:-13, 9:0, 10:0, 11:0, 12:0, 13:0, 14:0
  Normal mixer raw underrun counters: partial=0 empty=0
  2 Tracks of which 1 are active
    Type     Id Active Client Session Port Id S  Flags   Format Chn mask  SRate ST Usg CT  G db  L dB  R dB  VS dB  PortVol dB   Server FrmCnt  FrmRdy F Underruns  Flushed BitPerfect InternalMute   Latency
             86     no   5521     305      71 A  0x00D 00000001 00000003  44100  3   1  0    -6    -6    -6     0         -inf 000A30EC   3536       0 A     94596        0      false        false  135.94 k
             98    yes   4891     353      87 A  0x000 00000001 00000001   8000  3   1  2     0     0     0     0            0 00017C00   2592    2592 A         0        0      false        false  471.28 t

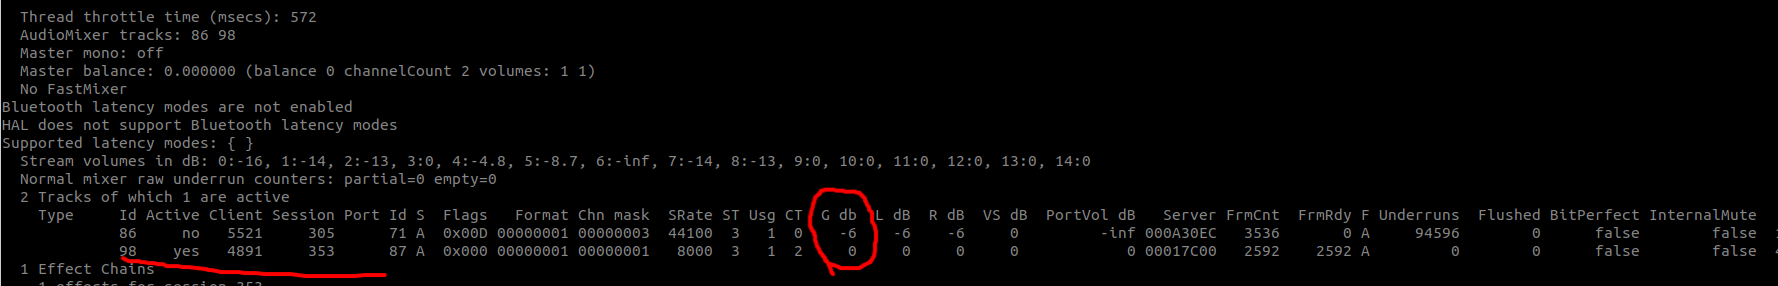
看得出播放音乐时候所在线程输出device为

 Output devices: 0x2 (AUDIO_DEVICE_OUT_SPEAKER)
在这里插入图片描述

可以看出正常情况下,这里的id为98的Active track的G db是0,也就是最大声音。

但是看看在内录声音时候的情况

Output thread 0x6ff581d880, name AudioOut_4D, tid 5859, type 0 (MIXER):
  I/O handle: 77
  Standby: no
  Sample rate: 48000 Hz
  HAL frame count: 1024
  HAL format: 0x1 (AUDIO_FORMAT_PCM_16_BIT)
  HAL buffer size: 4096 bytes
  Channel count: 2
  Channel mask: 0x00000003 (front-left, front-right)
  Processing format: 0x1 (AUDIO_FORMAT_PCM_16_BIT)
  Processing frame size: 4 bytes
  Pending config events: none
  Output devices: 0x8000 (AUDIO_DEVICE_OUT_REMOTE_SUBMIX)
  Input device: 0 (AUDIO_DEVICE_NONE)
  Audio source: 0 (AUDIO_SOURCE_DEFAULT)
  Timestamp stats: n=124 disc=1 cold=0 nRdy=0 err=0 rate=0.999947 jitterMs(ave=-0.000933826 std=2.41554 min=-10.9483 max=16.1616) localSR(48099.5, 8.55952e-06) correctedJitterMs(ave=-0.00776279 std=2.14526 min=-10.9483 max=16.1616)
  Timestamp corrected: no
  Last write occurred (msecs): 36
  Process time ms stats: ave=0.990861 std=1.06776 min=0.241823 max=10.5633
  Hal write jitter ms stats: ave=-0.320497 std=2.07707 min=-16.0205 max=2.75328
  Threadloop write latency stats: ave=62.2473 std=6.49902 min=8.23516 max=67.3149
  Master volume: 1.000000
  Master mute: off
  Mixer channel Mask: 0x3 (front-left, front-right)
  Normal frame count: 1024
  Total writes: 123
  Delayed writes: 0
  Blocked in write: yes
  Suspend count: 0
  Fast track availMask=0xfe
  Standby delay ns=3000000000
  AudioStreamOut: 0x6e92e6cba0 flags 0 (AUDIO_OUTPUT_FLAG_NONE)
  Frames written: 125952
  Suspended frames: 0
  
  Thread throttle time (msecs): 9
  AudioMixer tracks: 92 
  Master mono: off
  Master balance: 0.000000 (balance 0 channelCount 2 volumes: 1 1)
  No FastMixer
Bluetooth latency modes are not enabled
HAL does not support Bluetooth latency modes
Supported latency modes: { }
  Stream volumes in dB: 0:-16, 1:-11, 2:-8.7, 3:-33, 4:-4.8, 5:-8.7, 6:-inf, 7:-11, 8:-11, 9:0, 10:-23, 11:-21, 12:0, 13:0, 14:0
  Normal mixer raw underrun counters: partial=0 empty=0
  2 Tracks of which 1 are active
    Type     Id Active Client Session Port Id S  Flags   Format Chn mask  SRate ST Usg CT  G db  L dB  R dB  VS dB  PortVol dB   Server FrmCnt  FrmRdy F Underruns  Flushed BitPerfect InternalMute   Latency
             90     no    999       0       0 I  0x000 00000005 00000003  48000 13   f  0  -inf     0     0     0            0 00000000   3072       0 I         0        0      false        false       new
             92    yes   4891     321      81 A  0x000 00000001 00000001   8000  3   1  2   -33     0     0     0          -33 00005200   2592    2592 A         0        0      false        false  386.97 t

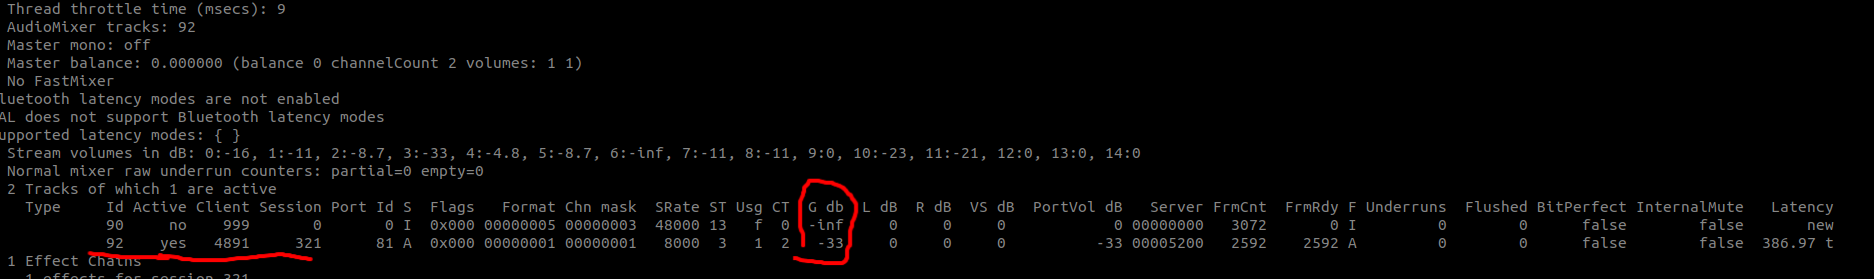
明显可以发现,这里的id为92的active track正在播放,他的输出设备是

 Output devices: 0x8000 (AUDIO_DEVICE_OUT_REMOTE_SUBMIX)

这个track的全局的音量系数为G db = -33
在这里插入图片描述
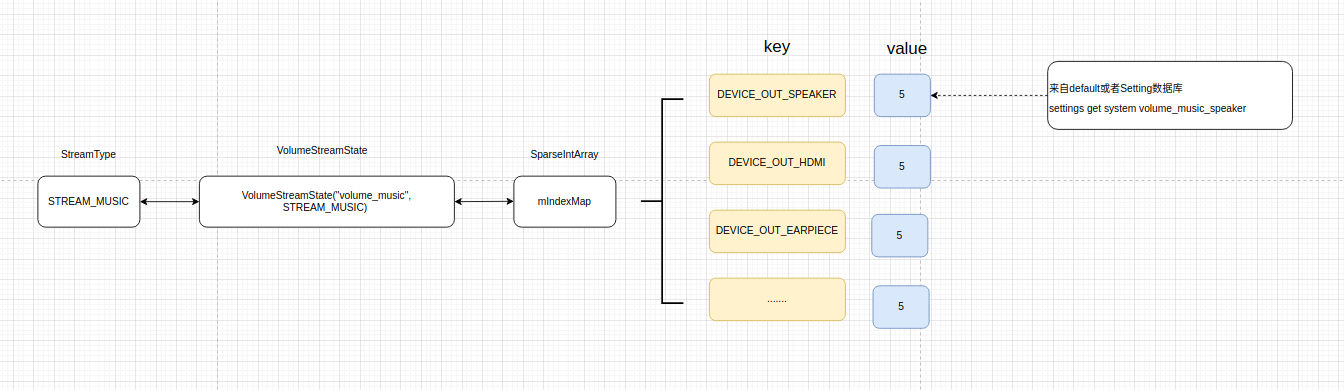
根据音频框架课程学习的,音量相关知识基础,可以得出内录时候投屏时候的音量为什么比较小的原因如下:
在这里插入图片描述
每个音量调节都是对应StreamType的VolumeStreamState里面mIndexMap,每个device对应的音量大小也是各自独立的,所以这个原因就导致同样是播放music这种StreamType的声音,但是明显AUDIO_DEVICE_OUT_SPEAKER发出声音大小比内录AUDIO_DEVICE_OUT_REMOTE_SUBMIX出来声音大。

就因为设备AUDIO_DEVICE_OUT_SPEAKER和设备AUDIO_DEVICE_OUT_REMOTE_SUBMIX属于不同的音量index值,需要单独针对应设备进行额外设置。

解决办法:

上面已经剖析清楚了相关直接播放的speaker声音比内录到的声音大的原因了,解决办法其实就比较简单,那就是需要针对内录情况下的设备AUDIO_DEVICE_OUT_REMOTE_SUBMIX对应的音量index和正常播放的设备AUDIO_DEVICE_OUT_SPEAKER音量index做成一致既可以。

做成一致方式很简单,可以用以下2种方式:
1、直接引导用户自己在内录声音时候要进行音量条的设置,因为这个时候输出设备是AUDIO_DEVICE_OUT_REMOTE_SUBMIX,所以音量调节就是针对这个设备的

2、直接系统框架子AudioService中,把AUDIO_DEVICE_OUT_SPEAKER的音量系数index,等比例映射到AUDIO_DEVICE_OUT_REMOTE_SUBMIX中即可以

ArcGIS山体坡度、坡向分析 本篇文章主要记录自己在对山体坡向及坡度分析中的一些操作。 阅读详情

相关推荐

vrep和matlab,使用Matlab与V-REP联合仿真 - Play V-REP with Matlab

OS: Win10 x64Matlab: R2016bV-REP: V-REP PRO EDU v3.5.0 下载、安装与支持V-REP操作基础V-REP仿真基础Matlab环境准备一个简单的例子对V-REP有一定了解的读者可以直接跳到第三节Matlab环境准备。下载、安装与支持V-REP提供Windows、Linux和MacOS三个平台的应用程序支持,任意平台都提供教育版和专业版两个版本。教育版...

weixin_42660494的博客 3213

SoundCard常见问题解答:从安装到高级应用的完整解决方案

SoundCard是一款纯Python实时音频库,能够帮助开发者轻松实现音频录制、播放和处理功能。本文将解答从安装配置到高级应用的常见问题,为新手和普通用户提供完整解决方案。 ## 一、快速安装SoundCard的正确方法 ### 1.1 使用pip一键安装 SoundCard支持通过pip直接安装,在终端中执行以下命令即可: ```bash pip install soundcard ```

gitblog_01076的博客 467

染色体外环状DNA:肿瘤研究新方向

染色体外环状DNA(ecDNA)是癌症中活化原癌基因扩增的主要方式。区别于常染色体,这类生物大分子主要以环状的形式存在于细胞核当中,长度分布在103-106数量级,无中心粒。ecDNA序列中包含一个或者多个基因与调控元件,结构开放,转录活性强,相比于在棒状染色体结构基因,ecDNA的生物功能活性更强。癌症中,成环的基因区域拷贝数往往增高,而超过一半的高拷贝数事件是ecDNA驱动生成。...

blackjimmy的博客 767

UML面向对象-分析、建模与设计(第三版·微课视频·题库版)顺序图画图

该顺序图展示了客户端(Client)通过事务对象(Transaction)与ODBC代理(ODBCProxy)的交互过程。客户端创建事务,设置操作参数并提交,事务调用代理完成数据设置,最后销毁事务。整个流程体现了对象间协作与生命周期管理,清晰展现了系统内部调用顺序与状态变化。

一亩高粱 35

复合材料RVE建模与力学性能分析实战指南

代表体积元(RVE)建模是复合材料多尺度分析的核心技术,通过建立微观结构与宏观性能的定量关联,可准确预测材料力学行为。本文基于ABAQUS平台,详细解析三材料(纤维/基体/界面相)RVE建模全流程,包括参数化几何建模、周期性网格划分策略、材料属性定义技巧等关键技术环节。针对碳纤维增强环氧树脂等典型复合材料,提供网格控制参数建议和材料参数参考表,并重点说明周期性边界条件的实现方法与验证标准。通过Python脚本自动化处理和优化分析流程,可显著提升计算效率,为复合材料设计提供可靠仿真依据。

weixin_34062469的博客 550

StarRocks慢查询排查实战:从Query Plan到Profile的保姆级调优指南

本文提供StarRocks慢查询排查的实战指南,从Query Plan解析到Profile诊断,详细讲解如何识别执行计划中的危险信号和优化关键指标。通过物化视图优化、分布式执行调整和资源管控方案,帮助DBA快速定位并解决查询性能问题,提升数据库效率。

weixin_42568801的博客 379

AI 视频进入智能体时代:一条短片,如何从灵感走到成片?

AI 视频创作正在从单点生成走向完整流程。本文结合 Adobe Firefly 的新动向,梳理从确定目标、准备授权素材、设计画面到配音字幕和发布前复核的五步方法,并介绍 Aivo容剪如何辅助团队衔接创作环节。

AIVOClaw的博客 148

服务器AutoDL自己部署QWen3

说明:核心参数:30B 模型原精度权重文件约 60GB,单张 PRO 6000 拥有 48GB 显存,单卡塞不下原精度模型,2张 PRO 6000 = 96GB 总显存,这不仅能装下模型,还能留出约 30GB 显存给 KV Cache(上下文长度) 以及 Omni 多模态组件 处理图片/视频输入时的额外开销。1. 前提准备模型选择:直接下载到 AutoDL 服务器上=》原精度模型(BF16/FP16) 的 Qwen3-Omni-30B,选择的示例和环境如下。# 3. 正式执行模型下载。

xiaoxiao_00001的博客 417

视频解说交付前,用 Python 检查字幕时轴与证据镜头是否对齐

用普通 SRT 和 Python 标准库复现两类字幕错误:时轴重叠,以及结论比证据画面提前出现。附可运行示例、修正结果和人工审片边界。

linan96的博客 150

Q3D提取PCB走线RLCG参数

介绍一种提取PCB走线寄生电容和寄生电感的方法

sinat_15150363的博客 2931

Redhawk: dynamic ir drop分析(Clock Buffer Clustering)

在dynamic分析中,ir drop问题多出现在三种情况下,缺power mesh,缺power switch,clock cell过于密集。 前两种情况通过选中具体instance查看min res path都比较容易分析出来,而且大部分问题都出现在channel里,这里不多做赘述。 clock cell过于密集这是观察结果,缺少报告支持,这里分享一下分析方法。 首先,选中压降超过signoff标准的instance,(Results->List of Worst Instance DVD中

m0_61544122的博客 5279

AI动画视频生成器免费在线怎么用?新手完整操作教程

AI动画视频生成器让零基础用户也能快速制作动画内容,本文拆解在线创作全流程:剧本构思、角色场景设定、提示词撰写、分镜生成、后期剪辑导出。对比免费版与付费版本的差异,讲解免费工具常见限制,分享素材导入、提升画面一致性的实操技巧,解答角色跑脸、提示词难写等高频问题,同时介绍适合短剧团队的规模化创作方案,帮助个人创作者和团队按需挑选AI动画工具。

2601_96477822的博客 555

【49】软考软件设计师——冲刺复盘:高频易错点与应试策略|复盘清单+应试技巧

本文是《软件设计师·50讲通关|从零基础到工程师职称》专栏第49篇,属于**模块六:冲刺与模拟**终篇,聚焦考前最后阶段的“精准复盘+应试提分”。全文围绕“高频易错点清零、答题时间优化、应急处理落地”三大核心,梳理9大知识领域的典型易错点(附避坑技巧)、优化版答题时间分配(含取舍策略)、考中全场景应急方案,配套可直接使用的“复盘清单”和“应试技巧手册”,帮助考生在最后阶段查漏补缺、固化得分逻辑,避免因低级错误丢分,以“稳、准、快”的状态应对考试。下一篇第50篇(终章)将进行全专栏知识体系回顾、考试策略总结

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 446

从一段视频到可漫游的 4D 有声场景:思路拆解与最小复现手记

只需一段手机视频,你就能生成可"走进去"的 4D 有声场景:转头时狗叫声方向随之变化,走近时声音更清晰。本文拆解 Video-to-4DAVScene 的核心思路,手把手带你用几十行 Python 搭出最小管线,把视频中的运动物体变成带空间位置的声源,并附上三个真实踩坑的排障经验,代码可直接跑。🎧

helloagent的博客 246

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

本地化部署会议视频软件如何替换旧平台?账号迁移、历史数据与用户培训怎么安排?

账号先映射:身份与权限验证通过,再开放使用。资料分级处理:能查、能读、权限正确,比“全部搬完”更重要。切换可恢复:入口、增量数据和业务通知都要纳入回退方案。培训按岗位落地:让用户完成真实任务,而不是只听功能介绍。这套方法适合政企、集团及医疗等具有长期资料留存、多终端接入和业务集成需求的组织。小规模替换可以简化批次与流程,但不应省略权限验证、备份恢复和关键会议演练。

hz56789的博客 292

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

打字就能剪视频的AI工具

AI 会替代剪辑师吗?这个问题和“AI 会替代程序员吗”一样,问错了方向。会用 AI 工具的人,正在替代不会用的人。一个剪辑师用传统方式花三天做的宣传片,另一个人用 UniCut 一天做完,质量差不多,市场会选谁,答案很明显。工具的进化从来不是把专业的人淘汰掉,而是把专业的门槛拆掉。浏览器已经打开了,剩下的就是你愿不愿意试一下。体验地址:https://unicut.h5ds.com/开源仓库:https://github.com/mtsee/unicut。

d676015863的博客 167

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

AI 礼盒开箱视频怎么做?让商品亮相更有仪式感

AI商品视频通过精细设计开箱动作与场景节奏,将礼盒从静态包装转化为沉浸式送礼体验。从暖光布景、情感化构图到手部停顿、商品细节特写,每一帧都传递“精致”与“珍视”。以珠宝礼盒为例,俯拍视角下,红色对开门展开如舞台揭幕,银色项链在深蓝夜空衬底中缓缓呈现,掌心承托、缓慢转动,强化视觉记忆。结尾平铺构图,礼盒与商品共存,情绪由期待落至静谧珍藏。全程无文字,靠画面叙事,实现仪式感与品牌调性的深度融合。

yunhhhhh的博客 132

RN鸿蒙空间音频实战

示例仓库:https://atomgit.com/m0_37170006/react-native-ohos-spatial-audio 社区导引:框架源码与版本发布见 https://atomgit.com/CPF-RN/ohos_react_native/tree/0.84-main CPF-RN 鸿蒙社区:https://atomgit.com/CPF-rn。

buhuisuanfa的博客 2万+

通过 AIGC 生成视频何时才能告别“抽卡”!

如果视频的主体内容已经符合要求,只存在错误字幕或局部画面瑕疵时,重新生成不仅增加成本,还可能改变原本满意的部分。针对这类问题,WAND-EraseVibe+ 提供了视频擦除与画面重建能力。根据腾讯云披露的技术方案,该工具采用基于隐空间 Transformer 的生成式修复架构,先将视频画面编码为隐空间特征,在特征层推断并重建需要修复的区域,再解码为视频画面。白模前置、垂直场景调优和局部修复分别作用于不同环节,目的都是减少为了获得可用内容而付出的重复生成成本。

Enweitech Software Works 166

网页视频资源识别与本地化管理:从 HTTP 流媒体技术到完整的视频工作流

现代网页视频技术已经从简单的文件传输发展到分段传输、自适应码率和浏览器端媒体处理。这使视频播放体验不断改善,也让资源识别和本地管理变得更加复杂。对于技术人员而言,理解 HTTP、HLS、MPEG-DASH 和 MSE 的基本工作机制,有助于更准确地分析网页视频的传输过程。对于视频创作者和研究人员而言,建立从内容发现、资源识别到本地整理的完整工作流,可能比单纯寻找一个下载工具更有长期价值。

m0_68263549的博客 455

Android 音频 Player 体系

Android 音频框架中,"Player"是统一抽象的音频播放实例,涵盖 AudioTrack、MediaPlayer 等。每个 Player 由唯一 piid 标识,通过 PlayerBase 注册至 PlaybackActivityMonitor,状态机管理其生命周期(idle→started→stopped→released)。关键事件如 portId 绑定、静音(位掩码标识主静音、音量为0等)、设备切换等均通过 PLAYER_UPDATE_* 通知系统。静音原因以掩码形式记录,日志中“source

aningxiaoxixi的博客 167

[黎阳之光] 边海防无人机巡检实战教程:航线规划、目标发现与视频孪生联动一次讲透

本文给出的是简化版模型与参考框架,面向真实项目的完整落地,还需结合具体海域、设备与业务规则做针对性设计。它的角色不是替代固定感知,而是做“机动确认层”——雷达和固定视频负责发现,无人机负责在 10 分钟内飞到目标上空,把“有个点”变成“看清是什么”。数据流的关键指标:无人机视频接入孪生平台延迟不超过 800ms,位置上报频率 1Hz,吊舱角度反馈 10Hz。位置或角度一滞后,图上无人机的视野锥就会和实际画面错位,指挥员按图指挥就会指错地方。这样既不断档,又不烧钱。

m0_75019831的博客 319

15. 调用ComfyUI生成视频!

在“导演大师”中,我们不仅支持导出分镜导演包并一键导入运行,还为用户提供了极高的自定义自由度。许多创作者希望结合自己精心调试的 MiniMax H3 工作流来生成视频,这当然是完全支持的。通常有两种操作方式:一种是手动复制,将分镜的资产与提示词手动粘贴至本地工作流中;另一种则是更为高效的自动化方案——直接在“导演大师”中调用 ComfyUI 工作流,实现一键生成。本文将重点介绍后者的配置与使用全流程,帮助你打通从分镜脚本到视频直出的自动化链路。

2601_95544990的博客 291

面向强噪声工业场景的 KL‑2510 音频 DSP 模组设计与多场景落地分析

KL-2510是一款22×16mm邮票孔SMT封装音频模组,集成ADC/DAC、AI-ENC降噪(45–90dB)与AEC回声消除(100dB),支持USB免驱及模拟/PDM麦克风输入,具备4档硬件拾音增益,适配医疗、矿山、安防等复杂噪声场景。通过五类真实案例验证其在病房对讲、井下报警、门铃对讲等应用中的稳定性与易用性。重点提示:需接入AEC_IN参考信号、输出加分压电路、外设勿接3V3电源,避免烧毁。适用于空间紧凑、无算法团队的嵌入式项目,显著降低音频开发门槛。

R190_6589的博客 419

翻译配音后音画对不上?用 ffmpeg + Python 把新音轨对齐到原视频时间轴

做视频出海、课程本地化的同学迟早会撞上这个坑:原片是中文 3 分钟口播,你换成英文 AI 配音后,要么配音在 2 分 10 秒就播完了、后面画面在放"默片",要么配音拖到 4 分钟、视频早黑屏了——也就是**音画不同步(A/V desync)**。 根因很简单:不同语言的"信息密度"不一样。同一段意思,英文往往比中文多 30%~50% 的音节,中文又比英文短。你把原音轨换成翻译后的配音,新音轨长度和原视频时间轴天然对不上。本文把"怎么测量偏差、怎么用 ffmpeg 把新音轨拉伸/压缩到刚好贴合原视频、...

weixin_60261120的博客 352

视频已经变模糊了,为什么还是会卡?

视频播放中画质忽清忽糊、画面转圈,根源在于下载速率与缓冲消耗不匹配。即使测速快,也未必能持续支撑高画质播放。自适应码率切换需综合考虑缓冲余量、持续吞吐与切换成本,盲目升档易导致卡顿。测试时应固定片源、模拟真实网络变化,记录缓冲、切换与停顿细节,结合下载、缓冲与轨道变化时间线分析问题,才能优化体验。稳定中等画质往往比频繁跳变更可接受。

NetworkSimulator的博客 266
上一篇: 安卓闪黑黑屏分析工具:aosp14/15版本Winscope之SurfaceFlinger信息剖析
下一篇: Android系统基础:底层状态监听UEvent之UEventObserver源码分析
千里马学框架
博客等级 码龄6年 1万+粉丝 652原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

千里马学框架

帮助你了,就请我喝杯咖啡

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值