CAMR2.0数据集介绍,编号LDC2021T13

NLP 自然语言处理数据集 粗略 收集匆忙,并不保证准确 dataset index dataset Abbreviation task note 1 LiBriSpeech Automatic speech recogniton 2 WSJ Automatic speech recogniton 3 Hub5’00 Evaluation Automatic speech recogniton ... 阅读详情

Chinese AMR(中文抽象意义表示)数据集是用于中文自然语言处理任务的一个重要资源。这个数据集的目标是提供一个统一的、跨语言的语义表示框架,以便更好地理解和分析中文文本的含义。

在数据内容上,Chinese AMR 数据集涵盖了多种来源的文本数据,包括新闻、讨论论坛、博客等。同时,为了丰富数据集的语义内容,它还可能引入了一些新的数据源,如来自特定文学作品或专业领域的句子等。

Chinese AMR 数据集在自然语言处理领域具有广泛的应用价值。它可以用于各种语义相关的任务,如语义角色标注、关系抽取、文本摘要、问答系统等。通过利用这个数据集,研究人员可以开发更加准确和高效的自然语言处理算法和模型,推动自然语言处理技术的不断进步。文件结构如下:
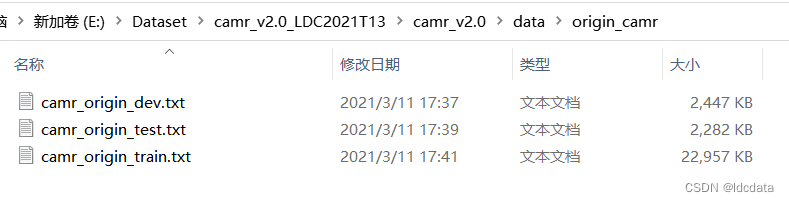
 获取方法:

方法1:注册LDC账号并加入组织获取数据,官网链接:LDC官网

方法2:关注公众号,回复CAMR2.0LDC语料小助手icon-default.png?t=N7T8https://mp.weixin.qq.com/s/8GgZFh9XAr7FYwivQ_ajRg


(三十四)人工智能应用--自然语言处理--自然语言处理概述 自然语言处理(NLP)是让机器理解人类语言的交叉学科,涵盖语音识别、语义理解与生成。其发展历经规则驱动、统计学习到深度学习三阶段,核心突破在于词向量(如Word2Vec)实现语义表示。课程以“三层金字塔”框架梳理基础技术、核心技术与应用实践,并强调数据维度:文本为2D,序列3D,图像4D,视频5D,第一维恒为样本数。掌握文本→ID→Embedding的转化链路,是构建模型的基础。 阅读详情

相关推荐

简述 LLaMA(Large Language Model Meta AI)的基本原理

简述 LLaMA(Large Language Model Meta AI)的基本原理

我哎GIS博客 297

AMR2.0数据集介绍,编号LDC2017T10

AMR2.0数据集常用于文本任务,其文件结构如下:

ldcdata的博客 320

ST-LLM+ 交通拥堵预警:把路网邻接矩阵塞进大语言模型

空间智能实验室 Vol.16:ST-LLM+ 交通拥堵预警:把路网邻接矩阵塞进大语言模型 大语言模型做交通预测,听起来像蹭概念,其实这条路线有明确的技术动机:交通流量的时序模式和人话里的时序模式长得一样,上下文、周期、趋

yilvyangguang520的博客 134

免费数据集下载

目前系统整理了一些网上开放的免费科研数据集,以下是分类列表以及下载地址,供高校和科研机构免费下载和使用。 金融 美国劳工部统计局官方发布数据 上证A股日线数据,1999.12.09 至 2016.06.08,前复权,1095支股票 深证A股日线数据,1999.12.09 至 2016.06.08,前复权,1766支股票 深证创业板日线数据,1999.12.09 至 2016.06.0...

weixin_30367543的博客 1万+

阿里云人工智能工程师ACA认证免费课程学习笔记

阿里云人工智能工程师ACA认证免费课程学习笔记

engchina的专栏 2013

2021年J题:基于STM32F103的周期信号波形识别与参数测量系统设计(立创EDA+SZPT_ZXL)

本文详细复盘了2021年全国大学生电子设计竞赛J题获奖项目,手把手教你如何基于STM32F103微控制器设计并实现周期信号波形识别与参数测量系统。文章深入剖析了硬件电路设计(包括程控放大、工作点抬升与滞回比较器)与核心软件算法(如动态采样、FFT频谱分析与波形识别逻辑),并分享了DMA传输、FFT库使用等实战要点与避坑指南,为嵌入式信号处理与电赛备赛提供了宝贵经验。

weixin_32673065的博客 227

论文阅读之:基于序列列到到序列的中文AMR解析;Chinese AMR Parsing based on Sequence-to-Sequence Modeling

本文使用中文 AMR 语料库 CAMR1.0 采用 seq2seq(Transformer)的方法进行中文AMR语义解析本文中文AMR语义解析方法最优性能达到了70.29的Smatch F1值。本文是第一次在该数据集上报告实验结果。

qq_42902997的博客 1105

金蝶云星空API实战:从零到一,用Postman打通业务数据流

本文详细介绍了如何使用Postman调试金蝶云星空API,从创建第三方应用到实战调试技巧,帮助开发者快速打通业务数据流。文章重点讲解了API配置的关键细节、常见问题排查方法以及自动化测试方案,提升开发效率与准确性。

weixin_33712987的博客 518

论文代码复现之:AMR Parsing as Sequence-to-Graph Transduction

接着运行如下命令,就会自动对 LDC2017T10 中的数据进行预处理,然后将所有的数据分配到。只需要按照作者 github 的命令即可,要下载的东西挺多的。,我们就把这个数据集解压到。

qq_42902997的博客 956

MAX96717实战:如何选择Host-to-Peripheral和Pass-Through I2C模式?附配置代码

本文深入解析MAX96717芯片的两种关键I2C模式:Host-to-Peripheral与Pass-Through。通过对比其核心差异、硬件连接考量及软件配置代码,为嵌入式开发者提供了清晰的模式选择策略与实战指南,帮助优化系统设计并避免常见通信故障。

weixin_29190573的博客 460

什么是 PD 电压诱骗?

电压诱骗” 的意思就是,使用某些方法让 PD 充电器误以为设备需要更高的电压,从而让充电器提供比实际需要更高的电压。手机可能只需要 5V,但笔记本电脑可能需要 20V,通过 PD 协议,充电器能够根据设备的需求输出合适的电压和电流。在“电压诱骗”的情况下,你通过某种手段让充电器以为设备需要 12V,于是充电器会按照这个伪造的请求输出 12V,而不是默认的 5V。充电器评估自己的能力,如果可以提供设备需要的电压和电流,它会调整输出电压,从默认的 5V 切换到设备请求的电压(如 12V)。

qq_45430571的博客 2657

ACL2022 | 抽象语义表示——建构、处理与应用的新进展

每天给你送来NLP技术干货!来自:复旦DISC引言TreeBank 作为自然语言语法的结构化表示可谓广为人知,其实在语义层面也有一种类似的结构化方法——抽象语义表示(Abstract Meaning Representation,AMR)。它能记录自然语言文本中最重要的语义信息,但并不限制实际表达时的语法结构。本次分享我们将向读者介绍 ACL 2022 中与 AMR 有关的三篇论文,一窥 AMR ...

zenRRan的博客 3032

【ArcGIS风暴】Win10操作系统ArcGIS许可License无法启动的解决方法汇总(绝对成功!)

文章目录1. 关闭Windows Defender2. 关闭系统防火墙3. 删除迈克菲(McAfee)杀毒软件4. 在系统服务中启动 在安装ArcGIS软件时,最重要的一步是许可服务的正常启动,通常,由于各种各样的原因,ArcGIS许可管理器License Manager十有八九会无法启动,点N多次都没反应,如果许可服务不能如愿启动的话,即使Desktop安装成功,也是无法打开的。本文汇总了Win10操作系统之上ArcGIS安装过程中可能会导致服务无法启动的原因及解决办法。 ArcGIS安装参考教程:

智慧空间实验室 2万+

自然语言处理的技术演进与核心任务

从早期的规则与统计方法,到以神经网络为代表的深度学习方法,再到当前以大规模预训练语言模型为主导的范式,这一领域发生了深刻变化。早期的自然语言处理高度依赖人工编写的语言规则与词典,虽在受限场景可用,却难以覆盖语言的开放性与多样性。这种先通识后专精的范式,使自然语言处理从分散的小模型走向统一的能力底座,也催生了对话、写作、摘要等丰富应用。对话系统把理解与生成结合,在上下文中持续回应。这类能力极大提升了内容生产的效率,但也带来事实准确性与原创性的挑战,需要配合检索与人工审核,避免流畅却失实的表达误导读者。

renhongxia1的博客 502

YOLOv8改进 | 融合篇,YOLOv8主干改进融合网络之MobileNetV3+CA注意机制,助力涨点

MobileNetV3通过结合硬件感知网络架构搜索(NAS)和NetAdapt算法,通过新颖的架构改进进一步提升了性能。YOLOv8中的主干网络替换成MobileNetV3+引入CA注意机制

在职AI算法工程师,擅长计算机视觉,YOLO目标检测、分割等,擅长web、pyqt界面可视化,好内容持续更新中,来这里跟大家一起学习,共同进步 1881

【k8s故障处理篇】calico-kube-controllers状态为“ImagePullBackOff”解决办法

【k8s故障处理篇】calico-kube-controllers状态为“ImagePullBackOff”解决办法

jks212454的博客 2307

总结1:大语言模型概述

AI是什么 → AI发展从1.0到2.0的演变 → 什么是大语言模型LLM → 市面上常见大模型介绍 → 大模型各行各业落地应用 → 大模型未来趋势与现存挑战、解决办法

xiaobaivera的博客 382

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

11.04 大语言模型研究简报:OpenAI 工程 Agent 在 BenchCAD 2.0 上达到 0.875 分

大型语言模型的应用场景正在从代码编写延伸至真实的工程设计。2026 年 11 月 3 日,OpenAI 发表《Accelerating engineering for the physical world》,介绍 GPT-6 Astra 与 Codex 在机械设计、计算机辅助设计(CAD)、印刷电路板(PCB)设计、有限元分析(FEA)及制造工作流中的应用。

qq_48717745的博客 406

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

港大 RosettaSim 让语言模型学会长时交通仿真(ECCV 2026)

在验证集 2% 子集、骨干冻结及单个 epoch 的训练预算下,Qwen2.5-0.5B-Instruct 的综合分数达到 0.7620,优于 Llama-3.2-1B-Instruct 的 0.7594、TinyLlama 的 0.7397 和 GPT-2-Small 的 0.5425。SMART 和 CAT-K 的行为整体分数较高,而 RosettaSim 在持续补充新参与者的同时,取得了更好的交通流表现与综合分数。在常见的短时设置中,模拟器主要关注初始场景里的参与者,预测它们接下来如何运动。

soaring_casia的专栏 111

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

论文 | WebCopass:面向代码语言模型的多模态Web编码评估 | 多模态网页编码评估基准

WebCompass:面向代码语言模型的多模态Web编码评估多模态基准测试平台完整的 lifecycle:生成-编辑-修复用任务感知评估方法,需要强大的功能推理能力,还深入的视觉设计理解和更高的输出一致性。代码生成评估流程图:流程:模型上下文协议(MCP)对真实浏览器的控制。

weixin_42479421的博客 106

新书预告 从《Transformer与大语言模型》到《LLM量化实战》

《Transformer 与大语言模型》完结,新系列《LLM 量化实战》启动。上一本解析“为什么”设计大模型,本册聚焦“怎么”让模型变小变快——从FP16到4-bit量化,详解GPTQ、AWQ、QLoRA、GGUF等技术,结合RTX 4090实测,手把手教你压缩模型、降低显存、部署推理。适合想在8GB~24GB显存设备上运行7B/70B模型的开发者与工程师。原理+实战双线并进,只写真实跑通的结果。

AI服务生活 331

总结2:大语言模型入门

我用开一家AI小餐馆做整套比喻: 把大模型想象成一家餐馆,大语言模型就是餐馆本身;训练原理就是装修、培训后厨;使用技巧是顾客怎么点菜才能吃到合心意的菜;解决幻觉就是避免后厨瞎编菜品;Agent智能体是雇来的全能店长;模型生态就是选后厨是自研(开源)还是外包(闭源),以及调整后厨规模大小。下面按顺序梳理,每个专业术语配一句话解释+生活化例子。

xiaobaivera的博客 716

来自Transformers的双向编码器表示(BERT)

BERT是一种基于Transformer编码器的双向预训练语言模型,通过自监督学习在大规模语料上进行掩蔽语言模型(MLM)和下一句预测(NSP)任务预训练。其输入包含词元、片段和可学习位置嵌入,利用双向上下文表示词元。预训练后,可微调用于下游自然语言处理任务。实验表明,BERT能生成上下文敏感的词向量,有效捕捉语义信息。

2301_76293625的博客 212

TALLRec:一种有效且高效的调优框架,使大型语言模型与推荐保持一致

大型语言模型(LLM)在不同领域表现出了卓越的性能,从而促使研究人员探索其在推荐系统中的应用潜力。最初的尝试利用了 LLM 的卓越能力,例如通过上下文学习丰富的知识和强大的泛化能力,其中涉及将推荐任务表述为提示。然而,由于LLM的训练任务和推荐任务之间存在巨大差异,以及预训练期间的推荐数据不足,LLM在推荐任务中的表现仍然不够理想。为了弥补这一差距,我们考虑通过使用推荐数据调整 LLM 来构建大型推荐语言模型。为此,我们提出了一个高效且有效的调整框架,用于使 LLM 与建议保持一致,即 TALLRec。

flying_1314的博客 228

编码器与解码器深度解析:BERT与GPT的本质区别(附Transformer架构对比)

## 学习目标 掌握Transformer架构中编码器(Encoder)与解码器(Decoder)的核心结构与作用 理解BERT(纯Encoder模型)与GPT(纯Decoder模型)的本质差异 学会根据任务场。全文依次讲解Transformer架构:编码器与解码器的母体、编码器的代表:BERT——理解之王等内容。

2602_96795563的博客 350
上一篇: Multi-Channel WSJ Audio数据集介绍,编号LDC2014S03
下一篇: PDTB3.0数据集介绍,编号LDC2019T05
ldcdata
博客等级 码龄3年 81粉丝 26原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值