


List和set和map的区别?
Java中的集合包括三大类,它们是Set(集合)、List(列表)和Map(映射),它们都处于java.util包中,Set、List和Map都是接口,它们有各自的实现类。Set的实现类主要有HashSet和TreeSet,List的实现类主要有ArrayList
List和set的区别
1、List,Set都是继承自Collection接口
2、List(有序,可重复):元素有放入顺序,按对象进入的顾序保存对象,可重复,允许多个NUll元素对象。另外list支持for循环,也就是通过下标来遍历,也可以使用Iterator(迭代器)取出所有元素再逐一遍历,还叫以使用get(int index)获收指定下标的元素。
3、set(无序,不可重复):元素无放入顺序,元素不可重复,重复元素会覆盖掉,最多允许有一个NUIl元素对象,(元素虽然无放入顺序,但是元素在set中的位置是有该元素的HashCode决定的,其位置其实是固定的)取元素时只能用Iterator(迭代器)接口取得所有元素,再逐一遍历各个元素。
Map (使用键值对存储):
- 使用键值对(key-value)存储,每个元素包含一个键和一个相关联的值。
- 键(key)是唯一的,但值(value)可以重复。
- 可以通过键来访问值,通常使用键来查找相关的值。

参考:Java | 怎样从集合类set中取出数据?_java获取set中的值-优快云博客
HashMap 和 Hashtable 的区别
1. 线程是否安全: HashMap 是非线程安全的,HashTable 是线程安全的;HashTable 内部的方法基本都经过 synchronized 修饰。(如果你要保证线程安全的话就使用 ConcurrentHashMap 吧!);
2. 效率: 因为线程安全的问题,HashMap 要比 HashTable 效率高一点。另外,HashTable 基本被淘汰,不要在 代码中使用它;
3. 对Null key 和Null value的支持: HashMap 中,null 可以作为键,这样的键只有一个,可以有一个或多个键 所对应的值为 null。。但是在 HashTable 中 put 进的键值只要有一个 null,直接抛出NullPointerException(空指针异常)。
4. 初始容量大小和每次扩充容量大小的不同 : ①创建时如果不指定容量初始值,HashMap 默认的初始化大小为16,之后每次扩充,容量变为原来 的2倍;Hashtable 默认的初始大小为 11,之后每次扩充,容量变为原来的2n+1。②创建时如果给定了容量初始值,HashMap 会将其扩充 为2的幂次方大小。(HashMap 中的 tableSizeFor() 方法保证,下面给出了源代码), Hashtable 会直接使用给定的大小。
5. 底层数据结构: JDK1.8 以后的 HashMap 在解决哈希冲突时有了较大的变化,当数组长度超过64、链表高度达到8的时候,将链表转化为红黑树,以减少搜索时间。Hashtable 没有这样的机制。
推荐使用:在 Hashtable 的类注释可以看到,Hashtable 是保留类不建议使用,推荐在单线程环境下使用 HashMap 替代,如果需要多线程使用则用 ConcurrentHashMap 替代。
下面这个方法保证了 HashMap 总是使用2的幂作为哈希表的大小。
/**
* Returns a power of two size for the given target capacity.
*/
static final int tableSizeFor(int cap) {
int n = cap - 1;
n |= n >>> 1;
n |= n >>> 2;
n |= n >>> 4;
n |= n >>> 8;
n |= n >>> 16;
return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1;
}
HashMap和ConcurrentHashmap 的区别?
-
都是 key-value 形式的存储数据;
-
HashMap 是线程不安全的,ConcurrentHashMap 是 线程安全的;
-
(JDK 1.8 之前)HashMap 底层数据结构是数组 + 链表。JDK 1.8 之后是数组 + 链表 + 红黑树。当数组长度超过64、链表高度达到8的时候,将链表转化为红黑树,以减少搜索时间;
-
在 JDK1.7 的时候,ConcurrentHashMap (分段锁) 对整个桶数组进行了分割分段(Segment),每一把锁只锁容器其中一部分数据,多线程访问容器里不同数据段的数据,就不会存在锁竞争,提高并发访问率。 到了 JDK1.8 ConcurrentHashMap取消了Segment分段锁,采用CAS和synchronized来保证并发安全,数据结构为Node 数组+链表+红黑树的来实现。
HashMap底层实现是什么?
底层实现:数组+链表实现(HashMap的底层原理)
从JDK1.8开始数组长度超过64、链表高度到8,链表转变为红黑树,元素以内部类Node节点存在
-
计算key的hash值,二次hash然后对数组长度取模,对应到数组下标
-
如果没有产生hash冲突(下标位置没有元素),则直接创建Node存入数组
-
如果产生hash冲突,先进行equal比较,相同则取代该元素;不同,则判断链表高度插入链表,链表高度达到8,并且数组长度到64则转变为红黑树,长度低于6则将红黑树转回链表
-
key为null,存在下标0的位置
hashmap扩容机制

为什么HashMap的长度必须是2的n次幂?
hashmap在确定元素落在数组的位置的时候,计算方法是(n - 1) & hash,n为数组长度也就是初始容量 。hashmap结构是数组,每个数组里面的结构是node(链表或红黑树),正常情况下,如果你想放数据到不同的位置,肯定会想到取余数确定放在那个数组里,计算公式:hash % n,这个是十进制计算。在计算机中, (n - 1) & hash,当n为2次幂时,会满足一个公式:(n - 1) & hash = hash % n,并且采用二进制位操作 &,相对于%能够提高运算效率计算更加高效。

ArrayList与LinkedList异同
相同点
-
线程安全:都是线程不安全的
-
顺序:都是按照存入的顺序取出
不同点
ArrayList:基于动态数组,连续内存存储,根据下标随机访问数组元素的效率高,向数组尾部添加元素的效率高;但是,删除数组中的数据以及向数组中间添加数据效率低,因为需要移动数组。
例如最坏的情况是删除第一个数组元素,则需要将第2至第n个数组元素各向前移动一位。而之所以称为动态数组,是因为Arraylist在数组元素超过其容量大,Arraylist可以进行扩容(针对JDK1.8 数组扩容后的容量是扩容前的1.5倍)
扩容机制:因为数组长度固定,超出长度存数据时需要新建数组,然后将老数组的数据拷贝到新数组,如果不是尾部插入数据还会涉及到元素的移动(往后复制一份,插入新元素)使用尾插法并指定初始容量可以极大提升性能、甚至超过linkedList(需要创建大量的node对象)
LinkedList:基于链表,可以存储在分散的内存中,适合做数据插入及删除不适合查询数据,需要逐一遍历。
遍历LinkedList必须使用iterator不能使用for循环,因为每次for循环体内通过get(i)取得某一元素时都需要对list重新进行遍历,性能消耗极大。
另外不要用indexOf等返回元素索引,并利用其进行遍历,因为使用indexOf对list进行遍历,当结果为空时会遍历整个列表。
参考:
【153期】面试官:谈谈常用的Arraylist和Linkedlist的区别-腾讯云开发者社区-腾讯云 (tencent.com)
ArrayList和LinkedList有何异同?_5.arraylist和linkedlist的异同-优快云博客
ArrayList扩容机制详细
面试官让我说一说ArrayList的扩容机制?【小白必看-3】_面试题详细描述arraylist扩容原理-优快云博客
ArrayList扩容机制
打开idea中ArrayList类的源码,ArrayList中有两个属性,size:表示ArrayList的长度,elementData数组:用来存储数据的数组。
在Arraylist扩容时,调用Add方法,
###方法中会首先判断得到最小扩容量,如果你构造的ArrayList是用无参构造,即你创建ArrayList时没有确定它的长度,最小扩容量就为10和size+1当中的最大值,
###然后再判断是否需要扩容,如果最小扩容量大于elementData.length,就需要扩容,然后调用grow()方法,其中旧容量为elementData.length,新容量为elementData.length的1.5倍(new=old+old>>1),
##若新容量大于size+1,最小需要容量就为新容量,若新容量小于size+1,最小需要容量就为size+1,之后再将原来的数组用Arrays.copyOf方法复制到新数组,使新数组的长度为最小需要容量。
Java--IO--字节流与字符流的区别
Java--IO--字节流与字符流的区别_java怎么判断用字符流还是字节流-优快云博客
final和finally和finalize的区别。
final可以修饰类、变量、方法,修饰类表示该类不能被继承、修饰方法表示该方法不能被重写、修饰变量表 示该变量是一个常量不能被重新赋值。
finally一般作用在try-catch代码块中,在处理异常的时候,通常我们将一定要执行的代码方法finally代码块 中,表示不管是否出现异常,该代码块都会执行,一般用来存放一些关闭资源的代码。
finalize是一个方法,属于Object类的一个方法,而Object类是所有类的父类,该方法一般由垃圾回收器来调 用,当我们调用System.gc() 方法的时候,由垃圾回收器调用finalize(),回收垃圾,一个对象是否可回收的 最后判断
JDK1.8的新特性。
JDK1.8增加default方法。
接口内部包含了一些默认的方法实现(也就是接口中可以包含方法体,这打破了Java之前版本对接口的语法限制) 。之前的接口是个双刃剑,好处是面向抽象而不是面向具体编程,缺陷是,当需要修改接口时候,需要修改全部实现该接口的类。
default使得开发者可以在不破坏二进制兼容性的前提下,往现存接口中添加新的方法,即不强制那些实现了该接口的类也同时实现这个新加的方法。
二进制兼容性:指的就是在升级(也可能是 bug fix)库文件的时候,不必重新编译使用这个库的可执行文件或使用这个库的其他库文件,程序的功能不被破坏。
实际开发中应该谨慎使用:在复杂的继承体系中,默认方法可能引起歧义和编译错误。
 package com.example;
 interface MyInterface{
     default void sayHello(){
         System.out.println("sayHello");
     }
 }
 class MyInterfaceImpl implements MyInterface{
     public void test(){
     }
 }
 public class Demo {
     public static void main(String[] args) {
         MyInterfaceImpl myInterface = new MyInterfaceImpl();
         myInterface.sayHello();
     }
 }
 //运行结果
 //sayHello
注意:如果两个接口都用default修饰同一方法,则会报错
 package com.example;
 interface MyInterface1{
     default void sayHello(){
         System.out.println("sayHello(1)");
     }
 }
 interface MyInterface2{
     default void sayHello(){
         System.out.println("sayHello(2)");
     }
 }
 class MyInterfaceImpl implements MyInterface1,MyInterface2{
     public void test(){
         MyInterface1 myInterface = new MyInterfaceImpl();
         myInterface.sayHello();
     }
 }
 public class Demo {
     public static void main(String[] args) {
         MyInterfaceImpl impl = new MyInterfaceImpl();
         impl.test();
     }
 }
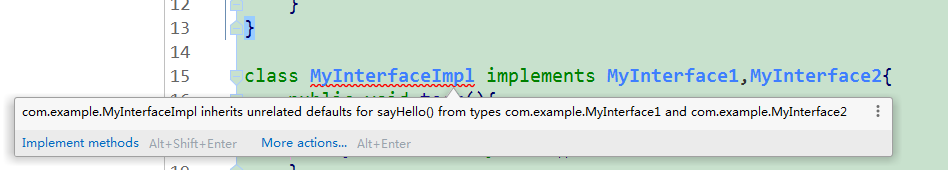
解决办法:在实现类中重写该方法。
 package com.example;
 interface MyInterface1{
     default void sayHello(){
         System.out.println("sayHello(1)");
     }
 }
 interface MyInterface2{
     default void sayHello(){
         System.out.println("sayHello(2)");
     }
 }
 class MyInterfaceImpl implements MyInterface1,MyInterface2{
     public void test(){
         MyInterface1 myInterface = new MyInterfaceImpl();
         myInterface.sayHello();
     }
     @Override
     public void sayHello() {
         System.out.println("sayHello(Impl)");
     }
 }
 public class Demo {
     public static void main(String[] args) {
         MyInterfaceImpl impl = new MyInterfaceImpl();
         impl.test();
     }
 }
 //运行结果
 //sayHello(Impl)
JDK1.8新增了static函数。static修饰的方法也是非抽象方法,有自己的方法体,在接口中定义一个静态方法,该方法可以直接用< 接口名.方法名() >的形式来调用。相当于调用类的静态方法一样
 package com.example;
 interface MyInterface{
     static void sayHello(){
         System.out.println("sayHello");
     }
 }
 public class Demo {
     public static void main(String[] args) {
         MyInterface.sayHello();
     }
 }
 //运行结果
 //sayHello
Java语言如何进行异常处理;
Throw和throws区别;
关键字:throws,throw,try,catch,finally 分别代表什么意义,在 catch 块中可以抛出异常吗?
Java的异常处理机制
Java 通过面向对象的方法进行异常处理,一旦方法抛出异常,系统自动根据该异常对象寻找合适
异常处理器(Exception Handler)来处理该异常,把各种不同的异常进行分类,并提供了良好的
接口。在 Java 中,每个异常都是一个对象,它是 Throwable 类或其子类的实例。当一个方法出现
异常后便抛出一个异常对象,该对象中包含有异常信息,调用这个对象的方法可以捕获到这个异常
并可以对其进行处理。Java 的异常处理是通过 5 个关键词来实现的:try、catch、throw、throws
和 finally。
在Java应用中,异常的处理机制分为声明异常,抛出异常和捕获异常。
1. 声明异常
通常,应该捕获那些知道如何处理的异常,将不知道如何处理的异常继续传递下去。传递异常可以
在方法签名处使用 throws 关键字声明可能会抛出的异常。
注意:非检查异常(Error、RuntimeException 或它们的子类)不可使用 throws 关键字来声明要抛出的
异常。
一个方法出现编译时异常,就需要 try-catch/ throws 处理,否则会导致编译错误。
2. 抛出异常
如果你觉得解决不了某些异常问题,且不需要调用者处理,那么你可以抛出异常。
throw关键字作用是在方法内部抛出一个 Throwable 类型的异常。任何Java代码都可以通过throw
语句抛出异常。
3. 捕获异常
程序通常在运行之前不报错,但是运行后可能会出现某些未知的错误,但是还不想直接抛出到上一
级,那么就需要通过try…catch…的形式进行异常捕获,之后根据不同的异常情况来进行相应的处
理。
4. 如何选择异常类型
可以根据下图来选择是捕获异常,声明异常还是抛出异常
Java异常处理机制主要是通过五个关键字,即try、catch、finally、throw、throws来实现的。 (1)try、catch主要是用来捕获和处理异常的; (2)finally表示不管是否出现异常,该代码块都会执行,一般用来存放一些关闭资源的代码。 (3)如果你觉得解决不了某些异常问题,且不需要调用者处理,那么你可以抛出异常。throw关键字作用是在方法内部抛出一个 Throwable 类型的异常。任何Java代码都可以通过throw语句抛出异常。
(4)throws主要用于声明所在的方法可能会出现的异常,简单来说就是告知这个方法的调用者,我这个方法可能会出现这个异常,但是我自己没有对这个方法进行异常处理,所以如果你要想调用我的话,那你记得处理我可能会抛出的这些异常。
Java异常的层次结构
Java--异常/Exception--类型/原理_判断exception的类型-优快云博客
String,StringBuffer,StringBuilder区别
解读:Java 平台提供了两种类型的字符串:String 和 StringBuffer/StringBuilder,它们都可以储存和操作字符串,区别 如下。 1)String 是只读字符串,也就意味着 String 引用的字符串内容是不能被改变的。初学者可能会有这样的误解:
 String str = “abc”;
 str = “bcd”;
如上,字符串 str 明明是可以改变StringBuffer/StringBuilder 表示的字符串对象可以直接进行修改的呀!其实不然,str 仅仅是一个引用对象,它指向一个字符串对象“abc”。第 二行代码的含义是让 str 重新指向了一个新的字符串“bcd”对象,而“abc”对象并没有任何改变,只不过该 对象已经成为一个不可及对象罢了。。
hashcode总结:
hashcode() 的作用是获取哈希码,也称为散列码;它实际上是返回一个int整数。这个哈希码的作用是确定该对象在哈希表中的索引位置。hashCode()定义在IDK的Object.java中,java中的任何类都包含有hashcode() 函数,散列表存储的是键值对(key-value),它的特点是:能根据“键”快速的检索出对应的“值”。这其中就利用到了散列码!(可以快速找到所需要的对象)
作用:
主要是保证基于散列的集合,如HashSet、HashMap以及HashTable等,在插入元素时保证元素不可重复,同时为了提高元素的插入删除便利效率而设计;主要是为了查找的便捷性而存在。
以“Hashset如何检查重复”为例子来说明为什么要有hashcode
对象加入Hashset时,Hashset会先计算对象的hashcode值来判断对象加入的位置,看该位置是否有值。如果没有,Hashset会假设对象没有重复出现;但是如果发现有值,这时会调用equals()方法来检查两个对象是否真的相同,此时如果两个对象相同,Hashset就不会让其加入操作成功。如果不同的话,就会重新散列到其他位置。这样就大大减少了equals的次数,相应就大大提高了执行速度。
重写equals已经能比较两个对象了,为什么还要重写hashcode方法
答案一:
重写equals方法时需要重写hashCode方法,主要是针对Map、Set等集合类型的使用; a: Map、Set等集合类型存放的对象必须是唯一的; b: 集合类判断两个对象是否相等,是先判断HashCode是否相等,如果HashCode返回TRUE,还要再判断equals返回值是否ture,只有两者都返回ture,才认为该两个对象是相等的。
答案二:
原因: 1.为了提高效率 采取重写hashcode方法,先进行hashcode比较,如果不同,那么就没必要在进行equals的比较了,这样就大大减少了equals比较的次数,这对比需要比较的数量很大的效率提高是很明显的,一个很好的例子就是在集合中的使用。
我们都知道java中的List集合是有序的,因此是可以重复的,而set集合是无序的,因此是不能重复的,那么怎么能保证不能被放入重复的元素呢,但靠equals方法一样比较的话,如果原来集合中以后又10000个元素了,那么放入10001个元素,难道要将前面的所有元素都进行比较,看看是否有重复,这个效率可想而知,因此hashcode就应遇而生了,java就采用了hash表,利用哈希算法(也叫散列算法),就是将对象数据根据该对象的特征使用特定的算法将其定义到一个地址上,那么在后面定义进来的数据只要看对应的hashcode地址上是否有值,那么就用equals比较,如果没有则直接插入,只要就大大减少了equals的使用次数,执行效率就大大提高了。
2.为了保证同一个对象 保证在equals相同的情况下hashcode值必定相同,如果重写了equals而未重写hashcode方法,可能就会出现两个没有关系的对象equals相同的(因为equal都是根据对象的特征进行重写的),但hashcode确实不相同的。
hash类存储结构(HashSet、HashMap等等)添加元素会有重复性校验,校验的方式就是先取hashCode判断是否相等(找到对应的位置,该位置可能存在多个元素),然后再取equals方法比较(极大缩小比较范围,高效判断),最终判定该存储结构中是否有重复元素。
总结: 1.提高效率。hash类型的存储结构,添加元素重复性校验的标准就是先取hashCode值,后判断equals()。重写后,使用hashcode方法提前校验,可以避免每一次比对都调用equals方法。
2.保证是同一个对象。如果重写了equals方法,而没有重写hashcode方法,会出现equals相等的对象,hashcode不相等的情况,重写hashcode方法就是为了避免这种情况的出现。
基本数据类型和包装数据类型的区别?
(1)初始值不同 基本数据类型的初始值为数据本身的零值,例如 int 的初始值为 0,boolean 的初始值为 false, 包装类的初始值为 null,正因为包装类的值可以为 null,所以包装类可以作为 POJO(也就是简单的无规则的 Java 对象,只有属性字段和getter以及setter方法),POJO 的属性必须使用包装类,而不能使用基本数据类型,因为数据库的查询结果可能为 null,如果使用基本数据类型的话,就需要将包装类拆箱成基本数据类型,就会抛出空指针异常(NullPointerException )
(2)储存位置不同 基本数据类型储存在栈中 包装类的引用指针储存在栈中,引用指针指向堆上的实例数据 所以包装类需要占用更多的内存
(3)基本数据类型不能用于泛型,而包装类可以** 因为泛型参数要求只能对象
(4)自动拆箱和自动装箱 将基础数据类型转换成包装类就称为装箱,将包装类转换成基础数据类型就是拆箱 自动装箱通过 Integer.valueOf() 方法来完成,自动拆箱通过 Integer.intValue() 方法完成
(5)声明方式不同 基础数据类型通过直赋值 包装类可以通过直接赋值,但是会在类内部进行自动的装箱,也可以通过 new 关键字来在堆上分配内存创建对象 注意:当进行自动装箱的时候,如果数字范围在 -128 到 127 范围内,就会直接使用缓存中的对象,如果不在这个范围内则会创建一个新的对象
//例如: int a = 100; Integer b = 100; System.out.println(a == b); // true Integer c = 100; Integer d = 100; System.out.println(c == d); // true 使用缓存中的对象 c = 200; d = 200; System.out.println(c == d); // false
什么是多态?举个例子
抽象类和接口的区别
1、抽象类可以有构造方法,接口中不能有构造方法。
2、抽象类中可以有普通成员变量,接口中没有普通成员变量
3、抽象类中可以包含非抽象的普通方法,接口中的所有方法必须都是抽象的,不能有非抽象的普通方法(抽象类可以存在普通成员函数,而接口中只能存在public abstract 方法)。
4、抽象类中的抽象方法的访问类型是任意访问修饰符(public、protected、default、private),但接口中的抽象方法只能是 public 类型的,并且默认即为 public abstract 类型,不允许定义为private或protected。
5、抽象类中可以包含静态方法,接口中不能包含静态方法(JAVA8的新特性:接口可以有静态方法和默认方法)
6、抽象类和接口中都可以包含静态成员变量,抽象类中的静态成员变量的访问类型可以任意,但接口中定义的变量只能是 public static final 类型,并且默认即为 public static final 类型。
7、一个类可以实现多个接口,但只能继承一个抽象类。
8、抽象类的子类使用 extends 来继承;接口必须使用 implements 来实现接口。

深拷贝和浅拷贝
深拷贝和浅拷贝的示意图大致如下:

深拷贝和浅拷贝就是指对象的拷贝,一个对象中存在两种类型的属性,一种是基本数据类型,一种是实例对象的引用。
1.浅拷贝是指,只会拷贝基本数据类型的值,以及实例对象的引用地址,并不会复制一份引用地址所指向的对象,也就是浅接贝出来的对象,内部的类属性指向的是同一个对象
2.深拷贝是指,既会拷贝基本数据类型的值,也会针对实例对象的引用地址所指向的对象进行复制,深拷贝出来的对象,内部的类属性指向的不是同一个对象。
基本数据类型的特点:直接存储在栈(stack)中的数据
引用数据类型的特点:存储的是该对象在栈中引用,真实的数据存放在堆内存里
引用数据类型在栈中存储了指针,该指针指向堆中该实体的起始地址。当解释器寻找引用值时,会首先检索其在栈中的地址,取得地址后从堆中获得实体。

==和equals的区别
区别是:一个是运算符,一个是方法。
==比较变量的值是否相同。
-
如果比较的对象是基本数据类型,则比较数值是否相等;
-
如果比较的是引用数据类型,则比较的是对象的内存地址是否相等。
因为Java只有值传递,对于==来说,不管是比较基本数据类型,还是引用数据类型的变量,其比较的都是值,只是引用类型变量存的值是对象的地址(引用类型对象变量其实是一个引用,它们的值是指向对象所在的内存地址)。
对于equals方法
-
如果类未重写equals方法 调用equals时,会调用Object中的equals方法,比较的是引用类型的变量所指向的对象的地址
-
如果类重写了equals方法 调用equals时,会调用该类自己的equals方法(一般是比较对象的内容是否相同)。比如: String:比较字符串内容是否相同; Integer:比较对应的基本数据类型int的值是否相同。 注意:equals方法不能作用于基本数据类型的变量,equals继承Object类,比较的是是否是同一个对象
Java中的几种基本类型,各占用多少字节?
隐式类型转换和强制类型转换?
类型转换——隐式转换和强制转换_隐式类型转换是指将取值范围大的数据类型-优快云博客?
类型转换时可能会导致溢出或精度的丢失,另外浮点数到整数的转换是通过舍弃小数得到的,而不是四舍五入。我们可以看下图的执行结果:

取自:java强制类型转换原理? - 知乎 (zhihu.com)
运行时异常有几种?
NullPointerException 空指针异常
ClassNotFoundException 指定类不存在
NumberFormatException 字符串转换为数字异常
IndexOutOfBoundsException 数组下标越界异常
ClassCastException 数据类型转换异常
FileNotFoundException 文件未找到异常
NoSuchMethodException 方法不存在异常
IOException IO 异常
SocketException Socket 异常
对面向对象的理解?面向对象的特征有那些?
面向对象编程是利用类和对象编程的一种思想。万物可归类,类是对于世界事物的高度抽象 ,不同的事物之间有不同的关系 ,一个类自身与外界的封装关系,一个父类和子类的继承关系, 一个类和多个类的多态关系。万物皆对象,对象是具体的世界事物,面向对象的三大特征封装,继承,多态。封装,封装说明一个类行为和属性与其他类的关系,低耦合,高内聚;继承是父类和子类的关系,多态说的是类与类的关系。 封装隐藏了类的内部实现机制,可以在不影响使用的情况下改变类的内部结构,同时也保护了数据。对外界而已它的内部细节是隐藏的,暴露给外界的只是它的访问方法。属性的封装:使用者只能通过事先定制好的方法来访问数据,可以方便地加入逻辑控制,限制对属性的 不合理操作;方法的封装:使用者按照既定的方式调用方法,不必关心方法的内部实现,便于使用; 便于修改,增强 代码的可维护性; 继承是从已有的类中派生出新的类,新的类能吸收已有类的数据属性和行为,并能扩展新的能力。在本质上是特殊~一般的关系,即常说的is-a关系。子类继承父类,表明子类是一种特殊的父类,并且具有父类所不具有的一些属性或方法。从多种实现类中抽象出一个基类,使其具备多种实现类的共同特性,当实现类用extends关键字继承了基类(父类)后,实现类就具备了这些相同的属性。继承的类叫做子类(派生类或者超类),被继承的类叫做父类(或者基类)。比如从猫类、狗类、虎类中可以抽象出一个动物类,具有和猫、狗、虎类的共同特性(吃、跑、叫等)。Java通过extends关键字来实现继承,父类中通过private定义的变量和方法不会被继承,不能在子类中直接操作父类通过private定义的变量以及方法。继承避免了对一般类和特殊类之间共同特征进行的重复描述,通过继承可以清晰地表达每一项共同特征所适应的概念范围,在一般类中定义的属性和操作适应于这个类本身以及它以下的每一层特殊类的全部对象。运用继承原则使得系统模型比较简练也比较清晰。 相比于封装和继承,Java多态是三大特性中比较难的一个,封装和继承最后归结于多态, 多态指的是类和类的关系,两个类由继承关系,存在有方法的重写,故而可以在调用时有父类引用指向子类对象。多态必备三个要素:继承,重写,父类引用指向子类对象。

 3万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


