句子表征|Poly-Encoders

Poly-encoders(2020 ICLR) Poly-encoders: architectures and pre-training strategies for fast and accurate multi-sentence scoring 非官方github : https://github.com/chijames/Poly-Encoder 1.摘要 Cross - encoder 对句子对进行完全self-attention ,Bi - encoder分别对句子对进行编码。前者往往性能更好,但实际使用起来太慢。在.. 阅读详情

目录

一、论文背景

二、模型架构

三、实验结果


论文:Poly-Encoders: Architectures And Pre-Training Strategies For Fast And Accurate Multi-Sentence Scoring

一、论文背景

        计算两个句子相似度有两种技术架构:Bi-Encoder(俗称双塔)和Cross-encoder,这两个的区别在于交互的时机,Bi-Encoder构架input_text和candidate分别训练,直到最后预测分数的时候才交互,而Cross-encoder将input_text分别和candidate拼接送入模型或者训练中多次产生交互。从上面的描述可以看到,两架构各有利弊:Bi-Encoder由于交互少,训练和预测会更快些,对线上工程来说,并发和响应时耗是有要求的,Cross-Encoder由于交互训练,模型可以学到更多特征,预测准确度上要优于Bi-Encoder,劣势就是更耗时。那么有没有一种方案够兼顾质量和速度:Poly-Encoder,本文模型提出的初衷正为此。

二、模型架构

        Poly-Encoder, 论文是这么定义的:具有额外学习注意力机制的架构,代表更多全局特征,从中执行自注意力。
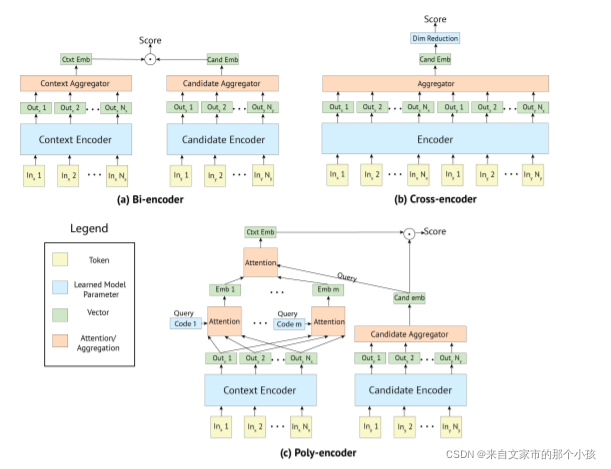
         见图知义,Poly-encoder是在Bi-encoder上加入一些调料,主要包括:

                1、query经过Encoder后并不生成单一的向量,出发点是query通常比较长,单一的向量无法完成涵盖全部语义信息,于是采用attention机制生成m个向量,多侧面去刻画query;

                2、生成最后query_emb的方式是通过1中的m个向量与candidate_emb做attention,可见,Poly-encoder与candidate进行了两次交互。

三、实验结果
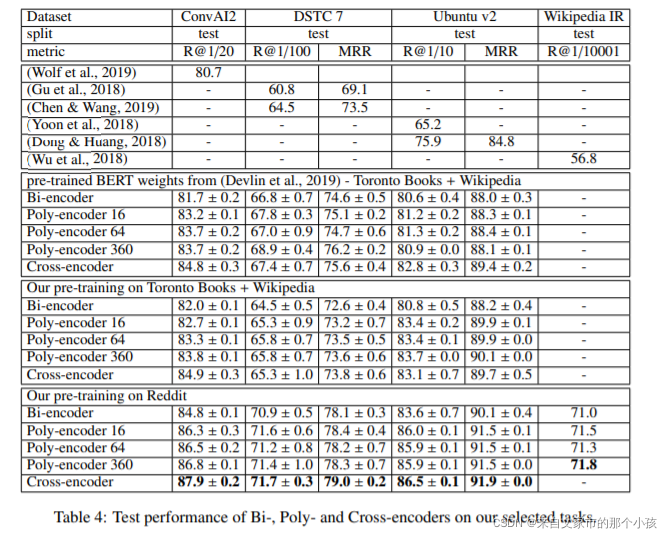
        

  预测准确度上,Poly-encoder的效果是介于Bi-encoder和Cross-encoder之间,但相对于Bi-encoder,在有些数据集上出现较大辐度提升,如ConvAI2和Ubuntu v2。
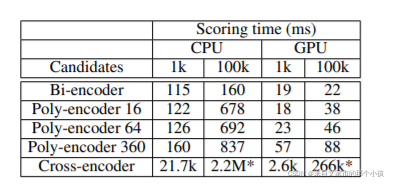
        从耗时上优势就比较明显了,与Cross-encoder准确度相当的条件下,预测效率相差3个量级 

顶会速递 | ICLR 2020录用论文全集 由深度学习三巨头Yoshua Bengio和Yann LeCun牵头创办的人工智能顶会ICLR今年最终收到2594篇投稿,共687篇论文被接收,其中48篇orals,108篇spotlights,531篇posters,录取率为26.5%,相比去年的31.4%略有下降。华人学者占比为47%。这篇博客为大家列出全部录用的论文列表,方便大家自取。 阅读详情

相关推荐

[论文笔记]Poly-encoder

:star: 通过引入了code向量来改造BERT提出了Poly-encoder模型,它结合了Bi-encoder和Cross-encoder的优点,可以用于生产部署。

日积月累,天道酬勤 724

Poly-encoders: architectures and pre-trainingstrategies for fast and accurate multi-sentence scorin

预测句子对之间关系一般有两种方法:cross-encoders(通过自注意力从全局实现编码)Bi-encoder(对输入的context和label分别进行编码),前者由于每次都需要将input和label进行concate后进行编码,因此虽然可以得到更好的效果,但是其速度会很慢。

garbage回收中心 566

Poly-Encoder

用于响应选择任务的双编码器,多编码器和交叉编码器 该存储库是的非官方重新实现。 特别感谢sfzhou5678! 一些数据预处理(dataset.py)和训练循环代码是从他的改编的。 但是,该存储库中的模型体系结构和数据表示与本文不完全一致,从而导致性能下降。 我在coder.py中重新实现了Bi-Encoder和Poly-Encoder的模型。 另外,还实现了交叉编码器的模型和数据处理流水线。 大多数run.py训练代码是从adpated 在库。 此实现与原始论文之间最重要的体系结构差异是仅使用一个bert编码器(而不是两个单独的编码器)。 有关详细信息,请参阅此。 但是,这应该不会对性能产生太大影响。 该存储库未实现原始论文中的所有详细信息,例如,稳定时学习率下降0.4。 同样由于有限的计算资源,我无法像原始论文中那样使用确切的参数设置,例如批处理大小或上下文长度。 另外,使用的

ICLR 2020 | 可提速3000倍的全新信息匹配架构(附代码复现)

©PaperWeekly 原创 ·作者|周树帆学校|上海交通大学硕士生研究方向|自然语言处理今天聊一篇 FAIR 发表在 ICLR 2020 上的文章:Poly-encoders: ...

Paper weekly 2245

FOC观测器之龙伯格观测器

状态观测器: 理论依据:根据控制理论,如果一个系统能够完全通过其检测到的输出值来重构其系统状态,则认为该系统是可观测的。其作用于无传感器转子的位置和速度的检测反馈,再作用到PARK逆变换和转矩磁链控制上。 Luenberger观察器原理图: Luenberger观测器的离散化: (其观测器的闭环参数为经验验证值) 引入估测电流( iα,iβ )的反馈值并离散化(T 为采样时间),可得...

ShawnChan的博客 2万+

实战指南:R语言多组倾向评分逆概率加权(IPTW)建模与结果解读

本文详细介绍了如何使用R语言实现多组倾向评分逆概率加权(IPTW)建模,包括数据预处理、倾向评分估计、权重计算及结果解读。通过实战案例演示,帮助研究者掌握这一统计方法,有效平衡多组混杂因素,模拟随机对照试验效果,适用于医学、社会科学等领域的数据分析。

weixin_42528534的博客 395

Poly-encoder

Poly-encoderPoly-encoderBi-encodercross-encoderpoly-encoder Poly-encoder 论文《Poly-encoders: Transformer Architectures and Pre-training Strategies for Fast and Accurate Multi-sentence Scoring》开放了一种新的transformer体系结构,即Poly-encoder。 Poly-encoder学习全局而不是token级别的s

gg13213的博客 1177

基于STM32F407的定时器以及定时器中断的实现

基于STM32F407的定时器以及定时器中断的实现

weixin_57941207的博客 5228

探索高效对话理解:Poly-encoders 开源实现

探索高效对话理解:Poly-encoders 开源实现 在这个数字化交流的时代,自然语言处理(NLP)技术在人机交互和机器对机器通信中扮演着越来越重要的角色。今天,我们向您推荐一个令人兴奋的开源项目——Poly-encoders,它是一个非官方的实现,旨在提高多句响应选择任务的效率和准确性。这个项目是基于论文《Poly-encoders: Transformer Architectures and...

gitblog_00049的博客 434

ADS笔记,新旧两组仿真数据进行绘图和列表对比

原理图器件参数的不同,怎么进行对比观看,操作如下。

彭辉荣的博客 3868

告别‘抓瞎’:CANoe的Trace、Graphics和Logging窗口实战技巧,高效分析总线故障

本文深入解析CANoe的Trace、Graphics和Logging窗口实战技巧,帮助工程师高效分析总线故障。通过智能过滤、可视化监控和智能日志管理,构建系统级问题定位工作流,显著提升车载网络故障排查效率。

weixin_42709044的博客 292

文本匹配深度学习模型总结(2020)——Pretrain、Poly-encoders、ColBERT

探究2020年顶会论文中,基于深度学习的文本匹配模型的改进方法,介绍了 Pre-training tasks for embedding-based large-scale retrieval、Poly-encoder、ColBERT 的核心思想

xuzf 的博客 4995

C# 开发实战:深度解析 13.56MHz 射频卡读写应用

本文详细介绍了如何在 C# 环境下开发 13.56MHz 射频卡的读写应用。通过 ACR122U 作为硬件设备,结合 C# 提供的 COM 组件或 SDK,我们能够实现对射频卡的读取与写入功能。在实际开发中,开发者还需要根据具体应用场景选择合适的卡片类型与设备,并注意性能优化和异常处理。随着技术的发展,RFID 技术的应用场景会越来越广泛,开发者可以根据不同需求,灵活扩展读写功能,实现更加智能化和自动化的系统。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 1601

基于表征(Representation)的文本匹配、信息检索、向量召回的方法总结

作者|夜小白整理|NewBeeNLP最近系统性的看了一些有关于信息检索、文本匹配方向的论文,先贴下三篇主角论文:「(ColBERT)」 Khattab, O., & Za...

Kaiyuan_sjtu的博客 1562

手把手教你学Simulink——基础储能管理场景实例:基于Simulink的压缩空气储能(CAES)系统简化模型仿真

本文介绍了基于Simulink的压缩空气储能(CAES)系统简化模型仿真方法。CAES作为大规模长时储能方案,相比锂电池具有成本低、寿命长等优势。文章详细讲解了AA-CAES系统组成、热力学建模理论,以及Simulink实现流程,包括储气室、压缩机、膨胀机等核心模块的建模方法。通过8小时充电(50MW)和6小时放电(40MW)的仿真,验证了系统可实现60%往返效率。该模型为理解CAES系统运行机制提供了实用工具,并指出热管理、储气室特性等工程实践要点,为新型电力系统储能规划提供了仿真基础。

MHD0815的博客 171

代谢组数据分析(十五):基于python语言构建PLS-DA分类预测模型

本教程阐述典型代谢组学数据分析工作流程,用于二元分类结果的研究。流程主要步骤如下:首先从 Excel 表格导入代谢物与实验数据,接着基于汇总 QC 进行数据清洗。随后借助主成分分析可视化检查数据质量,再开展两类单变量统计。之后运用偏最小二乘判别分析(PLS - DA)实施多变量分析,此过程涵盖模型优化(对比 R2 与 Q2)、置换测试及明确模型预测指标、确定特征重要性、对模型预测数据进行可视化。最终将统计表格导出至 Excel 表格,完整呈现从数据导入到分析结果输出的全过程。

专注生信领域 2875

基于表征(Representation)文本匹配、信息检索、向量召回的方法总结(用于召回、或者粗排)

@[toc] 最近系统性的看了一些有关于信息检索、文本匹配方向的论文,先贴下三篇主角论文: (ColBERT)Khattab, O., & Zaharia, M. (2020). ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT. ArXiv, abs/2004.12832.[PDF](Poly-encoders)Humeau, S., Shuster,...

朝闻道 1041

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

推荐系统粗排&召回相关性优化的最新进展

作者:cmathx 原文链接:https://zhuanlan.zhihu.com/p/195548025 编辑:深度传送门 看到三篇干货满满&&很实用的相关性优化paper,先上论文大餐。 https://arxiv.org/pdf/2002.03932.pdf Google的paper(How to pretrain?),主要是讲怎么样更好的设计pretrain任务,用于问答任务。 https://arxiv.org/pdf/2004.12832.pd.

公众号:该用户快成仙了 266

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

【NLP】2020深度文本匹配最新进展:精度、速度我都要!

文 | QvQ编 | 兔子酱在过去的几年里,信息检索(IR)领域见证了一系列神经排序模型的引入,这些模型多是基于表示或基于交互的,亦或二者的融合。然鹅,模型虽非常有效,尤其是基于 PLM...

fengdu78的博客 1298

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

NLP-文本匹配/语义相似度计算-2019:Poly-encoders【architectures and pre-training strategies for fast and accurate】

NLP-文本匹配-2019:Poly-encoders【Poly-encoders: Transformer Architectures and Pre-training Strategies fo】

u013250861的博客 476

预训练模型语义相似性计算(五)--poly-encoder

bi-encoder(SBERT)和cross-encoder两种模型架构都有各自的优缺点,FAIR在ICLR2020上提出的这个poly-encoder的架构集成了两者的优点,并且避免了缺点。poly-encoder的架构图如下: poly-encoder的架构其实很简单,对contexr-query向量进行再一次编码生成m个向量表示,再与candidate-query进行attention计算得到最后的相似表示。bi-encoder在表示的缺点是两个query在经...

choose_c的博客 1237

Poly-Encoder 使用教程

Poly-Encoder 使用教程 项目介绍 Poly-Encoder 是一个用于多域对话系统的高效编码器。它通过引入多域注意力机制,能够在保持计算效率的同时,提升对话系统的性能。该项目基于 PyTorch 框架开发,适用于需要处理多域对话数据的场景。 项目快速启动 环境准备 确保你已经安装了以下依赖: Python 3.6 或更高版本 PyTorch 1.0 或更高版本 克隆项目 git c...

gitblog_01099的博客 638

从 Sentence-BERT 谈句子表征

作者|太子长琴整理|NewBeeNLP在之前那篇 NLP 表征的历史与未来[1] 里,我们几乎从头到尾都在提及句子表征,也提出过一个很重要的概念:“句子” 才是语义理解的最小单位...

Kaiyuan_sjtu的博客 2206

2020深度文本匹配最新进展:精度、速度我都要!

文 | QvQ编 | 兔子酱在过去的几年里,信息检索(IR)领域见证了一系列神经排序模型的引入,这些模型多是基于表示或基于交互的,亦或二者的融合。然鹅,模型虽非常有效,尤其是基于 PLM...

夕小瑶科技说 2849

【论文解读 ICLR 2020 | 图上的预训练】STRATEGIES FOR PRE-TRAINING GRAPH NEURAL NETWORKS

论文题目:STRATEGIES FOR PRE-TRAINING GRAPH NEURAL NETWORKS 论文来源:ICLR 2020 论文链接:https://openreview.net/forum?id=HJlWWJSFDH&noteId=HJlWWJSFDH 代码链接:https://github.com/snap-stanford/pretrain-gnns/ 关键词:GN...

byn12345的博客 4573

Transformer Architectures and Pre-training Strategies for Fast and Accurate Multi-sentence Scoring

目录论文导读课前基础知识学习目标知识树研究背景初始BERT研究成果研究意义论文结构摘要论文精读模型总览BERT、Poly-encoderBERT的出现BERT结构BERT的实现小结Poly-Encoder结构Bi-EncoderCross-encoderPoly-encoder论文算法模型的细节BERT模型细节TransformerBERT模型Poly-Encoder模型细节Bi-encoder模型Cross-encoder模型Poly-encoder模型Poly-encoder简化模型实验设置及结果分析数

Ying_M 669
上一篇: 句子表征|Condenser: A Pre-training Architecture for Dense Retrieval
下一篇: 每天一个知识点——Normalization
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值