RAG实践:一文掌握大模型RAG过程

一、RAG是什么?

RAG(Retrieval-Augmented Generation,检索增强生成) , 一种AI框架,将传统的信息检索系统(例如数据库)的优势与生成式大语言模型(LLM)的功能结合在一起。不再依赖LLM训练时的固有知识,而是在回答问题前,先从外部资料库中"翻书"找资料,基于这些资料生成更准确的答案。

RAG技术核心缓解大模型落地应用的几个关键问题:

▪知识新鲜度:大模型突破模型训练数据的时间限制

▪幻觉问题:降低生成答案的虚构概率,提供参照来源

▪信息安全:通过外挂知识库而不是内部训练数据,减少隐私泄露

▪垂直领域知识:无需训练直接整合垂直领域知识

二、RAG核心流程

在这里插入图片描述

2.1 知识准备阶段

1、数据预处理

1、文档解析

▪输入:原始文档(如Markdown/PDF/HTML)

▪操作:

▪提取纯文本(如解析Markdown标题、段落)

▪处理特殊格式(如代码块、表格、图片、视频等)

例如:

[标题] 什么是 ROMA?
[段落] ROMA 是一个全自主研发的前端开发基于自定义DSL(Jue语言),一份代码,可在iOS、Android、Harmony、Web四端运行的跨平台解决方案。
[段落] ROMA 框架的中文名为罗码。
[标题] 今天天气
[列表项] 今天的室外温度为35°C,天气晴朗。

文档的解析过程需要考虑不同文档内容例如文本、图片、表格等场景,以及文档的语言,布局情况,可以考虑使用一些优秀的三方工具或者一些视觉模型,布局分析模型,语义理解模型来辅助解析。

2、数据清洗与标准化处理

提升文本质量和一致性,使向量表示更准确,从而增强检索相关性和LLM回答质量;同时消除噪声和不规则格式,确保系统能正确理解和处理文档内容。

包括:

▪去除特殊字符、标签、乱码、重复内容。

▪文本标准化,例如 时间、单位标准化(如“今天” → “2025-07-17”)。

▪其他处理

数据的清洗和标准化过程可以使用一些工具或NLTK、spaCy等NLP工具进行处理。

例如:

<p>ROMA框架</p>
处理: 
"ROMA框架"

今天的室外温度为35°C,天气晴朗。
处理:
"2025-07-17 的室外温度为35°C,天气晴朗"
3、元数据提取

关于数据的数据,用于描述和提供有关数据的附加信息。

▪文档来源:文档的出处,例如URL、文件名、数据库记录等。

▪创建时间:文档的创建或更新时间。

▪作者信息:文档的作者或编辑者。

▪文档类型:文档的类型,如新闻文章、学术论文、博客等。

▪ …

元数据在RAG中也非常重要,不仅提供了额外的上下文信息,还能提升检索质量:

  1. 检索增强

▪精准过滤:按时间、作者、主题等缩小搜索范围

▪相关性提升:结合向量相似度和元数据特征提高检索准确性

  1. 上下文丰富

▪来源标注:提供文档来源、作者、发布日期等信息

▪文档关系:展示文档间的层级或引用关系

常见的元数据提取方式:

▪正则/HTML/… 等解析工具,提取标题、作者、日期等

▪自然语言处理: 使用NLP技术(如命名实体识别、关键词提取)从文档内容中提取元数据,如人名、地名、组织名、关键词等

▪机器学习模型: 训练机器学习模型来自动提取元数据

▪通过调用外部API(如Google Scholar API、Wikipedia API)获取文档的元数据

▪…

例如:

complete_metadata_chunk1 = {
    'file_path': '/mydocs/roma_intro.md',
    'file_name': 'roma_intro.md',
    'chunk_id': 0,
    'section_title': '# 什么是 ROMA?',
    'subsection_title': '',
    'section_type': 'section',
    'chunking_strategy': 3,
    'content_type': 'product_description',
    'main_entity': 'ROMA',
    'language': 'zh-CN',
    'creation_date': '2025-07-02',  # 从文件系统获取
    'word_count': 42  # 计算得出,
    'topics': ['ROMA', '前端框架', '跨平台开发'],
    'entities': {
        'products': ['ROMA', 'Jue语言'], # 实体识别
        'platforms': ['iOS', 'Android', 'Web']
    },
}

2、内容分块(Chunking)

在RAG架构中,分块既是核心,也是挑战,它直接影响检索精度、生成质量,需要在检索精度、语境完整性和计算性能之间取得平衡。

在这里插入图片描述

内容分块将长文档切分成小块,可以解决向量模型的token长度限制,使RAG更精确定位相关信息,提升检索精度和计算效率。

autobots 功能分块:

在这里插入图片描述

实际RAG框架中按照文档的特性选择合适的分块策略进行分块.

常见的分块策略

1. 按大小分块

按固定字符数进行分块,实现简单但可能切断语义单元。

优点:实现简单且计算开销小,块大小均匀便于管理。

缺点:可能切断语义单元,如句子或段落被分到不同块中。

例如:

第一段:# ROMA框架介绍ROMA是一个全自主研发的前端开发框架,基于自定义DSL(Jue语言)。
一份代码,可在iOS、Android、Harmony

第二段:、Web三端运行的跨平台解决方案。ROMA框架的中文名为罗码。

句子被截断,“一份代码,可在iOS、Android、Harmony” 和 “、Web三端运行的跨平台解决方案” 被分到不同块,影响理解。

2. 按段落分块

以段落为基本单位进行分块,保持段落完整性,但段落长度可能差异很大。

优点:尊重文档自然结构,保留完整语义单元。

缺点:段落长度差异大,可能导致块大小不均衡。

例如:

第一段:# ROMA框架介绍ROMA是一个全自主研发的前端开发框架,基于自定义DSL(Jue语言)。
一份代码,可在iOS、Android、Harmony、Web三端运行的跨平台解决方案。ROMA框架的中文名为罗码。

第二段:# 核心特性1. 跨平台:一套代码运行于多端2. 高性能:接近原生的性能表现3. 可扩展:丰富的插件系统

第一段包含标题和多行内容,而其他段落相对较短,可能导致检索不均衡。

3. 按语义分块

基于文本语义相似度进行动态分块,保持语义连贯性,但计算开销大。

说明:基于文本语义相似度动态调整分块边界。

优点:保持语义连贯性,能识别内容主题边界。

示例:

第一段:# ROMA框架介绍ROMA是一个全自主研发的前端开发框架,基于自定义DSL(Jue语言)。
一份代码,可在iOS、Android、Harmony、Web四端运行的跨平台解决方案。

第二段:ROMA框架的中文名为罗码。
## 核心特性1. 跨平台:一套代码运行于多端

使用依赖模型质量,相同文本在不同运行中可能产生不同分块结果。

分块策略总结:

在这里插入图片描述

优化方式

▪混合分块策略

结合多种分块方法的优点,如先按段落分块,再根据块大小调整,做到既保持语义完整性,又能控制块大小均匀

▪优化重叠区域

根据内容特性动态调整块之间的重叠区域大小,关键信息出现在多个块中,提高检索召回率

常用的分块工具

▪LangChain框架:提供多种分块策略,包括RecursiveCharacterTextSplitter、MarkdownTextSplitter等

▪NLTK:用于基于自然语言句子的分块

▪spaCy:提供语言学感知的文本分割

3、向量化(Embedding)

将高维文本数据压缩到低维空间,便于处理和存储。将文本转换为计算机可以理解的数值,使得计算机能够理解和处理语义信息,从而在海量数据文本中实现快速、高效的相似度计算和检索。

简单理解:通过一组数字来代表文本内容的“本质”。

例如,"ROMA是一个跨平台解决方案…"这句话可能被转换为一个384维的向量:

[块1] 什么是ROMA?
ROMA是一个全自主研发的前端开发框架,基于自定义DSL(Jue语言)...

[
  {
    "chunk_id": "doc1_chunk1",
    "text": "# 什么是 ROMA?\nROMA 是一个全自主研发的前端开发基于自定义DSL(Jue语言),一份代码,可在iOS、Android、Harmony、Web端运行的跨平台解决方案。",
    "vector": [0.041, -0.018, 0.063, ..., 0.027],
    "metadata": {
      "source": "roma_introduction.md",
      "position": 0,
      "title": "ROMA框架介绍"
    }
  },
  // 更多文档块...
]

常用的Embedding模型

模型名称开发者维度特点
all-minilm-l6-v2Hugging Face384高效推理,多任务支持,易于部署,适合资源受限环境
Text-embedding-ada-002OpenAI1536性能优秀,但可能在国内使用不太方便。
BERT embeddingGoogle768 (base) 1024 (large)广泛用于各种自然语言处理任务。
BGE (Baidu’s General Embedding)百度768在HuggingFace的MTEB上排名前2,表现非常出色。

4、向量数据库入库

将生成的向量数据和元数据进行存储,同时创建索引结构来支持快速相似性搜索。

常用的向量数据库包括:

数据库复杂度核心优势主要局限适用场景
ChromaDB低轻量易用, Python集成仅支持小规模数据原型开发、小型项目
FAISS中十亿级向量检索, 高性能需自行实现特殊化学术研究、大规模检索
Milvus高分布式扩展, 多数据类型支持部署复杂, 资源消耗大企业级生产环境
Pinecone低全托管, 自动扩缩容成本高, 数据在第三方云无运维团队/SaaS应用
Elasticsearch高全文搜索强大,生态系统丰富向量搜索为后加功能,性能较专用解决方案差日志分析、全文搜索、通用数据存储

2.2 问答阶段

1、查询预处理

` 意图识别: 使用分类模型区分问题类型(事实查询、建议、闲聊等)。

问题预处理: 问题内容清洗和标准化,过程与前面数据预处理类似。

查询增强: ****使用知识库或LLM生成同义词(如“动态化” → “Roma”),上下文补全可以结合历史会话总结(例如用户之前问过“Roma是什么”)。

2、数据检索(召回)

1、向量化

使用与入库前数据向量化相同的模型,将处理后的问题内容向量化。

例子:

问题: "ROMA是什么?"

处理后
{
    "vector": [0.052, -0.021, 0.075, ..., 0.033],
    "top_k": 3,
    "score_threshold": 0.8,
    "filter": {"doc_type": "技术文档"}
}
2、检索

相似度检索:查询向量与所存储的向量最相似(通过余弦相似度匹配)的前 top_k 个文档块。

关键词检索:倒排索引的传统方法,检索包含"Roma"、"优势"等精确关键词的文档。

混合检索: 合并上面多种检索结果,效果最优。

例如:检索"ROMA是什么?"
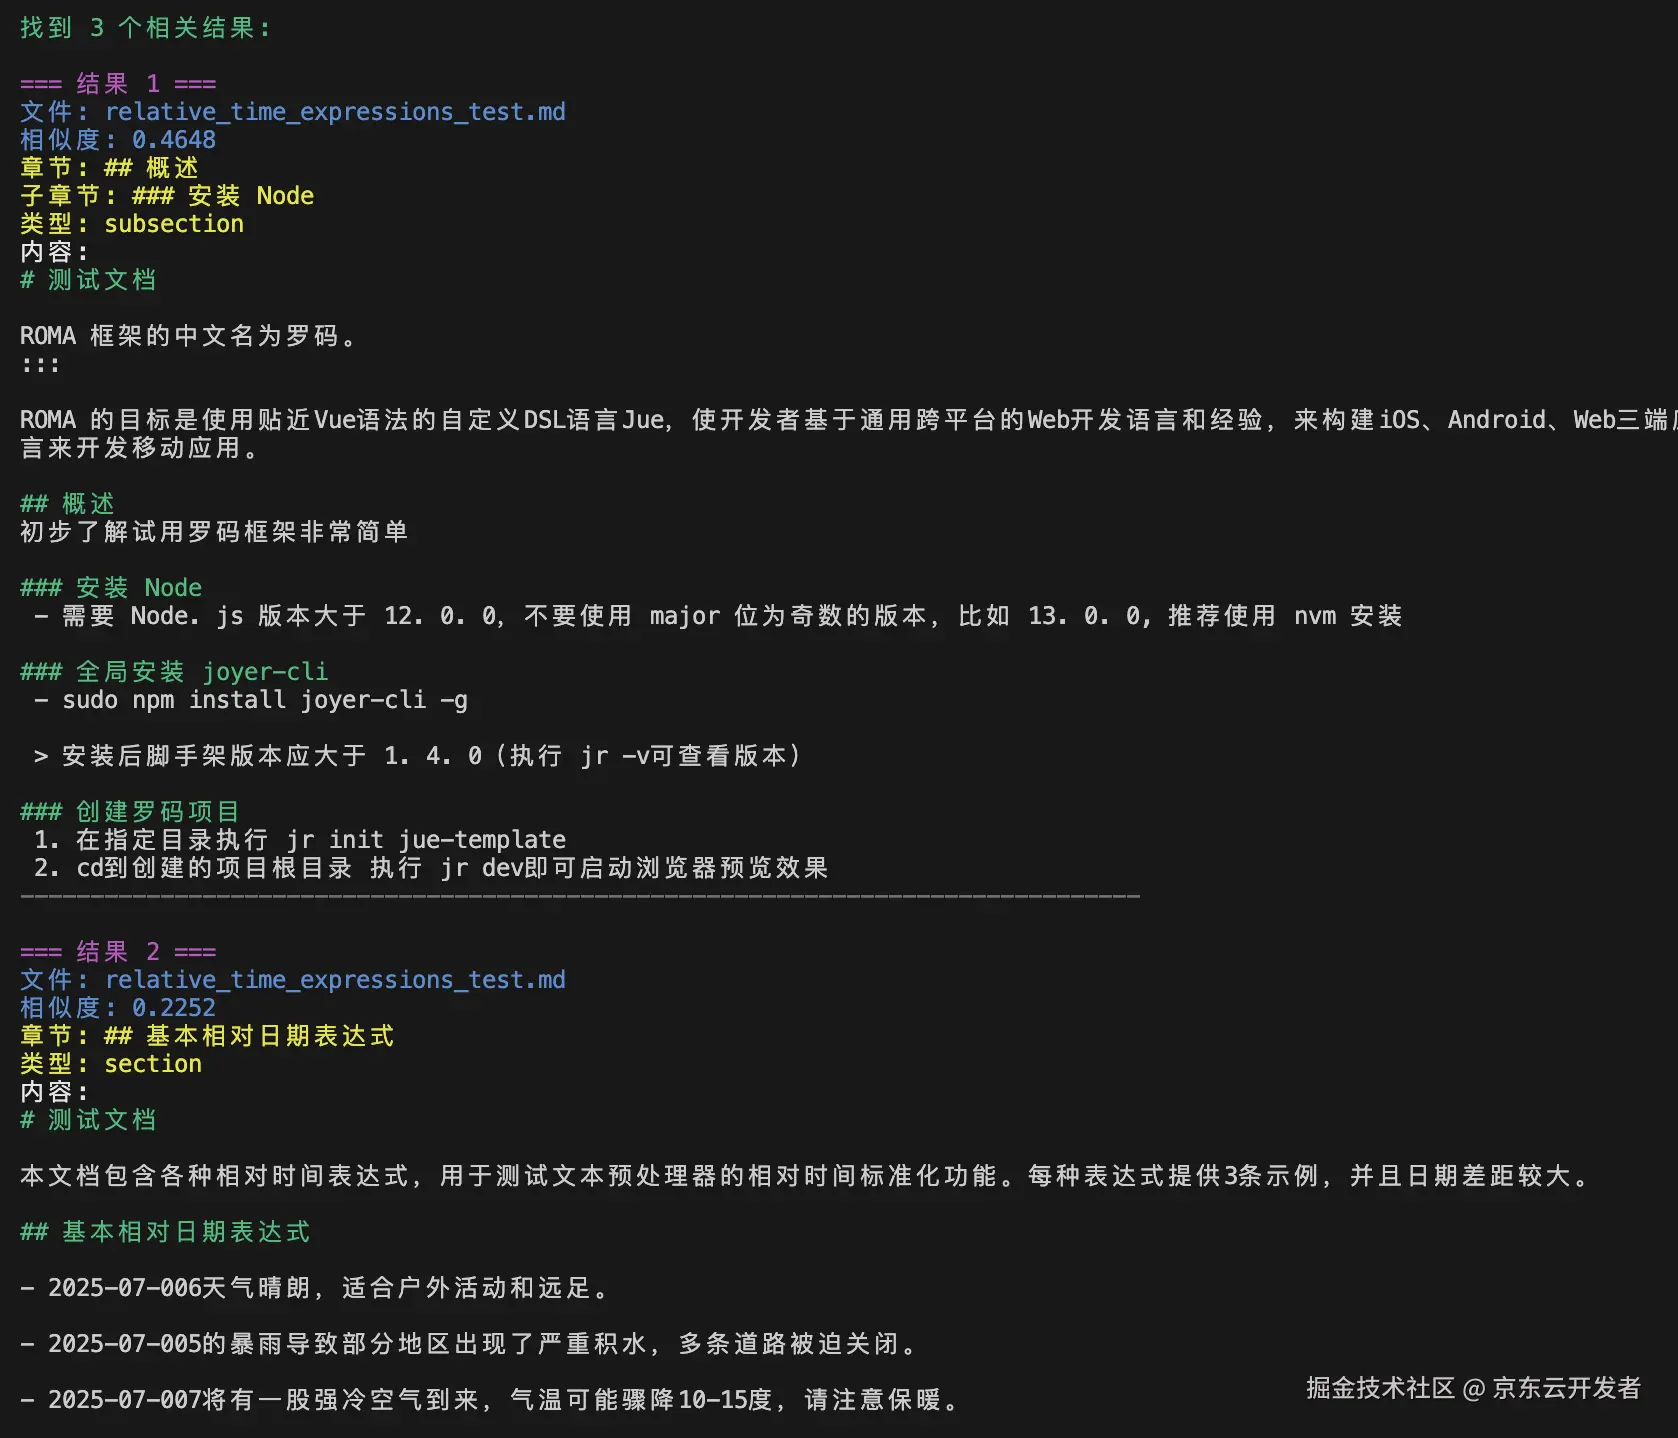
在这里插入图片描述

3、重排序(Reranking)

初步检索在精度和语义理解上的不足,通过更精细的上下文分析提升结果相关性。它能更好处理同义词替换、一词多义等语义细微差异,使最终结果准确。

原理:使用模型对每个检索结果计算相关性分数。

归一化:重排序模型原始输出分数没有固定的范围,它可能是任意实数,将结果归一化处理,将分数映射到 [0, 1] 范围内,使其更容易与向量相似度分数进行比较。

例如:

在这里插入图片描述

常用的重排序模型:

在这里插入图片描述

3、信息整合

格式化检索的结果,构建提示词模板,同时将搜索的内容截断或摘要长文本以适应LLM上下文窗口token。

提示词优化:

  1. 限定回答范围

  2. 要求标注来源

  3. 设置拒绝回答规则

  4. …

例如:

prompt 模板:

你是一名ROMA框架专家,请基于以下上下文回答:

参考信息:
[文档1] 什么是 ROMA?
ROMA 是一个全自主研发的前端开发基于自定义DSL(Jue语言),一份代码,可在iOS、Android、Harmony、Web四端运行的跨平台解决方案。
ROMA 框架的中文名为罗码。
[文档2] Roma介绍?
[Roma介绍](docs/guide/guide/introduction.md)
文档地址: https://roma-design.jd.com/docs/guide/guide/introduction.html

要求:
1. 分步骤说明,含代码示例
2. 标注来源文档版本
3. 如果参考信息中没有相关内容,请直接说明无法回答,不要编造信息

请基于以下参考信息回答用户的问题。如果参考信息中没有相关内容,请直接说明无法回答,不要编造信息。


用户问题: ROMA是什么?

回答: {answer}

4、LLM生成

向LLM(如GPT-4、Claude)发送提示,获取生成结果。

autobots示例:

在这里插入图片描述

以上,实现了最简单的RAG流程。实际的RAG过程会比上述麻烦更多,包括图片、表格等多模态内容的处理,更复杂的文本解析和预处理过程,文档格式的兼容,结构化与非结构化数据的兼容等等。

最后RAG各阶段优化方式:

在这里插入图片描述

相关推荐

京东云推出全新JoyCode智能编码工具,让AI Coding从代码生成走向成果交付

全新JoyCode结合项目背景与任务目标,通过Agent Loop持续规划、执行、验证与迭代,并支持多智能体并行协作、模型灵活配置及工具与流程复用,贯通从需求分析到开发验证的任务链路,推动AI Coding从代码生成走向可运行软件与可用工具的成果交付。模型使用的关键,不只是选择更强的能力,而是让投入与任务需要相匹配。作为面向严肃开发场景的企业级编码产品,京东云JoyCode所拓展的,不只是代码生成的能力,更是将专业经验与日常灵感付诸实现的路径,让技术承接实现过程中的繁复,让人更专注于问题、判断与创造。

京东科技开发者 42

GPT-6凌晨上线智能UI:智能UI时代的技术架构重构与应对之道

从命令行到图形界面,计算机行业用了三十年证明了同一件事:人类需要视觉的、空间的、可重复的交互表面,纯文字从来只是过渡形态。智能界面的出现,意味着AI行业第一次大规模承认了这个规律——对话是创造的接口,界面是使用的归宿。生成的界面如何稳定下来?个人的数据与身份如何安全地沉淀?Agent的行动能力如何可信地放大?谁能把这三个问题答好,谁就站在了Personal Agent图形界面时刻的浪潮之巅。

京东科技开发者 225

AI 会写代码之后,交付为什么还没变快?

AI 写代码,只是这场变革的起点,而不是终点。真正决定一个组织能否吃到 AI 红利的,不是"能不能用 AI 写出代码",而是敢不敢用 AI 重新设计交付流程、重新划分角色分工、重新组织团队结构。研发视角能把工具和个人推到极致,却会在组织的边界前止步;只有站上组织视角,把AI × 工具一路推进到AI × 组织,那些被 AI 照出来的摩擦,才会真正被抹平。国际技术部 Multi AI Native 想做的,正是这件事——让 Agent 成为你可靠的数字战友,让每一次迭代交付都快一个量级;

京东科技开发者 314

OxygenData-Vibe搭建:用 AI Coding重新定义数据看板搭建

长期以来,数据看板开发主要有两种方式:一种是使用标准化 BI 工具,交付快、成本低,但图表样式、交互体验和功能扩展都受限于 BI 本身的能力;另一种是自研定制开发,能够充分满足复杂和个性化需求,但需要投入大量研发资源,交付周期也更长。比如一个通过 BI 只需要 1 天就能搭建出来的看板,如果采用自研方式,可能需要投入 30 PD 的研发人力。既然 BI 交付这么快,为什么不把所有看板需求都交给 BI?原因在于,业务某些场景需要的不只是把数据展示出来。

京东科技开发者 375

当我谈数据库高可用时我谈些什么

大家都经常听到说数据库的双1,那双1指的是什么呢?参数=1(最安全)≠1(更快但可能丢)每次提交都把 redo 刷盘0/2:攒着刷,崩溃丢最近 1 秒每次提交都把 binlog 刷盘0/N:攒着刷,崩溃丢最近若干条"双 1"(都设为 1)= 单机不丢已提交事务的前提。生产核心库必须双 1;代价是每次提交两次 fsync。小结:单机层用 WAL 提速、用 2PC 保证 redo/binlog 一致、用崩溃恢复裁决半成品事务、用双 1 兜底持久性。

京东科技开发者 320

ScoAI:面向供应链的运筹原生决策智能

ScoAI 关注的并非 AI 能否进入供应链,而是 AI 参与供应链决策之后,哪些内容适合通过数据学习,哪些关系必须显式计算,以及哪些结果需要依据执行记录进行验证。其基本分工是:供应链业务定义问题、资源与行动后果,运筹学表达目标、约束和协同关系,AI 提供可复用的估计与判断。真正用于改进后续决策的,不仅是模型生成的初始结果,还包括实际采取的行动及其产生的业务反馈。

京东科技开发者 407

拆解海博 AI-Native 落地保障:海博团队 AI 知识库能力建设

绕了一大圈,回头看,我们其实一直在解开头那三个结:AI 读不懂系统、影响面靠人脑记、测试预期没处查。做到这里,本质上是把"AI 用不好"这个问题,从"是不是该换个更强的模型"重新定义成了"怎么把上下文经营好"。顺着这个思路,我们攒下了这么几样东西:•。

京东科技开发者 562

从零构建一个生产级记忆型 AI Agent —— AgentScope 项目全景技术与学习指南

domain 层端口接口(domain)职责适配器实现(infra)对话流水账读写经验记忆检索/落库请求级幂等四态会话元数据 CRUD会话级 Skill 选择态Skill 元数据HITL 权限网关(domain 内含逻辑,见第四篇)StreamSink技术中立的流式下沉(client 层桥接)以幂等端口为例,头部注释明确写道:实现 domain 端口,持有实体不出 infra 边界,对外只暴露嵌套视图GateResult。

京东科技开发者 615

数据涅槃:Agentic 重塑搜推数据生产体系

当前大模型已经能够理解需求、生成代码和解释错误,但数据生产的难点并不只是“写出一段 SQL”。一个需求还要经过数据源确认、口径澄清、加工编排、资源规划、任务提交、调度运行、结果交付和故障处置。任何一步缺少都可能让“看起来正确”的任务变成生产事故。

京东科技开发者 383

81.8 秒的视频,我们改了 15 个版本:一次纯 Codex 驱动的 AI-native 视频实践

81.8 秒、15 个版本,这些数字真正想说明什么?视频制作正在从一组专业软件里的复杂操作,变成一场围绕目标、参考和反馈展开的持续对话。AI 已经可以接住从脚本到交付的大量工作。你可以把精力留给更重要的部分:理解观众、选择故事、判断好坏。过去停在 PPT 和脑海里的想法,现在有机会被快速做成一支能看、能改、也愿意转发的视频。如果明天就要介绍你手头的项目,你最想先把哪一步交给 AI?

京东科技开发者 469

Codex 驱动的移动端AI全栈开发:从 Relay 原型图到可交付链路

AI 编程工具降低了跨端开发门槛,但“让 AI 写页面”并不等于“完成移动端交付”。PC 运营端页面通常以功能闭环为中心,设计约束较弱,研发可以基于组件库快速搭建;移动端 C 端页面直接面对用户,Relay 原型图和 UI 设计稿不仅是视觉参考,更是交互、信息层级、状态反馈和业务信任感的综合契约。

京东科技开发者 595

Claude Code vs Codex 记忆体系深度对比

Claude Code —— 分层自动记忆系统四层分层架构(CLAUDE.md / Auto Memory / Session Memory / AutoDream)构成自优化闭环,系统主动捕获、分类、去冗并跨会话接力经验。走的是自动化优先路线——让机器替人记忆、替人整理,以少量可控性的不确定换取强大的经验积累能力。Codex —— 声明式契约系统两层扁平架构(AGENTS.md 静态声明层 + 会话上下文层),记忆完全由人显式订立、显式修改,系统只读契约、绝不擅自变更。走的是可控性优先。

京东科技开发者 631

上游给空、下游拿到 -1,我把故障一直追到了 commons-beanutils 的构造函数

这篇手记是一份事后复盘,写在我们已经把修复推上线、把测试用例跑绿、把约束文档沉淀进团队库之后。非研发同事,可以直接从第八章开始看,前七章都是讲排障和代码分析。故障本身不复杂,修复也不复杂,但这次排查真正让我想写下来的,不是技术本身——而是从问题提报到解决全程AI的作用:问题定位:业务方反馈了一个异常单号说「下发失败」,一线运维同事直接在日志系统捞到相关的系统日志,用IDE打开下游代码库,把异常信息给到JoyCode——AI 直接指向了问题是serialType值非法,系统只接受0和1,而当前上游给的是-1。

京东科技开发者 720

SKill测评:谁才是真正的Skill之王?

巧合的是,阿里近期开源了一款名为 Skill-Up 的测评工具——它专门面向 Agent Skill 开发者,支持在 Claude Code、Codex、Qoder CLI 等真实 Agent Engine 环境中验证 Skill 的功能正确性,并可将失败用例转化为精准的修复指引,同时支持本地与 CI 环境的持续回归。2026年,Skill 的热度不减,已成为 AI 辅助编程领域的标配。在日常研发中,无论是沉淀个人经验,还是将团队的优秀范本标准化,将知识“蒸馏”为 Skill 已是大家的常规操作。

京东科技开发者 641

让AI真正参与工作!JoyDesk已上线京东云

JoyDesk提供覆盖AI资产管理、权限控制、安全策略、审批审计、运营监控等企业级治理能力,支持按组织、角色和项目进行精细化权限管理,并支持私有化部署,确保企业数据边界清晰、AI行为全程可追溯、安全策略灵活可配置,满足金融、政企等行业对数据安全和合规治理的要求,让AI真正成为企业可信赖的生产力。JoyDesk支持MCP协议、标准API、技能等多种开放接入方式,可快速连接企业现有业务系统,将业务能力封装为AI可调用的技能和专家,让AI能够理解业务流程、调用业务系统、完成业务任务,而无需改变企业原有IT架构。

京东科技开发者 674

【全栈实践】第一个 AI Agent 项目:从零搭建 AI 音频创作助手【最终版】

这个项目展示了AI Agent 在垂直内容创作领域端到端自动化:从内容理解到播客输出,全流程 AI 驱动多模态融合:文字、图片、音频、视频统一处理专业级音频质量:音色设计 + 智能混音,输出广播级品质低门槛使用:可视化配置 + 自然语言交互,无需技术背景。

京东科技开发者 563

【全栈实践】第一个 AI Agent 项目:从零搭建 AI 音频创作助手(高级篇)

这是一个 AI 驱动的播客创作助手,专注于从文字/视频/音频内容识别到播客制作的全流程。你可以用自然语言与它对话,也可以上传视频和音频,它会理解意图、调用相应的语音合成工具,把他们变成真实的播客音频。

京东科技开发者 728

【全栈实践】第一个 AI Agent 项目:从零搭建 AI 音频创作助手(进阶篇)

这是一个AI 驱动的音频内容创作助手。你可以用自然语言与它对话,它会理解意图、调用相应的语音合成工具,把文字变成真实的播客音频,并保存在本地。关于项目的详细介绍见第一篇文章:第一个 AI Agent 项目:从零搭建 AI 音频创作助手(入门篇)这篇文章更多介绍进阶篇添加的功能。

京东科技开发者 552

【全栈实践】第一个 AI Agent 项目:从零搭建 AI 音频创作助手(入门篇)

这个项目让我第一次把前端、后端、AI Agent 三块内容独立串联起来。技术选型上每一块都是当下主流的方案,实际跑通整条链路之后对"全栈"有了更具体的感受。框架版本要锁定:LangChain 这类快速迭代的框架,版本差异带来的问题远比你想象的多先跑通链路,再追求完美:新手阶段能把用户输入 → AI 处理 → 结果展示这条链跑通,比深入某个技术点更有价值多看官方文档:相比博客和教程,官方文档更新及时,特别是 LangGraph 这种新框架后续计划继续迭代,欢迎交流!

京东科技开发者 610

ICLR 2026 | 面向序列决策的贝叶斯集成方法

在这篇工作中,我们关注的是。

京东科技开发者 296

ICML 2026|NaviAgent:面向 Oxygen 智能体的可扩展工具编排

大型语言模型(LLM)越来越多地作为函数调用代理,调用外部工具来处理超出其静态知识范围的任务。然而,它们通常一次只调用一个工具,缺乏对任务结构的全局视图。由于工具之间往往相互依赖,这会导致错误累积和可扩展性差,尤其是在扩展到数百或数千个工具时。为了解决这些局限性,我们提出了NaviAgent,一种显式的双层架构,它通过基于图的工具关系建模将任务规划与工具执行解耦。在规划层,基于 LLM 的代理决定是直接响应、澄清意图,还是检索并执行一个独立于工具间复杂性的工具链。

京东科技开发者 389

实测 9 款 AI 架构图工具:从 Mermaid 美化到 GPT-Image2,一份选型清单

支持 5 类图(架构图、工作流图、时序图、数据流图、生命周期/状态机图),主题 4 种(Classic、Signal Flow、Blueprint、Editorial)+ 3 种色彩模式(Dark / Light / System Auto),输出格式含 HTML、PNG、SVG、WebM、Share Card PNG、JSON IR。它把提示词图库、图像生成案例、参考图编辑流程和命令行工具整合在一起,让 AI Agent 能直接调用 GPT Image 2 模型完成文生图、图生图、参考图编辑等任务。

京东科技开发者 906

别再守着 Claude Code 了——学会指挥它自主干活

回到开头那句:别再一句一句地喂它、然后守着屏幕。真正的用法是——把一件事想清楚、划好边界、给它一个能自我验证的目标,然后交出去。你会发现,省下来的时间不是一点半点。把重复的判断和执行还给机器,把真正需要你的判断留给自己。

京东科技开发者 587

CVPR 2026|Oxygen XR 团队在原生鱼眼高斯泼溅技术上带来新突破

京东零售技术团队联合清华大学提出DirectFisheye-GS框架,创新性地将鱼眼相机模型原生嵌入3D高斯泼溅管线,通过跨视角联合优化策略直接处理鱼眼图像,避免了传统去畸变预处理导致的信息损失。该方案在多个公开数据集上达到SOTA性能,有效解决了单视角优化引起的几何畸变和视角不一致问题,同时保持与现有3DGS工具链的兼容性。技术已应用于电商3D重建和4D体积视频等场景,显著提升了沉浸式体验。相关论文被CVPR 2026接收,为宽视场场景重建提供了高效解决方案。

京东科技开发者 355

拆解海博 AI-Native 落地保障:Harness、双 Loop、知识库与技能自主迭代实践

海博研发RoadMap 的落地,彻底终结了 AI 编程“对话式玄学”的旧模式,真正落地了AI Native 研发工程化。它证明 AI 规模化赋能研发的核心,不在于堆砌大模型能力,而在于用工程思维重构 AI 的工作范式:用结构化流程替代随机对话,用固化规则约束模型行为,用持续沉淀实现能力复利,用分层架构支撑规模化落地。

京东科技开发者 638

让 AI 快速「读懂」你的代码仓:Joy-Code-Graph 云端图谱服务的三次进化

代码知识图谱不是要取代 AI 的智能,而是要补齐它对代码全局关系的认知盲区。当 AI 能一眼看清「谁调用了谁、改动会波及哪里」,它写出的代码才真正靠谱;当这份认知安全地留在自己手里、随时被 Joygen 调用、并且永久沉淀在代码仓里——AI 编程的体验,才算真正上了一个台阶。这,就是我们做 Joy-Code-Graph 云端服务的初衷。能力共享,数据自主;一次建图,长期受用。

京东科技开发者 752

【Coding生态】从代码托管到 AI 能力底座:与Coding一起共建 AI 研发生态

前两种框架能够很好地支撑对话式能力和预设流程式能力。它们适合基于提示词或预设工作流完成研发问答、知识查询、流程编排等任务。但在更复杂的研发场景中,仅仅“回答问题”还不够。当用户业务逻辑复杂时,一旦场景进入真实落地阶段,例如下载代码、修改文件、执行命令、安装依赖、运行测试、读取完整代码文件,或者与自有系统联动、将结果渲染到 Coding 页面、推送到京 ME,AI 应用需要的不只是知识能力,还需要真实的代码库操作能力和独立可执行环境。

京东科技开发者 768

GPT-5.6、ChatGPT Work 与 Codex 更新食用指南

三档模型当前都提供 1,050,000 tokens 上下文、922,000 tokens 最大输入和 128,000 tokens 最大输出,接受文本与图像输入、输出文本,并支持 web search、file search、Computer Use、MCP、Tool Search、Skills、Apply Patch 等工具。Work 可以读取你提供的文件,通过插件连接 Slack、Google Drive、SharePoint、邮箱、日历、CRM 或项目系统,调用获批工具,并在执行中展示进度。

京东科技开发者 873

把业务流程沉淀成高质量 Skill 的实践路径

使用Record & Replay创建的Skill,尽管创建流程简单,但它的本质实际是让 AI 去操作页面,这不但有可能影响我们对电脑的操作,还有可能无法稳定复现。创建Skill时,可以使用 Codex 的 Record & Replay 插件,把一次手工操作录下来,再让 AI 生成可复用流程。刚开始切换时,很容易遇到接口报错,可以让Codex排查原因进行优化,直到可以稳定执行;补充相应业务背景,说明这件事为什么要做,谁会用,输入从哪来,输出给谁看。电脑休眠、关机、软件没开时,本地任务可能无法执行。

京东科技开发者 836

政企前台AI-Agent的架构实践:打造可复用的 AI 服务平台-【灯塔计划】

不止是爆火的龙虾,还是各种Skills,MCP、Agent,脱离的具体的场景谈方案,最后只会是一场空。这一套可复用的 AI 服务平台,截止目前,通过前后端对接规范文档,多项能力已快速接入到各个场域的不同端平台,大幅降低研发成本, 并且各业务线新场景的接入从原来的 “开发驱动” 转为 “配置驱动”,接入周期从天维度缩短至小时级。

京东科技开发者 864
上一篇: 代码之美-代码整洁之道
下一篇: 递归算法实践--到仓合单助力京东物流提效增收
京东云开发者
京东云开发者 企业官方账号 企业官方账号
博客等级 码龄8年 1万+粉丝 2141原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值