


GPT5.6的发布,OpenAI 同时更新了模型、长任务功能和代码执行环境,使得用户可以提交目标、材料和验收标准,并获得可审阅的结果。
Chat 适合回答问题和处理短任务;Work 可以找资料、调用工具、制作文档;Codex 可以修改仓库、运行测试、审查 diff。
零、先说结论
- 官方名称需要分开写。GPT-5.6 是模型家族;ChatGPT Work 和 Codex 是使用这些模型的产品功能。“ChatGPT 5.6”只是日常简称。
- GPT-5.6 提供 Sol、Terra、Luna 三种模型。 它们分别面向复杂高价值、日常均衡、清晰高频任务;先按任务选模型,再按需要提高推理强度。
- Chat、Work、Codex 的分工清楚了。 Chat 负责快速回答,Work 负责可审阅的交付物,Codex 负责可验证的代码与工程任务。
- Codex 已并入 ChatGPT 桌面端。 项目、设置和工作流会保留,同时增加应用内编辑、PR 评审和多仓库项目。
- vibe coding 更容易上手,验收却省不掉。 GPT-5.6 更善于理解意图和做前端,需求边界、权限、测试与人工审阅仍要明确。
- API 团队可以使用一组新的 Agent 运行能力。 Programmatic Tool Calling、多智能体 beta、显式缓存、跨轮次推理和 Pro mode,分别处理长任务中的数据加工、并行、成本与连续性问题。
一、这次到底发布了什么
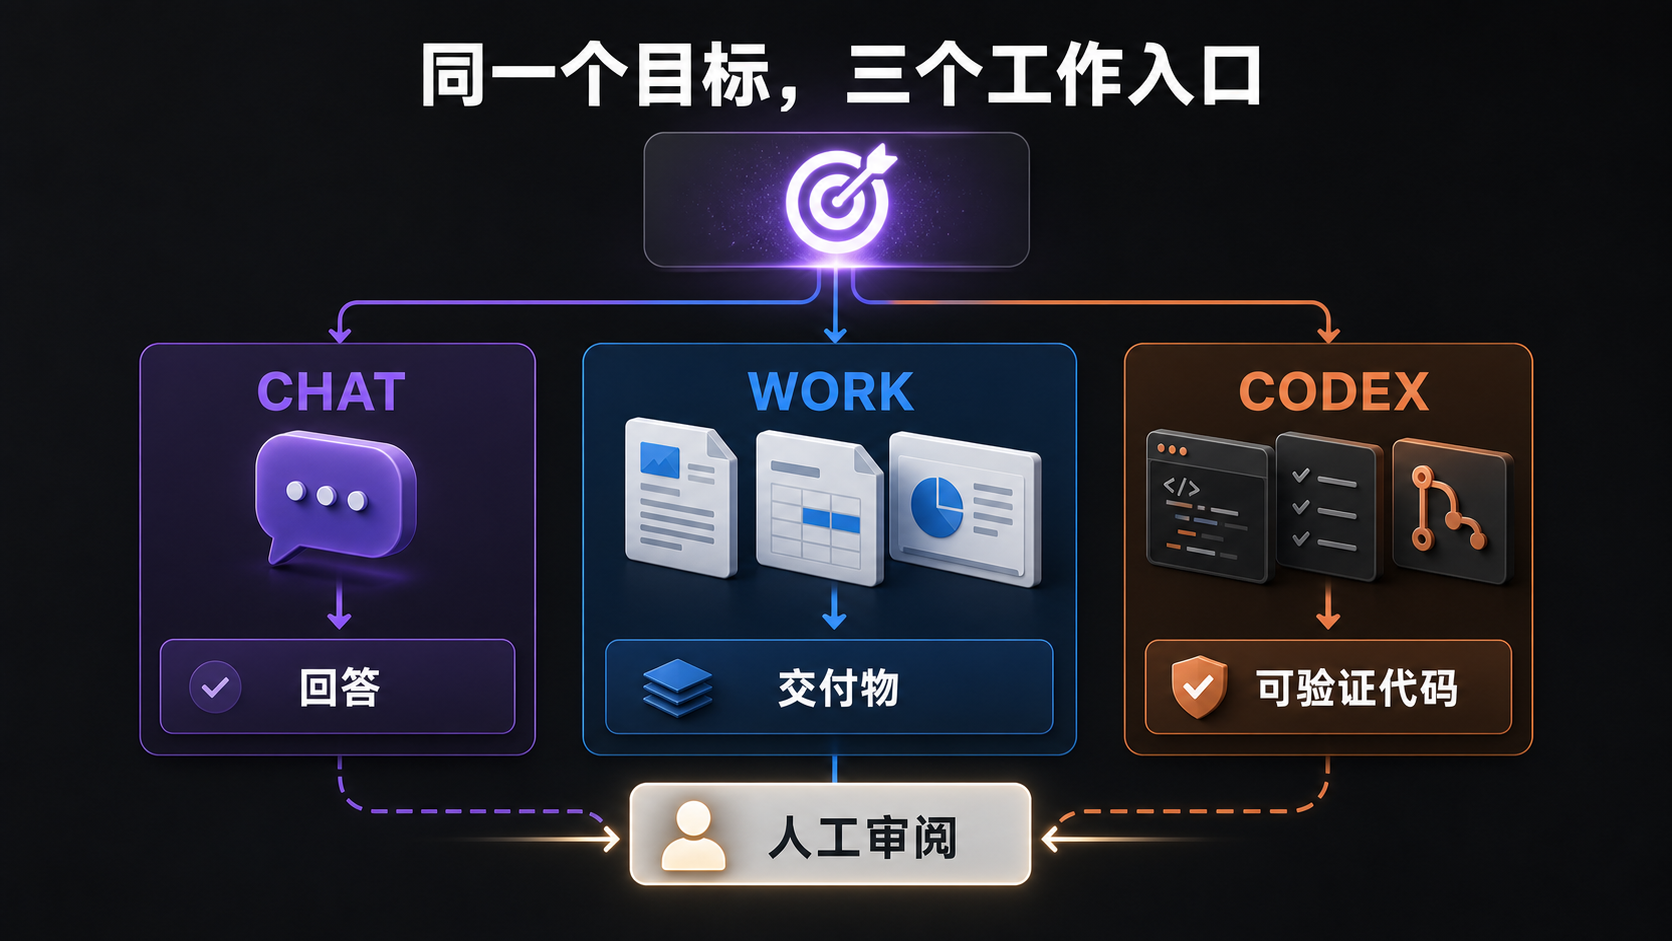
OpenAI 在 2026 年 7 月 9 日发布的内容分为模型、产品和工程工具三部分:
| 层次 | 更新 | 直接变化 | 对工作方式的影响 |
| 模型 | GPT-5.6 | Sol / Terra / Luna 三档模型,支持更高推理、工具调用与长任务 | 同一套能力可以按质量、速度和成本路由 |
| 产品 | ChatGPT Work | 可围绕目标持续数小时,调用文件、插件和工具,产出文档、表格、演示和 Sites | ChatGPT 支持长任务,并输出可审阅的交付物 |
| 工程 | Codex 进入 ChatGPT 桌面端 | 编辑、代码、PR、终端、Computer Use、多仓库项目进入同一应用 | 产品工作与代码工作进入同一个应用与本地操作环境 |
官方在 7 月 6—10 日更新摘要里,把三件事列在同一个发布周期中;Codex Changelog 的 7 月 9 日条目标题是 “Codex joins the ChatGPT desktop app”。在桌面端,用户可以在同一任务中管理工具、文件和审阅。
时间线上还有一个细节:GPT-5.6 在 6 月 26 日先向少量受信任伙伴开放预览,7 月 9 日正式发布。预览阶段与美国政府的网络安全评测协调有关;相关行政令规定的是最长 30 天的自愿协作框架,并非发布许可或强制审批。理解产品时,区分“有限预览”和“正式可用”即可,监管背景不能拿来证明模型能力。
名词纠正:下文统一使用 GPT-5.6 指模型家族,使用 ChatGPT Work 指长任务功能,使用 Codex 指代码与工程功能。
二、GPT-5.6:先选模型,再设置推理强度
2.1 Sol、Terra、Luna 怎么分
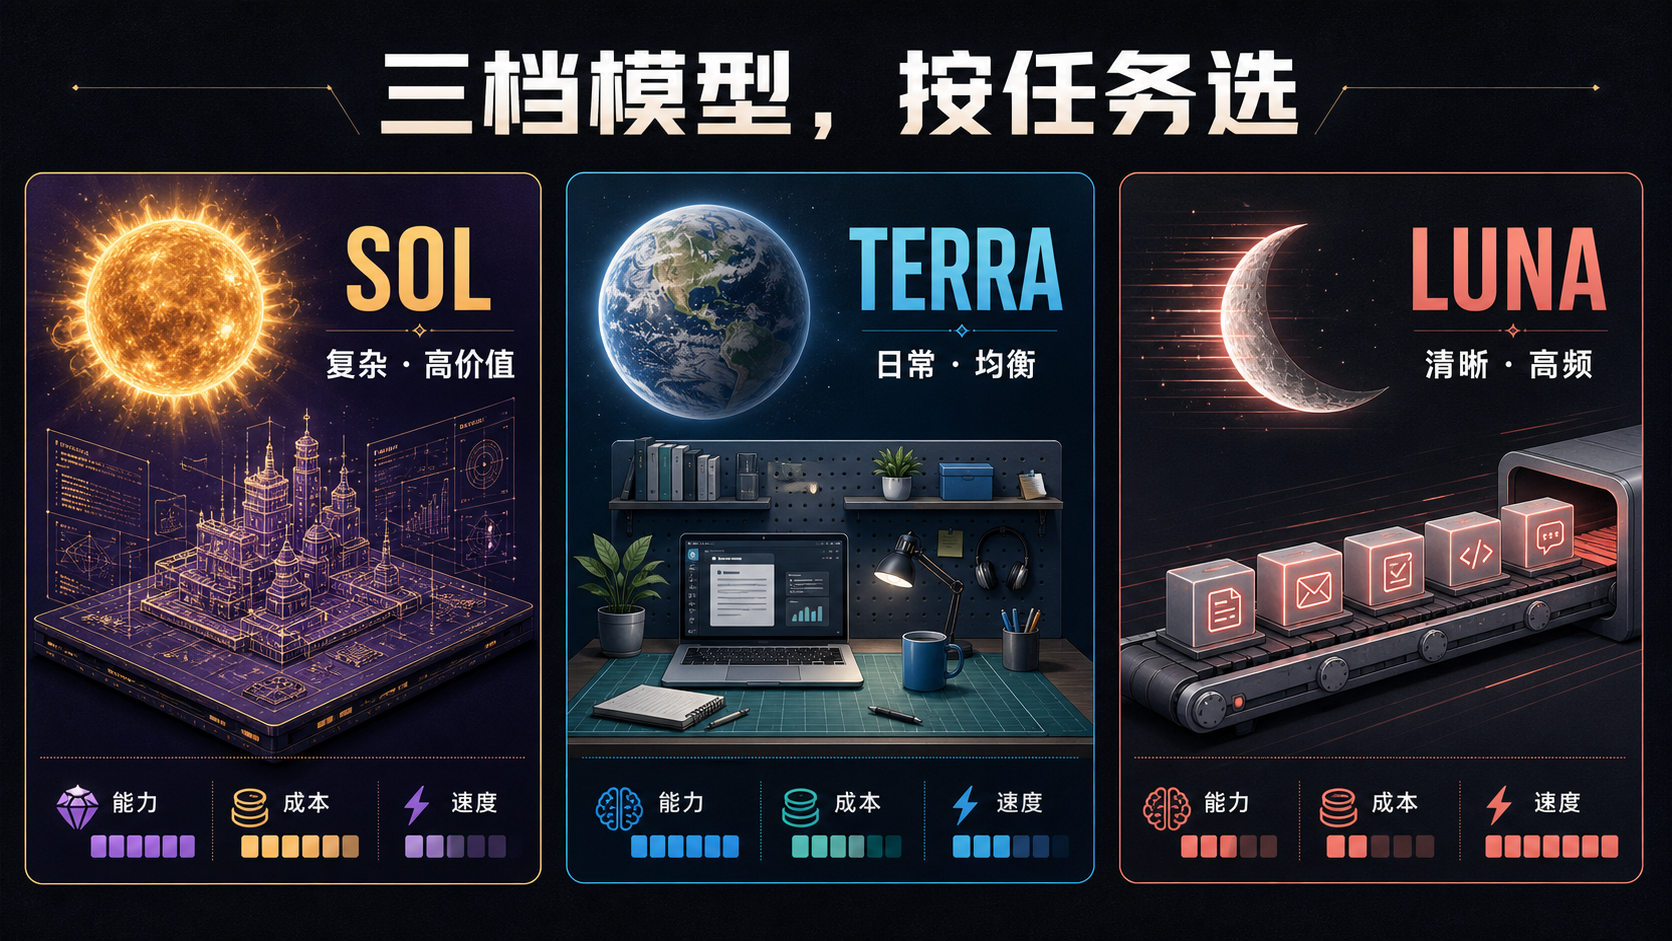
| 模型 | 官方定位 | 推荐任务 | 不建议默认使用的场景 |
|---|---|---|---|
gpt-5.6-sol | 旗舰能力,复杂编码、Computer Use、研究和安全工作最强 | 跨仓库重构、复杂产品研究、高价值方案、难排障、成品级前端 | 规则明确的批处理、简单改写和高频抽取 |
gpt-5.6-terra | 能力与成本均衡,官方称可用更低成本获得与 GPT-5.5 有竞争力的表现 | 日常编码、PR 评审、需求整理、数据分析、常规 Agent | 极难问题或大量完全固定的流水线任务 |
gpt-5.6-luna | 家族中最快、成本最低,面向清晰高频任务 | 分类、抽取、格式转换、结构化摘要、批量轻任务 | 高歧义决策、复杂架构判断、重要安全审计 |
如果你不想研究参数,直接从 Power 开始即可:官方默认配置是 gpt-5.6-sol + medium reasoning。日常大量任务可优先试 Terra,固定规则的批处理再试 Luna。
API 里,gpt-5.6 别名会路由到 gpt-5.6-sol。三档模型当前都提供 1,050,000 tokens 上下文、922,000 tokens 最大输入和 128,000 tokens 最大输出,接受文本与图像输入、输出文本,并支持 web search、file search、Computer Use、MCP、Tool Search、Skills、Apply Patch 等工具。
2.2 API 价格与产品可用范围
下面是 OpenAI 公布的 API 标准价格。ChatGPT 订阅费用另行计算:
| 模型 | 输入 / 1M tokens | 输出 / 1M tokens | 适合怎么用 |
|---|---|---|---|
gpt-5.6-sol | $5.00 | $30.00 | 少量、高价值、复杂度高的任务 |
gpt-5.6-terra | $2.50 | $15.00 | 日常主力与成本敏感的交互任务 |
gpt-5.6-luna | $1.00 | $6.00 | 规则清晰、量大、可评测的任务 |
输入输出规模相同时,Luna 的名义 token 价格约为 Sol 的五分之一。实际选型还要看每个合格交付物的总成本:失败重试、工具调用、reasoning、缓存和人工返工都算在内。
产品侧的首发可用范围也不同:
- Chat:Plus、Pro、Business、Enterprise 可使用 GPT-5.6 Sol 的 medium 及以上设置;Pro 和 Enterprise 还可选择 Sol Pro。
- Work 与 Codex:Free 和 Go 使用 Terra;Plus、Pro、Business、Enterprise 可选择 Sol、Terra、Luna。
- 高阶设置:在 Work 与 Codex 中,有 GPT-5.6 访问权的用户可启用 Max;Ultra 在 Work 面向 Pro、Enterprise,在 Codex 面向 Plus 及以上计划。
这些权限仍可能受地区、管理员设置和渐进发布节奏影响。做团队推广前,先用真实工作区确认,不要只看宣传页。
2.3 Light、Medium、Max、Ultra 四种推理设置
- Light / Low:任务清楚、追求快,例如改一段文案、修一个小函数。
- Medium:默认均衡档,适合大多数需要计划与检查的任务。
- High / Extra High:多步骤、跨来源、存在权衡的复杂任务。
- Max:增加单个模型的推理投入,适合质量优先且能接受等待的难题。
- Ultra:启动多个 subagents 并行分工;官方默认配置会协调四个 agent,适合能拆成独立工作流的大任务。
选择时先看任务结构:难且不可拆,用 Max;大且能拆,用 Ultra;其余先用 Medium。 官方提醒,大多数任务并不需要 Max 或 Ultra,Ultra 的高并发还可能快速增加用量。
2.4 产品和 vibe coding 相关变化
前端完成度更高。 OpenAI 将布局、视觉层级、设计判断和可用性单独列为 GPT-5.6 的提升方向。生成的页面更接近可用产品,但设计系统、品牌规范和真实用户测试仍由团队负责。
模糊需求更容易被理解。 不必再把每个中间步骤都写成操作手册,但权限边界、禁止动作和验收标准仍应明确。这些内容一旦含糊,最后的误操作和返工仍由团队承担。
旧 prompt 可以适当缩短。 OpenAI 的内部评测显示,把冗长 system prompt 缩短后,分数提高约 10%—15%,总 token 降低 41%—66%,成本降低 33%—67%。这组数据不一定能在每个业务里复现,可靠的做法是先删重复规则,再用真实 eval 检查是否需要补回约束。
GPT-5.6 本身已经偏向压缩输出。只写“尽量简短”,可能把必需交付物也一起删掉。可以改成:
结论先行。保留完成任务所需的事实、证据、风险和下一步;
优先删除套话、重复和与决策无关的背景。
2.5 Benchmark:终端和浏览表现突出,代码修复仍有差距
正式发布页给出了较完整的评测矩阵。下面只取四项和产研工作关系较大的数据,用来判断它擅长什么、又在哪里落后:
| 评测 | GPT-5.6 Sol | Sol Ultra | 说明 |
|---|---|---|---|
| Terminal-Bench 2.1 | 88.8% | 91.9% | 终端规划、迭代和工具协同;并行 agent 进一步提升结果 |
| OSWorld 2.0 | 62.6% | — | 桌面环境中的计算机操作能力 |
| BrowseComp | 90.4% | 92.2% | 自主浏览、查找和整合信息 |
| SWE-Bench Pro | 64.6% | — | 真实代码库修复;低于 Fable 5 的 80.0% 和 Mythos 5 的 80.3% |
四项评测的结果差异明显:GPT-5.6 在终端、浏览器和计算机操作上表现突出,Ultra 能改善可并行任务的结果;在 SWE-Bench Pro 这类深层代码修复评测上,它落后于表中两个对比模型。选型时应先判断自己的任务更接近哪类评测。
评测说明:以上数字来自 OpenAI 2026 年 7 月 9 日正式发布页。不同评测使用不同 harness、reasoning 和 agent 配置,只能用于理解能力边界,不能替代团队自己的回归集。
三、ChatGPT Work:适合有明确交付物的长任务
官方对 Chat 和 Work 的区分很实用:
- 需要答案、解释、脑暴或短草稿,用 Chat。
- 需要一份可以审阅和使用的 brief、PPT、表格、分析、网站或重复工作,用 Work。
- 需要修改仓库、运行命令、验证代码、处理 PR,用 Codex。
Work 可以读取你提供的文件,通过插件连接 Slack、Google Drive、SharePoint、邮箱、日历、CRM 或项目系统,调用获批工具,并在执行中展示进度。你可以补充信息、改变方向,也可以要求它在发送、发布或其他关键动作前停下来等审批。
3.1 Work prompt 示例:先写清交付要求
一个可委托任务至少要有五个元素:
目标结果 + 可信来源 + 关键边界 + 验收标准 + 人工审批点例如:
阅读附件中的用户访谈、问卷结果和历史 PRD,产出一份 8 页产品评审稿,
面向产品与研发负责人。聚焦三个最常见的问题,用原始材料支持每个结论,
把事实、推断和建议分开。信息不足时明确标记,不要补造数字。
先给我目录和证据缺口,确认后再生成最终 PPT;不要对外发送。
这条 prompt 写清了两件容易被遗漏的事:什么叫完成,以及什么时候必须停下来等人确认。
3.2 用 Scheduled tasks 持续执行 Work 任务
Scheduled tasks 可以按一次、周期、事件或监控条件运行。典型用法包括:
- 每周汇总竞品、用户反馈和项目风险,更新同一份例会材料;
- 监控 GitHub CI 或线上指标,有变化时回到原任务继续排查;
- 定期刷新研究、表格或站点内容;
- 让一个已经稳定的 Skill 在固定时间运行。
建议先手动完成一次,再设置定时执行。Skill 记录操作方法,Scheduled task 规定执行时间。无人值守任务应使用尽可能窄的文件、网络和应用权限。
四、Codex 进入 ChatGPT 桌面端:项目、编辑和 PR 放到了一起
7 月 9 日之后,Codex 成为 ChatGPT 桌面端的一部分,覆盖 macOS 和 Windows。原 Codex 用户按原方式升级即可,项目、设置和工作流会保留;还可以把 Codex 设为默认视图,macOS 用户也可继续使用 Codex 图标。
研发侧较实用的变化有四个:
- 直接编辑 Markdown 与代码。 可以在应用里选择内容、写 inline annotation,再让 Codex 只改选中部分。
- PR 审阅进入侧边栏。 diff、reviewer feedback 和修改动作出现在同一上下文,减少 GitHub 与本地工具之间的切换。
- 一个项目可以跨多个仓库。 对前后端、SDK + 服务端、应用 + 基础设施这类联动改动更实用。
- GPT-5.6 驱动更快的 Computer Use。 Codex 可以在同一任务中处理代码、浏览器预览和桌面应用操作,但敏感动作仍受审批和权限约束。
CLI 用户建议升级到 7 月 9 日的 0.144.1:
npm install -g @openai/codex@0.144.1
0.144.0 还增加了一个值得企业团队关注的 writes 应用审批模式:声明为只读的动作可以直接运行,写操作仍然需要确认。它比“全部允许”或“每次都问”更符合真实 Agent 工作流。
当前限制:ChatGPT 桌面端、Codex CLI 和 IDE extension 可以选择 GPT-5.6;Codex cloud 任务目前由平台指定默认模型,用户不能手动更改。介绍团队使用范围时,应把本地模型选择和 cloud 任务分开说明。
五、Vibe Coding:生成更快,验收不能省
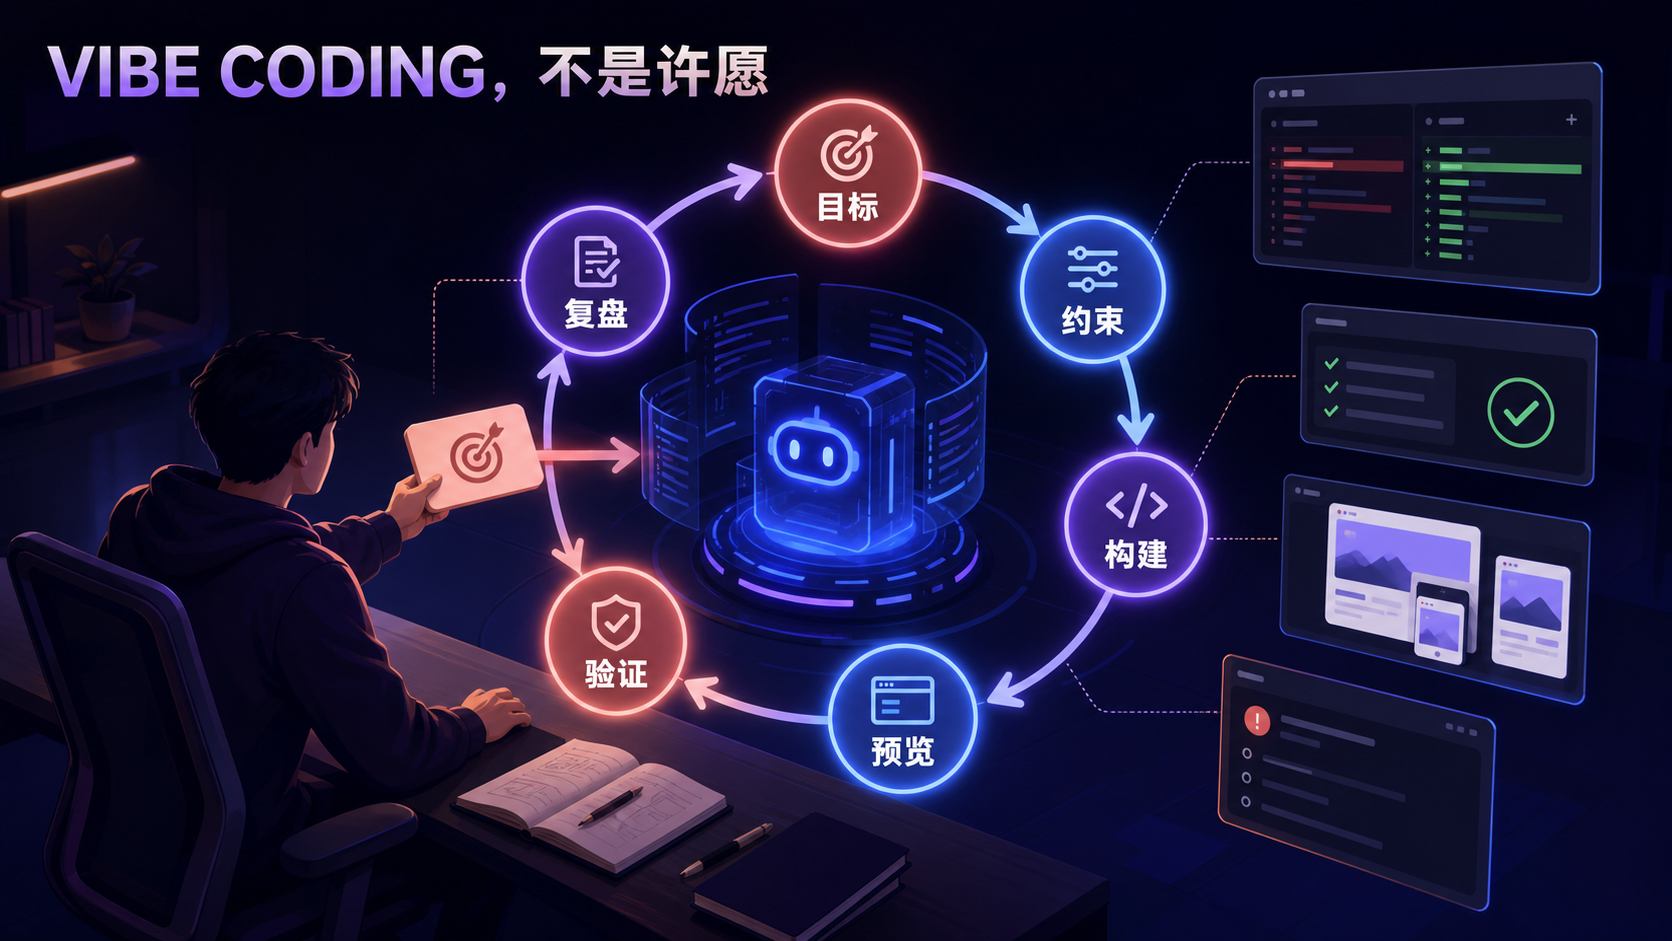
GPT-5.6 提升了前端设计和意图理解能力;Codex 提供浏览器、Computer Use、diff 和测试环境。没有专业开发经验的用户,也更容易完成一个可运行的产品。
但一个稳定的 vibe coding 循环仍然是:
目标 -> 约束 -> 构建 -> 预览 -> 验证 -> 复盘需要避免的流程:
提出模糊需求 -> 跳过检查 -> 直接部署5.1 一条可直接复制的 vibe coding prompt
请在当前项目中完成一个可运行的活动报名页。

目标:用户能理解活动价值、查看时间地点、填写报名信息,并看到成功状态。
范围:只修改当前前端项目;不要接真实支付,不要部署,不要改现有登录逻辑。
视觉:延续项目已有字体、颜色和组件;重点做好移动端层级、间距和表单反馈。
验证:启动本地项目,用浏览器检查 390px 与 1440px 两个视口;
      走通正常提交、空字段、错误手机号和重复提交;修复发现的问题。
交付:列出修改文件、关键设计判断、验证结果和仍需人工确认的内容。
这里刻意省略了“先写 HTML 再写 CSS”一类操作步骤,让模型自己规划过程;目标、范围和验证则不能省,它们决定页面最后能不能用。
5.2 Sites:版本审阅、分享和部署
Sites 是 ChatGPT 中的网站、Web App 和游戏托管功能,目前处于 public beta。可以用一条 prompt 新建,也可以导入兼容的本地项目。发布分成两个动作:先保存版本供审阅,再部署。
保存版本 -> 人工审阅 -> 部署版本 -> 获得生产 URL每一次 Deploy 都是生产部署。如果只是想让团队看效果,应明确要求“保存一个版本,不要部署”。需要持久化数据时,可以要求 D1 关系数据库;需要图片、文档、音视频等上传时,可以要求 R2 对象存储。访问范围可按账号与工作区设置为仅自己或受邀者、整个工作区、任何持有链接的人;工作区管理员仍可限制公共分享。
一条更安全的 Sites prompt 可以这样写:
请用 Sites 为当前项目准备一个可部署版本。
先检查项目兼容性、数据存储和环境变量需求,列出需要修改的文件。
用户提交的数据需要持久保存,请使用 D1;上传文件请使用 R2。
先保存版本并给我预览、代码 diff 和访问范围建议,不要部署。
只有我确认版本、权限和数据处理方式后,才创建生产部署。
不要把密钥写进 prompt、附件或 .openai/hosting.json;应通过 Sites 设置维护托管环境变量。这样既能快速做出页面,也能在部署前检查版本、权限和数据处理方式。
5.3 产品经理怎么用
把需求讨论交给 Chat,把调研、PRD、竞品表和汇报稿交给 Work,把原型或已有项目的真实修改交给 Codex。不要让一个入口同时承担所有职责。
5.4 研发怎么用
任务说明里应写清:允许改什么、不能碰什么、必须运行哪些测试、失败时何时停止、最终需要哪些证据。跨仓库任务先让 Codex 列出受影响的仓库和文件,再授权实现。
5.5 设计师怎么用
给它真实设计稿、截图或设计系统,让它在浏览器里做前后对照;再按布局、层级、字体、颜色、状态和响应式逐项检查。生成后仍要人工检查品牌一致性、可访问性与极端状态。
六、API 团队:升级重点在 Agent 运行方式
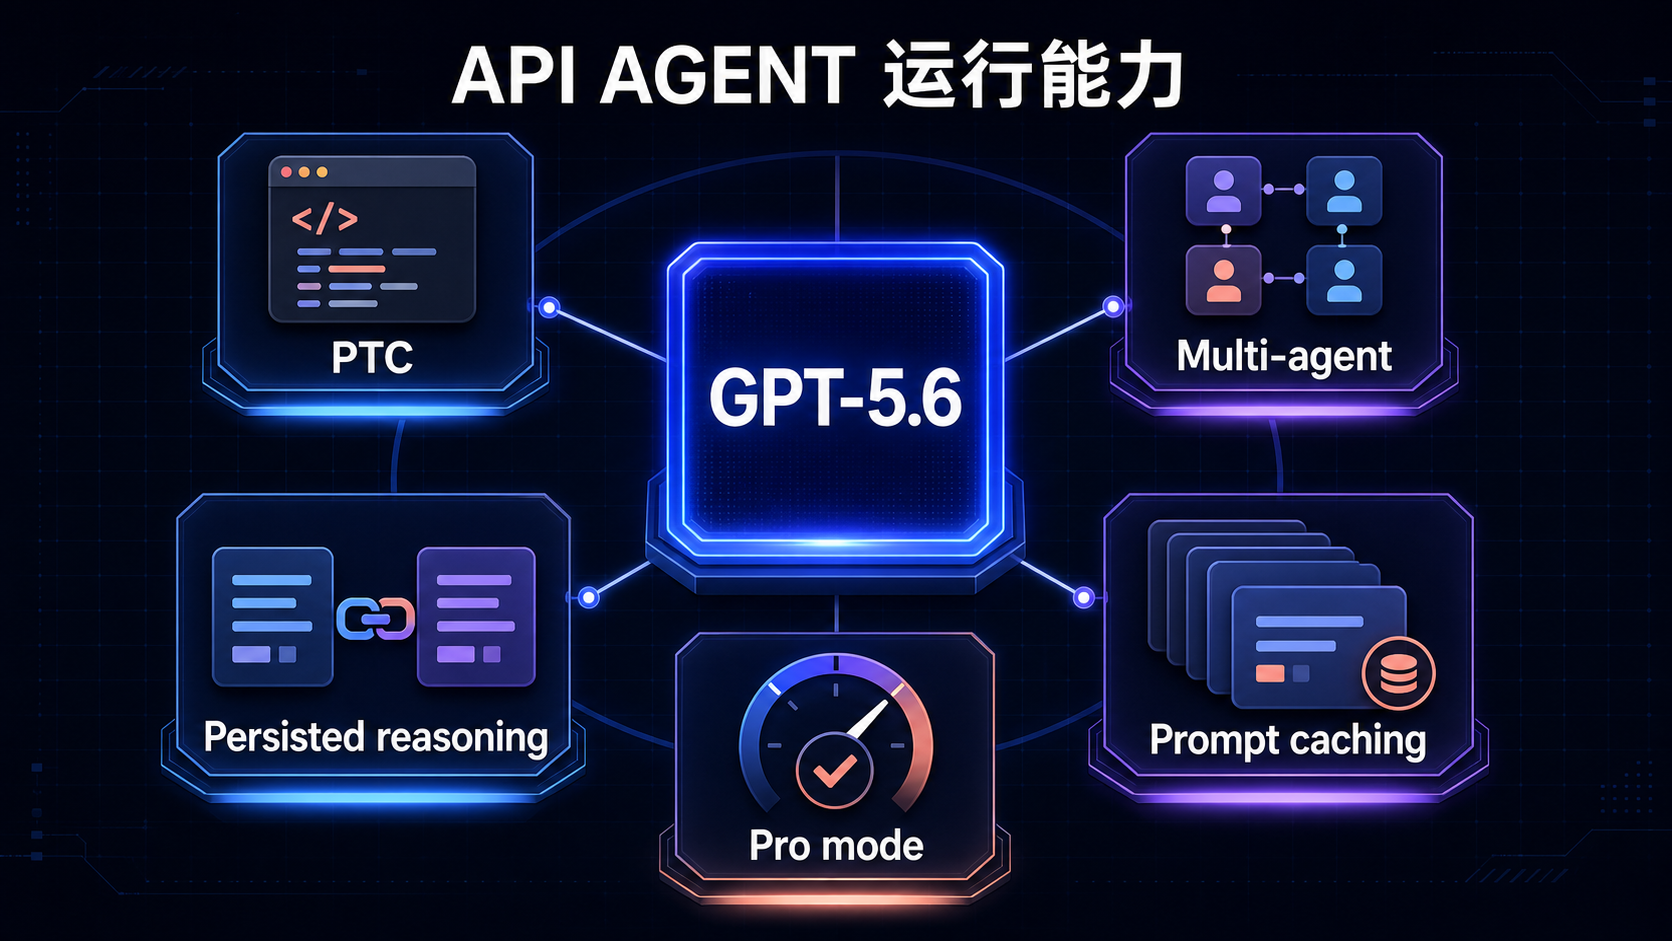
只替换模型 ID 可以获得基础能力提升。Programmatic Tool Calling、多智能体和缓存配置还需要单独接入。
6.1 Programmatic Tool Calling:让模型写一小段程序调工具
GPT-5.6 可以在隔离的 V8 环境里生成 JavaScript,调用已授权工具、并行请求、做循环和条件判断,再把大批中间结果压缩成小型结构化结果。
这个 V8 环境没有 Node.js、包安装、直接网络、通用文件系统、子进程和跨执行持久状态;外部系统访问必须经过请求中明确授权的工具。PTC 适合可预测的数据处理,不适合作为通用后端。
它适合:过滤、去重、聚合、校验、排序,以及数据流明确的依赖调用。
它不适合:每一步都需要新语义判断、需要保留原始引用、涉及审批或写操作的流程。此时应继续使用直接 tool calling,把授权边界留给人和应用。
PTC 可以用于 Zero Data Retention 工作流,但前提是组织或项目本身已经启用 ZDR;单独设置 store: false 只表示无状态续传,不等于自动获得 ZDR。
6.2 Multi-agent beta:并行有用,但先问能不能拆
Responses API 的 Multi-agent 仍是 beta。适合把大任务拆成互不依赖的研究、代码扫描、方案比较或测试工作流,再由主模型合并结果。若多个子任务会频繁修改同一文件、共享隐藏状态或相互等待,并行只会制造冲突。
6.3 Persisted reasoning:保留跨轮次推理上下文
reasoning.context 可以选择只保留当前轮次,或在支持的模型上让早期 reasoning items 跨轮次继续参与后续推理。这对稳定目标下的长任务有帮助;当目标或假设改变时,应切回 current_turn,避免旧推理拖累新方向。
6.4 显式 Prompt Caching:核算缓存读写成本
GPT-5.6 允许精确标记可复用前缀,也保留自动缓存。默认最低缓存生命周期为 30 分钟;缓存写入按未缓存输入价格的 1.25 倍计费,命中读取享受 90% 的 cached-input 折扣。大于 272K 输入 tokens 的请求,整个请求的输入按 2 倍、输出按 1.5 倍计价。无选择地粘贴全部资料会增加成本。
可以按这个顺序配置:把稳定的系统指令、工具和示例放在前缀,把用户变量放在后面;给同一类前缀设置稳定的 prompt_cache_key;同时观测 cache_write_tokens 和 cached_tokens。否则缓存写入越多,账单不一定越低。
6.5 Pro mode:为少量困难任务增加计算投入
API 中不需要寻找 gpt-5.6-pro。在所选 GPT-5.6 模型上配置 reasoning.mode: "pro" 即可让系统为困难任务投入更多模型工作,返回一个最终答案。它会增加延迟与用量,适合高价值代码审查、复杂优化和深度分析,不适合高频常规请求。
七、已知限制与容易误读的地方
- 桌面端可用不等于每项能力都对所有账号开放。 新 ChatGPT 桌面端全球覆盖所有计划,包括 Free;但 Work、Computer Use、插件、企业策略和区域能力仍可能受计划、管理员设置与灰度节奏影响。
- Codex cloud 暂不支持手动选择默认模型。 本地、桌面端、CLI 和 IDE extension 的模型设置不会同步到 cloud 任务。
- Ultra 与 Multi-agent 会增加成本和协调问题。 只在独立子任务足够清楚时使用。
- 1.05M 上下文仍然需要检索和权限控制。 超长输入还会触发更高 API 价格。
- Computer Use 能操作已登录页面和桌面应用。 账号、权限、支付、隐私、网络和凭证相关流程应保持人在场并逐步审批。
- 安全护栏可能影响合法的双用途工作。 网络安全和生物领域请求可能被实时分类器暂停、复核或拒绝;ChatGPT 与 Codex 提供改用较低能力模型重试的路径。生产系统应记录 request ID、时间和拒绝类型,为合法任务准备人工复核或降级流程。
- 官方 benchmark 仅用于参考。 同一模型在 Terminal-Bench、OSWorld 和 SWE-Bench Pro 上表现差异明显,Ultra 的成绩也不能当成单 agent 成绩。上线前仍要用真实任务评估成功率、人工返工、延迟、成本和越权风险。
参考资料
- What's new:2026 年 7 月 6—10 日更新摘要
- Codex Changelog:2026 年 7 月 9 日桌面端与 CLI 更新
- GPT-5.6 模型选择:Sol / Terra / Luna / Max / Ultra
- ChatGPT Work 上手指南
- Scheduled tasks
- Using GPT-5.6:API 能力、迁移与提示词建议
- GPT-5.6 Sol 模型规格
- GPT-5.6 Terra 模型规格
- GPT-5.6 Luna 模型规格
- Programmatic Tool Calling
- Multi-agent
- Reasoning 与 persisted reasoning
- Prompt Caching

 246


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


