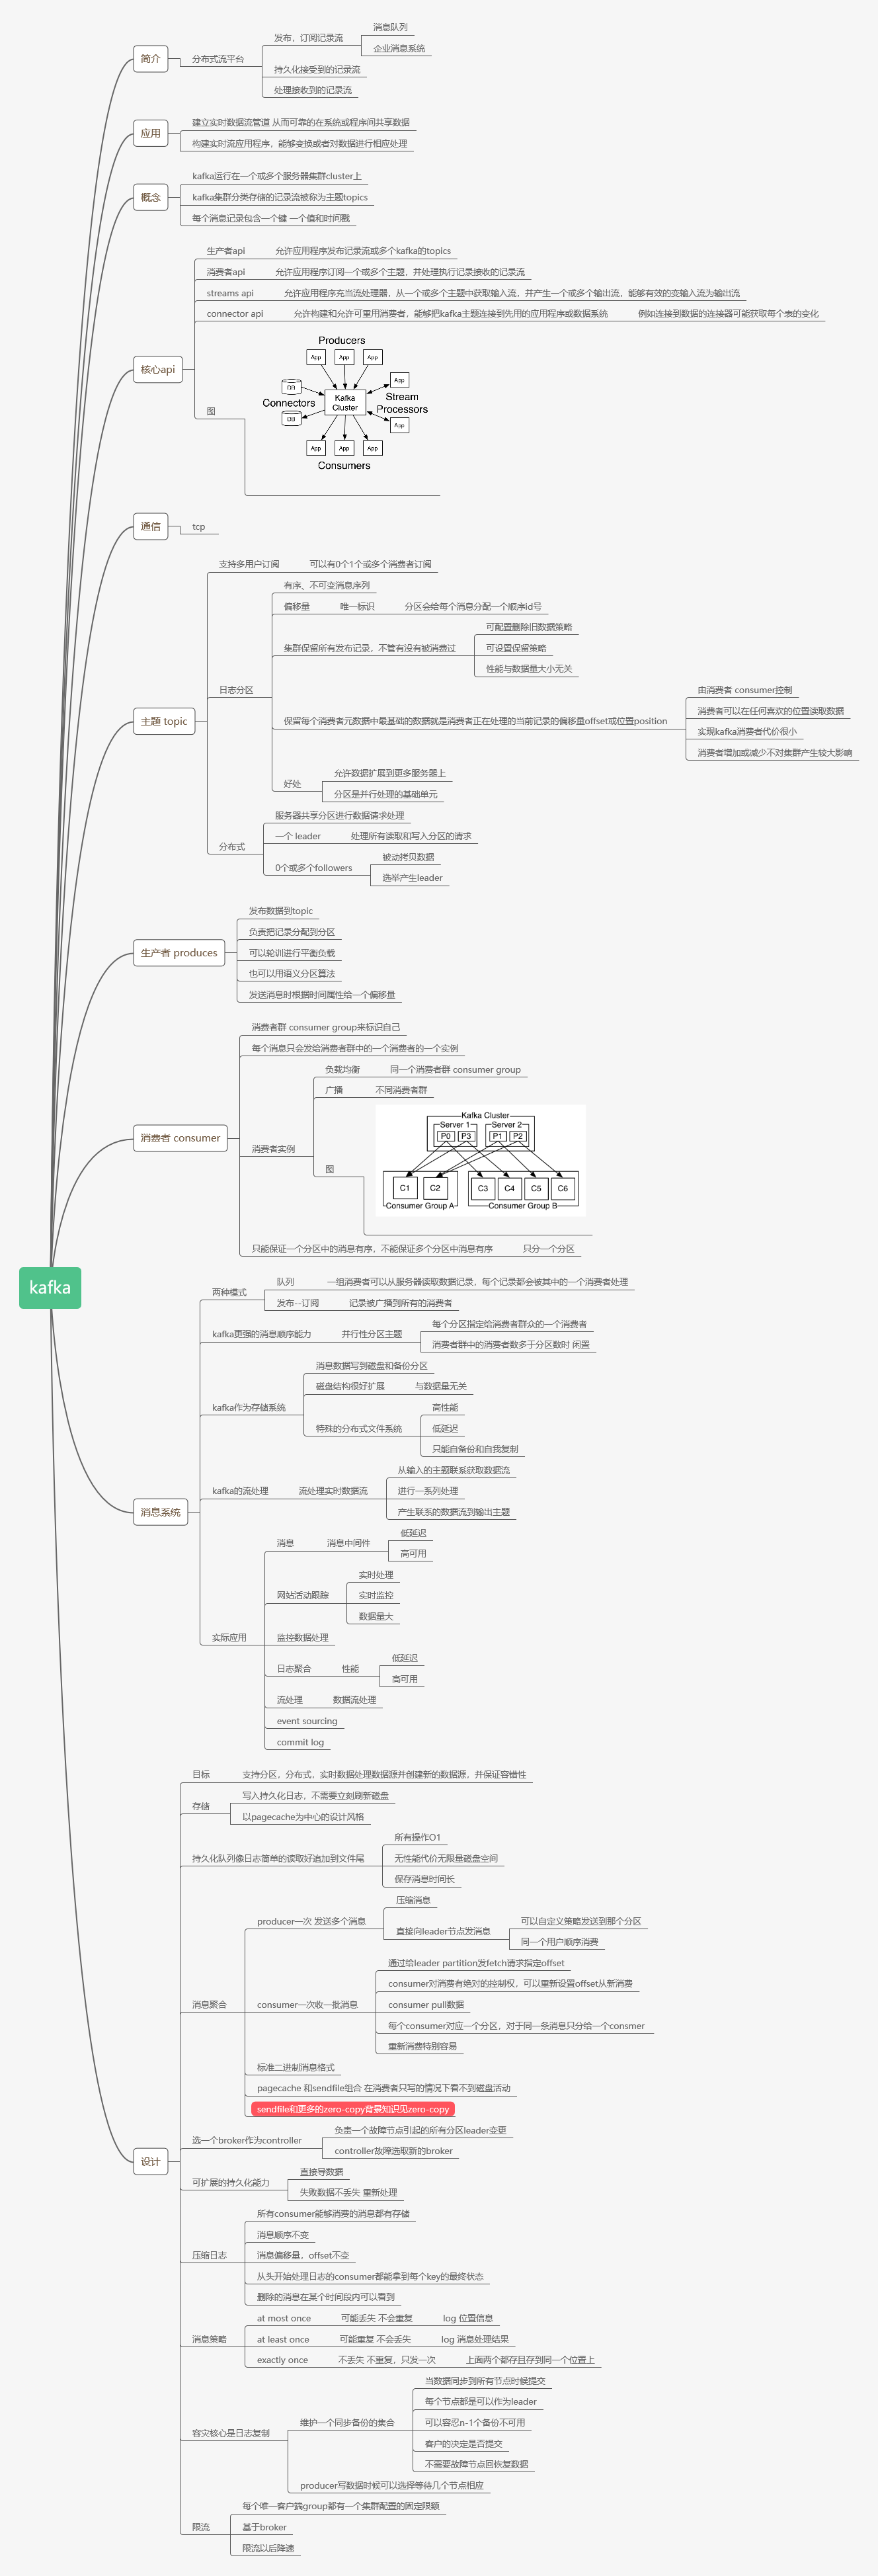
【Kafka主题/分区/日志/消费顺序】

Kafka学习(一):消费者实现对分区的并发消费 说明 在上篇博文《springboot学习(十七):了解spring - kafka配置工作原理》中,我们简单了解了spring-kafka的配置工作原理。通过源码可以看到spring在实现并发消费时,采用的是线程封闭的策略,也就是一个groupid中,根据配置的concurrency来创建多个消费者线程,每个消费者消费一个或多个分区,来实现整个topic消息的消费处理。本篇博文将对上篇博文中最后... 阅读详情

我是🌟廖志伟🌟,一名🌕Java开发工程师🌕、📝Java领域优质创作者📝、🎉优快云博客专家🎉、🌹幕后大佬社区创始人🌹。拥有多年一线研发经验,研究过各种常见框架及中间件的底层源码,对于大型分布式、微服务、三高架构(高性能、高并发、高可用)有过实践架构经验。

🍊博主:java_wxid
🍊博主:Java廖志伟
🍊社区:幕后大佬


本文内容:

Kafka主题/分区/日志


kafka

主题/分区/日志的概念

Topic是一个类别的名称,同类消息发送到同一个Topic下面。对于每一个Topic,下面可以有多个分区(Partition)日志文件。Topic是一个逻辑概念,真正落实的数据都在分区上面,一般每个主题至少有一个分区。这样可以通过多个分区,放在在不同的服务器上面去,达到分布式存储的功能,海量数据通过分区存储,切片存储解决单台机器无法存储海量数据的问题。
kafka

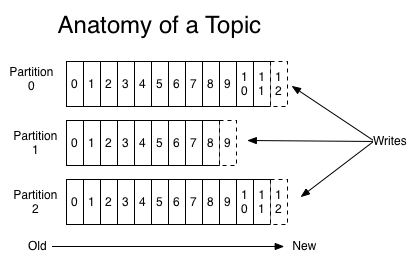
分区是一个有序的消息序列,这些消息按顺序添加到一个叫做commit log的文件中。每个分区中的消息都有一个唯一的编号,称之为offset,用来唯一标示某个分区中的消息。 每个分区,都对应一个commit log文件。一个分区中的消息的offset都是唯一的,但是不同的分区中的消息的offset可能是相同的。

kafka一般不会删除消息,不管这些消息有没有被消费。只会根据配置的日志保留时间(log.retention.hours)确认消息多久被删除,默认保留最近一周的日志消息。kafka的性能与保留的消息数据量大小没有关系,因此保存大量的数据消息日志信息不会有什么影响。

每个消费者是基于自己在commit log中的消费进度(offset)来进行工作的。在kafka中,消费offset由消费者自己来维护;一般情况下我们按照顺序逐条消费commit log中的消息,当然我可以通过指定offset来重复消费某些消息,或者跳过某些消息。这意味kafka中的消费者对集群的影响是非常小的,添加一个或者减少一个消费者,对于集群或者其他消费者来说,都是没有影响的,因为每个消费者维护各自的消费offset。

Topic/Partition/Broker的初体验

创建多个分区的主题
/opt/kafka_2.13-2.7.1/bin/kafka-topics.sh --create --zookeeper 106.14.132.94:2181 --replication-factor 1 --partitions 2 --topic test1
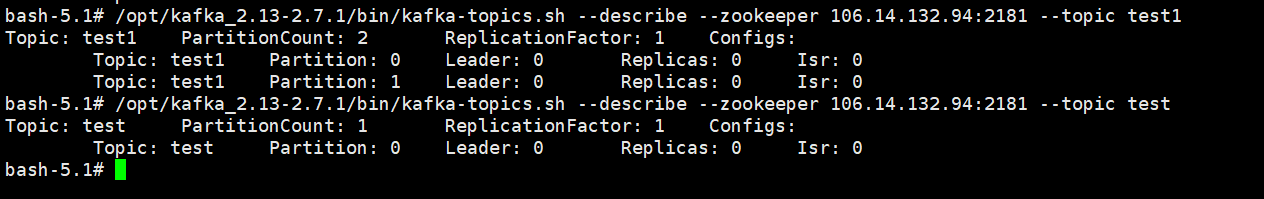
查看下topic的情况
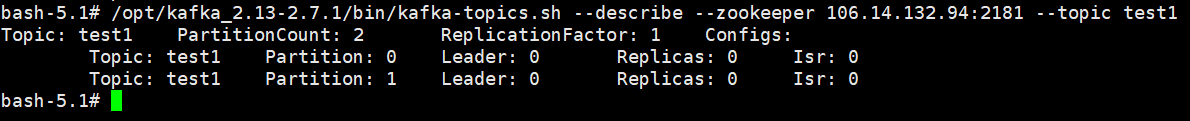
/opt/kafka_2.13-2.7.1/bin/kafka-topics.sh --describe --zookeeper 106.14.132.94:2181 --topic test1
kafka
第一行是所有分区的概要信息,之后的每一行表示每一个partition的信息。

  • leader节点负责给定partition的所有读写请求。
  • replicas表示某个partition在哪几个broker上存在备份。不管这个几点是不是”leader“,甚至这个节点挂了,也会列出。
  • isr是replicas的一个子集,它只列出当前还存活着的,并且已同步备份了该partition的节点。
创建的名称为"test"的topic
/opt/kafka_2.13-2.7.1/bin/kafka-topics.sh --describe --zookeeper 106.14.132.94:2181 --topic test 
kafka
之前设置了topic的partition数量为1,备份因子为1,因此显示就如上所示了。

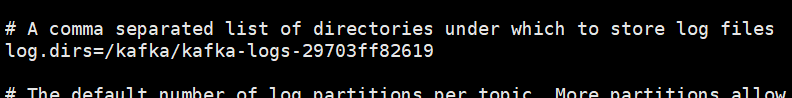
查询kafka的数据文件存储目录
cat /opt/kafka_2.13-2.7.1/config/server.properties

找到log.dirs配置的路径
kafka

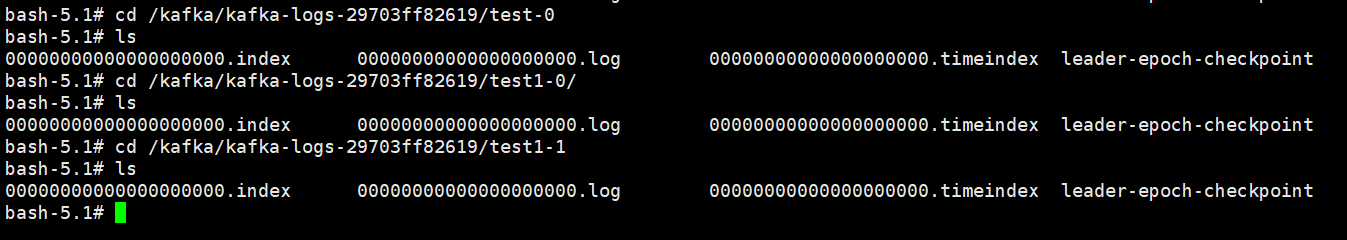
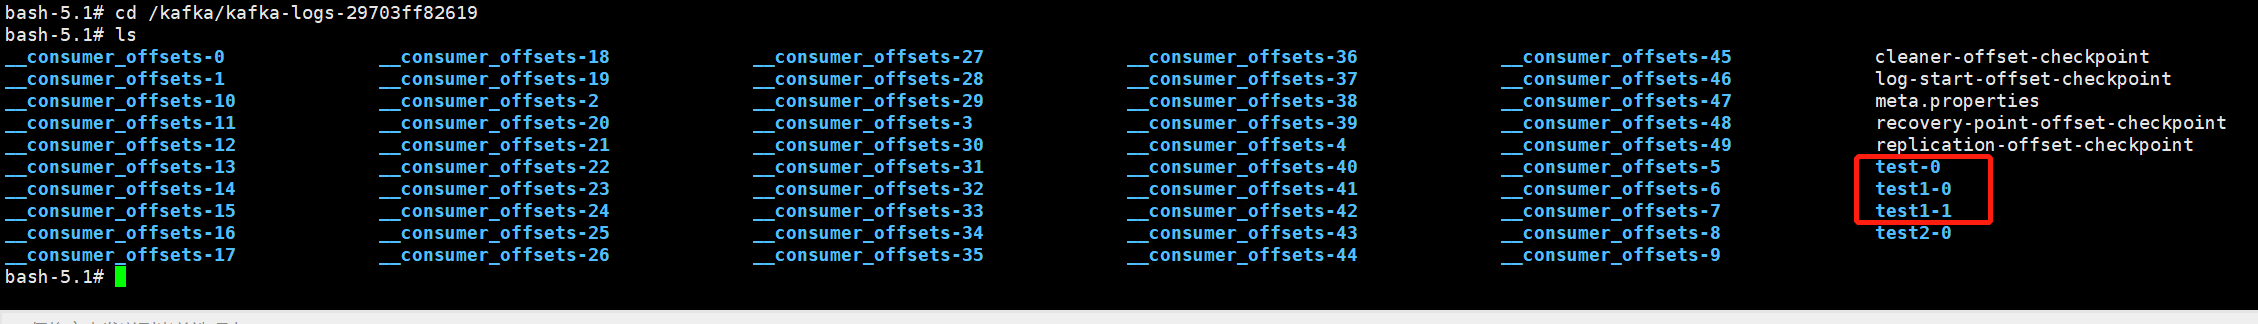
进入kafka的数据文件存储目录查看test和test1主题的消息日志文件
kafka

消息日志文件主要存放在分区文件夹里的以log结尾的日志文件里

kafka

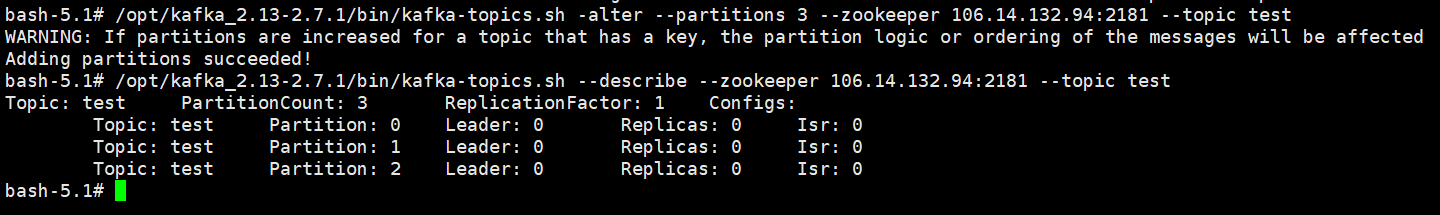
增加topic的分区数量(目前kafka不支持减少分区)

/opt/kafka_2.13-2.7.1/bin/kafka-topics.sh -alter --partitions 3 --zookeeper 106.14.132.94:2181 --topic test

查看分区

/opt/kafka_2.13-2.7.1/bin/kafka-topics.sh --describe --zookeeper 106.14.132.94:2181 --topic test
kafka

一个主题,代表逻辑上的一个业务数据集,比如按数据库里不同表的数据操作消息区分放入不同主题,订单相关操作消息放入订单主题,用户相关操作消息放入用户主题,对于大型网站来说,后端数据都是海量的,订单消息很可能是非常巨量的,比如有几百个G甚至达到TB级别,如果把这么多数据都放在一台机器上可定会有容量限制问题,那么就可以在主题内部划分多个分区来分片存储数据,不同的分区可以位于不同的机器上,每台机器上都运行一个Kafka的进程Broker。

为什么要对主题下数据进行分区存储?

  1. commit log文件会受到所在机器的文件系统大小的限制,分区之后可以将不同的分区放在不同的机器上,相当于对数据做了分布式存储,理论上一个主题可以处理任意数量的数据。
  2. 为了提高并行度。

消费顺序

一个分区同一个时刻在一个消费组中只能有一个消费者实例在消费,从而保证消费顺序。消费组中的消费者实例的数量不能比一个主题中的分区的数量多,否则,多出来的消费者消费不到消息。Kafka只在分区的范围内保证消息消费的局部顺序性,不能在同一个主题中的多个分区中保证总的消费顺序性。如果有在总体上保证消费顺序的需求,那么我们可以通过将主题的分区数量设置为1,将消费组中的消费者实例数量也设置为1,但是这样会影响性能,所以kafka的顺序消费很少用。


总结

以上就是今天要讲的内容,还希望各位读者大大能够在评论区积极参与讨论,给文章提出一些宝贵的意见或者建议📝,合理的内容,我会采纳更新博文,重新分享给大家。

🙏四连 关注🔎点赞👍收藏⭐️留言📝

感谢大家的支持,用心写博文分享给大家,你的支持(🔎点赞👍收藏⭐️留言📝)是对我创作的最大帮助。
🍊微信公众号:南北踏尘
🍊主页地址:java_wxid
🍊社区地址:幕后大佬

给读者大大的话

我本身是一个很普通的程序员,放在人堆里,除了与生俱来的🌹盛世美颜🌹、所剩不多的发量,就剩下180的大高个了。就是我这样的一个人,默默坚持写博文也有好多年了,有句老话说的好,🌕牛逼之前都是傻逼式的坚持🌕。希望自己可以通过大量的作品,时间的积累,个人魅力、运气和时机,可以打造属于自己的🌟技术影响力🌟。同时也希望自己可以成为一个🎄懂技术🎄,🎄懂业务🎄,🎄懂管理🎄的综合型人才,作为项目架构路线的总设计师,掌控全局的🌕团队大脑🌕,技术团队中的🍊绝对核心🍊是我未来几年不断前进的目标。


提示:以下都是资源分享,求个一键三连。

面试资料

福利大放送,🎉欢迎关注🔎点赞👍收藏⭐️留言📝,拜托了🙏,这对我真的很重要。
点击:面试资料
提取码:2021

200套PPT模板

福利大放送,🎉欢迎关注🔎点赞👍收藏⭐️留言📝,拜托了🙏,这对我真的很重要。
点击:200套PPT模板
提取码:2021

提问的智慧

福利大放送,🎉欢迎关注🔎点赞👍收藏⭐️留言📝,拜托了🙏,这对我真的很重要。
点击:提问的智慧
提取码:2021

Java开发学习路线

名称链接
JavaSE点击: JavaSE
MySQL专栏点击: MySQL专栏
JDBC专栏点击: JDBC专栏
MyBatis专栏点击: MyBatis专栏
Web专栏点击: Web专栏
Spring专栏点击: Spring专栏
SpringMVC专栏点击: SpringMVC专栏
SpringBoot专栏点击: SpringBoot专栏
SpringCould专栏点击: SpringCould专栏
Redis专栏点击: Redis专栏
Linux专栏点击: Linux专栏
Maven3专栏点击: Maven3专栏
Spring Security5专栏点击: Spring Security5专栏
更多专栏更多专栏,请到 java_wxid主页 查看

P5学习路线图
p5学习路线图P6学习路线图
P6学习路线图P7学习路线图
P7学习路线图P8学习路线图
P8学习路线图

以上四张图详细介绍了作为Java开发工作者所需要具备的知识技能,同学们学废了嘛,有想法系统学习的同学可以私聊我,🎉欢迎关注🔎点赞👍收藏⭐️留言📝。
🍊博主:java_wxid
🍊博主:Java廖志伟
🍊社区:幕后大佬

(场景)kafka的topic多分区的情况,如何保证跨区的消息消费的顺序性 这个问题严格来说是肯定有的,kafka只能保证分区内的有序性。 如果one partition -> one consumer的话,就没这样的问题,但失去了并行。 如果N partition-> M consumer, 1.N 2.N>M,这种情况,如何去消费多个partition的,kafka的消费机制要去研究下 阅读详情

相关推荐

大数据领域Kafka入门指南:快速上手必备技巧

在大数据时代,企业每天要处理海量的实时数据流(如用户点击、日志、交易记录)。这些数据需要高效传输、存储和处理,而Kafka正是解决这类问题的“瑞士军刀”。本文聚焦Kafka的核心功能,覆盖基础概念、操作流程、代码实战,帮助读者快速上手,为后续深入学习(如流处理、高可用架构)打基础。用“快递中心”故事引出Kafka核心概念;拆解主题、分区、生产者等组件的关系;手把手教你搭建Kafka环境并编写消息收发代码;分析真实业务场景(如日志收集、实时推荐);总结常见问题与未来趋势。主题(Topic)

AI 算法实战派 365

【kafka】服务器命令行查询kafka信息消费情况

kafka-tool出问题的情况下,可以用命令行来查看kafka信息

好学的小师弟的博客;华为云社区月度积极博主 1万+

激光定位算法竞技场:hdl_localization与Cartographer/AMCL的横向技术解剖

本文深入对比了hdl_localization、Cartographer和AMCL三种激光定位算法的技术原理与性能表现。通过UKF-NDT融合、图优化和粒子滤波等核心技术,分析了各算法在结构化环境、动态环境和大尺度场景下的适应性。实验数据表明,Cartographer在全局一致性上表现最优,而AMCL在动态环境中更具鲁棒性。文章还提供了算法选型指南和参数调优技巧,为工程实践提供参考。

weixin_29062865的博客 367

如何查看Kafka的Topic消费情况

2.10为Scala版本,0.10.0.2.5.3.0为kafka版本。进入kafka安装目录,然后执行以下命令。从某一时间开始消费某一topic。从最开始开始消费某一topic。或者不指定日志输出位置和设置。

qq_36862125的博客 8636

MAX31865三线PT100测温实战:配置、接线与代码全解析

本文详细解析MAX31865三线PT100测温的配置、接线与代码实现。通过实战经验分享,介绍如何利用MAX31865芯片实现高精度温度测量,重点讲解三线制接法的自动误差补偿功能,并提供完整的寄存器配置、SPI通信和温度转换算法,帮助开发者快速解决工业测温中的常见问题。

ss78901的博客 760

基于YOLOv8的农作物病虫害检测系统设计与实现

国内如中国农业大学的科研团队采用改进的Faster R-CNN模型对小麦病害进行检测,取得了较好的效果。农作物病虫害是影响农业生产的重要因素之一,每年因病虫害导致的农作物减产高达20%-40%。YOLO(You Only Look Once)系列算法作为目标检测领域的代表性模型,以其高效、准确的特点在众多领域得到广泛应用。YOLOv8作为该系列的最新版本,在精度和速度上都有显著提升,非常适合农作物病虫害检测这类需要实时处理的应用场景。然而,现有研究仍存在一些不足:一是模型复杂度高,难以部署到移动设备;

YOLO 797

Kafka - 主题Topic与消费者消息Offset日志记录机制

kafka topic分区存储消息以及 消息信息存储的形式与日志记录

程序员路同学 2779

高电压技术的面试内容整理(详细版本:57题)

涵盖了高电压技术的关键领域,包括气体放电的物理过程、液体和固体介质的绝缘特性、高压外绝缘的分类与特性、电气设备绝缘试验的方法与原理、电力系统的防雷保护措施,以及内部过电压的产生、影响与限制方法,为理解和应对高电压环境下的电气问题提供了系统的知识框架。通过深入探讨气体放电理论、介质极化与损耗、绝缘子的电气特性、绝缘试验技术、防雷策略以及内部过电压的管理。

weixin_44808274的博客 779

Kafka 消费进度

监控消费进度 : 看滞后程度:消费者 Lag , Consumer Lag滞后程度 : 消费者落后于生产者的程度Lag : 反映消费者的运行情况。

记录点点滴滴 2251

Python 爬虫实战:爬取 BOSS 直聘职位,实现岗位要求关键词提取

摘要:本文基于BOSS直聘数据分析师岗位信息,采用Python爬虫技术获取职位数据,通过文本分析和可视化方法研究岗位技能需求特征。研究首先设计爬虫程序获取职位基本信息和岗位要求文本,经数据清洗后运用jieba分词和词频统计提取关键词。结果显示SQL、Python为最核心技能,不同级别岗位需求差异明显:初级重基础数据处理,高级需建模和管理能力;行业间亦存在差异,互联网关注用户增长,金融侧重风控。研究为求职者技能提升提供了数据支持,同时展示了从非结构化文本中挖掘有价值信息的完整流程。

2503_91057718的博客 1771

【银河麒麟桌面系统】安装英伟达(NVIDIA)显卡驱动

本文详细介绍了在麒麟桌面操作系统V10 SP1(版本号2503)上安装NVIDIA RTX 5060显卡驱动的完整流程。主要内容包括:查看系统版本信息,从NVIDIA官网下载Linux 64位驱动,授予执行权限后运行安装程序,处理安装过程中的X server警告、32位库安装、DKMS模块选择等问题,以及安装完成后如何验证驱动状态。同时提供了卸载驱动的步骤和常见问题解决方案,如处理X server警告、libglvnd EGL依赖问题等。该指南适用于需要在国产麒麟系统上安装NVIDIA显卡驱动的用户,包含完

信创运维工程师 · 银河麒麟 & 容器实战 | 金融生产环境迁移·等保加固 | 142篇原创·17万+阅读 6316

kafka操作2

Topic是逻辑上的概念,而partition是物理上的概念,每个partition对应于一个log文件,该log文件中存储的就是Producer生产的数据。压缩后的offset可能是不连续的,比如上图中没有6,当从这些offset消费消息时,将会拿到比这个offset打的offset对应的消息,实机上会拿到offset为7的消息,并从这个位置开始消费。在生产环境中,每台服务器的配置和性能不一致,但是kafka只会根据自己的代码规则创建对应的分区副本,就会导致个别服务器的存储压力较大。

weixin_51343683的博客 3138

什么是 SAP FICO 的 GL?

GL,即总账,是 SAP FI(Financial Accounting)模块中的一个重要组件。它的主要作用是收集、分类和汇总所有财务交易,以便企业可以生成财务报表,如资产负债表、利润表和现金流量表。科目结构:GL 账户(G/L Account)用于记录企业的财务交易,并按会计准则分类。实时更新:由于 SAP 是基于事务驱动的系统,每一笔业务发生后,都会实时反映到总账科目中。集成性。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1692

Kafka 原理以及分区分配策略剖析

一、简介 Apache Kafka 是一个分布式的流处理平台(分布式的基于发布/订阅模式的消息队列【Message Queue】)。 流处理平台有以下3个特性: 可以让你发布和订阅流式的记录。这一方面与消息队列或者企业消息系统类似。 可以储存流式的记录,并且有较好的容错性。 可以在流式记录产生时就进行处理。 1.1 消息队列的两种模式 1.1.1 点对点模式 生产者将消息发送到queue中,然后消费者从queue中取出并且消费消息。消息被消费以后,queue中不再存储.

Java搜索工程技术栈 2659

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

kafka 基础知识

现在它已被多家不同类型的公司作为多种类型的数据管道和消息系统使用。活动流数据是几乎所有站点在对其网站使用情况做报表时都要用到的数据中最常规的部分。 活动数据包括页面访问量(Page View)、被查看内容方面的信息以及搜索情况等内容。 这种数据通常的处理方式是先把各种活动以日志的形式写入某种文件,然后周期性地对这些文件进行统计分析。 运营数据指的是服务器的性能数据(CPU、IO 使用率、请求时间、服务日志等等数据)。运营数据的统计方法种类繁多。 近年来,活动和运营数据处理已经成为了网站软件产品特性中一个至关

weixin_45739956的博客 311

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

kafka学习

文章目录1. kafka概念2. 安装部署单节点安装java环境zookeeper安装kafka的安装kafka测试消费和生产创建主题展示所有主题查看主题详情消费端订阅消息生产端发送消息集群搭建zk安装kafka集群搭建验证:3. 生产者1. 流程消息发送流程发送类型序列化器分区器拦截器interceptor发送原理 1. kafka概念 和rocketmq类似,都有broker,不同的是,rocketmq通过nameserver进行调度,而kafka依赖zookeeper进行调度。 此外,kafka采用

wjl31802的博客 2251

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Kafka 消费者重试与死信:Spring for Apache Kafka 的边界设计

从“消息处理失败后到底该重试几次、重试期间线程在做什么、最终失败的消息去哪”这一具体问题出发,逐层拆解 Spring for Apache Kafka 的监听容器并发模型、错误处理器链、非阻塞重试与死信主题投递、消费位移提交语义,并用一个可复现的订单消费主线演示错误配置与正确实现的差异,最后给出重复消费的验证方法与适用边界。

qq_29029209的博客 229

Kafka 面试题,看这一篇就够了

Kafka基础消息系统的作用大部分小伙伴应该都清楚,这里用机油装箱举个例子:所以消息系统就是如上图我们所说的仓库,能在中间过程作为缓存,并且实现解耦合的作用。引入一个场...

xmt1139057136的专栏 1万+

kafka架构与原理

1、简介 它可以让你发布和订阅记录流。在这方面,它类似于一个消息队列或企业消息系统。 它可以让你持久化收到的记录流,从而具有容错能力。 首先,明确几个概念: • Kafka运行在一个或多个服务器上。 • Kafka集群分类存储的记录流被称为主题(Topics)。 • 每个消息记录包含一个键,一个值和时间戳。 Kafka有四个核心API: • 生产者 API 允许应用程序发布记录流至一个或多个Kaf...

SuperBoy_Liang的博客 445

kafka专题:kafka的Topic主题、Partition分区、消费组偏移量offset等基本概念详解

文章目录1. kafka集群整体架构2. 单播消费和多播消费的概念2.1 消费组和偏移量 1. kafka集群整体架构 kafka集群整体运作如上图所示,来看一下kafka的相关术语 名称 解释 Broker 消息中间件处理节点,一个Kafka节点就是一个broker,一个或者多个Broker可以组成一个Kafka集群Topic Topic Kafka根据topic对消息进行归类,发布到Kafka集群的每条消息都需要指定一个topicProducer Producer 消息生产者

qq_1149513559的博客 1万+

【Kafka专栏 05】一条消息的完整生命周期:Kafka如何保证消息的顺序消费

除了默认的哈希分区策略外,Kafka还允许使用自定义的分区器。这为用户提供了更大的灵活性,可以根据业务需求自定义分区逻辑,进一步确保消息的顺序性。Kafka通过其独特的分区机制、消费者组配置、生产者的分区策略以及监控与错误处理机制,共同保证了消息的顺序消费。在实际应用中,需要根据业务需求合理配置和使用这些机制,以确保消息的有序性。同时,也需要注意Kafka的性能和可扩展性,以满足大规模数据处理的需求。

weixin_40736233的博客 2789

kafka 分布式的情况下,如何保证消息的顺序消费?

kafka 分布式的情况下,如何保证消息的顺序消费?

杨荧的优快云博客 6202

Kafka 如何保证顺序消费

摘要:本文探讨了Kafka如何保证消息顺序消费的核心机制。Kafka通过分区特性实现消息有序性,同一分区内的消息天然有序。生产者端可通过自定义分区器或固定分区策略将关联消息发送至同一分区,消费者端则需确保每个分区仅由一个消费者线程处理。典型应用场景包括金融交易、数据库变更日志及电商库存管理等需严格顺序处理的业务。文章详细分析了实现顺序消费的技术方案,并强调了在保证顺序性的同时需兼顾系统性能的平衡。

shangjg3的博客 1294

Kafka 主题分区策略的优化

Kafka 提供了多种分区策略,默认采用基于消息键(Key)的分区方式(DefaultPartitioner)。这种策略确保具有相同键的消息始终被路由到同一个分区中,从而保持消息顺序。此外,还有其他几种常见的分区策略:无键分区(No Key Partitioning):消息没有指定键时,Kafka 会使用轮询(Round Robin)的方式将消息均匀分配给各个分区。自定义分区器(Custom Partitioner):用户可以根据业务需求编写自定义逻辑,灵活控制消息的分发方式。

2501_91140651的博客 1376
上一篇: 【Kafka使用场景/基本概念/初体验/消费模式/消费组的偏移量】
下一篇: 【Kakfa集群】
Java程序员廖志伟
Java程序员廖志伟 优质创作者: Java技术领域 优质创作者: Java技术领域 领域专家: 后端开发技术领域 领域专家: 后端开发技术领域
博客等级 码龄8年 2万+粉丝 1902原创
评论 7
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

Java程序员廖志伟

赏我包辣条呗

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值