spark如何生成/加载checkpoint的数据

Spark_Spark 中 checkpoint 的正确使用方式 以及 与 cache区别 1.Spark性能调优:checkPoint的使用 https://blog.youkuaiyun.com/leen0304/article/details/78718346 概述 checkpoint的意思就是建立检查点,类似于快照,例如在spark计算里面,计算流程DAG特别长,服务器需要将整个DAG计算完成得出结果,但是如果在这很长的计算流程中突然中间算出的数据丢失了,spark又会根据RDD的依赖关系从头到尾计算一遍,这样子就很费性能,当然我们可以将中间的计算结果通过cache或者persi... 阅读详情

生成checkpoint数据

  1. 设置checkpoint目录

  1. 需要缓存的rdd调用checkpoint方法

sc.setCheckpointDir("/data/checkpoint")
rdd.checkpoint()

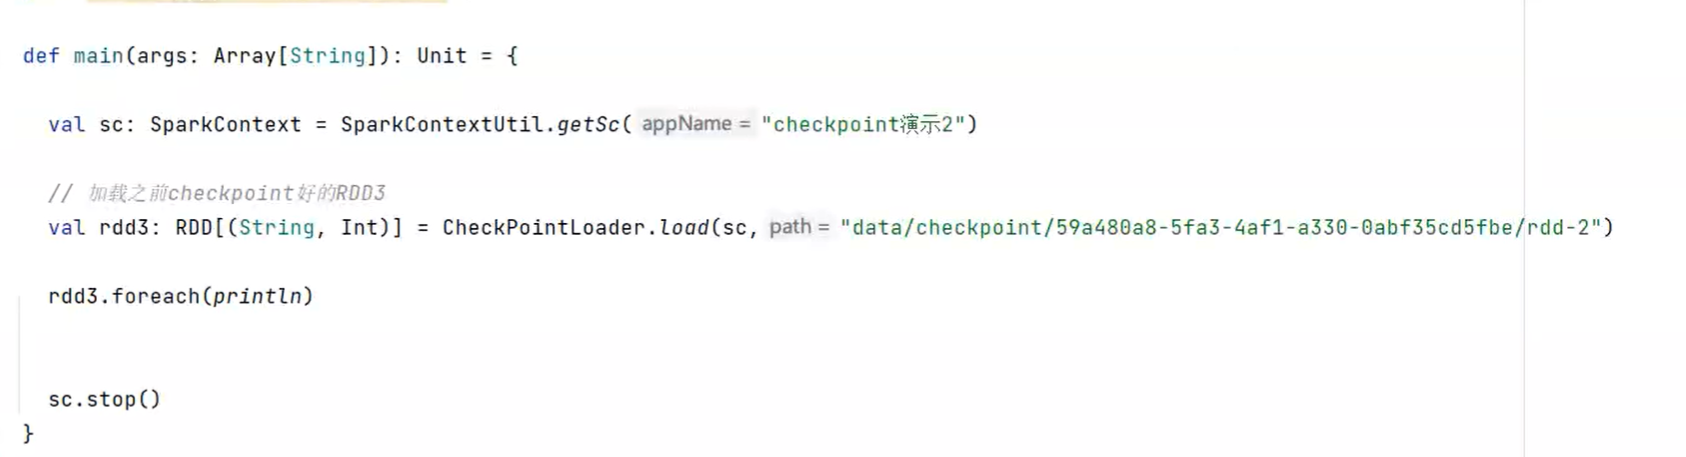
加载checkpoint数据

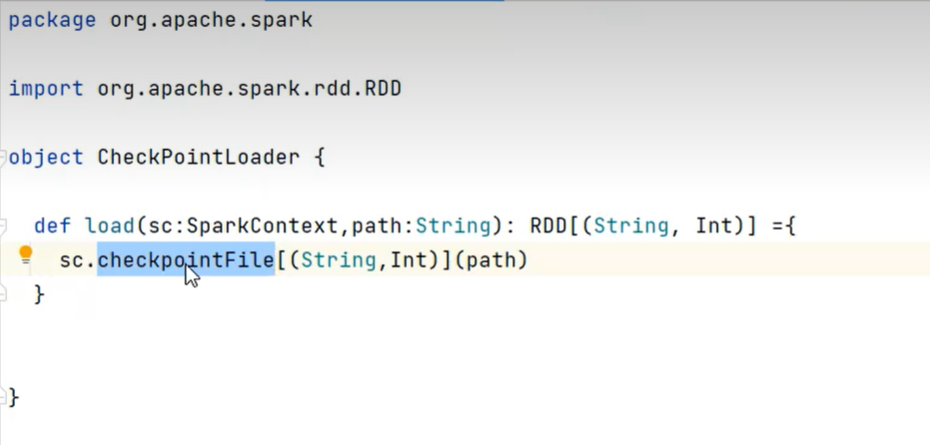
  1. sparkContext通过checkpointFile方法指定ck目录,实现加载上次的数据,但是不对外开放。

  1. sparkContext中checkpointFile方法是私有的,我们可以在org.apache.spark包下创建一个一个类,调用checkpointFile方法即可
spark 的checkpoint 详解 Spark core的checkpoint (1)为什么checkpoint? 虽然RDD的血缘关系天然地可以实现容错,当RDD的某个分区数据失败或丢失,可以通过血缘关系重建。但是对于长时间迭代型应用来说,随着迭代的进行,RDDs之间的血缘关系会越来越长,一旦在后续迭代过程中出错,则需要通过非常长的血缘关系去重建,势必影响性能。 Spark中对于数据的保存除了持久化操作之外,还提供了一种检查点的机制,检查点(本质是通过将RDD写入Disk做检查点)是为了通过lineage做容错的辅助,lineage过长会造 阅读详情

相关推荐

Spark Streaming的checkpoint(更新中)

文章目录1. Spark Streaming的checkpoint机制1.1 Spark Streaming 的checkpoint示例1.2 源码分析1.2.1 初始化和设置checkpoint目录1.2.2 StreamingContext的start()方法1.2.3 JobScheduler的start()方法1.2.4 JobGenerator的start方法1.2.5 startFi...

changshuchao的博客 1665

Spark09: Spark之checkpoint

checkpoint,是Spark提供的一个比较高级的功能。有时候,我们的Spark任务,比较复杂,从初始化RDD开始,到最后整个任务完成,有比较多的步骤,比如超过10个transformation算子。而且,整个任务运行的时间也特别长,比如通常要运行1~2个小时。在这种情况下,就比较适合使用checkpoint功能了。因为对于特别复杂的Spark任务,有很高的风险会出现某个要反复使用的RDD因为节点的故障导致丢失,虽然之前持久化过,但是还是导致数据丢失了。

anglemanyi的博客 1550

Spark中CheckPoint、Cache、Persist的用法、区别

Spark中CheckPoint、Cache、Persist 大家好,我是一拳就能打爆A柱的猛男 这几天看到一套视频《尚硅谷2021迎新版大数据Spark从入门到精通》,其中有关于检查点(CheckPoint)的内容,所以就给大家以文字的形式复盘一下。接下来的顺序是:Spark关于持久化的描述、Cache用法、Persist用法、CheckPoint用法。中间会讲解三者之间的关系。 1、Spark关于持久化的描述 在Spark官网,我可以找到关于RDD持久化的全部内容就是如下的内容: RDD Persis

Alian_W的博客 2143

001.checkpoint文件

001.checkpoint文件 1.用途 捕获模型使用的所有tf.Variable的确切值 2.创建 2.1 save_weights(filename) import tensorflow as tf class Net(tf.keras.Model): """A simple linear model.""" def __init__(self): super(Net, self).__init__() self.l1 = tf.keras.layers.Dense(

TommyLiuZ的博客 1061

nRF52840 低功耗蓝牙开发指南:从硬件架构到物联网应用实战

本文深入解析nRF52840低功耗蓝牙芯片的硬件架构与开发实践,涵盖从开发环境搭建到BLE协议栈开发的详细指南。通过实战案例分享低功耗优化技巧,帮助开发者高效实现物联网应用,特别适合智能家居和工业场景。

d3e4f的博客 419

Blender地形建模实战:5步搞定Gazebo仿真地形(附避坑指南)

本文提供了一份详细的Blender地形建模实战指南,旨在帮助开发者快速创建Gazebo仿真地形。文章通过五个核心步骤,从环境准备、地形雕刻、模型优化导出,到创建Gazebo模型包及问题排错,系统讲解了如何将Blender中的地形模型成功导入Gazebo进行机器人仿真,并重点分享了关键的避坑经验。

weixin_28475533的博客 345

Spark本地调试和程序重启checkpoint恢复碰到的问题

Spark本地调试和程序重启checkpoint恢复碰到的问题 1、产生问题的背景   今天自测Spark程序碰到两个问题,(1)、启动流式程序报错 (2)、重启Spark程序,同一个对象的部分数据恢复了,一部分没有恢复   第一个问题的报错信息:   第二个问题的结果信息: 2、排查问题的原因   第一个问题的原因是:没有配置hadoop的环境变量,导致在写checkpoint数据的时候报错了...

qq_38019655的博客 1605

【驱动适配】高通sa522平台tac5x1x驱动适配全指南

本手册详细介绍了TAC5301-Q1音频编解码器在高通sa525平台Linux系统下的驱动适配流程。主要内容包括:1)TAC5301-Q1核心特性(车载级音频Codec、关键接口和功能);2)驱动适配依赖(高通声卡驱动、ALSA SoC框架等);3)I2S协议原理及主从模式说明;4)硬件准备与检查要点;5)完整的驱动移植步骤(代码移植、Kconfig/Makefile修改、设备树配置)。该手册适用于嵌入式音频开发工程师快速完成TAC5301-Q1芯片的驱动移植与验证工作。

嵌入式博哥的博客 304

spark2实战-使用checkpoint保存和读取还原RDD

概述 本文讲述如何使用checkpoint来保存rdd,并读取还原rdd的数据。 checkpoint简介 checkpoint可以把rdd持久化到磁盘上,可以是本地磁盘也可以是外部存储系统(比如:hadoop文件系统)。 要注意的是:在rdd进行checkpoint时,会先把rdd的血缘(lineage)去掉。 另外:在大数据量的情况下,保存和读取rdd数据也会十分消耗资源。所以,是选择使用ch...

zg_hover的专栏 3831

SD-WAN组网案例——数据中心

SD-WAN组网案例——数据中心

2301_78457663的博客 706

ESP8266红外控制美的空调:从协议解析到Home Assistant集成

红外遥控技术作为一种经典的非接触式控制方式,其原理是通过红外发光二极管发射经过特定频率调制的光信号来传递指令。在物联网和智能家居领域,利用微控制器如ESP8266模拟红外信号,成为将传统家电接入智能生态系统的关键技术。这项技术通过精准解析和生成符合设备厂商私有协议的红外编码,实现了对空调、电视等设备的远程与自动化控制,具有很高的实用价值。本文聚焦于美的空调的红外协议,深入探讨了其脉冲宽度调制(PWM)和全量式编码的特点,并提供了基于ESP8266的完整解决方案,包括硬件连接、库函数API详解以及如何将其无缝

weixin_30718391的博客 402

Spark Checkpoint 的使用、具体内容及读写过程

引用:https://www.cnblogs.com/cenglinjinran/p/9542589.html

初心江湖路的博客 6256

Playwright Java环境配置避坑指南:浏览器路径、类加载与离线部署

Playwright作为现代端到端测试框架,其Java SDK突破了传统Selenium的Driver管理模式,将Chromium/Firefox/WebKit内核视为可编程运行时资源。其核心原理在于SDK与浏览器二进制分离——Maven仅管理Java字节码,而浏览器需独立下载、校验与沙箱加载。这一设计带来显著技术价值:跨平台一致性、进程隔离安全性及多浏览器并行能力;典型应用场景涵盖Spring Boot集成测试、金融级离线CI/CD、Kubernetes容器化部署及Air-Gapped封闭环境。然而,因J

weixin_32956805的博客 679

【总结】论spark中的cache/persist/checkpoint

1. cache与persist cache 能够让重复数据在同一个 application 中的 jobs 间共享。RDD的cache()方法其实调用的就是persist方法,缓存策略均为MEMORY_ONLY。 下面简单引入一下cache的机制:哪些 RDD 需要 cache? 会被重复使用的(但不能太大)。用户怎么设定哪些 RDD 要 cache? 因为用户只与 driver

一寒惊鸿 2万+

GAN网络(论文阅读):Generative Adversarial Nets

当判别器效果比较好时,D(G(z))值为0,则log(1-D(G(z)))值为0,当判别器效果不好,会输出一个大于0 的数,则log(1-D(G(z)))值就为一个负数,在极端情况下,会得到负无穷大,此时判别失误。在价值函数的第二项中存在问题,在早期G比较弱的时,生成的数据和真实数据相差很大,D就容易训练的比较好,很容易区分,就会导致log(1-D(G(z)))变成0 ,这样很难求梯度来优化G,所以更新G时,将优化函数改为log(D(G(z)))。最终使G赢,即G生成的数据D判别不出来。

m0_54248968的博客 2293

PyTorch深度学习实战(25)——从零开始实现Mask R-CNN实例分割

Mask R-CNN 是一种在目标检测任务中引入了语义分割的强大框架,通过在 Faster R-CNN 基础上进行扩展,添加了额外的分支网络,不仅可以准确地检测对象的位置和类别,还可以生成每个实例的精确像素级别的语义分割掩码。其模块化的设计可以轻松地应用于不同的任务和数据集,并且可以通过添加更多的分支进行功能扩展,如实例关键点检测等。

盼小辉丶的博客 1万+

spark checkpoint详解

转载地址:https://www.cnblogs.com/superhedantou/p/9004820.html checkpoint在spark中主要有两块应用:一块是在spark core中对RDD做checkpoint,可以切断做checkpoint RDD的依赖关系,将RDD数据保存到可靠存储(如HDFS)以便数据恢复;另外一块是应用在spark streaming中,使用checkp...

learn_tech的博客 2067

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

Spark中CheckPoint操作

参考:http://www.tuicool.com/articles/bQVRryr /**    * Mark this RDD for checkpointing. It will be saved to a file inside the checkpoint    * directory set with `SparkContext#setCheckpointDir` and all

心如止水 宠辱不惊 3803

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

spark的checkpoint

========================================================================================================== 一.checkpoint 原理 http://spark.apache.org/docs/1.6.1/streaming-programming-guide.html#transfo

keyuquan的博客 1024

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

Spark:checkpoint介绍

checkpoint,是Spark提供的一个比较高级的功能。 有时候我们的Spark任务,比较复杂,从初始化RDD开始,到最后整个任务完成,有比较多的步骤,比如超过10个transformation算子。而且整个任务运行的时间也特别长,比如通常要运行1~2个小时。 在这种情况下,就比较适合使用checkpoint功能了。 因为对于特别复杂的Spark任务,有很高的风险会出现某个要反复使用的RDD因为节点的故障导致丢失,虽然之前持久化过,但是还是导致数据丢失了。那么也就是说,出现失败的时候,没有容错机制,所以

简单随风的博客 3616

Spark Streaming之checkpoint机制

目录一、checkpoint机制二、checkpoint启用方式三、Driver失败重写超过程序四、配置spark-submit提交参数五、checkPoint的说明 一、checkpoint机制 每一个Spark Streaming应用,正常来说,都是要7 * 24小时运转的,这就是实时计算程序的特点。因为要持续 不断的对数据进行计算。因此,对实时计算应用的要求,应该是必须要能够对与应用程序逻辑无关的失败,进行 容错。 如果要实现这个目标,Spark Streaming程序就必须将足够的信息checkpo

蔡政洁的博客 2018

spark checkpoint机制简述

本文主要简述spark checkpoint机制,快速把握checkpoint机制的来龙去脉,关于源码方面可以看参考文章。 1、Spark core的checkpoint 1)为什么checkpoint? 分布式计算中难免因为网络,存储等原因出现计算失败的情况,RDD中的lineage信息常用来在task失败后重计算使用,为了防止计算失败后从头开始计算造成的大量开销,RDD会chec...

简单就好 4531

彻底理解 spark 的checkpoint 机制《Spark进阶》

我们应该都很熟悉 checkpoint 这个概念, 就是把内存中的变化刷新到持久存储,斩断依赖链 在存储中 checkpoint 是一个很常见的概念, 举几个例子 数据库 checkpoint 过程中一般把内存中的变化进行持久化到物理页, 这时候就可以斩断依赖链, 就可以把 redo 日志删掉了, 然后更新下检查点, hdfs namenode 的元数据 editlog, Secondary namenode 会把 edit log 应用到 fsimage, 然后刷到磁盘上, 也相当于做了一次 check

不积跬步,无以至千里;不积小流,无以成江海。 1351

Spark RDD Checkpoint 数据的保存机制

是一种容错机制,用于将 RDD 的数据保存到可靠的存储系统(如 HDFS)中,以便在节点故障时可以从存储中重新加载数据,而不是重新计算依赖链。它适用于需要高容错性的场景,同时对计算成本较高的 RDD 提供了中间结果保存的能力。假设 checkpoint 目录为。

z1941563559的博客 1150

Spark如何删除无效rdd checkpoint

spark可以使用checkpoint来作为检查点,将rdd的数据写入hdfs文件,也可以利用本地缓存子系统。 当我们使用checkpoint将rdd保存到hdfs文件时,如果任务的临时文件长时间不删除,长此以往,hdfs会出现很多没有用的文件,spark也考虑到了这一点,因此,用了一些取巧的方式来解决这种问题。 spark config: spark.cleaner.referenceTrack...

weixin_30654583的博客 1664

Flink Checkpoint 和 Spark Checkpoint 的区别

更像一个“它主要目的是,避免因链路过长导致的性能问题或 StackOverflowError。它是一个** coarse-grained(粗粒度)** 的、的、的容错机制。:是一个“它是 Flink,用于在发生故障时,将整个分布式数据流状态恢复到一致性的检查点,实现或 At-Least-Once 语义。它是一个的、的、的容错机制。简单来说,Spark Checkpoint 是为了解决 RDD 带来的内部问题,而 Flink Checkpoint 是对外提供容错保证的核心特性。

好记性不如烂笔头 1104
上一篇: spark数据源小文件问题如何解决
下一篇: spark RDD中的并行度、分区器默认策略
JNWsong
博客等级 码龄9年 287粉丝 204原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值