Ollama—87.4k star 的开源大模型服务框架!!

本地部署大模型工作流实战:Dify+Ollama中文落地指南 大语言模型本地化部署是企业数据安全与AI工程可控性的核心实践。其本质是构建‘模型运行时—智能体框架—应用集成’三层技术栈:底层依赖Ollama/Llama.cpp实现轻量级模型推理,中层通过Dify等开源Agent框架提供可视化编排与RAG能力,上层对接飞书、API或内部系统完成业务闭环。该路径具备零境外依赖、全中文文档、Windows原生支持、SQLite开箱即用等显著工程优势,已广泛应用于会议纪要处理、知识库问答、自动化报告生成等真实场景。本文基于2024年主流工具链(Dify v1.12.3、Olla 阅读详情

这一年来,AI 发展的越来越快,大模型使用的门槛也越来越低,每个人都可以在自己的本地运行大模型。今天再给大家介绍一个最厉害的开源大模型服务框架——ollama。

项目介绍

Ollama 是一个开源的大语言模型(LLM)服务工具,它允许用户在本地环境快速实验、管理和部署大型语言模型。它支持多种流行的开源大型语言模型,如 Llama 3.1、Phi 3、Mistral、Gemma 2 等,并且可以通过命令行界面轻松下载、运行和管理这些模型。

Ollama 的出现是为了降低使用大型语言模型的门槛,是让大型语言模型更加普及和易于访问。

项目安装

既然说到要降低门槛,Ollama 的安装也自然是非常的方便了。

Ollama 支持 macOS、Windows 和 Linux 操作系统,同时也提供了 Docker 镜像,方便在不同环境中部署。

  • macOS: 可以通过 Homebrew 安装,使用命令 brew install ollama。也可以直接下载安装包运行。

  • Windows: 需要下载安装包并运行。

  • Linux: 可以通过包管理器或使用命令 curl -fsSL ``https://ollama.com/install.sh`` | sh安装。

  • Docker: 可以使用 docker pull ollama/ollama 命令拉取镜像,并运行容器。

这里以 macOS 为例,下载了 ollama 的安装包后,直接双击运行这个可爱羊驼的应用,程序会提示你将应用移动到 application 文件夹,并且有后续的提示操作,我们按照指引去安装就可以了。
图片

图片

项目使用

安装完成后,我们可以直接执行 ollama 应用启动,也可以在命令行中执行 ollama serve 来启动 Ollama 服务。

当然,现在的我们主要在命令行中去操作 ollama。

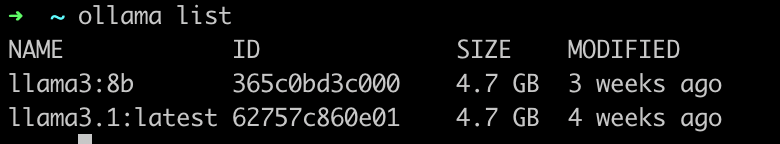
执行 ollama list:可以列出已下载的模型,如图:
图片

执行 ollama pull <model> 可以从远程仓库拉取模型。

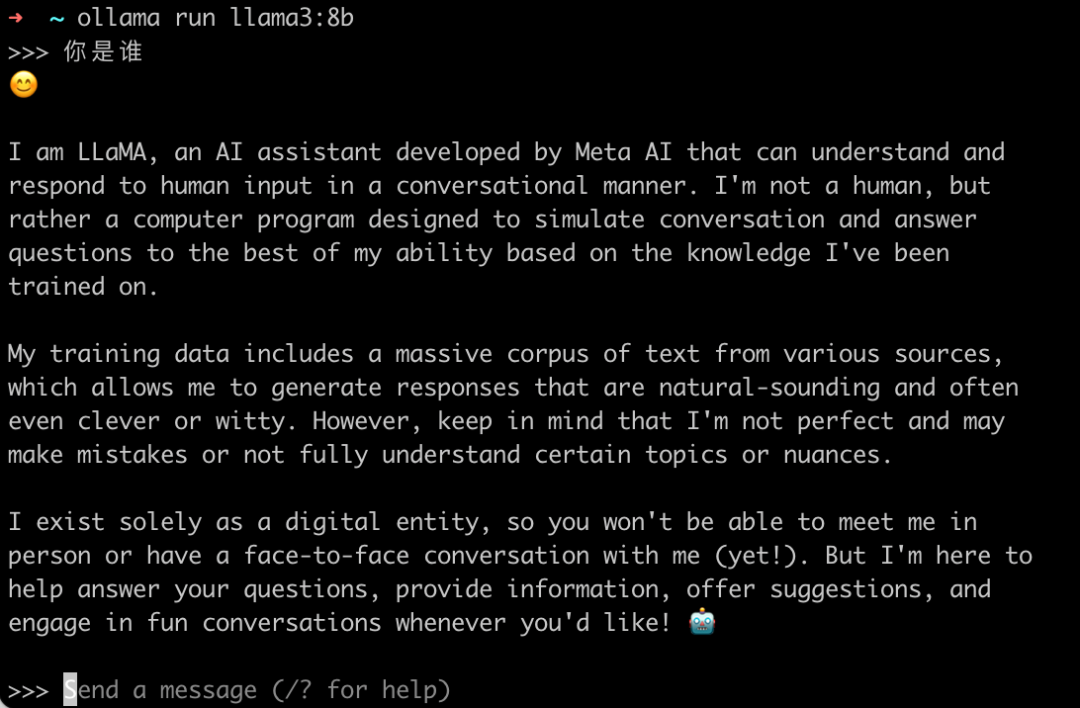
执行 ollama run <model> 可以运行指定的模型,我们使用 ollama run llama3:8b 来运行已经安装的模型,并且开始对话,如图:
图片

web 界面

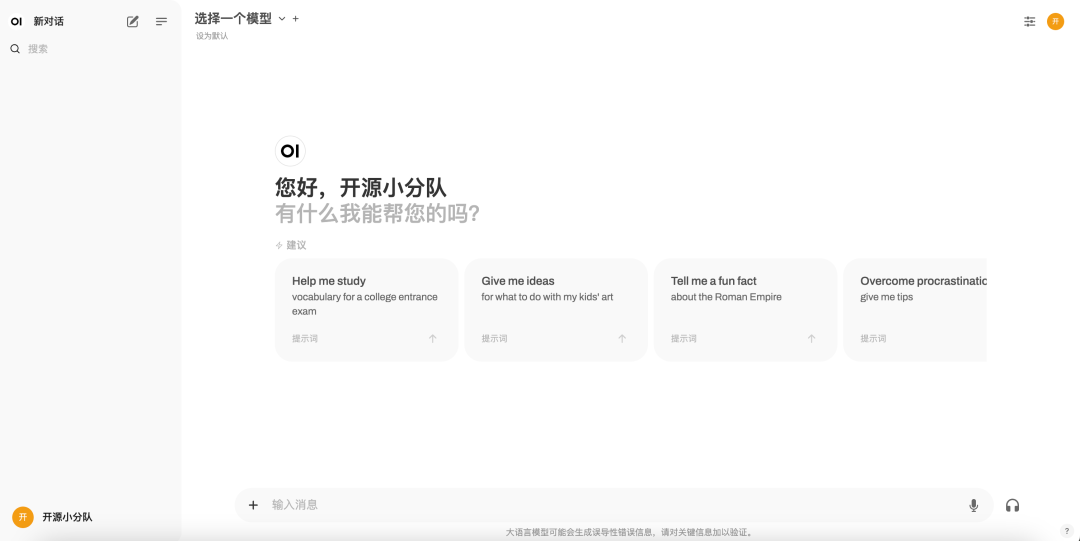
如果都是用命令行交互,还是挺麻烦的。这里再给大家介绍一个好用的 ollama 的 web 界面:open-webui。

这也是一个开源项目,我们可以使用 docker 来快速部署:

docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:main

之后在浏览器访问 localhost:3000,可以打开一个和 ChatGPT 很像的页面:
图片

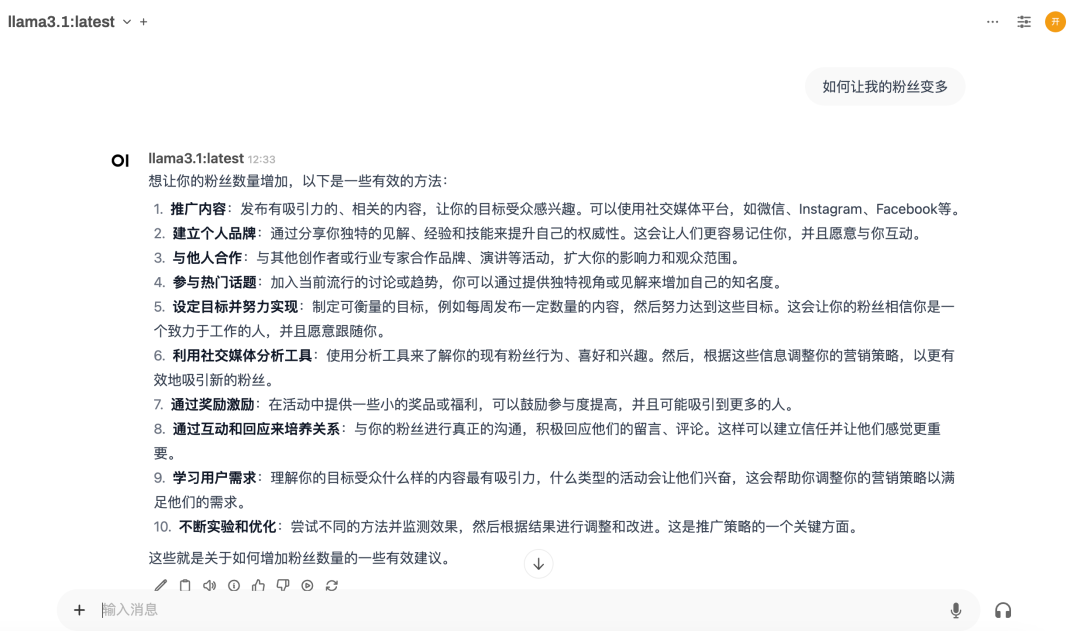
点击上方的“选择一个模型”,便可以看到 ollama 中已经下载的模型,选中后直接开启聊天就可以啦。
图片

总结

Ollama 是一个功能强大且易于使用的工具,它为本地部署和运行大型语言模型提供了一个简单而有效的方法。无论是研究、开发还是日常使用,Ollama 都能满足用户对大型语言模型的需求。Ollama 拥有庞大的社区用户和相关的开源项目,配合 open-webui,我们可以更好的使用 Ollama,并为朋友们提供一个类似于 ChatGPT 的对话界面。

感兴趣的朋友们,赶紧去试试吧。

项目地址:
https://github.com/ollama/ollama
https://github.com/open-webui/open-webui
2025免费大模型直连方案:HF、高校API与Ollama本地部署实战指南 大语言模型(LLM)推理服务正从中心化API向多元接入演进,理解其底层原理与工程约束是构建稳定AI应用的前提。免费大模型并非零成本,而是指无需付费账户、无显式调用配额、可直连使用的开源托管服务(如Hugging Face免费Inference Endpoint)、高校公益API及本地化部署方案(如Ollama+量化模型)。其技术价值在于降低中小开发者与教育场景的接入门槛,规避密钥管理、频控告警与跨域限制等典型痛点。典型应用场景包括教学演示、低频知识问答、隐私敏感的离线推理及学术对比实验。本文聚焦‘能用’到‘ 阅读详情

相关推荐

开源大模型选型避坑指南:破除榜单迷信,回归场景验证

开源大模型并非单一维度可排序的技术产品,其本质是面向特定任务、硬件与数据分布的工程化组件。理解模型架构原理(如RoPE、GQA、SwiGLU)是判断适配性的前提;技术价值体现在中文长文本解析、量化推理效率、LoRA微调兼容性等可测量指标;典型应用场景包括政企知识库、多语言客服、边缘端代码辅助等;而真实落地成败取决于本地GPU上的首token延迟、领域测试集准确率与许可证合规性。本文聚焦Qwen2系列与Llama-3、Phi-3等主流开源模型的实操对比,揭示‘衍生模型’定义模糊、榜单统计口径失真等常见认知偏差

weixin_30402343的博客 437

【ollama 下载不下来的问题解决】

国内从官网下载ollama经常遇到下载不下来,或者卡住的问题,今天给大家分享解决这个问题的方法。

zishuijing_dd的博客 10万+

2026本地部署大模型实战指南:显卡选型、模型适配与生产就绪部署

大模型本地部署已从技术尝鲜升级为金融、医疗、制造等行业的刚性需求,其核心在于满足数据合规、领域定制与毫秒级实时响应三大硬约束。理解显存带宽而非仅看容量、选择经实测验证的量化模型(如Qwen2-7B-Int4)、构建含健康检查与自愈能力的Docker部署体系,是跨越‘能跑’到‘稳产’的关键。本文聚焦2026年真实硬件环境(RTX 4090/A100/昇腾910B)与主流开源模型(Qwen2、Phi-3-mini、Qwen2-VL)的协同优化,提供覆盖选型、压测、部署、监控全链路的工程化落地方案。

weixin_34178244的博客 378

三种快速下载OLLAMA的方法(任何版本都适用)

三种快速下载OLLAMA的方法(任何版本都适用)

anningyue的博客 12万+

Hermes Agent:开源AI代理的自进化记忆与上下文压缩实践

AI代理系统正从简单提示调用迈向具备长期记忆、上下文管理与模型无关适配能力的智能工作流基础设施。其核心在于将对话历史转化为可检索、可复用、可压缩的知识资产,而非临时缓存。自进化记忆(self-improving memory)通过结构化分层(会话/人格/技能)实现跨周期知识沉淀;上下文压缩(context compression)采用索引+蒸馏双阶段工程,在保障信息完整性前提下显著降低token消耗与延迟。这类技术已广泛应用于科研文献追踪、本地大模型私有化部署及自动化研究日报生成等场景。Hermes Age

weixin_33778544的博客 486

JetBrains AI Assistant Windows 实战指南:从概念纠偏到国产模型接入

代码智能补全是现代IDE的核心能力之一,其技术本质是基于大语言模型的上下文感知生成。这类能力依赖云端或本地推理服务,通过标准化API(如OpenAI兼容接口)与IDE深度集成,实现行内补全、跨文件推理与自然语言生成等高阶功能。在Windows平台,该能力面临UAC权限控制、TLS协议兼容、Windows Defender拦截及GPU调度等特有挑战。JetBrains AI Assistant作为官方支持的成熟方案,不仅提供开箱即用的云服务,更自1.5版本起开放Custom Model Provider机制,

376

这个 87.4k star 的大模型项目,你必须拥有

Ollama 是一个开源的大语言模型(LLM)服务工具,它允许用户在本地环境快速实验、管理和部署大型语言模型。它支持多种流行的开源大型语言模型,如 Llama 3.1、Phi 3、Mistral、Gemma 2 等,并且可以通过命令行界面轻松下载、运行和管理这些模型。Ollama 的出现是为了降低使用大型语言模型的门槛,是让大型语言模型更加普及和易于访问。Ollama 是一个功能强大且易于使用的工具,它为本地部署和运行大型语言模型提供了一个简单而有效的方法。

小白码上飞 1062

开源AI落地七道生死关:从可运行到生产就绪的工程实践

开源AI已超越代码共享概念,演进为涵盖模型架构、训练数据、推理引擎、量化方案与安全护栏的全栈可控技术范式。其核心价值在于提供确定性响应、自主可控的模型即基础设施(Model-as-Infrastructure)能力,并支撑本地化推理、模型可审计性等关键需求。在金融、政务、教育等强合规场景中,开源方案通过vLLM加速、分层量化、提示词程序化、三级安全防御与AI专属可观测体系,实现比闭源API更低延迟、更高精度与更强溯源能力。本文基于47个真实落地案例,系统拆解从‘能跑起来’到‘生产就绪’必须跨越的七道工程关卡

weixin_30861797的博客 342

一个开源的大语言模型(LLM)服务工具,支持Llama 3.1、Phi 3、Mistral、Gemma 2 等, 87.4k star你必须拥有(附源码)

一个功能强大且易于使用的工具,它为本地部署和运行大型语言模型提供了一个简单而有效的方法。

m0_68103752的博客 1230

Phi-3-Mini实战指南:3.8B小模型如何在MacBook Air等低端设备高效运行

小语言模型(SLM)是当前AI工程落地的关键演进方向,其核心在于通过数据效率、架构轻量化与场景锚定,在参数规模受限前提下实现高推理精度与低硬件依赖。Phi-3-Mini作为典型代表,以3.8B参数和128K上下文支持,在真实开发流中展现出远超预期的代码理解、错误诊断与文档生成能力。它不追求通用大模型的广度,而是聚焦开发者协同时的确定性输出与低延迟响应,天然适配CPU推理、边缘设备及离线RAG系统。结合GGUF/AWQ量化、MLX框架优化与分步提示工程,该模型可在MacBook Air、Jetson Orin

weixin_30383279的博客 376

Ollama系列---【如何离线安装ollama?】

1.环境 本文以centos7.9安装ollama为例 2.下载ollama安装包 官网地址:https://ollama.com/download/linux GitHub手动安装文档地址:https://github.com/ollama/ollama/blob/main/docs/linux.md 安装包下载地址:https://ollama.com/download/ollama-lin...

-少年-的博客 3874

87.4k star!一个最厉害的开源大语言(LLM)模型服务框架,支持Llama 3.1、Phi 3、Mistral、Gemma 2 等 (带私活源码)

一个功能强大且易于使用的工具

m0_68103752的博客 1025

ollama在2025.12月发布的最新包的安装方式

Ollama最新版本v0.13.2发布,用户现在可以通过官方镜像直接下载,无需使用代理工具。官方提供了安装脚本,只需设置OLLAMA_MIRROR环境变量指向国内镜像地址(https://ghproxy.cn/),然后执行修改后的安装脚本即可完成安装。这一改进大大简化了国内用户的下载流程,解决了之前需要特殊网络访问的问题。用户可以通过GitHub发布页面获取最新版本信息。

拥抱具身智能,昇腾Ascend C 5674

C#轻量图像生成工具:Ollama本地多模态工作流实践

图像生成工具是AI应用落地的关键中间件,其核心在于模型调用、提示词工程与跨平台部署的协同优化。本文围绕基于C#构建的本地化图像生成服务展开,深入解析如何通过Ollama统一抽象层对接Flux、SDXL等主流开源模型,结合离线Codex提示词增强实现中英文语义对齐,并依托.NET 6+对macOS ARM64的原生支持,达成免依赖、低内存、高确定性的端侧部署。技术价值体现在降低多模态集成门槛、规避Python生态碎片化、适配M1/M2 Mac mini等边缘算力设备。典型应用场景包括电商主图批量生成、.NET

weixin_34185320的博客 360

‌【人工智能】Ollama,一个开源的大型语言模型(LLM)服务工具,旨在帮助用户简化在本地环境中部署和运行大模型的过程

Ollama 是一个开源的大型语言模型(LLM)服务工具,旨在帮助用户简化在本地环境中部署和运行大模型的过程。它提供了一种类似于Docker的简明易用框架,让用户可以通过简单的安装指令,在本地快速启动和运行各种开源大型语言模型,如Llama 2。Ollama是一个让用户能够在本地轻松运行大型语言模型的服务工具,大大降低了技术门槛,促进了大模型在个人开发者和企业中的应用。通过其提供的简易安装和广泛的模型支持,Ollama正在改变人们与大型语言模型交互的方式,使其更加便捷和高效。

奶爸的编程之路,也就一周冷个三天 3376

手把手教你用C语言给STM32写一个Modbus RTU从机库(含完整项目源码)

在工业自动化领域,Modbus RTU协议因其简单可靠的特点,成为RS485总线通信的事实标准。对于嵌入式开发者而言,为STM32等微控制器实现一个高效的Modbus RTU从机协议栈,是开发智能传感器、执行器等设备的必备技能。Modbus RTU从机的核心是一个状态机,需要处理帧接收、CRC校验、功能码解析和响应生成等环节。工业现场总会遇到意想不到的干扰情况,一个健壮的协议栈应该能够优雅地处理各种异常场景,而不是简单地崩溃或死锁。工业现场环境复杂,协议栈必须具备完善的异常处理机制。

weixin_30561425的博客 516

2024开源大模型选型实战指南:许可证、硬件适配与中文长文本稳定性

开源大模型并非单纯比拼参数或评测分数,其核心价值在于工程落地可行性。从基础概念看,开源大模型指具备可本地部署、可商用、可审计、可修改特性的公开权重模型;原理上,选型需综合考量许可证合规性(如Apache 2.0 vs Custom License)、硬件适配深度(CPU/ARM/GPU推理支持)及中文语义建模能力;技术价值体现在降低隐性成本——包括法务风险、运维迭代开销与数据治理负担;典型应用场景覆盖政务公文解读、制造业故障分析、边缘端语音交互及金融合同风控等真实业务闭环;本文聚焦Qwen2系列的中文长文档

weixin_34068198的博客 381

死磕GMSSL通信-java/Netty系列(二)

Netty-tcnative再linux编译比较好编译,但是再window编译,我尝试了各种办法,总是编译失败,所以我采用半自动的方式进行编译,Netty-tcnative会生成临时文件,直接用vs打开,设置openssl的头文件和静态库路径,然后生成静态库,静态库改个名字放到jar包里边,其实自动编译也是这个原理哈哈O(∩_∩)O。直接传输五个证书的路径吗,之前有的是说要转成x509之类的,转来转去的有点麻烦,这个是直接传输证书路径,由底层gmssl去解析,格式必须是pem格式。然而,若项目已依赖于。

qq_36577699的博客 3027

小模型如何在真实工作流中追平大模型?

小模型并非大模型的简化版,而是一种面向任务流优化的轻量化架构——其核心价值在于低延迟、高可控、数据本地化。通过结构适配(如注意力机制优化)、领域增强(法律/代码微调)和工程嵌入(RAG+提示词契约),3B~9B量级模型已在合同审核、周报生成、PDF摘要等典型办公场景中实现与GPT-4 Turbo相当的交付质量。关键技术支撑包括AWQ量化、PagedAttention内存管理、Grammar-Guided Decoding格式控制,以及基于PyMuPDF+FAISS的端到端本地化处理链路。本文聚焦‘任务流对齐

weixin_30251829的博客 351

使用PaddleOCR识别查验平台验证码

PaddleOCR识别国税查验平台验证码

m0_63932300的博客 1269

用于多种无人机协作的群体智能算法:综合综述

随着无人机技术的快速高水平发展,将多架无人机作为自主控制的编队应用于复杂情况是一个新兴领域的代表之一。在实现自主控制的挑战中,碰撞避免、任务分配、路径规划和编队重构是关键功能。本文对各种经典的无人机群智能算法进行了系统的总结和分析。

erjia_的博客 1万+
上一篇: “微服务革命”之后...
下一篇: Lombok 中的那些整活儿骚操作!!
架构文摘JGWZ
博客等级 码龄5年 8808粉丝 345原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值