


一、什么是 LangChain4j?
目前主流的 Java AI 开发框架有 Spring AI 和 LangChain4j,它们都提供了很多 开箱即用的 API 来帮你调用大模型、实现 AI 开发常用的功能,上期我们学了SpringAi,今天我们要学的是:
- 对话记忆
- 结构化输出
- RAG 知识库
- 工具调用
- MCP
- SSE 流式输出
二、开始实操
1、新建项目
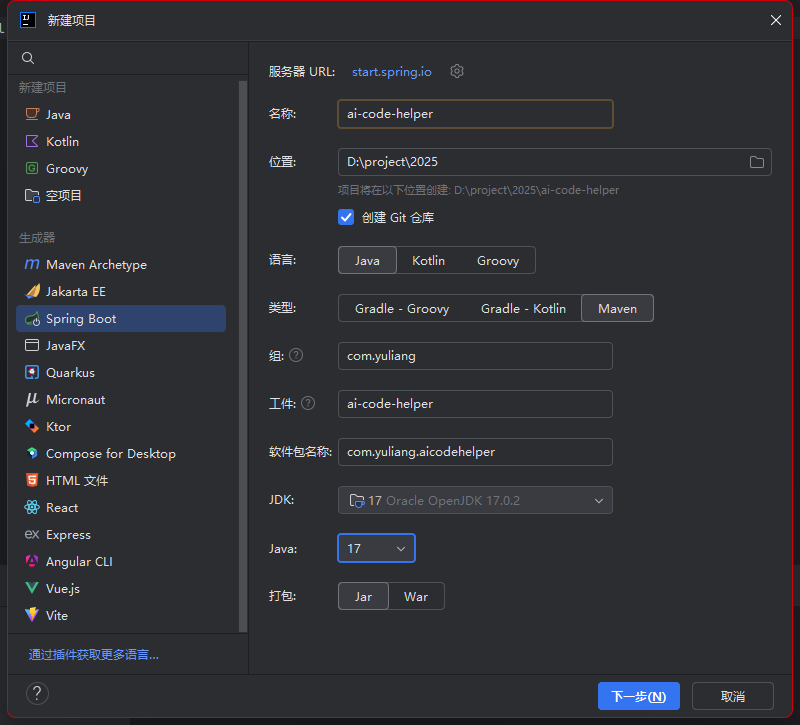
打开 IDEA 开发工具,新建一个 Spring Boot 项目,Java 版本尽量选择 21(因为 LangChain4j 最低支持 17 版本):
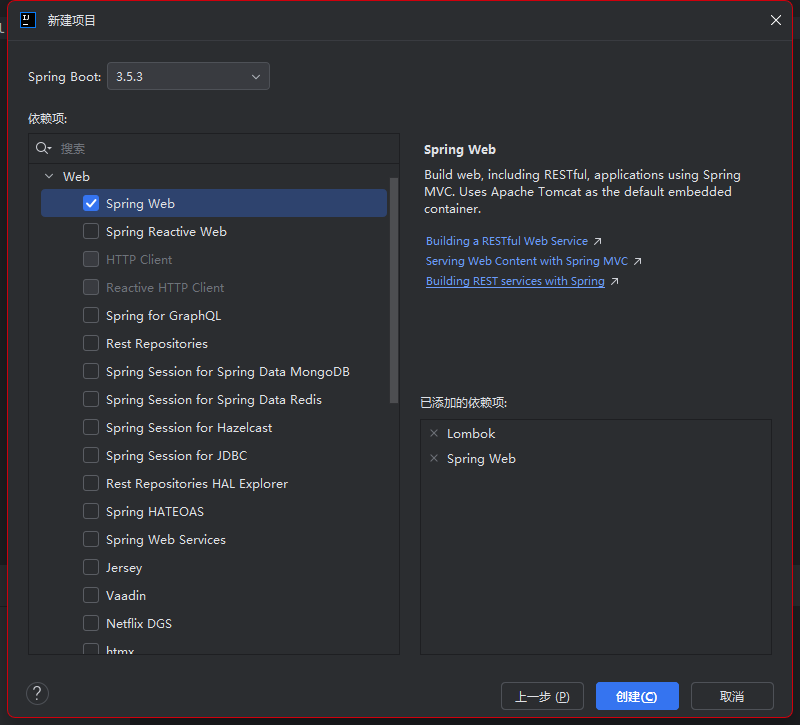
选择依赖,使用 3.5.x 版本的 Spring Boot,引入 Spring MVC 和 Lombok 注解库:
2、AI 对话 - ChatModel
ChatModel 是最基础的概念,负责和 AI 大模型交互。
首先需要引入至少一个 AI 大模型依赖,这里选择国内的阿里云大模型,提供了和 Spring Boot 项目的整合依赖包,比较方便:
<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-community-dashscope-spring-boot-starter</artifactId>
    <version>1.1.0-beta7</version>
</dependency>
需要到 阿里云百炼平台 获取大模型调用 key,注意不要泄露!
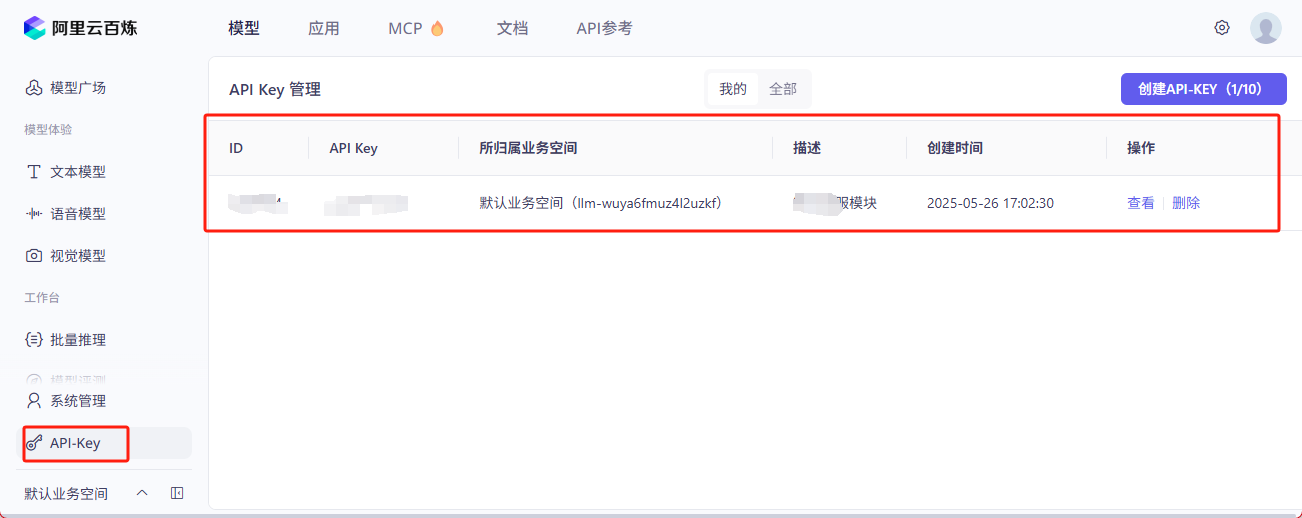
回到项目,在配置文件中添加大模型配置,指定模型名称和 API Key:
langchain4j:
  community:
    dashscope:
      chat-model:
        model-name: qwen-max
        api-key: <You API Key here>
有了 ChatModel 后,创建一个 AiCodeHelper 类,引入自动注入的 qwenChatModel,编写简单的对话代码,并利用 Lombok 注解打印输出结果日志:
@Service
@Slf4j
publicclass AiCodeHelper {

    @Resource
    private ChatModel qwenChatModel;

    public String chat(String message) {
        UserMessage userMessage = UserMessage.from(message);
        ChatResponse chatResponse = qwenChatModel.chat(userMessage);
        AiMessage aiMessage = chatResponse.aiMessage();
        log.info("AI 输出:" + aiMessage.toString());
        return aiMessage.text();
    }
}
编写单元测试【在chat方法中按alt+回车】
@SpringBootTest
class AiCodeHelperApplicationTests {

    @Resource
    public AiCodeHelper aiCodeHelper;

    @Test
    void chat() {
        String chat = aiCodeHelper.chat("你好,我是程序员鱼亮");
        System.out.println(chat);
    }
}
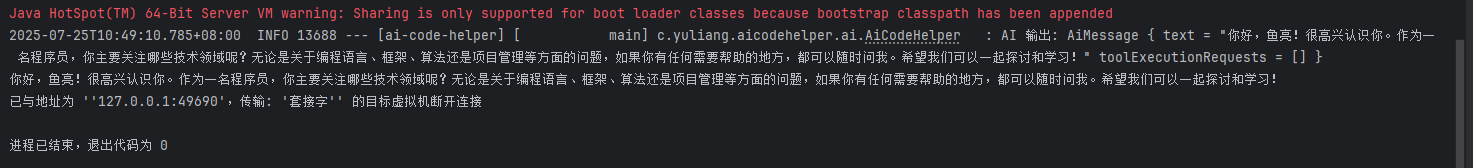
以 Debug 模式运行单元测试,成功运行并查看输出:
3、多模态【候补】
多模态是指能够同时处理、理解和生成多种不同类型数据的能力,比如文本、图像、音频、视频、PDF 等等。
LangChain4j 中使用多模态的方法很简单,用户消息中是可以添加图片、音视频、PDF 等媒体资源的。
4、系统提示词 - SystemMessage
系统提示词是设置 AI 模型行为规则和角色定位的隐藏指令,用户通常不能直接看到。系统 Prompt 相当于给 AI 设定人格和能力边界,也就是告诉 AI “你是谁?你能做什么?”。
修改 chat 方法,代码如下:
private static final String SYSTEM_MESSAGE = """
        你是编程领域的小助手,帮助用户解答编程学习和求职面试相关的问题,并给出建议。重点关注 4 个方向:
        1. 规划清晰的编程学习路线
        2. 提供项目学习建议
        3. 给出程序员求职全流程指南(比如简历优化、投递技巧)
        4. 分享高频面试题和面试技巧
        请用简洁易懂的语言回答,助力用户高效学习与求职。
        """;

public String chat(String message) {
    SystemMessage systemMessage = SystemMessage.from(SYSTEM_MESSAGE);
    UserMessage userMessage = UserMessage.from(message);
    ChatResponse chatResponse = qwenChatModel.chat(systemMessage, userMessage);
    AiMessage aiMessage = chatResponse.aiMessage();
    log.info("AI 输出:" + aiMessage.toString());
    return aiMessage.text();
}
5、AI 服务 - AI Service
在学习更多特性前,我们要了解 LangChain4j 最重要的开发模式 —— AI Service,提供了很多高层抽象的、用起来更方便的 API,把 AI 应用当做服务来开发。
使用 AI Service
首先引入 langchain4j 依赖:
<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j</artifactId>
    <version>1.1.0</version>
</dependency>
然后创建一个编程助手 AI Service 服务,采用声明式开发方法,编写一个对话方法,然后可以直接通过 @SystemMessage 注解定义系统提示词。
public interface AiCodeHelperService {

    @SystemMessage("你是一位编程小助手")
    String chat(String userMessage);
}
不过由于我们提示词较长,写到注解里很不优雅,所以单独在 resources 目录下新建文件 system-prompt.txt 来存储系统提示词。
public interface AiCodeHelperService {

    @SystemMessage(fromResource = "system-prompt.txt")
    String chat(String userMessage);
}
然后我们需要编写工厂类,用于创建 AI Service:
@Configuration
public class AiCodeHelperServiceFactory {

    @Resource
    private ChatModel qwenChatModel;

    @Bean
    public AiCodeHelperService aiCodeHelperService() {
        return AiServices.create(AiCodeHelperService.class, qwenChatModel);
    }
}
调用 AiServices.create 方法就可以创建出 AI Service 的实现类了,背后的原理是利用 Java 反射机制创建了一个实现接口的代理对象,代理对象负责输入和输出的转换,比如把 String 类型的用户消息参数转为 UserMessage 类型并调用 ChatModel,再将 AI 返回的 AiMessage 类型转换为 String 类型作为返回值。
6、Spring Boot 项目中使用
如果你觉得手动调用 create 方法来创建 Service 比较麻烦,在 Spring Boot 项目中可以引入依赖:
<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-spring-boot-starter</artifactId>
    <version>1.1.0-beta7</version>
</dependency>
然后给 AI Service 加上 @AiService 注解,就能自动创建出服务实例了:
@AiService
public interface AiCodeHelperService {

    @SystemMessage(fromResource = "system-prompt.txt")
    String chat(String userMessage);
}
记得注释掉之前工厂类的 @Configuration 注解,否则会出现 Bean 冲突
7、会话记忆 - ChatMemory
会话记忆是指让 AI 能够记住用户之前的对话内容,并保持上下文连贯性,这是实现 AI 应用的核心特性。
使用会话记忆
LangChain4j 为我们提供了开箱即用的 MessageWindowChatMemory 会话记忆,最多保存 N 条消息,多余的会自动淘汰。创建会话记忆后,在构造 AI Service 设置 chatMemory:
@Configuration
public class AiCodeHelperServiceFactory {

    @Resource
    private ChatModel qwenChatModel;

    @Bean
    public AiCodeHelperService aiCodeHelperService() {
        // 会话记忆
        ChatMemory chatMemory = MessageWindowChatMemory.withMaxMessages(10);
        AiCodeHelperService aiCodeHelperService = AiServices.builder(AiCodeHelperService.class)
                .chatModel(qwenChatModel)
                .chatMemory(chatMemory)
                .build();
        return aiCodeHelperService;
    }
}
8、结构化输出
结构化输出有 3 种实现方式:
- 利用大模型的 JSON schema
- 利用 Prompt + JSON Mode
- 利用 Prompt
比如我们增加一个 让 AI 生成学习报告 的方法,AI 需要输出学习报告对象,包含名称和建议列表:
@SystemMessage(fromResource = "system-prompt.txt")
Report chatForReport(String userMessage);

// 学习报告
record Report(String name, List<String> suggestionList){}
编写单元测试:
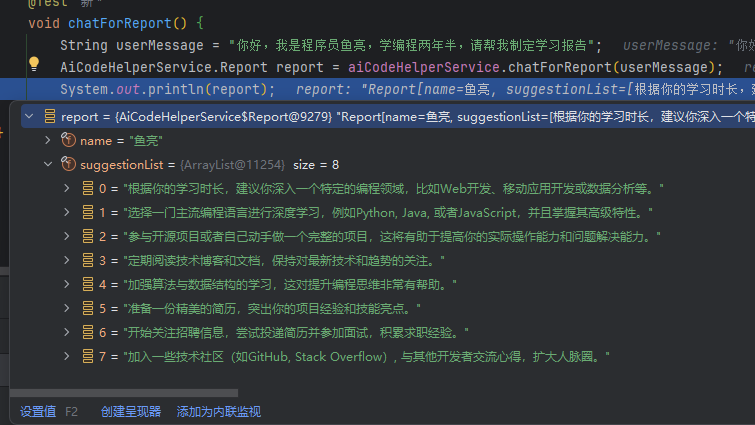
void chatForReport() {
String userMessage = "你好,我是程序员鱼亮,学编程两年半,请帮我制定学习报告";
AiCodeHelperService.Report report = aiCodeHelperService.chatForReport(userMessage);
System.out.println(report);
}
运行单元测试,效果很不错:
如果你发现 AI 有时无法生成准确的 JSON,那么可以采用 JSON Schema 模式,直接在请求中约束 LLM 的输出格式。这是目前最可靠、精确度最高的结构化输出实现。
ResponseFormat responseFormat = ResponseFormat.builder()
        .type(JSON)
        .jsonSchema(JsonSchema.builder()
                .name("Person")
                .rootElement(JsonObjectSchema.builder()
                        .addStringProperty("name")
                        .addIntegerProperty("age")
                        .addNumberProperty("height")
                        .addBooleanProperty("married")
                        .required("name", "age", "height", "married")
                        .build())
                .build())
        .build();
ChatRequest chatRequest = ChatRequest.builder()
        .responseFormat(responseFormat)
        .messages(userMessage)
        .build();
9、检索增强生成 - RAG
RAG(Retrieval-Augmented Generation,检索增强生成)是一种结合信息检索技术和 AI 内容生成的混合架构,可以解决大模型的知识时效性限制和幻觉问题。
简单来说,RAG 就像给 AI 配了一个 “小抄本”,让 AI 回答问题前先查一查特定的知识库来获取知识,确保回答是基于真实资料而不是凭空想象。很多企业也基于 RAG 搭建了自己的智能客服,可以用自己积累的领域知识回复用户。
RAG 的完整工作流程如下:
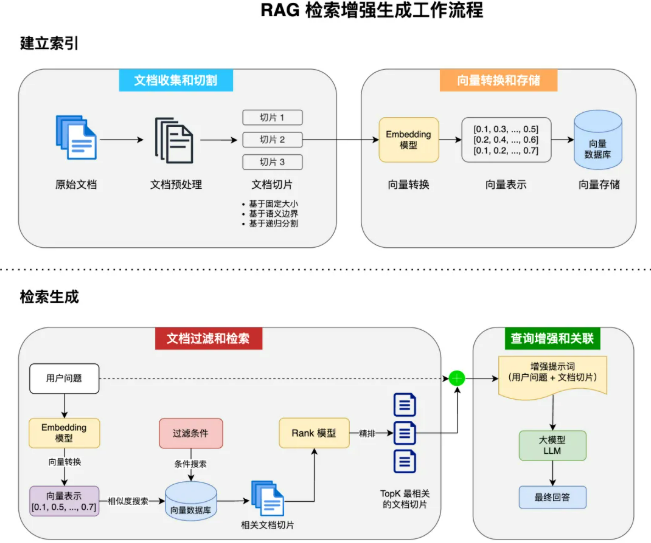
LangChain 提供了 3 种 RAG 的实现方式,我把它称为:极简版、标准版、进阶版。
极简版 RAG
极简版适合快速查看效果,首先需要引入额外的依赖,里面包含了内置的离线 Embedding 模型,开箱即用:
<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-easy-rag</artifactId>
    <version>1.1.0-beta7</version>
</dependency>
示例代码如下,使用内置的文档加载器读取文档,然后利用内置的 Embedding 模型将文档转换成向量,并存储在内置的 Embedding 内存存储中,最后给 AI Service 绑定默认的内容检索器。
// RAG
// 1. 加载文档
List<Document> documents = FileSystemDocumentLoader.loadDocuments("src/main/resources/docs");
// 2. 使用内置的 EmbeddingModel 转换文本为向量,然后存储到自动注入的内存 embeddingStore 中
EmbeddingStoreIngestor.ingest(documents, embeddingStore);
// 构造 AI Service
AiCodeHelperService aiCodeHelperService = AiServices.builder(AiCodeHelperService.class)
        .chatModel(qwenChatModel)
        .chatMemory(chatMemory)
        // RAG:从内存 embeddingStore 中检索匹配的文本片段
        .contentRetriever(EmbeddingStoreContentRetriever.from(embeddingStore))
        .build();
可以看到,极简版的特点是 “一切皆默认”,实际开发中,为了更好的效果,建议采用标准版或进阶版。
标准版 RAG
下面来试试标准版 RAG 实现,为了更好地效果,我们需要:
- 加载 Markdown 文档并按需切割
- Markdown 文档补充文件名信息
- 自定义 Embedding 模型
- 自定义内容检索器
在 Spring Boot 配置文件中添加 Embedding 模型配置,使用阿里云提供的 text-embedding-v4 模型:
langchain4j:
  community:
    dashscope:
      chat-model:
        model-name:qwen-max
        api-key:<YouAPIKeyhere>
      embedding-model:
        model-name:text-embedding-v4
        api-key:<YouAPIKeyhere>
新建 rag.RagConfig,编写 RAG 相关的代码,执行 RAG 的初始流程并返回了一个定制的内容检索器 Bean:
/**
 * 加载 Rag
 */
@Configuration
public class RagConfig {

    @Resource
    private EmbeddingModel qwenEmbeddingModel;

    @Resource
    private EmbeddingStore<TextSegment> embeddingStore;

    @Bean
    public ContentRetriever contentRetriever(){
        // ---- Rag -----
        // 1、加载文件
        List<Document> document = FileSystemDocumentLoader.loadDocuments("src/main/resources/docs");
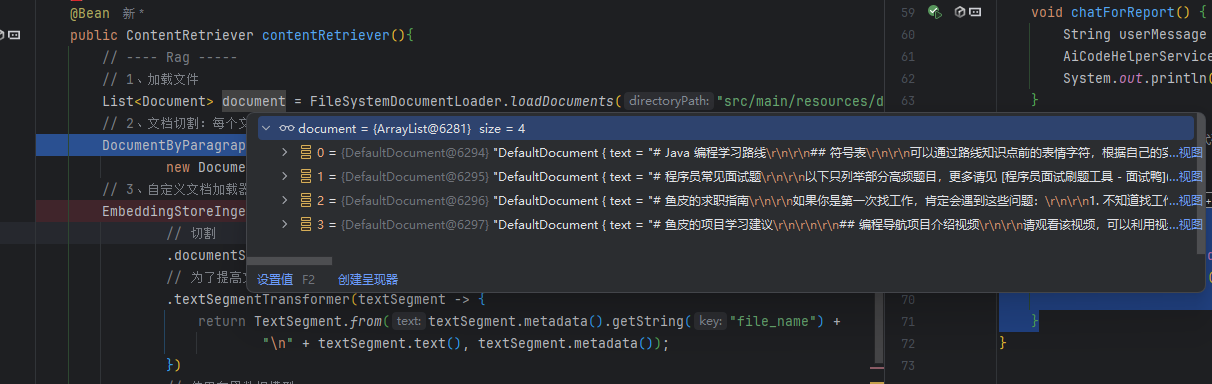
        // 2、文档切割:每个文档按照段落进行分割,最大1000个字符 每次最多重叠200个字符
        DocumentByParagraphSplitter documentByParagraphSplitter =
                new DocumentByParagraphSplitter(1000, 200);
        // 3、自定义文档加载器 把文档转化成向量并保存到向量数据库中
        EmbeddingStoreIngestor ingestor = EmbeddingStoreIngestor.builder()
                // 切割
                .documentSplitter(documentByParagraphSplitter)
                // 为了提高文档的质量,为每个切割后的文档碎片 TextSegment 添加文档名称作为元信息[file_name是固定写法,不可改]
                .textSegmentTransformer(textSegment -> {
                    return TextSegment.from(textSegment.metadata().getString("file_name") +
                            "\n" + textSegment.text(), textSegment.metadata());
                })
                // 使用向量数据模型
                .embeddingModel(qwenEmbeddingModel)
                // 保存向量数据
                .embeddingStore(embeddingStore)
                .build();
        // 加载文档
        ingestor.ingest(document);
        // 4、自定义内容加载器
        EmbeddingStoreContentRetriever contentRetriever = EmbeddingStoreContentRetriever.builder()
                .embeddingStore(embeddingStore)
                .embeddingModel(qwenEmbeddingModel)
                .maxResults(5) // 最多返回5个结果
                .minScore(0.75) // 过滤分数小于 0.75的结果
                .build();
        return contentRetriever;
    }
}
然后在构建 AI Service 时绑定内容检索器:
@Resource
private ContentRetriever contentRetriever;

@Bean
public AiCodeHelperService aiCodeHelperService() {
    // 会话记忆
    ChatMemory chatMemory = MessageWindowChatMemory.withMaxMessages(10);
    // 构造 AI Service
    AiCodeHelperService aiCodeHelperService = AiServices.builder(AiCodeHelperService.class)
            .chatModel(qwenChatModel)
            .chatMemory(chatMemory)
            .contentRetriever(contentRetriever) // RAG 检索增强生成
            .build();
    return aiCodeHelperService;
}
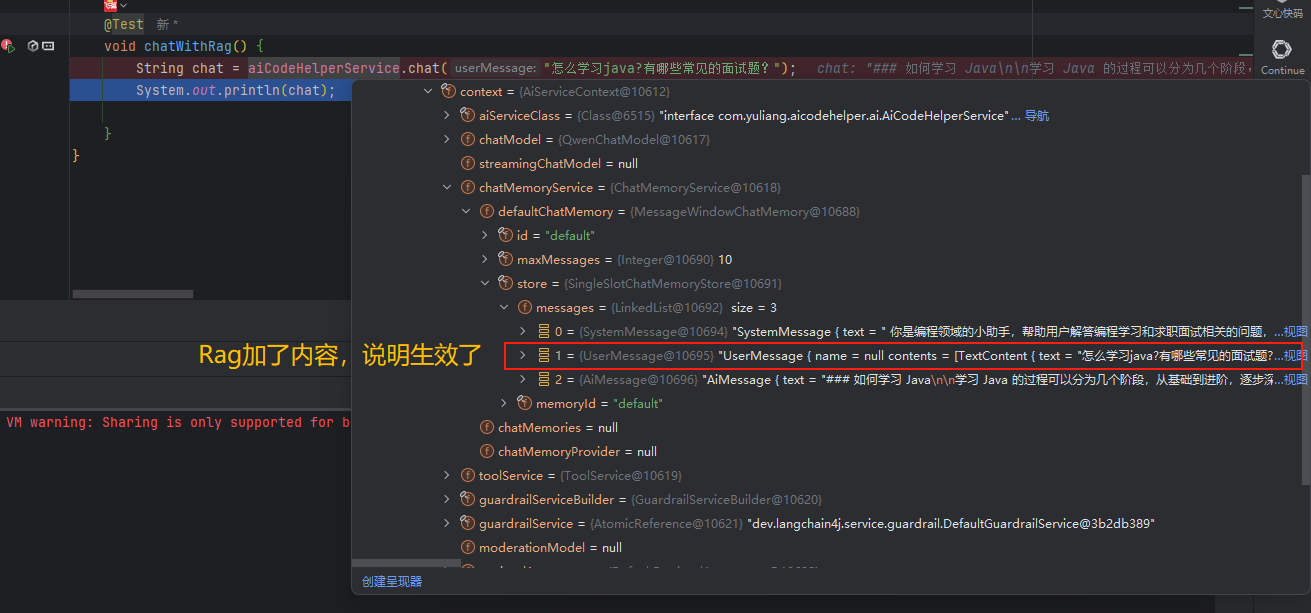
编写单元测试:
@Test
void chatWithRag() {
    String chat = aiCodeHelperService.chat("怎么学习java?有哪些常见的面试题?");
    System.out.println(chat);
}
Debug 运行,能够看到分割的文档片段,部分文档片段有内容重叠:
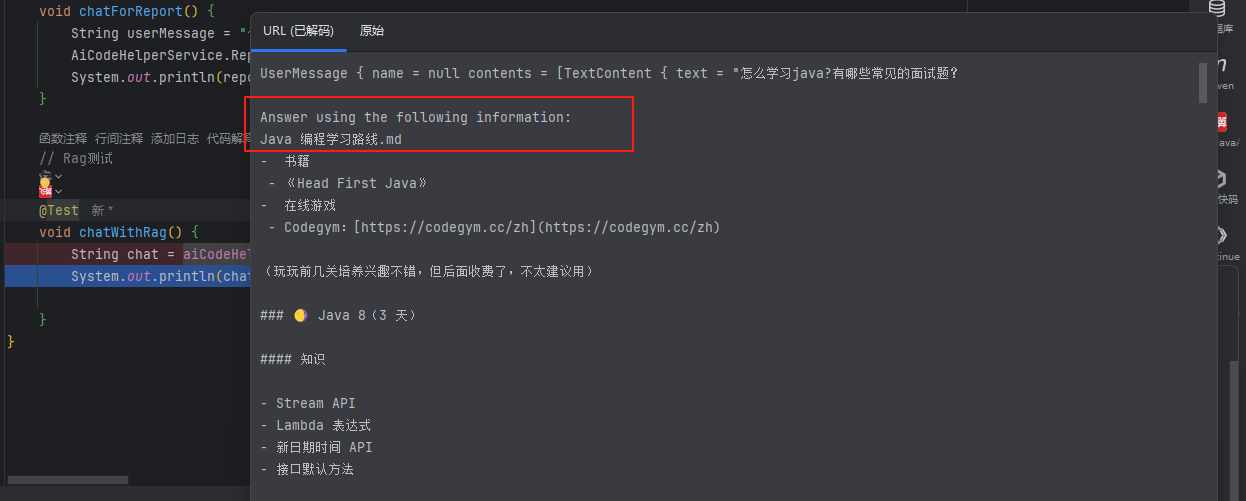
可以在对话记忆中看到实际发送的、增强后的 Prompt:
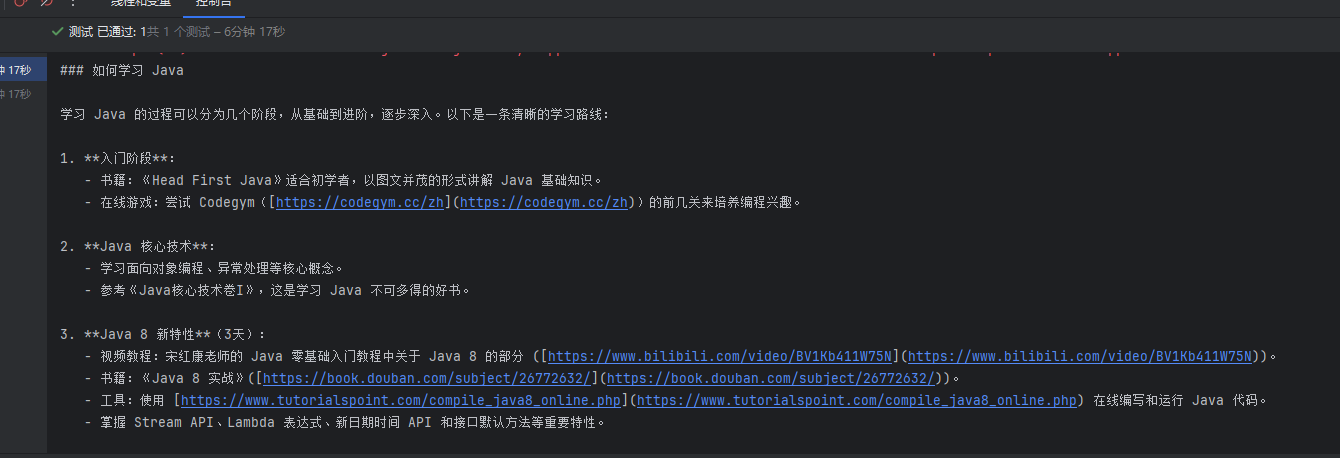
回答效果也是符合预期的:
获取引用源文档
如果能够给 AI 的回答下面展示回答来源,更容易增加内容的可信度
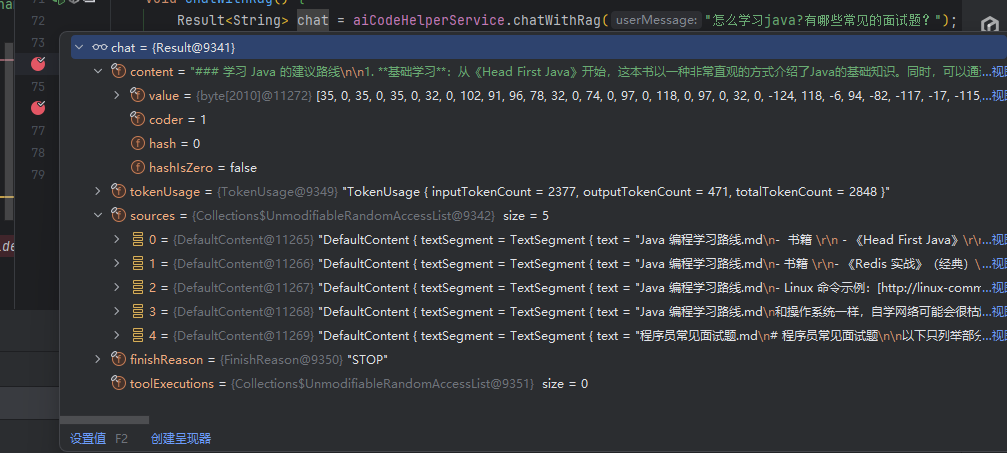
在 LangChain4j 中,实现这个功能很简单。在 AI Service 中新增方法,在原本的返回类型外封装一层 Result 类,就可以获得封装后的结果,从中能够获取到 RAG 引用的源文档、以及 Token 的消耗情况等等。
@SystemMessage(fromResource = "system-prompt.txt")
Result<String> chatWithRag(String userMessage);
修改单元测试,输出更多信息:
@Test
void chatWithRag() {
    Result<String> result = aiCodeHelperService.chatWithRag("怎么学习 Java?有哪些常见面试题?");
    String content = result.content();
    List<Content> sources = result.sources();
    System.out.println(content);
    System.out.println(sources);
}
执行效果如图,获取到了引用的源文档信息:
10、工具调用 - Tools
工具调用(Tool Calling)可以理解为让 AI 大模型 借用外部工具 来完成它自己做不到的事情。
跟人类一样,如果只凭手脚完成不了工作,那么就可以利用工具箱来完成。
工具可以是任何东西,比如网页搜索、对外部 API 的调用、访问外部数据、或执行特定的代码等。
比如用户提问 “帮我查询上海最新的天气”,AI 本身并没有这些知识,它就可以调用 “查询天气工具”,来完成任务。
需要注意的是,工具调用的本质 并不是 AI 服务器自己调用这些工具、也不是把工具的代码发送给 AI 服务器让它执行,它只能提出要求,表示 “我需要执行 XX 工具完成任务”。而真正执行工具的是我们自己的应用程序,执行后再把结果告诉 AI,让它继续工作。
第一步:先引入 Jsoup 库:
<dependency>
    <groupId>org.jsoup</groupId>
    <artifactId>jsoup</artifactId>
    <version>1.20.1</version>
</dependency>
然后在 tools 包下编写工具,通过 @Tool 注解就能声明工具了,注意 要认真编写工具和工具参数的描述,这直接决定了 AI 能否正确地调用工具。
@Slf4j
publicclass InterviewQuestionTool {
   /**
     * 从面试网站获取关键词相关的面试题列表
     *
     * @param keyword 搜索关键词(如"redis"、"java多线程")
     * @return 面试题列表,若失败则返回错误信息
     */
    @Tool(name = "interviewQuestionSearch", value = """
            Retrieves relevant interview questions from mianshiya.com based on a keyword.
            Use this tool when the user asks for interview questions about specific technologies,
            programming concepts, or job-related topics. The input should be a clear search term.
            """
    )
    public String searchInterviewQuestions(@P(value = "the keyword to search") String keyword) {
        List<String> questions = new ArrayList<>();
        // 构建搜索URL(编码关键词以支持中文)
        String encodedKeyword = URLEncoder.encode(keyword, StandardCharsets.UTF_8);
        String url = "https://www.mianshiya.com/search/all?searchText=" + encodedKeyword;
        // 发送请求并解析页面
        Document doc;
        try {
            doc = Jsoup.connect(url)
                    .userAgent("Mozilla/5.0")
                    .timeout(5000)
                    .get();
        } catch (IOException e) {
            log.error("get web error", e);
            return e.getMessage();
        }
        // 提取内容
        Elements questionElements = doc.select(".ant-table-cell > a");
        questionElements.forEach(el -> questions.add(el.text().trim()));
        return String.join("\n", questions);
    }
}
给 AI Service 绑定工具:
// 构造 AI Service
AiCodeHelperService aiCodeHelperService = AiServices.builder(AiCodeHelperService.class)
        .chatModel(qwenChatModel)
        .chatMemory(chatMemory)
        .contentRetriever(contentRetriever) // RAG 检索增强生成
        .tools(new InterviewQuestionTool()) // 工具调用
        .build();
编写单元测试,验证工具的效果:
@Test
void chatWithTools() {
    String result = aiCodeHelperService.chat("有哪些常见的计算机网络面试题?");
    System.out.println(result);
}
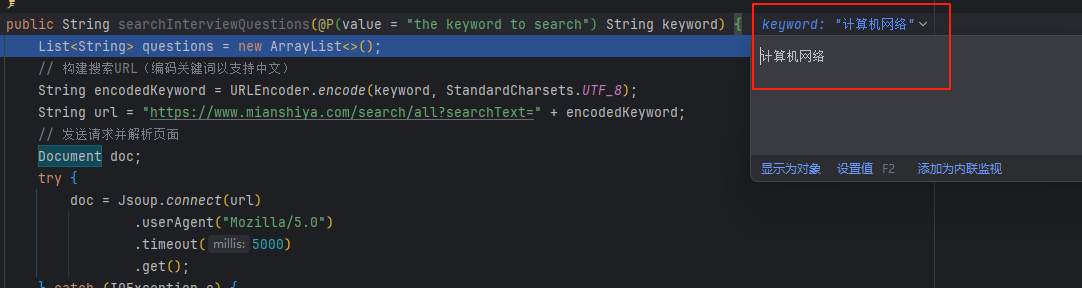
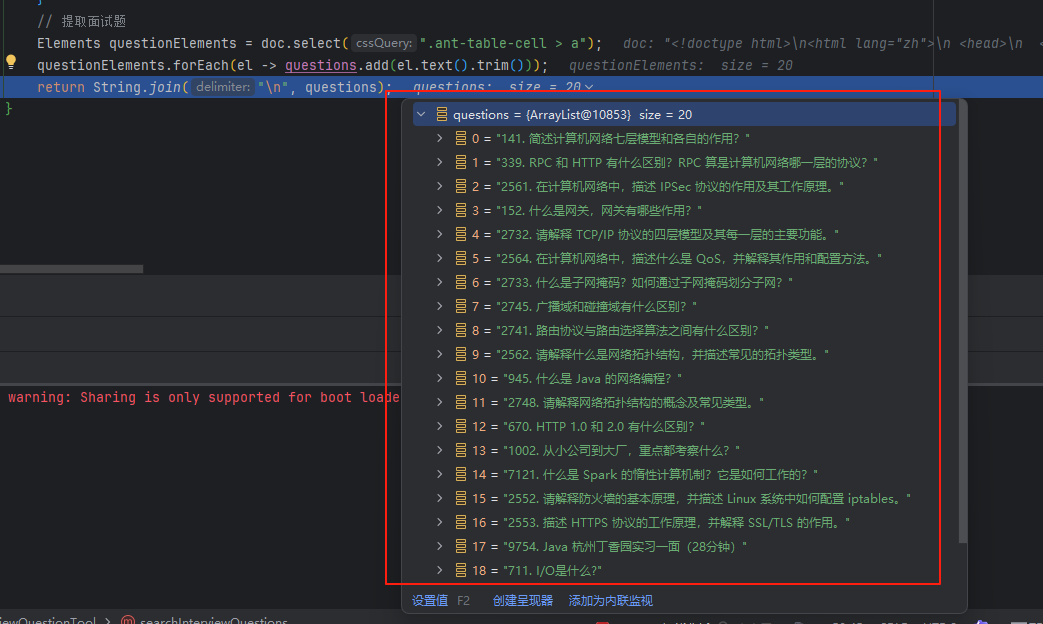
Debug 运行,发现 AI 调用了工具:
工具检索到了题目列表:
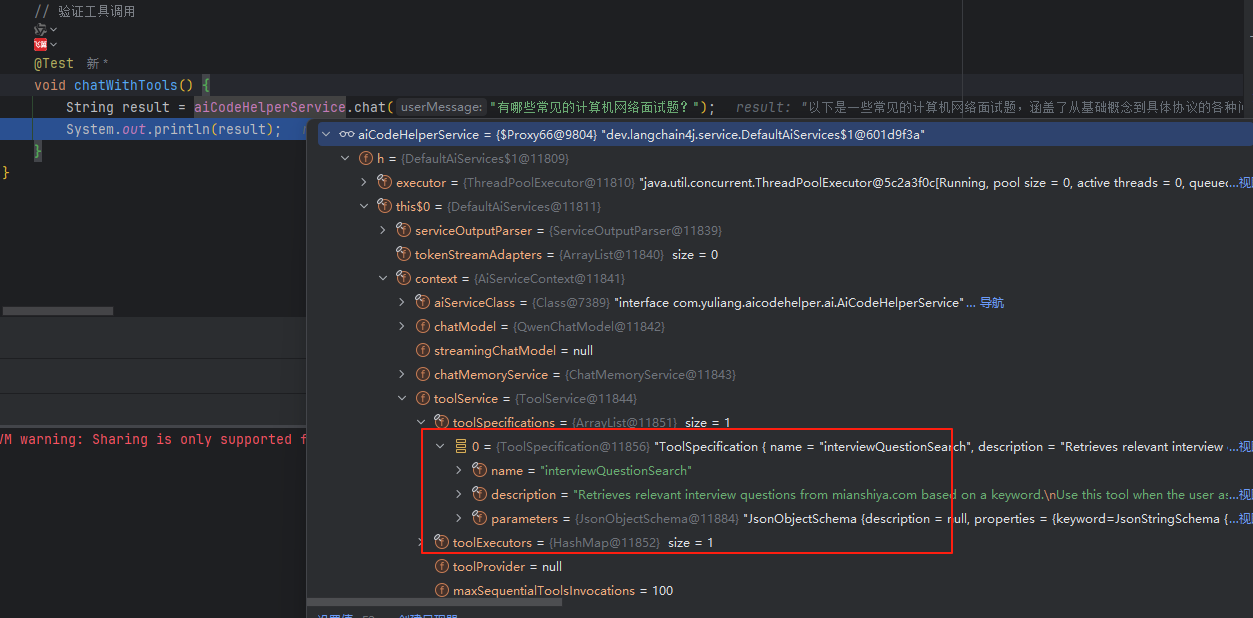
可以通过 Debug 看到 AI Service 加载了工具:
11、模型上下文协议 - MCP
MCP(Model Context Protocol,模型上下文协议)是一种开放标准,目的是增强 AI 与外部系统的交互能力。MCP 为 AI 提供了与外部工具、资源和服务交互的标准化方式,让 AI 能够访问最新数据、执行复杂操作,并与现有系统集成。
可以将 MCP 想象成 AI 应用的 USB 接口。就像 USB 为设备连接各种外设和配件提供了标准化方式一样,MCP 为 AI 模型连接不同的数据源和工具提供了标准化的方法。
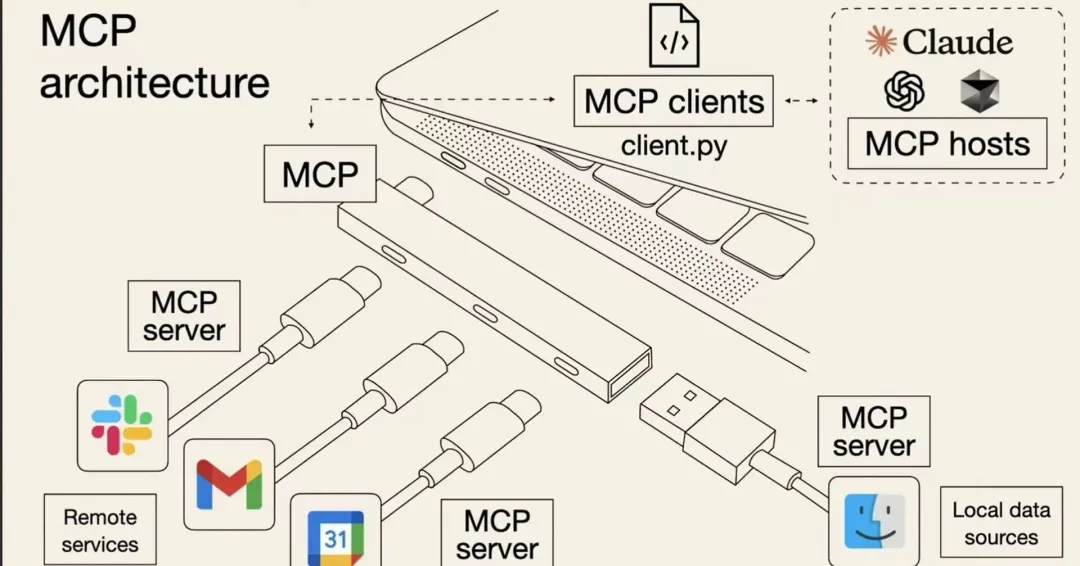
简单来说,通过 MCP 协议,AI 应用可以轻松接入别人提供的服务来实现更多功能,比如查询地理位置、操作数据库、部署网站、甚至是支付等等。
刚刚我们通过工具调用实现了面试题的搜索,下面我们利用 MCP 实现 全网搜索内容,这也是一个典型的 MCP 应用场景了。
引入依赖:
<!-- https://mvnrepository.com/artifact/dev.langchain4j/langchain4j-mcp -->
<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-mcp</artifactId>
    <version>1.1.0-beta7</version>
</dependency>
在配置文件中新增 API Key 的配置:
bigmodel:
  api-key: <Your Api Key>
新建 mcp.McpConfig,按照官方的开发方式,初始化和 MCP 服务的通讯,并创建 McpToolProvider 的 Bean:
@Configuration
publicclass McpConfig {

    @Value("${bigmodel.api-key}")
    private String apiKey;

    @Bean
    public McpToolProvider mcpToolProvider() {
        // 和 MCP 服务通讯
        McpTransport transport = new HttpMcpTransport.Builder()
                .sseUrl("https://open.bigmodel.cn/api/mcp/web_search/sse?Authorization=" + apiKey)
                .logRequests(true) // 开启日志,查看更多信息
                .logResponses(true)
                .build();
        // 创建 MCP 客户端
        McpClient mcpClient = new DefaultMcpClient.Builder()
                .key("yupiMcpClient")
                .transport(transport)
                .build();
        // 从 MCP 客户端获取工具
        McpToolProvider toolProvider = McpToolProvider.builder()
                .mcpClients(mcpClient)
                .build();
        return toolProvider;
    }
}
注意,上面我们是通过 SSE 的方式调用 MCP。如果你是通过 npx 或 uvx 本地启动 MCP 服务,需要先安装对应的工具,并且利用下面的配置建立通讯:
McpTransport transport = new StdioMcpTransport.Builder()
    .command(List.of("/usr/bin/npm", "exec", "@modelcontextprotocol/server-everything@0.6.2"))
    .logEvents(true) // only if you want to see the traffic in the log
    .build();
在 AI Service 中应用 MCP 工具:
@Resource
private McpToolProvider mcpToolProvider;

// 构造 AI Service
AiCodeHelperService aiCodeHelperService = AiServices.builder(AiCodeHelperService.class)
        .chatModel(qwenChatModel)
        .chatMemory(chatMemory)
        .contentRetriever(contentRetriever) // RAG 检索增强生成
        .tools(new InterviewQuestionTool()) // 工具调用
        .toolProvider(mcpToolProvider) // MCP 工具调用
        .build();
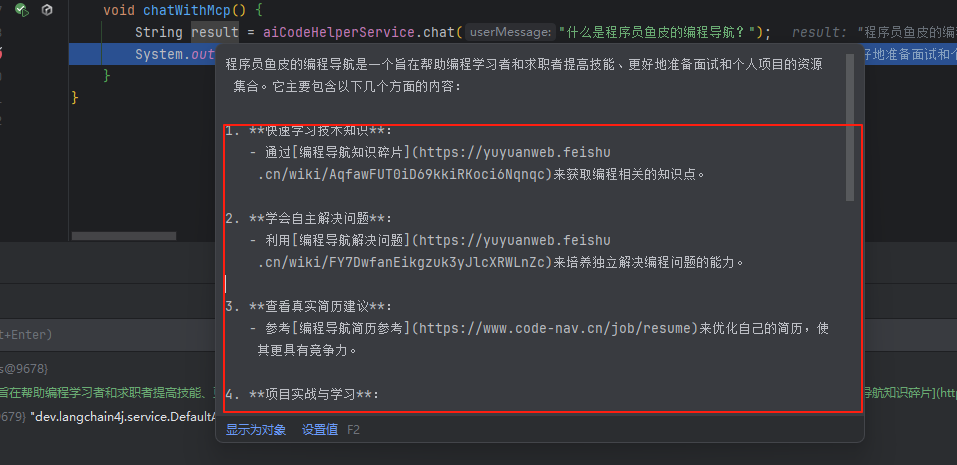
编写单元测试:
@Test
void chatWithMcp() {
    String result = aiCodeHelperService.chat("什么是程序员鱼皮的编程导航?");
    System.out.println(result);
}
12、护轨 - Guardrail
分为输入护轨(input guardrails)和输出护轨(output guardrails),可以在请求 AI 前和接收到 AI 的响应后执行一些额外操作,比如调用 AI 前鉴权、调用 AI 后记录日志。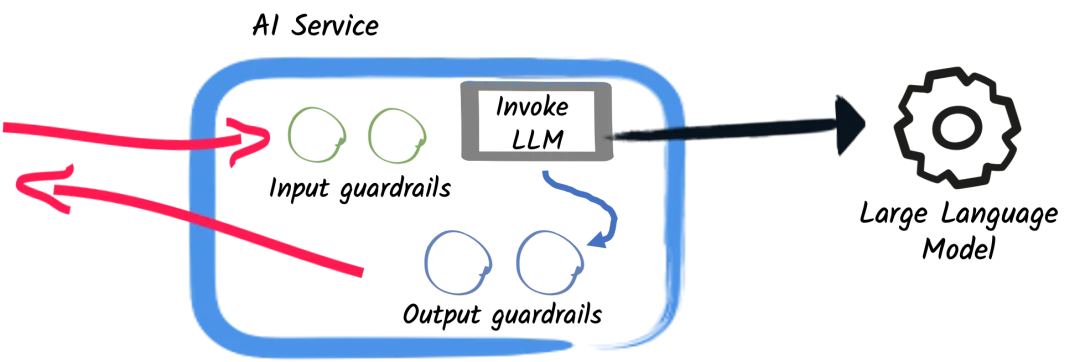
让我们小试一把,在调用 AI 前进行敏感词检测,如果用户提示词包含敏感词,则直接拒绝。
新建 guardrail.SafeInputGuardrail,实现 InputGuardrail 接口:
/**
* 安全检测输入护轨
*/
publicclass SafeInputGuardrail implements InputGuardrail {
privatestaticfinal Set<String> sensitiveWords = Set.of("kill", "evil");
/**
* 检测用户输入是否安全
*/
public InputGuardrailResult validate(UserMessage userMessage) {
// 获取用户输入并转换为小写以确保大小写不敏感
String inputText = userMessage.singleText().toLowerCase();
// 使用正则表达式分割输入文本为单词
String[] words = inputText.split("\\W+");
// 遍历所有单词,检查是否存在敏感词
for (String word : words) {
if (sensitiveWords.contains(word)) {
return fatal("Sensitive word detected: " + word);
}
}
return success();
}
}
修改 AI Service,使用输入护轨:
({SafeInputGuardrail.class}) // 添加输入护轨
public interface AiCodeHelperService {
编写单元测试,写一个包含敏感词的提示词:
void chatWithGuardrail() {
String result = aiCodeHelperService.chat("kill the game");
System.out.println(result);
}
运行并查看效果,会触发输入检测,直接抛出异常:
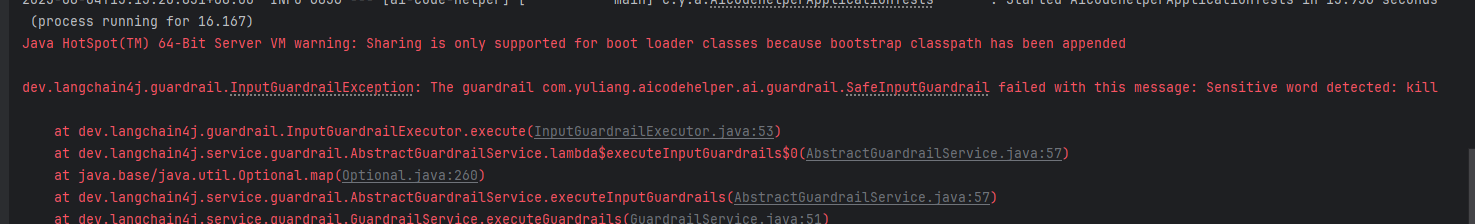
当然,除了输入护轨,也可以编写输出护轨,对 AI 的响应结果进行检测。
13、日志和可观测性
开启日志的方法很简单,直接构造模型时指定开启、或者直接编写 Spring Boot 配置,支持打印 AI 请求和响应日志。
但并不是所有的 ChatModel 都支持,比如我测试下来 QwenChatModel 就不支持。这时只能把希望交给可观测性了。
可观测性
可以通过自定义 Listener 获取 ChatModel 的调用信息,比较灵活。
新建 listener.ChatModelListenerConfig,输出请求、响应、错误信息:
@Configuration
@Slf4j
publicclass ChatModelListenerConfig {

    @Bean
    ChatModelListener chatModelListener() {
        returnnew ChatModelListener() {
            @Override
            public void onRequest(ChatModelRequestContext requestContext) {
                log.info("onRequest(): {}", requestContext.chatRequest());
            }

            @Override
            public void onResponse(ChatModelResponseContext responseContext) {
                log.info("onResponse(): {}", responseContext.chatResponse());
            }

            @Override
            public void onError(ChatModelErrorContext errorContext) {
                log.info("onError(): {}", errorContext.error().getMessage());
            }
        };
    }
}
但是只定义 Listener 好像对 QwenChatModel 不起作用,所以我们需要手动构造自定义的 QwenChatModel。
新建 model.QwenChatModelConfig,构造 ChatModel 对象并绑定 Listener:
(prefix = "langchain4j.community.dashscope.chat-model")
publicclass QwenChatModelConfig {
private String modelName;
private String apiKey;
private ChatModelListener chatModelListener;
public ChatModel myQwenChatModel() {
return QwenChatModel.builder()
.apiKey(apiKey)
.modelName(modelName)
.listeners(List.of(chatModelListener))
.build();
}
}
然后,我们将AiCodeHelpServiceFactory中引用的ChatModel 的名称改为 myQwenChatModel,防止和 Spring Boot 自动注入的 ChatModel 冲突。
再次调用 AI,就能看到很多信息了:
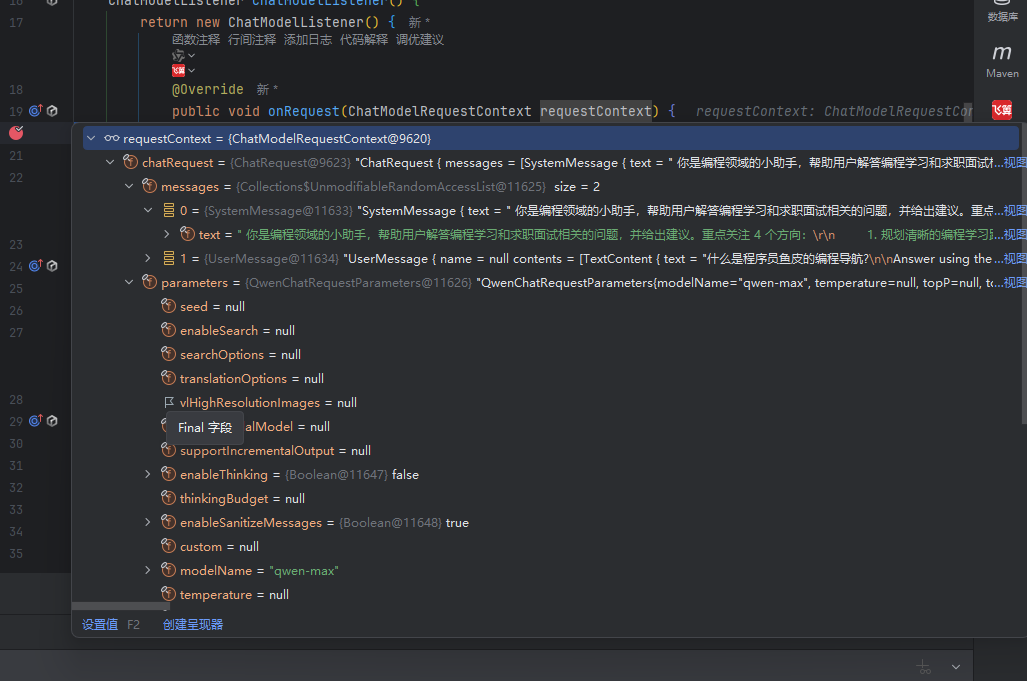
14、AI 服务化
AI 的能力基本开发完成,但是目前只支持本地运行,需要编写一个接口提供给前端调用,让 AI 能够成为一个服务。
我们平时开发的大多数接口都是同步接口,也就是等后端处理完再返回。但是对于 AI 应用,特别是响应时间较长的对话类应用,可能会让用户失去耐心等待,因此推荐使用 SSE(Server-Sent Events)技术实现实时流式输出,类似打字机效果,大幅提升用户体验。
SSE 流式接口开发
LangChain 提供了 2 种方式来支持流式响应(注意,流式响应不支持结构化输出)。
一种方法是 TokenStream,先让 AI 对话方法返回 TokenStream,然后创建 AI Service 时指定流式对话模型 StreamingChatModel:
interface Assistant {

    TokenStream chat(String message);
}

StreamingChatModel model = OpenAiStreamingChatModel.builder()
    .apiKey(System.getenv("OPENAI_API_KEY"))
    .modelName(GPT_4_O_MINI)
    .build();

Assistant assistant = AiServices.create(Assistant.class, model);

TokenStream tokenStream = assistant.chat("Tell me a joke");

tokenStream.onPartialResponse((String partialResponse) -> System.out.println(partialResponse))
    .onRetrieved((List<Content> contents) -> System.out.println(contents))
    .onToolExecuted((ToolExecution toolExecution) -> System.out.println(toolExecution))
    .onCompleteResponse((ChatResponse response) -> System.out.println(response))
    .onError((Throwable error) -> error.printStackTrace())
    .start();
我个人会更喜欢另一种方法,使用 Flux 代替 TokenStream,熟悉响应式编程的同学应该对 Flux 不陌生吧?让 AI 对话方法返回 Flux 响应式对象即可。
首先需要引入响应式包依赖:
<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-reactor</artifactId>
    <version>1.1.0-beta7</version>
</dependency>
然后给 AI Service 增加流式对话方法,这里顺便支持下多用户的会话记忆:
// 流式对话
Flux<String> chatStream( int memoryId, String userMessage);
由于要用到流式模型,需要增加流式模型配置:
langchain4j:
  community:
    dashscope:
      streaming-chat-model:
        model-name: qwen-max
        api-key: <Your Api Key>
构造 AI Service 时指定流式对话模型(自动注入即可),并且补充会话记忆提供者:
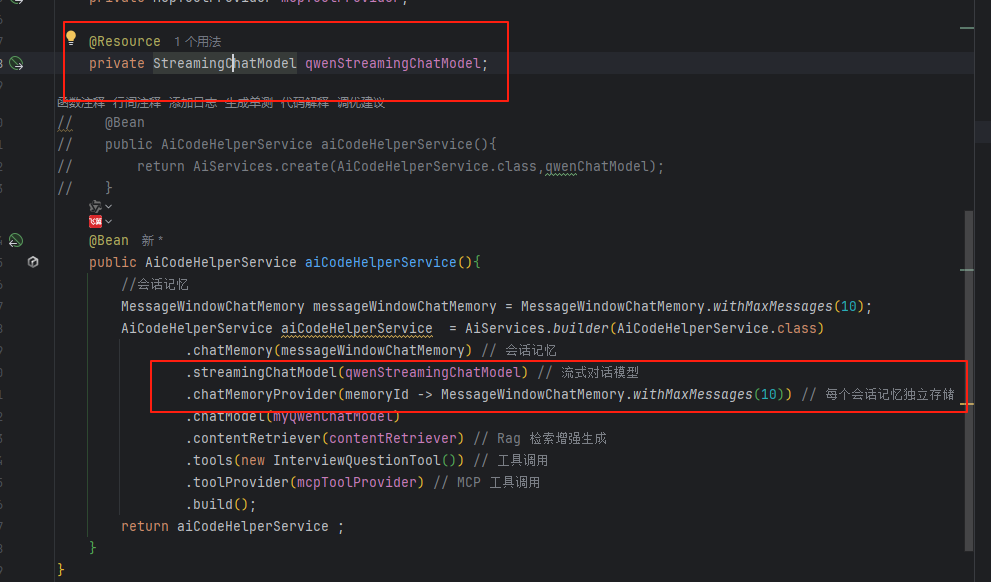
最后,编写 Controller 接口。为了方便测试,这里使用 Get 请求:
("/api")
public class AiController {
private AiCodeHelperService aiCodeHelperService;
("/chat")
public Flux<ServerSentEvent<String>> chat(int memoryId, String userMessage){
return aiCodeHelperService.chatStream(memoryId, userMessage)
.map(chunk -> ServerSentEvent.<String>builder()
.data(chunk).build()
);
}
}
增加服务器配置,指定后端端口和接口路径前缀:
server:
  port: 8081
  servlet:
    context-path: /api
使用ApiFox测试:
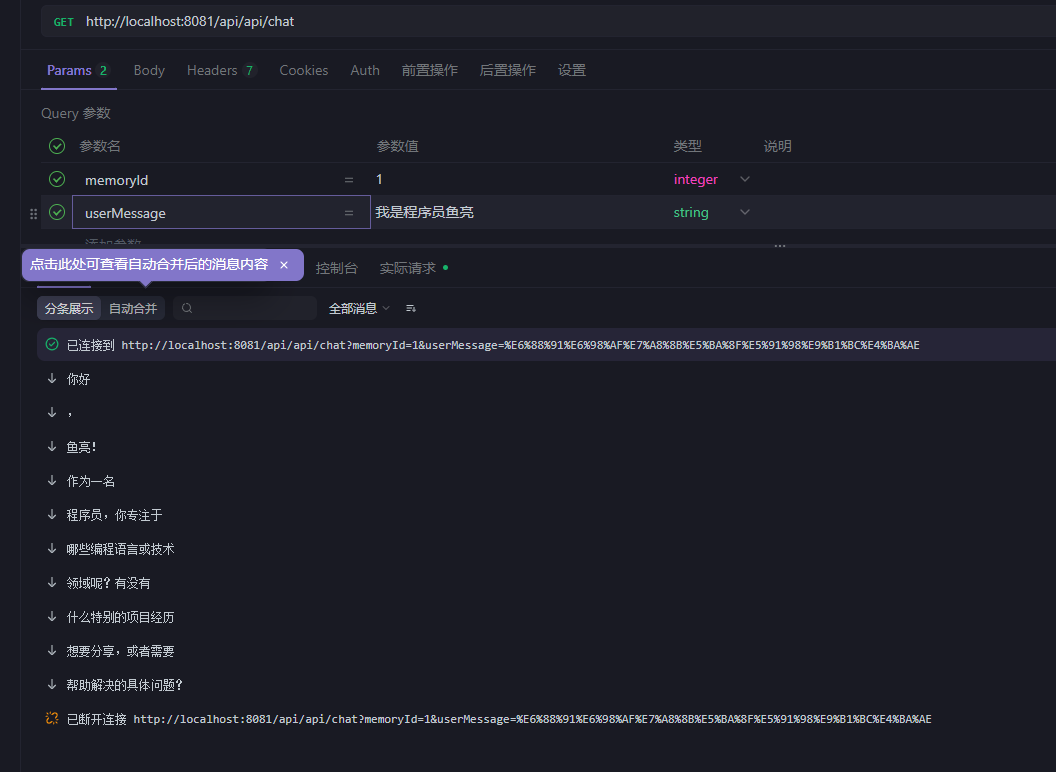
后端支持跨域
为了让前端项目能够顺利调用后端接口,我们需要在后端配置跨域支持。在 config 包下创建跨域配置类,代码如下:
/**
* 全局跨域配置
*/
publicclass CorsConfig implements WebMvcConfigurer {
public void addCorsMappings(CorsRegistry registry) {
// 覆盖所有请求
registry.addMapping("/**")
// 允许发送 Cookie
.allowCredentials(true)
// 放行哪些域名(必须用 patterns,否则 * 会和 allowCredentials 冲突)
.allowedOriginPatterns("*")
.allowedMethods("GET", "POST", "PUT", "DELETE", "OPTIONS")
.allowedHeaders("*")
.exposedHeaders("*");
}
}
注意,如果 .allowedOrigins(“*”) 与 .allowCredentials(true) 同时配置会导致冲突,因为出于安全考虑,跨域请求不能同时允许所有域名访问和发送认证信息(比如 Cookie)。
15、AI 生成前端
我们可以利用 AI 来快速生成前端代码,极大提高开发效率。这里鱼皮使用 主流 AI 开发工具 Trae,挑战不写一行代码,生成符合要求的前端项目。你应该使用 Windows 支持的命令来完成任务。
提示词
首先准备一段详细的 Prompt,一般要包括需求、技术选型、后端接口信息,还可以提供一些原型图、后端代码等。
你是一位专业的前端开发,请帮我根据下列信息来生成对应的前端项目代码。
## 需求
应用为《AI 编程小助手》,帮助用户解答编程学习和求职面试相关的问题,并给出建议。
只有一个页面,就是主页:页面风格为聊天室,上方是聊天记录(用户信息在右边,AI 信息在左边),下方是输入框,进入页面后自动生成一个聊天室 id,用于区分不同的会话。通过 SSE 的方式调用 chat 接口,实时显示对话内容。
## 技术选型
1. Vue3 项目
2. Axios 请求库
## 后端接口信息
接口地址前缀:http://localhost:8081/api
## SpringBoot 后端接口代码
("/api")
public class AiController {
("/chat")
public Flux<ServerSentEvent<String>> chat(int memoryId, String message) {
return aiCodeHelperService.chatStream(memoryId, message)
.map(chunk -> ServerSentEvent.<String>builder()
.data(chunk)
.build());
}
}
开发
打开“Trae”软件,创建ai-code-helper-frontend项目,将上述提示此给到Builder,直接生成好,我们还可以根据自己的想法不断的优化
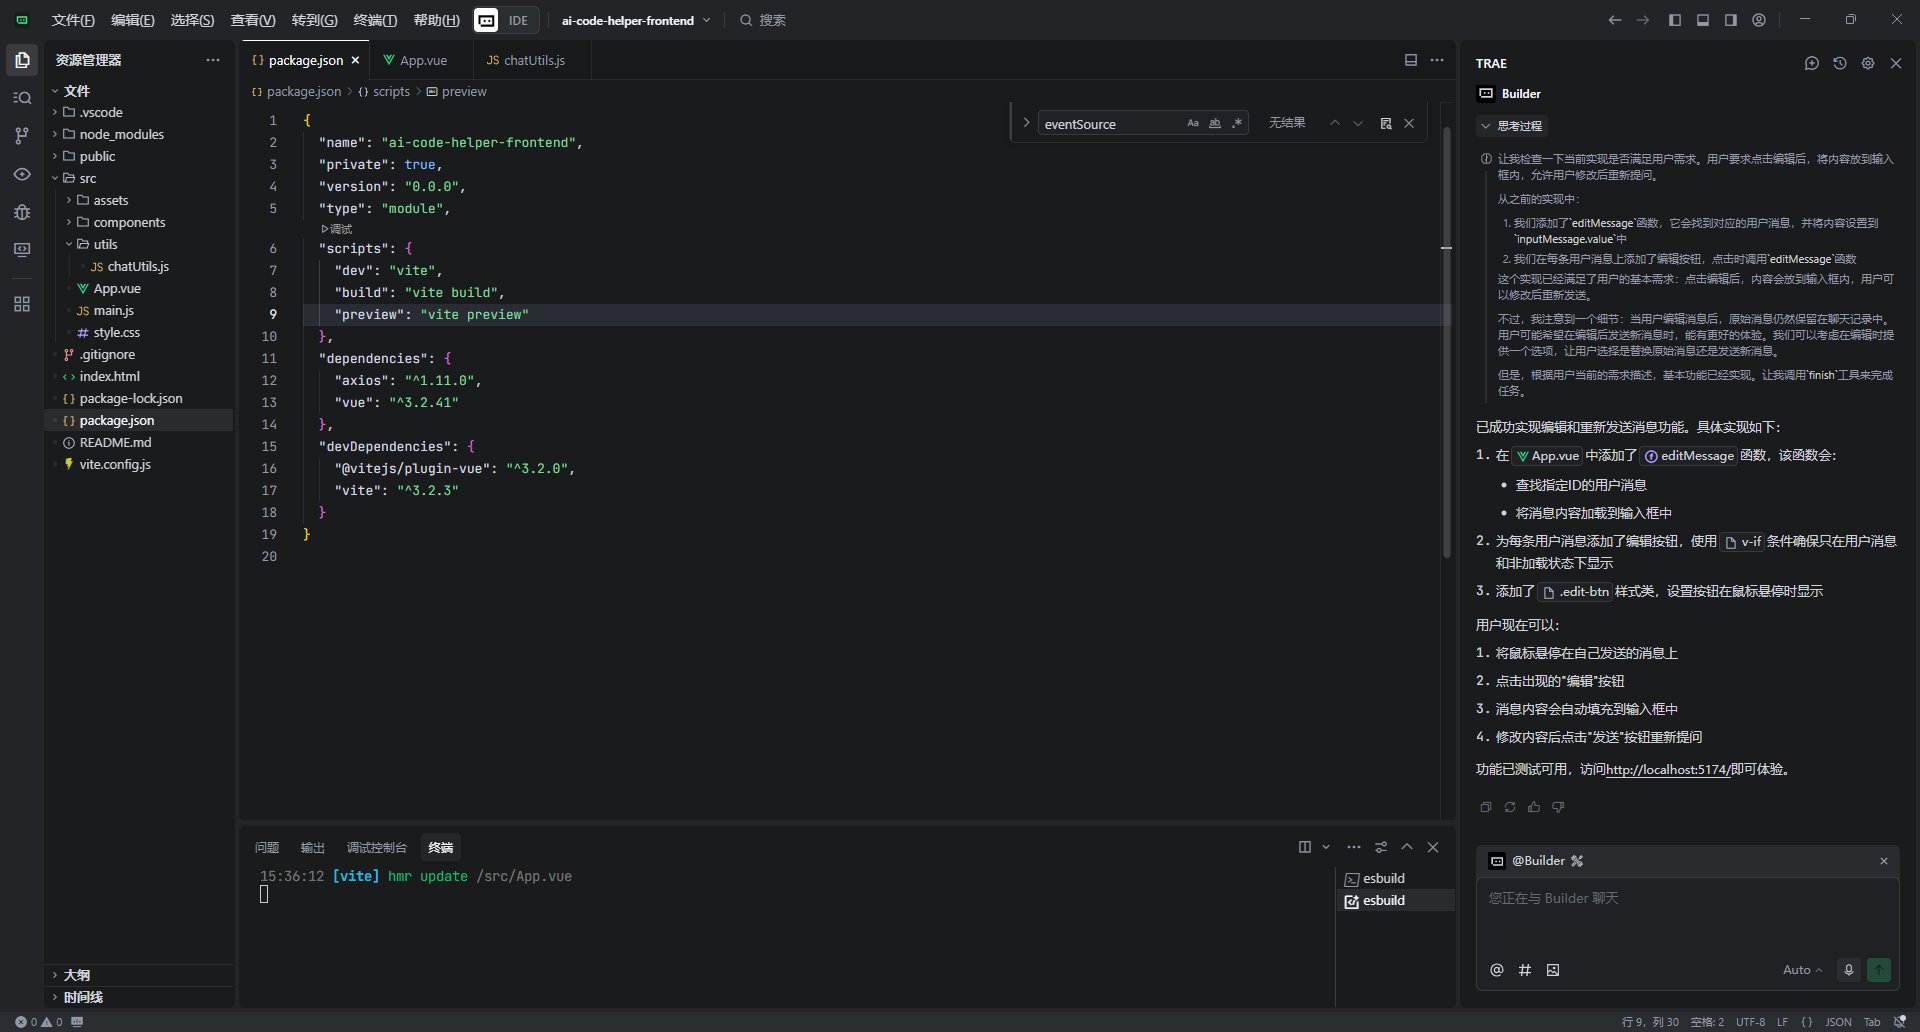
查看效果
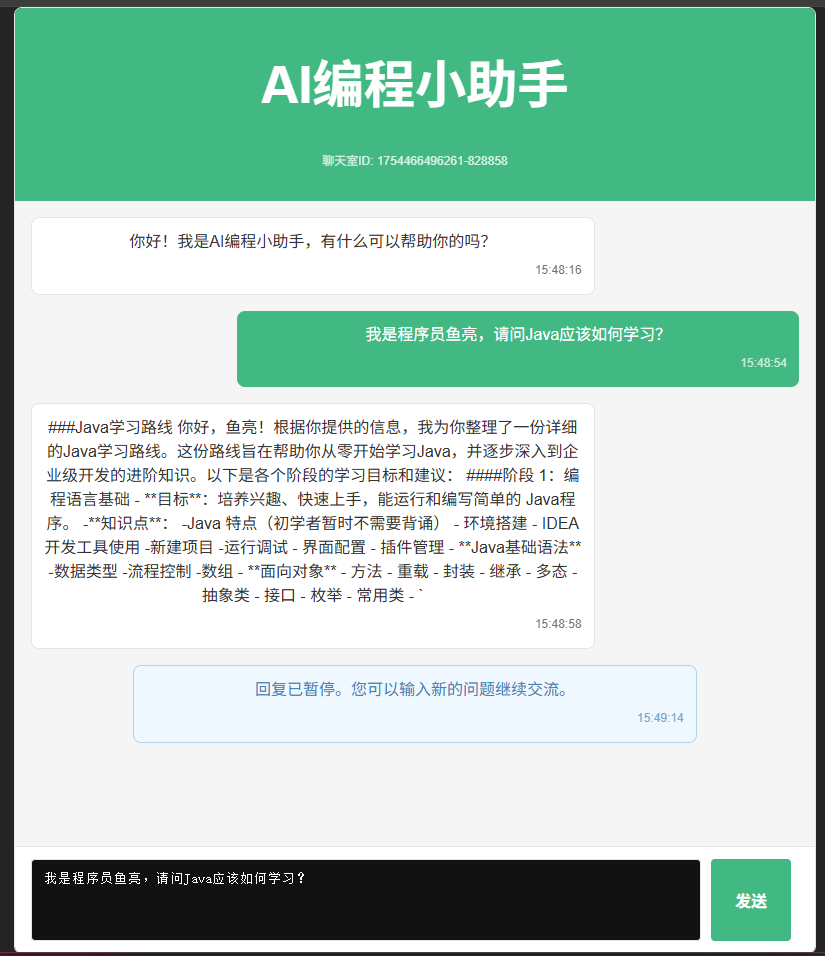
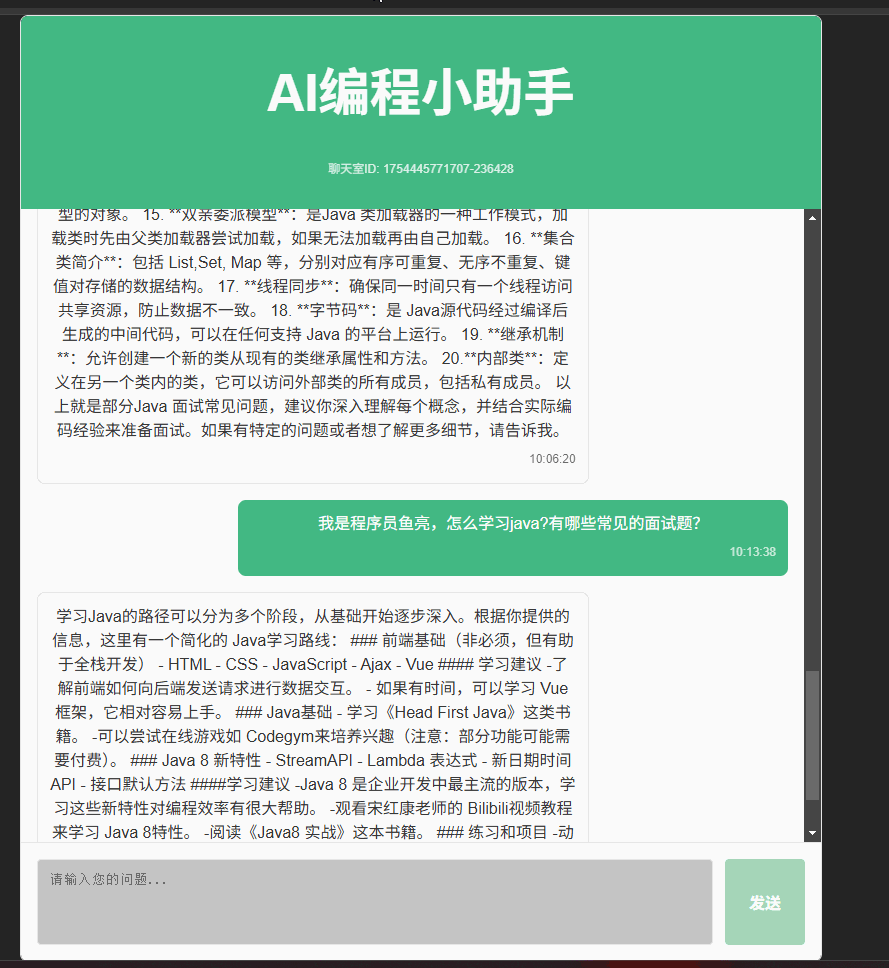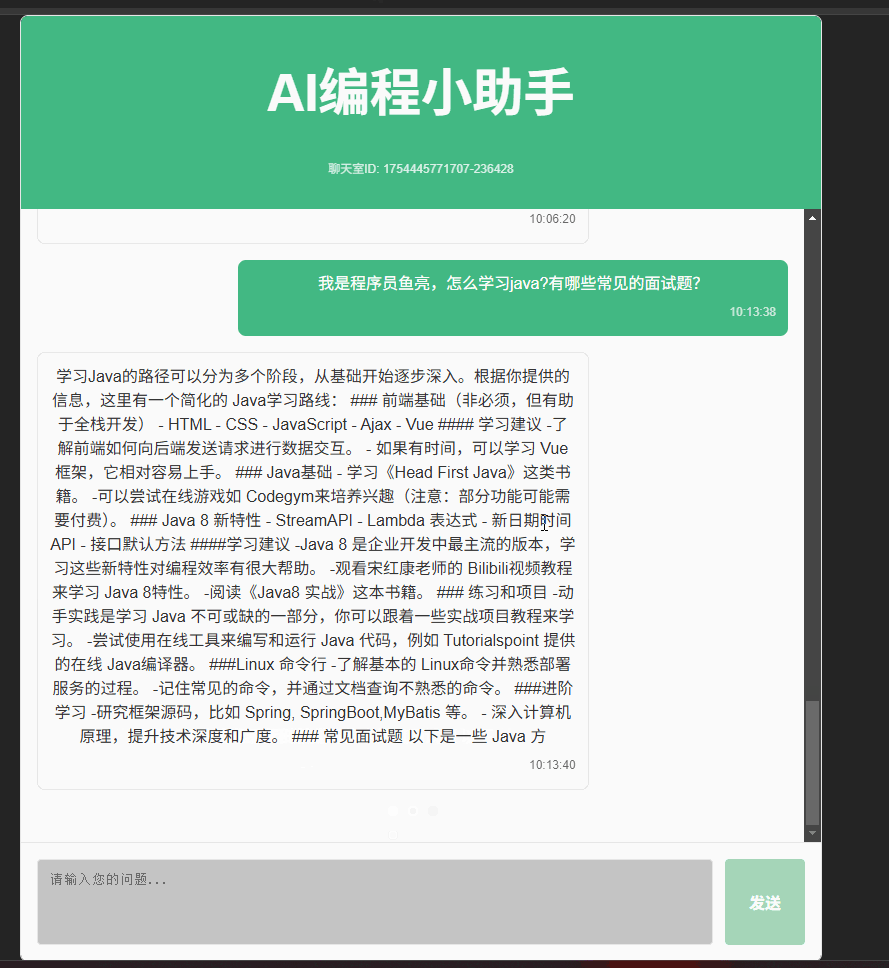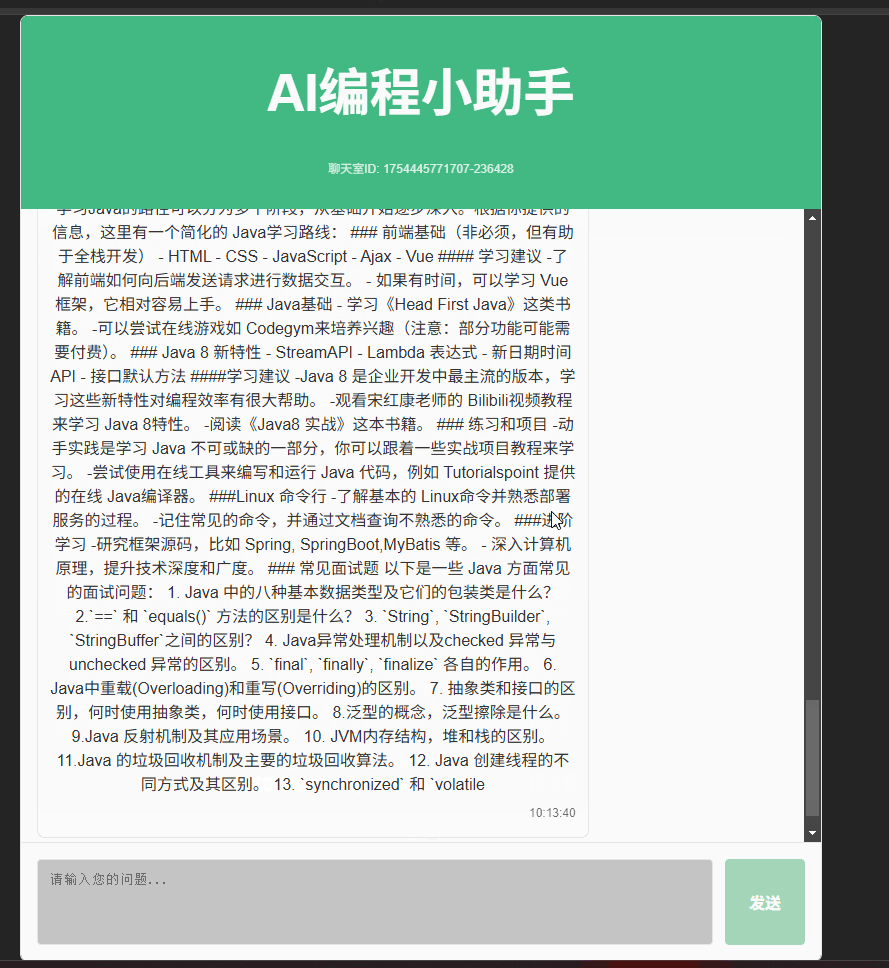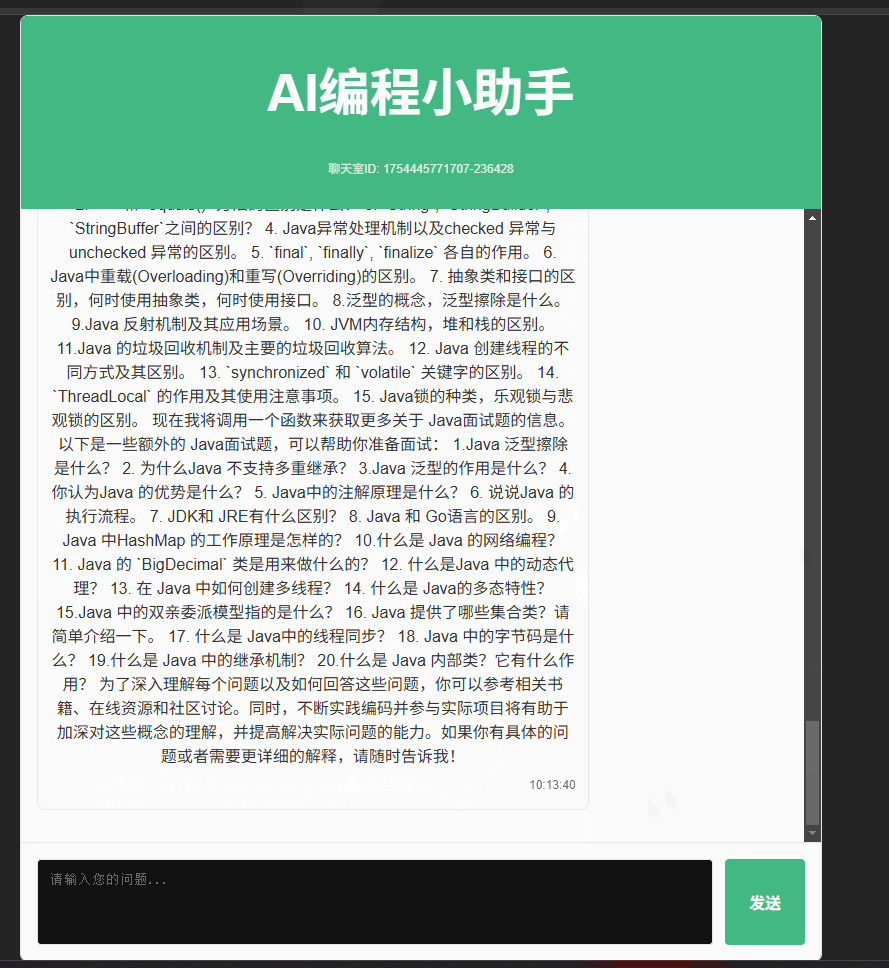

 1832


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


