


elasticsearch
集群部署
| 主机 | ip | 角色 |
| server1 | 192.168.247.132 | elasticsearch |
| server2 | 192.168.247.133 | elasticsearch |
| server3 | 192.168.247.134 | elasticsearch |
| server4 | 192.168.247.135 | cerebro kibana |
| server5 | 192.168.247.136 | logstash |
软件安装
[root@server1 ~]# rpm -ivh elasticsearch-7.6.1-x86_64.rpm
修改配置
[root@server1 ~]# cd /etc/elasticsearch/
[root@server1 elasticsearch]# vim elasticsearch.yml
cluster.name: my-es
path.data: /var/lib/elasticsearch
path.logs: /var/log/elasticsearch
bootstrap.memory_lock: true
network.host: 0.0.0.0
http.port: 9200
discovery.seed_hosts: ["server1", "server2", "server3"]
cluster.initial_master_nodes: ["server1", "server2", "server3"]
系统设置
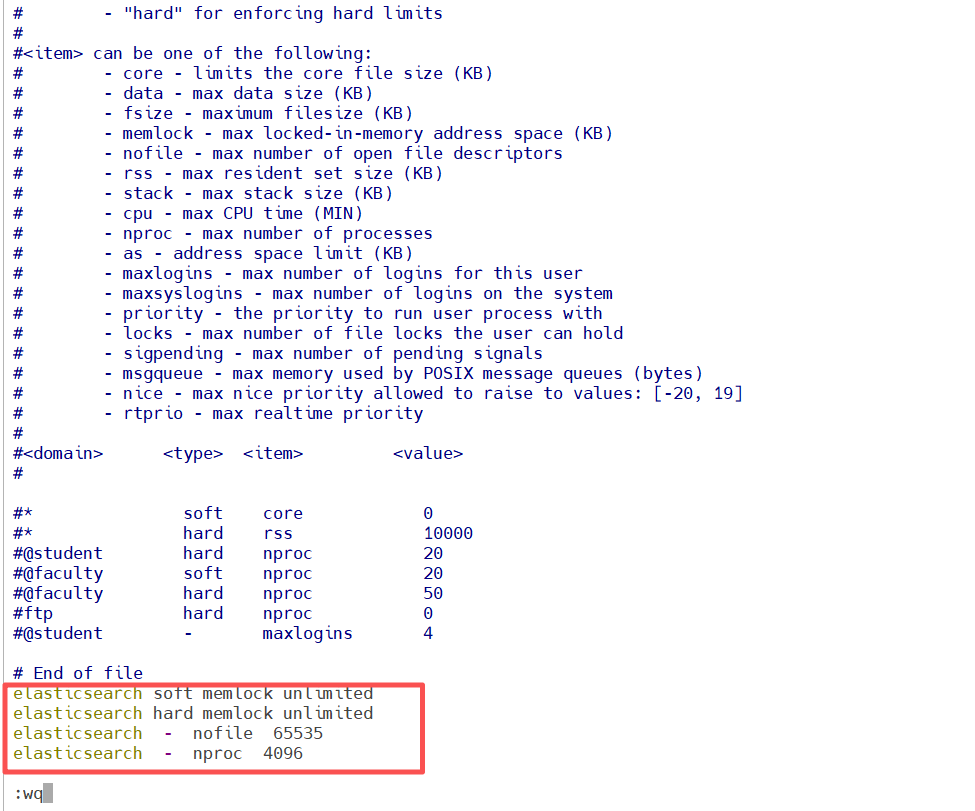
[root@server1 elasticsearch]# vim /etc/security/limits.conf
elasticsearch soft memlock unlimited
elasticsearch hard memlock unlimited
elasticsearch - nofile 65535
elasticsearch - nproc 4096
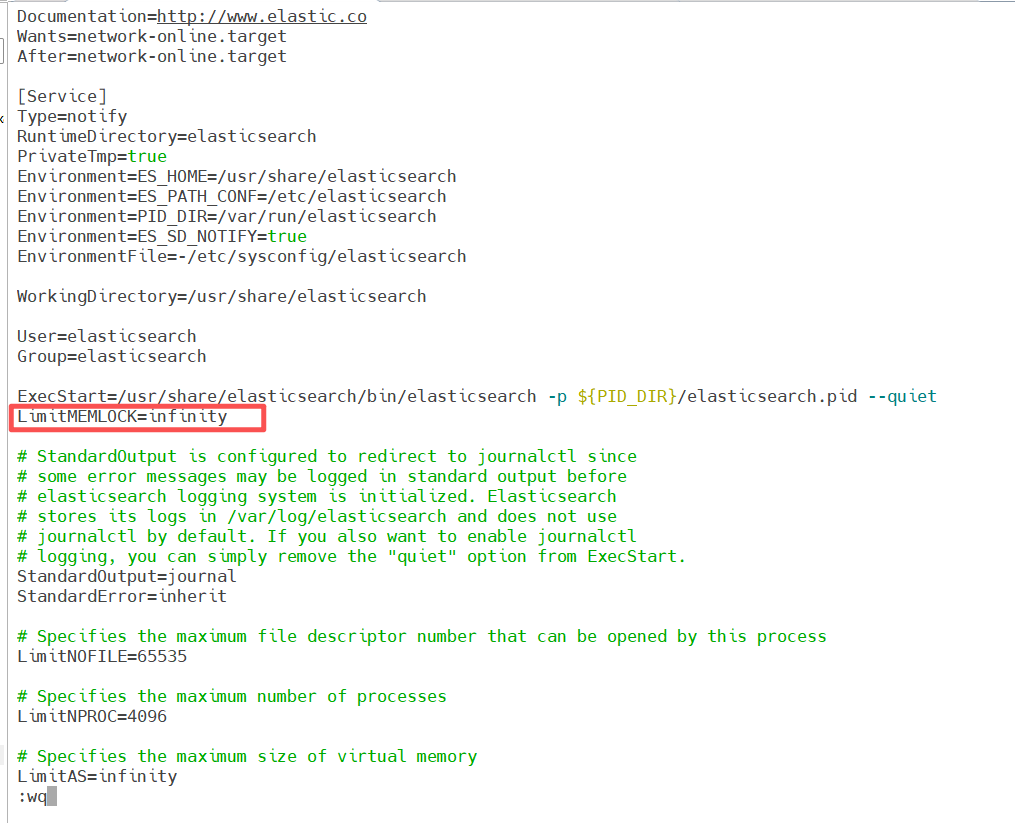
[root@server1 elasticsearch]# vim /usr/lib/systemd/system/elasticsearch.service
[service]
...
LimitMEMLOCK=infinity
[root@server1 elasticsearch]# systemctl daemon-reload
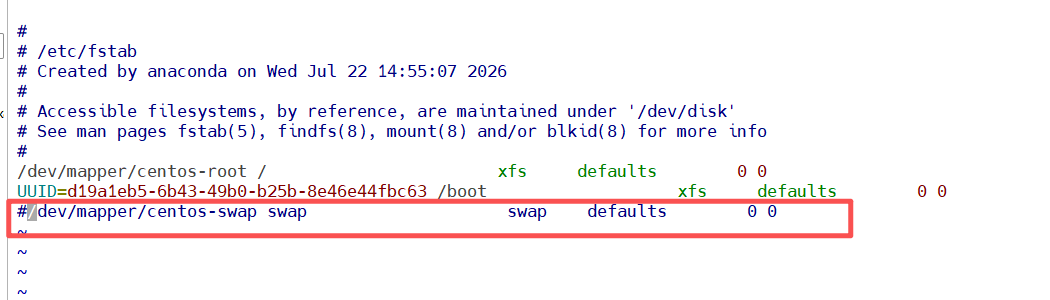
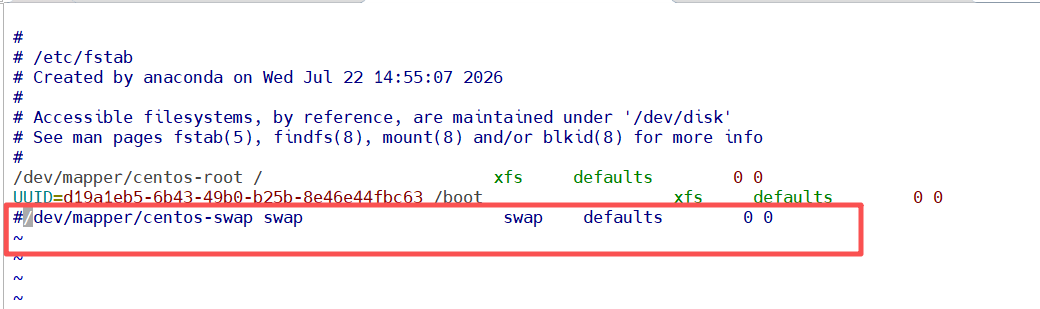
[root@server1 elasticsearch]# swapoff -a
[root@server1 elasticsearch]# vim /etc/fstab
[root@server1 elasticsearch]# systemctl daemon-reload
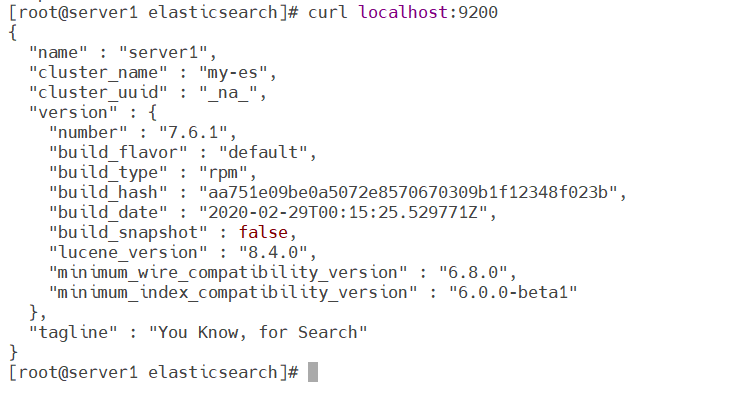
[root@server1 elasticsearch]# systemctl enable --now elasticsearch
配置复制到server2和server3
server2和server3软件安装
[root@server2 ~]# rpm -ivh elasticsearch-7.6.1-x86_64.rpm
[root@server3 ~]# rpm -ivh elasticsearch-7.6.1-x86_64.rpm
配置ssh免密
[root@server1 elasticsearch]# ssh-keygen
[root@server1 elasticsearch]# ssh-copy-id server2
[root@server1 elasticsearch]# ssh-copy-id server3
从server1复制配置
[root@server1 ~]# cd /etc/elasticsearch/
[root@server1 elasticsearch]# scp elasticsearch.yml server2:/etc/elasticsearch/
[root@server1 elasticsearch]# scp elasticsearch.yml server3:/etc/elasticsearch/
[root@server1 elasticsearch]# scp /etc/security/limits.conf server2:/etc/security/
[root@server1 elasticsearch]# scp /etc/security/limits.conf server3:/etc/security/
[root@server1 elasticsearch]# scp /usr/lib/systemd/system/elasticsearch.service server2:/usr/lib/systemd/system/
[root@server1 elasticsearch]# scp /usr/lib/systemd/system/elasticsearch.service server3:/usr/lib/systemd/system/
server2和server3启动服务
[root@server2 ~]# swapoff -a
[root@server2 ~]# vim /etc/fstab
[root@server2 ~]# systemctl daemon-reload
[root@server2 ~]# systemctl enable --now elasticsearch
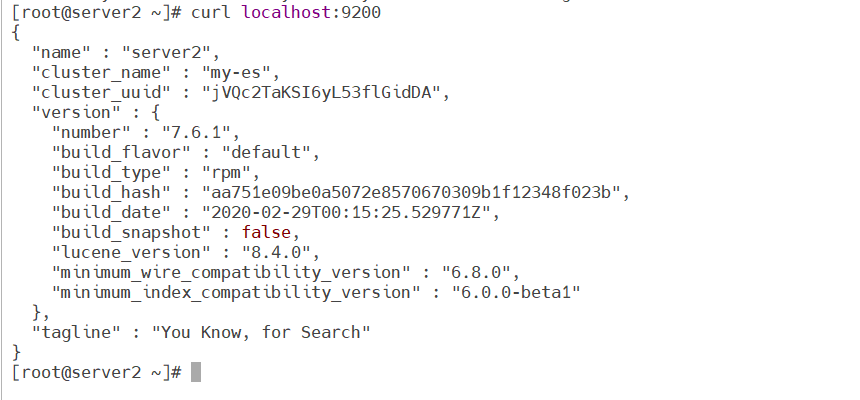
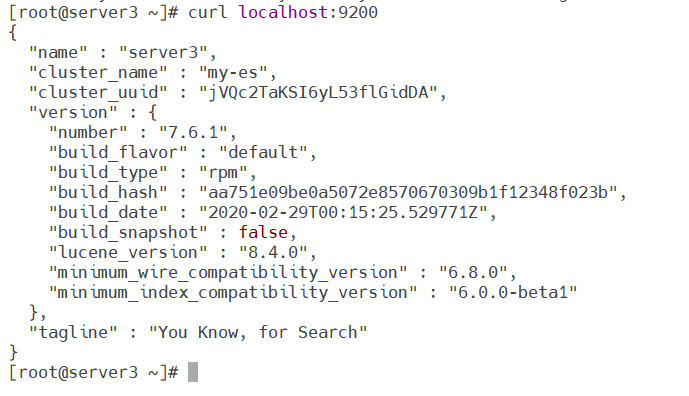
server3同理
cerebro部署
配置docker镜像源
[root@server4 ~]# cd /etc/yum.repos.d/
[root@server4 yum.repos.d]# wget https://mirrors.aliyun.com/docker-ce/linux/centos/docker-ce.repo
安装并启动docker
[root@server4 ~]# yum install -y docker-ce
[root@server4 ~]# systemctl enable --now docker
启动Cerebro 容器
[root@server4 ~]# docker load -i cerebro.tar
[root@server4 ~]# docker run -d --name cerebro -p 9000:9000 lmenezes/cerebro
访问网页http://192.168.247.135:9000/
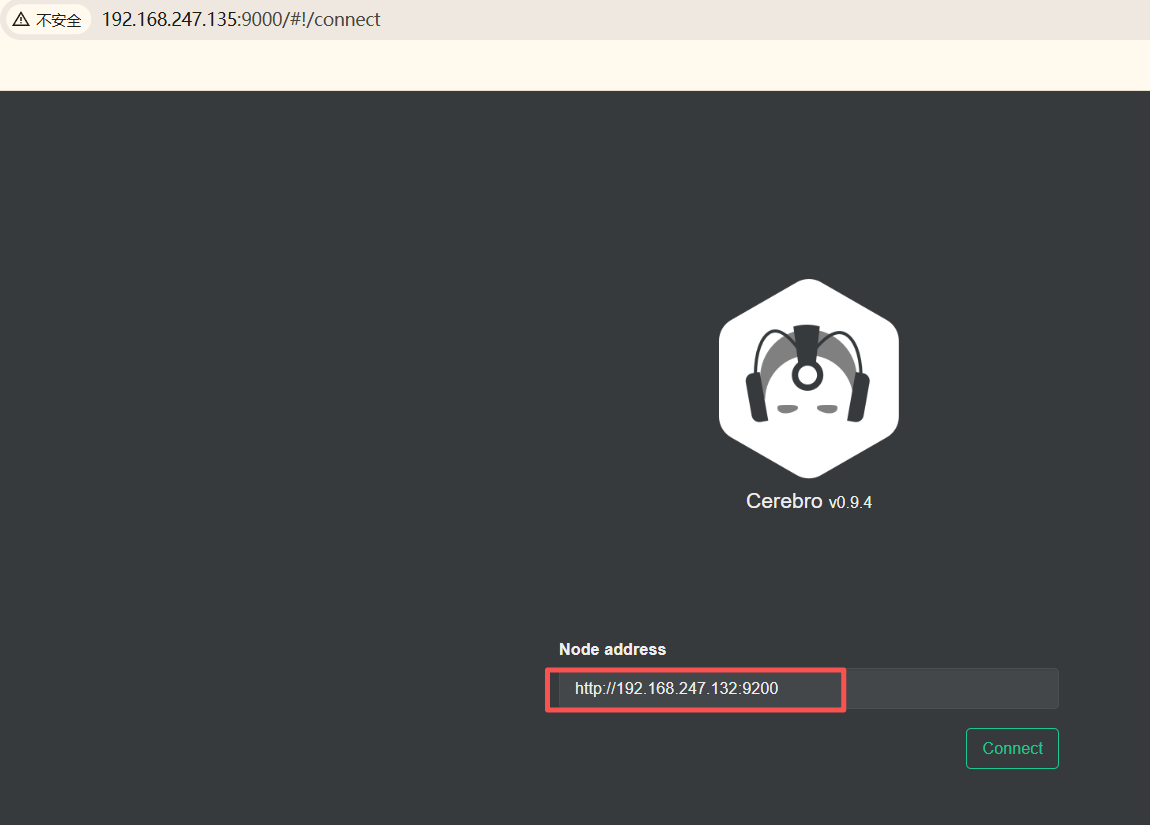
节点地址可以填写任意ES集群节点ip
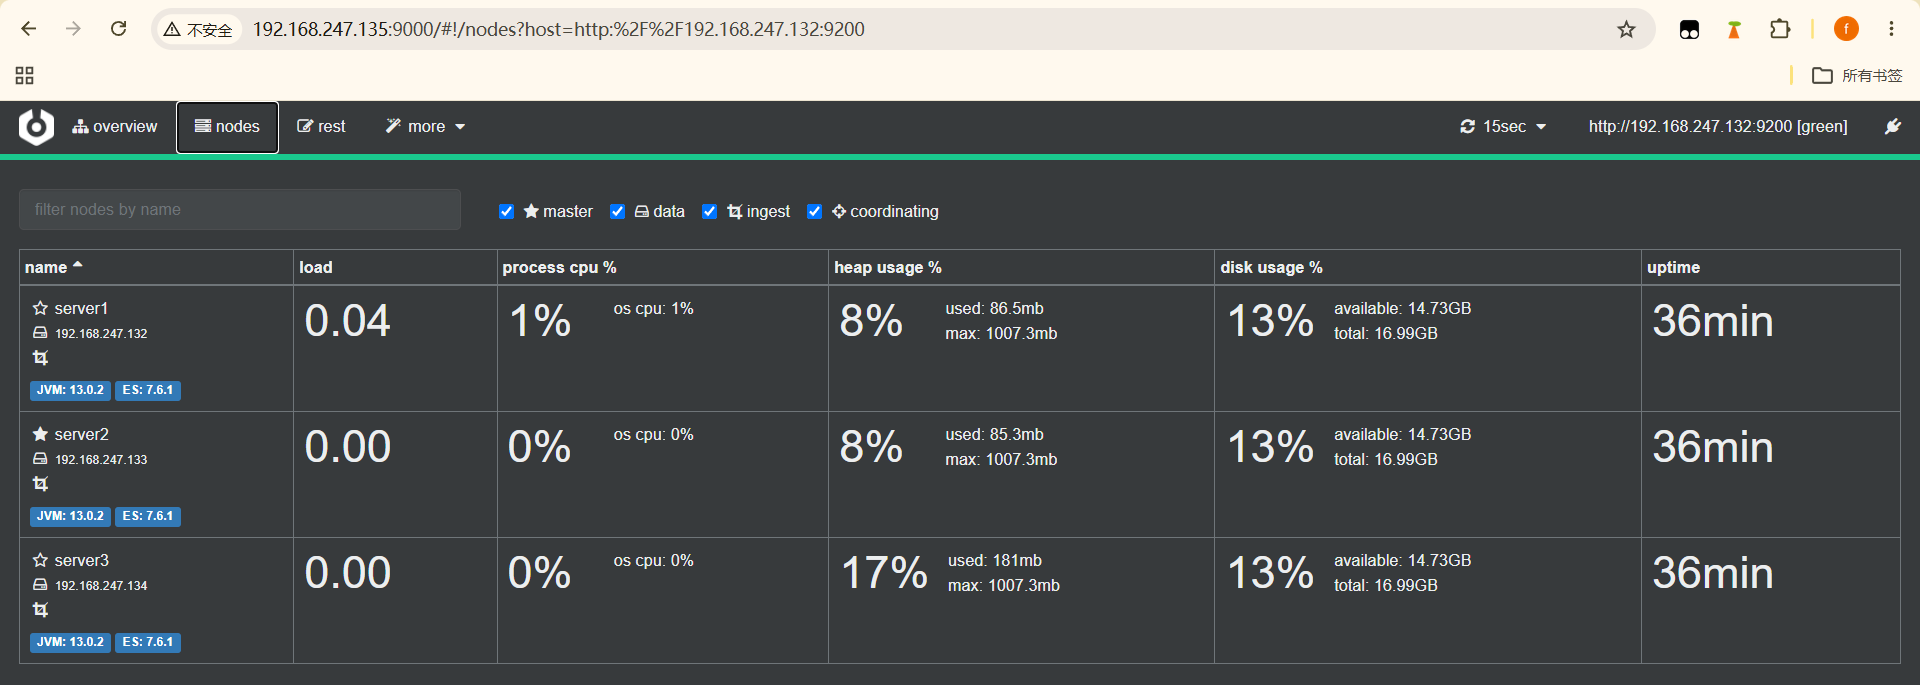
elasticsearch集群角色分类
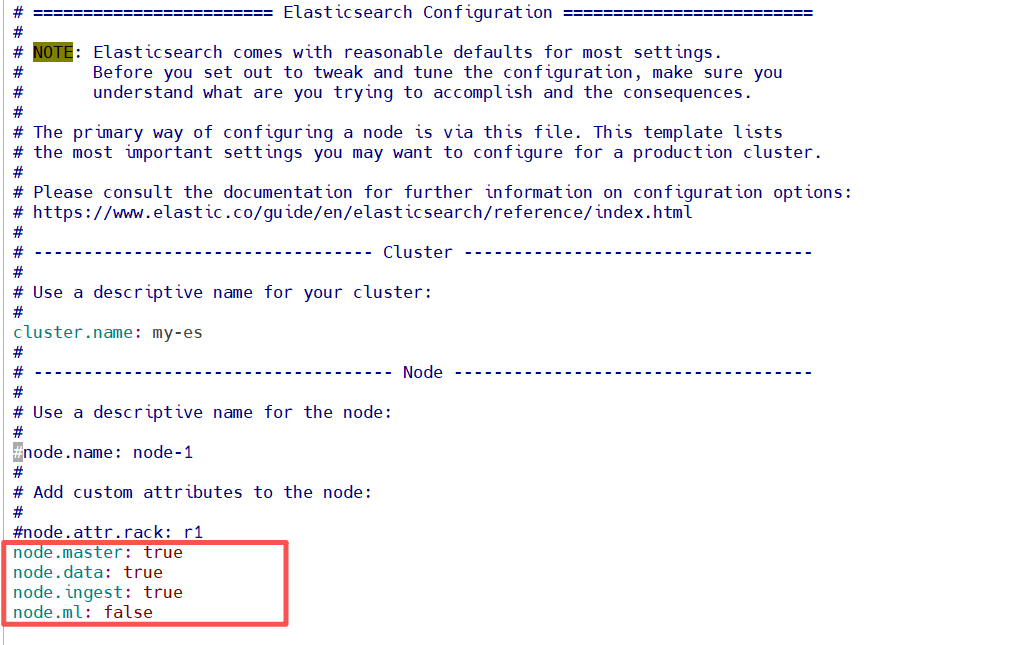
[root@server1 ~]# vim /etc/elasticsearch/elasticsearch.yml
node.master: true
node.data: true
node.ingest: true
node.ml: false
[root@server1 elasticsearch]# systemctl restart elasticsearch.service
[root@server2 ~]# vim /etc/elasticsearch/elasticsearch.yml
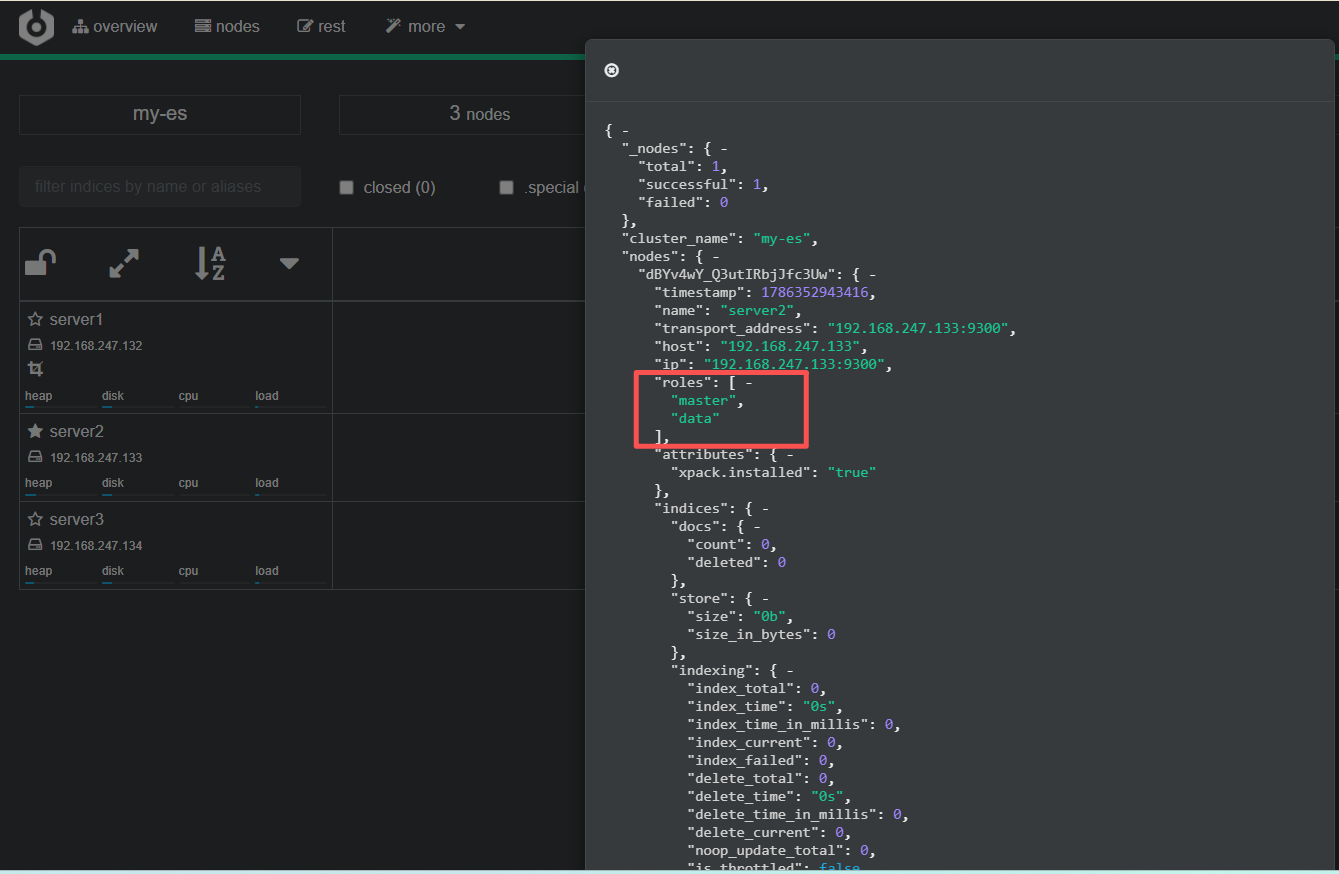
node.master: true
node.data: true
node.ingest: false
node.ml: false
[root@server2 ~]# systemctl restart elasticsearch.service
[root@server3 ~]# vim /etc/elasticsearch/elasticsearch.yml
node.master: true
node.data: true
node.ingest: false
node.ml: false
[root@server3 ~]# systemctl restart elasticsearch.service
logstash
部署
[root@server5 ~]# yum install -y jdk-11.0.15_linux-x64_bin.rpm
[root@server5 ~]# yum install -y logstash-7.6.1.rpm
elasticsearch输出插件
[root@server5 ~]# cd /etc/logstash/conf.d/
[root@server5 conf.d]# vim test.conf
input {
stdin { }
}
output {
stdout {}
elasticsearch {
hosts => "192.168.247.132:9200"
index => "logstash-%{+YYYY.MM.dd}"
}
}
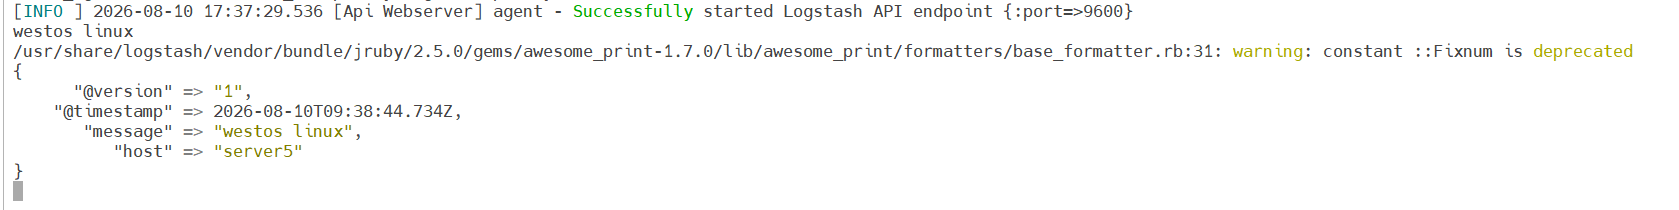
启动成功后录入数据,ctrl+c退出
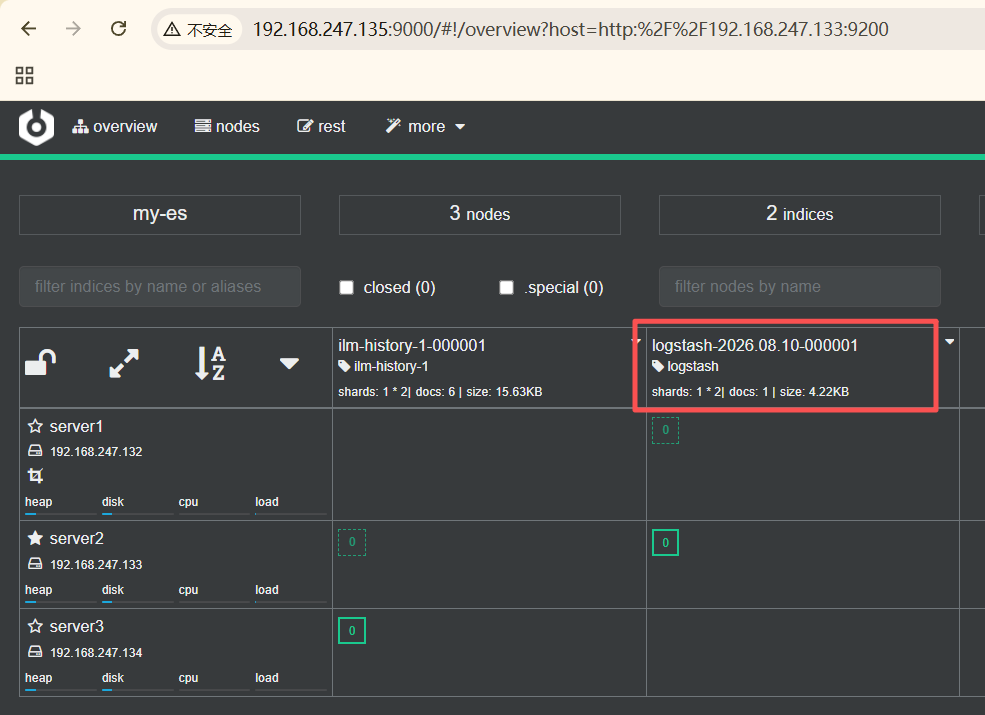
elasticsearch-head插件
安装依赖
[root@server4 ~]# yum install -y bzip2
[root@server4 ~]# tar jxf phantomjs-2.1.1-linux-x86_64.tar.bz2
[root@server4 ~]# cd phantomjs-2.1.1-linux-x86_64
[root@server4 phantomjs-2.1.1-linux-x86_64]# cp bin/phantomjs /usr/local/bin/
[root@server4 ~]# yum install -y fontconfig
安装插件
[root@server4 ~]# rpm -ivh nodejs-9.11.2-1nodesource.x86_64.rpm
[root@server4 ~]# yum install -y unzip
[root@server4 ~]# unzip elasticsearch-head-master.zip
[root@server4 ~]# cd elasticsearch-head-master/
[root@server4 elasticsearch-head-master]# npm install --registry=https://registry.npmmirror.com/
[root@server4 elasticsearch-head-master]# vim _site/app.js
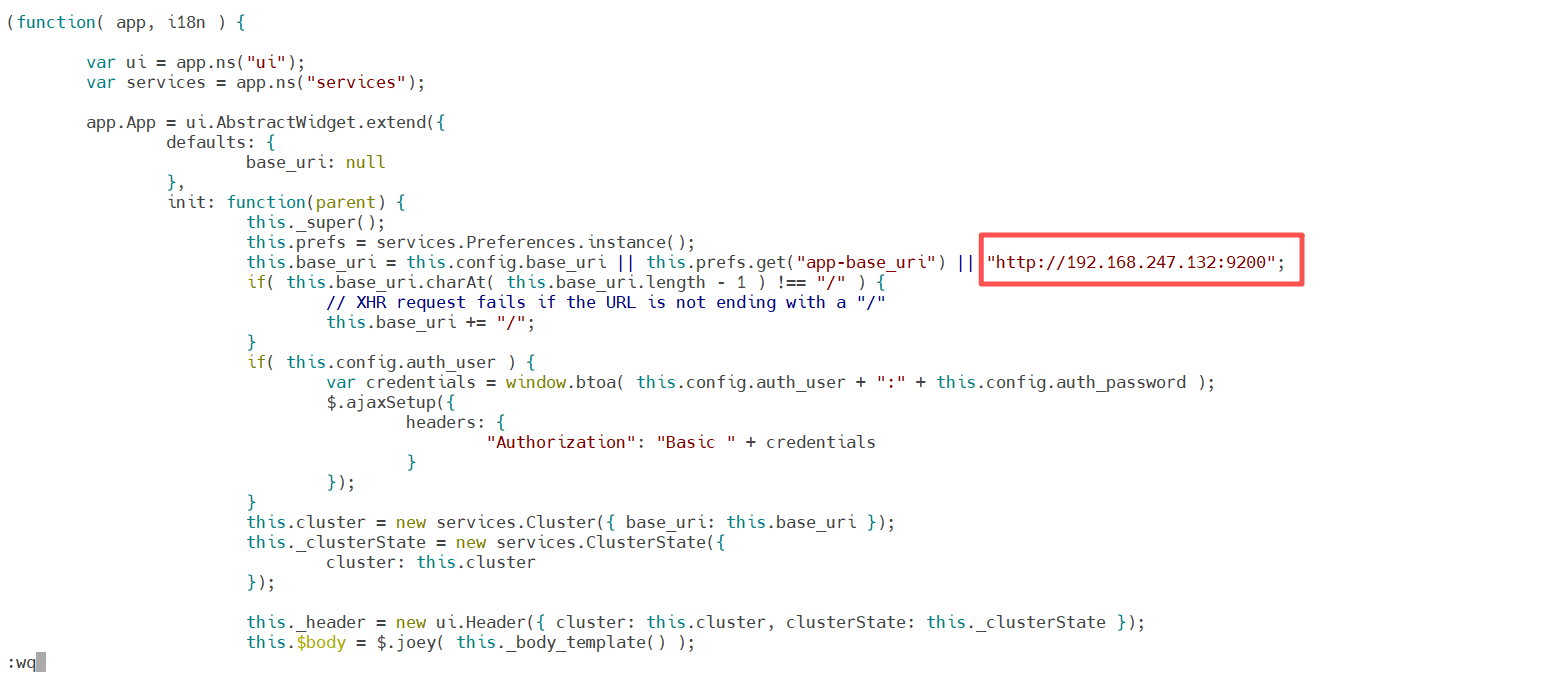
启动服务
[root@server4 elasticsearch-head-master]# npm run start &
修改es配置
[root@server1 ~]# vim /etc/elasticsearch/elasticsearch.yml
http.cors.enabled: true
http.cors.allow-origin: "*"
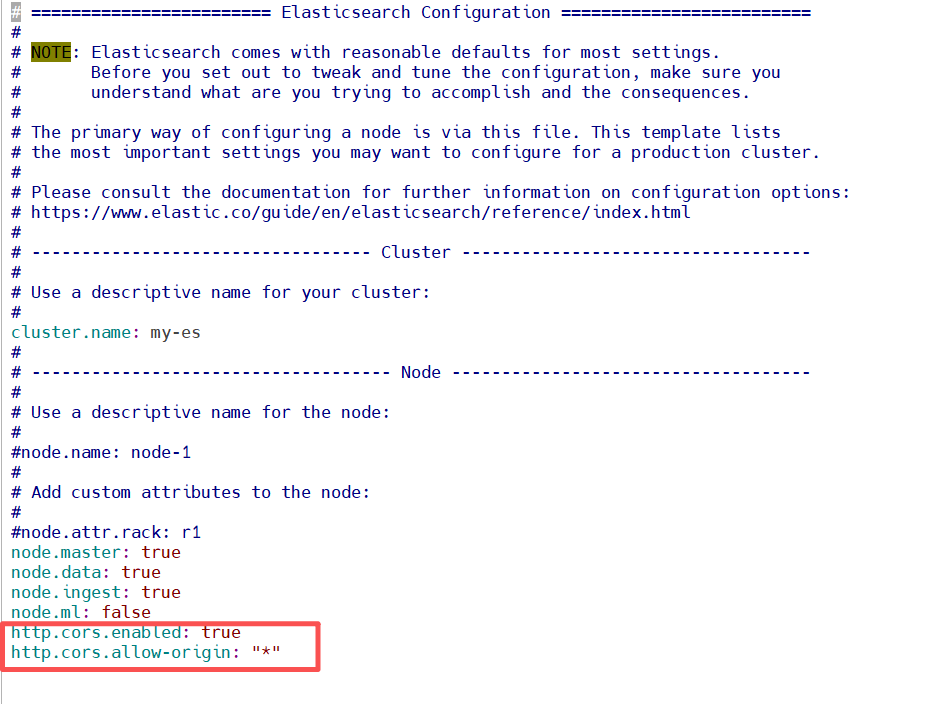
[root@server1 ~]# systemctl restart elasticsearch.service
访问:http://192.168.247.135:9100/
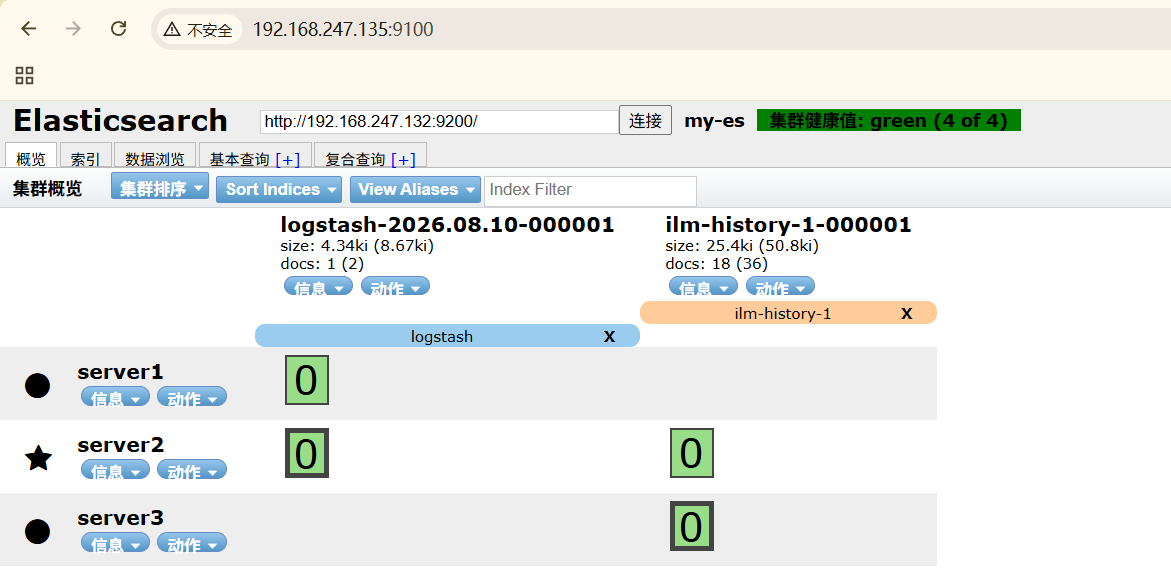
file输入插件
[root@server5 ~]# cd /etc/logstash/conf.d/
[root@server5 conf.d]# vim test.conf
input {
file {
path => "/var/log/messages"
start_position => "beginning"
}
}
output {
stdout {}
elasticsearch {
hosts => "192.168.247.132:9200"
index => "syslog-%{+YYYY.MM.dd}"
}
}
[root@server5 conf.d]# /usr/share/logstash/bin/logstash -f /etc/logstash/conf.d/test.conf
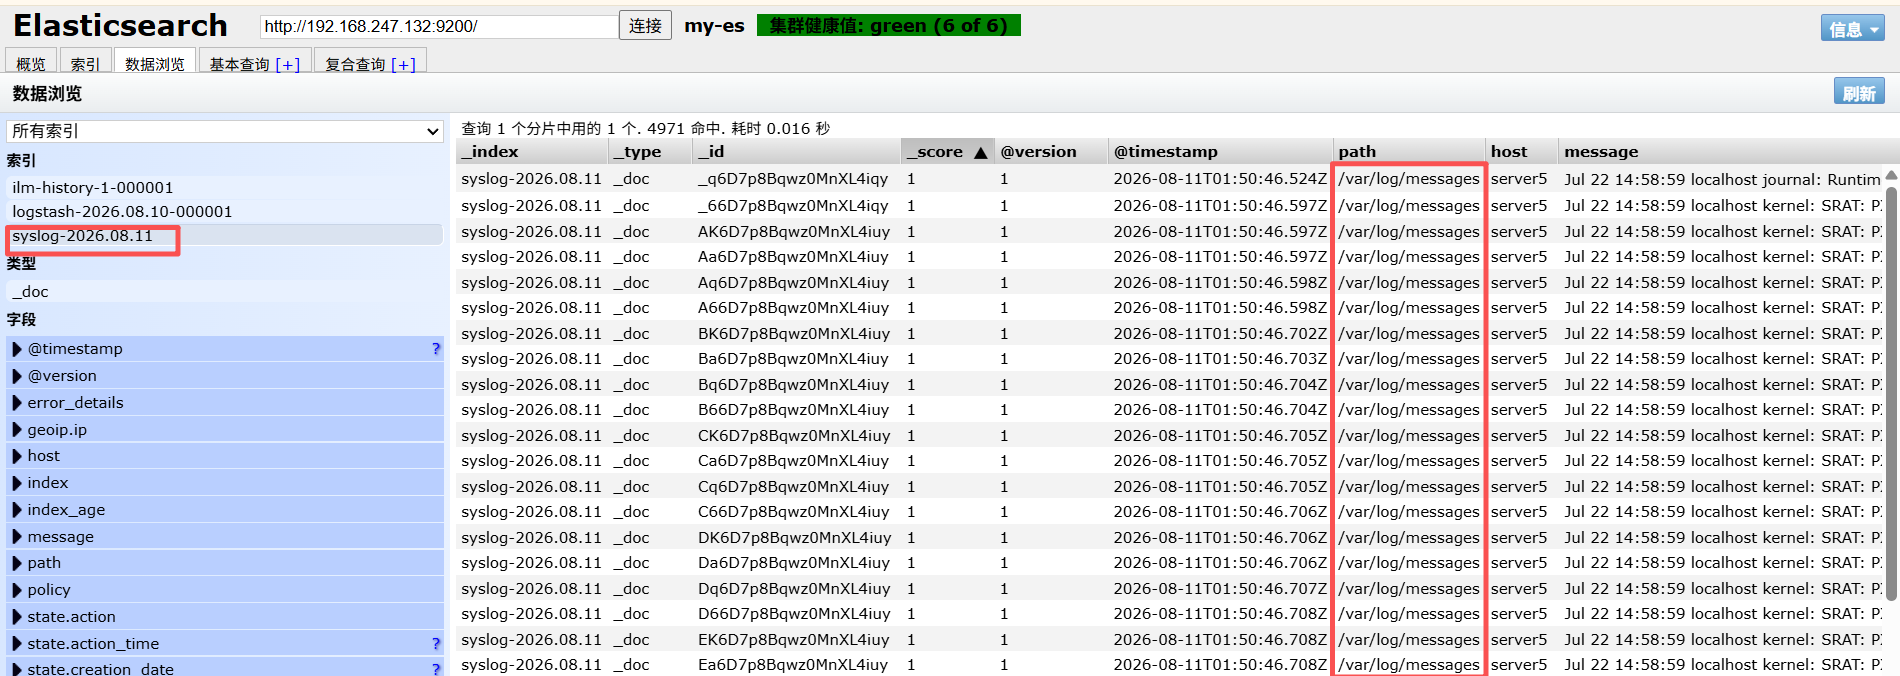
.sincedb文件保存文件读取进度,避免数据冗余读取
[root@server5 ~]# cd /usr/share/logstash/data/plugins/inputs/file
[root@server5 file]# l.
. .. .sincedb_452905a167cf4509fd08acb964fdb20c
[root@server5 file]# ls -i /var/log/messages
17342384 /var/log/messages
sincedb文件一共6个字段
- inode编号
- 文件系统的主要设备号
- 文件系统的次要设备号
- 文件中的当前字节偏移量
- 最后一个活动时间戳(浮点数)
- 与此记录匹配的最后一个已知路径
删除后重新读取
[root@server5 file]# rm -f .sincedb_452905a167cf4509fd08acb964fdb20c
syslog插件
logstash伪装成日志服务器
[root@server5 ~]# cd /etc/logstash/conf.d/
[root@server5 conf.d]# vim test.conf
input {
syslog{}
}
output {
stdout {}
elasticsearch {
hosts => "192.168.247.132:9200"
index => "syslog-%{+YYYY.MM.dd}"
}
}
配置客户端日志输出
[root@server1 ~]# vim /etc/rsyslog.conf
去掉以下行的注释
$ModLoad imtcp
$InputTCPServerRun 514
*.* @@192.168.247.136:514
[root@server1 ~]# systemctl restart rsyslog.service
[root@server5 file]# /usr/share/logstash/bin/logstash -f /etc/logstash/conf.d/test.conf
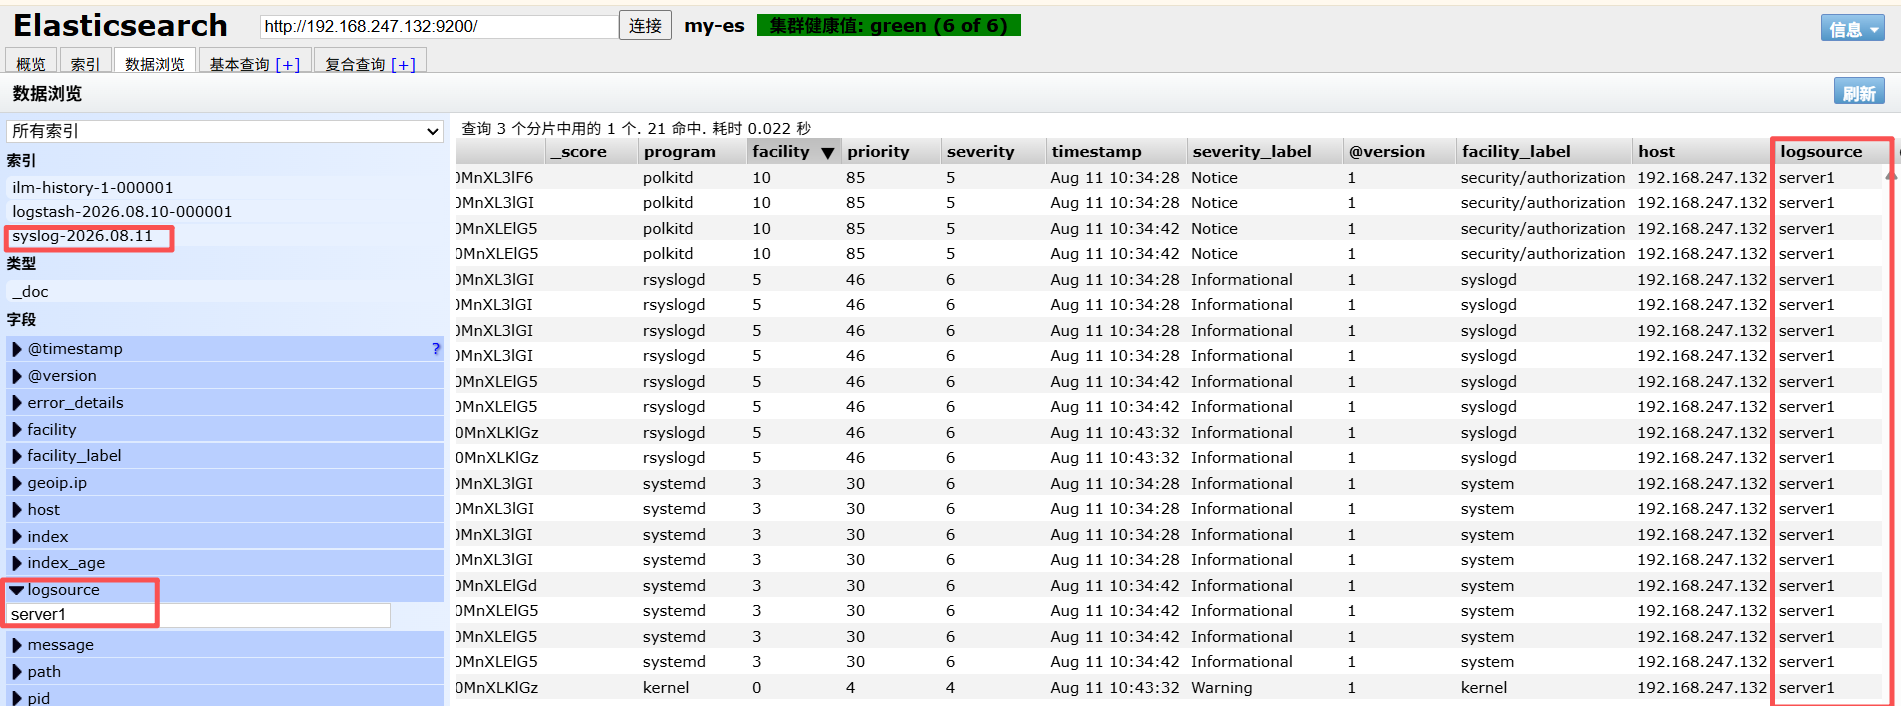
多行过滤插件
从server1拷贝模板
[root@server1 ~]# cd /var/log/elasticsearch/
[root@server1 elasticsearch]# scp my-es.log server5:/var/log/
[root@server5 ~]# cd /etc/logstash/conf.d/
[root@server5 conf.d]# vim test.conf
input {
file {
path => "/var/log/my-es.log"
start_position => "beginning"
codec => multiline {
pattern => "^\["
negate => true
what => previous
}
}
}
output {
stdout {}
elasticsearch {
hosts => "192.168.247.132:9200"
index => "myeslog-%{+YYYY.MM.dd}"
}
}
[root@server5 conf.d]# /usr/share/logstash/bin/logstash -f /etc/logstash/conf.d/test.conf
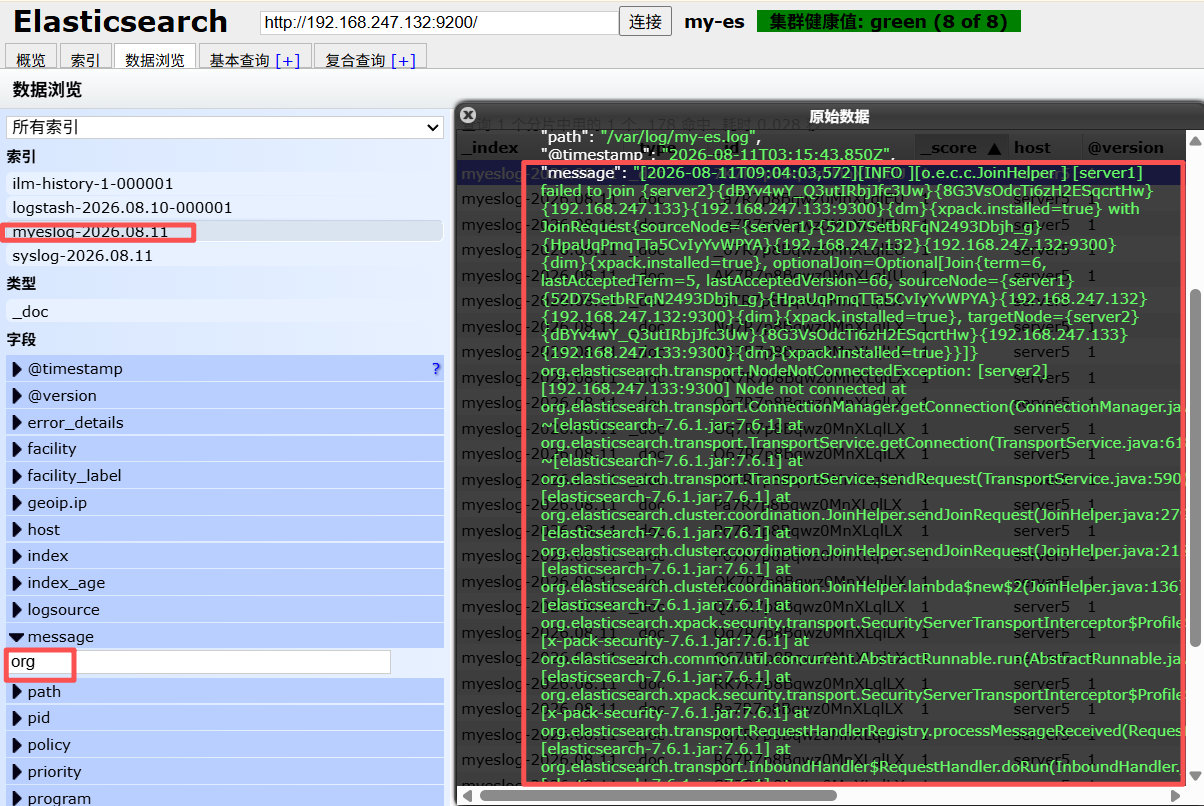
grok过滤
[root@server5 ~]# yum install -y httpd
[root@server5 ~]# systemctl enable --now httpd
[root@server5 ~]# echo www.westos.org > /var/www/html/index.htm
访问此站点生成日志信息
[root@server5 ~]# ab -c1 -n 300 http://192.168.247.136/index.html
[root@server5 ~]# cd /etc/logstash/conf.d/
[root@server5 conf.d]# vim grok.conf
input {
file {
path => "/var/log/httpd/access_log"
start_position => "beginning"
}
}
filter {
grok {
match => { "message" => "%{HTTPD_COMBINEDLOG}" }
}
}
output {
stdout {}
elasticsearch {
hosts => "192.168.247.132:9200"
index => "apachelog-%{+YYYY.MM.dd}"
}
}
[root@server5 conf.d]# /usr/share/logstash/bin/logstash -f /etc/logstash/conf.d/grok.conf
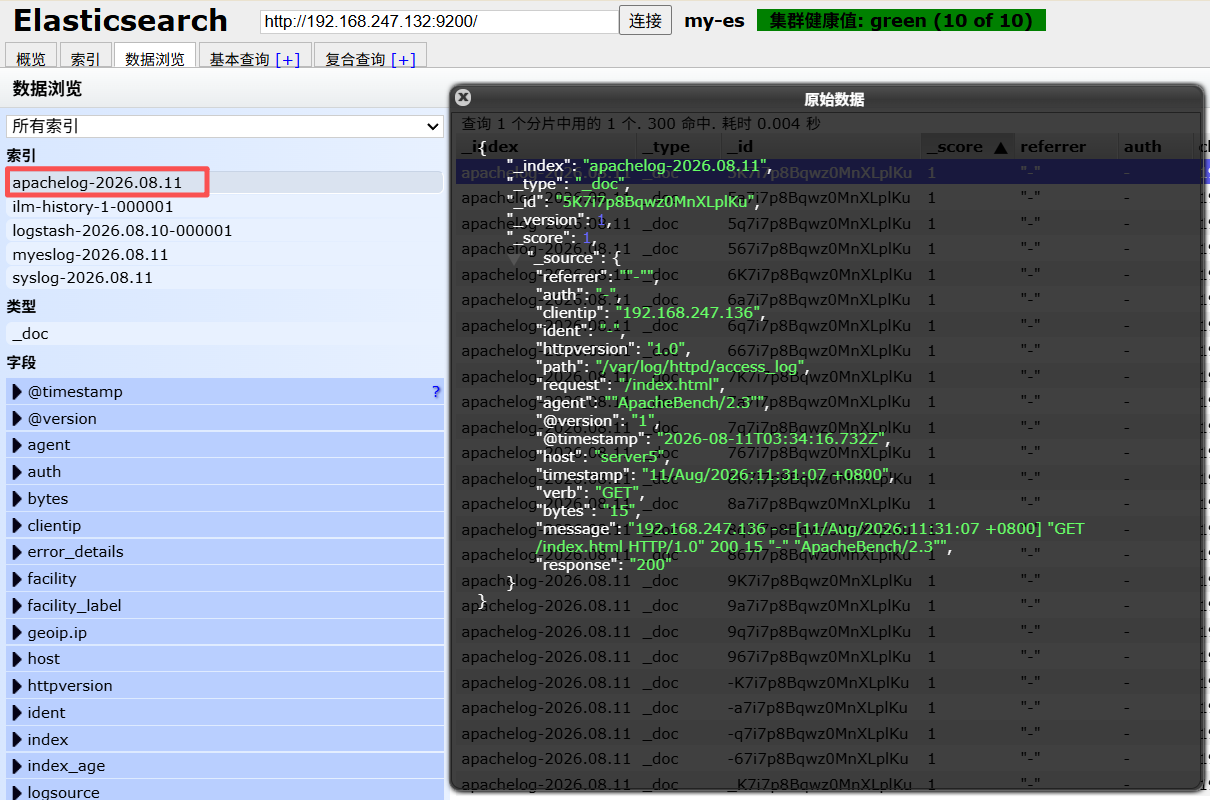
filebeat日志采集
filebeat 采集web 服务日志
[root@server4 ~]# yum install -y httpd
[root@server4 ~]# systemctl enable --now httpd
[root@server4 ~]# rpm -ivh filebeat-7.6.1-x86_64.rpm
[root@server4 ~]# cd /etc/filebeat/modules.d
[root@server4 modules.d]# filebeat modules enable apache #激活apache模块
[root@server4 modules.d]# vim apache.yml
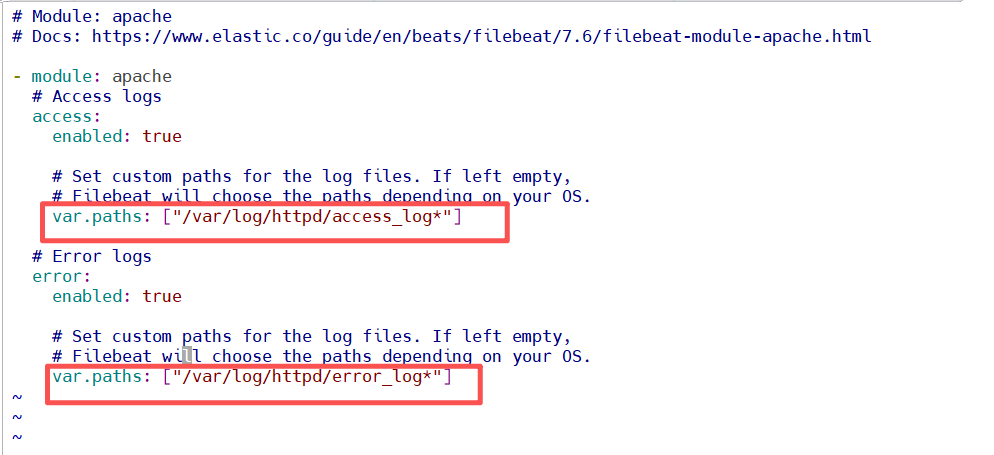
输出到ES
[root@server4 modules.d]# vim /etc/filebeat/filebeat.yml
output.elasticsearch:
# Array of hosts to connect to.
hosts: ["192.168.247.132:9200"]
检查配置文件语法
filebeat test config -c /etc/filebeat/filebeat.yml
测试与 ES 的连接
filebeat test output -c /etc/filebeat/filebeat.yml
启动 Filebeat
systemctl enable --now filebeat
输出到logstash
[root@server5 conf.d]# vim /etc/logstash/conf.d/beats.conf
input {
beats {
port => 5044
}
}
filter {
grok {
match => { "message" => "%{HTTPD_COMBINEDLOG}" }
}
}
output {
elasticsearch {
hosts => ["http://192.168.247.132:9200"]
index => "apachelog-%{+YYYY.MM.dd}"
}
}
启动logstash
[root@server5 conf.d]# /usr/share/logstash/bin/logstash -rf /etc/logstash/conf.d/beats.conf
修改filebeat输出
[root@server4 ~]# vim /etc/filebeat/filebeat.yml
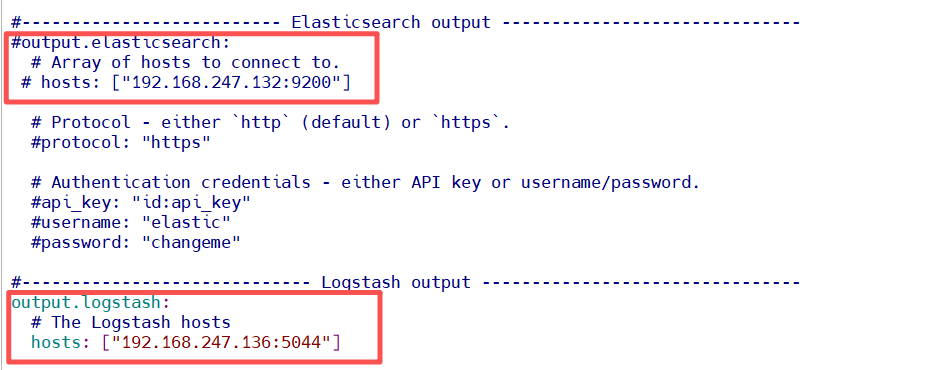
[root@server4 ~]# systemctl restart filebeat.service
kibana数据可视化
部署
[root@server4 ~]# rpm -ivh kibana-7.6.1-x86_64.rpm
[root@server4 ~]# cd /etc/kibana/
[root@server4 kibana]# vim kibana.yml
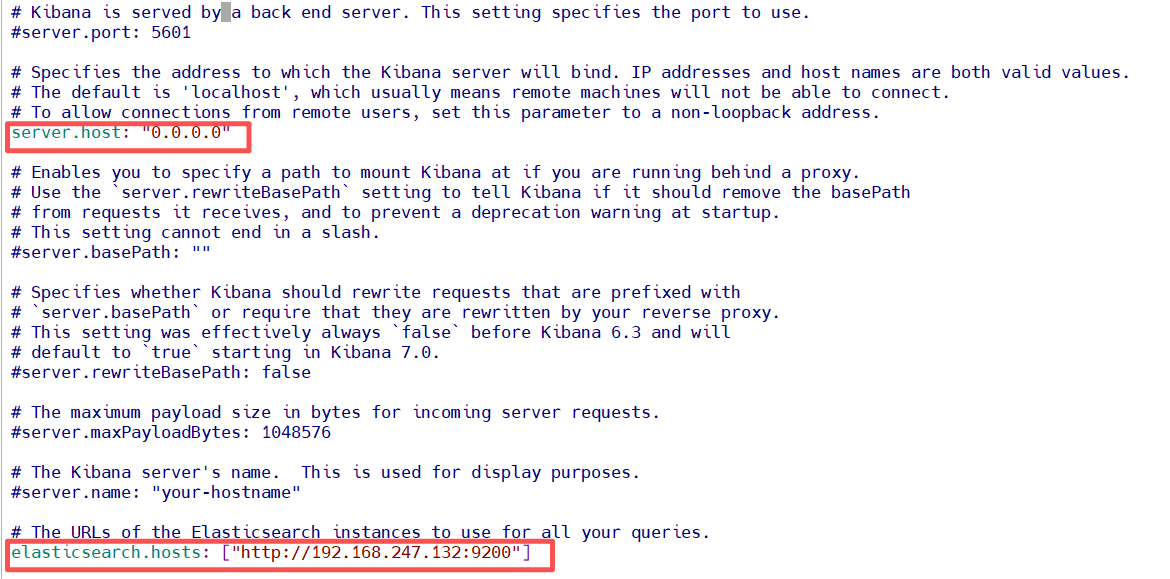

[root@server4 kibana]# systemctl enable --now kibana
[root@server4 kibana]# netstat -antlp |grep :5601

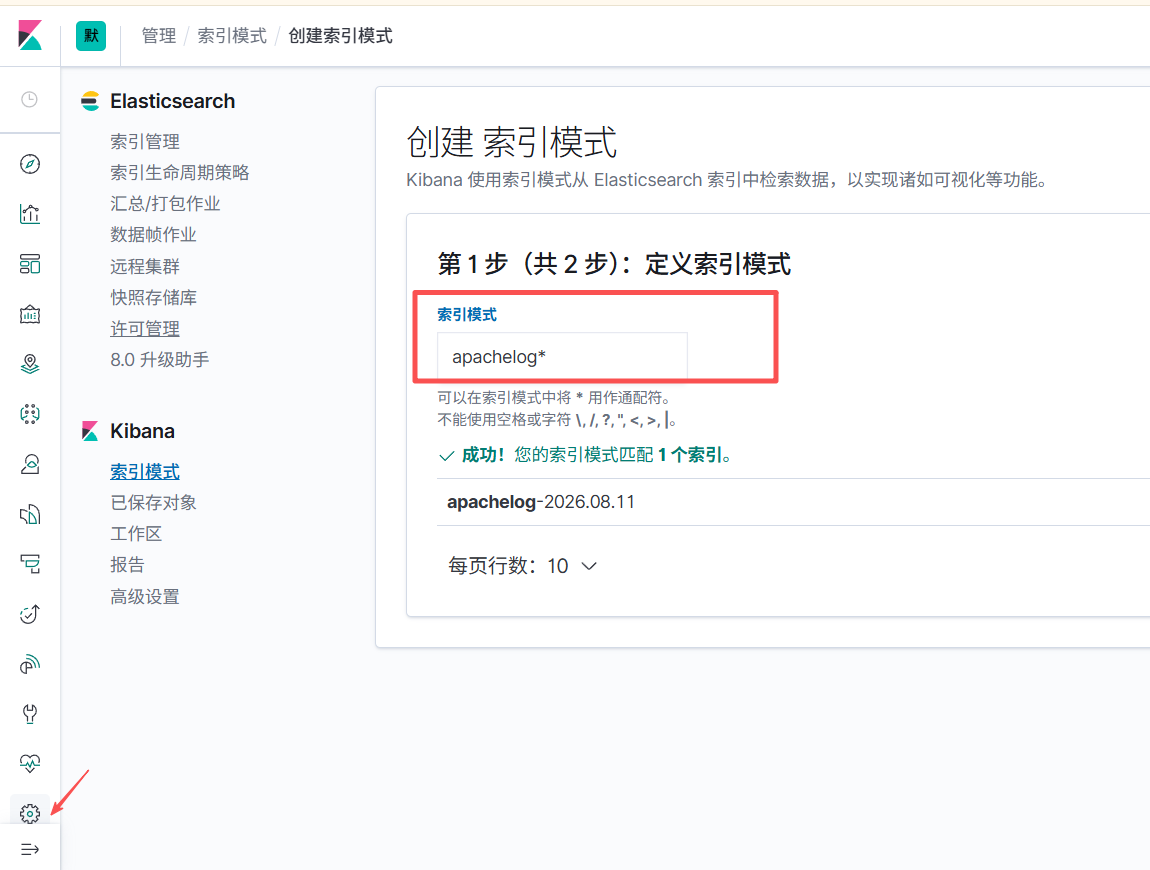
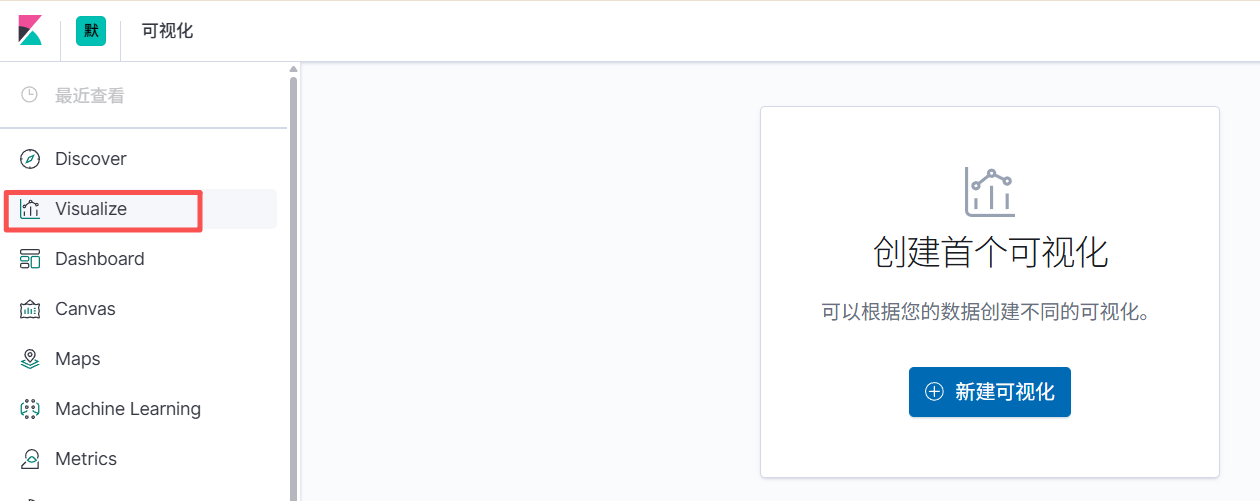
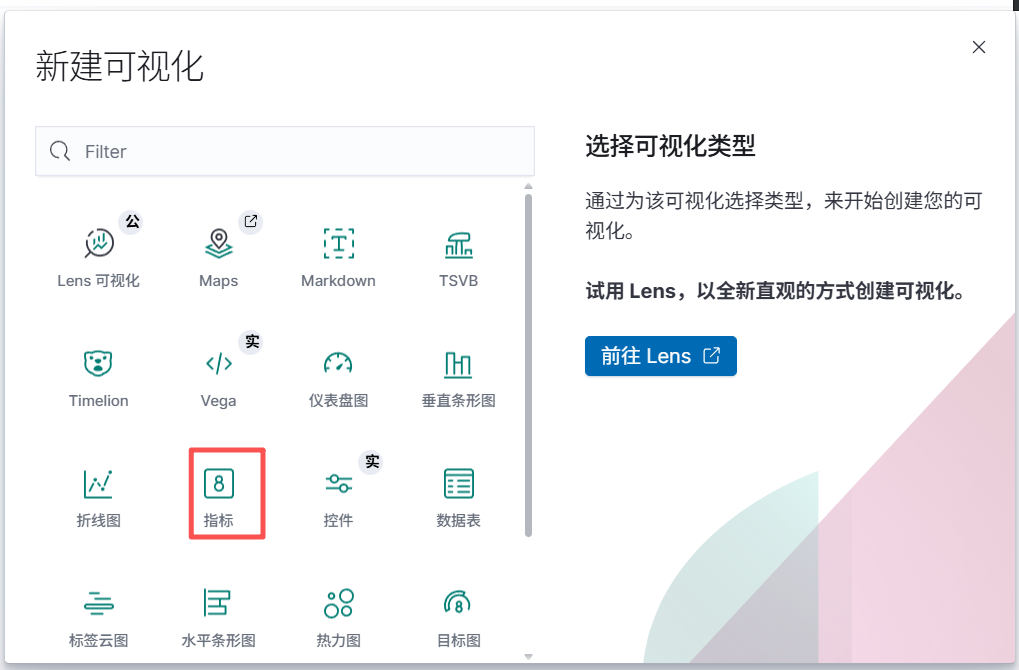
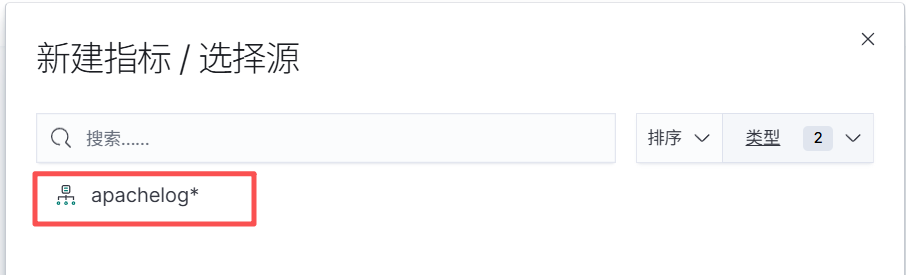
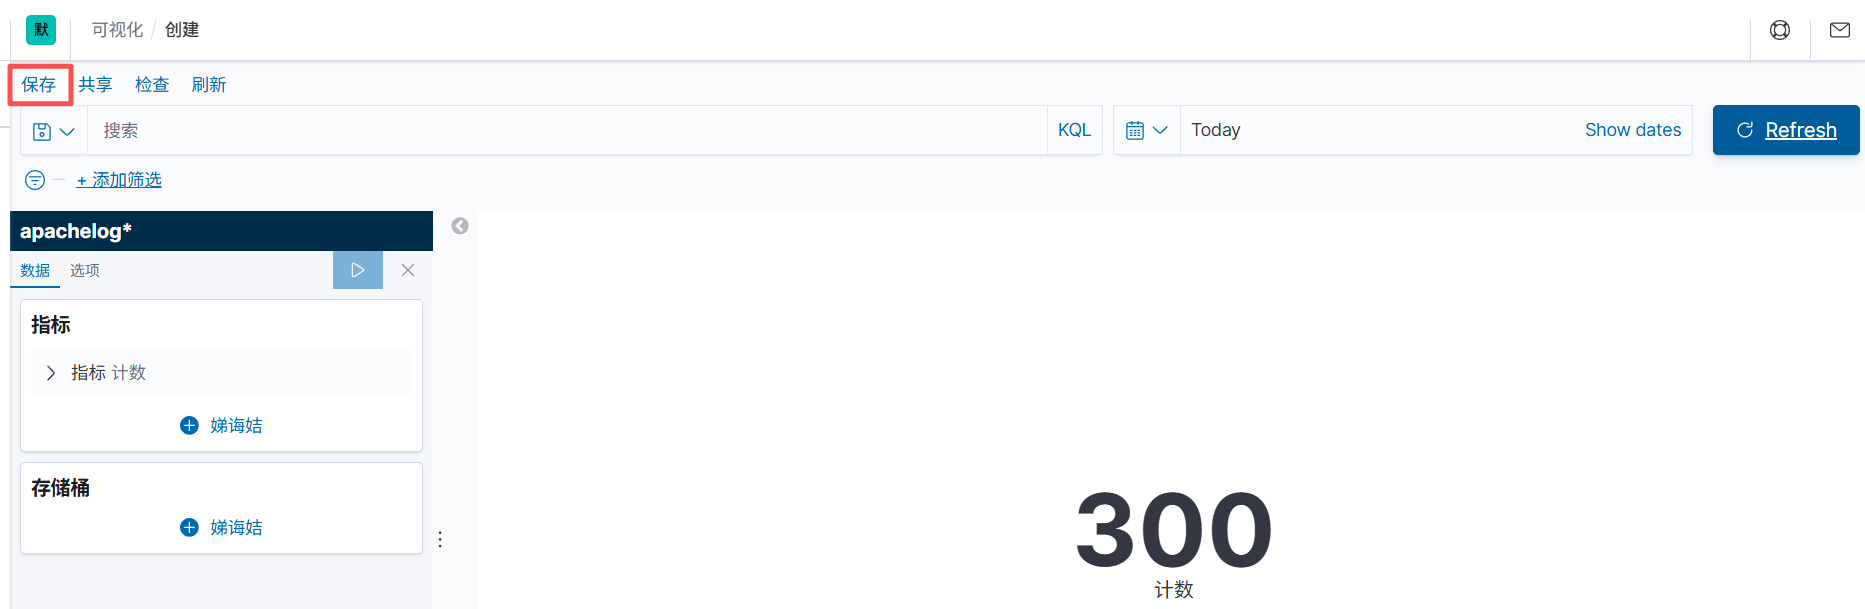
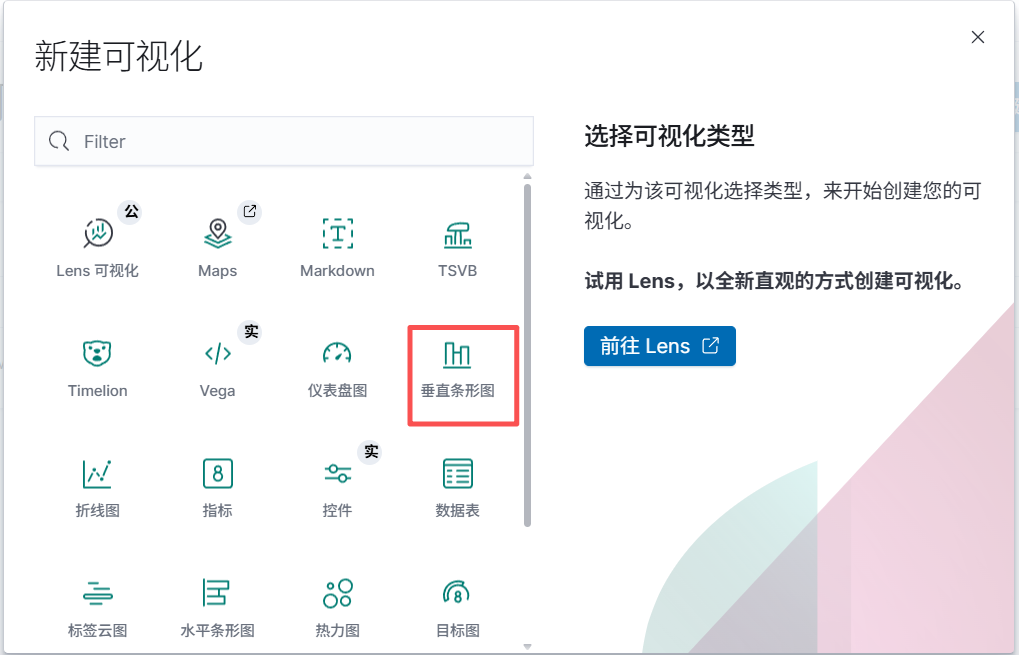
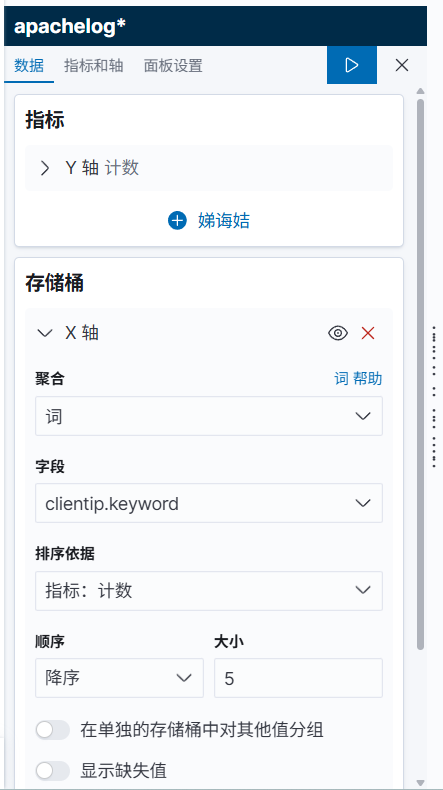
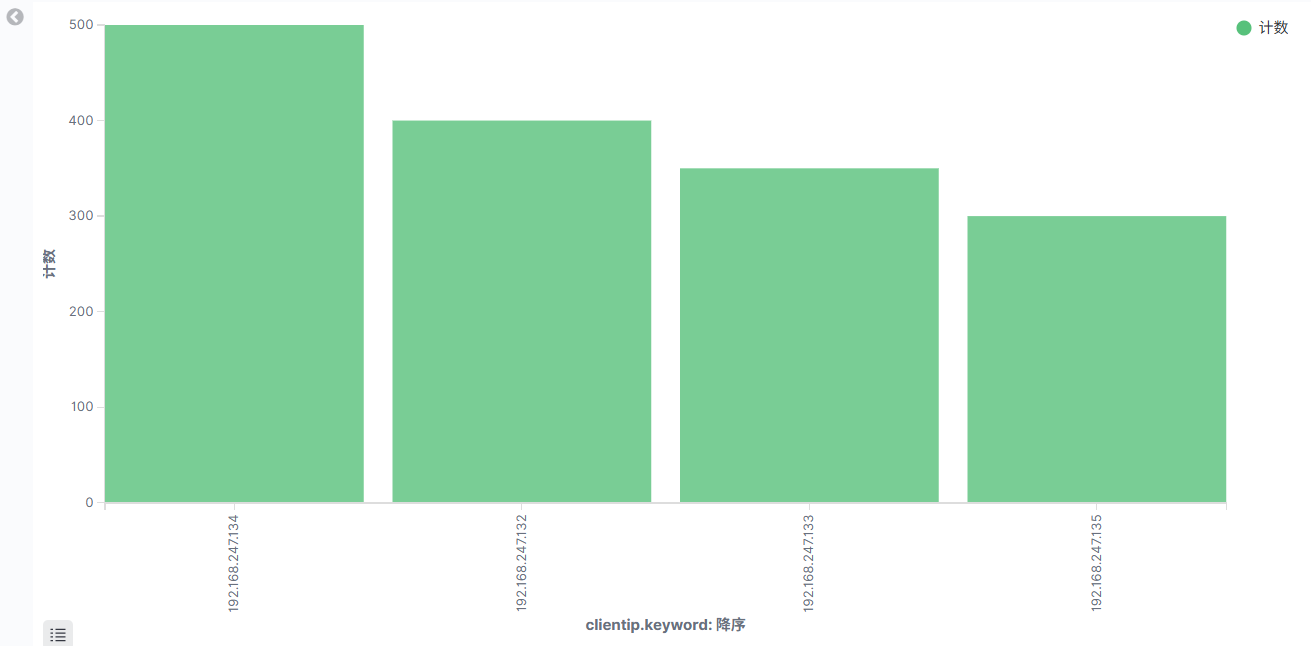
创建dashboard,大屏展示
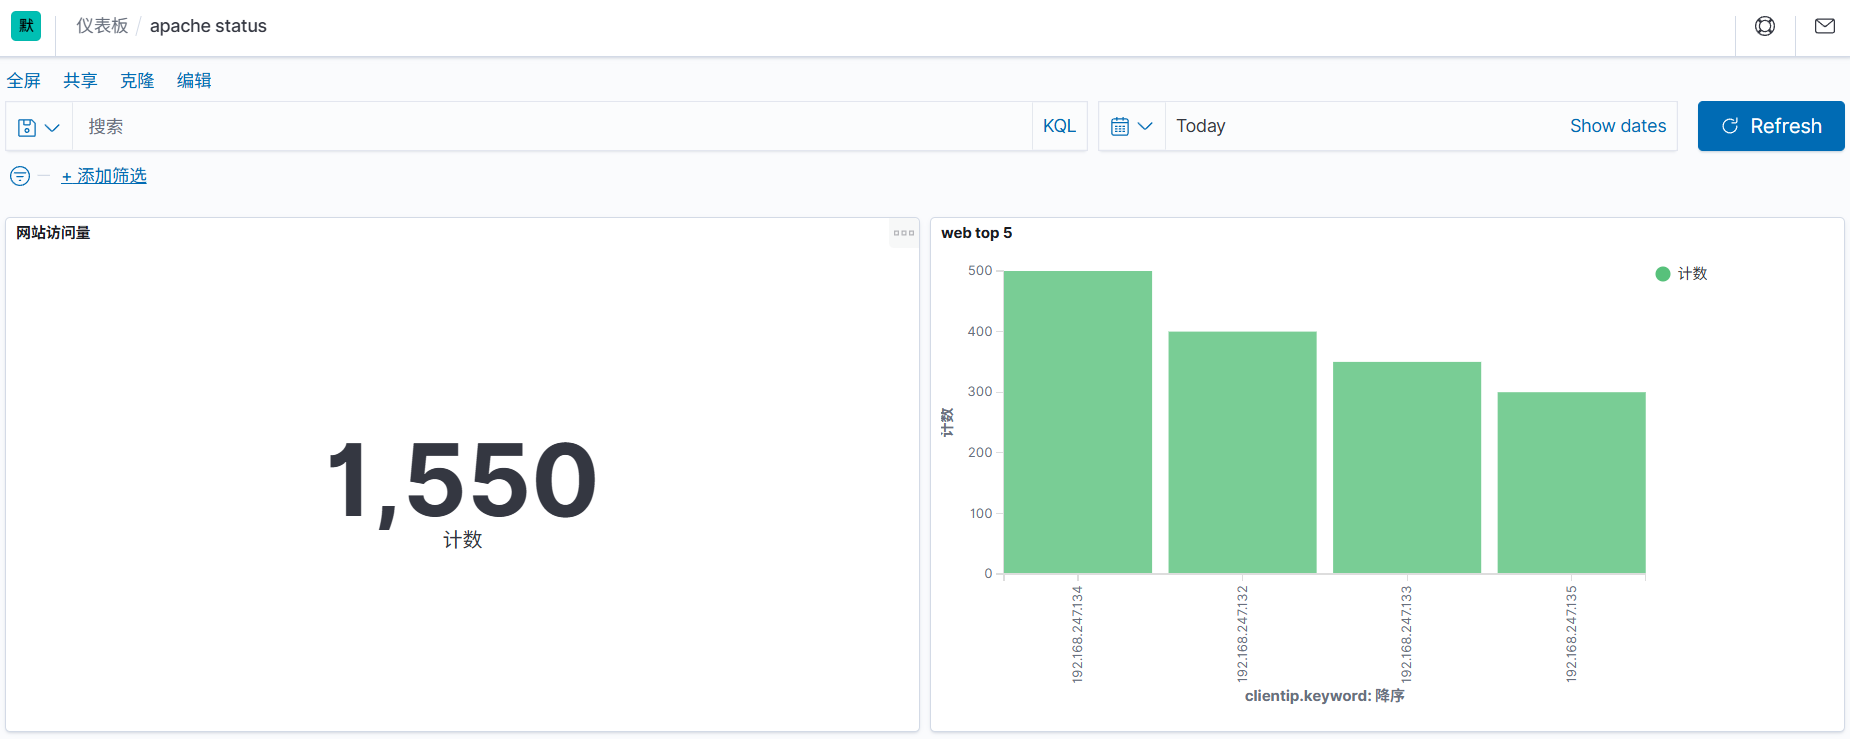
把上面创建的两个可视化添加到仪表板中
ES数据备份与恢复
配置快照仓库(nfs)
nfs 服务端
[root@server4 ~]# yum install -y nfs-utils
[root@server4 ~]# systemctl enable --now nfs
[root@server4 ~]# mkdir -p /data/es-backup
[root@server4 ~]# chmod 777 /data/es-backup/
[root@server4 ~]# vim /etc/exports
/data/es-backup *(rw,sync,no_root_squash)
[root@server4 ~]# exportfs -rv
所有ES节点都要配置
[root@server1 ~]# yum install -y nfs-utils
[root@server1 ~]# systemctl enable --now nfs
[root@server1 ~]# mkdir -p /data/es-backup
[root@server1 ~]# mount 192.168.247.135:/data/es-backup /data/es-backup
path.repo: /data/es-backup
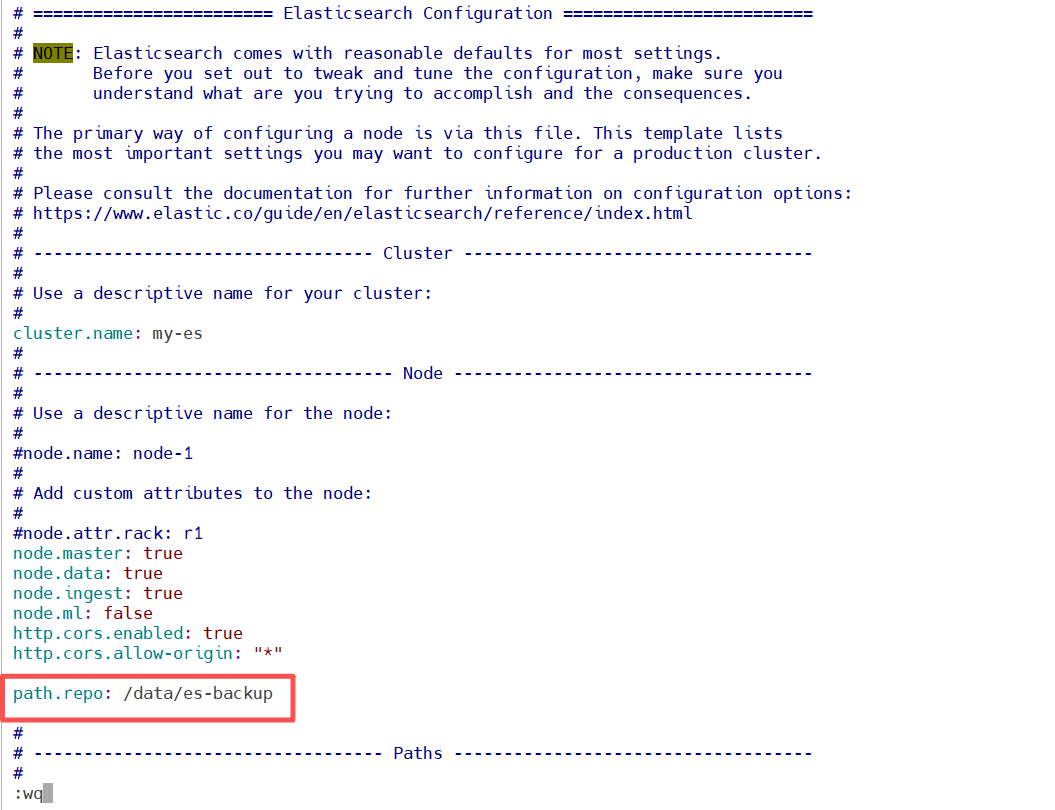
[root@server1 ~]# systemctl restart elasticsearch
server2和server3同理
通过 API 创建仓库
PUT /_snapshot/my_backup # 仓库名称(自定义)
{
"type": "fs", # 本地文件系统类型
"settings": {
"location": "/data/es-backup", # 与elasticsearch.yml中配置一致
"compress": true # 启用压缩(可选)
}
}
直接使用kibana开发工具
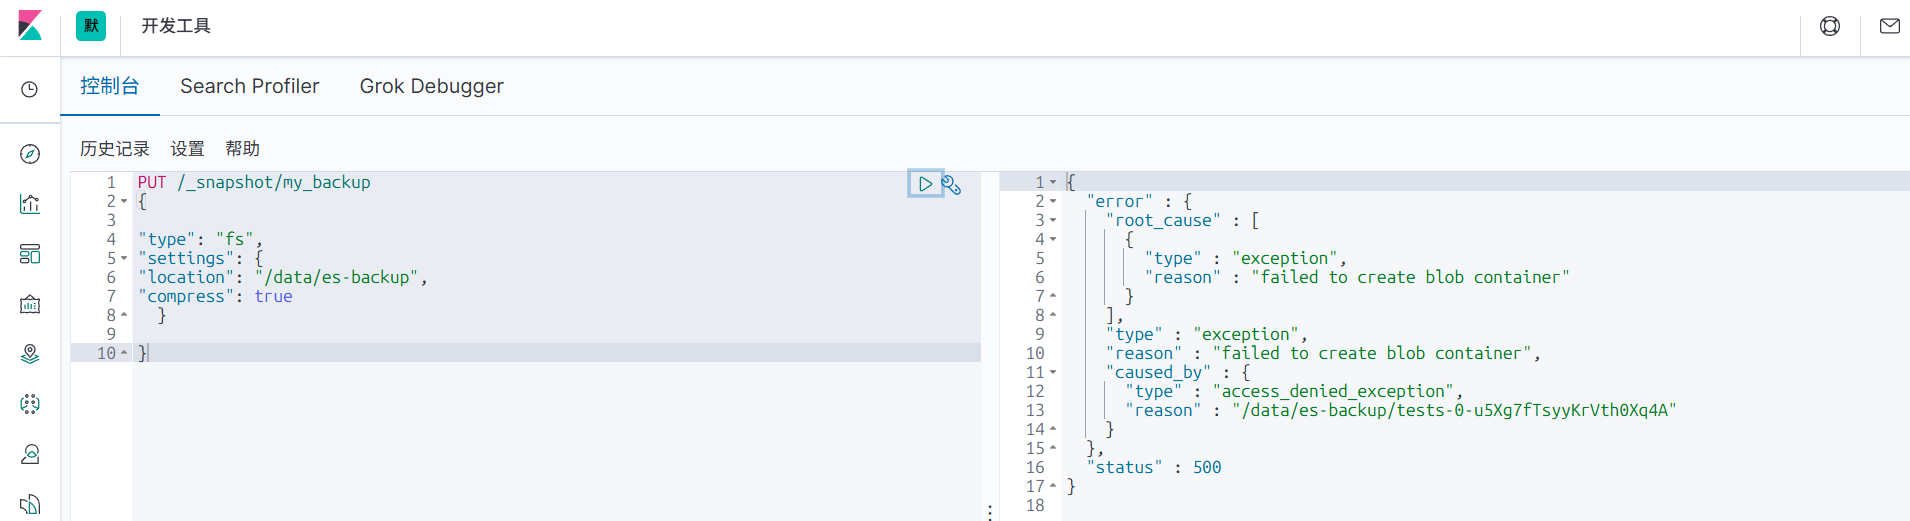
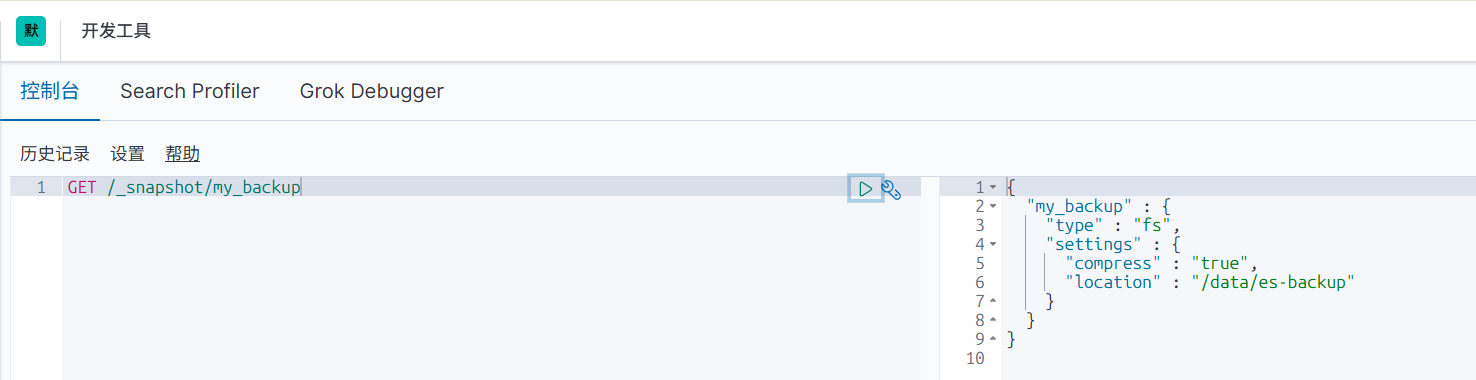
验证仓库是否创建成功
GET /_snapshot/my_backup
创建快照
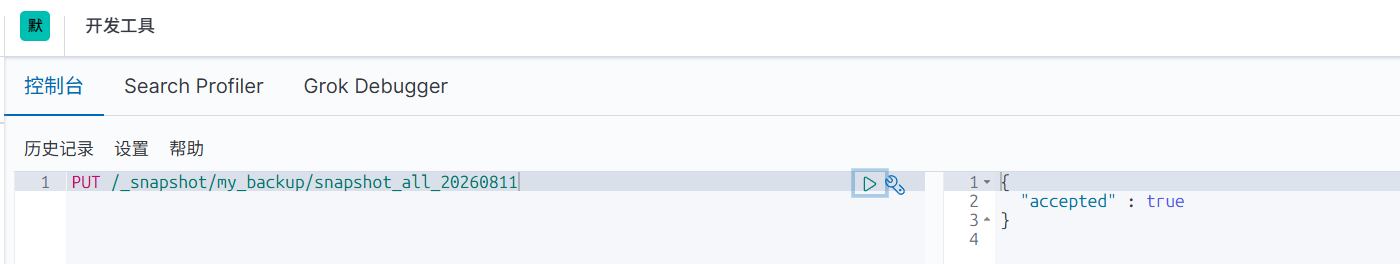
备份所有索引
PUT /_snapshot/my_backup/snapshot_all_20260811 # 快照名称(自定义,建议含时间)
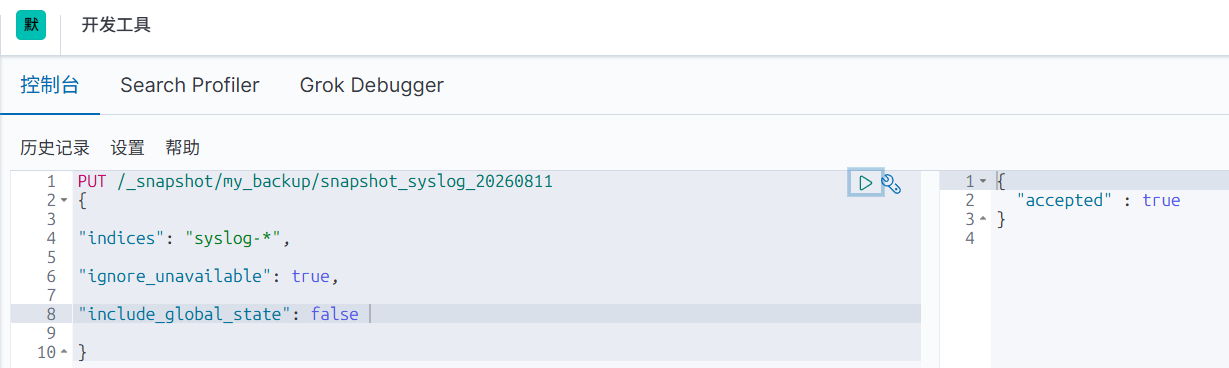
备份指定索引
PUT /_snapshot/my_backup/snapshot_syslog_20260811
{
"indices": "syslog-*", # 逗号分隔的索引名或通配符
"ignore_unavailable": true, # 忽略不存在的索引
"include_global_state": false # 是否备份集群全局状态(如模板、别名等)
}
查看快照状态
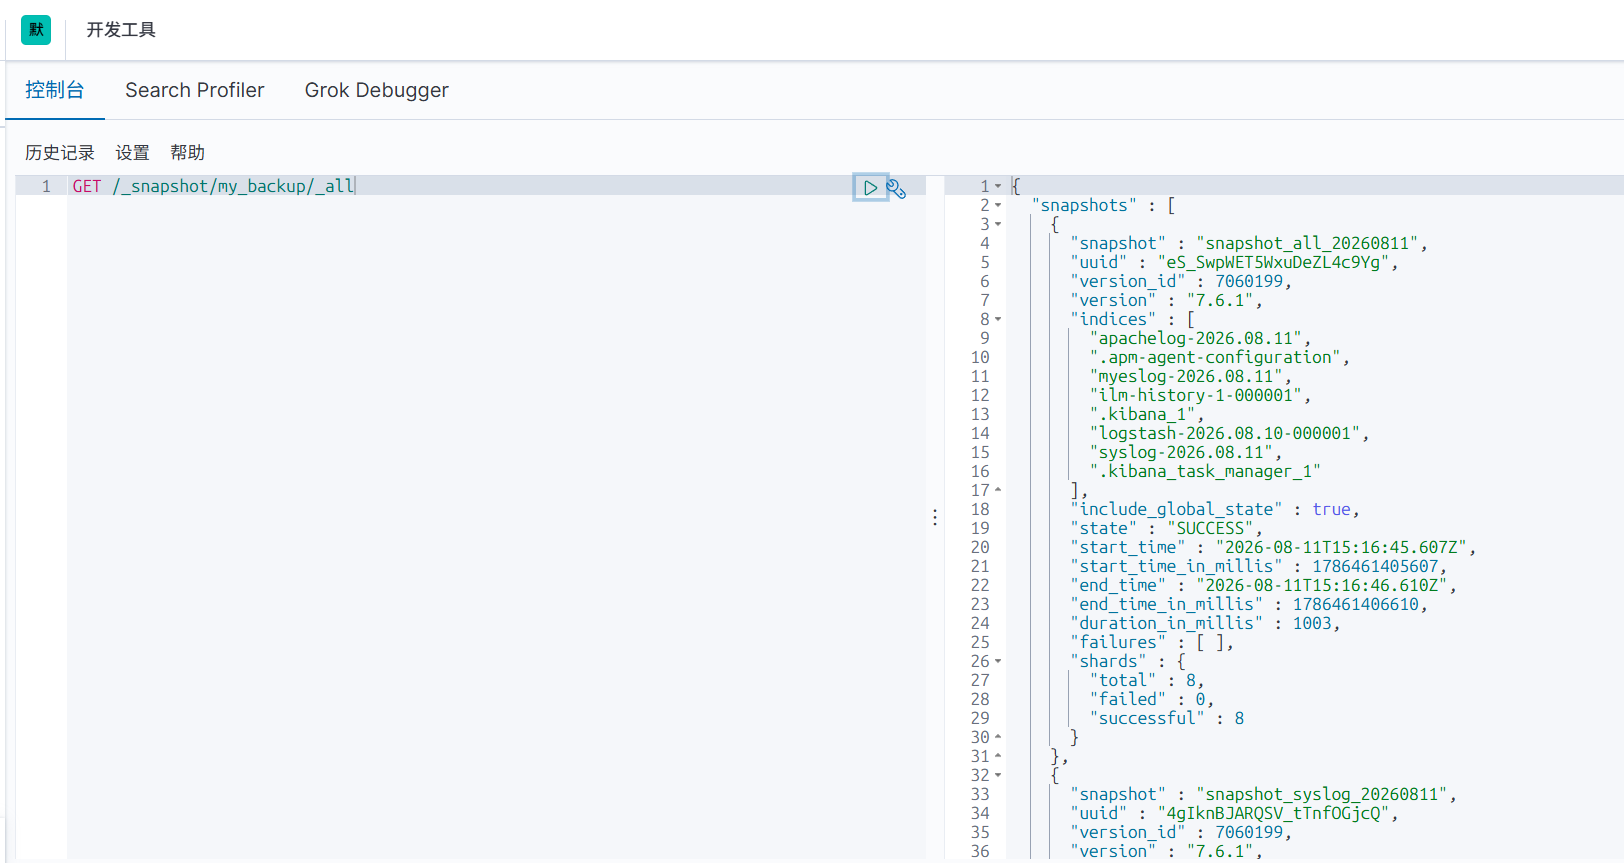
列出仓库中所有快照
GET /_snapshot/my_backup/_all
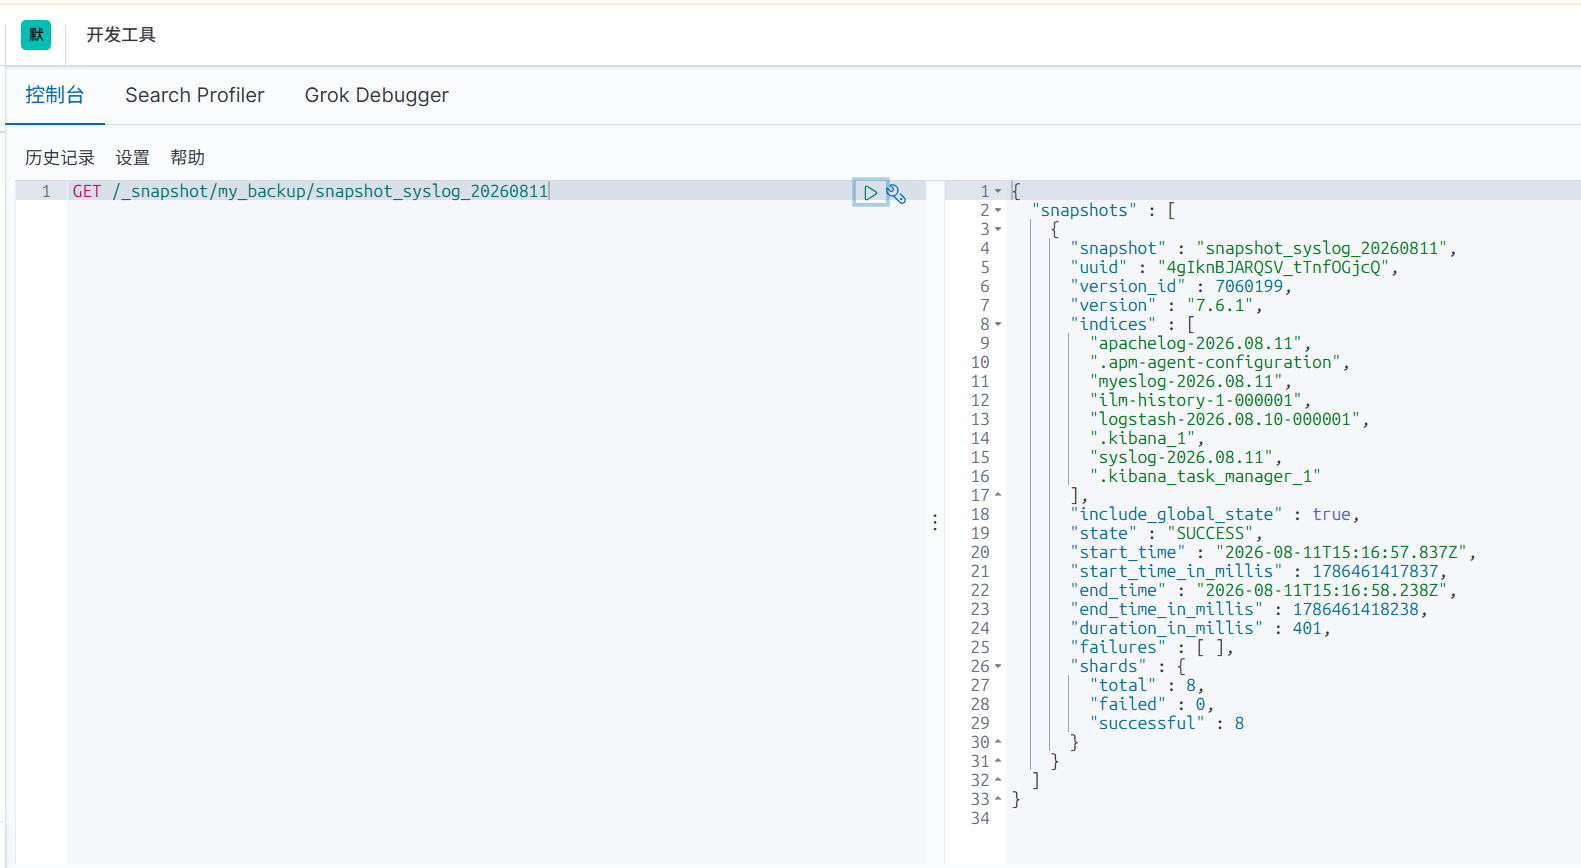
查看单个快照详情
GET /_snapshot/my_backup/snapshot_syslog_20260811
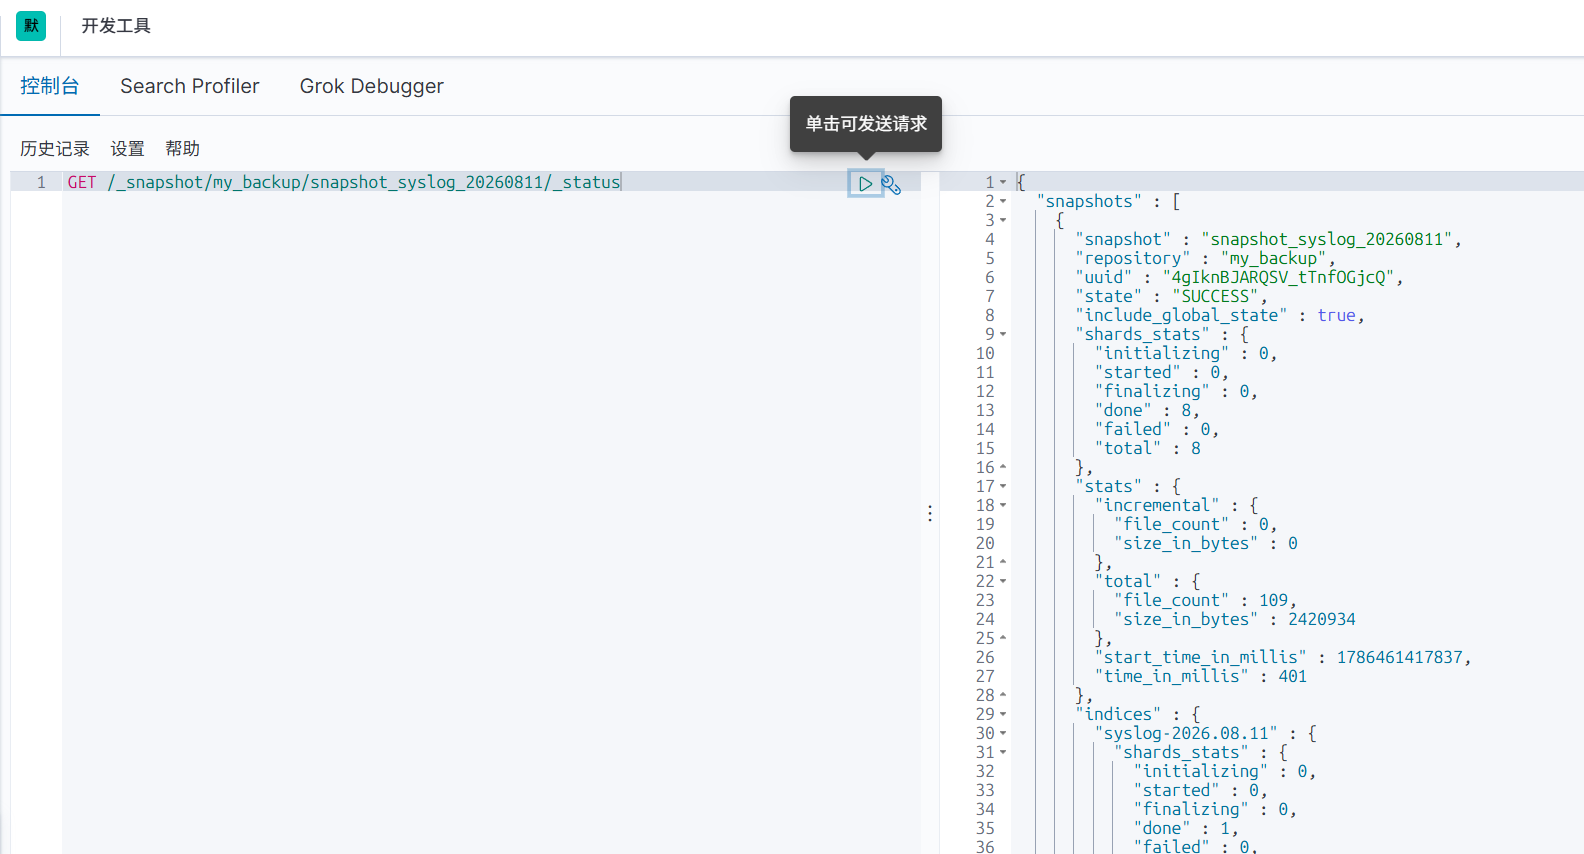
监控快照进度
GET /_snapshot/my_backup/snapshot_syslog_20260811/_status
恢复整个快照
将快照中的所有索引恢复到集群(若索引已存在,默认不覆盖,需指定rename_pattern重命名)
POST /_snapshot/my_backup/snapshot_syslog_20260811/_restore
恢复指定索引
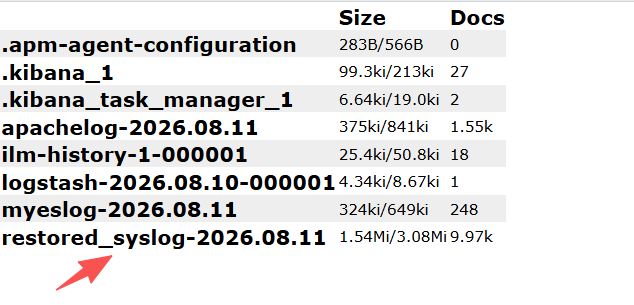
仅恢复快照中的部分索引,并可重命名避免冲突
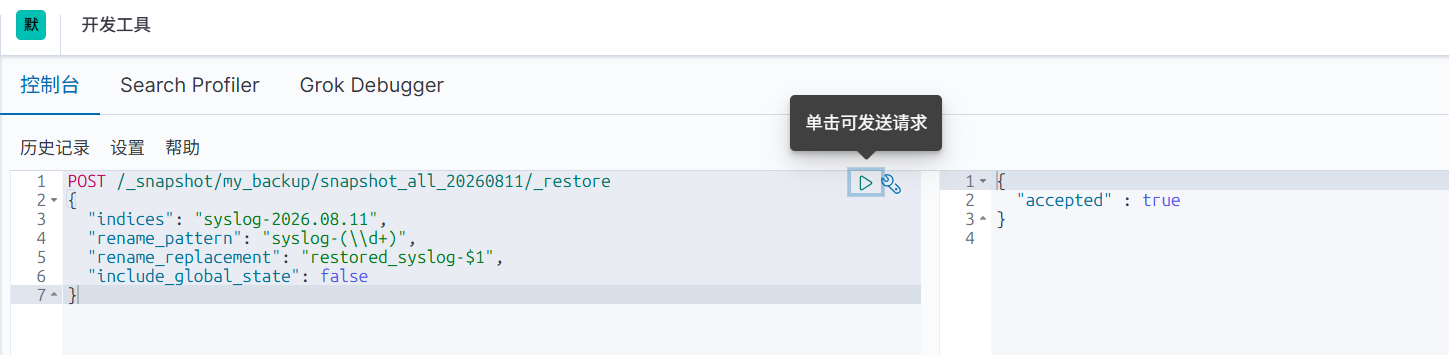
POST /_snapshot/my_backup/snapshot_all_20260811/_restore
{
"indices": "syslog-2026.08.11", # 仅恢复syslog-2026.08.11索引
"rename_pattern": "syslog-(\\d+)", # 匹配原索引名的正则
"rename_replacement": "restored_syslog-$1", # 重命名
"include_global_state": false # 不恢复集群全局状态
}
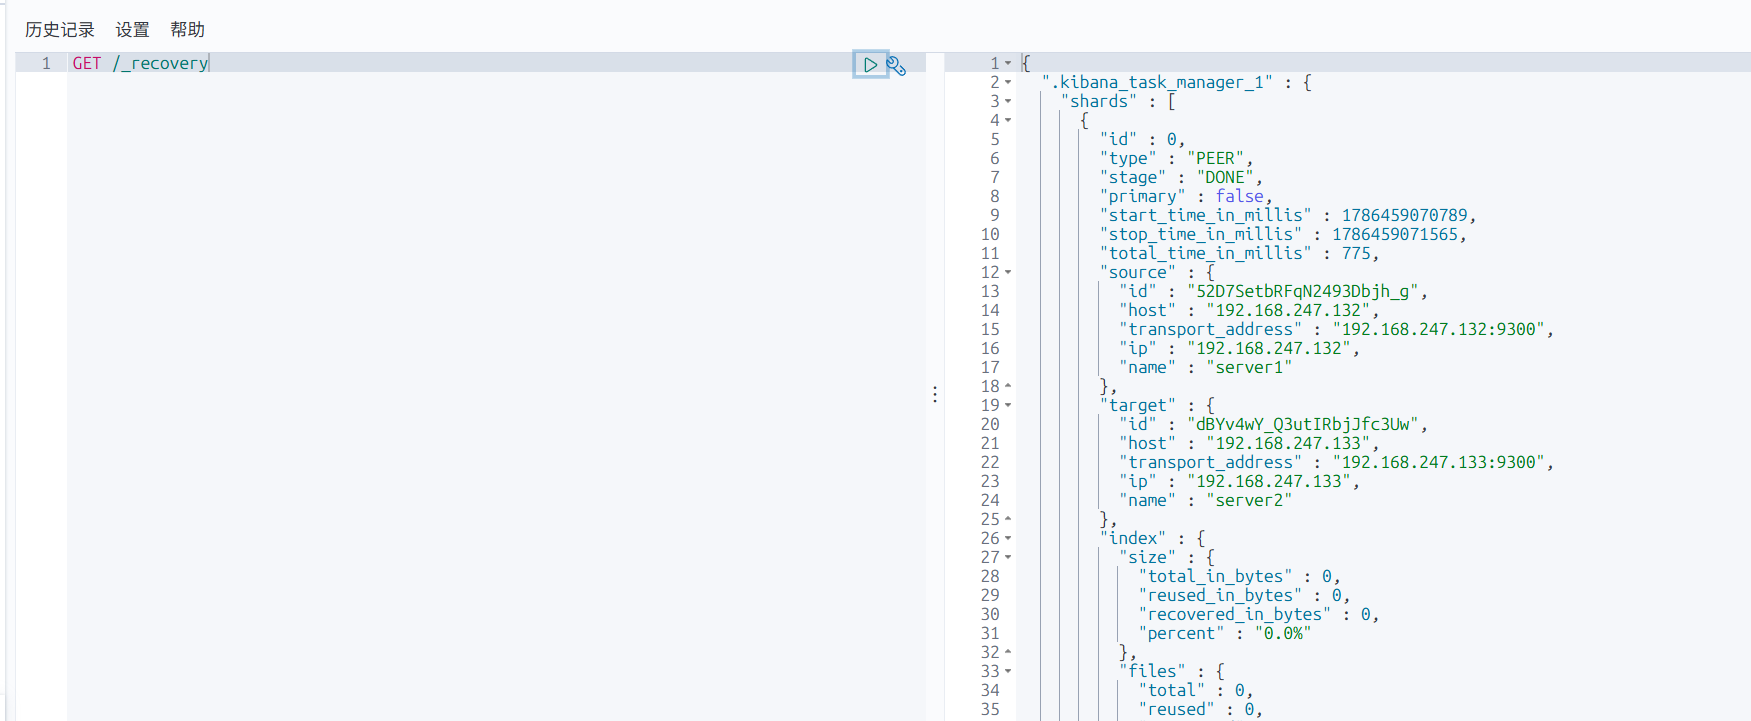
查看恢复进度
GET /_recovery # 查看所有索引的恢复状态
删除快照
DELETE /_snapshot/my_backup/snapshot_all_20260811
ES集群监控
启用xpack认证
在server1上生成证书
[root@server1 ~]# cd /usr/share/elasticsearch/
[root@server1 elasticsearch]# bin/elasticsearch-certutil ca
[root@server1 elasticsearch]# bin/elasticsearch-certutil cert --ca elastic-stack-ca.p12
[root@server1 elasticsearch]# cp elastic-certificates.p12 /etc/elasticsearch
[root@server1 elasticsearch]# cd /etc/elasticsearch/
[root@server1 elasticsearch]# chown elasticsearch elastic-certificates.p12
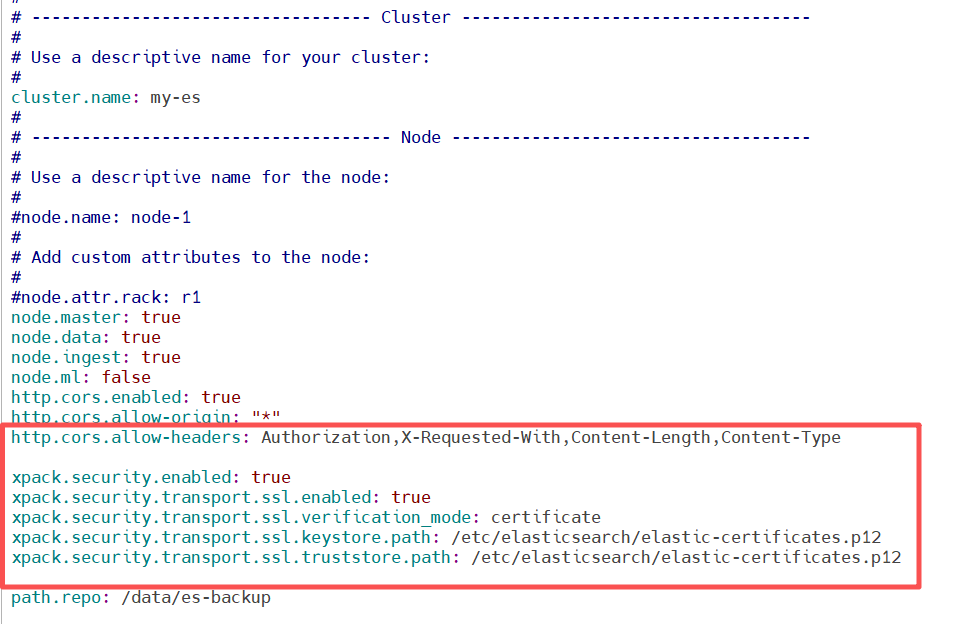
[root@server1 elasticsearch]# vim elasticsearch.yml
...
http.cors.allow-headers: Authorization,X-Requested-With,Content-Length,Content-Type
xpack.security.enabled: true
xpack.security.transport.ssl.enabled: true
xpack.security.transport.ssl.verification_mode: certificate
xpack.security.transport.ssl.keystore.path: /etc/elasticsearch/elastic-certificates.p12
xpack.security.transport.ssl.truststore.path: /etc/elasticsearch/elastic-certificates.p12
[root@server1 elasticsearch]# systemctl restart elasticsearch.service
拷贝证书到其它集群节点
[root@server1 elasticsearch]# scp elastic-certificates.p12 server2:/etc/elasticsearch/
[root@server1 elasticsearch]# scp elastic-certificates.p12 server3:/etc/elasticsearch/
server2配置
[root@server2 ~]# chown elasticsearch /etc/elasticsearch/elastic-certificates.p12
[root@server2 ~]# vim /etc/elasticsearch/elasticsearch.yml
...
xpack.security.enabled: true
xpack.security.transport.ssl.enabled: true
xpack.security.transport.ssl.verification_mode: certificate
xpack.security.transport.ssl.keystore.path: /etc/elasticsearch/elastic-certificates.p12
xpack.security.transport.ssl.truststore.path: /etc/elasticsearch/elastic-certificates.p12
[root@server2 ~]# systemctl restart elasticsearch.service
server3配置
[root@server3 ~]# chown elasticsearch /etc/elasticsearch/elastic-certificates.p12
[root@server3 ~]# vim /etc/elasticsearch/elasticsearch.yml
...
xpack.security.enabled: true
xpack.security.transport.ssl.enabled: true
xpack.security.transport.ssl.verification_mode: certificate
xpack.security.transport.ssl.keystore.path: /etc/elasticsearch/elastic-certificates.p12
xpack.security.transport.ssl.truststore.path: /etc/elasticsearch/elastic-certificates.p12
[root@server3 ~]# systemctl restart elasticsearch.service
设置认证账户密码
[root@server1 elasticsearch]# cd /usr/share/elasticsearch/
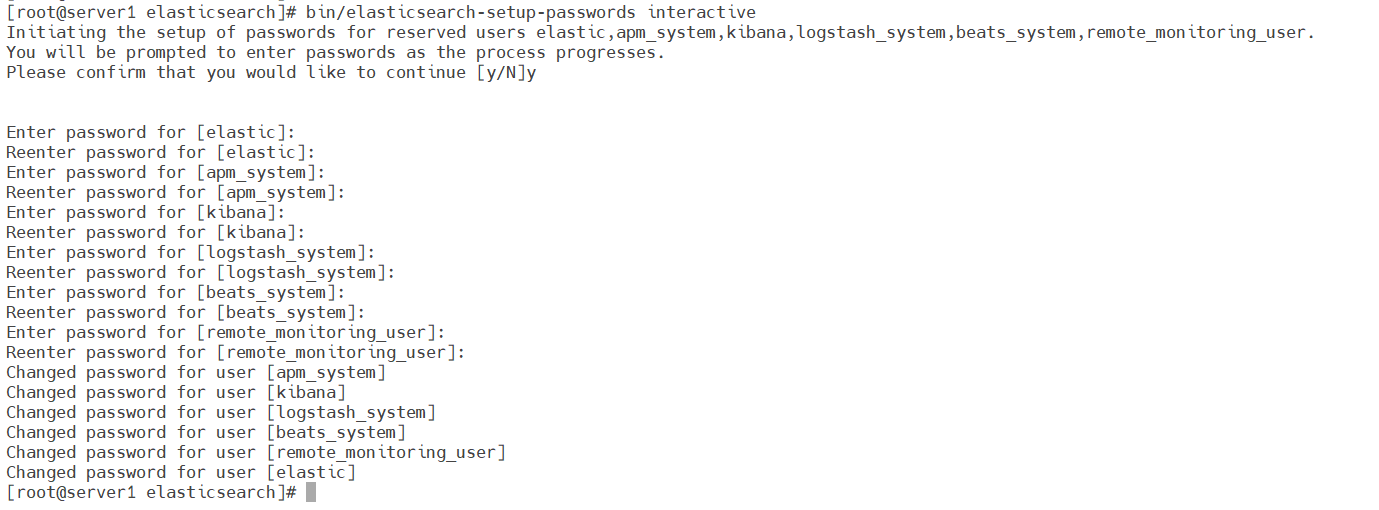
[root@server1 elasticsearch]# bin/elasticsearch-setup-passwords interactive
交互式输入密码
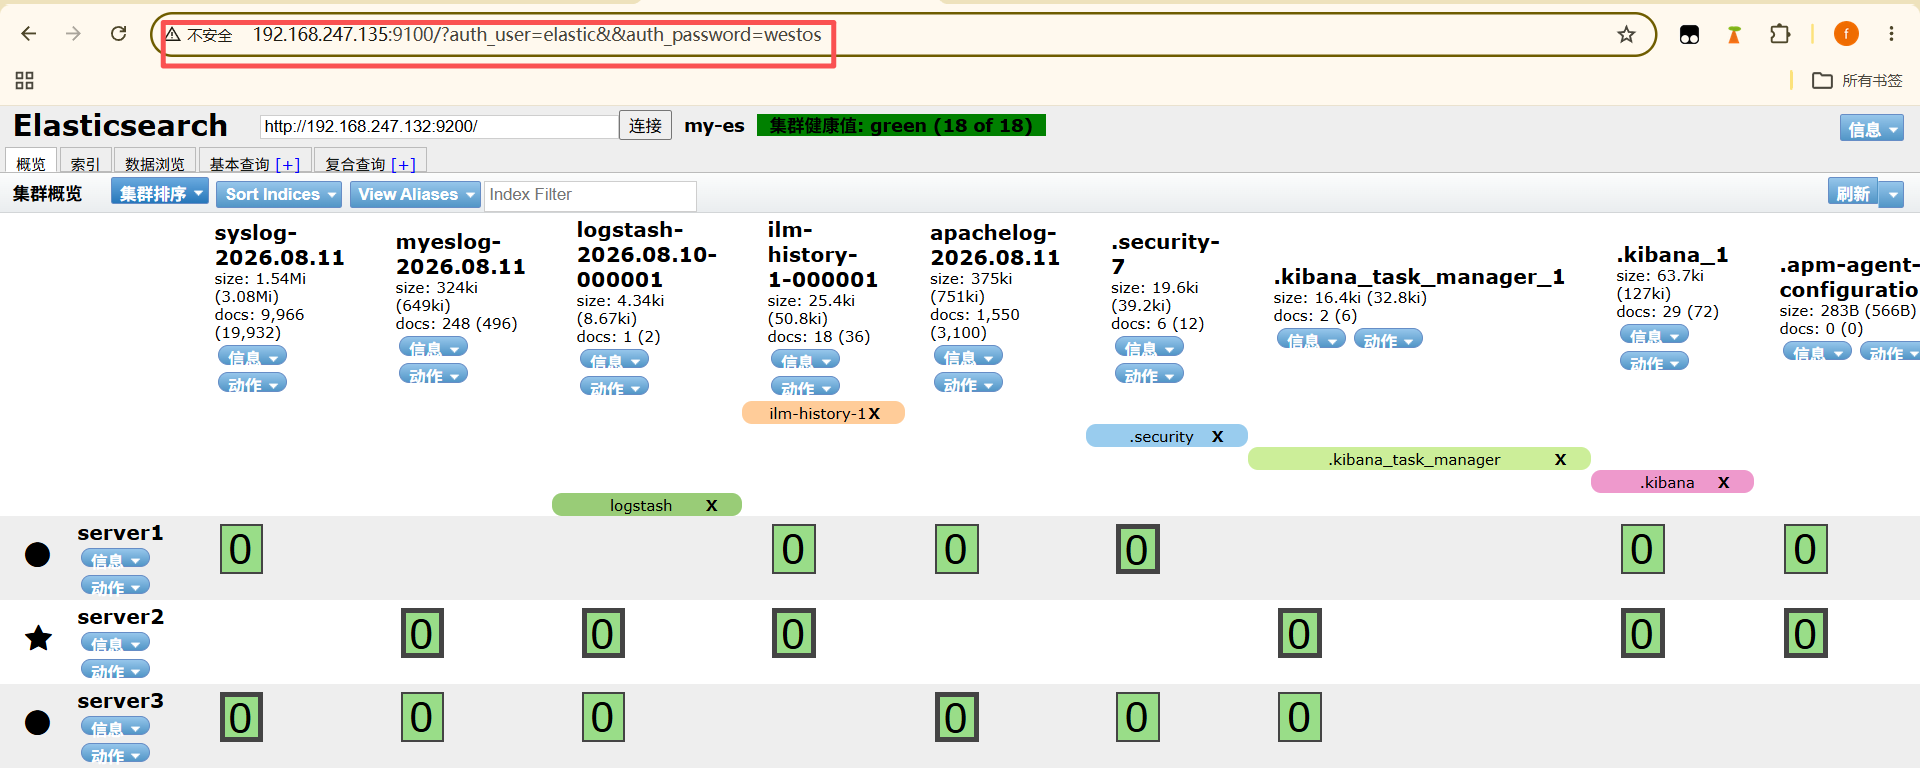
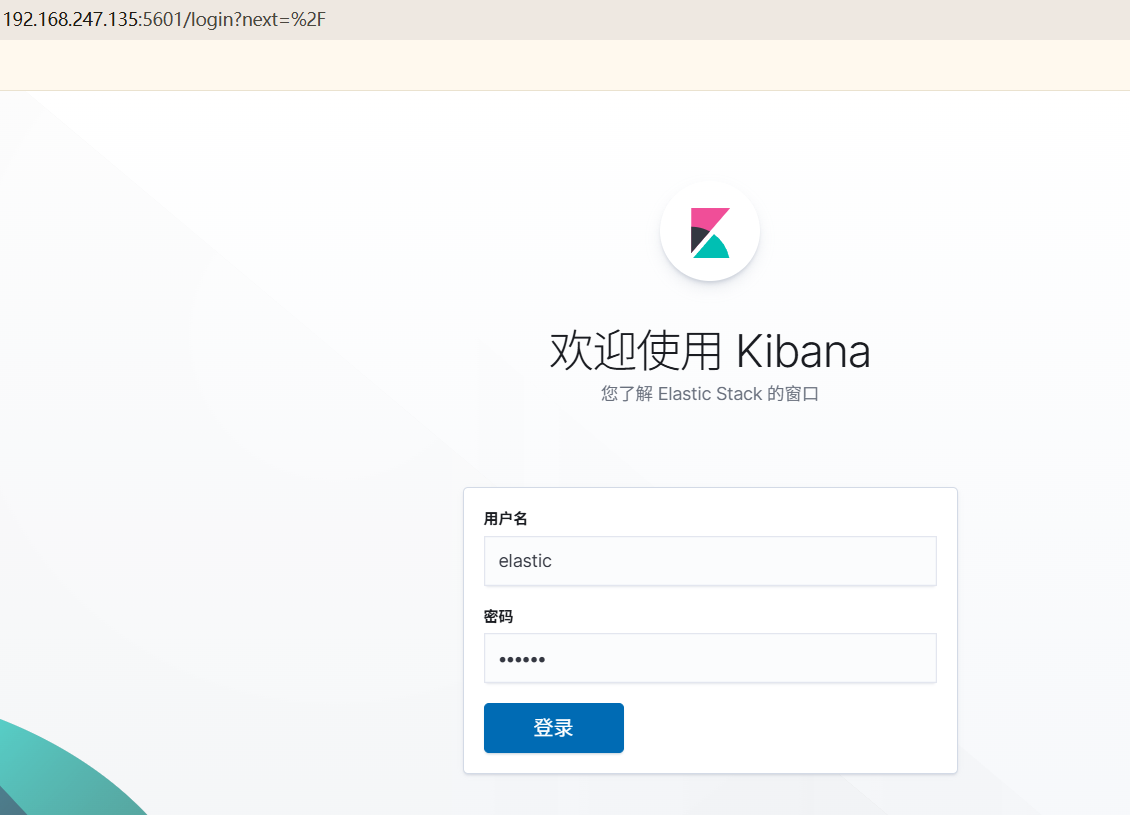
ES启用xpack之后,其它服务都需要配置认证
head插件在访问时,需要在url中输入用户和密码
http://192.168.247.135:9100/?auth_user=elastic&&auth_password=westos
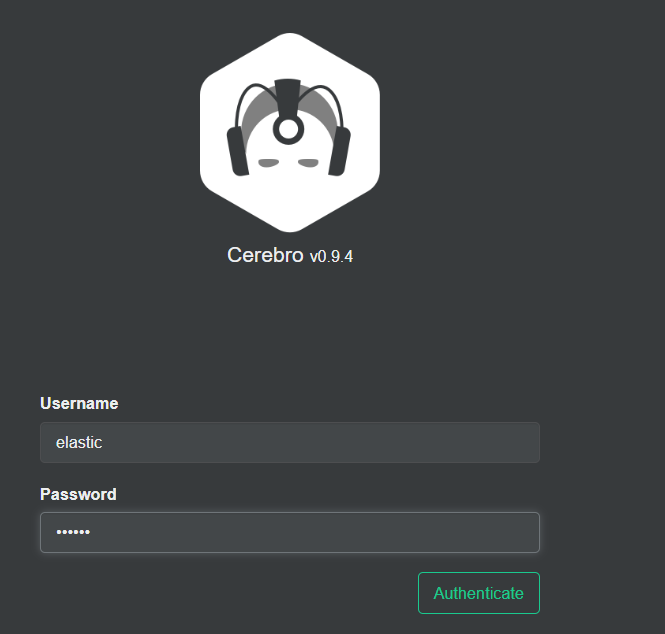
cerebro访问
logstash访问
[root@server5 ~]# cd /etc/logstash/conf.d/
[root@server5 conf.d]# vim beats.conf
input {
beats {
port => 5044
}
}
filter {
grok {
match => { "message" => "%{HTTPD_COMBINEDLOG}" }
}
}
output {
stdout {}
elasticsearch {
hosts => ["http://192.168.247.132:9200"]
index => "apachelog-%{+YYYY.MM.dd}"
user => "elastic"
password => "westos"
}
}
查看是否启动成功
[root@server5 conf.d]# /usr/share/logstash/bin/logstash -f /etc/logstash/conf.d/beats.conf
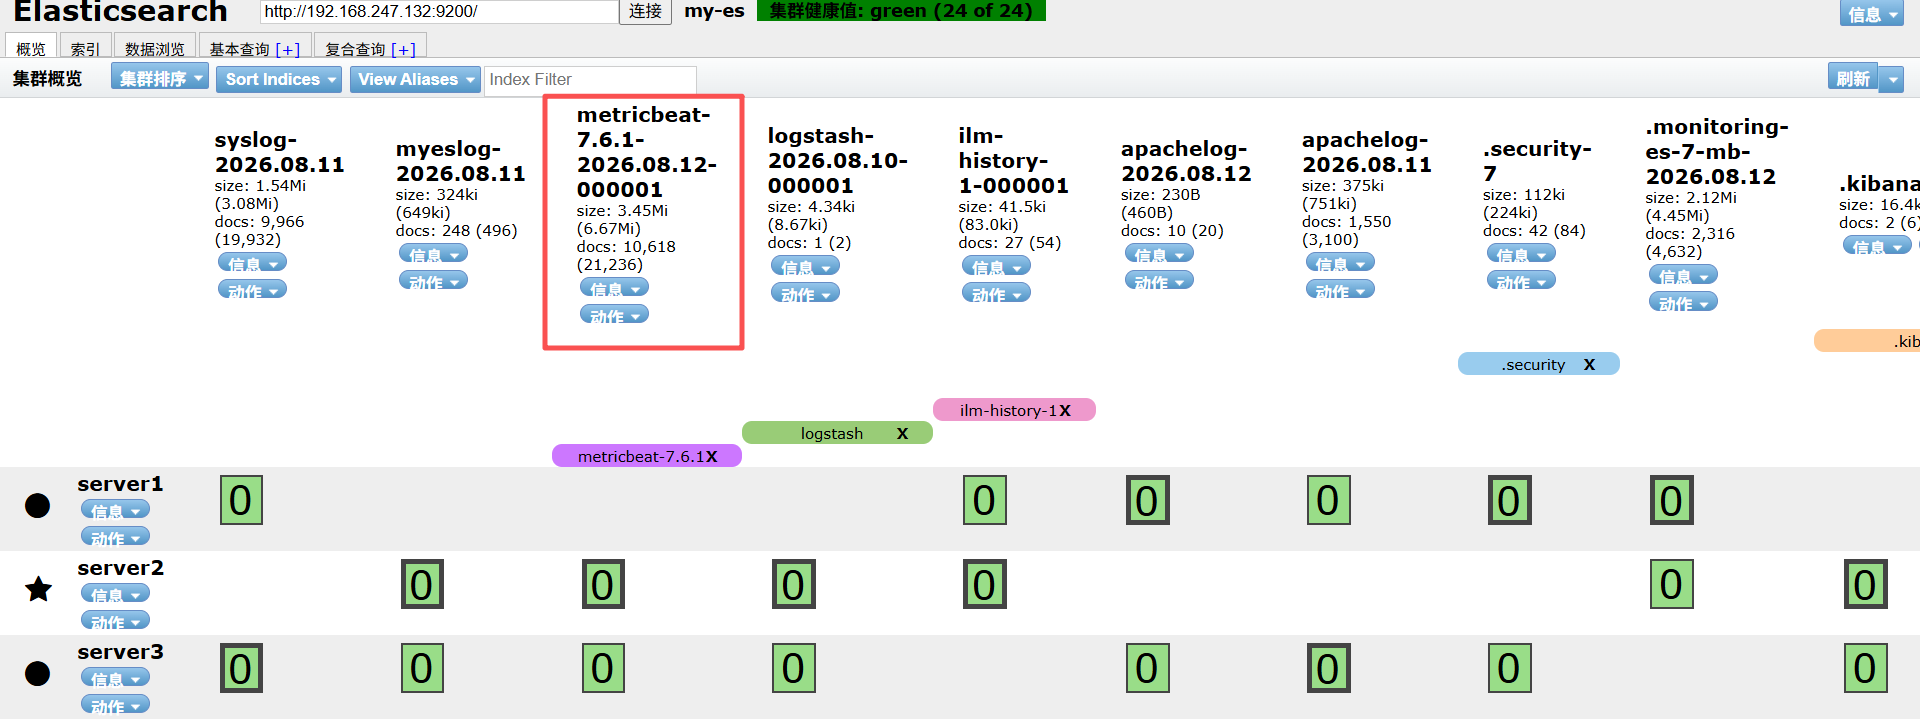
kibana访问
[root@server4 ~]# cd /etc/kibana/
[root@server4 kibana]# vim kibana.yml
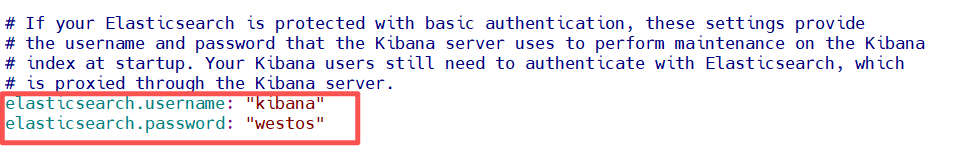
[root@server4 kibana]# systemctl restart kibana.service
metricbeat监控
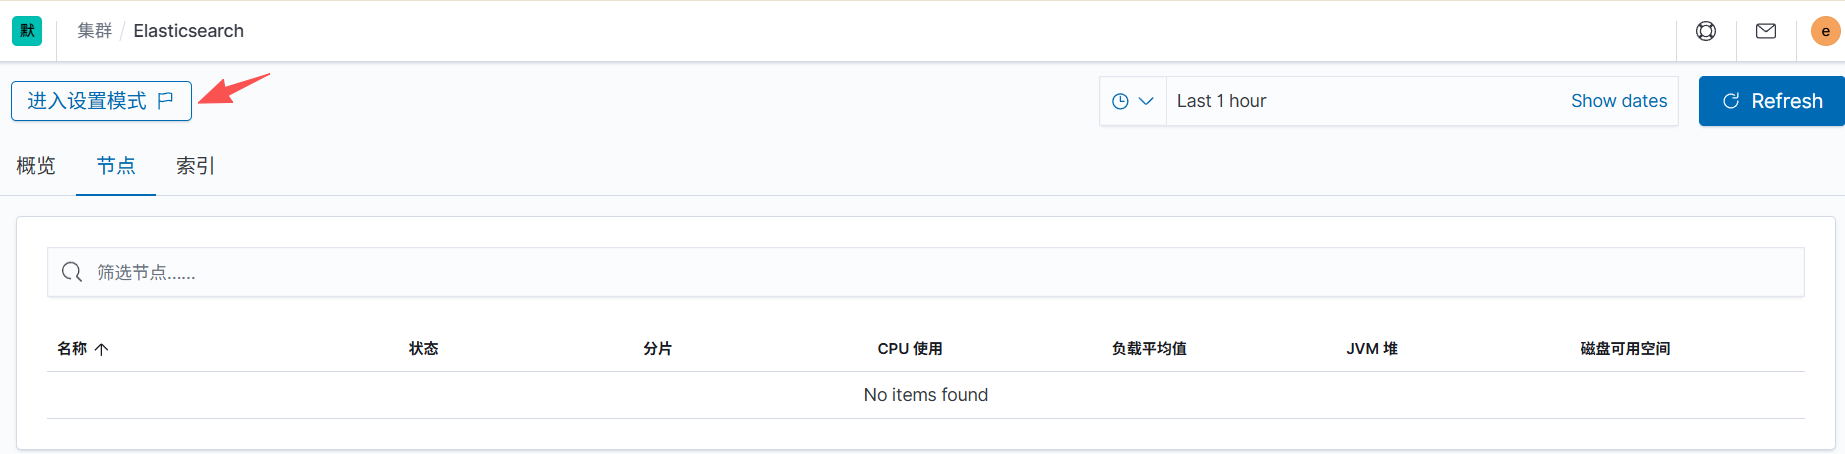
首先使用内部检测,然后进入设置模式
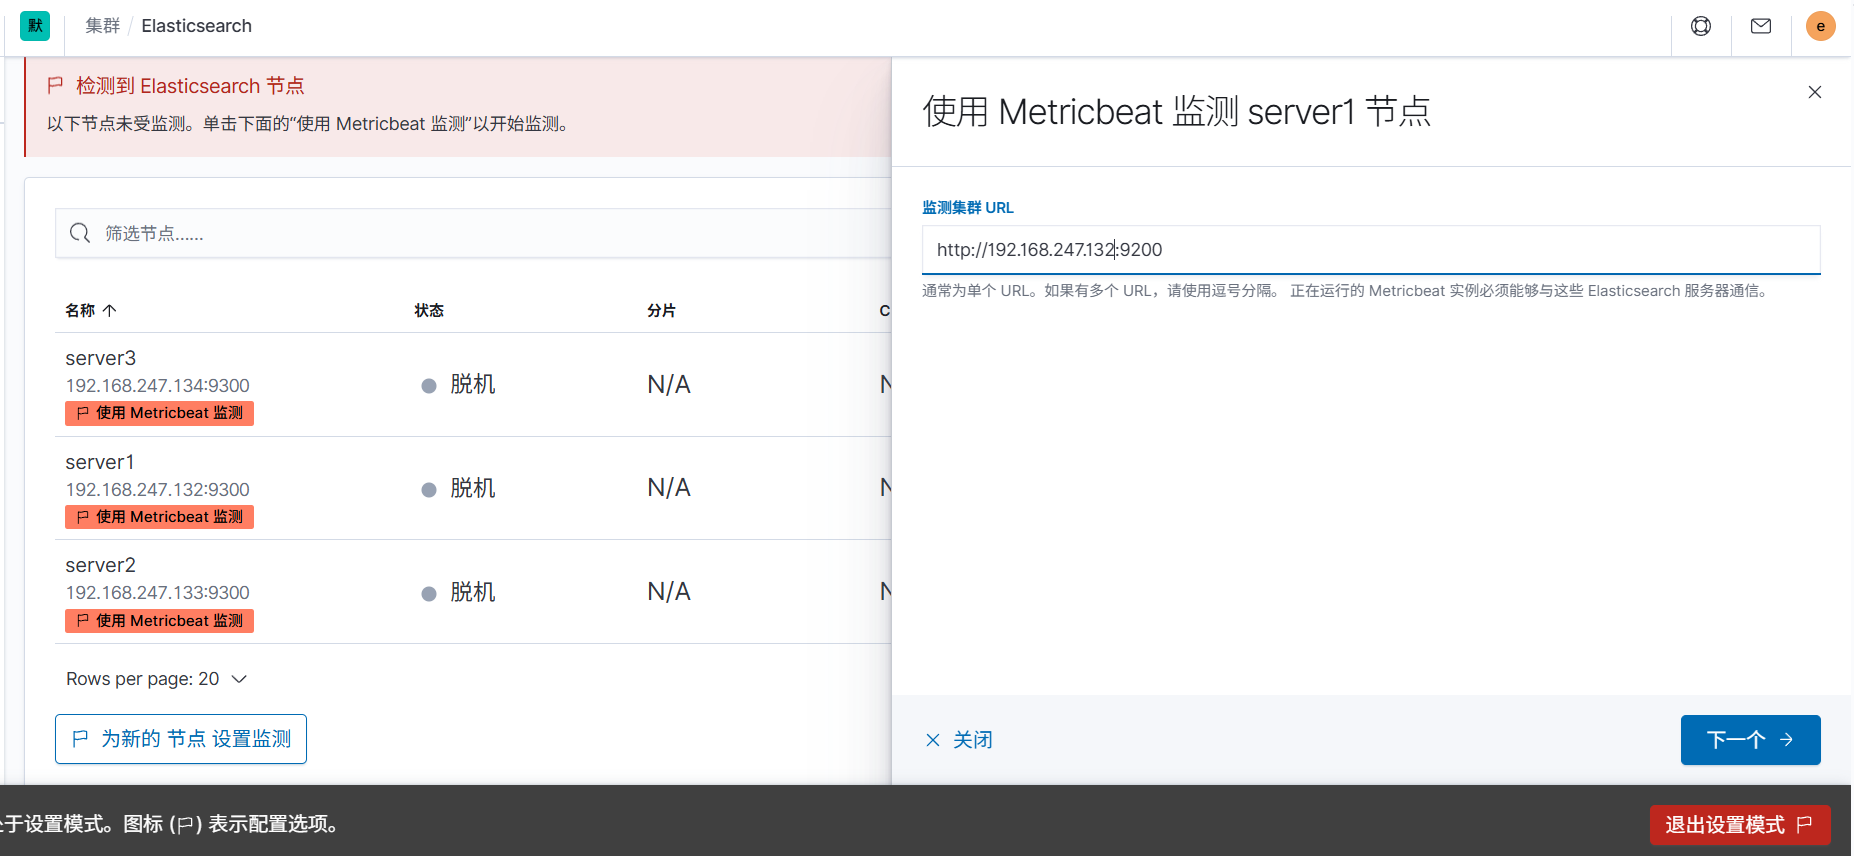
选择启动metricbeat的节点,然后根据提示步骤操作
安装软件
[root@server1 ~]# rpm -ivh metricbeat-7.6.1-x86_64.rpm
[root@server1 ~]# cd /etc/metricbeat/modules.d
[root@server1 modules.d]# metricbeat modules enable elasticsearch-xpack
[root@server1 modules.d]# vim elasticsearch-xpack.yml
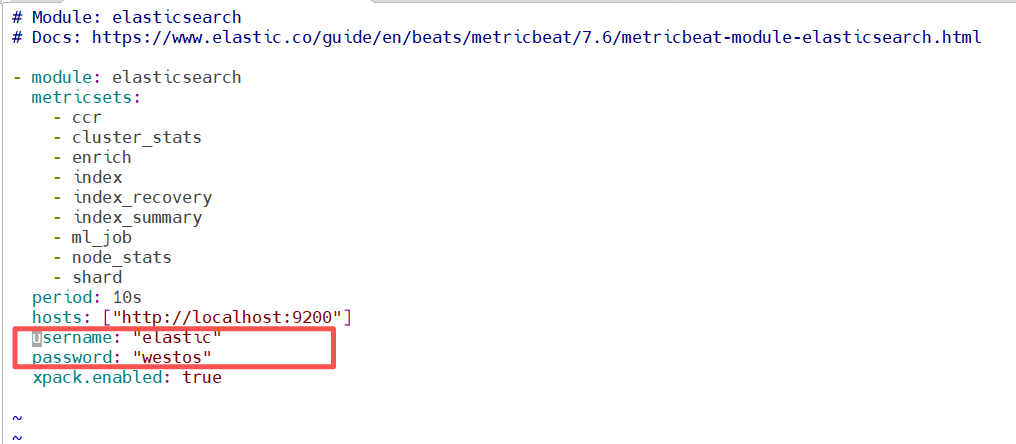
[root@server1 modules.d]# cd ..
[root@server1 metricbeat]# vim metricbeat.yml
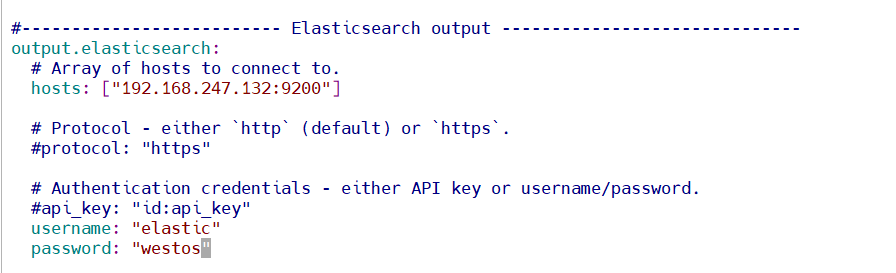
[root@server1 metricbeat]# systemctl enable --now metricbeat.service
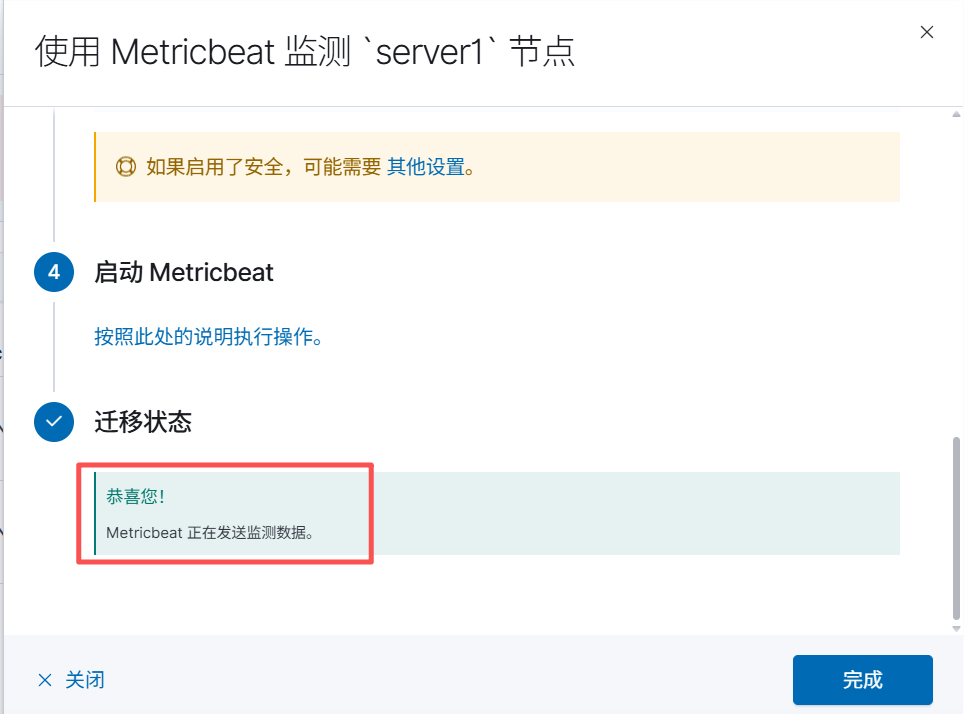
其他节点同理
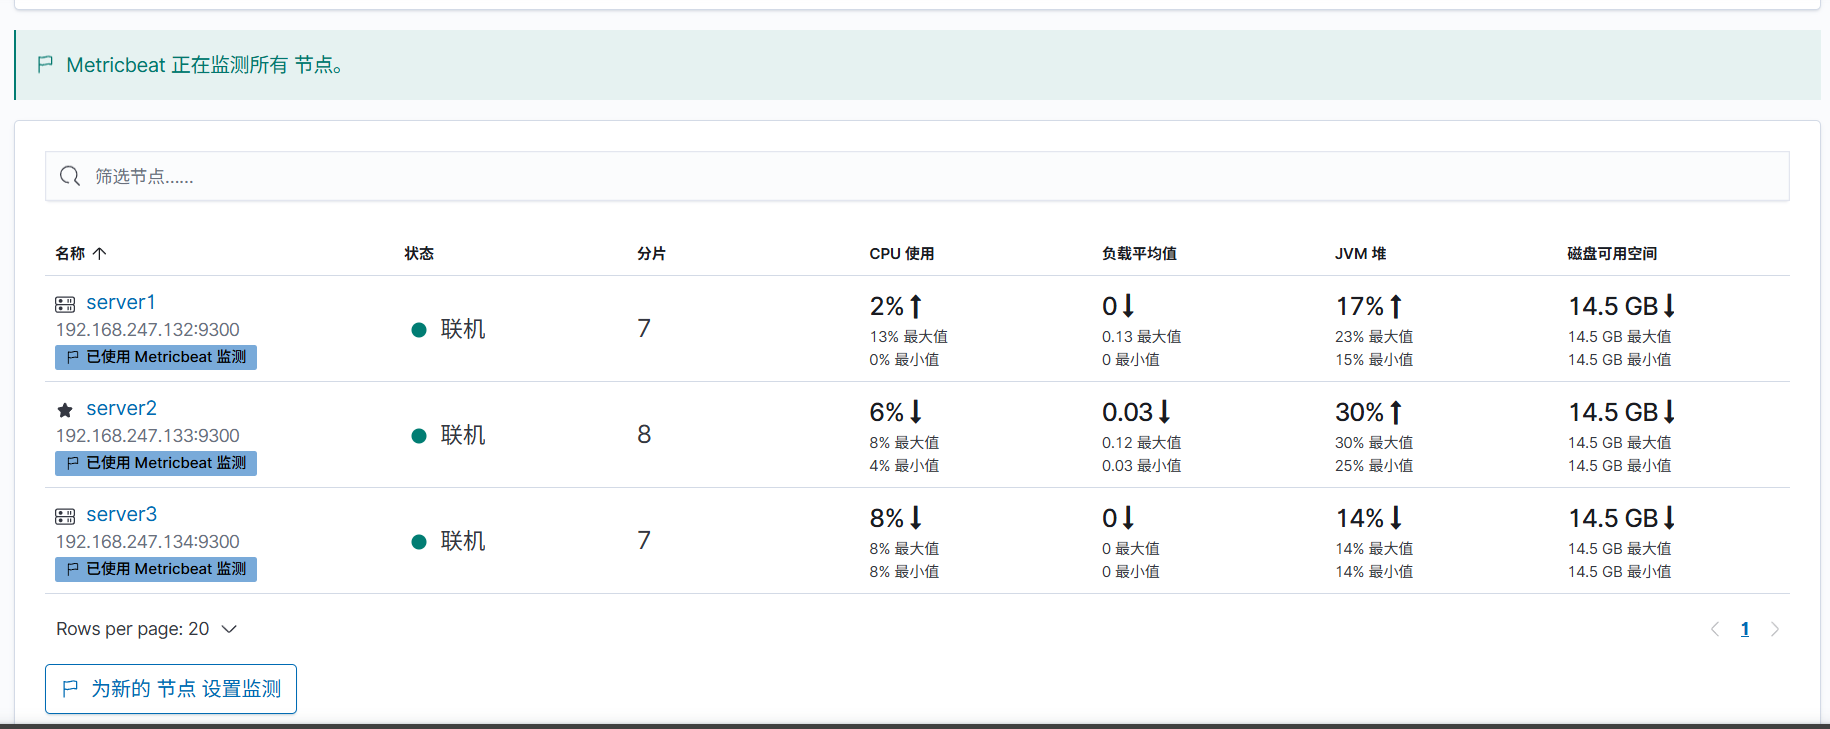
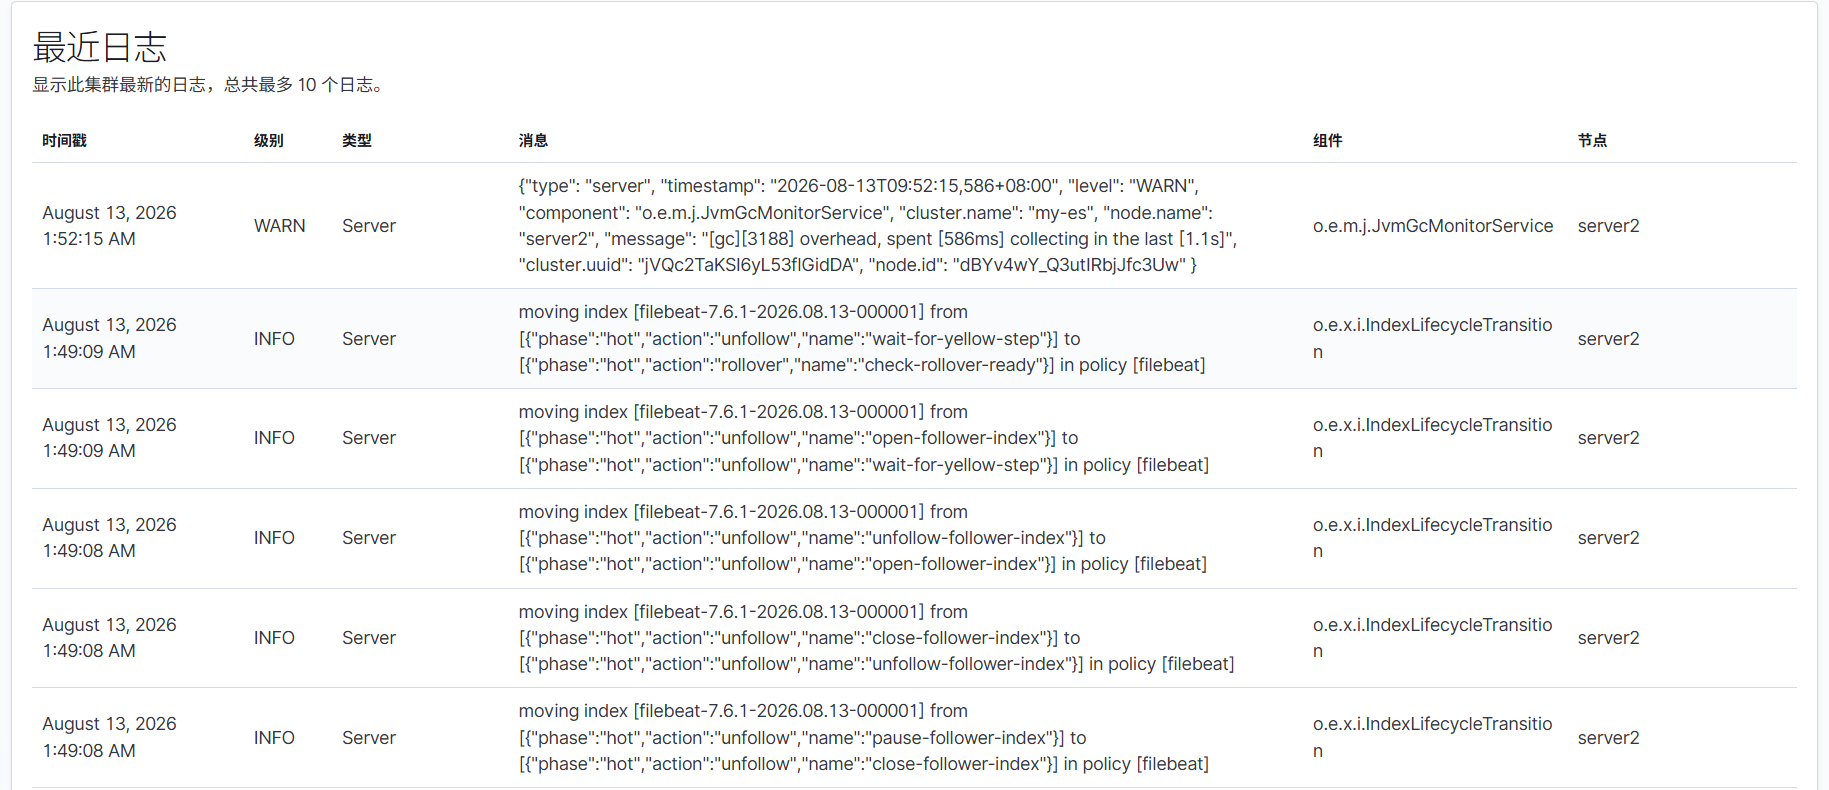
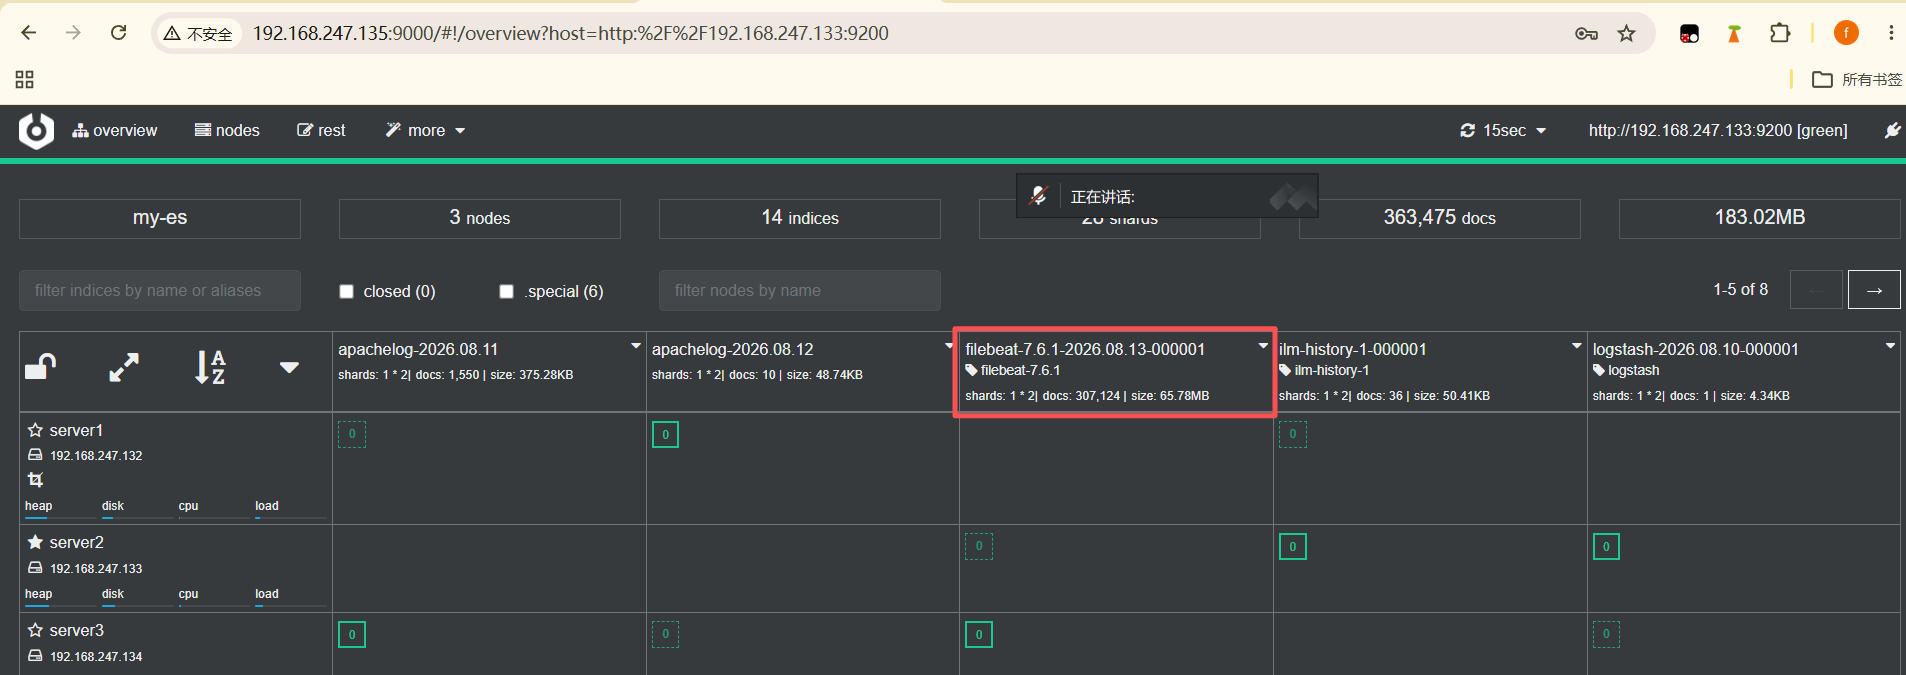
ES日志采集
[root@server1 ~]# rpm -ivh filebeat-7.6.1-x86_64.rpm
[root@server1 ~]# cd /etc/filebeat/modules.d
[root@server1 modules.d]# filebeat modules enable elasticsearch
[root@server1 modules.d]# vim elasticsearch.yml
参照官方文档修改配置
Elasticsearch module | Filebeat Reference [7.6] | Elastic
[root@server1 modules.d]# cd ..
[root@server1 filebeat]# vim filebeat.yml
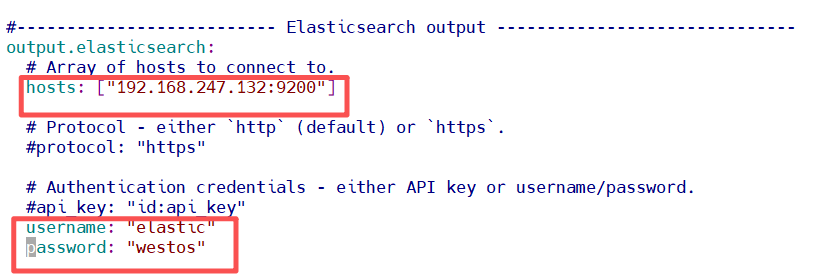
[root@server1 filebeat]# systemctl enable --now filebeat.service
server2和server3同理配置
 1725


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


