数据结构---哈希表

GE Proficy Historian8.0历史数据库部署与配置全攻略 本文提供了GE Proficy Historian 8.0历史数据库的详细部署与配置指南。内容涵盖安装前的系统环境、权限与依赖检查,服务器安装的关键步骤与类型选择,采集器的安装配置与数据接入,以及客户端工具的使用与数据分析实战。旨在帮助用户规避常见陷阱,实现一次部署成功,构建稳定高效的工业数据归档平台。 阅读详情

1.01 哈希表

-散列表(Hash table,也叫哈希表),是根据关键码值(Key value)而直接进行访问的数据结构。也就是说,它通过把关键码值映射到表中一个位置来访问记录,以加快查找的速度。这个映射函数叫做散列函数,存放记录的数组叫做散列表。
-给定表M,存在函数f(key),对任意给定的关键字值key,代入函数后若能得到包含该关键字的记录在表中的地址,则称表M为哈希(Hash)表,函数f(key)为哈希(Hash) 函数。

基本概念:

  • 若关键字为k,则其值存放在f(k)的存储位置上。由此,不需比较便可直接取得所查记录。称这个对应关系f为散列函数,按这个思想建立的表为散列表。
  • 对不同的关键字可能得到同一散列地址,即k1≠k2,而f(k1)=f(k2),这种现象称为冲突。具有相同函数值的关键字对该散列函数来说称做同义词。综上所述,根据散列函数f(k)和处理冲突的方法将一组关键字映射到一个有限的连续的地址集(区间)上,并以关键字在地址集中的“像”作为记录在表中的存储位置,这种表便称为散列表,这一映射过程称为散列造表或散列,所得的存储位置称散列地址。
  • 若对于关键字集合中的任一个关键字,经散列函数映象到地址集合中任何一个地址的概率是相等的,则称此类散列函数为均匀散列函数(Uniform Hash function),这就是使关键字经过散列函数得到一个“随机的地址”,从而减少冲突。

哈希函数:

散列函数能使对一个数据序列的访问过程更加迅速有效,通过散列函数,数据元素将被更快地定位。

实际工作中需视不同的情况采用不同的哈希函数,通常考虑的因素有:
· 计算哈希函数所需时间
· 关键字的长度
· 哈希表的大小
· 关键字的分布情况
· 记录的查找频率

1.直接寻址法:

  取关键字或关键字的某个线性函数值为散列地址。即H(key)=key或H(key) = a·key + b,
其中a和b为常数(这种散列函数叫做自身函数)。若其中H(key)中已经有值了,就往下
一个找,直到H(key)中没有值了,就放进去。
  1. 数字分析法:

      分析一组数据,比如一组员工的出生年月日,这时我们发现出生年月日的前几位
    数字大体相同,这样的话,出现冲突的几率就会很大,但是我们发现年月日的后几位
    表示月份和具体日期的数字差别很大,如果用后面的数字来构成散列地址,则冲突
    的几率会明显降低。因此数字分析法就是找出数字的规律,尽可能利用这些数据来构造冲突几率较低的散列地址。
    
  2. 平方取中法:

     当无法确定关键字中哪几位分布较均匀时,可以先求出关键字的平方值,然后按
    需要取平方值的中间几位作为哈希地址。这是因为:平方后中间几位和关键字中每
    一位都相关,故不同关键字会以较高的概率产生不同的哈希地址。 
    

例:

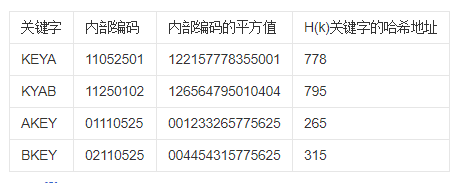
 我们把英文字母在字母表中的位置序号作为该英文字母的内部编码。例如K的内部编码为
 11,E的内部编码为05,Y的内部编码为25,A的内部编码为01, B的内部编码为02。由此
 组成关键字“KEYA”的内部代码为11052501,同理我们可以得到关键字“KYAB”、“AKEY”、
 “BKEY”的内部编码。之后对关键字进行平方运算后,取出第7到第9位作为该关键字哈希地址,如下图所示
在这里插入图片描述
4. 折叠法:

 将关键字分割成位数相同的几部分,最后一部分位数可以不同,然后取这几部分的叠加和
(去除进位)作为散列地址。数位叠加可以有移位叠加和间界叠加两种方法。移位叠加是
将分割后的每一部分的最低位对齐,然后相加;间界叠加是从一端向另一端沿分割界来回
折叠,然后对齐相加。
  1. 随机数法:

    选择一随机函数,取关键字的随机值作为散列地址,通常用于关键字长度不同的场合。
    
  2. 除留余数法:

      取关键字被某个不大于散列表表长m的数p除后所得的余数为散列地址。即
     H(key) = key MOD p,p<=m。不仅可以对关键字直接取模,也可在折叠、平方
     取中等运算之后取模。对p的选择很重要,一般取素数或m,若p选的不好,容易产生同义词。
    

哈希函数的设计:

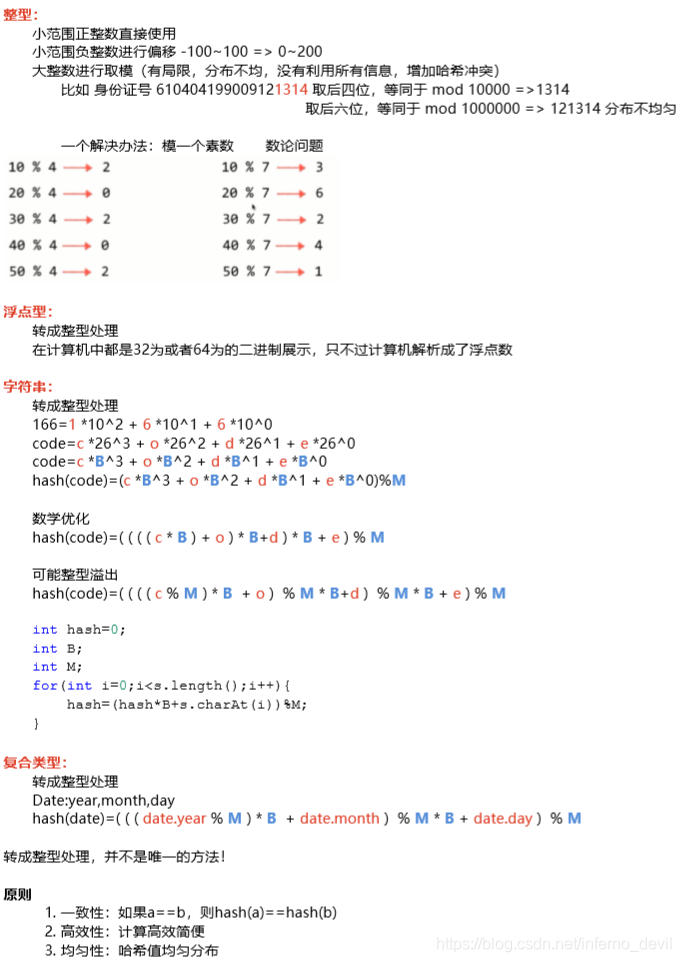
-“键”通过哈希函数得到的“索引”分布越均匀越好
-对于一些特殊领域,有特殊领域的哈希函数设计方式,甚至有专门的论文
-我们只关注一般的哈希函数的设计
在这里插入图片描述
Java中的hashCode
1.Object中的hashCode

public native int hashCode();
  • 任何子类的hashCode函数都继承自Object。
  • 在子类没有重写该函数之时,子类的哈希值由Object的hashCode函数计算。
  • 该函数默认将对象的物理内存地址当做哈希值。

2.基本数据类型中的hashCode

重写了Object的hashCode,都是转整型,没有%M。

3.String类中的hashCode

重写了Object的hashCode,没有%M

public int hashCode(){
	int h=hash;
	if(h==0&&value.length>0){
		char val[]=value;
		for(int i=0;i<value.length;i++){
			h=31*h+val[i];	//字符串转成整型处理的公式
		}
		hash=h;
	}
	return h;
}

4.自定义类中的hashCode

public class Student{
	int grade;
	int cls;
	String name;
	public Student(int grade, int cls,String name){
		super();
		this.grade=grade;
		this.cls=cls;
		this.name=name;
	}
	public int hashCode(){
		int B=31;
		int hash=0;
		hash=hash*B+grade;
		hash=hash*B+cls;
		hash=hash*B+name.toLowerCase().hashCode();
		return hash;
    }
    //自动生成的hashCode推荐使用
    public int hahsCode(){
    	final int prime=31;
    	int result=1;
    	result=prime*result+cls;
    	result=prime*result+grade;
    	result=prime*result+((name==null)?0:name.hashCode());
    	return result;
    }
}

Java中的哈希表

Java中自带的HashSet集合和HashTable映射
hashCode()函数只能计算出元素对应在哈希表中的索引,但是正如上文所述,不同的元素也可能计算出相同的索引。如何处理?
在这里插入图片描述
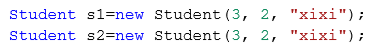
如代码所示,s1和s2都是3年级2班的名称为"xiix"的学生
如果不重写Student类的hashCode函数的话,默认使用Object的,就用对象的地址作为哈希值
所以,s1和s2是两个对象,其地址肯定不同,所以哈希值也不同,则两者都能存入到哈希表中
但是,如果从业务逻辑考虑的话,年级相同,班级相同,姓名也相同的话,表示同一个人
那么此时s1和s2虽然是两个对象,是业务中的同一人,但是也能存在哈希表中,这样子不符合逻辑 如何处理呢?
这就是哈希冲突,目前解决的思路是:
如果哈希值相同,就比较内容,如何比较内容,就需要重写equals方法
内容相同,意味着 两个对象计算的哈希值一样 且内容一样 表示同一人 哈希表不存s2
内容不相同,意味着 两个对象计算的哈希值一样 但内容不一样 表示两个人 哈希表存s2

public boolean equals(Object obj){
	if(this==obj)	//跟自身比较
		return true;
	if(obj==null)	//判断是否为空
		return false;
	if(getClass()!=obj.getClass())	//比较是否是相同类型
		return false;
	Student other=(student) obj;
	if(cls!=other.cls)
		return false;
	if(grade!=other.grade)
		return false;
	if(name==other.name){
		if(other.name!=name)
			return false; 
	}else if(!name.equals(other.name))
			return false;
	return true;
}

所以,对于Java中自带的哈希表,计算步骤如下

  1. 先调用对象的hashCode计算哈希值
  2. 通过哈希值寻表中的位置
  3. 如果该位置中没有元素,则直接存入
  4. 如果该位置中已有元素,则调用后者的equals和已存在元素进行比较
    a. 内容相同,后者不存如
    b. 内容不同,后者存入(链地址法 )

哈希冲突的处理 链地址法(Seperate Chaining)

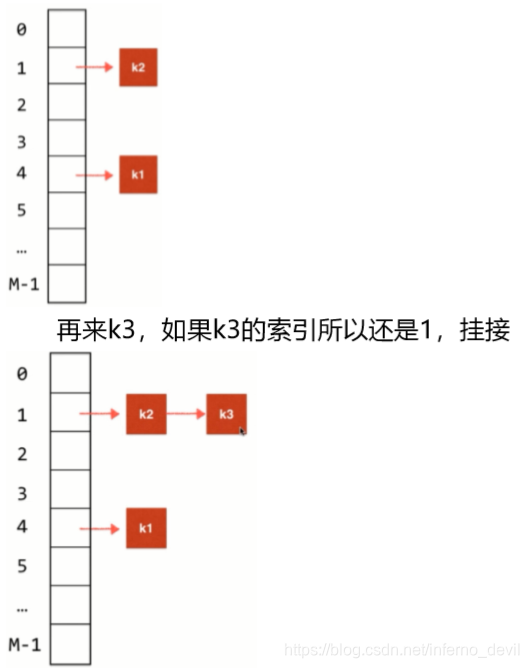
哈希表的本质就是一个数组,一个位置如果存放多个元素 使用链表挂接的方法 。
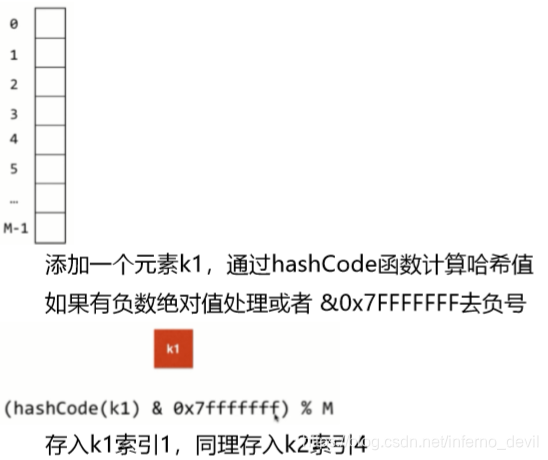
在这里插入图片描述
在这里插入图片描述
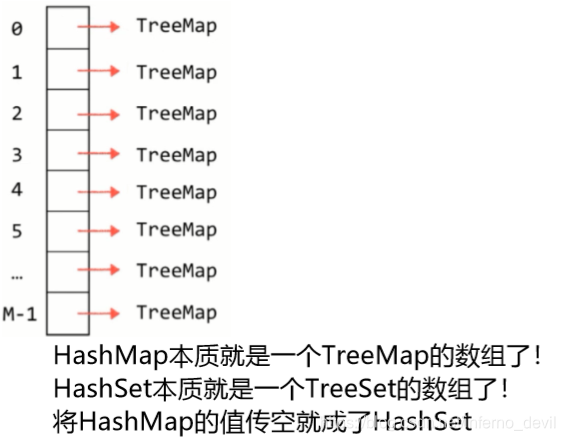
这样子的话,相当于数组中每个位置存的是一个查找表,可以是链表也可以是数组,但是这样的话,在该位置查找元素时,时间复杂度为O(n),倒不如存一颗树,红黑树即可。
在这里插入图片描述
注意:
Java8之前,每一个位置对应一个链表
Java8之后,当哈希冲突达到一定程度,每一个位置从链表转成红黑树

AI测试干货:让大语言模型稳定输出 JSON 的四种实现方案 用大语言模型做测试用例生成、数据提取时,最头疼的就是让它老老实实返回 JSON。你以为它会给你 `{"name":"张三"}`,结果它来一句"好的,这是生成结果:```json...",或者干脆在 JSON 里加注释,直接把你的 `json.loads()` 干崩溃。 模型本质上是个话痨,天生爱解释。但我们要的是结构化数据,不是聊天记录。我整理了四种实战方案,从最简单的提示词技巧到工程化框架,覆盖了从快速验证到生产环境的各种场景。 阅读详情

相关推荐

第4章 本地一键部署(新手首选)

本文介绍了OpenClaw的本地部署方法,特别适合新手用户。部署过程仅需执行一条命令,通过自动脚本完成安装和配置向导。安装完成后,用户可通过终端TUI或Web控制面板验证部署是否成功。文章还提供了常见问题的排查方法,包括端口占用、权限不足、APIKey无效和安装卡顿等情况。整个部署流程简单直观,无需手动修改配置文件,适合快速搭建使用。

eastyuxiao的专栏 195

哈希表,哈希冲突(解决的4种方法)

哈希冲突:当两个不同的数经过哈希函数计算后得到了同一个结果,即他们会被映射到哈希表的同一个位置时,即称为发生了哈希冲突。当我们的所需要存放值的位置被占了,我们就往后面一直加1并对m取模直到存在一个空余的地址供我们存放值,取模是为了保证找到的位置在0~m-1的有效空间之中。举例:就是当我们去教室上课,发现该位置已经存在人了,所以我们应该寻找新的位子坐下,这就是开放定址法的思路。存在问题:出现非同义词冲突(两个不想同的哈希值,抢占同一个后续的哈希地址)被称为堆积或聚集现象。(i会逐渐递增加1)

Ydritws的博客 3872

HttpClient vs OkHttpClient:哪个更适合你的Java项目?(附性能对比实测)

本文深度对比了Apache HttpClient与OkHttpClient在Java项目中的性能表现与适用场景。通过实际性能测试,OkHttp在连接复用、高并发吞吐量及内存占用方面表现更优,尤其适合现代微服务与Spring生态。HttpClient则凭借其高度可配置性,在需要精细控制HTTP协议细节的场景中更具优势。文章提供了清晰的选型指南,帮助开发者根据项目需求做出最佳决策。

onion的博客 510

哈希表以及哈希冲突

我们在前面讲解了TerrMap(Set)的底层是一个搜索二叉树,同时Set和Map还存在HashSet(Map)类,但是HahsMap(Set)到底是什么呢?本章来详细介绍以下。

weixin_67807492的博客 2841

2024从零开始使用VSCode编程(静态页面制作篇)HTML+CSS+JS阶段

VSCode第一个前端静态页面的编写

ssrsrrn的博客 9593

数字麦克风PDM信号采集与STM32 I2S接口应用(二)

在使用STM32的数字麦克风I2S接口时,计算采样率让人头疼,芯片手册上没有明确的说法,而手册上的计算方法经过测试却和实验不符。借助搜索引擎,大部分资料都是来自于开发板卖家或开发板论坛,主要是咪头采集然后配置WM89系列解码芯片,然后配合FatFS、MP3解码等模式,主要是讲解I2S录音、存储、放音等。外文资料得到的也寥寥无几,也没有找到讲解STM32数字麦克风配置、计算的文档。加上网上资料转载、抄袭、浅尝辄止的笔记教程,这些更是让检索大海捞针,过程艰辛一言难尽,有些网文三言两语抑或作者都没有搞清楚随手一写

XIAOYOUDUODUO的博客 6057

详细版:哈希表(Hash Table)哈希冲突及其解决方法

哈希冲突是哈希表使用中不可避免的问题,但通过合理的解决方法,可以有效地管理和缓解冲突的影响。链地址法和开放地址法是两种主要的冲突解决策略,各有优缺点,大家需要根据具体应用场景和需求选择合适的方法。希望你喜欢这篇文章!如果有更多问题,欢迎随时提问。

m0_64974617的博客 1505

idea出现 EXCEPTION_ACCESS_VIOLATION (0xc0000005) 的解决方法

idea启动的时候出现如下问题,以为没啥事,就索性关闭 后面再打开idea的时候发现直接闪退,之后打开其他软件,直接蓝屏

码农研究僧的博客 4817

哈希表、哈希冲突解决办法

我们知道,普通数组能够直接寻址,在O(1)时间内能访问到数组中的任意位置。它需要足够大的空间,为每一个关键字保留一个位置。当关键字取值的范围很大,储存空间又有限时,能不能同样用数组的形式实现O(1)查找?哈希表(Hash Table)就是这样的数据结构,当实际储存的关键字集合,比所有可能的关键字的全集小许多时,使用一个长度有限的数组去储存这些关键字,从而节省大量的空闲空间。它也被称作为散列表,因为它的键是分散存储在数组中的。如图,黄色区域为键的全集,范围为0~99,绿色区域为实际存储的键。

baboon_chen 1811

YOLOv13改进:卷积魔改 | 动态蛇形卷积(Dynamic Snake Convolution),实现暴力涨点

如何跟YOLOv13结合:替代YOLOv13的DS-C3K2

①答疑群聊服务;②YOLO大模型知识问答系统;③计算机视觉论文生成智能体; 368

RGB渐变颜色转换公式及例程

设Step=51,将RGB(255,0,0)颜色渐变为RGB(0,255,0),即RGB(255,0,0)经过51次颜色渐变转为RGB(0,255,0);设Step=51,将RGB(0,255,0)颜色渐变为RGB(0,0,255),即RGB(0,255,0)经过51次颜色渐变转为RGB(0,0,255);设Step=51,将RGB(0,0,255)颜色渐变为RGB(255,0,0),即RGB(0,0,255)经过51次颜色渐变转为RGB(255,0,0);分步骤的方式,使其渐变色循环整个颜色值;

1万+

详解哈希数据结构,手写哈希表

哈希表,终于姗姗来迟了。 本文系统讲解了哈希表数据结构的相关概念,并以HashMap为案例讲解一下它与普通哈希表的不同点,最后也手写一个简易的哈希表。 所以通过本文,我希望读者们能对哈希表有一个清楚的认识,尤其是在Java面试过程中,HashMap的相关面试题几乎是逢面必问,如果你连哈希表结构都不清楚,那真的很难从根上理解HashMap。 除了面试,在你掌握了哈希表之后也可以根据应用场景的需要,对哈希函数进行重写,以此来保证在你的应用场景下哈希分布的更加均匀。 本文概览如下: 哈希表 散列表(Hash

CRMEB小程序商城的博客 6490

一文读懂服务器带外管理

服务器带外管理(Out-of-Band Management)是指在服务器正常运行时,通过专门的管理通道对服务器进行监控、配置和控制,而无需依赖服务器的主操作系统

小熊猫的博客 6141

数据结构 | 散列表(哈希表)

​ 散列表(Hash Table),也称为哈希表,是一种根据关键码值(Key value)而直接进行访问的数据结构。它通过把关键码值映射到表中一个位置来访问记录,从而加快查找速度。这个映射函数称为散列函数,存放记录的数组称为散列表。

ROBOT_a的博客 2714

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

[一篇详解哈希表]数据结构之哈希表(散列表)

✅作者简介:大家好,我是Philosophy7?让我们一起共同进步吧!🏆 📃个人主页:Philosophy7的csdn博客 🔥系列专栏: 👑哲学语录: 承认自己的无知,乃是开启智慧的大门 💖如果觉得博主的文章还不错的话,请点赞👍+收藏⭐️+留言📝支持一下博>主哦🤞 文章目录散列表简介:为什么需要散列表?哈希函数的实现哈希表的代码 散列表 简介: 散列表又可以叫做哈希表,那什么是散列表呢? 现在就让我们深入研究一下吧 是根据关键码值(Key value)而直接进行访问的数据结构。也就是说,它通过把.

Philosophy7的博客 2406

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

C++数据结构 之 哈希表(散列表)_Hash Table

C++数据结构 之 哈希表(散列表)_Hash Table源代码只包含头文件注:需要C++11的支持

liu798675179的专栏 9817

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

数据结构—散列表(Hash table,也叫哈希表)

散列表(Hash table,也叫哈希表)是一种查找算法,与链表、树等算法不同的是,散列表算法在查找时不需要进行一系列和关键字(关键字是数据元素中某个数据项的值,用以标识一个数据元素)的比较操作。 散列表算法希望能尽量做到不经过任何比较,通过一次存取就能得到所查找的数据元素,因而必须要在数据元素的存储位置和它的关键字(可用key表示)之间建立一个确定的对应关系,使每个关键字和散列表中一个唯一的存储位置相对应。因此在查找时,只要根据这个对应关系找到给定关键字在散列表中的位置即可。这种对应关系被称为散列

heyuchang666的专栏 9048

HashSet、HashMap,散列表数据结构(哈希表)

HashSet、HashMap,散列表数据结构(哈希表) 前几天介绍了ArrayList的底层实现以及对性能的简单分析。今天再来看看HashSet,HashMap。 HashSet: 很多开发者,初学者都知道HashSet无序,不可重复,线程非同步。底层是哈希表结构。 但它是怎么做到的?什么是散列表数据结构(哈希表)?有什么特性?都清楚吗?不清楚继续往下看。 它是

Thinking_IN_Java 4869

数据结构:散列表(哈希表)

概念:     在理想情况下,散列表数据结构就是一个某种数据类型的具有固定大小的数组。在数组用于保存某一集合的数据。集合中的元素根据某种运算(散列函数)得到相应的小标。理想情况下,不同的元素对应不同的下标。如果不同的元素对应相同的下标,那么我们称这种情况为冲突。     散列函数多种多样,根据不同的情况选择不同的函数,散列函数一般有哪些,自己查课本。那么出现冲突时,有几种解决方法,这里,我们将

haizi8888的专栏 819

数据结构—————散列表(哈希表)和字典(unity)

散列表(Hash table,也叫哈希表),是根据关键码值(Key value)而直接进行访问的数据结构。也就是说,它通过把关键码值映射到表中一个位置来访问记录,以加快查找的速度。这个映射函数叫做散列函数,存放记录的数组叫做散列表。 给定表M,存在函数f(key),对任意给定的关键字值key,代入函数后若能得到包含该关键字的记录在表中的地址,则称表M为哈希(Hash)表,函数f(key)为哈希(...

纸上得来终觉浅,绝知此事要躬行 2154

数据结构——哈希表(散列表)

文章目录一,哈希表(散列表)概念二,哈希(散列)函数的构造哈希(散列)函数的构造原则构造方法平方取中法折叠法保留余数法三,冲突处理散列冲突的方法开放定址法1.线性探测法2.二次探测法3.随机探测法再散列函数法公共溢出区法链地址法四,代码实现1.哈希函数2.链表和哈希表的创建3.哈希表初始化3.从哈希表中根据key查找元素4.哈希表插入元素5.元素删除6.哈希表销毁 一,哈希表(散列表)概念 大话数据结构里面是这样介绍的: 散列表,又称为哈希表(Hash table),采用散列技术将记录存储在一块连续的存储空

m0_61705102的博客 1万+

哈希表 / 散列表数据结构

JAVA中的哈希表 / 散列表数据结构 HashMap集合底层是哈希表/散列表的数据结构 哈希表数据结构: 哈希表是一个数组和单向链表的结合体 哈希表结合了数组和单向链表的优点,查询效率和增删效率都很高 哈希表:一维数组,数组中的每一个元素都是一个单向链表 ...

qq_42843172的博客 264

js数据结构-散列表(哈希表)

散列表 散列表(Hash table,也叫哈希表),是根据键(Key)而直接访问在内存存储位置的数据结构。也就是说,它通过计算一个关于键值的函数,将所需查询的数据映射到表中一个位置来访问记录,这加快了查找速度。这个映射函数称做散列函数,存放记录的数组称做散列表。 我们从上图开始分析 有一个集合U,里面分别是1000,10,152,9733,1555,997,1168 右侧是一个10个插槽的...

weixin_43028729的博客 355

数据结构---散列表(Hash table, 哈希表)

2018.6.2            上大学时数据结构肯定学过  哈希,不过很多细节都忘了,惭愧, 最近看    “算法图解”,阅读了一下。还是梳理一下以前所学知识。                   如果用专业术语来表达的话, 散列函数就是“将输入映射到数字”。你可能认为散列函数输出的数字没什么规律,但其实散列函数必须满足一些要求。  它必须是一致的。例如,假设你输入apple时得...

游戏路上的小学生 5517

数据结构 8.散列表(哈希表)

Leetcode部分散列表(哈希表)相关练习一、散列表(哈希表)1. 散列表(哈希表)的定义2. 散列表和 LRU 缓存淘汰算法的实现2.1 实现一个基于链表法解决冲突问题的散列表2.2 实现一个 LRU 缓存淘汰算法2.2.1 LRU原理2.2.2 LRU实现8.2.3 用python实现LRU 一、散列表(哈希表) 1. 散列表(哈希表)的定义 哈希表(Hash table,也叫散列表),是根...

小蜗牛的博客 559

数据结构——散列表(Hash Table)(哈希表)

散列表 散列表英文是hashtable,经常被叫做Hash表,或者哈希表。 哈希表其实就是由数组演化而来的,利用的就是数组支持按照下标随机访问数据的特性,可以说散列表就是数组的一种扩展。 百度文库对散列表的解释: 根据关键码值(Key value)而直接进行访问的数据结构。也就是说,它通过把关键码值映射到表中一个位置来访问记录,以加快查找的速度。这个映射函数叫做散列函数,存放记录的...

qq_42006733的博客 2016
上一篇: 数据结构---图
下一篇: nowcoder刷题错题总结(1)
inferno devil
博客等级 码龄9年 54粉丝 172原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值