Python:爬取软科排名的历年所有数据

Python动态柱状图图表可视化:历年软科中国大学排行! 本来想参照:https://mp.weixin.qq.com/s/e7Wd7aEatcLFGgJUDkg-EQ搞一个往年编程语言动态图的,奈何找不到数据,有数据来源的欢迎在评论区留言。 这里找到了一个,是2020年6月的编程语言排行,供大家看一下:https://www.tiobe.com/tiobe-index/ 我们要实现的效果是: 大学排名来源:http://www.zuihaodaxue.com/ARWU2003.html 部分截图: 在http://www.zui... 阅读详情
import traceback
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.common import exceptions
import time
import xlsxwriter
import os

class ShangHaiRanking:
    __SHANGHAIRANKING_ROOT = './shranking'
    indicator_list = []
    more_indicator_cnt = 0

    def __init__(self):
        self._driver = webdriver.Chrome()

    def __initIndicatorList(self):
        self.indicator_list.clear()
        butt = self._driver.find_element_by_xpath('//*[@id="content-box"]/div[2]/table/thead/tr/th[6]/div/div[1]/div[1]/input')
        self._driver.execute_script('arguments[0].click();', butt)
        menu = self._driver.find_element_by_xpath('//*[@id="content-box"]/div[2]/table/thead/tr/th[6]/div/div[1]/div[2]/ul')\
                            .find_elements_by_css_selector('li')
        for m in menu:
            self.indicator_list.append(m.text)
        self.more_indicator_cnt = len(menu)

    #init workbook
    def __initWorkBook(self, year):
        if not os.path.exists(self.__SHANGHAIRANKING_ROOT):
            os.mkdir(self.__SHANGHAIRANKING_ROOT)
            if os.path.exists(self.__SHANGHAIRANKING_ROOT):
                print('[info]: 文件创建成功')
            else:
                print('[error]: 文件创建失败')
                exit(1)
        self.workBook = xlsxwriter.Workbook(f'{self.__SHANGHAIRANKING_ROOT}/shranking_{year}.xlsx')
        print('[info]: workbook initialized...')


    def __closeWorkBook(self):
        self.workBook.close()
        print('[info]: workbook closed...')


    #init sheet
    def __initSheet(self):
        if self.workBook == 0 or not isinstance(self.workBook, xlsxwriter.Workbook):
            print("[error]: init workbook first")
            self.close()
            exit(1)
        self.sheet = self.workBook.add_worksheet()
        #initial the table head
        self.sheet.write(0, 0, '排名')
        self.sheet.write(0, 1, '学校名称')
        self.sheet.write(0, 2, '英文名称')
        self.sheet.write(0, 3, '标签')
        self.sheet.write(0, 4, '省市')
        self.sheet.write(0, 5, '类型')
        self.sheet.write(0, 6, '总分')
        for i in range(len(self.indicator_list)):
            self.sheet.write(0, 7 + i, self.indicator_list[i])
        print('[info]: sheet initialized...')


    def recording(self, year):
        offset = 1
        url = f'https://www.shanghairanking.cn/rankings/bcur/{year}11'
        self._driver.get(url)
        time.sleep(2)
        self.__initIndicatorList()
        self.__initWorkBook(year)
        self.__initSheet()
        while True:
            table = self._driver.find_element_by_xpath('//*[@id="content-box"]/div[2]/table/tbody')
            trs = table.find_elements_by_tag_name('tr')
            curline = offset
            for tr in trs:
                tds = tr.find_elements_by_tag_name('td')
                self.sheet.write(curline, 0, tds[0].text)
                self.sheet.write(curline, 1, tds[1].find_element_by_class_name('name-cn').text)
                self.sheet.write(curline, 2, tds[1].find_element_by_class_name('name-en').text)
                try:
                    tags = tds[1].find_element_by_class_name('tags')
                    self.sheet.write(curline, 3, tags.text)
                except exceptions.NoSuchElementException:
                    self.sheet.write(curline, 3, '')
                self.sheet.write(curline, 4, tds[2].text)
                self.sheet.write(curline, 5, tds[3].text)
                self.sheet.write(curline, 6, tds[4].text)
                curline = curline + 1
            for index in range(self.more_indicator_cnt):
                curline = offset
                butt = self._driver.find_element_by_xpath('//*[@id="content-box"]/div[2]/table/thead/tr/th[6]/div/div[1]/div[1]/input')
                self._driver.execute_script('arguments[0].click();', butt)
                menu = self._driver.find_element_by_xpath('//*[@id="content-box"]/div[2]/table/thead/tr/th[6]/div/div[1]/div[2]/ul')\
                                    .find_elements_by_css_selector('li')
                self._driver.execute_script('arguments[0].click();', menu[index])
                time.sleep(0.5)
                for tr in trs:
                    self.sheet.write(curline, 7 + index, tr.find_elements_by_tag_name('td')[-1].text)
                    curline = curline + 1
            offset = curline
            try:
                self._driver.find_element_by_class_name('ant-pagination-disabled.ant-pagination-next')
                print('[processing]: {} finished...'.format(offset - 1))
                print(f'[info]: shanghairanking of {year} is finished...')
                self.__closeWorkBook()
                return
            except exceptions.NoSuchElementException:
                nextButt = self._driver.find_element_by_class_name('ant-pagination-next')
                self._driver.execute_script('arguments[0].click();', nextButt)
                print('[processing]: {} finished...'.format(offset - 1))
                time.sleep(0.5)
            except BaseException as e:
                self.__closeWorkBook()
                raise(e)


    def close(self):
        self._driver.close()


if __name__ == '__main__':
    shr = ShangHaiRanking()
    try:
    	#爬取2015年-2022年所有数据
        for i in range(2015, 2023):
            shr.recording(i)
    except BaseException as e:
        print('[error]: crashed, details are blow')
        print(traceback.format_exc(), end='')
    finally:
        shr.close()

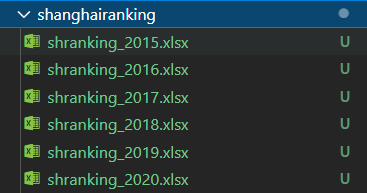
结果如下:
在这里插入图片描述

在这里插入图片描述

爬取豆瓣排名前250的电影并进行可视化分析(python) 目标:通过编写Python程序自动抓取豆瓣电影Top 250的数据,之后使用可视化技术对这些数据进行深入分析,最后将分析结果以直观的方式展示出来。意义了解当前市场上最受欢迎的电影及其特征。分析观众对于不同类型电影的喜好趋势。提供给观众,方便观众了解电影质量并做出观影选择提供给影视制作方参考,辅助决策。 阅读详情

相关推荐

Python批量采集软科/QS/THE近5年大学排名原始数据(含榜单+高校详情页)

一套即装即用的Python数据采集工具,专注获取三大国际高校排名机构的历年原始数据:软科(2017–2021共5届)、QS(2019–2022共4届)、THE(2019–2022共4届)。所有脚本基于requests纯HTTP请求实现,不依赖Selenium等浏览器驱动,运行轻量、响应快、稳定性高。每个年份和榜单单独封装为独立脚本(如2022QS_Rank.py),执行后自动生成结构化TXT文件(如2022QS_Rank.txt),字段包含学校名、排名、国家、得分、指标分项等完整信息。部分THE数据通过其官

oil88的博客 262

Selenium爬虫案例——大学排名

要爬的网站: 代码: import time import pandas as pd from selenium import webdriver def save_csv(arr, csv_filename=None): """Save the data in csv format""" if csv_filename == None: csv_filename="paiming.csv" arr_df = pd.DataFrame({'name': a.

ahc176的博客 422

【小白必看】Python爬取NBA球员数据示例

本文介绍了使用Python爬取NBA球员数据的示例代码。首先,我们设置了请求头信息和请求地址,并发送HTTP请求获取响应。然后,通过lxml库对响应文本进行解析,并使用XPath表达式提取需要的数据。最后,将结果保存到文件中。这个示例代码可以帮助读者了解爬虫的基本原理和操作步骤,同时也能够获取到有关NBA球员的数据。

全栈若城,专注知识分享 2503

爬虫实战系列(十四):中国大学软科排名数据爬取及可视化分析

说明:之前发在优快云对应的博客因为其审核标准改了,我改了下权限就不让发了,补一下我个人网站对应的博客地址:爬虫实战系列(十四):中国大学软科排名数据爬取及可视化分析。 欢迎大家访问我的个人网站,以后会在优快云和个人博客网站上同步更新内容。 ...

LW的技术小筑 3198

爬虫软科,最好大学网

request爬取软科,最好大学网,源码+详细注释

使用 C# 实现大华监控摄像头的控制与数据处理

本文介绍了使用C#调用大华SDK(DHNetSDK.dll)开发监控系统的方法。主要内容包括:开发准备、DLL引用设置、SDK初始化与设备登录、视频预览窗口嵌入、云台控制、抓图录像等核心功能实现。通过P/Invoke技术封装SDK接口,开发者可以快速构建具有视频监控、设备控制功能的C#应用程序。文中还提供了代码示例、常见问题解决方案,以及视频帧智能分析的扩展建议,为开发大华监控系统的二次应用提供了完整的技术指南。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 1275

嵩天《Python网络爬虫与信息提取》实例2:中国大学排名定向爬虫

爬取目标:爬取上海软科官网提供的中国最好大学排名,并在IDLE页面打印输出大学名称、排名、省市、总分信息 相关库名:requests/BeautifulSoup

weixin_43095088的博客 2511

【Creator】cocoscreator 2.4 apk还原为工程 (1)

Cocos Creator 2.4 还原图片 meta文件

jokesuser的博客 2259

【Python爬虫】爬取2022软科全国大学排行榜

目录 1.任务要求2.网络爬虫实现原理3.系统设计与代码实现3.1 第一题3.1.1 最初设计方案:采用request+BeautifulSoup 方式3.1.2 更改后的设计方案:采用request直接获取json格式的html信息。3.2 第二题3.2.1 流程图 3.2.1 代码3.3 第三题3.3.1 流程图 3.3.2 代码4.运行结果4.1 第一题4.2 第二题4.3 第三题5.结果评价6.不足和改进之处访问网址https://www.shanghairanking.cn/rankings,爬取

m0_67463447的博客 9663

从桨叶设计到电机匹配:手把手教你调出无人机最佳动力组合

本文系统介绍了无人机动力系统的核心匹配原则,重点解析了如何通过测试与数据分析,优化螺旋桨与电机的组合,从而显著提升系统力效与续航。文章提供了从参数解读、实战测试到深度调优的完整指南,帮助开发者解决电机过热、推力不足等常见问题,实现无人机性能最大化。

weixin_29305313的博客 235

告别密码烦恼:用Windows Server NPS给公司Wi-Fi和有线网加一道MAC地址白名单(附H3C交换机配置)

本文详细介绍了如何利用Windows Server NPS(网络策略服务器)与H3C交换机实现MAC地址白名单认证,为企业Wi-Fi和有线网络提供零密码安全方案。通过配置NPS服务器、网络策略及H3C交换机联调,实现无感知认证体验,降低运维负担,同时满足审计追溯需求。适用于中小企业网络管理,提升安全性与便捷性。

weixin_42535703的博客 367

获取中国大学排名相关信息的爬虫实例

由于大学排名是一个典型的二维数据,因此,采用二维列表存储该排名所涉及的表单数据。第二,分析网页内容并提取有用数据到恰当的数据结构中;第三,利用数据结构展示或进一步处理数据。第一,从网络上获取网页内容;

m0_74972727的博客 1680

AI Agent 架构的底层原理与核心机制

AI Agent五层架构实现智能闭环运转:1)感知层负责多模态信息输入与预处理;2)记忆层分类存储短期/长期记忆及知识库;3)认知层通过ReAct推理和反思机制进行决策规划;4)工具层调用外部API扩展能力边界;5)执行层完成任务输出并形成反馈闭环。五层架构通过"输入-处理-输出-优化"的联动机制,使Agent具备自主决策、持续学习和任务执行能力,突破传统LLM的局限,实现从信息处理到实际落地的完整智能体系。

女王の专属领地 494

数据可视化(六):Pandas爬取NBA球队排名、爬取历年中国人口数据、爬取中国大学排名、爬取sina股票数据、绘制精美函数图像

数据可视化(六):Pandas爬取NBA球队排名、爬取历年中国人口数据、爬取中国大学排名、爬取sina股票数据、绘制精美函数图像 目录 数据可视化(六):Pandas爬取NBA球队排名、爬取历年中国人口数据、爬取中国大学排名、爬取sina股票数据、绘制精美函数图像 1. 爬取NBA球队排名页面,并进行分析 2. 爬取以下网址的历年中国人口数据进行并进行分析 3. 获取大学排名数据并进行分析 4. 获取sina股票数据并进行分析 5. matplotlib模仿绘图 6. matplotlib模仿绘图

m0_60732994的博客 1903

【即插即用模块】Transformer篇 | CVPR 2025 | D2T:双域特征融合,完美适配缺陷检测/小目标检测和分割等频域细节敏感的任务!

本文提出了一种基于小波和原型增强的双域Transformer(WPFormer)用于像素级表面缺陷检测。该模型通过Dual-domain Transformer (D2T)模块融合频域和空间域特征:小波增强交叉注意力(WCA)分解高低频特征并加权平衡,增强缺陷细节捕捉;原型引导注意力(PCA)生成全局原型向量强化关键信息聚合。实验表明,该模块在缺陷检测任务中性能优于现有方法,通过频域细节增强和全局依赖建模有效提升了复杂场景下的检测效果。代码已开源,适用于对频域敏感的目标检测和分割任务。

主要更新底层视觉(去噪、超分等)相关的科研内容,形式为【论文精读】+【论文复现】 1374

【FPGA教程案例100】深度学习1——基于CNN卷积神经网络的手写数字识别纯Verilog实现,使用mnist手写数字数据库

MNIST 数据库有一个 60,000 示例的训练集,还有一个 10,000 示例的测试集。这些数字已在大小方面规范化,在固定大小的图像中居中。如下图所示:我们任意选择0~9是个数字,将其转化为数字:0_0.txt1_0.txt2_0.txt3_0.txt4_0.txt5_0.txt6_0.txt7_0.txt8_0.txt9_0.txt。

FPGA/MATLAB学习教程/源码/项目合作开发 7824

python爬取全球历年GDP数据

python爬取全球历年GDP数据并以两种方式写入excel

m0_67790374的博客 4654

【企业智能体开发】优化模型成本、延迟与失败降级

小林的培训快开始时,服务台花很久“思考最优回答”,体验并不会更好。反过来,为了省钱而始终选最轻的模型,若连房间、连接方式和任务状态都识别不稳,后续错误检索和重复建单会造成更大代价。企业 Agent 的优化对象不是单次模型调用价格,而是任务在可接受时间内、安全地推进到正确结果的总成本。

Mr数据杨 893

用scrapy框架爬取历年电影排名和出版

Scrapy简介 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架。 Scrapy入门请看官方文档:scrapy官方文档 本爬虫爬取的是电影排名与放映时间和评分 成果图如下: 整体思路 1、新建项目和爬虫文件2、编写test1文件和main.py代码 3、修改middlewares.py/编写piplines.py 4、修改settings,items文件代码 5、启动 1.新建项目和爬虫文件 2.编写imdb.py文件 注意理解注释。 from y...

weixin_56749456的博客 989

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

用Python爬取GDP数据

废话少说,直接上代码,然后再详细介绍构造过程。 代码 import urllib.request import re import pandas as pd import time def getdata(url): req=urllib.request.Request(url) req.add_header('User-Agent',' Mozilla/5.0 (Windows NT 6.3; Win64; x64) AppleWebKit/537.36 (KHTML, like Gec

weixin_45723705的博客 5443

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

Python爬虫实战:从大学排名数据抓取到分析可视化的完整项目指南

网络爬虫作为数据采集的核心技术,其原理是通过模拟浏览器行为自动抓取网页信息,实现数据的自动化获取。这项技术在数据驱动决策的时代具有重要价值,广泛应用于市场分析、学术研究和舆情监控等场景。在Python生态中,requests库和BeautifulSoup是构建基础爬虫的常用工具,而pandas则为后续的数据处理与分析提供了强大支持。本文聚焦于一个结合了数据采集、清洗、存储与分析全流程的实战案例——中国大学排名数据爬取项目。该项目不仅涉及反爬策略应对、JSON/HTML数据解析等关键技术点,还通过pandas

weixin_29051245的博客 933

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

Pyhton可视化(1): 历年中国大学学术排行榜

摘要::最近在朋友圈看到一个很酷炫的动态数据可视化表,介绍了新中国成立后各省GDP的发展历程,非常惊叹竟然还有这种操作,也想试试。于是,照葫芦画瓢虎,在网上爬取了历年中国大学学术排行榜,制作了一个中国大学排名Top20强动态表。 由于本文中含有一些超链接,微信中无法直接打开,所以建议点击最左下角阅读原文阅读,体验更好,也可以复制链接到浏览器打开: https://www.makcyun.top...

zhusongziye的博客 805

requests,BS4 爬取2016-2019中国大学排名并存储为csv格式文件

最好大学网url: http://www.zuihaodaxue.com/zuihaodaxuepaiming2016.html http://www.zuihaodaxue.com/zuihaodaxuepaiming2017.html http://www.zuihaodaxue.com/zuihaodaxuepaiming2018.html http://www.zuihaodaxue.co...

qq_41829386的博客 1869

基于BeautifulSoup库的简易爬虫实现:以大学排名为例

本实验成功实现了对软科中国网站大学排名数据的自动化采集,掌握了网络爬虫的基本原理和实现方法。通过本次实验,加深了对HTML解析、数据提取和存储的理解,提高了Python编程能力和实际问题解决能力。特别是针对特定院校(广东财经大学)的排名变化分析,体现了数据采集的针对性和实用性。可改进之处:可增加数据去重和清洗功能;可添加进度显示功能,方便监控爬取过程;可考虑使用数据库存储替代CSV文件;可增加异常重试机制,提高数据完整性。

2202_75369126的博客 1541

requests+BeautifulSoup入门——爬取2015-2020年中国大学排名并写入csv文件中

requests作为python第三方库,为用户爬取网页内容省下很多力气 BeautifulSoup同样也是python第三方库,它可以将用requests获取到的网页内容美化,也就是做成一碗“美味的汤” 目标:爬取2015年-2020年中国大学排名并写入csv文件中 思路:利用requests获取网页内容,再利用beautifulsoup对爬到的网页做处理,最终得到想要的数据 废话不多说,现在就开始做 首先找到我们要爬取的网页地址:https://www.shanghairanking.cn/ 点.

qq_46146608的博客 2232
上一篇: Linux虚拟内存与线性地址翻译
下一篇: 硬核解析Linux文件系统底层【VFS文件系统】
Hack Rabbit
Hack Rabbit 新星创作者: 运维技术领域 新星创作者: 运维技术领域
博客等级 码龄9年 2893粉丝 67原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

Hack Rabbit

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值