实测 HeyGem AI:本地数字人效果炸裂,但“开源”没那么简单!附超详细一键部署教程

AI摘要

本文对HeyGem AI数字人项目进行深度实测。其生成的数字人视频效果出色,但资源占用高,对显卡显存要求大。作者提供一键部署教程,解决安装难题。此外,该项目所谓“开源”多为前端,核心技术未开放。最后给出使用建议,供不同需求者参考。

大家好,我是 annus mirabilis。

俗话说得好,可以不懂人情世故,但不能不懂AI。这句话在当今这个时代,我觉得尤其适用。AI 浪潮汹涌澎湃,新技术层出不穷,稍不留神就可能被拍在沙滩上。而在 AI 的众多应用中,数字人无疑是最近风头最劲、也最引人关注的一个领域。它不仅能解放生产力,甚至能创造全新的内容形式和交互体验。
这不,最近有一个号称“硅基开源”的 HeyGem AI 数字人项目在圈子里传得火热。听闻效果惊人,而且还能在本地部署,这一下子就勾起了我的好奇心。作为数字人领域的“老兵”(姑且这么自称吧,哈哈),我可不能错过这么好的“玩具”。

于是,我马不停蹄地把它拿来进行了深度实测和研究。效果究竟如何?跑起来吃不吃配置?最关键的部署流程是不是像传说中那么复杂?以及,它号称的“开源”到底有几分真假?这些都是大家关心的问题,也是我 annus mirabilis 在这篇文章里将要为大家一一揭晓的秘密。

在本篇文章中,我将带大家走过一个完整的 HeyGem AI 体验旅程:

  1. 先看效果硬不硬:直接展示我用它生成的数字人视频,眼见为实。

  2. 再测资源吃不吃:详细分析运行它所需的硬件配置,特别是大家最关心的显卡占用情况。

  3. 手把手教你部署:分享我 annus mirabilis 独家整理的“一键部署”方法,让复杂的安装变得像“大象装冰箱”一样简单。

  4. 最后揭秘“开源”:深入剖析 HeyGem AI 的技术架构,聊聊它究竟“开源”了什么,又“藏着”什么。

话不多说,咱们直接进入正题!

一、惊艳初见:HeyGem AI 数字人效果实测

任何工具,效果好才是硬道理。在我 annus mirabilis 看来,一个数字人工具的优劣,最直观的体现就是它生成的视频是否自然、逼真。

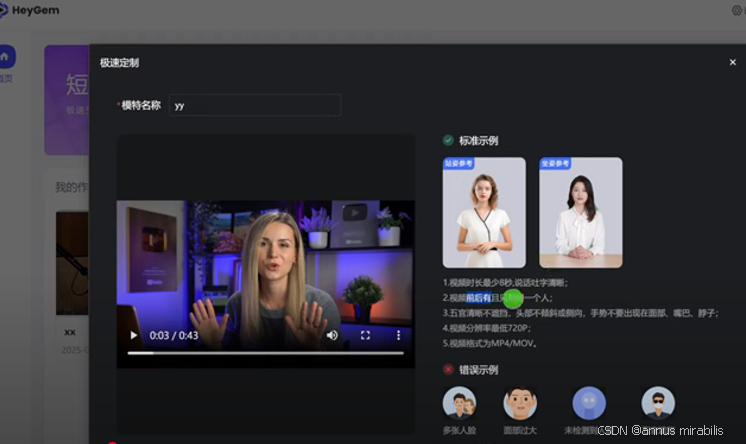
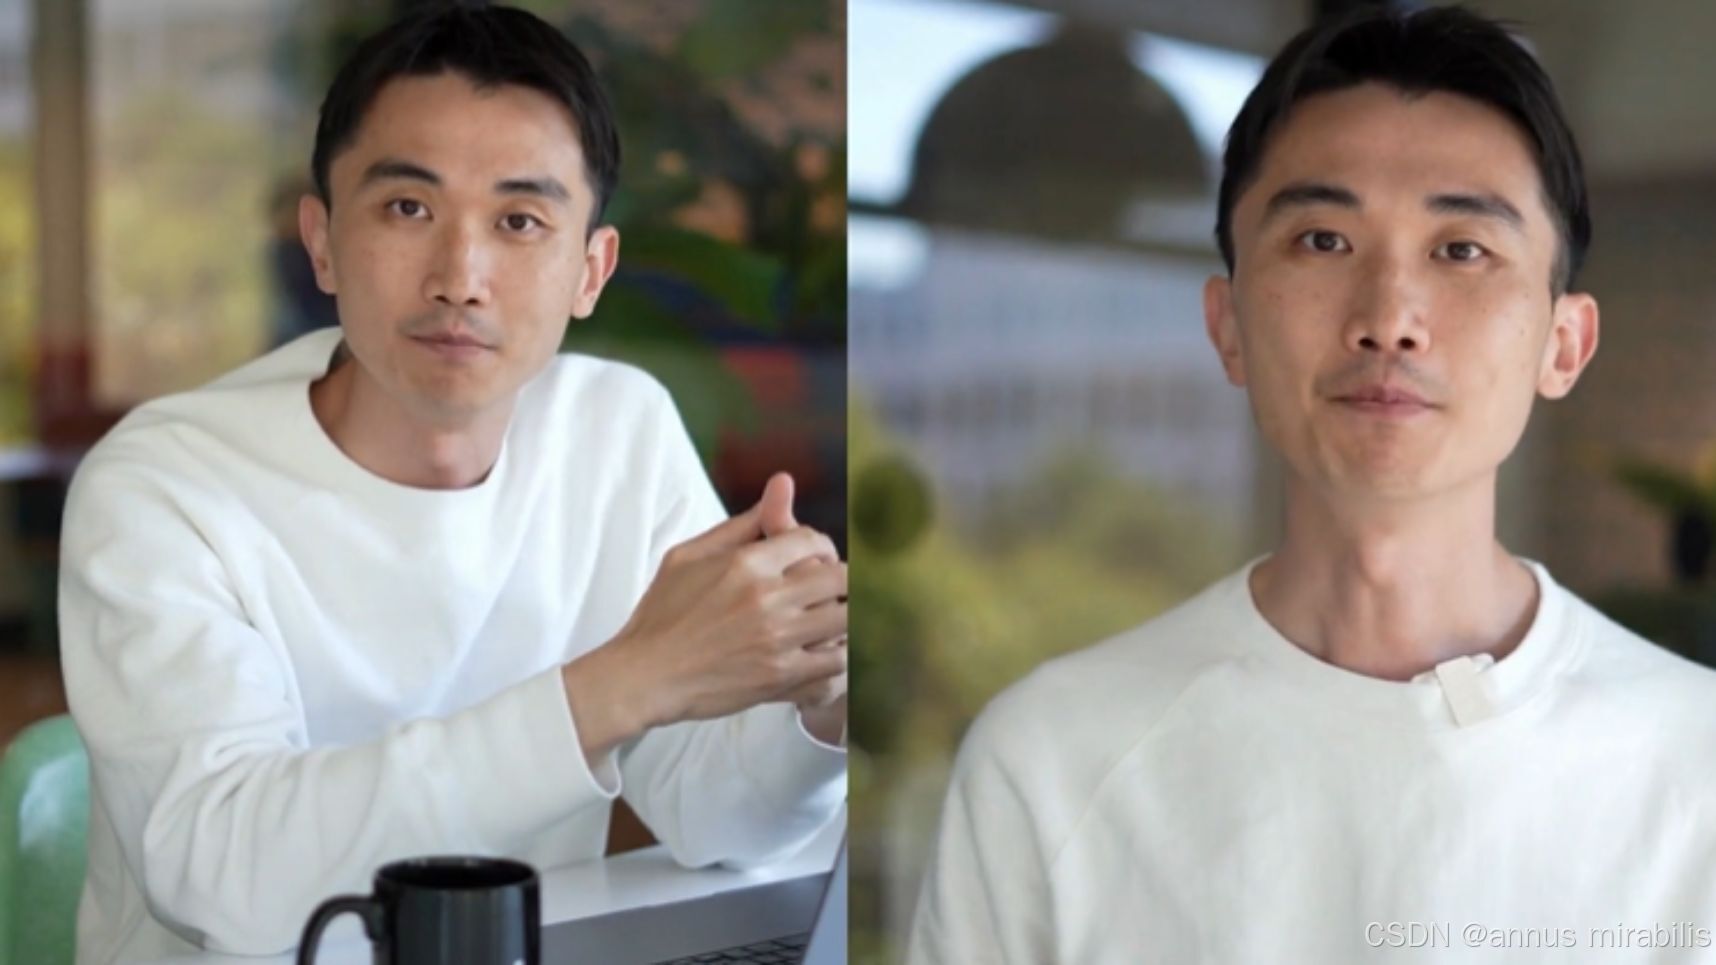
我首先导入了一段我自己的原始视频素材。这段视频时长超过了 HeyGem AI 要求的最短 8 秒限制,画面也比较清晰,符合它对模特视频的要求。说实话,这原始视频嘛,就是普通的记录,没什么特别之处。

接着,我利用 HeyGem AI,基于这段原始素材生成了一段新的数字人视频。当我第一次看到生成结果时,说实话,心里是“咯噔”一下——哇塞,效果确实超出预期!
对比原始视频,数字人视频中的我(或者说我的数字分身)嘴型与新的语音内容(我输入了一段新的文本让它去合成)完美匹配,面部的细微表情也能跟着语气的变化而联动。眼神、头部的小动作都显得很自然,不像一些低质量数字人那样显得僵硬或呆板。听觉上,合成的语音也相当流畅自然,几乎没有明显的机器感。

在我 annus mirabilis 过去接触过的许多号称“开源”或半开源的数字人项目中,达到这种级别的效果的,HeyGem AI 绝对是目前我所见到的第一家。它在效果上,确实立住了脚跟。

当然,这里我已经在心里给它的“开源”属性打了个问号,这个问号我们在文章的最后一部分会详细解答。但从纯粹的效果层面讲,HeyGem AI 的表现是令人满意的。

二、能跑起来吗?资源占用深度解析

效果再好,如果“吃”的资源太多,让大多数人的电脑望而却步,那也意义不大。所以,效果看完,我 annus mirabilis 立刻把注意力转向了它的资源占用情况。这是大家普遍关心的问题:我的电脑到底能不能跑得动?跑起来流畅不流畅?

在使用过程中,HeyGem AI 的运行架构是这样的:它有一个你直接操作的“前端”程序,就像一个漂亮的驾驶舱;而真正干活的“后端”则有三个服务在默默运行,它们是数字人生成的“发动机”和“变速箱”。我们主要观察的就是这三个后端服务工作时的资源消耗。

我分别在定制模特和生成视频两个关键环节观察了系统的资源管理器。
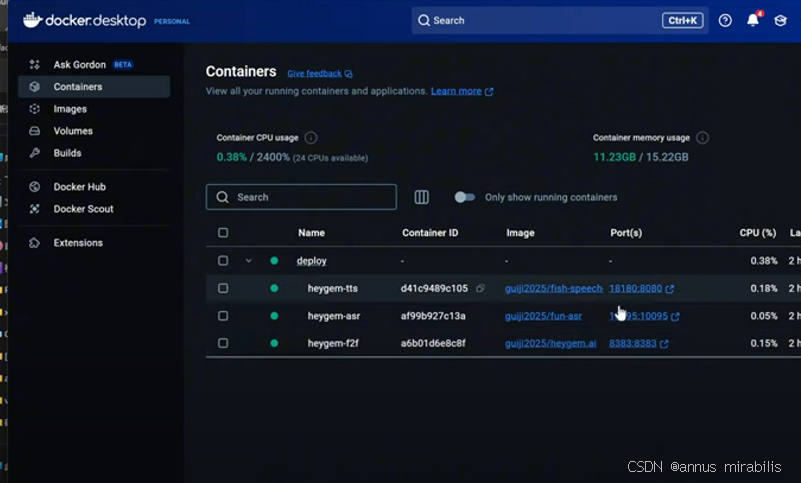
  1. 定制模特阶段:
    当你上传视频素材,让它去“学习”生成你的数字分身模型时,这个阶段的资源占用并不高。主要是文件上传、初步分析等任务,对 CPU、内存和 GPU 的压力都相对较小。这是一个“准备”过程,机器配置稍弱一点也不用担心。

  2. 生成视频阶段 (核心!):
    这才是真正“见真章”的时候。当你输入文本或音频,点击“生成视频”的那一刻起,系统的资源占用就开始攀升了。

    • 内存 (RAM): 在我的测试中,总共 32GB 的内存,它大概占用了 18GB 左右。这说明 HeyGem AI 在生成过程中会使用相当一部分内存来加载数据和中间结果。如果你只有 8GB 或 16GB 内存,可能需要关闭一些其他程序,确保内存充足。16GB 勉强够用,32GB 更稳妥。

    • CPU: 令人意外的是,CPU 在整个生成过程中并非主要瓶颈,占用率并不持续处于高位。大部分繁重的计算任务,都交给了另一个硬件。

    • GPU (显卡,划重点!): 这才是 HeyGem AI 的“动力心脏”,也是决定你能否流畅运行、甚至能否运行的关键!

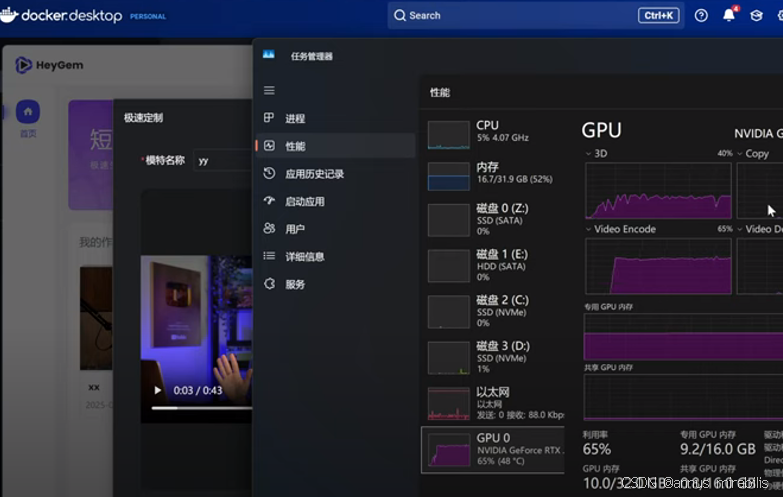
      • 在视频合成过程中,GPU 的利用率会显著飙升。我观察到,它的计算过程似乎是分批次的,比如每处理几帧画面,GPU 利用率就会上来一下,然后再稍微回落,呈现出一种波动的状态。这是因为后端服务在进行人脸检测、特征提取、画面合成、人脸增强等一系列复杂的图形学和 AI 计算。

      • 更重要的是 GPU 的显存 (VRAM) 占用。在我使用的 16GB 显存显卡上,我看到显存占用峰值大约在 10GB 到 13GB 之间波动。这个数据非常关键!

      • 结论: 这意味着,HeyGem AI 对显卡显存的要求是比较高的。如果你有一块显存达到 16GB 的独立显卡(比如 RTX 4060Ti 16G、RTX 3090、RTX 4080 等),跑起来会相对流畅,生成速度也更快。如果是12GB 显存的显卡(比如 RTX 3060 12G、RTX 4070 等),可能需要根据具体视频长度和分辨率来看,有时候可能会遇到显存不足导致的生成失败或速度极慢的情况。显存低于 12GB 的显卡,我annus mirabilis 觉得,可能就比较困难,甚至无法正常运行了。

    生成速度方面,在我配置还不错的机器上(使用 RTX 4060Ti 16GB 显卡进行测试),生成视频的时长与实际耗时比,大约在 1:4 到 1:8 之间。也就是说,生成一分钟的数字人视频,可能需要四到八分钟。这个速度取决于你的硬件性能,特别是显卡性能。

    所以,总结一下硬件需求:内存建议 16GB 或以上,CPU 要求不高,但显卡必须给力,特别是显存,强烈建议 16GB 及以上,最低也得是 12GB 显存的型号。 如果你的显卡显存达不到这个标准,那么即使你对 HeyGem AI 再感兴趣,可能也只能先“持币观望”或者考虑升级硬件了。

三、告别复杂:annus mirabilis 的一键部署秘籍

了解了硬件要求,接下来就是最让许多小伙伴头疼的问题:怎么把这个 HeyGem AI 装到我自己的电脑上跑起来?官方的部署文档,对于不熟悉 Docker、命令行操作的小白用户来说,确实像看天书一样晦涩难懂。各种环境配置、依赖安装、服务启动,每一步都可能隐藏着无数的“坑”。

不过别担心!我 annus mirabilis 出马,当然是要把复杂的事情简单化。我已经为大家整理好了一个“懒人包”,并且编写了一个超简单的“一键部署”脚本。只要跟着我的步骤来,把“大象装冰箱”这件事,轻松搞定!

就像把大象装进冰箱只需要三步一样,把 HeyGem AI 部署到你本地,跟着我 annus mirabilis 的方法,也只需要简单的三步:

第一步:获取 annus mirabilis 的 HeyGem AI 懒人包

首先,你需要下载我 annus mirabilis 为大家精心准备的 HeyGem AI 资源包。这个包里包含了所有必需的文件:

  • HeyGem AI 前端程序安装包 (一个 .exe 文件)

  • Docker Desktop 安装包 (用于运行后端服务)

  • 三个 HeyGem AI 后端服务的 Docker 镜像文件 (体积庞大!)

  • 我的“一键部署”脚本文件 (init_base.bat)

  • 一份简单的图文说明文档

这些资源文件总体积不小,特别是 Docker 镜像,加起来几十个 GB 是跑不掉的。所以下载需要一些时间和耐心,并且确保你有足够的硬盘空间来存放它们。

资源包的下载链接,我通常会放在这篇文章的评论区或者我的个人官网上对应的文章页面,大家去那里找就好了。

第二步:安装 Docker Desktop 并导入后端服务镜像

这是最关键的一步,也是我 annus mirabilis 用“一键脚本”为大家解决最大难题的地方。

  1. 安装 Docker Desktop: 打开资源包,找到 Docker Desktop Installer.exe 文件,双击运行,像安装普通软件一样把它装上。过程中如果需要重启电脑,按提示操作即可。

    • 安装验证(可选但推荐): 安装完成后,打开系统的命令提示符 (CMD) 或 PowerShell。最好是在你存放 annus mirabilis 资源包的那个文件夹里打开终端。怎么打开呢?最简单的方法是,进入存放资源包的文件夹,然后在文件管理器的地址栏里输入 cmd 或 powershell,回车,终端窗口就会在你当前目录下打开。在终端里输入 docker --version 回车,如果看到类似 Docker version XX.YY.Z, build ... 的输出,就说明 Docker 安装成功了。别担心,即使你不手动检查,我的一键脚本也会帮你检查。

  2. 运行 annus mirabilis 的一键部署脚本 init_base.bat:

    • 确保你当前在存放资源包的那个文件夹里(如果你按照上一步的方法打开的终端,那就在正确位置)。

    • 直接双击运行 init_base.bat 这个文件,或者在刚才打开的终端中输入 init_base.bat 回车。

    • 脚本会自动执行:首先检查 Docker 环境是否就绪,然后会自动加载资源包里的三个 HeyGem AI 后端服务的 Docker 镜像。

    • 耐心等待: 这一步需要一些时间,因为脚本正在将几十 GB 的镜像导入 Docker。请耐心等待,直到脚本运行完毕并提示成功。

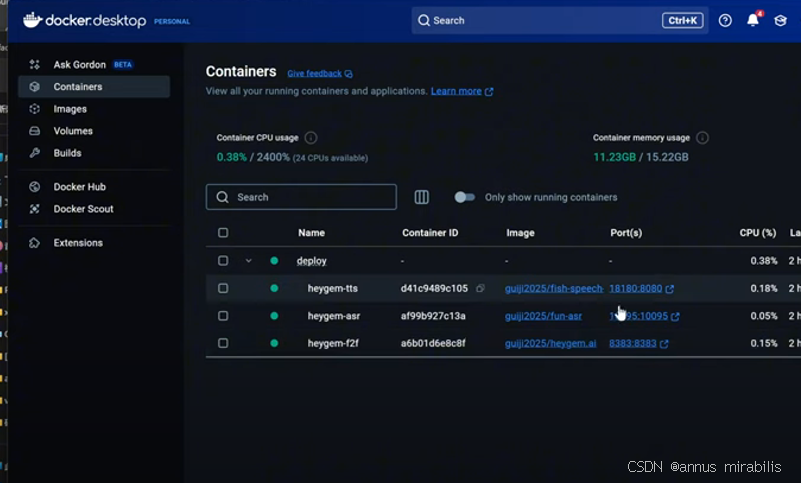
  3. 验证后端服务是否正常运行:

    • 打开 Docker Desktop 程序。

    • 在左侧或顶部的菜单中找到 Containers (容器) 或 Images (镜像) 选项。

    • 你应该能在 Containers 列表中看到三个名字类似 tts, asr, f2f 的容器正在运行中(状态显示为 Running)。如果都显示 Running,恭喜你,后端服务已经部署成功并启动了!

    【特别注意!硬盘空间问题!】

    这里有一个非常重要的细节,我 annus mirabilis 必须强调一下:Docker 默认会将下载和导入的镜像文件以及容器产生的数据存储在系统盘,通常是 C 盘!前面说了,这三个后端服务的镜像文件体积巨大,加起来轻轻松松几十个 GB。如果你像我一样,C 盘空间比较紧张(比如很多笔记本电脑的 C 盘只有 256GB 或 512GB SSD,系统和常用软件装完就没剩多少了),务必在运行一键脚本之前,更改 Docker 的数据存储路径!如何更改 Docker 数据路径: 打开 Docker Desktop 程序 -> 点击右上角的设置齿轮图标 (Settings) -> 在左侧菜单选择 Resources (资源) -> 找到 Disk image location (磁盘镜像位置) 或 Docker data folder 类似的选项 -> 点击 Browse (浏览) -> 选择一个空间充足的硬盘分区作为 Docker 的数据存储目录 -> 点击 Apply & Restart (应用并重启)。

  4. 完成这一步后再运行我的 init_base.bat 脚本,这样那些大体积的镜像文件就会乖乖地存到你指定的新位置,不会挤爆你的 C 盘了!这个小技巧,能帮你避开一个巨大的“坑”。
第三步:安装 HeyGem AI 前端程序并启动

前两步搞定,剩下的就很轻松了。

  1. 安装前端程序: 打开资源包,找到 HeyGem AI 的安装程序文件 (比如 HeyGem 1.03.exe),双击运行,按照提示一步步安装即可。这个程序本身不大。

  2. 启动程序: 安装完成后,在桌面或开始菜单找到 HeyGem AI 的图标,双击启动。

启动后的 HeyGem AI 界面,最初会是空白的模特列表和作品列表。这是正常的,因为你还没有添加任何模特或创建作品。接下来,你就可以按照前面“效果实测”部分提到的使用流程,点击“快速定制”上传你自己的视频来创建模特,然后选择模特和文本/音频来生成你的第一个数字人视频作品了!

看吧,在我 annus mirabilis 的这套“组合拳”下,原本复杂的部署过程是不是变得异常简单?基本上就是安装两个程序,然后运行一个脚本等一会儿。只要你的硬件达标,按照这个流程来,成功率会大大提高。

如果你在部署或使用过程中遇到任何问题,别犹豫,欢迎在评论区留言提问。我会尽力帮助大家。

四、剥开“开源”外衣:HeyGem AI 的技术真相

好了,我们已经看过了 HeyGem AI 的效果,了解了它的硬件胃口,也掌握了部署它的“懒人包”秘籍。现在,是时候来聊聊它身上最引人注目的标签——“开源”。HeyGem AI 声称是“硅基开源”项目,那么,它到底“开源”了多少?核心技术是否真的开放了?作为一名对技术实现充满好奇的探索者,我 annus mirabilis 对此进行了深入的分析。

我的结论是:HeyGem AI 的“开源”,更多是“部分开源”或“UI 开源”,其最核心、最关键的技术部分,目前并没有真正开放源代码。

让我们来详细分析一下:

  1. 它“开源”了什么?
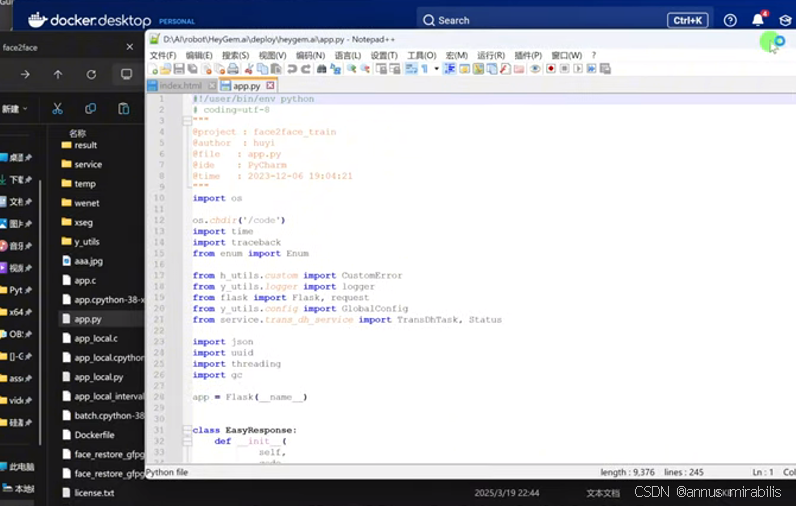
    经过我的研究,HeyGem AI 确实开源了一部分代码,但这部分主要集中在它的前端程序(也就是我们直接操作的那个 UI 界面)。这意味着,你可以看到那个图形界面的源代码,了解它是如何设计界面的、如何接收用户的点击和输入、如何组织这些信息,以及如何通过网络请求与后端服务进行通信的。这部分代码对于开发者来说,可以学习界面的交互逻辑,甚至可以尝试修改界面风格或增加一些自动化操作。

    但这部分 UI 代码,就像汽车的仪表盘和中控系统,它负责接收你的指令并显示信息,但它本身并不驱动汽车前进。生成数字人视频这种繁重的计算和合成工作,完全是由后端服务完成的。

  2. 它“隐藏”了什么?
    HeyGem AI 的核心技术,全部封装在了它那三个在 Docker 中运行的**后端服务(TTS、ASR、F2F)**里。

    • TTS 服务 (Text-to-Speech,文本转语音): 这个服务负责将你输入的文本转换成语音。根据我的初步分析,它可能使用了像 Fish Audio 这样的语音合成引擎作为基础,并可能在其上进行了改良和优化,以达到更好的语音效果。Fish Audio 本身也是一个不错的开源语音合成项目,擅长生成带有情感和语气的语音。

    • ASR 服务 (Automatic Speech Recognition,自动语音识别): 这个服务负责将音频转换成文本。在 HeyGem AI 中,它主要用于分析你上传的原始模特视频中的语音,提取出对应的文本,作为后续模型学习和对齐的基础。它可能使用了如 FunASR 等成熟的语音识别框架。ASR 技术本身也相对成熟,市面上有很多优秀的开源或闭源方案。

    • F2F 服务 (Face-to-Face 或 Figure-to-Figure,面部/人物生成): 这才是 HeyGem AI 最核心、最具价值的部分! 它负责接收处理过的原始视频信息、识别出的文本以及合成的语音,然后将这些信息结合起来,生成最终的数字人视频画面。

    当我尝试深入查看 F2F 服务内部的技术细节时,我发现它的核心代码是被高度保护的。组成这个服务的程序,很多都是被编译过的二进制文件,比如在 Windows 系统下可能是 .dll 文件,在 Linux 下可能是 .so 文件。这些文件是机器可执行代码,不是人类可读的源代码!这意味着,你无法看到它内部是如何实现人脸对齐、表情迁移、嘴型同步、背景融合、画面增强等一系列复杂算法的。

    虽然在它的依赖库中,我 annus mirabilis 看到了一些熟悉的名字,比如 GFP-GAN(这是一个很强大的人脸修复和增强工具),也检测到了人脸识别相关的组件。这些都印证了它确实使用了先进的图像处理和深度学习技术。我甚至大胆猜测它可能使用了某个特定的核心生成模型(比如我怀疑是“hello”模型,但这仅仅是基于一些零散信息和文件结构的推测,没有任何确切证据),但模型是如何训练的,具体的网络结构是什么样的,生成视频的完整流水线是怎么设计的,这些最核心的“Know-how”,都被严严实实地“藏”在了那些编译后的文件中,完全没有开源。

  3. 为何称“开源”,却又隐藏核心?
    在我 annus mirabilis 看来,这种“半开源”或者说“前端开源,核心闭源”的策略,在商业上是非常常见的。核心技术是公司的立身之本,“吃饭的家伙”,轻易不会完全开放。而开放一个易于使用的前端界面,让大家能够简单体验到其强大效果,是一种非常聪明的市场推广手段。

    通过让用户免费在本地运行,HeyGem AI 可以迅速扩散影响力,吸引大量用户关注。用户亲身体验到效果后,可能会对背后的技术产生兴趣,甚至在商业应用场景下,考虑购买其提供的更稳定、更便捷的商业服务(比如云端 API 调用、企业级解决方案等)。这种策略,既展示了技术实力,又保护了核心资产,同时还能吸引潜在的商业客户,一举多得。

    所以,虽然它号称“开源”,从纯技术的“源代码开放”角度看,它并没有完全做到。但从推广和普及的角度看,这种开放一部分代码、提供本地体验的方式,已经大大降低了用户接触和试用数字人技术的门槛,具有积极意义。
五、价值与局限:我的最终评价与建议

聊到这里,我们对 HeyGem AI 已经有了比较全面的了解。

它的价值:

  • 效果出众: 在目前我接触到的本地可部署的数字人方案中,HeyGem AI 的生成效果绝对是顶尖水平,达到了商用级应用的门槛。

  • 提供本地化方案: 能够在本地运行,摆脱了对云服务的依赖,对于需要处理敏感数据或者希望无限量使用的用户来说,非常有吸引力。

  • 降低体验门槛: 即使其核心未开源,但提供了免费可用的前端和后端镜像,配合我 annus mirabilis 的“一键部署”脚本,大大降低了普通用户体验高质量数字人技术的难度。

它的局限:

  • 非完全开源: 最核心的生成技术并未开放,限制了技术爱好者对其进行二次开发和深度定制的可能性。

  • 硬件要求高: 对显卡显存的要求是硬门槛,不是所有人的电脑都能跑得动。

  • 软件稳定性与流程: 作为一个相对较新的工具,前端程序可能存在一些小 Bug(比如前面提到的刷新问题),而且其内置的流程(如手动创建模特、手动生成作品)对于需要批量处理的用户来说不够自动化和便捷。

annus mirabilis 的建议:

如果你:

  • 对数字人技术充满好奇。

  • 拥有一块16GB 及以上显存的独立显卡(12GB 显存可以试试,但可能不稳定)。

  • 希望免费体验并生成高质量的本地数字人视频。

  • 不介意手动操作单个视频的生成流程。

那么,HeyGem AI 绝对值得你尝试!按照我 annus mirabilis 提供的一键部署方法,你可以很快把它跑起来,亲身体验它的魔力。

如果你:

  • 显卡显存不足。

  • 需要批量生成大量数字人视频。

  • 希望有更自动化、更流畅的工作流程。

  • 或者对数字人技术有更深入的二次开发需求。

那么,HeyGem AI 的当前版本可能不太适合你。你可以先关注它未来的发展,或者寻找其他更符合你需求的方案(比如我 annus mirabilis 之前分享过的 auto Robot 项目,就是偏向自动化的方向,虽然效果可能略逊于 HeyGem AI,但流程更适合批量生产)。

相关推荐

Chaos Volume Trend 指標使用說明

ChaosVolumeTrend交易指标结合成交量加权、混沌趋势线和AI算法,提供多空交易信号。主指标通过价格突破趋势线判断入场时机,采用1.618斐波那契比例分步止盈,同时支持回调和挂单策略。副图ChaosMACD指标通过布林带挤压算法识别趋势起始,结合超买超卖信号辅助决策。系统支持突破报警、量能异常报警等功能,推荐在2H/4H周期使用,强调顺势交易,在震荡行情中需平衡盈亏比与胜率。需注意价格突破趋势线时及时止损。

注重AI领域前沿发展 2016

基于AI学习的交易指标来了:Chaos Volume Trend使用初体验

【摘要】ChaosVolumeTrend"是一款革命性AI智能交易指标,融合AI机器学习算法与经典技术分析。该指标通过三重验证系统(智能趋势线、成交量Delta分析、自适应参数)实现精准预测,能提前识别趋势反转点并过滤市场噪音。其专业警报系统可及时捕捉突破信号,适用于股票、外汇及加密货币等多品种交易,支持全时段智能参数优化,以红绿颜色直观展示趋势方向。

注重AI领域前沿发展 682

阿里巴巴视觉生成大模型1.2.1版本深度部署指南

阿里巴巴最新发布的1.2.1位置系列视觉生成模型,包含1.3B基础版和14B增强版,分别适用于个人开发者和企业级商业应用。该模型支持混合精度训练、动态分辨率适配和多模态输入融合,显著提升了生成效率和质量。部署流程包括环境预配置、Conda环境搭建、核心组件安装和模型权重部署,支持Ubuntu系统和Google Colab云端部署。此外,文章还提供了Web交互界面配置、生成效果优化技巧和故障排查方法,帮助开发者快速搭建和优化视觉生成系统。

注重AI领域前沿发展 1757

爆炸预警:GPT-5要来了?这不是演习,而是一场 AI 革命!

但对于我们大多数普通用户来说,由于它在推理、灵活性和多任务处理上表现出的强大能力,它很可能会**“感觉”起来就像 AGI 一样强大**,成为当前最接近 AGI 的存在。如果说过去的 GPT 版本像是在不断建造更高的摩天大楼,那么 GPT-5 可能要做的,是重塑整个城市的地基和天际线。虽然开发之路充满荆棘,但“神奇的统一智能”的愿景,以及它将带来的前所未有的能力,无疑是令人兴奋的。GPT-4.5 是现有 GPT 架构的集大成者,它拥有庞大的知识库,对话更自然,幻觉更少,但它依然属于“蛮力计算”的范畴。

注重AI领域前沿发展 1625

Deep Vicky,不用下载代码也能吃透开源项目!

可以直接在网站上输入项目的 GitHub 链接,或者,还有一个更酷更简单的方法:直接在你想看的 GitHub 项目的浏览器地址栏里,把 github.com 改成 deepvicky.com,然后回车,它就能自动帮你把项目导入 Deep Vicky 了,省去了手动复制粘贴链接的步骤。更棒的是,它会直接给出相关的代码来源。总的来说,Deep Vicky 是一个非常实用的 GitHub 项目理解工具,特别是它能够将问答与具体的代码实现关联起来,这一点对于想要深入学习和掌握开源项目的人来说,价值巨大。

注重AI领域前沿发展 1560

微软的“思考”引擎升级了?Phi-4 Reasoning 模型能否撬动本地AI新未来!

Phi-4 Reasoning 系列模型的推出,或许正在向我们暗示,未来操作系统内置的AI能力,其推理水平可能就是基于类似量级的模型。正如 Andre Karpathy 等技术专家曾讨论过的“认知核心”概念一样,许多人认为,当前大型模型浪费了太多参数去记忆海量琐碎的信息,比如过时的网站信息、SHA 哈希值等——这些信息通过外部查询完全可以获取,模型无需“内置”它们。这是一种典型的蒸馏过程:利用更强大的模型生成数据,然后用这些数据来微调一个较小的(或已有的)模型,使其具备类似的能力。

注重AI领域前沿发展 1784

为什么有人靠 AI 赚几千万,而我们还在混温饱?我深挖了他们的项目,发现了真正的差距

最近,我在网上看到一些非常厉害的个体案例,他们借助 AI 技术,在短短一两年内就取得了令人难以置信的成功,有人甚至年收入达到了上千万元。看到这些,我不禁反思:为什么同样是“小白”,同样使用着差不多的 AI 工具,他们却能实现财务自由,而我还在为了“混个温饱”而忙碌?好奇心驱使我深入挖掘了这些“超级个体”的故事和打法。经过一番深入剖析后,我终于发现了隐藏在表象之下的,我们与他们之间的真正差距到底在哪里。这篇文章,我想把这些发现跟大家分享。这不是为了贩卖焦虑,而是希望我们能从中学习,找到突破点。

注重AI领域前沿发展 1659

AI黑话:Agent、MCP、Function Calling…是什么意思?

总之,System Prompt、User Prompt、AI Agent、Agent Tool、Function Calling、MCP 以及最底层的 AI 模型,它们就是这样互相连接又各司其职的。在这种情况下,即使 AI 还是生成了不正确的响应,因为响应格式是固定的,AI 服务端自己就能检测到,并执行重试。AutoGPT 会根据这些信息,生成一段 System Prompt,告诉 AI 模型用户提供了哪些工具(tools)、它们有什么用,以及如果 AI 想使用它们,应该返回什么格式的内容。

注重AI领域前沿发展 2017

告别CPU思维,拥抱并行世界:AI工程师深入解释GPU架构与执行模型

在向量加法的例子中,一个 Warp 中的 32 个线程可能都在执行“加法”指令,但每个线程操作的是向量中不同的索引位置上的元素。过去,GPU主要用于图形渲染,是游戏玩家的“专属”。虽然全局内存时延高,但 GPU 的其他层级内存(特别是 Shared Memory 和 L1/L2 Cache)以及海量的计算单元和高效的调度机制,能够有效地“隐藏”这种时延,确保计算单元不会长时间空闲等待数据。虽然编写高效的GPU Kernel 是一项复杂的任务,涉及对硬件细节的深刻理解和精妙的代码优化,但基础原理是相通的。

注重AI领域前沿发展 1934

Google Agent space时代,浅谈Agent2Agent (A2A) 协议和挑战!

Google Cloud Next 2025 大会的主角不再是“AI”本身,而是“Agents”!从主题演讲到展区 Demo,“Agent”这个词无处不在。然而,现场 Demo 似乎并未完全兑现 Agents 的宏大愿景。真正让我眼前一亮的,是 Google 重磅发布的 Agent2Agent (A2A) 协议。这可能才是通往 Agent 协作、乃至“Agent 应用商店”时代的关键基石。本文将带你深入解读 A2A 协议是什么、它想解决什么问题、它的潜力何

注重AI领域前沿发展 1648

小米搞出来个MiMo 7B RL模型,真实能力大揭秘!

科技巨头小米正式进军大语言模型领域,推出开源 MiMo 模型家族,其中 MiMo-7B-RL 版宣称在多项能力上可对标 OpenAI。是“狼来了”还是实力派?本文将通过一系列实测,深入剖析 MiMo-7B-RL 的真实表现,揭示其优势与短板,并探讨其背後技术细节。

注重AI领域前沿发展 3278

全参数解读Qwen 3 系列模型 + 本地部署实操 + 多维度能力深度测评

相较于前代模型和其他同类模型,Qwen 3 在知识问答、逻辑推理、结构化输出、代码生成等多个维度都展现出了显著的进步和强大的通用能力。这是一个非常令人惊喜的发现。在开启“思考模式”后,14B 模型在某些复杂的逻辑推理(如矩阵填充)、需要精确结构化输出和内部计算的任务(如 JSON 格式化)中,表现甚至能够超越参数量远大于它的235B和32B模型。考虑到14B 模型更容易在本地部署,它无疑是资源有限场景下的一个“黑马”选项。

注重AI领域前沿发展 5004

Agent 进阶必修课!Coze 工作流:解锁智能体处理复杂任务的真正潜力

我们可以用一个简单的日常例子来理解工作流。想象一下,你的目标是从深圳前往上海。实现这个目标有多种方式:飞机、高铁、汽车。选择哪种方式取决于你的具体需求(比如是否紧急、是否需要沿途风景等)。但无论你选择哪种方式,都需要遵循一系列固定的步骤或流程。前往机场 -> 过安检 -> 办理值机/登机 -> 飞行 -> 落地取行李 -> 出机场。这一系列的步骤,就是一个为了达成“从深圳到上海”这个目标的工作流。在这个流程中,每一个步骤(前往机场、过安检等)都可以看作是完成一个特定任务的节点。

注重AI领域前沿发展 5449

《扣子从入门到精通》:了解字节跳动的AI Agent

這篇文章深入探討了字節跳動的 AI Agent 平台「扣子空間」。文章首先介紹了 AI Agent 的興起背景與核心價值,強調其自主規劃、調用 MCP 工具完成複雜任務的能力,超越了傳統聊天機器人。接著,文章詳解了「扣子空間」的兩種模式(探索與規劃)、MCP 工具集成(如高德地圖、飛書),並通過生成遊戲網頁、行程規劃等實例展示其功能與局限,特別指出 Agent 可能出現上下文丟失等錯誤,強調輸出結果必須人工驗證。最後,文章分析了字節在該領域的優劣勢,並展望 Agent+MCP 結合交易能力的未來趨勢

注重AI领域前沿发展 2396

AI狂飙:我们正在亲手打开潘多拉魔盒...

第一,全球AI开发者必须像核科学家那样持证上岗。你总不会让高中生随便玩钚元素吧?第二,给AI装上"数字黑匣子",就像飞机的飞行记录仪,每次出事都能追溯。第三,也是最关键的——在座各位现在就可以做点什么。打开手机,把这篇演讲转给那个还觉得"AI就是高级Siri"的朋友。

注重AI领域前沿发展 1009

Google NotebookLM,赋能你的智能知识工作流

在“Process”区域上方,你会看到为每个源文件生成的摘要。点击可以查看详细内容和摘要。

注重AI领域前沿发展 2404

AI提示词优化五大技巧,瞬间提升10倍效率

谷歌研究显示,成功AI提示词平均需21词(远超多数人输入的9词)。优化提示词质量,可参考五大实战技巧:1. 三的法则要求AI生成3个变体,如“写3版广告语,分别侧重续航、智能驾驶、充电速度”,避免单一答案局限,捕捉用户真实需求。2. 多步骤拆解复杂任务分步处理(如预算申请PPT拆解为数据量化、反驳预判、可视化设计三步),准确率提升67%。3. 模板预建用AI生成场景化模板(如电商运营的直播选品评分表),并优化现有模板:“在周报模板中新增数据异常预警模块”。

注重AI领域前沿发展 2425

Grok、Gemini、Perplexity、GPT火拼了?深度研究实测

Gemini 的准确率最高,回答详细且精确。Perplexity 准确率也相当不错。ChatGPT 准确率一般,甚至会弄错自己的功能和订阅信息。Grok 的准确率最差,测试问题几乎全错。

注重AI领域前沿发展 2255

Mac用户狂喜!手把手教你本地部署DeepSeek大模型

它清晰地表明,你的 Mac 的 M 芯片(特别是它的统一内存和集成的 GPU),正在被充分利用来执行 AI 的计算任务!就算你之前没怎么接触过终端,跟着我的步骤走,也能轻松搞定!DeepSeek 作为一款优秀的开源模型,能力也很不错,无论是写代码、写文章、翻译还是问答,都能胜任。作为一个技术宅,我一直在想,能不能把这些强大的 AI 能力,,无论是写代码、写文章、头脑风暴,DeepSeek 都能在你本地给你提供强大的帮助!把你的 Mac 变成一个强大的离线 AI 工作站,随时随地发挥 AI 的力量!

注重AI领域前沿发展 5504

Suno AI 完全上手教程:从文字生成到混音,打造专属音乐库

从简单的文字生成,到复杂的自定义歌词、音频上传、制作翻唱、编辑片段,甚至还有那些能“魔改”演唱方式的隐藏标签,它的功能强大到令人,,,怎么说呢,寝食难安呐!听说了么,一个技术员用ai写歌,几天就赚到了5万块钱,还开通了视频号。甚至能做出像(此处可以脑补一段炸裂或感人的音乐)这样的,或者(此处再脑补一段)这样的歌!要是再一年以前,完全不同音乐的人要想学个吉他都非常难,别说写歌了,但是!Suno 也能搞定!赶紧试试,看看 Suno 是怎么“理解”你的指令的!,保证让你看完就能做出自己的第一首歌,甚至更多!

注重AI领域前沿发展 6812

免费的真香!Google Gemini 全面实测

这就像是玩“提示词工程”(Prompt Engineering),你给的指令越清晰、越有条理,它给你的反馈就越给力!刚进 Gemini 的界面,你可能会看到右上角有一个地方可以点(录视频的时候是这样),里面有两个选项:一个叫。如果你想体验更顶级的,可以考虑 Advanced,据说后面会有一个专门的 Advanced 视频介绍。别光把它当成一个问答机器!你可以用一些更高级的提示词技巧,把它变成你的写作助手。登录进去后,咱们看看它有哪些给力的地方,以及怎么把它用得更溜!最关键的是,基础版本的 Gemini,

注重AI领域前沿发展 1万+

4o 图片生成:ChatGPT 里的隐藏修图大师!免费(暂时)体验教程 + 10大创意玩法揭秘!

你可以上传几张不同的图片,然后告诉 AI 把它们合成为一张图,并且按照你的指令来组合。比如,上传一张女生的图,一张椅子的图,一张猫的图,然后说:“把图1的女生放到图2的椅子上坐着,让她抱着图3的猫咪”。考虑到 OpenAI 的迭代速度,以及 Sora 本身在视频生成上的惊艳表现,我们完全有理由期待 4o 未来会更加强大,甚至在 Sora 的下一个版本中,图片和视频的生成编辑能力会进一步融合!,极大地拓展了 AI 图片的应用场景,让普通用户也能通过简单的对话,创作出令人惊艳的图片和进行复杂的编辑。

注重AI领域前沿发展 1492

Google Gemini全面进化,深度评测与实战指南

Gemini的快速发展印证了Google"AI First"战略的成功。对于技术从业者而言,掌握这个平台意味着获得了:效率提升:自动生成技术文档能力创意扩展:跨模态内容生产管线研究加速:智能文献分析工具。

注重AI领域前沿发展 2244

Runway Gen-3开箱体验,又一个惊艳的文生视频工具来了

可以直接复用提示,稍微改一点继续生成,Runway支持这个,非常友好。远景里的人有点奇怪,有些看着像鸟~不过这也能理解,毕竟目前是Gen-3 Alpha版,细节上还有待打磨,整体来说,体验还是非常惊艳的!目前积分用得比较快,视频生成成本也不低,所以要稍微规划好,不要乱点浪费哦!第一次进来,可以把默认提示词删掉,它就会弹出一份官方小指南,教你怎么写提示词。:Gen-3是需要付费订阅的,最低12美元一个月,注册之后你会拿到一点点积分,可以用来生成视频的。生成速度很快,我这边测试的时候,大概一分钟以内就搞定了。

注重AI领域前沿发展 2426

Midjourney从入门到精通

AI 绘画,顾名思义就是利用人工智能进行绘画,是人工智能生成内容(AIGC)的一个应用场景。其主要原理就是收集大量已有作品数据,通过算法对它们进行解析,最后再生成新作品,而算法也便是 AI 绘画的核心,随着AI技术的爆火,Midjourney不到一年时间公测,就获得了大量的付费用户。关于MidjourneyMidjourney借助Discord使用,而Discord据说2019年就是已经有2.5亿注册用户的网络实时通话软件与数字发行平台。

注重AI领域前沿发展 1206

深度体验Sora:文字化神奇,视频随心造!人人都是导演的时代来了?

体验完 Sora,我 annus mirabilis 的心情是复杂的——既有对技术突破的兴奋和惊叹,也有一丝对未来不确定性的担忧。它让我们看到了“文字生成视频”那令人难以置信的潜力,让“人人都是导演”不再是遥远的梦想。它用高效和便捷,为创意插上了翅膀。但同时,它也暴露了AI在处理细节上的不足,以及在伦理和安全方面带来的巨大挑战。那么,你看完这篇文章,是感到新奇,迫不及待想去尝试一下 Sora 的魔法?还是觉得有些担忧,对未来充满了不确定性?欢迎在下方评论区告诉我你的想法!

注重AI领域前沿发展 1270

全世界最受欢迎的10个AI,deepseek居然排名第九

好了,以上就是 annus mirabilis 为大家精心梳理的,全球最受欢迎的10个人工智能。它们各具特色,从艺术创作到编程辅助,从声音模拟到模型聚合,从中文理解到开源生态,从高效算力到通用智能,每一位都在用自己的方式,改变着我们的数字生活和工作方式。看完这十位“智能之神”,不知道哪一位给你留下了最深刻的印象?是那位能够瞬间把文字变成画作的 Midjourney?还是默默提高你编程效率的 GitHub Copilot?是让声音栩栩如生的 Eleven Labs?还是集百家之长的 Poe?

注重AI领域前沿发展 1905

AI赋能高考志愿填报:技术视角下的报考小程序设计与实践

开发一个AI报考小程序是集数据工程、机器学习、后端服务、前端开发、用户体验设计于一体的系统工程。它要求我们不仅要处理海量复杂的数据,设计和实现高效准确的AI算法,还要构建稳定可靠的技术基础设施,并关注最终用户的使用感受。对于技术人员而言,这是一个充满挑战但极具价值的项目。它有机会利用我们的专业技能,解决一个社会性的痛点,为无数学生和家庭提供实实在在的帮助。通过不断迭代和优化,AI报考小程序有望成为高考志愿填报领域不可或缺的智能助手。

注重AI领域前沿发展 2171

深挖 Google AI Studio 的 Stream 功能:一位 AI自媒体人的实战评测

Google AI Studio 提供并鼓励使用的 Stream 功能,是现代 LLM 应用开发中不可或缺的一环。它不仅仅是让文字看起来像“打字”,更是通过实时、增量的响应方式,彻底改变了用户与 AI 的交互体验,让等待不再煎熬,让协作更加高效。通过智能客服、实时代码助手、内容创作工具等案例,我们可以清晰地看到 Stream 功能在提升用户感知延迟、优化长内容处理、实现实时协作等方面的巨大价值。

注重AI领域前沿发展 2087

玩转命令行也能“变现”?聊聊Linux大牛如何在网络世界“掘金”!

但你有没有想过,这身“Linux内功”,除了让你在技术圈里备受尊敬,或者在公司里稳定输出外,能不能在更广阔的网络世界里,帮你开辟一条“搞钱”的新路子?你想想,从大公司的服务器集群,到小网站的虚拟主机,再到智能家居设备,哪里没有Linux的身影?在你的博客、GitHub、自由职业者平台简介中,合理使用目标客户可能搜索的关键词(如“Linux运维”、“Docker部署”、“服务器安全”)。Linux,它不仅仅是一个操作系统,它是现代互联网的“基石”,是云计算、大数据、物联网背后的“隐形引擎”。

注重AI领域前沿发展 1147
上一篇: AI赋能高考志愿填报:技术视角下的报考小程序设计与实践
下一篇: 全世界最受欢迎的10个AI,deepseek居然排名第九
annus mirabilis
annus mirabilis 屿翼百货商行 屿翼百货商行
博客等级 码龄2年 1370粉丝 108原创
评论 9
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值