


利用大模型解决表格数据处理难题
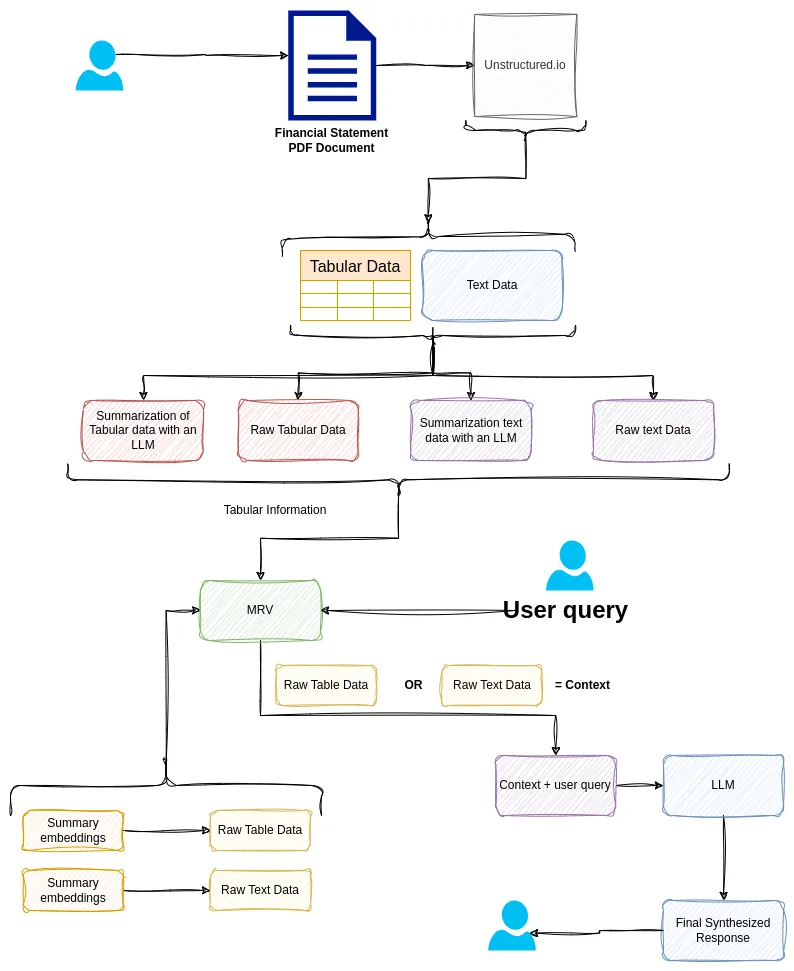
当涉及到 PDF 文档中的表格数据时,聊天机器人的表现往往不尽如人意。例如,对于包含表格形式的会计信息的财务报表等文档,我们通常熟悉的典型检索增强生成(RAG)方法并不能有效发挥作用。在本文中,我们将详细探讨解决此问题的技术,学习如何使用不同工具提取和预处理表格数据,以使聊天机器人在聊天时能给出更准确的结果,具体会涉及LangChain、ChromaDB 和 MultiVector 检索器等工具。
一、项目准备
(一)创建 Python 虚拟环境
首先要创建一个 Python 虚拟环境,这里我们使用 Python 的 Poetry 来完成。在命令行中依次执行以下命令:
$ mkdir financial_statement_bot
$ cd financial_statement_bot
$ poetry init
$ poetry install
(二)安装必要的依赖
在项目文件夹的根目录下创建一个名为 main.ipynb 的 Jupyter notebook。在第一个单元格中添加以下命令并运行,以安装所需的依赖项:
%pip install "unstructured[all-docs]" unstructured-client watermark python-dotenv pydantic langchain langchain-community langchain_core langchain_openai chromadb
(三)查看计算机基本信息(可选)
如果您想了解运行程序的计算机或硬件信息(主要是为了确保不存在潜在的硬件兼容性问题,或者您只是单纯想知道运行环境),可以在 notebook 中执行以下命令:
import watermark
%load_ext watermark
%watermark -n -v -m -g -b
为了忽略可能出现的警告,还可以添加一个单元格并输入以下代码:
import warnings
warnings.filterwarnings('ignore')
此外,使用以下命令可以查看系统中安装的 Unstructured 包的列表:
import unstructured.partition
help(unstructured.partition)
二、加载和处理 PDF 文档
(一)加载 PDF 文档
现在我们开始加载 PDF 文档。创建一个新单元格并添加以下代码:
from unstructured.partition.pdf import partition_pdf
# 替换为实际的 PDF 文件路径
pdf_path = "./data/Sample-Accounting-Income-Statement-PDF-File.pdf"
# 读取文件并获取解析后的 PDF 文件每页的元素列表
elements = partition_pdf(pdf_path)
上述代码将返回 Unstructured.io 在文档中识别出的元素类别列表。您可以打印 elements 变量来查看其中的内容,还可以获取文档中识别出的所有元素的数量:
print(f"Lenght of elements: {len(elements)}")
(二)将元素转换为 JSON 对象
为了更方便阅读,我们将 elements 对象转换为 JSON 对象。添加以下代码:
import json
element_dict = [el.to_dict() for el in elements]
output = json.dumps(element_dict, indent=2)
print(output)
(三)获取唯一元素类型
我们还可以获取 PDF 文档中所有唯一识别的元素类型列表:
unique_element_types = set()
for item in element_dict:
    unique_element_types.add(item['type'])
此时您会发现,虽然 PDF 文档中有表格,但 Unstructured.io 并没有将表格识别为表格元素,而是将其识别为普通文本元素。例如,当我们查看文档中包含 “CURRENT” 字样的表格部分时,会发现其所属列被识别为 “Title” 类别。这显然不是我们想要的结果,如果基于这样的数据构建聊天机器人,它将获取错误信息,从而给出错误答案,并且在其他下游任务中的性能也会下降。
三、提取表格数据
(一)提取表格的方法
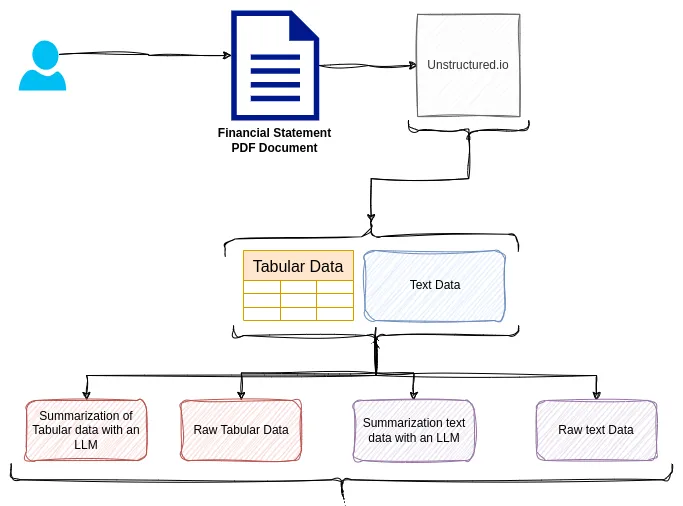
要提取表格数据,我们可以在本地进行,也可以使用 Unstructured 提供的免费或付费 API。如果在本地运行,需要在机器上安装 Tesseract,并且需要性能较好的 GPU 或强大的 CPU,但并非所有人都具备这样的条件。因此,本文将使用其免费 API。该 API 使用OCR和其他技术从 PDF 文档中提取表格数据,在此我们不详细介绍其原理。
(二)获取 API 密钥并设置环境变量
首先,需要从这里获取 API 密钥(请将链接替换为实际获取密钥的链接)。获取 API 密钥后,在项目的根目录下创建一个名为 .env 的新文件,并按照以下格式添加 API 密钥:
UNSTRUCTURED_API_KEY=Your_API_key
UNSTRUCTURED_API_URL=https://api.unstructured.io/general/v0/general
然后运行以下代码加载 API 密钥:
import os
from dotenv import load_dotenv, find_dotenv
# 从.env 文件加载环境变量
load_dotenv(find_dotenv())
# 访问 API 密钥
unstructured_api_key = os.environ.get('UNSTRUCTURED_API_KEY')
unstructured_api_url = os.environ.get('UNSTRUCTURED_API_URL')
(三)创建 Unstructured 客户端
使用加载的 API 密钥和 URL 创建一个 Unstructured 客户端,以便与 Unstructured 的免费 API 进行连接并执行提取操作:
from unstructured_client import UnstructuredClient
client = UnstructuredClient(
    api_key_auth=unstructured_api_key,
    server_url=unstructured_api_url
)
(四)使用 Unstructured API 客户端提取表格和文本元素
建立连接后,就可以开始提取信息了。首先导入必要的模块:
from unstructured_client.models import shared
from unstructured_client.models.errors import SDKError
from unstructured.staging.base import dict_to_elements
然后执行以下代码提取信息:
with open(pdf_path, "rb") as f:
    files = shared.Files(
        content=f.read(),
        file_name=pdf_path
    )
    req = shared.PartitionParameters(
        files=files,
        strategy="hi_res",
        hi_res_model_name="yolox",
        skip_infer_table_types=[],
        pdf_infer_table_structure=True
    )
    try:
        resp = client.general.partition(req)
        elements = dict_to_elements(resp.elements)
    except SDKError as e:
        print(e)
我们可以获取提取的所有唯一元素的列表:
unique_elements_set = set()
for el in elements:
    unique_elements_set.add(el.category)
此时可以看到,我们已经能够成功提取表格数据了。
四、分析提取的表格和文本数据
(一)查看提取的表格
现在我们已经提取了表格数据,接下来查看提取的不同元素类别。首先获取所有表格元素:
tables = [el for el in elements if el.category == "Table"]
print(tables)
print(f"Number of tables: {len(tables)}")
可以看到文档中共有 8 个表格,这与实际情况相符。还可以查看给定表格的文本内容,例如:
tables[0].text
以及查看表格对象的元数据:
tables[0].metadata
(二)查看表格的 HTML 数据
在 Unstructured 中提取的每个表格都以 HTML 文档形式返回。查看第一个提取的表格的 HTML 数据:
first_table_html = tables[0].metadata.text_as_html
first_table_html
为了使其看起来更像 HTML 格式,可以执行以下操作:
from io import StringIO
from lxml import etree
parser = etree.XMLParser(remove_blank_text=True)
file_obj = StringIO(first_table_html)
tree = etree.parse(file_obj, parser)
print(etree.tostring(tree, pretty_print=True).decode())
还可以将其转换为实际的表格形式:
from IPython.core.display import HTML
HTML(first_table_html)
(三)将提取的表格转换为 Pandas DataFrame
我们也可以将提取的表格转换为 Pandas DataFrame 对象,具体操作如下:
import pandas as pd
dfs = pd.read_html(first_table_html)
df = dfs[0]
df.head()
(四)查看提取的文本数据元素
要获取提取的文本元素,可以使用以下方法:
texts = [el for el in elements if el.category!= "Table"]
texts[0].text
这些文本元素包括标题、电子邮件地址等不同类别。还可以将所有提取的元素按照文档顺序组合在一起:
extracted_text = ""
for cat in elements:
    if cat.category == "Formula":
        extracted_text += cat.text + "\n"
    elif cat.category == "FigureCaption":
        extracted_text += cat.text + "\n"
    elif cat.category == "NarrativeText":
        extracted_text += cat.text + "\n"
    elif cat.category == "ListItem":
        extracted_text += cat.text + "\n"
    elif cat.category == "Title":
        extracted_text += cat.text + "\n"
    elif cat.category == "Address":
        extracted_text += cat.text + "\n"
    elif cat.category == "EmailAddress":
        extracted_text += cat.text + "\n"
    elif cat.category == "Table":
        extracted_text += cat.metadata.text_as_html + "\n"
    elif cat.category == "Header":
        extracted_text += cat.text + "\n"
    elif cat.category == "Footer":
        extracted_text += cat.text + "\n"
    elif cat.category == "CodeSnippet":
        extracted_text += cat.text + "\n"
    elif cat.category == "UncategorizedText":
        extracted_text += cat.text + "\n"
print(extracted_text)
还可以以 Markdown 形式显示:
from IPython.display import Markdown
Markdown(extracted_text)
五、预处理提取的表格和文本数据
(一)数据分类
将提取的表格和文本数据预处理为我们自己的文档类型,以便后续创建嵌入和多向量检索存储。首先定义一个 Element 类:
from typing import Any
from pydantic import BaseModel

class Element(BaseModel):
    type: str
    page_content: Any
然后对提取的元素进行分类:
categorized_elements = []
for element in elements:
    if "unstructured.documents.elements.Table" in str(type(element)):
        categorized_elements.append(Element(type="table", page_content=str(element.metadata.text_as_html)))
    elif "unstructured.documents.elements.NarrativeText" in str(type(element)):
        categorized_elements.append(Element(type="text", page_content=str(element)))
    elif "unstructured.documents.elements.ListItem" in str(type(element)):
        categorized_elements.append(Element(type="text", page_content=str(element)))
    elif "unstructured.documents.elements.Title" in str(type(element)):
        categorized_elements.append(Element(type="text", page_content=str(element)))
    elif "unstructured.documents.elements.Address" in str(type(element)):
        categorized_elements.append(Element(type="text", page_content=str(element)))
    elif "unstructured.documents.elements.EmailAddress" in str(type(element)):
        categorized_elements.append(Element(type="text", page_content=str(element)))
    elif "unstructured.documents.elements.Header" in str(type(element)):
        categorized_elements.append(Element(type="CodeSnippet", page_content=str(element)))
    elif "unstructured.documents.elements.CodeSnippet" in str(type(element)):
        categorized_elements.append(Element(type="text", page_content=str(element)))
    elif "unstructured.documents.elements.UncategorizedText" in str(type(element)):
        categorized_elements.append(Element(type="text", page_content=str(element)))
接着将表格元素和文本元素分别放在一起:
table_elements = [e for e in categorized_elements if e.type == "table"]
print(len(table_elements))
text_elements = [e for e in categorized_elements if e.type == "text"]
print(len(text_elements))
可以看到,我们有 8 个不同的表格元素和 44 个不同的非表格元素类别。
(二)生成摘要
现在我们已经提取了表格和文本内容,接下来需要为它们创建摘要。因为直接将原始表格和文本存储到向量数据库中并进行相似性搜索不是一个好主意,所以我们对每个表格或文本内容的摘要(即文本嵌入)进行相似性搜索,这样可以更好地检索到所需数据。
使用 LangChain Expression Language(LCEL)创建一个摘要链:
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI

summary_chain = (
    {"doc": lambda x: x}
    | ChatPromptTemplate.from_template("Summarize the following html tables or text given to you:\n\n{doc}")
    | ChatOpenAI(max_retries=0)
    | StrOutputParser()
)
对表格内容按每五个一组生成摘要:
tables_content = [i.page_content for i in table_elements]
table_summaries = summary_chain.batch(tables_content, {"max_concurrency": 5})
table_summaries[:2]
对文本元素也生成摘要:
texts_content = [i.page_content for i in text_elements]
text_summaries = summary_chain.batch(texts_content, {"max_concurrency": 5})
text_summaries[:2]
六、创建嵌入和多向量检索器
(一)创建嵌入和存储
我们现在有了摘要和原始数据,只对摘要进行嵌入并存储在向量存储中。对于每个嵌入,我们将附加一个元数据,将每个摘要嵌入与其实际的原始数据组件链接起来。这样,一旦检索到与查询最相似的嵌入,就可以使用与实际原始数据组件相关联的 ID 的元数据,并返回原始数据组件,这就是多向量检索器的基本工作原理。
以下是实现代码:
import uuid
from langchain.vectorstores import Chroma
from langchain.storage import InMemoryStore
from langchain.schema.document import Document
from langchain.embeddings import OpenAIEmbeddings
from langchain.retrievers.multi_vector import MultiVectorRetriever

store = InMemoryStore()
id_key = "doc_id"
# 用于索引子块的向量存储
vectorstore = Chroma(
    collection_name="financials",
    embedding_function=OpenAIEmbeddings(),
    persist_directory="./chroma_data"
)
# 检索器(初始为空)
retriever = MultiVectorRetriever(
    vectorstore=vectorstore,
    docstore=store,
    id_key=id_key
)
# 表格摘要嵌入和存储
doc_ids = [str(uuid.uuid4()) for _ in table_elements]
summary_tables = [Document(page_content=s,metadata={id_key: doc_ids[i]}) for i, s in enumerate(table_summaries)]
retriever.vectorstore.add_documents(summary_tables)
retriever.docstore.mset(list(zip(doc_ids, table_elements)))
# 文本摘要嵌入和存储
doc_ids = [str(uuid.uuid4()) for _ in text_elements]
summary_texts = [Document(page_content=s,metadata={id_key: doc_ids[i]}) for i, s in enumerate(text_summaries)]
retriever.vectorstore.add_documents(summary_texts)
retriever.docstore.mset(list(zip(doc_ids, text_elements)))
(二)测试多向量检索器
可以通过检索一些信息来测试多向量检索器。例如:
retriever_first_response = retriever.invoke("Give me a summary of the CASH FLOWS FROM OPERATING ACTIVITIES in a table format for the year 2001 and 2002")
print(retriever_first_response)
retriever_first_response_page_content = retriever_first_response[0].page_content
print(retriever_first_response_page_content)
从结果可以看到,我们成功检索到了正确的表格来回答用户问题,并且多向量检索器会将整个表格传递给大型语言模型(LLM),但 LLM 只会利用所需部分生成最终答案。
七、创建财务报表聊天机器人
现在我们已经完成了读取 PDF 文件、提取文本和表格并将它们存储在多向量检索器存储中的所有工作。接下来构建一个聊天机器人,它将接收从多向量存储中检索到的信息并用于回答查询。这里我们使用 LCEL 来构建聊天机器人。
(一)定义提示模板
首先定义提示模板如下:
from operator import itemgetter
from langchain.schema.runnable import RunnablePassthrough

# 提示模板
template = """Answer the question based only on the following context, which can include text and tables:
{context}
Question: {question}
"""
prompt = ChatPromptTemplate.from_template(template)
(二)选择语言模型
这里选择 ChatOpenAI 作为语言模型,并设置温度为 0,模型为 gpt - 4(也可以选择 gpt - 3.5 - turbo):
model = ChatOpenAI(temperature=0, model="gpt-4")
(三)构建 RAG 管道
构建 RAG 管道,将检索器、提示和模型连接起来:
chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | prompt
    | model
    | StrOutputParser()
)
(四)测试聊天机器人
现在可以测试聊天机器人了,例如询问 “What is the Leasehold improvements cost?”:
response = chain.invoke("What is the Leasehold improvements cost")
print(response)
还可以查看传递给 LLM 的表格信息:
table_respones = retriever.invoke("What is the Leasehold improvements cost")
from IPython.display import Markdown
Markdown(table_respones[0].page_content)
再尝试另一个问题 “Give me a summary of the CASH FLOWS FROM OPERATING ACTIVITIES in a table format for the year 2001 and 2002”:
response = chain.invoke("Give me a summary of the CASH FLOWS FROM OPERATING ACTIVITIES in a table format for the year 2001 and 2002")
print(response)
from IPython.display import Markdown
Markdown(response)
从结果可以看出,聊天机器人的回答相当准确。
今天先写到这里~,原计划有两个项目,另一个下次写~~
本文由 mdnice 多平台发布
 2627


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


