


感染控制与医院流行病学 (2018),0,1–6
doi:10.1017/ice.2018.265
评审
数字医疗流行病学中的机器学习导论
为了充分利用大规模常规数据在医疗领域的潜力,并有效地与信息技术专家和数据分析师进行沟通与合作,医疗流行病学家应具备一些大规模分析技术的知识,特别是机器学习方面的知识。本综述聚焦于机器学习这一广泛领域及其在新兴的数字医疗流行病学领域的初步应用。
(于2018年8月16日收到;于2018年9月28日接受)
背景
医疗流行病学在美国和欧洲的重要性日益增加,原因在于医院面临的财政压力不断加大、多重耐药病原体的出现增多以及医疗服务提供和系统的复杂性不断提高,并且在大数据时代可能会进一步发展。
在医疗保健领域,电子病历的持续采用和整合、数据源的链接以及新型诊断和数字监测技术的出现,导致了常规电子数据的数量和多样性达到了前所未有的水平。医疗保健中的大数据可用于更好地发挥感染预防与控制、质量改进以及医院资源的优化分配的潜力。
对于医疗流行病学家而言,要利用大数据,需要能够处理大型数据集的计算系统和方法。随着常规医疗数据的不断增加以及处理速度的提升(计算能力每两年翻一番,成本不变),机器学习正越来越多地应用于医疗项目,并有可能成为医疗流行病学中的关键分析工具。
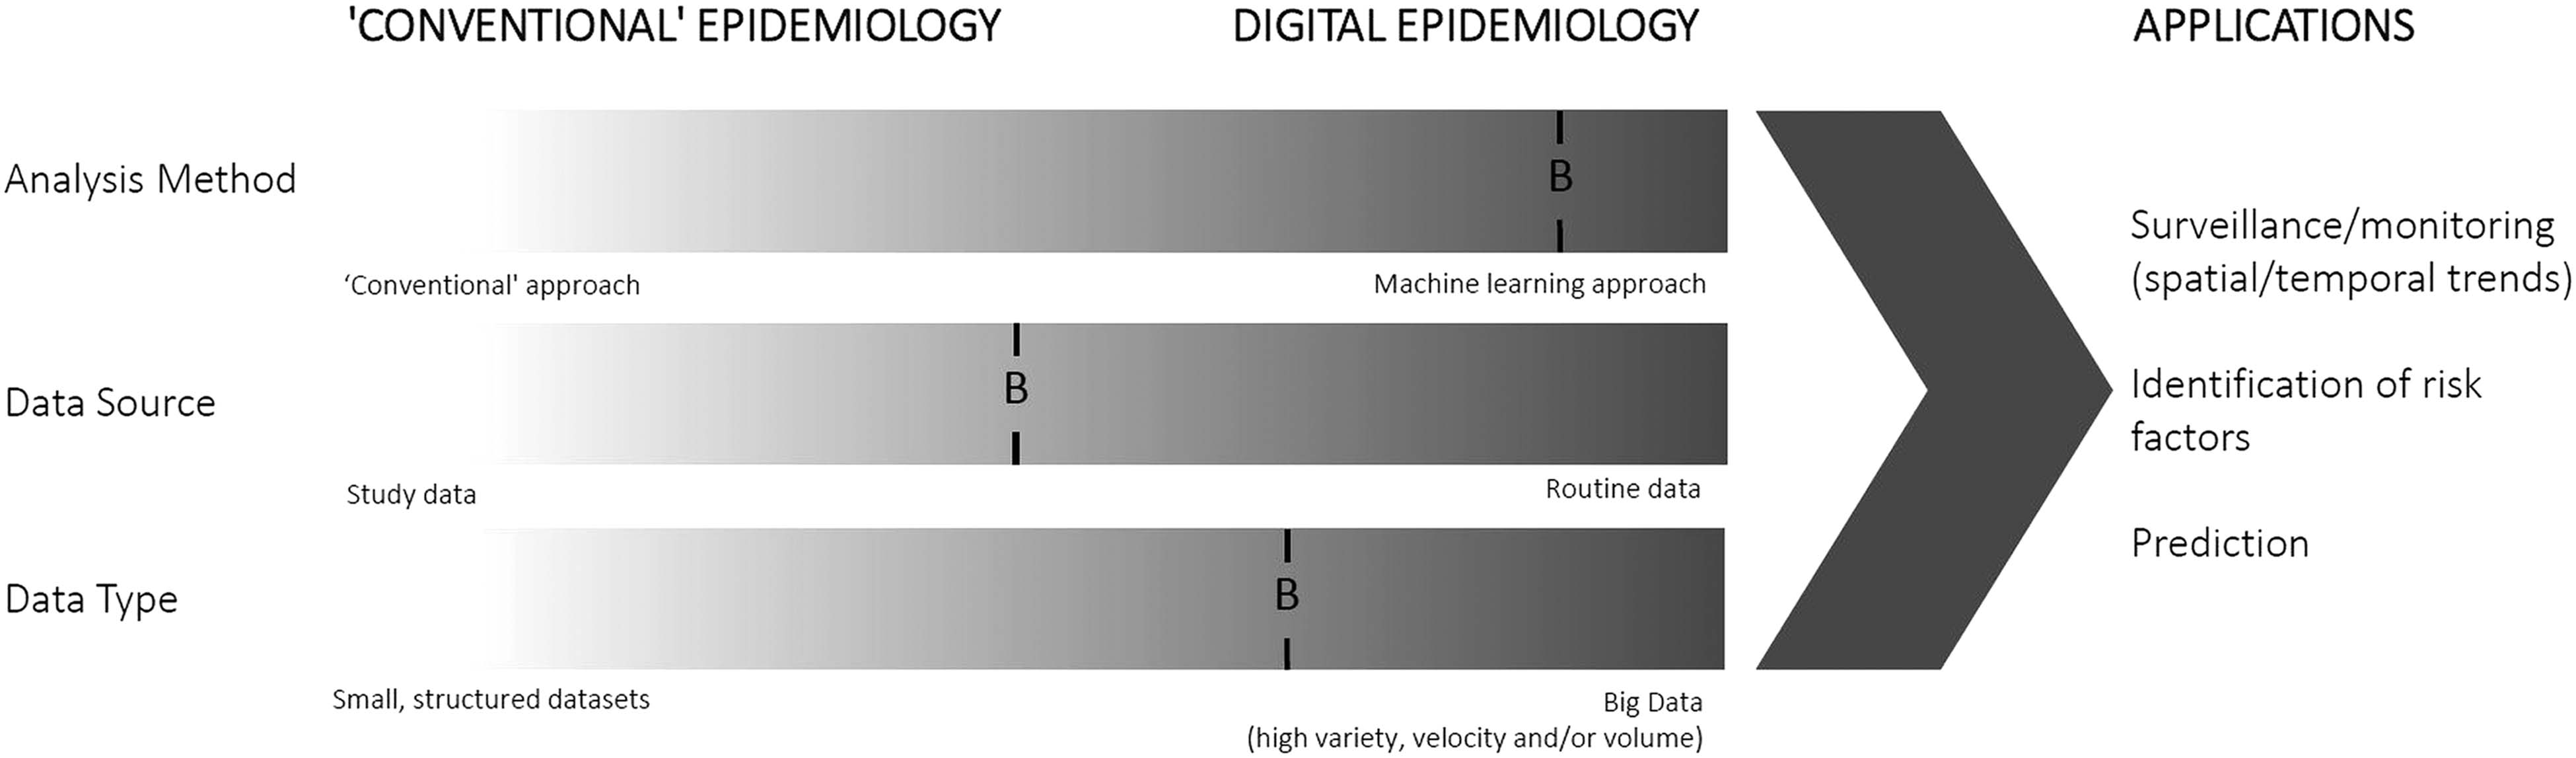
因此,专注于医疗人群的数字医疗流行病学可能会成为一个重要的流行病学领域,类似于主要利用一般人群中的社交媒体数据和其他例行数据源而迅速发展的数字流行病学。与流行病学的总体领域相似,这些相互关联领域的首要目标——数字流行病学和数字医疗流行病学——旨在了解特定人群中健康相关状态的分布及其决定因素,并利用这些知识来改善健康和预防疾病。为简便起见,我们将传统医疗流行病学与数字医疗流行病学之间的范围划分为三个轴:(1)分析方法,(2)数据来源,以及(3)数据类型(图1)。
为了充分挖掘大规模常规数据在医疗领域的潜力,并高效地与IT专家和数据分析师进行沟通与协作,医疗流行病学家需要掌握一些大规模分析技术的知识,特别是机器学习。
本综述介绍了机器学习这一广泛领域及其在数字医疗流行病学新兴领域中的最新应用,包括预测、趋势和模式检测(例如用于监测目的)以及风险因素识别。先前已有研究回顾了依赖于例行医疗数据和大数据的研究所面临的主要挑战与机遇。
机器学习:简介
机器学习作为一个学科起源于计算机科学,与统计学有着非常紧密的联系,但很难在两者之间划出明确的界限。相比起源于数学领域的统计学(其发展远早于计算机的出现),机器学习是一个较年轻的领域。机器学习和统计学有着共同的目标:从数据中进行学习。例如逻辑回归,这是统计学中的一种标准方法,在机器学习领域则被称为机器学习算法。对于随机森林等较新的算法也是如此,它们是广为人知的机器学习算法,由统计学家利奥·布雷曼开发。
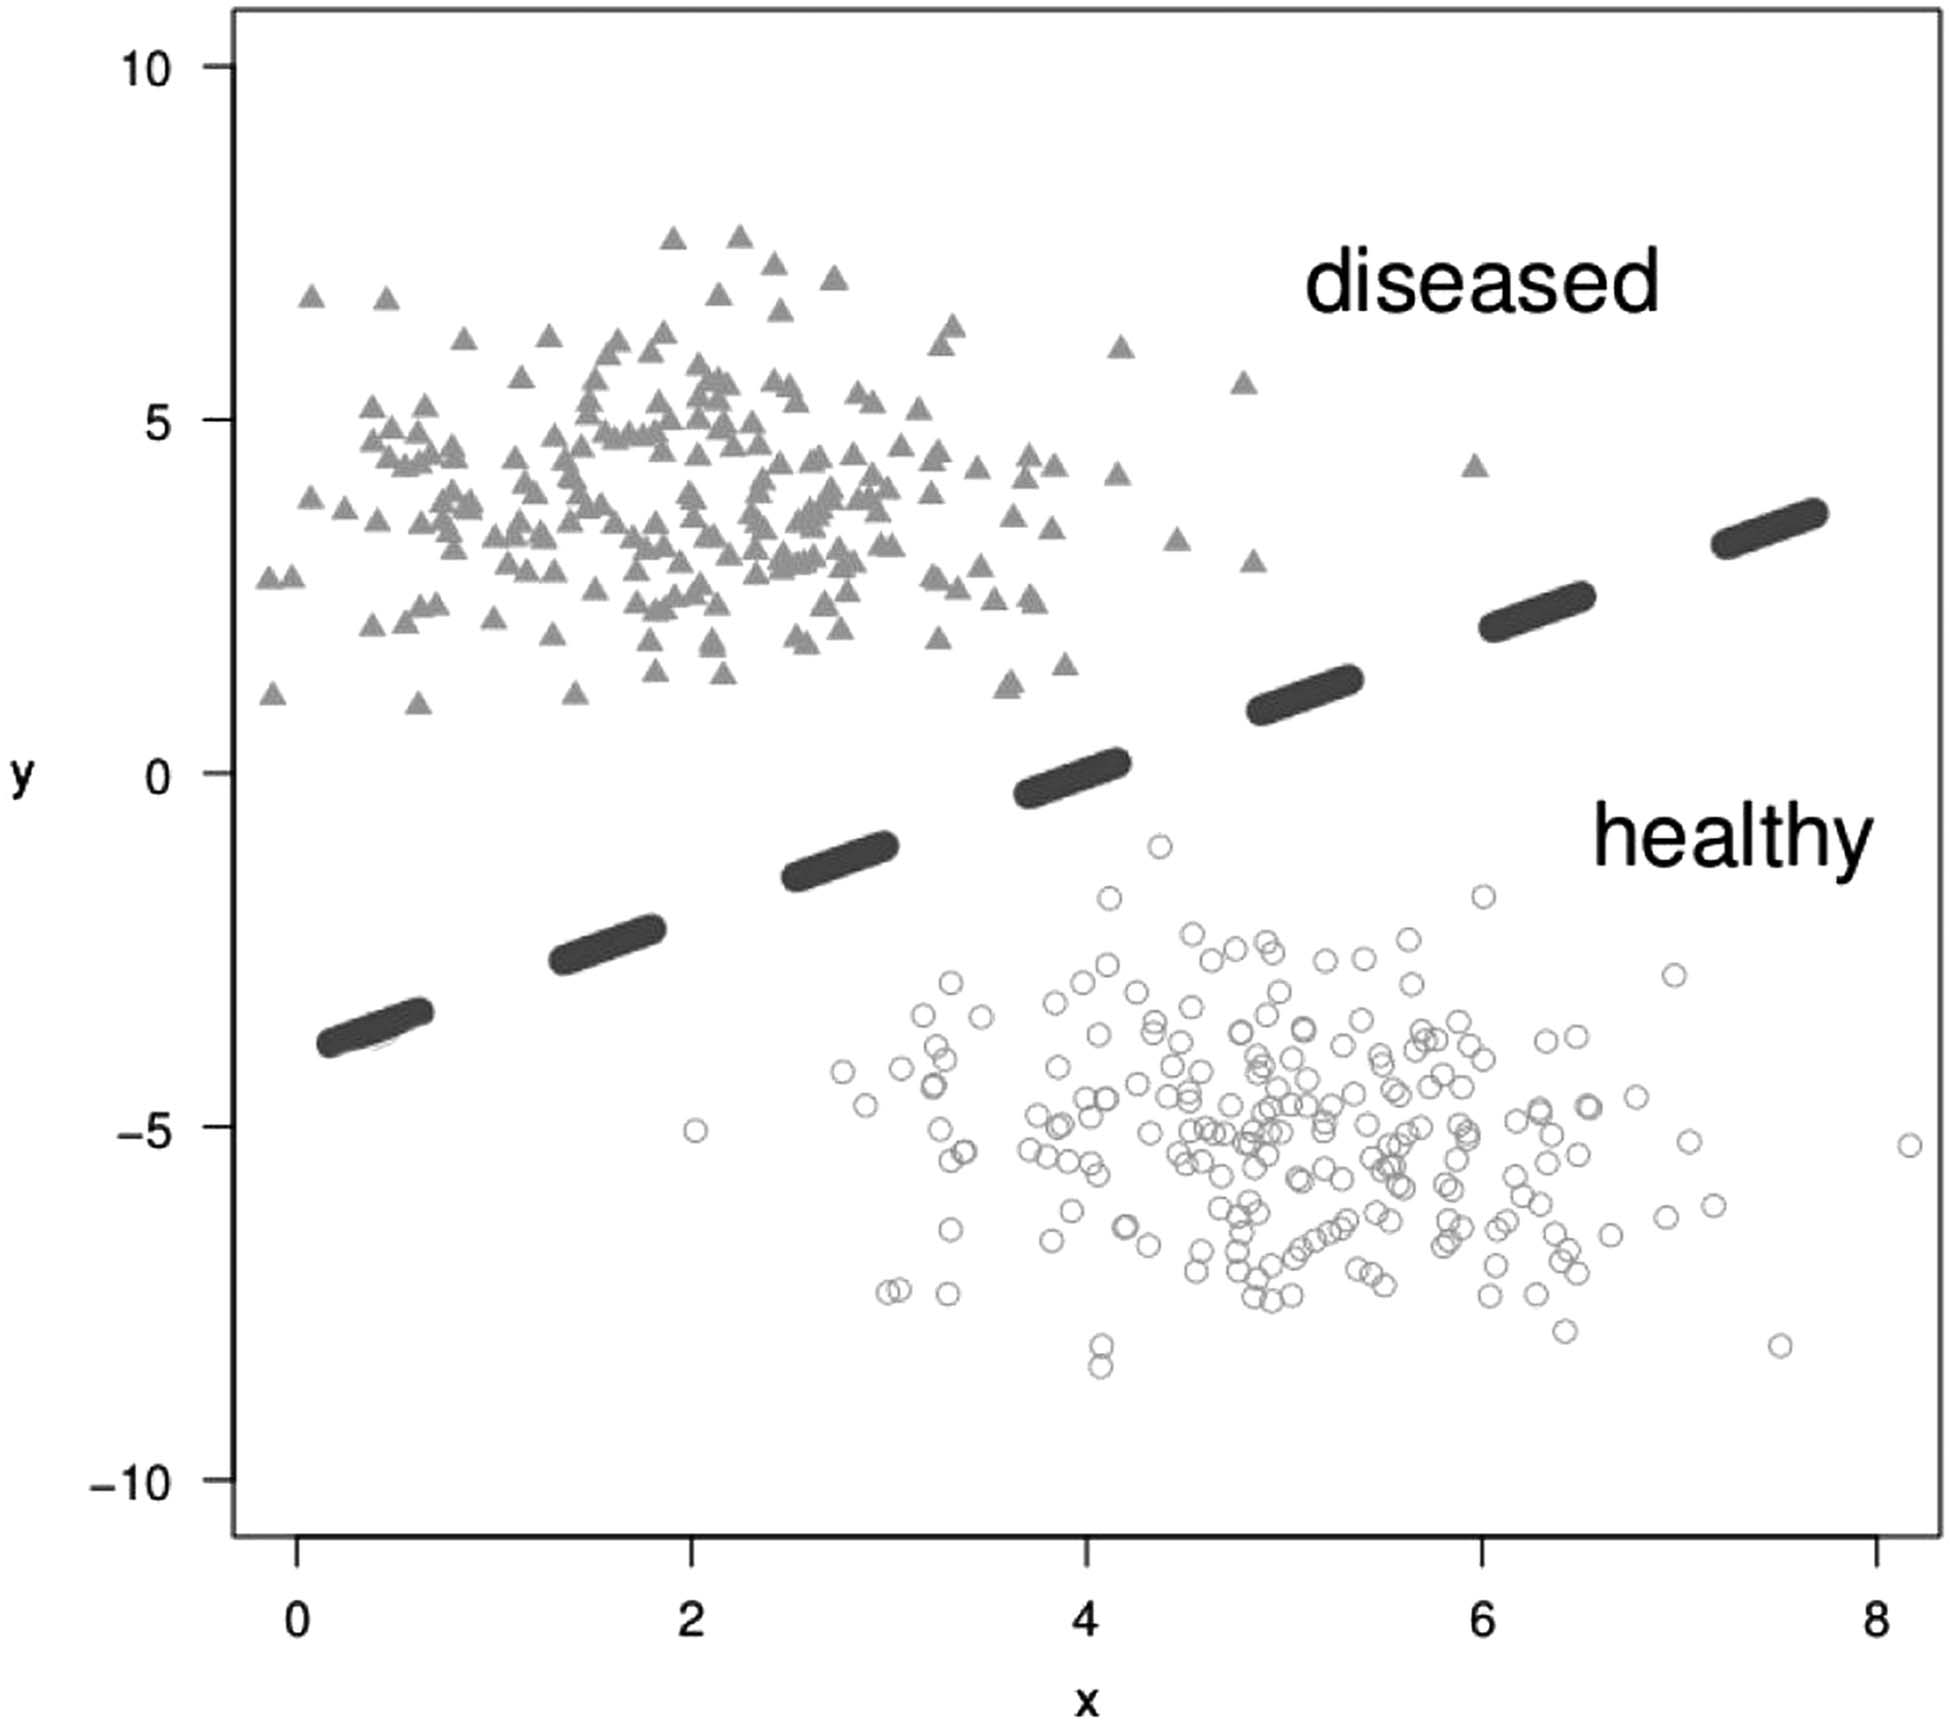
机器学习 broadly 可分为两个子领域:监督式学习和无监督学习。在监督学习中,输入数据和相应的目标值(即结果)均可被观测到。一个例子是将患者分类为患病或健康。领域专家(例如,医生)会为每位患者分配一个注释(“标签”),例如患病或健康。目标是找到能够最好地区分这两类的最佳模型,以便为新的未标记患者正确分配患病或健康标签,或识别重要的协变量。这类问题被称为分类问题(图2)。众所周知的分类算法包括逻辑回归、随机森林、支持向量机和神经网络的变体。
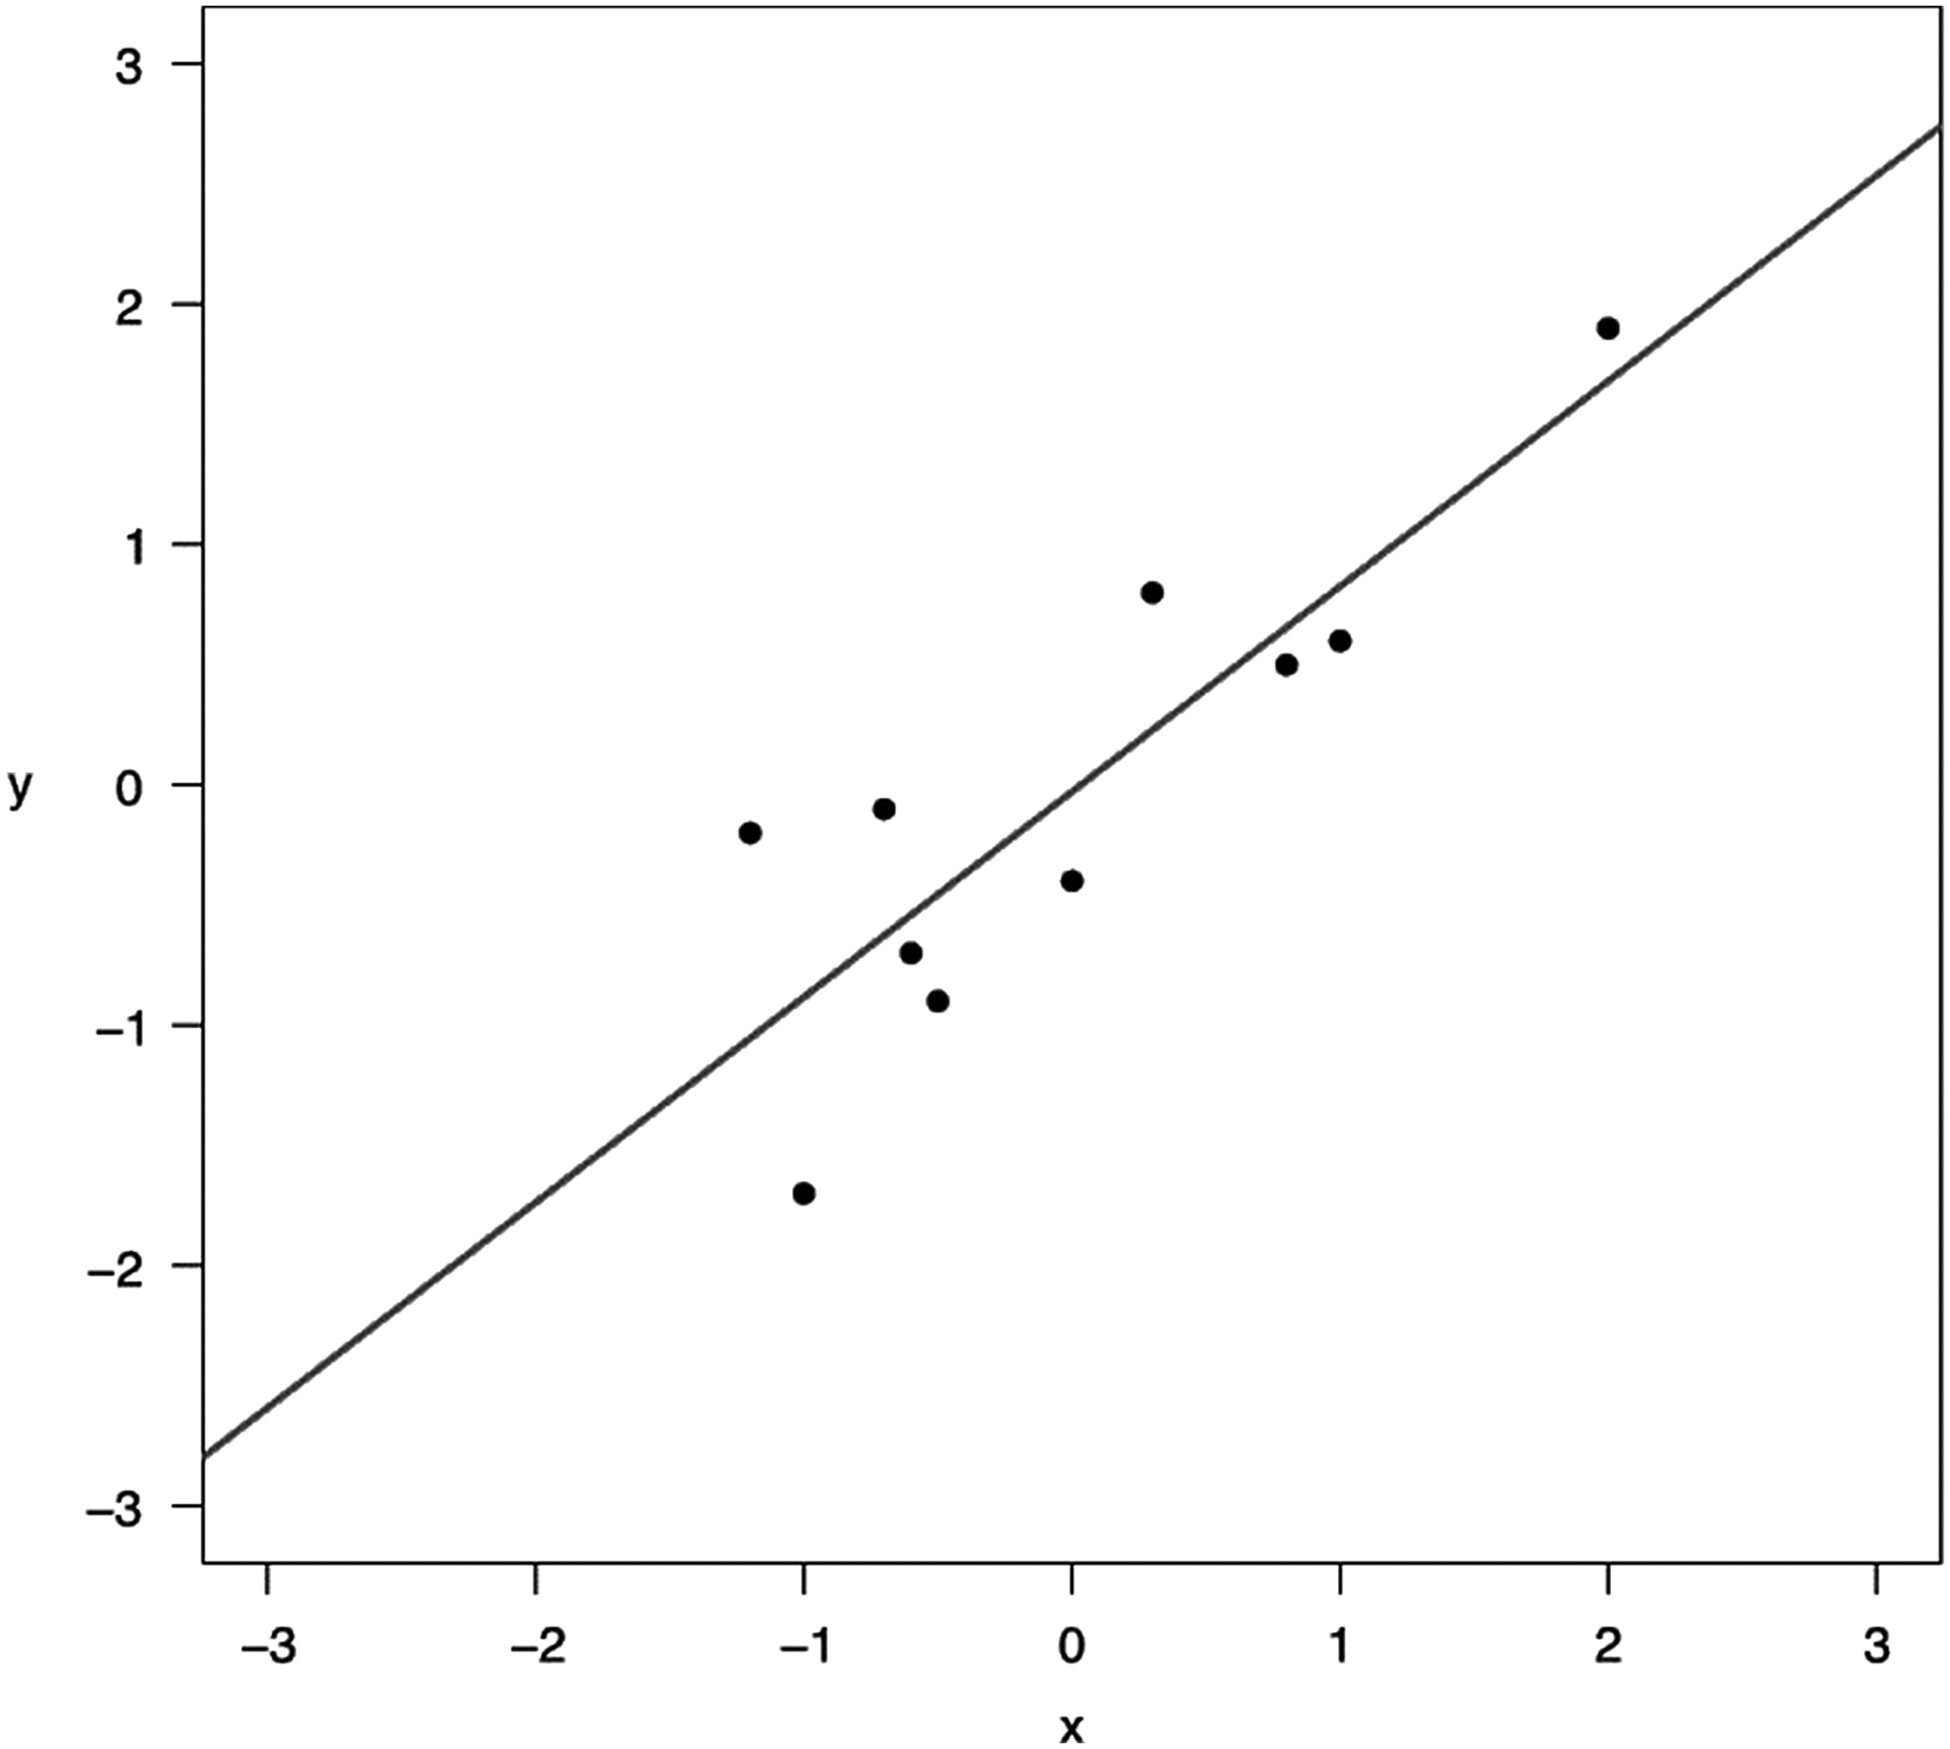
使用哪种分类算法取决于数据类型(例如图像、文本、实验室指标和基因数据),以及数据的大小和数据维度。应仔细选择相应的模型,使其能够很好地泛化到未见过的数据,而不仅仅是记忆训练数据(这种现象称为“过拟合”)。回归算法是另一种知名的监督式机器学习方法。在回归问题中,目标不是分离两个或多个类别,而是找到最能描述数据的函数,以预测新数据点的正确值(图3)。
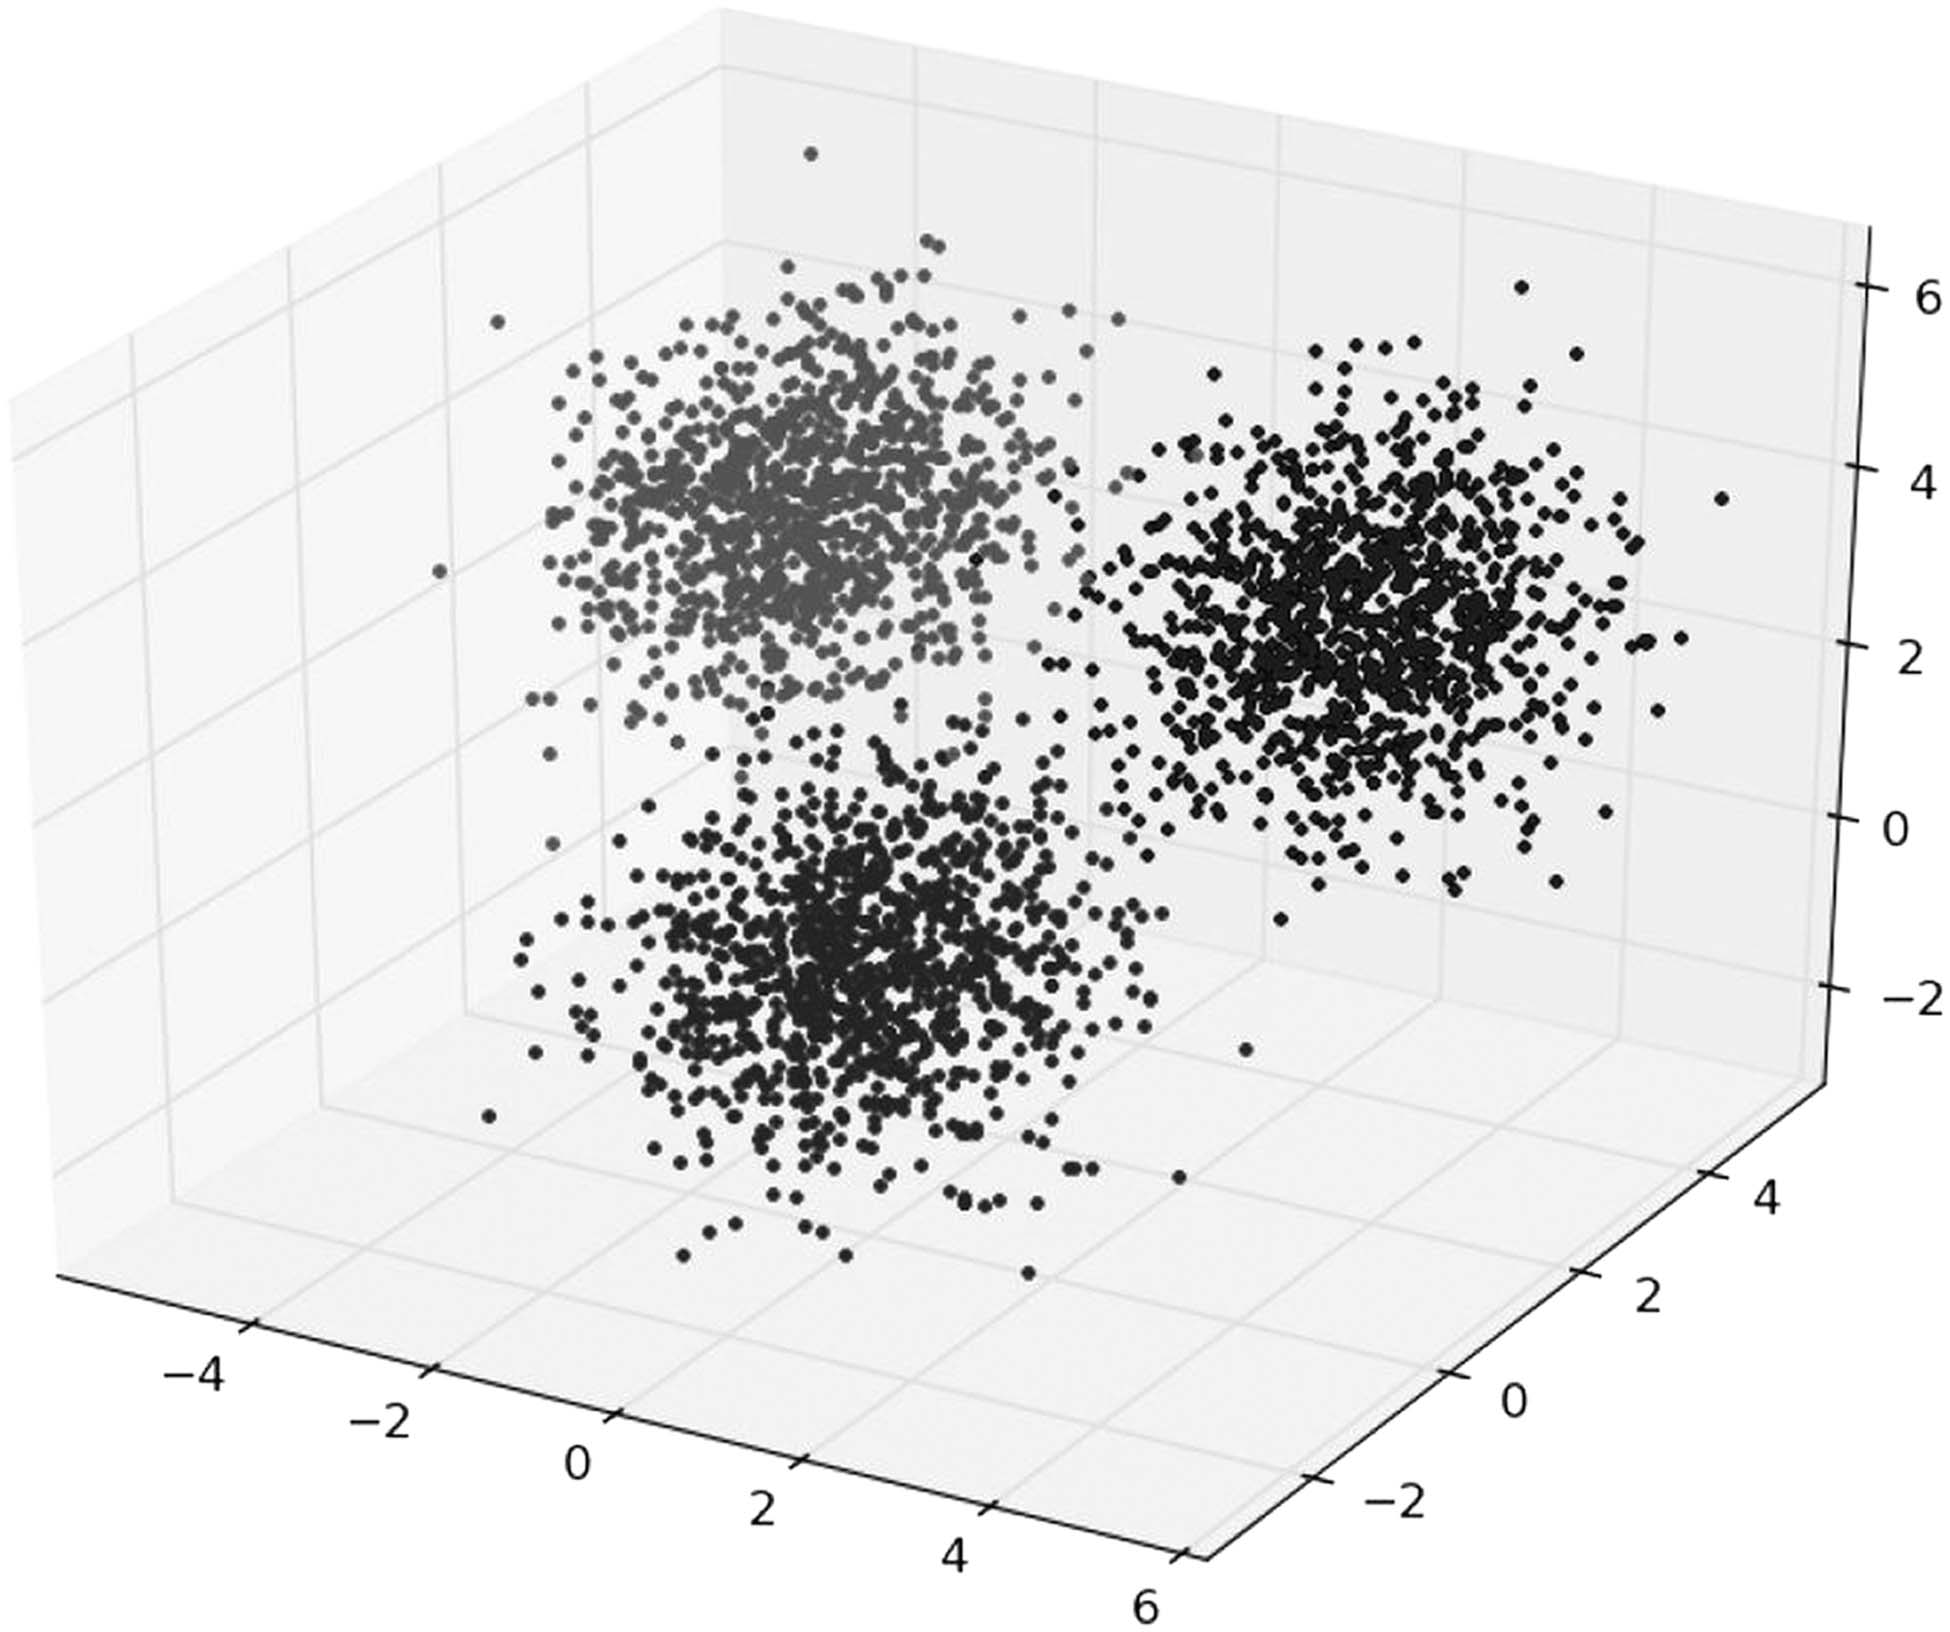
在无监督学习中,训练数据由一组输入变量组成,不包含监督学习所需的相应目标值(结果标签)。无监督学习问题的目标是发现数据中的模式并提取隐藏结构,完全通过数据驱动实现,无需专家标注。典型的例子是聚类问题,旨在将相似的数据点分组到一起(图4)。示例包括医院获得性感染患者的亚型检测,以及发现相似的患者亚组以将患者分配到临床试验中。用于无监督学习的典型机器学习方法包括k‐均值聚类或概率高斯混合模型。
近年来,由于医疗领域中可获得的常规电子数据量巨大且种类多样,机器学习技术在医疗流行病学领域变得越来越流行。然而,理论机器学习研究与临床研究之间仍然存在差距。开发新型机器学习技术的研究人员通常具有计算机科学、数学或物理学背景。他们进行前沿研究,开发新算法,甚至可能将这些算法应用于医疗数据。但是,他们对日常临床实践中数据生成过程缺乏全面了解。另一方面,医疗专业人员对临床问题以及特定医疗数据的质量有着深刻理解。如今,他们通常能够使用标准统计软件包(例如,R)自行应用一些机器学习方法。然而,一些医疗专业人员可能不了解模型背后的假设和局限性,这可能导致统计上不合理的模型或过拟合模型。这两个研究领域相互补充;要将数字医疗流行病学提升到一个新的水平,需要这些领域之间的相互理解、沟通与合作。
机器学习:在数字医疗流行病学中的最新应用
大量最近的报告展示了机器学习在数字医疗流行病学中的首批应用,最常见的是基于常规医疗数据进行预测(表1)。
通过机器学习可以实现这一目标,特别是分析大规模且多样化数据集合(有时涉及数千个变量),而这些数据可能会使更多依赖人工指导的建模方法变得复杂。
在一项基于密歇根大学医院电子病历数据以及马萨诸塞州总医院的典型回顾性研究中,Oh 等人采用数据驱动的方法,使用L2正则化逻辑回归构建针对特定医院的模型,以估算患者每日发生艰难梭菌感染(CDI)的风险。这些机器学习模型基于>150,000例成人住院患者的数据构建并进行了内部验证,涉及数千个时间不变和时间变化变量,预测性能良好,受试者工作特征曲线下面积范围为0.75至0.82。在两家机构中,模型均能在CDI诊断前至少5天识别出一半的真实阳性病例。作为监测或决策支持工具的一部分,这些模型有助于在微生物学检测结果出来之前快速识别新的CDI病例,或用于筛选应接受艰难梭菌检测的患者。此外,研究还识别出一系列机构特有的预测因子(例如特定科室),这可能促使医疗流行病学家开展进一步调查,以生成关于CDI发生或传播风险因素的(因果)假设。该研究很好地说明了医疗保健领域从构建“一刀切”的预测模型向应用更多以患者为中心的分析方法的范式转变,这种转变可能导致多种不同的数据驱动预测模型的出现。这种灵活的方法可以整合异质且不断变化的常规变量,但这也可能使跨医疗机构通用的预测模型的开发和应用变得复杂;来自不同系统的变量并非都能轻易对应。此外,这种方法允许机构在后续过程中调整其模型,而这种灵活性是必要的,因为电子病历中的变量及其相应的编码实践可能会发生变化,且基于回归分析和机器学习所构建的模型可能出现校准漂移。
即使使用基于大量潜在预测因子的最先进的机器学习算法,某些关注的结果也可能无法被准确预测。这一点最近在埃斯科瓦尔等人对凯撒医疗机构北加州地区21家医院的电子病历详细数据进行的一项回顾性研究中得到了说明。在这项研究中,无论是传统模型还是机器学习模型,在预测复发性艰难梭菌感染方面均未表现出良好的区分能力。此类研究结果可能表明,尽管本研究中拥有丰富的电子病历数据,但相关预测因子可能难以通过机器学习识别,甚至可能根本未包含在记录中。
此外,大多数机器学习预测模型的外部有效性和临床有效性,如同医学领域的大多数预测模型和评分一样,尚不明确。特别是在预测模型的开发和应用过程中,应以反映临床实践的方式对模型进行仔细评估。与传统预测模型相比,机器学习有时是一种“黑箱”方法,机器学习算法对预测变量的选择可能不透明且难以直观理解。然而,通过机器学习进行预测建模(与其他统计技术一样)并不要求仅包含因果预测因子,因为即使变量本身与感兴趣的结果无因果关系,也可利用大量变量及因果因素的代理指标来构建准确的预测模型(例如,脑钠肽作为心力衰竭的标志物)。
与预测任务相比,关于在医疗流行病学中使用机器学习进行因果推断以及识别独立风险因素(即因果建模)的报道较少,而这需要对偏倚进行仔细考量。混杂、交互作用、反向因果关系以及偶然效应。一些机器学习算法能够检测变量之间的线性和非线性交互作用,但在缺乏人工指导和专家知识的情况下,通过概念性因果框架充分解决混杂问题可能具有挑战性。已有研究提出可处理可观测的混杂的机器学习算法,未来这些方法可能会更加先进。因此,可以通过机器学习从常规医疗数据中生成因果假设,且所需人工指导较少(例如,识别隐匿性疫情来源)。然而,在观察性研究中应用机器学习无法替代样本量充足且执行良好的随机对照试验来进行因果推断,因为随机对照试验能够控制已知和未知/未测量的混杂因素。
最近大多数将机器学习应用于医疗流行病学实际任务的研究,至少部分依赖于来自电子病历的例行数据(表1)。这些丰富的数据源已被证明在针对先前未知的风险因素提出假设,以及构建针对各种感兴趣结果(例如,特定的医疗相关感染、医院并发症)的准确预测模型方面特别有用。
将电子病历数据与高质量队列或登记数据进行链接,已成为一种有价值的选项,可添加常规医疗记录中可能不存在的暴露、潜在混杂因素、效应修饰因子和结果,并采用严格的定义标准。这一选项尤为有价值,因为据报告,由于定义标准/编码实践的变化和差异以及缺失数据,电子病历(及其其他例行数据来源)的数据质量有时低于前瞻性调查所获取的数据。因此,依赖常规收集的健康数据的研究需要在研究设计阶段和分析阶段仔细考虑信息偏倚、选择偏倚和残余混杂的可能性。此外,相关研究结果的报告应尽可能透明。
除了结构化的例行数据元素外,非结构化数据(例如临床记录)现在可以通过自然语言处理的机器学习方法进行分析,从而提供合理的信息;这种方法可以进一步增加可获取的常规医疗数据的体量。然而,从日常例行临床记录中获得的医疗数据的增量价值尚未得到证实,且非结构化和结构化的例行数据并不总是可靠和适用的。
为了利用来自健康记录和其他常规数据源的日益增长的常规医疗数据体量,在任何机器学习任务中都需要考虑数据质量、数据异质性、缺失数据和选择性数据收集等问题;此前已有研究回顾了依赖常规医疗数据和大数据的研究所面临的主要挑战与机遇。
知识空白
迄今为止,关于最先进的机器学习在医疗流行病学中的应用报道较少。特别是,基于机器学习的预测模型在改善医疗服务提供方面的有效性和实效性仍有待证实。值得注意的是,机器学习如何充分转化为临床实践在很大程度上仍不清楚。因此,需要开展更多研究来阐明机器学习在医疗流行病学中的益处、弊端以及意外后果,并了解如何最好地将机器学习的成果应用于医疗实践。尽管有许多耸人听闻的媒体报道,但机器学习并非一种能将低质量数据转化为黄金的魔法技术,正如一位数据科学家最近所言:“医疗领域的机器学习仍处于蛮荒西部状态。”
常规医疗数据的数量、多样性和速度日益增加,显然为医疗流行病学中的监督式及潜在的无监督机器学习任务提供了巨大潜力。然而,为了充分利用(大型)常规数据进行质量改进和医疗研究,必须建立相应的方法学、伦理和数据安全标准以应对这些发展。
总结
数字医疗流行病学是医学领域中一个不断发展的学科,其发展得益于医疗日常常规记录所产生的大数据日益增多。机器学习可能成为医疗流行病学家工具库中的重要工具,以更好地利用大数据在感染预防与控制、质量改进以及医院资源的优化分配方面的潜力。由于机器学习项目的复杂性,通常应在领域专家与机器学习专家之间依据最佳实践进行紧密合作来开展。
 90


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


