微服务架构落地:基础服务 —— 报表服务(AI 集成篇:AI 增强报表能力)

企业级AI集成实战:基于MCP协议构建Agent×RAG×微服务架构 最近跟几个大厂的朋友聊天,发现一个很有意思的现象:大家手里都有一堆AI工具,ChatGPT、Claude、Cursor、各种RAG框架,但真正要把AI能力“丝滑”地接入到公司那些动辄几十万行代码、十几个微服务的复杂项目里,却总是卡在“最后一公里”。 问题不是技术本身,而是 工程化 。你可能会遇到: 一个简单的需求,比如“帮我查一下上周订单异常的用户”,需要手动拼接多个API、处理鉴权、解析不同格式的返回数据,最后才能喂给大模型。 想用RAG增强知识库,但公司内部文档散落在Confluence、GitLab、 阅读详情

大宗商品销采运储系统・六层架构连载(基础服务篇)

前面两篇我们完成报表服务基础架构、元数据、查询引擎、缓存权限的落地。传统报表服务已经可以稳定支撑销采运储绝大多数统计查询需求。

当前很多企业都在探索 AI 在报表场景的集成落地,但必须先明确一个前提:

AI 不是报表服务的必选项,不是架构升级的必经之路,更不存在“不引入 AI 就不能运行”的强制要求。
AI 是在原有稳定报表底座之上,做能力增强的可选方案。

一句话定边界:

报表底座负责稳、准、可控;AI 负责降低门槛、提升效率、辅助发现。AI 故障,报表必须还能正常用。


一、先定边界:哪些能做,哪些不要做

适合 AI 增强的场景

  1. 自然语言查询:业务人员输入“查一下上个月华东仓螺纹钢库存”,自动转成报表查询条件;

  2. 指标异常检测:自动识别库存突增、销量暴跌、运费异常,输出告警和简单归因;

  3. 报表辅助生成:根据业务描述,辅助生成报表元数据、查询脚本草稿,人工审核后发布;

  4. 报表内容智能解读:对报表结果做文字总结,帮助业务快速看懂数据。

不建议交给 AI 的场景

  • 直接让大模型生成 SQL 并执行;

  • 让 AI 绕过报表权限直接查数据;

  • 让 AI 直接写业务库、改单据、删数据;

  • 让 AI 替代数仓 ETL 和复杂统计;

  • 让 AI 在没有校验的情况下决定指标口径。

核心原则:

AI 只生成“查询意图”和“参数草稿”,不直接生成可执行 SQL。最终 SQL 仍由报表查询引擎根据元数据、权限、参数化规则生成。


二、AI 集成架构:插件化,不侵入主链路
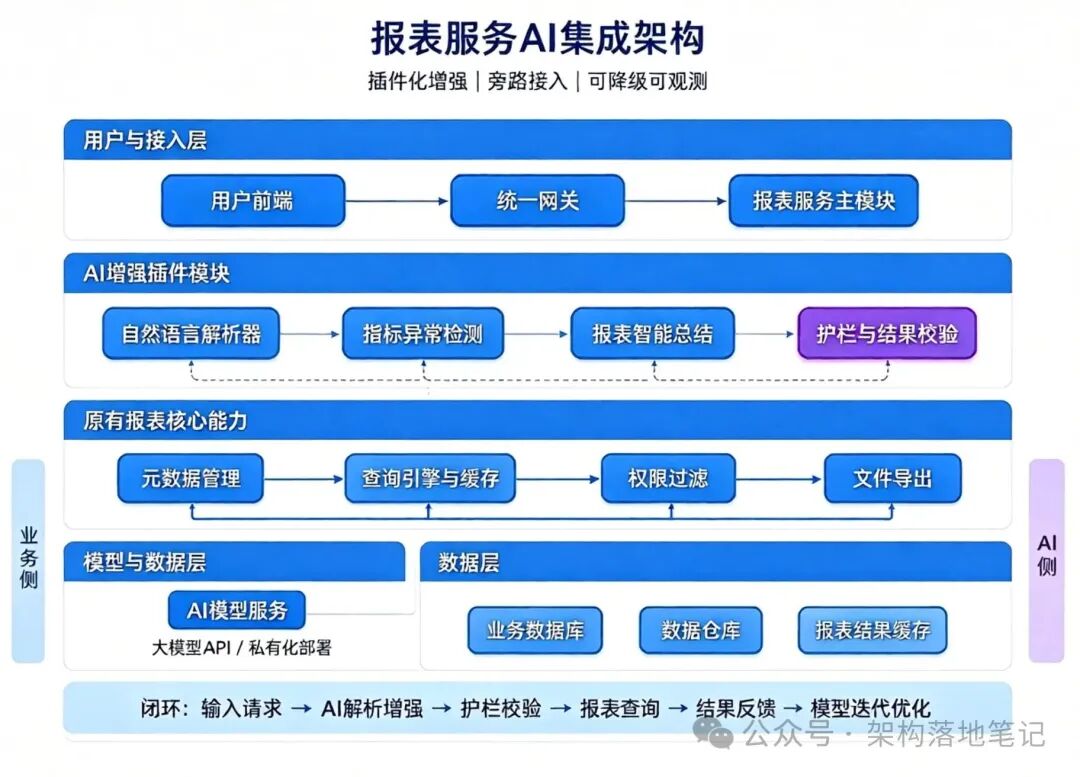
图片

结合上图,核心落地要求如下:

  1. 业务侧与AI侧严格隔离:AI 插件在旁路,不直接触碰底层数据库。

  2. 护栏与结果校验是必经之路:AI 解析出的结果,必须经过紫框的校验,才能进入原有报表核心能力。

  3. 原有报表核心能力是底座:即使 AI 侧链路(紫框以上)全部断开,原有的元数据、查询引擎、权限过滤和文件导出依然能独立工作。

  4. 数据层闭环:底部的模型迭代优化闭环,意味着 AI 效果不是一次性配置,而是通过结果反馈持续运营的。


三、落地优先级:先底座,后增强

如果你们正在建设报表服务,建议按这个顺序推进:

优先级能力说明
P0传统报表底座元数据、查询引擎、缓存、权限、慢查询治理
P1自然语言转查询参数只读、参数化、不直接生成 SQL
P2指标异常检测规则/统计模型优先,LLM 做解释
P3报表智能总结对脱敏后的结果做文字总结
P4报表辅助生成生成元数据草稿,人工审核发布

不要一上来就做“AI 自动生成 SQL 并执行”,这是高风险路径。


四、核心场景一:自然语言转报表查询

1. 正确链路

用户自然语言  → 意图识别:查哪张报表  → 参数抽取:时间、仓库、客户、物料、指标  → 生成 ReportQueryDSL  → 护栏校验  → 报表查询引擎根据元数据生成参数化 SQL  → 注入行级权限  → 执行查询  → 返回结果

不要让模型直接输出:

select * from orders where ...

而是输出:

{
  "reportCode": "INV_MONTHLY_SUMMARY",
  "params": {
    "startDate": "2026-01-01",
    "endDate": "2026-01-31",
    "warehouseId": "WH001"
  },
  "dimensions": ["warehouse", "material"],
  "metrics": ["qty", "amount"],
  "sort": [{"field": "amount", "order": "desc"}],
  "limit": 1000
}

然后由查询引擎根据 reportCode 找到元数据,生成参数化 SQL,并自动追加行级权限条件。

2. Prompt 模板示例

你是大宗商品销采运储报表查询参数解析器。你只能输出 JSON,不能输出 SQL,不能输出解释。可用报表:- INV_MONTHLY_SUMMARY:月度进销存汇总,参数:startDate, endDate, warehouseId- SALE_DAILY_SUMMARY:当日成交汇总,参数:statDate, customerId维度字典:warehouse, material, customer, org指标字典:qty, amount, weight, fee用户问题:{userInput}请输出符合以下 JSON Schema 的结果:{schema}如果无法确定,请输出 {"error": "无法识别"}

3. Java 伪代码

@Component
public class ReportAiAssistPlugin {

    private final ReportMetaService reportMetaService;
    private final UserService userService;
    private final ModelClient modelClient;
    private final AiGuard aiGuard;
    private final ReportQueryEngine queryEngine;

    public AiQueryResp nl2Query(String userInput, Long reportId, Long userId) {
        ReportMeta meta = reportMetaService.getById(reportId);
        UserDataScope scope = userService.getUserDataScope(userId);

        String prompt = buildPrompt(userInput, meta, scope);
        String modelResult = modelClient.callModel(prompt);

        AiGuardResult guardResult = aiGuard.check(modelResult, meta, scope);
        if (!guardResult.pass()) {
            throw new BusinessException("AI生成查询条件存在风险:" + guardResult.reason());
        }

        ReportQueryDSL dsl = parseResult(modelResult);
        return queryEngine.queryByDsl(dsl, userId);
    }
}

4. 护栏必须做

输入护栏:

  • 限制输入长度;

  • 过滤注入类字符;

  • 识别越权意图;

  • 不允许“查所有客户”“导出全表”等高风险表达。

输出护栏:

  • JSON Schema 校验;

  • 报表编码必须在白名单;

  • 参数必须在元数据定义范围内;

  • 枚举值必须来自字典;

  • 日期范围必须有限制;

  • 禁止出现 delete、update、drop、insert、;、-- 等关键字;

  • 最大行数、最大时间跨度限制。

执行护栏:

  • 只读账号;

  • 参数化 SQL;

  • 超时终止;

  • 最大行数;

  • 行级权限二次注入;

  • 全量审计。

AI 不能成为权限绕过通道。AI 生成的查询,必须和普通报表查询走同一套权限、缓存、限流、审计链路。


五、核心场景二:指标异常检测

不要直接让大模型判断“有没有异常”。更稳的做法是:

规则/统计模型检测异常  → 输出异常指标、时间、维度、偏离程度  → LLM 基于异常结果做解释和归因建议  → 人工确认

常用检测方法

  • 同比/环比;

  • 3σ;

  • MAD 中位数绝对偏差;

  • EWMA 指数加权移动平均;

  • 阈值规则;

  • 季节性分解。

输出示例

{
  "anomaly": true,
  "level": "HIGH",
  "metric": "库存数量",
  "dimension": "华东仓 / 螺纹钢",
  "time": "2026-01",
  "currentValue": 125000,
  "expectedValue": 82000,
  "deviation": "+52.4%",
  "possibleReasons": [
    "采购集中入库",
    "销售出库减少",
    "跨仓调拨未及时出库"
  ],
  "suggestion": "建议核查采购入库单和调拨单"
}

LLM 只基于给定异常数据总结,不允许编造不存在的原因。原因最好从候选集中选择,或标记为“可能原因,需人工确认”。


六、核心场景三:报表辅助生成

AI 可以根据业务描述生成报表元数据草稿:

业务描述:我要一张月度进销存汇总,按仓库和物料统计数量、金额,支持按日期和仓库筛选。

AI 输出:

{
  "reportCode": "INV_MONTHLY_SUMMARY_DRAFT",
  "name": "月度进销存汇总",
  "category": "仓储",
  "params": [
    {"name": "startDate", "type": "date", "required": true},
    {"name": "endDate", "type": "date", "required": true},
    {"name": "warehouseId", "type": "select", "required": false}
  ],
  "dimensions": ["warehouse", "material"],
  "metrics": ["qty", "amount"],
  "queryDraft": "select warehouse_id, material_id, sum(qty), sum(amount) from ..."
}

注意:

  • 只生成草稿;

  • 必须人工审核;

  • 必须走元数据发布流程;

  • 禁止 AI 直接上线报表;

  • 禁止 AI 直接修改生产元数据。


七、核心场景四:报表智能总结

对报表结果做总结时,先脱敏,再送模型。

适合总结:

  • 本月库存变化;

  • 销售 Top10 客户;

  • 异常波动说明;

  • 同比环比变化;

  • 区域/品类对比。

不适合:

  • 包含成本价、毛利、供应商敏感信息未脱敏的数据;

  • 超大数据集;

  • 需要精确法律口径的财务结论。

建议:

LLM 总结只作为辅助阅读,不替代正式报表口径和财务确认。


八、模型选型与环境搭建

两种路线

维度私有化部署开源模型调用大模型 API
数据安全高,数据不出网需脱敏,依赖厂商
成本前期高,长期可控按量付费,验证快
效果取决于模型和调优通常更强
运维需要 GPU、推理服务运维轻
适用阶段生产、敏感数据验证、非敏感场景
信创环境适合需评估合规

推荐路线:

  1. 测试验证阶段:API + 脱敏数据;

  2. 小流量阶段:私有化模型 + 灰度;

  3. 生产阶段:模型网关统一接入,支持多模型切换。

模型网关要统一

不要让业务代码直接调用某家模型 API。建议封装 ModelClient:

  • 统一超时、重试、限流;

  • 统一日志、审计、成本统计;

  • 支持模型切换;

  • 支持脱敏;

  • 支持缓存常见问题;

  • 支持降级。


九、评估与测试

测试集要提前准备

  • 100~500 条真实业务自然语言问题;

  • 覆盖采购、销售、仓储、运输;

  • 覆盖模糊表达、错别字、多条件、时间范围;

  • 构造异常样本和正常样本;

  • 构造越权、注入、诱导性输入。

评估指标

指标说明
意图识别准确率是否找到正确报表
参数抽取 F1时间、仓库、客户、物料是否抽对
DSL 合法率输出是否符合 Schema
查询执行成功率最终能否查到结果
异常召回率异常是否被发现
异常误报率正常是否被误判
人工采纳率业务是否愿意用
平均耗时端到端响应时间
单次成本Token 成本

测试通过标准建议

  • DSL 合法率 ≥ 99%;

  • 查询执行成功率 ≥ 95%;

  • 越权拦截率 100%;

  • 异常召回率 ≥ 80%,误报率 ≤ 10%;

  • AI 故障降级成功率 100%。


十、灰度上线与风险控制

灰度阶段

  1. 阶段 0:AI 关闭,只保留传统报表;

  2. 阶段 1:内部研发、产品试用;

  3. 阶段 2:业务专家试用,收集问题;

  4. 阶段 3:小流量账号开放;

  5. 阶段 4:逐步放量,保留一键关闭开关。

风险控制

  • 数据脱敏:客户、价格、供应商、成本等敏感字段脱敏;

  • 权限隔离:AI 查询必须走用户权限;

  • 只读限制:AI 只能生成查询,不能写数据;

  • 护栏校验:输入、输出、执行三层护栏;

  • 全量审计:记录输入、输出、耗时、用户、报表、是否命中护栏;

  • 成本控制:Token 预算、缓存、小模型优先、异步执行;

  • 降级方案:AI 超时/异常直接走传统报表。


十一、落地效果对比

能力项传统报表AI 增强报表
查询方式手动选维度、填条件自然语言描述自动生成查询条件
异常发现人工查看对比自动识别指标异动,推送告警
报表配置人工配置元数据、写 SQLAI 辅助生成草稿,人工审核
数据解读人工看表自动生成文字总结
故障影响报表正常使用AI 异常,原有报表完全可用
安全边界权限、只读、审计同样权限、只读、审计,外加 AI 护栏

十二、本篇小结

AI 对报表服务属于可选增强,核心思路是:

插件化集成,和原有报表主链路解耦;做好安全护栏、灰度发布、数据脱敏;优先在测试环境验证准确率,再逐步放量上线。

落地记住三句话:

  1. AI 不直接生成 SQL,只生成查询 DSL 和参数草稿;

  2. AI 不绕过权限,必须走报表查询引擎;

  3. AI 故障不影响报表,传统能力始终可用。

报表服务三篇连载到此完成。

下篇预告:报表服务之后,我们将进入基础服务的收尾模块,继续完整走完大宗商品销采运储六层架构的基础服务拆解

Java后端面试新趋势:AI集成能力成为关键加分项 随着企业数字化转型加速,AI大模型集成已成为后端开发的重要技术方向。从技术原理来看,AI接口调用本质上是外部服务集成,但增加了流式响应、长连接等新特性。在工程实践中,Java开发者可以运用熟悉的SpringBoot框架和Redis缓存技术,通过SSE实现流式输出,结合异步处理提升系统性能。这种技术融合的价值在于,既能保持传统系统的稳定性,又能为业务注入智能问答、内容生成等AI能力。在电商客服、知识库系统等应用场景中,AI集成已成为提升用户体验的关键技术。本文聚焦Java后端面试中的AI集成考点,帮助开发者掌 阅读详情

相关推荐

微服务架构下大模型API统一网关:安全集成、成本控制与高可用设计

在微服务架构中,API网关是解耦服务、统一管理外部依赖的核心组件。其核心原理是作为所有外部请求的唯一入口,通过路由、认证、限流、监控等机制,实现服务的集中管控与安全保障。这一技术价值在于能显著提升系统的可维护性、安全性和可观测性。在AI应用场景下,当多个业务微服务需要集成不同供应商的大模型API时,直接调用会带来密钥管理混乱、成本不可控、运维复杂等挑战。此时,一个专门设计的AI网关层成为关键解决方案。它能将分散的API调用收敛于一处,通过统一的认证鉴权机制管理访问权限,并利用精细化的路由策略、Token计量

cqbh2011的博客 495

微服务架构落地:基础服务 —— 报表服务(上篇:定位、边界与整体架构)

本文首发于微信公众号,优快云为同步发布版本

helloword_monkey的博客 335

AI编排不是加API:企业级MuleSoft与LangChain协同落地框架

AI编排(AI Orchestration)是实现大模型在企业系统中稳定、安全、可审计运行的核心工程范式,其本质在于解耦AI的非确定性推理能力与企业系统的强契约、高可靠、细粒度权限等刚性要求。技术原理上,它通过分层架构将数据集成、协议转换、字段映射、安全脱敏等职责交由MuleSoft等企业集成平台承担,而将Prompt链管理、工具调用、RAG检索、对话记忆等AI原生逻辑交由LangChain等框架处理。这种分工带来显著技术价值:保障SLA、满足GDPR/SOX等合规审计、支持AB测试与可观测性追踪。典型应用

weixin_34262482的博客 690

微服务到底要不要上?中小项目如何低成本落地

微服务不是一种“状态”,而是一个过程。对于中小项目而言,“不上微服务”往往是更明智的起点,但“具备微服务的能力”是必须的终点。在2026年,技术的进步让我们能够以更低的成本、更小的风险去拥抱微服务。核心建议总结:能不分就不分,直到痛点出现。先逻辑拆分,后物理拆分(模块化单体是最佳过渡)。能买就不建,充分利用云厂商的托管能力。善用AI,让工具帮你处理复杂性和监控。记住,架构的目的是服务于业务,而不是炫技。最适合你的架构,永远是那个能让你的团队以最快迭代速度、最低成本交付价值的架构。

2603_94941287的博客 440

AI编排:企业级系统集成与大模型协同的中枢架构

AI编排是一种面向企业生产环境的智能决策流调度范式,其核心在于协调异构系统(如CRM、ERP)与AI能力(如LLM、RAG)之间的安全、合规、可审计交互。它既非单纯API编排,也非纯提示工程,而是融合数据治理、权限控制、协议适配与模型调度的复合型基础设施。技术原理上,依赖运行时数据清洗、动态脱敏、结构化契约传递与服务边界隔离;其价值体现在降低AI落地的运维风险、满足GDPR/HIPAA等合规要求,并支撑销售预测、客户流失预警等高价值场景。本文聚焦MuleSoft与LangChain协同实践,揭示AI编排如何

weixin_34241036的博客 480

大数据DaaS架构深度剖析:微服务+容器化实践

在数字化转型的浪潮中,企业对“数据驱动决策”的需求激增:业务部门需要快速获取用户行为分析、实时销售报表等数据服务,而传统大数据平台(如Hadoop集群)往往以“项目制”交付,响应慢、复用性差。DaaS(数据即服务)的出现,正是为了将分散的大数据能力封装成标准化、可调用的服务(类似“数据API”),让数据像水电一样按需获取。本文聚焦“如何用微服务+容器化技术构建DaaS架构”,覆盖概念解析、技术选型、实战案例及未来趋势,适合大数据工程师、架构师及对云原生技术感兴趣的开发者阅读。

AI智能探索者的博客 1010

2025 CRM 革命:从微服务到 AI 服务,架构重生才是智能转型核心

CRM+AI转型的困境与破局之道 尽管大模型技术快速发展,72%的企业仍面临CRM与AI融合的困境,销售团队依然依赖传统工具。失败根源在于架构思维:表层AI集成、数据治理不足和功能堆砌。破局需从底层重构:1)构建智能数据基座,实现实时特征工程;2)打造AI能力中台,贯穿业务流程;3)以场景驱动设计六大智能体(营销、销售、客服等),使AI成为"数字员工"。运营商等企业案例显示,深度重构可使营销响应率提升3倍,销售周期缩短38%。技术实现需分三阶段:数据智能升级→流程重构→生态拓展,采用大模

技术传感器的博客 1552

车窗标定工作流程

标定简单来说就是修改防夹参数来适配对应的车型,所有的防夹的参数在vers_userdef.h文件中定义。#标定内容。

qq_21274991的博客 4270

QuickBlue:基于微服务与JDK 21的企业级AI应用底座架构实践

企业级AI应用常面临模型接入混乱、提示词管理困难、多租户资源隔离等挑战。通过微服务架构与Spring Cloud服务治理,结合JDK 21虚拟线程对IO密集型场景的优化,可构建统一AI底座,实现模型路由、知识库检索增强、权限计量与可观测等核心能力。该底座将公共能力下沉,使业务应用专注逻辑,适用于多业务线AI能力快速交付、成本精细化管理及故障隔离等场景。QuickBlue正是这一思路的工程化落地,为AI应用提供稳定、可扩展的基础平台。

weixin_34098209的博客 274

如何利用 多 张 GPU 高效运行 Ollama

通过以上步骤,我们可以确保系统尽可能地利用所有 多张GPU 来运行 Ollama。如果在配置过程中遇到问题,建议查阅 Ollama 的官方文档,确认其是否支持多 GPU 并行计算,或者对系统性能进行进一步的优化。充分利用多 GPU 的并行计算能力,可以显著提升 Ollama 的运行效率,加快模型的推理和训练速度。希望本文能帮助你顺利实现 多张 GPU 的高效利用。

weixin_44997264的博客 8031

保姆级教程:用Adams/Car和Simulink搞定你的第一个整车联合仿真(附模型文件)

本文提供了一份详尽的Adams/Car与Simulink联合仿真教程,涵盖从环境配置到模型导出的全流程。通过实战案例解析,帮助工程师快速掌握多体动力学仿真与控制算法开发的集成技术,特别适合汽车工程领域的初学者。文章还包含常见问题解决方案和性能优化建议,助您高效完成整车联合仿真项目。

weixin_29663861的博客 337

2026 企业AI业务系统服务商有哪些?五大核心维度拆解主流厂商技术架构与落地能力

真正的企业AI业务系统,不是在传统ERP上叠加一个AI聊天窗口,而是让AI从底层架构融入财务、供应链、制造、人力等全价值链,形成"洞察-决策-执行"的闭环。对于中大型成长型企业来说,真正有价值的AI业务系统需要同时具备:云原生架构支撑的弹性扩展能力、AI深度融入全业务场景的原生能力、覆盖国际国内主流标准的安全合规体系。真正有价值的AI业务系统,不是提供问答机器人,而是让智能体直接参与费用审核、库存补货、生产排产、合同审查等具体业务动作,实现从"人看数据做决策"到"AI驱动决策人执行"的跃迁。

weixin_48291902的博客 425

Halcon实战:基于图像清晰度自动筛选最佳对焦图片

本文详细介绍了如何使用Halcon实现基于图像清晰度的自动筛选最佳对焦图片技术。通过分析灰度值统计和标准差等核心指标,结合实战代码示例,帮助开发者高效处理工业检测中的对焦问题,提升自动化检测的准确性和效率。

weixin_27015733的博客 438

QuickBlue AI应用底座:基于Spring Cloud与JDK 21的微服务治理实践

微服务架构通过Spring Cloud实现服务注册发现、配置管理和网关路由,解决单体应用拆分后的治理难题。其核心原理在于将通用能力下沉至平台层,利用JDK 21虚拟线程提升高并发场景下的资源利用率。技术价值体现在统一技术栈、降低维护成本,并支持AI推理服务的无缝接入与限流降级。典型应用场景包括企业级AI应用、智能客服和RAG检索流程编排。QuickBlue作为AI应用底座,正是基于Spring Cloud与JDK 21,将微服务治理与AI能力适配整合为可复用的基础平台。

weixin_33404102的博客 266

智能车‘大脑’的诞生:揭秘电磁循迹代码背后的控制论与系统思维

本文深入探讨智能车电磁循迹系统的核心架构与控制原理,揭示了其作为精密闭环系统如何通过模块化设计、信号处理、PID控制算法及电机驱动实现自主导航。重点分析了电磁信号采集与处理流程框架,为开发者提供从理论到实践的全面指南。

arduino9maker的博客 531

GEE训练教程:基于Sentinel-2卫星的归一化建筑指数(NDBI)等的进行城市扩张分析

本文介绍利用Sentinel-2卫星数据和谷歌地球引擎平台监测印度卡姆鲁普都会区2018-2024年城市扩张的方法。通过计算归一化建筑指数(NDBI)、植被指数(NDVI)和水体指数(MNDWI),采用多阈值规则识别建设用地,并量化不同年份的城市扩张面积。代码实现了从数据预处理、指数计算到面积统计的完整流程,为城市扩张研究提供了可复制的技术方案。关键参数包括年份选择、云覆盖阈值和分类阈值,均可根据研究需求调整。该方法能有效追踪城市边界变化,为城市规划提供数据支持。

此星光明博客 135

Java微服务与AIGC架构实战:大厂面试技术解析

微服务架构是现代分布式系统的核心设计模式,通过Spring Cloud等框架实现服务解耦与弹性扩展。其技术原理基于领域驱动设计(DDD)和云原生理念,采用容器化部署和API网关统一治理。在AIGC等高并发场景中,微服务配合消息队列(Kafka/RabbitMQ)能有效应对内容生成、分发的异步处理需求。Java生态的Spring Boot提供了RESTful接口快速开发能力,结合JVM调优(如G1GC策略)可显著提升AI服务吞吐量。典型应用还包括使用Redis实现多级缓存缓解数据库压力,以及通过向量数据库(M

weixin_30709061的博客 306

语义分割(Semantic Segmentation)近年发展综述

目标:为图像中每个像素分配一个语义类别标签(如“道路”、“行人”、“天空”),不区分同类实例。关键挑战精确边界恢复(高空间分辨率)全局上下文理解(大感受野)计算效率与精度平衡小样本/弱监督泛化语义分割的十年演进,是一条从专用→通用、封闭→开放、慢速→实时、像素→语义2015:FCN/U-Net 奠基;2018:DeepLabv3+/PSPNet 实现高精度;2020:HRNet+OCR 登顶竞赛;2021:SegFormer 开启 Transformer 新纪元;2023+

浩瀚之水的专栏 976

QuickBlue:面向Java微服务的AI应用底座实战指南

AI应用底座是支撑大模型能力在企业级系统中安全、可观测、可治理落地的核心基础设施。其本质是解决传统微服务架构在协议适配(如SSE流式响应)、调用链追踪、成本分摊与Prompt版本管理等方面的结构性缺失。依托JDK21虚拟线程实现高并发低延迟,结合Spring Cloud 2025的AI感知路由与Reactive Stream原生支持,并通过Vite 8保障前端AI能力快速迭代,真正打通LLM工程化‘最后一公里’。本文聚焦QuickBlue这一经过金融、制造、政务场景验证的AI原生平台,详解其分层设计、技术选

weixin_31309419的博客 274

免费教你快速学会分析运算放大器电路(保证学会)

本文旨在学习如何快速简单地对运算放大器进行分析

一名热爱技术的工程师的博客。分享技术干货,记录美好生活。永远相信美好的事情即将发生。 1万+

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

基于微服务架构的AI智能客服系统:从传统客服到智能问答的完整解决方案

本文介绍了一个基于微服务架构的企业级AI智能客服系统,该系统整合了大语言模型(LLM)、知识库检索(RAG)和工单管理等核心功能,提供从传统客服到智能问答的全流程解决方案。系统采用Spring Boot 3.x + Vue 3技术栈,支持多租户和会话隔离,具备高扩展性和可用性。核心特性包括:基于LLM的智能对话、RAG知识库检索(支持多格式文档和向量化存储)、工单系统、实时通信和客户管理。文章详细阐述了系统的微服务架构设计、RAG工作流程及新增的文档版本管理功能,并提供了快速启动的环境要求和步骤。

欢迎点赞 + 关注,开源项目见下方栏目 1643

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

构建企业级微服务架构:开源低代码平台的生产环境部署与架构解析

JeeLowCode是一款基于Spring Boot的企业级低代码开发框架,专为技术决策者和架构师设计,以微服务架构为核心,提供完整的可视化开发解决方案。该平台通过模块化设计、多数据库支持和容器化部署能力,帮助企业快速构建复杂业务系统,实现数字化转型的高效落地。作为完全开源且免费商用的解决方案,JeeLowCode不仅降低了技术门槛,更通过专业的架构设计保障了企业级应用的高可用性和可扩展性。 #

gitblog_00372的博客 903

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

AI服务架构图

数据层:作为核心支撑底座,整合托育领域政策文件、技能标准、科学养育指南、机构证照信息等海量资源,同时收集网站论坛等热点信息,为 AI 模型训练与应用提供坚实的数据基础和理论依据;处理层:聚焦数据质量把控与价值挖掘,通过数据治理、关键词提取、实体识别等系列处理流程,有效降低模型幻觉风险,持续提升数据可信度与可用性,进而保障模型回复的精准性,筑牢用户对 AI 服务的信任基石;模型层。

qq_43781332的博客 1147

如何构建高效企业级数据架构:开源数据中台解决方案深度解析

在数字化转型浪潮中,企业数据架构的复杂性日益凸显,数据孤岛、治理混乱、价值挖掘困难成为普遍痛点。AllData数据中台作为开源可定义数据中台项目,以数据平台为底座、数据中台为桥梁、机器学习平台为工厂,为企业提供全链路数字化解决方案,帮助企业实现数据的统一管理、高效利用和价值挖掘。 ## 一、数据架构设计的核心挑战与应对策略 企业级数据架构面临的核心挑战包括:数据源异构性、实时处理需求、治理规范

gitblog_00952的博客 957

为什么选择yudao-cloud:企业级微服务架构与物联网工作流双引擎的全面解决方案

在数字化转型浪潮中,企业面临着传统业务系统难以适应物联网时代、业务流程僵化、系统集成复杂等核心痛点。yudao-cloud作为基于Spring Cloud Alibaba的企业级微服务架构平台,通过物联网模块与工作流引擎的双重赋能,为企业提供从设备管理到业务流程自动化的完整技术栈,助力企业快速构建智能化应用系统。 ## 行业痛点与挑战分析 传统企业系统在物联网时代面临多重挑战:设备管理分散导致

gitblog_00110的博客 898

互联网大厂 Java 面试实战:从 Spring Boot 到 AI 微服务的全链路问答

Lambda 与函数式接口标记单抽象方法接口,Lambda 可直接实例化。:Maven 结构化、生命周期固定;Gradle DSL 灵活、增量编译快。大型项目偏向 Maven,模块化新特性可采用 Gradle。GC 日志表示 Young GC,使用 G1 回收器的复制算法,暂停期间会把存活对象迁移到新区域。

qq_34968019的博客 731
上一篇: 微服务架构落地:基础服务 —— 报表服务(中篇:元数据、查询引擎、缓存与权限落地)
下一篇: 微服务架构落地:公共中间件层总览——不承载业务,只承载稳定性
code_slave(码畜)
博客等级 码龄10年 31粉丝 49原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

