【知识星球】为什么图像分类任务要从256*256中裁剪出224*224

卷积神经网络(AlexNet)识别Fashion-MNIST数据集(Pytorch版) 卷积神经网络(AlexNet)识别Fashion-MNIST数据集(Pytorch版)1. 前言1.1 案例介绍1.2 环境配置1.3 模块导入2. 图像数据准备2.1 训练验证集的准备2.2 测试集的准备3. 卷积神经网络的搭建4. 卷积神经网络训练与预测5. 运行程序 1. 前言 1.1 案例介绍 本案例使用Pytorch搭建一个稍微简化的AlexNet网络结构,用于Fashion-MNIST数据集的图像分类。针对该问题的分析可以分为数据准备、模型建立以及使用训练集进行训练和使用测试集测试模型的效果。 阅读详情
AI摘要

本文深入探讨了深度学习中图像分类任务的输入尺寸选择原因,解释了为何输入常设定为224*224,并分析了从256*256中裁剪224*224的原理,旨在帮助读者理解图像预处理的重要性。

欢迎大家来到《知识星球》专栏,这里是AI1000问小专题。

作者&编辑 | 言有三

1 图像分类任务输入尺寸相关的问题

有关于经典的图像分类任务中的输入图像尺寸问题,很多同学都有疑问,我们之前已经回答过为什么图像分类网络输入大小是224*224,可以查看往期解答,【AI-1000问】为什么深度学习图像分类的输入多是224*224。

今天再来回答一个与之相关的,为什么很多模型将输入缩放到256*256然后裁剪成224*224呢?

有三AI1000问-模型篇

为什么要从256*256中裁剪出224*224
640?wx_fmt=png

大家都知道,很多模型的训练是先将图像resize到256*256,然后再随机裁剪成224*224大小,为什么是这么做呢?

作者/编辑 言有三

首先要回顾一下为什么分类任务的输入图像大小常常是224*224。


分类任务输出特征图如果尺寸太小,那么信息就丢失太严重,如果尺寸太大,信息的抽象层次不够高,计算量也更大,7*7的大小是一个很好的平衡。图像从大分辨率降低到小分辨率,降低倍数通常是2的指数次方,所以图像的输入一定是7*2的指数次方。以ImageNet为代表的大多数分类数据集,图像的长宽在300分辨率左右。

所以要找一个7*2的指数次方,并且在300左右的分辨率作为输入,其中7*2的4次方=7*16=112,7*2的5次方等于7*32=224,7*2的6次方=448,与300最接近的就是224了。

接下来我们再思考为什么通常是将图像resize到256*256。

首先我们要知道crop的目标是用于做数据增强。

当我们描述一个数据集的大小,通常是以数量级来衡量,而数据增强也比例外,我们的目标是将数据集增长为原来的几个数量级以上,即扩充10,100,1000倍等。

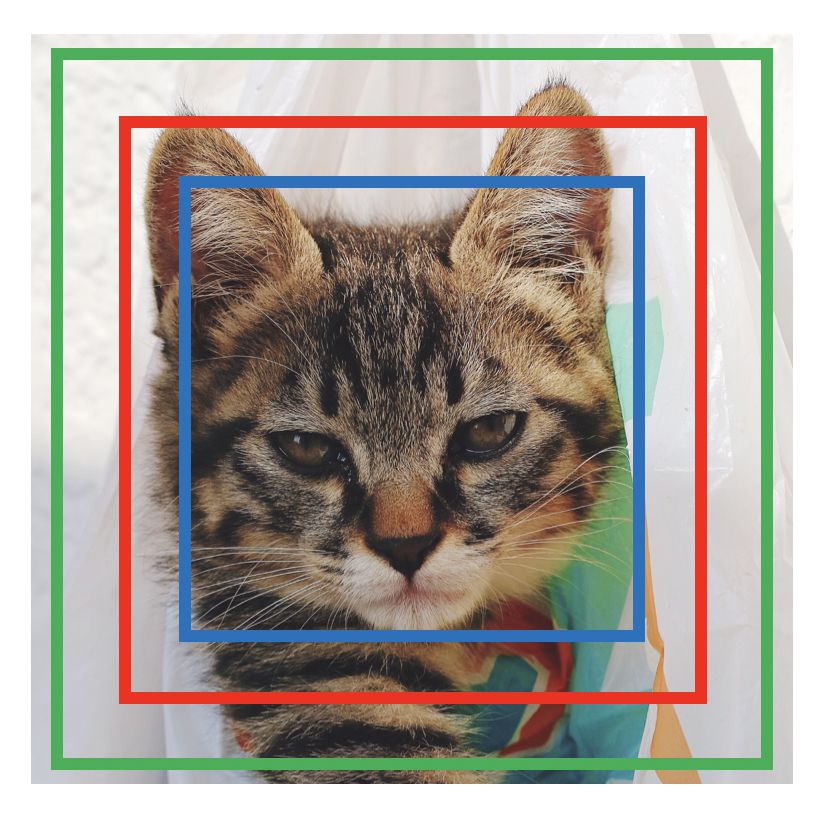
输入为N*N的大图,crop输出为M*M的小图,可以实现(N-M)*(N-M)的数据集扩充倍数。对应扩充10,100,1000,10000倍,N-M约为3,10,32,100,因为最终结果图是224*224,所以原图就应该是227*227,234*234,256*256,324*324,很明显从256*256这个尺度进行裁剪,能够保证主体不至于太小或者太大,如前面图中红色框。


那不使用256*256使用其他的尺寸如何呢?在比赛刷榜中,经常使用多尺度模型测试,即使用不同尺度的输入图进行裁剪然后进行结果融合,笔者曾经在Place365数据集上训练过ResNet和DPN模型,下面是不同尺度的测试结果。
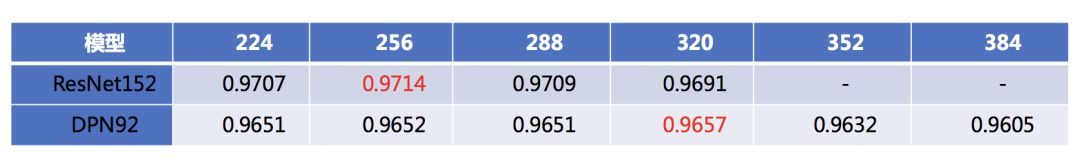
640?wx_fmt=png

不同尺度的结果会有差异,但是通常都不大,因此除非模型特殊,不必太纠结与这个问题,毕竟256等于2^8,2的指数次幂,多么经典又快意。

2 更多AI1000问

更多的问题,可以移步知识星球阅读,也可以主动提出需求,合适的问题会被添加进本系列!
640?wx_fmt=jpeg

有三AI知识星球的内容非常多,大家可以预览一些内容如下。

640?wx_fmt=png

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg


以上所有内容

加入有三AI知识星球即可获取

来日方长

点击加入

不见不散

更多精彩

每日更新


640?wx_fmt=jpeg

转载文章请后台联系

侵权必究

640?wx_fmt=png

640?wx_fmt=png

640?wx_fmt=png

往期精选

滤波算法-呼吸心跳信号检测方法(四) 呼吸心跳信号检测系列文章:信号滤波处理 阅读详情

相关推荐

Sharding Sphere JDBC使用Mybatis的saveBatch无法返回主键的问题

Sharding Sphere JDBC使用Mybatis的saveBatch无法返回主键的问题

HHCS231的博客 1837

为什么深度学习图像分类里的图片的输入大小都是224*224呢?

在论文中进行各类方法的比较时,要求使用同样的数据集。而为了公平的比较,网络的输入大小通常都是224*224的大小,那为什么呢? 我们都知道,一个图像分类模型,在图像中经历了下面的流程。 从输入image->卷积和池化->最后一层的feature map->全连接层->损失函数层softmax loss 从输入到最后一个卷积特征feature map,就是进行信息抽象的过程,然后就经过全连接层/全局池化层的变换进行分类了,这个feature map的大小,可以是3*3,5*5

Mr_zhuo_的博客 1万+

从内参矩阵到归一化平面:揭秘相机成像的标准化核心

本文深入解析了相机成像中的核心概念——归一化平面。通过拆解内参矩阵(包含焦距、主点等参数)的作用,详细阐述了如何将像素坐标转换为与具体相机硬件无关的归一化坐标。这一标准化过程是计算机视觉算法(如多相机系统对齐、视觉SLAM)实现跨设备通用性的关键,能有效提升算法的鲁棒性和泛化能力。

opencv7vision的博客 450

灵魂拷问——为什么深度学习图像分类的输入多是224*224?

最近在做细粒度图像检索,老师提供的数据集数量太少,我就想着能不能去网上爬一些图片。但是我发现我爬到的那种图片尺寸都挺小的,只有十几二十几KB,尺寸也只有184x276。我心想做深度学习时一开始就要将图片resize成224x224,这么小的图片应该没用吧。 图1 17.5KB的小图 到了开组会时,老师问我要数据集,我摊摊手说都是些小图,感觉没什么用。老师说这也是一个方向啊,如果这么小的图也能用来做检索。我说一般输入的图片不都得resize成224x224吗,这种图本身都没这么大,resize

蘼芜vodka的博客 3630

数字签名(Digital Signature)技术详解:从原理到实践

数字签名技术是数字世界身份认证和数据完整性的核心保障。它结合非对称加密和哈希函数两大密码学技术,实现双重安全防护:哈希函数确保数据完整性,非对称加密确保签名不可伪造。签名过程包括发送方用私钥加密文件哈希值生成签名,接收方用公钥验证签名并比对哈希值。RSA、DSA、ECDSA等主流算法各有特点,适用于不同场景。公钥基础设施(PKI)通过数字证书和CA认证建立信任链,确保公钥真实性。这套技术体系支撑着电子合同、软件认证、在线交易等各类数字安全应用,是现代网络信任体系的基石。

guigenyi的专栏 1373

基于Python的虚拟货币社区情绪分析与市场价格预测爬虫实现

本文探讨了如何利用Python爬虫技术获取虚拟货币社区数据,并通过情感分析预测市场价格走势。我们将使用最新的异步爬虫框架、自然语言处理技术和机器学习模型,构建一个完整的社区情绪分析系统。本文提供了详细的代码实现和理论解释,适合作为毕业设计参考。关键词:Python爬虫、虚拟货币、情感分析、价格预测、异步爬虫、机器学习爬虫框架aiohttp和httpx用于异步HTTP请求HTML解析和parsel数据存储MongoDB和Pandas用于数据处理自然语言处理库和VADER情感分析工具机器学习和。

2201_76125261的博客 524

为什么深度学习图像分类的输入多是224*224

摘抄自: https://zhuanlan.zhihu.com/p/58188430 仅用来个人学习和分享

学无止境、积少成多、厚积薄发 618

【光子 AI】AI Agent 知识体系深度研究报告

从理论基础到前沿应用:全面解析人工智能代理的核心架构、关键技术与发展趋势📅 2026 年 3 月 | 📊 深度研究报告 | 🔬 人工智能领域 | 📈 前沿技术分析**AI Agent(人工智能代理)**是一种能够感知环境、基于所获得的信息做出决策,并执行行动以影响该环境的软件系统。AI Agent 的设计旨在模仿或实现智能行为,它们可以在各种环境中操作,包括物理世界和虚拟空间。随着大语言模型(LLM)技术的突破性进展,AI Agent 正从实验室研究快速走向产业应用。根据 Gartner 发布的《2

AI天才研究院 179

深度学习训练中为什么要将图片随机剪裁(Random Crop)

这篇文章是用Markdown重写了原来的文章。图像分类中,深度学习训练时将图片随机剪裁(random crop)已经成为很普遍的数据扩充(data augmentation)方法,随机剪裁不但提高了模型精度,也增强了模型稳定性,但是它如此有效的核心原因是什么呢?仅仅是因为数据扩充吗?这个是下面我们需要研究的问题。

u010165147的博客 5841

基于爬虫+词云图+Kmeans聚类+LDA主题分析+社会网络语义分析对大唐不夜城用户评论进行分析

本项目是基于携程网中关于大唐不夜城评论的文本分析,项目中用到了Python爬虫、词频分析、词云图分析、kmeans聚类、LDA主题分析、情感分析、社会网络语义分析等。本次实验我们使用了爬虫、词云图、情感分析、LDA主题分析、TF-IDF+Kmeans、社会网络语义分析等对大唐不夜城的评论进行了分析。关于博文中的源码大家可以关注派森小木屋公众号进入粉丝群领取,如对文章有疑惑,请评论区留言。

m0_64336780的博客 1万+

LSTM在DNA序列分析中的应用:生物信息学的探索

长短期记忆网络(LSTM)是循环神经网络(RNN)的一个变种,旨在解决RNN在长序列数据中出现的梯度消失和梯度爆炸问题。LSTM通过引入“记忆单元”和三个门(输入门、遗忘门和输出门)来有效捕捉长距离依赖关系。这使得LSTM在处理DNA序列等时间序列数据时具有优势。LSTM在DNA序列分析中展现了强大的能力,能够捕捉复杂的序列特征,并提供高效的解决方案。本文从LSTM的基本原理、DNA序列特性、模型构建、训练过程到实际应用进行了详细阐述。

斌擎科技 752

为什么vs会输出一个框作为结果_【知识星球】为什么图像分类任务要从256*256中裁剪出224*224...

欢迎大家来到《知识星球》专栏,这里是AI1000问小专题。作者&编辑 | 言有三 1 图像分类任务输入尺寸相关的问题有关于经典的图像分类任务中的输入图像尺寸问题,很多同学都有疑问,我们之前已经回答过为什么图像分类网络输入大小是224*224,可以查看往期解答,【AI-1000问】为什么深度学习图像分类的输入多是224*224。今天再来回答一个与之相关的,为什么很多模型将输入缩放...

weixin_39879665的博客 214

Spring Framework 7.002.Spring IoC 容器与 Bean 简介(Introduction to the Spring IoC Container and Beans)

摘要:Spring框架的核心技术包括IoC容器和AOP技术。IoC容器通过依赖注入实现控制反转,提供Bean管理和配置功能。ApplicationContext作为BeanFactory的扩展,增加了企业级特性。文档详细介绍了容器配置、Bean定义、依赖注入、作用域等核心概念,以及基于注解的配置方式。AOP框架支持80%的AOP需求,并可集成AspectJ。此外还涵盖环境抽象、容器扩展点等高级特性,为Java企业应用开发提供全面支持。(150字)

无 214

【知识星球】ElementAI提出超复杂多尺度细粒度图像分类Attention模型

欢迎大家来到《知识星球》专栏,这里是网络结构1000变小专题。作者&编辑 | 言有三 1 Attention模型Attention机制已经被证明在很多的任务中都...

hacker_long的专栏 2771

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

【知识星球】softmax损失相关的小问题

欢迎大家来到《知识星球》专栏,这里是AI1000问小专题。作者&编辑 | 言有三 1 Softmax相关的问题Softmax在图像分类,分割任务中是很常见的,关...

hacker_long的专栏 499

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

损失函数一直不变_【知识星球】softmax损失相关的小问题

欢迎大家来到《知识星球》专栏,这里是AI1000问小专题。作者&编辑 | 言有三 1 Softmax相关的问题Softmax在图像分类,分割任务中是很常见的,关于它有些常见的小问题,供大家思考学习。有三AI1000问-机器学习篇为什么分类任务softmax损失输入是2通道,sigmoid损失是1通道想必大家都玩过图像分类了,为什么同样是2分类任务,softmax损失函数的输入是...

weixin_39531780的博客 875

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

PSPNet输入图像尺寸的讲究

PSPNet输入图像尺寸:473 or 713 一般的图像输入为224,256基本为32的整数倍。进行图像语义分割时,边缘部分因为卷积池化的关系,特征丢失多,导致边缘分割精度不好。PSPNet 将原始尺寸设定为473 or 713,通过padding后,实际的输入尺寸为480 or 720,feature map 1/8后为60 or 90,刚好与1,2,3,6 金字塔池化对应。(60 or 90...

qq_43258953的博客 1570

深度学习(3):ResNet--图像预处理

152层的 Resnet的图片输入尺寸为224*224,那对于大多数情况,图片的分辨率都是大于这个数值,那么该如何把图片的尺寸裁剪到这样一个尺寸,又如何进行数据增强呢? 第一,调整尺寸(Rescaling) 先将图片较短的那条边,随机缩放到[256,480]这样一个范围内。注意,此时的图片是等比例缩放的。举个例子,原始图片的尺寸为[1000,800,3],假设图片短边缩放到256,那么此时图片的...

weixin_41847115的博客 1万+

CNN图像的尺寸和参数计算(深度学习)

分享一些公式计算张量的尺寸,以及CNN中参数的计算。 以Alexnet网络为例,以下是该网络的参数结构图。 AlexNet网络的层结构如下: 1.Input: 图像的尺寸是2272273. 2.Conv-1: 第1层卷积层的核大小11*11,96个核。步长(stride)为4,边缘填充(padding)为0。 3.MaxPool-1: 池化层-1对Conv-1进行池化,尺寸为3*3,步长为2. 4.Conv-2: 核尺寸:5*5,数量:256,步长:1,填充:2 5.Max

左手coding,右手cooking 5853

基于深度学习的图像分类任务实现(一)线性分类器&全连接人工神经网络分类器

实现多种对Cifar-10数据集的线性、前馈神经网络分类器,并比较其算法精度。 超参数的选择对模型的效果至关重要,但线性模型和前馈神经网络模型本身就有一定的相对局限性。 本文阐述了网络设计的方法、代码编写思路,分为四个阶段:数据集加载、定义网络模型(结构)、定义损失函数和优化器、训练+测试模型。 在基于深度学习的图像分类任务实现(二)中将实现卷积神经网络分类器以及基于Residual Bolck的卷积神经网络分类器,并于二者进行比较。.........

weixin_45928096的博客 3593

CNN学习-CNN图像尺寸输入限制问题

通过CNN组成(卷积层和全连接层)进行分析。(1)卷积层   卷积层对于图像是没有尺寸限制要求的。输入图像是28*28,卷积仅于自身的卷积核大小,维度有关,输入向量大小对其无影响(如第一层卷积,输入图像的大小和维度)。 # 输入图像 x = tf.placeholder(tf.float32, [None, 784]) y_ = tf.placeholder(tf.float32, [None...

LeoLee 6022

CenterCrop图像裁剪原理

CenterCrop模式解决的就是: 图片要去两头,留中间 图片要填充满控件 我们按照Image与ImageView的宽高比差值,分两种情况进行讨论。 假设原始图片高h,宽w , Imageview的高y,宽x ,比较两者高宽比。裁剪出的图称为Image1: 1、 当 y / x - h / w > 0 时 说明Imageview的高宽比大于图片的高宽比,如图所示: 左图实线标示的是图片Image的高和宽,右图是Imageview。 我们需要从Image的中间按照...

逆流而上Mr李 1万+

matlab图像uint8和double的关系,除以255乘以255

matlab默认图像的储存和读取方式为uint8 但是为了计算和表达方便 matlab针对uint8和double都有相应操作 有时我们会疑惑 一会 iMG = double(img); imshow(uint8(IMG)*25) 一会 imshow(IMG) imwrite同样有如此操作 为什么呢?????????? 我们在使用时可以分成两个体系 在用uint8时,matlab默认图像为[0,2...

三眼二郎 1万+

深度学习样本规则裁剪(图片规则裁剪)

该代码是在处理DeepGlobe时所写,可灵活应用 deepglobe 数据训练图片和标签的大小都是1024×1024,而我们要处理成256×256;便可以使用下列代码。 def clip(): imgpath = "Original training image path" labelpath = "Original label path" imgfile = os.listdir(imgpath) labelfile = os.listdir(labelpath)

chen18876633032的博客 2197

ImageNet数据集介绍

ImageNet是一个庞大的视觉对象识别数据库,由斯坦福大学的计算机科学系开发。它是一个包含超过1400万张图像的大规模图像数据库,用于训练和评估计算机视觉算法。ImageNet数据集的目标是识别和分类图像中的各种物体和场景。它涵盖了从动物到交通工具等各个领域的图像。ImageNet数据集是一个规模庞大且多样性的图像数据库,用于训练和评估计算机视觉算法。它具有高质量的标注和挑战性的任务,广泛应用于图像分类、目标检测和图像生成等领域。

牛肉胡辣汤 7394

【深度学习】针对ImageNet---AlexNet所写的图像预处理程序(3264*2448)

/******************************************************************************************************************* *文件功能: * 1--针对AlexNet模型,进行的图片处理程序,将图片处理成256*256的大小 * 2--用于更改图片的图片名,后缀图片格式,图

maweifei的博客 3434
上一篇: 如何系统性掌握深度学习模型设计和优化
下一篇: 【图像分类】 基于Pytorch的细粒度图像分类实战
言有三
言有三 领域专家: 人工智能技术领域 领域专家: 人工智能技术领域
博客等级 码龄15年 3635粉丝 976原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

言有三

三人行必有AI

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值