如何系统性掌握深度学习模型设计和优化

基于深度学习的火焰检测系统设计与实现:YOLOv5/v6/v7/v8/v10模型实现与UI界面集成 数据集准备与预处理:使用公开火焰图像数据集或自定义采集的火焰图像,并对其进行标注和预处理。深度学习模型训练:使用YOLO系列模型进行火焰检测模型的训练,并调整模型的超参数以提升模型的检测效果。推理与测试:利用训练好的模型进行推理,对实时视频或图像进行火焰检测。UI界面设计:设计用户友好的界面,用户可以通过上传图片、视频或实时摄像头获取火焰检测结果。系统部署与性能优化:通过模型剪枝、量化等技术提高模型在实际环境中的表现。 阅读详情

640?wx_fmt=png

模型是深度学习的核心技术之一,我们平时在从事相关工作时,有很大一部分精力都在模型设计和优化上。对于新手朋友们来说,往往只会跑一跑别人的模型或者只会盲目的简单修改一下参数,不知道该如何进行设计和优化。

今天便来谈谈这个问题,同时介绍一个好的学习社区供大家讨论与提升。

文/编辑 | 言有三 

1 需要掌握哪些内容

根据不同的用途(刷榜或者工业级部署),模型设计需要实现以下目标:

(1) 获得更高的任务指标。

(2) 获得更快的运行速度。

(3) 获得更小的模型体积。

(4) 获得稳定可靠的性能。

以上各类要求其实对模型设计的侧重点又不同。要获得更高的任务指标,需要不断提高模型的学习能力。要获得更快的运行速度和更小的模型体积,需要优化模型结构。要获得性能稳定的模型,需要保证模型的通用性。

具体涉及的技术又非常多了,下面列举一些常用的。

(1) 模型深度和宽度的设计。

(2) 分辨率和感受野的设计。

(3) 卷积类型,大小,步长的设计。

(4) 正则化技术的设计。

(5) 网络拓扑结构的设计。

(5) 多尺度与信息融合的设计。

(6) 注意力等感知机制的使用。

(7) 量化与剪枝技术的使用。

(8) 半监督/无监督技术的使用。

(9) 一些工程技巧的使用。

(10) AutoML技术的使用。

除了这些内容,还涉及模型的具体训练,部署,转换等各种问题。

2 有三AI已经做了什么

有三从至少三四年之前就致力于CNN网络架构相关的设计和优化研究,至今公众号已经写过很多的文章,知乎也回答过相关的问题,直播也做过几次分享,首先我们回顾一下已有的内容!

在两年多前,有三AI就开始关注模型优化并撰写了相关综述文章和实验文章,如下:

为了压榨CNN模型,这几年大家都干了什么

【技术综述】如何Finetune一个小网络到移动端(时空性能分析篇)

在有三的新书第8章,非常详细地讨论了模型压缩理论和实战。

640?wx_fmt=png

从去年开始,我们公众号发了非常多的模型结构解读,比如主流的图像分类,分割模型。

【完结】总结12大CNN主流模型架构设计思想

640?wx_fmt=png


【完结】12篇文章带你逛遍主流分割网络

640?wx_fmt=png

现在我们又开始了GAN模型结构相关的分享,如果时间容许还会有其他任务,比如目标检测,跟踪等,很多很多。

另外,我们在《AI修行之路》的不惑境界系列中深刻探讨过网络的宽度和深度对模型性能的影响,并进行了一系列实验的验证!讲述了残差网络,分组网络,多尺度网络,注意力机制等网络的设计。

【AI不惑境】网络深度对深度学习模型性能有什么影响?

【AI不惑境】网络的宽度如何影响深度学习模型的性能?

【AI不惑境】残差网络的前世今生与原理

【AI不惑境】移动端高效网络,卷积拆分和分组的精髓

【AI不惑境】深度学习中的多尺度模型设计

有三在知乎上也开设过三个相关的直播,分别是《如何设计更加强大的CNN架构》,《如何设计更加高效的CNN架构》,《千奇百怪的CNN网络架构》内容如下:

640?wx_fmt=png

在这个网络上,比有三更熟悉各种各样的模型架构设计的朋友,已知的恐怕真不多。

3 哪里有更多更新

以上就是全部了吗?当然远远不是,仅仅是九牛一毛。几个月前开始,有三在知识星球平台每天更新各种各样的模型结构,涉及或者即将涉及几乎所有领域。

640?wx_fmt=png

已经更新有多少不记得了,可能接近200期了,最近的一个总结是这篇,【知识星球】超3万字的网络结构解读,学习必备。


不过现在应该已经超过4万字的解读了,为了方便大家收藏阅读,有三将分享做成了卡片的形式,案例如下:

有三AI知识星球-网络结构1000变

DeepRebirth

640?wx_fmt=png

在深度学习模型中有许多的非tensor网络层虽然参数很少,但是有较大的计算量,因此模型在最终部署到移动端时经常合并这些网络层从而进一步提高推理速度。

作者/编辑 言有三

模型压缩有许多的方法,比如使用小卷积,多尺度,去除全连接层,瓶颈结构等思路设计紧凑的网络,也有对权重进行量化剪枝等方法,而DeepRebirth则采用了另外一种思路,即将Non-tensor layer(包括pooling、BN、LRN、ReLU等)合并到tensor层中,因为它们虽然参数不多,但是有很大的计算量,下面首先看看经典网络中这些层的计算时间比例:

640?wx_fmt=png

640?wx_fmt=png

可以看出这些非卷积层占据了很大比例的计算时间,在Intel x86上甚至能占到一半,如果能够将其去除将大幅度的提升模型的运算速度。

作者提出了两种思路,分别是StreamLine Merging和Branch Merging。

StreamLine Merging是一种串行的合并方式,如下:

640?wx_fmt=png

通常来说,就是将Pooling、LRN,BN等网络层与相邻近的Conv层进行合并,上图的案例中经过合并后从153.8ms直接降低到了16.6ms。这里卷积本身的计算时间也大大降低,是因为pool2融合进了conv,使其步长从1变为2。

现今更为常见的情况是将BN,Scale等网络层和相邻的Conv层合并,也能降低不少计算量。

Branch Merging是一个分支的合并方式,如下:

640?wx_fmt=png

如上图,将1*1卷积层以及Pooling层分支分别合并到和它并行的3*3卷积和5*5卷积分支中。另外考虑到3*3卷积和5*5卷积分支输出通道增加会增大参数量和运算量,因此调整这些分支的输入通道进行压缩。


在进行以上的合并后,模型的性能通常会降低,所以需要重新训练,作者采用的方式是合并得到的新层使用标准的初始化方式,将其他层的参数固定不变,然后将新层的学习率设置为其他层的10倍后进行finetuning。

那么实验效果如何呢?以GoogLeNet为基准模型的实验结果如下:

640?wx_fmt=png

640?wx_fmt=png

上表展示了对不同的网络层使用以上合并策略,可以发现各种网络层的速度都有很大提升,在精度只降低0.4%的时候,能有超过3倍的速度提升。

这是非常实用且强大的一个提升模型运行速度的方法,在实际进行模型部署时,常常会对BN等网络层进行合并。

[1] Li D, Wang X, Kong D. Deeprebirth: Accelerating deep neural network execution on mobile devices[C]//Thirty-Second AAAI Conference on Artificial Intelligence. 2018.


更多的内容,下面从其中10类中随机挑选出一些给大家感受一下。

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg

640?wx_fmt=jpeg

今年的目标只有一个:做到500期以上。


4 最后要说的话

老朋友们应该都知道,有三做内容不喜欢推送信息,而是喜欢做原创,系统彻底的原创。因此,每次讲述一个模型,我不会只是告诉大家有什么,而是会细致剖析解读。

在这个系列上,我每天花的时间就超过了3个小时,后面还要增加模型训练和部署相关的内容。

因此,更多的内容都会在有三AI知识星球分享,不会继续在公众号分享。有三AI没有广告收入,希望大家能够理解支持。

如果真的需要,就加入有三AI知识星球,一起讨论学习吧。

640?wx_fmt=png

另外,网络结构只是有三AI知识星球中的一个板块,还有很多重磅,相信你不会失望。
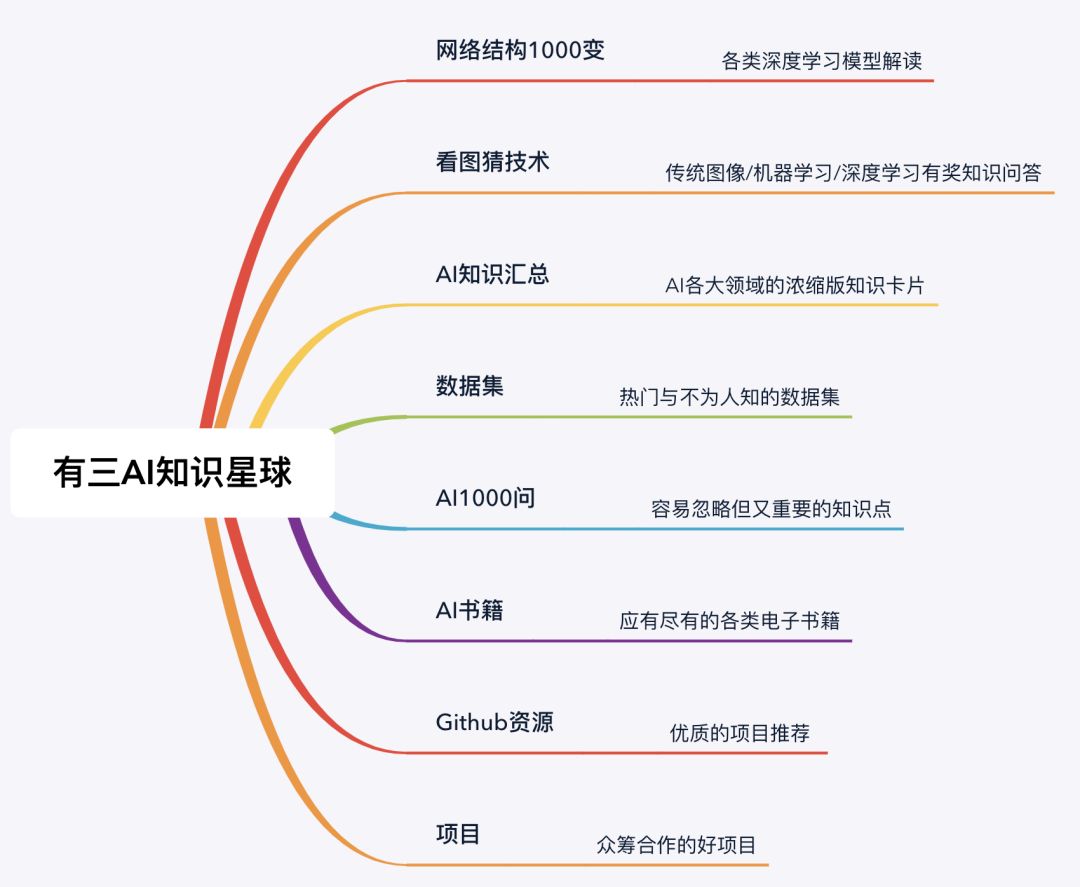
640?wx_fmt=png

已经加入的朋友,邀请一位新朋友加入,就可以获得超过50元微信红包的即时奖金噢,系统自动发放。

640?wx_fmt=jpeg

转载文章请后台联系

侵权必究

640?wx_fmt=png

640?wx_fmt=png

640?wx_fmt=png

98、构建和优化生产环境中的深度学习系统 本文详细介绍了深度学习系统在生产环境中的构建与优化方法,涵盖数据工程、模型工程、DevOps工程等生命周期管理环节,并深入探讨了部署策略(如单机、多机、容器化和云平台部署)及性能监控与优化技巧,帮助读者更好地设计高效、稳定的深度学习系统。 阅读详情

相关推荐

声音身份识别系统:设计与实现

声音身份识别技术,作为现代生物识别技术的一种,利用声音信号中包含的个人独特特征进行个体的识别与验证。在日常生活中,我们可能已经习惯了面部识别和指纹扫描等身份验证方式,但是声音识别提供了一种更为自然和便捷的方式,无需直接接触设备,通过声音即可完成识别。在深入探讨声音身份识别技术之前,本章将概述该技术的基本概念,包括其工作原理和在不同场景中的潜在应用。我们会分析声音身份识别系统的基本组成部分,并讨论如何将这些部分集成到一个完整系统中。

weixin_42502089的博客 1304

如何轻量化深度学习模型

概述卷积神经网络依靠神经网络中数以千万计的网络参数共同参与计算,存在网络结构复杂,运算量大,速度慢的缺点,并且很难移植到嵌入式设备中。随着网络模型层数越来越深,参数越来越多,减少他们的大小和计算损耗至关重要,特别是对于在线学习和增强学习这样的实时应用来说。不仅如此,近年来 VR,AR 以及智能可穿戴设备的高速发展,需要研究者们解决将大规模学习系统部署到移动设备上的问题。而达到这个目标需要从很多方面获取整合的解决方案,包括但不限于机器学习,优化方法,计算机结构,数据压缩,索引和硬件设计。这是一个重要且十分活.

andeyeluguo的博客 6147

深度学习轻松学核心算法与视觉实践源码

深度学习轻松学核心算法与视觉实践源代码 为python语言编写

知识蒸馏、轻量化模型架构、剪枝…几种深度学习模型压缩方法

模型压缩算法旨在将一个大模型转化为一个精简的小模型。工业界的模型压缩方法有:知识蒸馏、轻量化模型架构、剪枝、量化。

华为云官方博客 3857

智能车小白也能懂:手把手教你用LM358和工字电感搭建电磁循迹模块(附PCB设计避坑)

本文详细介绍了如何利用LM358运放和工字电感搭建智能车电磁循迹模块,从电感选型、电路设计到PCB布局和焊接调试,提供全流程实战指南。特别针对新手常见问题,如信号干扰、电路饱和等,给出具体解决方案和参数配置,帮助智能车比赛爱好者快速掌握电磁循迹技术。

weixin_30307921的博客 403

LaTeX新手入门以及TeXlive和TeXstudio的安装使用

作为一个新手,LaTeX的了解和使用很是费了一番功夫,因此,在这里给找不到路的同志们稍微介绍一下。如有错误,敬请指正。本篇内容基于Win10系统,因此安装在Mac或者Linux上的同学可以再找找其他的介绍文章。 目录 LaTeX介绍 LaTeX环境配置 一、TeXlive下载 二、TeXlive安装 1. 安装main installer 2. 正式安装 三、TeXstudio安装...

zywhehe的博客 21万+

2021-06-23对深度学习模型进行更小,更快,更好的综述——微软研究院

高效的深度学习:对深度学习模型进行更小,更快,更好的调查综述摘要一、引言高效的深度学习二、五个主要方面提升模型效率2.1 压缩技术2.2 学习技术2.2 自动化2.4 高效的架构2.5 基础设施 论文的作者为微软研究院,即做模型轻量化 摘要 深度学习已经彻底改变了计算机视觉,自然语言理解,语音识别,信息检索等领域。然而,随着深度学习模型的逐步改进,他们的参数数量,延迟,培训所需的资源等都有显着增加。因此,要注意模型的这些足迹度量,而且不仅仅是其质量变得重要。我们呈现并激励深度学习效率的问题,随后对模型效率

m0_47180208的博客 684

「免费开源」从 OCR 识别到结构化输出:合同文本高效比对的完整解决方案!

本文将系统拆解这一解决方案的技术逻辑、实施步骤与落地价值,为企业合同管理数字化转型提供实操指南。字段提取:自动识别并提取预设的关键字段(如 “甲方”“乙方”“合同金额”“履约期限” 等),若遇到模糊表述(如 “付款时间为合同签订后 30 个工作日内”),系统可自动解析为 “履约期限:合同签订日 + 30 工作日”;预设结构化字段:根据合同类型(如采购合同、服务合同、租赁合同),定义需提取的关键字段(如 “甲方名称”“乙方名称”“合同金额”“有效期起 / 止日期”“履约地点”“违约金比例” 等);

qxsz_yyh的博客 836

深度学习之模型轻量化

模型的权值参数往往以32位浮点数的形式保存,神经网络的参数,会占据极大的存储空间,因此,如果在存储模型参数时将 32 位浮点数量化为8位的定点数,可以把参数大小缩小为原来的1/4,整个模型的大小也可以缩小为原来的1/4,不仅如此,随着参数量化后模型的减小,网络前向运算阶段所需要的计算资源也会大大减少。,该值越小,说明对应的神经元对网络输出结果影响越小,属于不重要的神经元,应该被移除,对应的连接也应被剪除。,网络性能和准确度依然会受到较大的影响,为了消除这些影响,一个很重要的步骤是对。

ajin156的博客 5224

AFSim 2.9中文手册实战指南:从安装到高级功能详解(附B站视频链接)

本文详细介绍了AFSim 2.9的安装配置、基础功能操作和高级功能应用,帮助用户快速掌握这款强大的仿真平台。从系统要求检查到多体动力学仿真,再到性能优化技巧,全面解析AFSim 2.9的使用方法,适合初学者和进阶用户参考。

weixin_30892037的博客 569

【数据挖掘】心跳信号分类预测 之 特征工程 —— 学习笔记(三)

三、特征工程 3.1 看书 常言道,“巧妇难为无米之炊”。在 ML 中,数据和特征将作“米”,模型和算法则为“妇”。若无数量充足的数据、良好表示的特征,再强大的模型也难以得到满意的结果 (garbage in,garbage out)。对于 ML 问题,数据和特征往往决定了结果的上限,而模型、算法的选择及优化则是在逐步接近该上限。 特征工程,顾名思义,是对原始数据进行一系列工程处理,将其提炼为特征,作为输入供算法和模型使用。在本质上,特征工程是一个表示和展现数据的过程。在实际中,特征工程旨在去除...

闻韶 3359

高效深度学习:让模型更小、更快、更好!

作者|太子长琴整理|NewBeeNLP自从 AlexNet 在 ImageNet 上大放异彩后,图像就进入了预训练时代,随后 VGGNet,Inception,ResNet 不...

Kaiyuan_sjtu的博客 3920

OpenClaw 在 Windows 环境下的完整安装、配置和部署指南

介绍Windows环境下OpenClaw的完整安装,配置和部署的全流程

hxbao的专栏 1486

【视频课】3层境界,如何掌握深度学习模型设计、优化、部署

好的模型结构是深度学习成功的关键因素之一,不仅是非常重要的学术研究方向,在工业界实践中也是模型是否能上线的关键。对各类底层深度学习模型设计和优化技术理解的深度是决定我们能否在深度学习项目中...

hacker_long的专栏 775

FineBI学习总结

交叉表:一组作为行标题显示在表的左部,另一组作为列标题显示在表的顶部。连接到数据,如果数据不满足数据分析的需求,先进行自助数据集处理。数据集分类:DB表、SQL、Excel、自助数据集。分组表:将报表中的数据按相同项合并为一组显示。1、数据准备2、制作仪表板3、分享仪表板。左合并:保留左边全部数据,合并右边。右合并:保留右边全部数据,合并左边。上下拼接:上下拼接到一张表数据。3、如何实现拼表:多表拼一张。分组–业务包–数据集–字段。字段分类:数值、文本和日期。目录–仪表板–数据准备。维度:文本和日期类型。

Rsun2018的博客 1562

出现Command ‘vim‘ is available in the following places,vim: command not found等解决方法

内置命令无法识别,说明系统变量有误,导致无法识别,既然系统变量有误,将其注释或者更改为正确的即可,但是现在打不开,又怎么注释掉。替换vim来打开编辑,打开之前错误的全局变量文件,发现变量有误,要么注释要么改为。系统变量有全局变量(通过命令行printenv或者echo)和局部变量。对应通过vim修改错误的变量文件,不然source也无法让配置文件生效。本身vim是系统内置的命令,连vim都出现问题。修改为正确的即可,之后还需要重启服务器,使用。之后即可成功,通过即可查看命令是否有写入。...

码农研究僧的博客 5884

【人工智能】【机器学习】- 好书推荐之《深度学习调参指南》

深度学习调参指南》是一份由Google和哈佛大学的研究人员与工程师共同编写的实战手册,旨在帮助读者系统性地优化深度学习模型的性能。该指南强调了在深度学习实践中遇到的实际问题和解决方案,尤其关注超参数调优的过程,同时也涉及工作流实施和优化等其他方面。

技术分享、程序员趣事、行业趋势等内容! 1274

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

【一对一小组】2024年有三AI-CV中阶-模型算法组发布,如何循序渐进地学习好模型原理与落地...

2024年有三AI-CV中阶-模型算法组正式发布!有三AI已经推出了CV初-中-高级培养计划(原名有三AI-CV季划),这是我们的终身计算机视觉学习小组。该培养计划具有以下特点:【系统性】配套有非常完备的理论与实践【永久性】不限制学习期限,一直有效【成长性】内容保持更新,不额外收费【专业性】原创书+视频讲解+真实项目锻炼【丰富性】数千页PPT,文档,项目等【权威性】工业界资深背景辅导老师,弱运营属...

hacker_long的专栏 1305

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

【一对一小组】2024年有三AI-CV中阶-模型算法组发布,如何循序渐进地学习好模型原理与部署落地...

2024年有三AI-CV中阶-模型算法组正式发布!有三AI已经推出了CV初-中-高级培养计划(原名有三AI-CV季划),这是我们的终身计算机视觉学习小组。该培养计划具有以下特点:【系统性】配套有非常完备的理论与实践【永久性】不限制学习期限,一直有效【成长性】内容保持更新,不额外收费【专业性】原创书+视频讲解+真实项目锻炼【丰富性】数千页PPT,文档,项目等【权威性】工业界资深背景辅导老师,弱运营属...

hacker_long的专栏 1331

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

21、深度学习综合实践 - 从理论到应用的完整实战(MNIST手写数字识别)

深度学习项目开发流程的系统学习,包括问题定义、数据准备、模型设计、训练调优、评估部署等完整环节。MNIST手写数字识别项目的深入实现,从数据加载和预处理开始,设计多层全连接网络架构,实现完整的训练和测试流程。模型调优技巧的学习,包括学习率调整、批大小选择、网络深度和宽度的设计原则,正则化方法的应用。训练过程的可视化和监控,学习使用TensorBoard等工具跟踪训练过程,分析损失函数和准确率的变化趋势。模型性能分析方法,学习错误样本分析、混淆矩阵解读、模型解释性分析等技能。

开源AI 专属 UI——papyrai-ui。《千界明彻录》(故事形式构建元思维)——胡说小说。更多思辨内容在公众号。 834

计算机毕业设计Python深度学习物流网络优化与货运路线规划系统 智慧交通 机器学习 大数据毕设(源码 +LW文档+PPT+讲解)

计算机毕业设计Python深度学习物流网络优化与货运路线规划系统 智慧交通 机器学习 大数据毕设(源码 +LW文档+PPT+讲解)

全网计算机/大数据辅导(自媒体)道祖第一人、全网粉丝100W+,专注于大学生项目实战开发,讲解,毕业答疑辅导,高校老师/讲师/同行合作。以及产品测评宣传、工具推广等合作。同时招收学生代理、校园代理。 1086

计算机毕业设计Django+Vue.js深度学习股票行情分析预测 量化交易分析 大数据毕业设计(源码+LW文档+PPT+讲解)

计算机毕业设计Django+Vue.js深度学习股票行情分析预测 量化交易分析 大数据毕业设计(源码+LW文档+PPT+讲解)

全网计算机/大数据辅导(自媒体)道祖第一人、全网粉丝100W+,专注于大学生项目实战开发,讲解,毕业答疑辅导,高校老师/讲师/同行合作。以及产品测评宣传、工具推广等合作。同时招收学生代理、校园代理。 889

D-FINE模型标准化:模型格式标准化与互操作性保障

在深度学习目标检测领域,模型部署的标准化一直是制约技术落地的关键瓶颈。传统DETR(Detection Transformer)架构虽然性能优异,但在实际部署中面临着框架兼容性差、推理效率低、跨平台迁移困难等诸多挑战。D-FINE作为重新定义回归任务的创新架构,通过Fine-grained Distribution Refinement(细粒度分布精炼)技术,不仅在检测精度上实现了突破,更在模型标...

gitblog_00238的博客 591

如何通过深度学习蛋白质设计论文库加速生物技术创新

想象一下,你是一位生物信息学研究员,面对一个紧迫的医疗需求:需要设计一种能够精准靶向癌细胞表面蛋白的新型抗体。传统方法需要数月甚至数年的试错实验,而深度学习技术正在将这个过程缩短到几周甚至几天。这个深度学习蛋白质设计论文库正是连接前沿人工智能技术与实际生物医学应用的关键桥梁,为研究者提供了从理论到实践的完整知识地图。 深度学习蛋白质设计论文库不仅仅是一个静态的资源集合,而是一个动态生长的知识生态

gitblog_01024的博客 909

PyTorch深度学习7天速成:从环境配置到模型部署实战指南

深度学习作为人工智能的核心技术,通过神经网络模拟人脑学习机制实现智能决策。其原理基于反向传播算法优化网络参数,在计算机视觉、自然语言处理等领域展现巨大技术价值。PyTorch凭借动态计算图和Pythonic设计,成为当前最流行的深度学习框架之一,特别适合快速原型开发和学术研究。在实际应用中,PyTorch通过张量运算和自动微分机制简化模型构建,配合TorchVision、TorchText等扩展库支持多领域任务。本文基于2026年最新技术环境,提供包含环境配置、模型训练、性能优化的完整7天学习路线,帮助开发

weixin_30596343的博客 386

实战开发:AI 语音合成系统的设计与实现(本科毕业设计全流程)

技术落地:实现了 “文本→梅尔频谱→语音波形” 的端到端合成,中文 / 英文合成音质达行业优秀水平(PESQ>3.5),实时性满足交互场景(RTF=0.08);工程优化:通过数据清洗、数据增强提升模型泛化能力,通过 Redis+RabbitMQ 优化系统并发与实时性,解决 “训练久、合成慢” 的工程痛点;易用性:提供 Web 界面,用户无需技术背景即可操作,支持语音下载与反馈,可直接用于智能助手、有声读物等场景。数据质量差导致模型训练发散。

858
上一篇: 【每周NLP论文推荐】 NLP中命名实体识别从机器学习到深度学习的代表性研究
下一篇: 【知识星球】为什么图像分类任务要从256*256中裁剪出224*224
言有三
言有三 领域专家: 人工智能技术领域 领域专家: 人工智能技术领域
博客等级 码龄15年 3635粉丝 976原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

言有三

三人行必有AI

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值