【模型解读】从2D卷积到3D卷积,都有什么不一样

3D卷积神经网络详解 1 3d卷积的官方详解 2 2D卷积与3D卷积 1)2D卷积 2D卷积:卷积核在输入图像的二维空间进行滑窗操作。 2D单通道卷积 对于2维卷积,一个3*3的卷积核,在单通道图像上进行卷积,得到输出的动图如下所示: 2D多通道卷积 在之前的2D单通道的例子中,我们在一张图像上使用卷积核进行扫描,得到一张特征图。这里的“被扫描图像”是一个通道,而非一张彩色图片。如果卷积核每扫描一个通道,就会得到一张特征图,那多通道的图像应该 被怎样扫... 阅读详情

接着模型解读系列,在中国科幻作家刘慈欣的科幻小说《三体Ⅲ·死神永生》中,首次提出了降维打击这个概念,这是本质上区别于同一维度的攻击,破坏性也更大。

而现在我们要说的是从二维卷积升级到三维卷积,它相比2D卷积是否会有不一样呢?

作者 | 言有三

编辑 | 言有三

01

3D卷积

首先看一下二维卷积,一个3*3的卷积核,在单通道图像上进行卷积,得到输出。
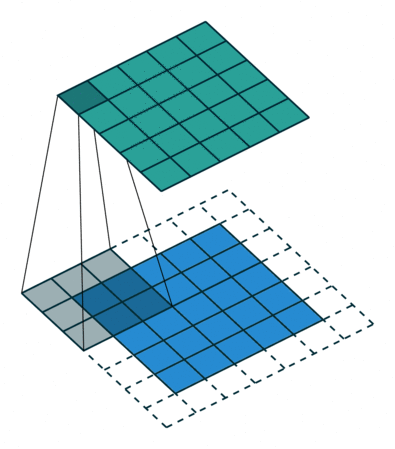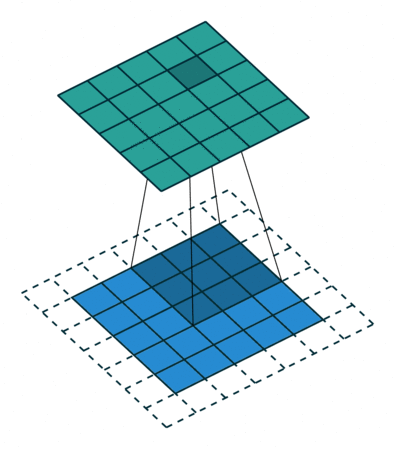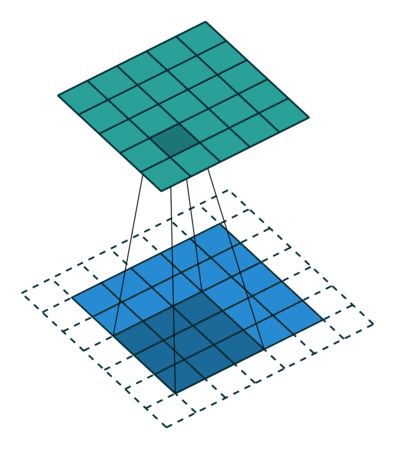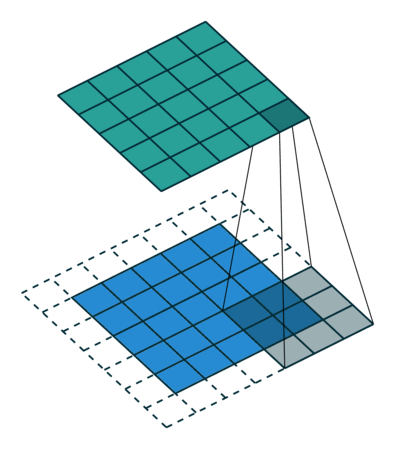
640?wx_fmt=gif

然后我们再看一下3维卷积,一个3*3*3的卷积核在立方体上进行卷积,得到输出。
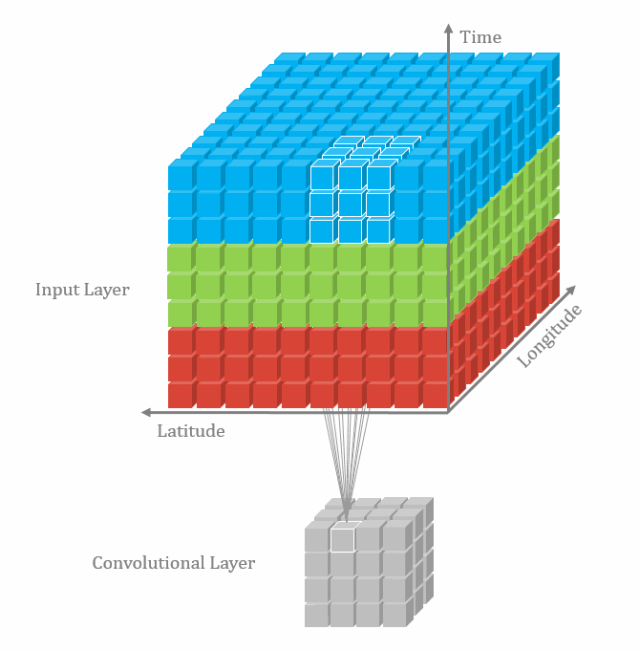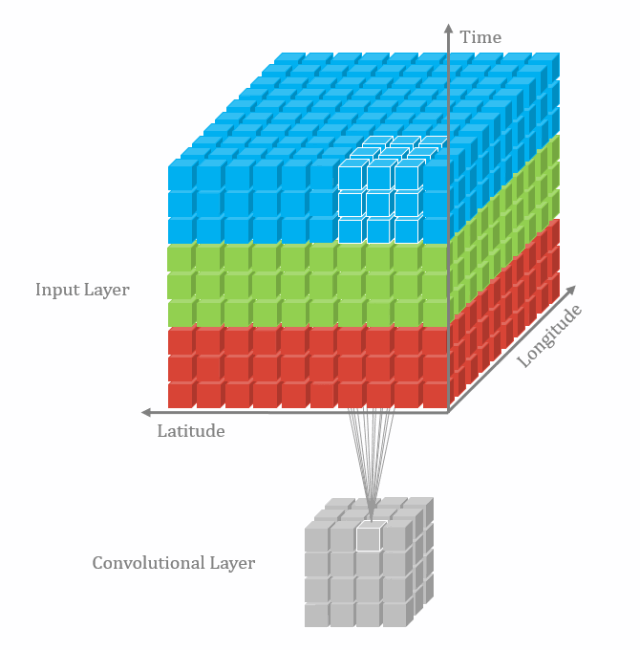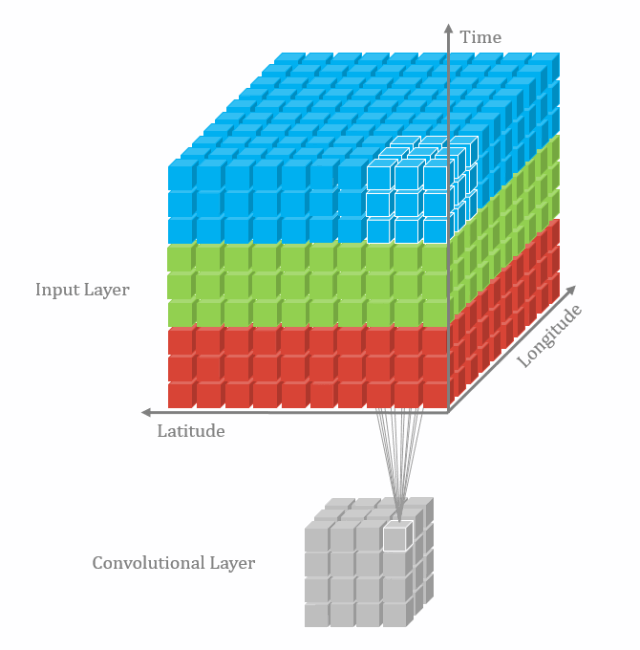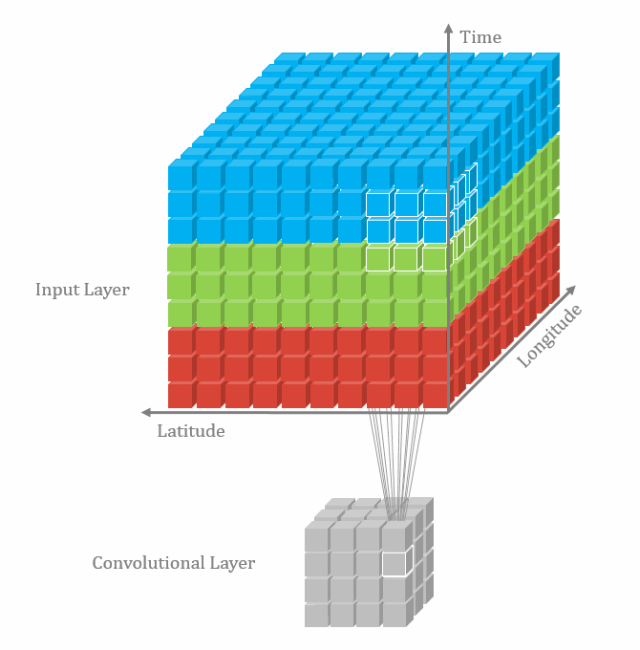
640?wx_fmt=gif

就是这样,没什么其他花样了。

可能有人会问,这跟多通道卷积有什么区别呢?

有。

多通道卷积不同的通道上的卷积核的参数是不同的,而3D卷积则由于卷积核本身是3D的,所以这个由于“深度”造成的看似不同通道上用的就是同一个卷积,权重共享嘛。

总之,多了一个深度通道,这个深度可能是视频上的连续帧,也可能是立体图像中的不同切片。

02

3D卷积的应用

上面也说了,3D卷积就是多了一个深度通道,而这个深度通道可能是视频上的连续帧,也可能是立体图像中的不同切片,所以从应用上来说,主要就是两大主要方向。

2.1 视频分类

相比于2D图像,什么数据多了一个维度呢?当然就是视频了,视频的帧数,就是完美的另一个深度维度,将3D卷积用于视频的分类,再自然不过,关键就是看谁先来干。

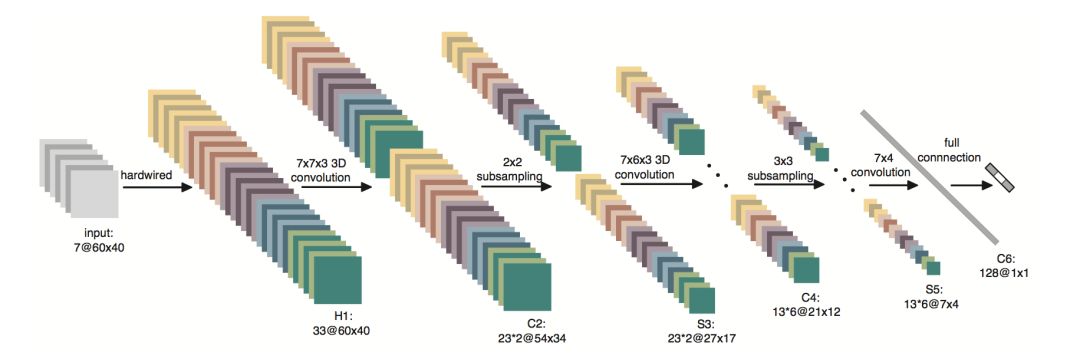
据我所知,文【1】是最早的,看看他们使用的网络结构。
640?wx_fmt=png

网络很浅,只有3个卷积层和1个全连接层,2个池化层,这样的网络规模和LeNet5可以称兄道弟了。不过3D多了一个维度,计算量自然是多了很多。

这里有两个3D卷积层,卷积核大小分别是7x7x3,7x6x3,前两维是空间的卷积,后一维是时间的卷积,看得出来,不需要保持一致,而且通常空间的卷积核大小和时间就不会一致,毕竟处理的“分辨率”不同。


这个网络结构在视频分类数据集UCF-101上的top-1精度为63.3%,别看这个指标不高,其他的比如LSTM,双流网络等也差不太多,而普通的2D卷积或者传统方法则要低于这个指标。

更细致的三维卷积在视频分类中应用的网络结构的探索在文【2】中,感兴趣读者可以自取。

2.2 图像分割

既然可以用于分类,自然也可以用于分割。不过对视频使用3D卷积似乎优势并不大,而在医学领域的应用前景更大一些。

医学数据通常都是3D的,比如CT扫描的数据,虽然我们看的片子是2D的,但其实那只是一个切片,真正的扫描数据是3D的。

而如果要分割出一些病变组织,比如肿瘤,也必须是3D的。
640?wx_fmt=jpeg

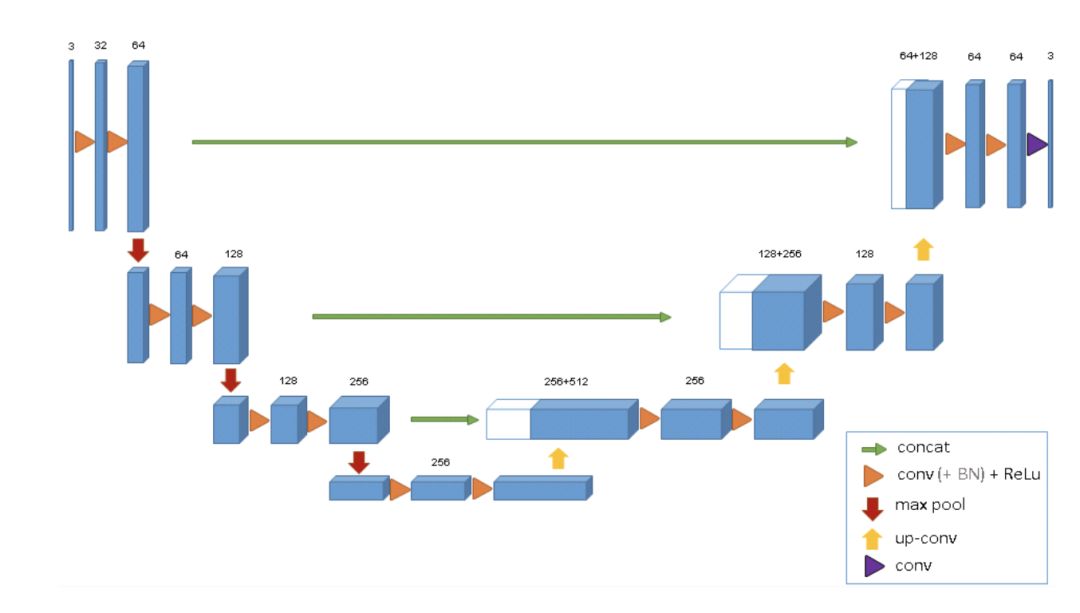
具体的网络结构就是将U-Net改为3D的形式。

640?wx_fmt=png

就讲这么多,未完待续。

【1】Ji S, Xu W, Yang M, et al. 3D convolutional neural networks for human action recognition[J]. IEEE transactions on pattern analysis and machine intelligence, 2013, 35(1): 221-231.

【2】Tran D, Bourdev L, Fergus R, et al. Learning spatiotemporal features with 3d convolutional networks[C]//Proceedings of the IEEE international conference on computer vision. 2015: 4489-4497.

【3】Casamitjana A, Puch S, Aduriz A, et al. 3D Convolutional Neural Networks for Brain Tumor Segmentation: a comparison of multi-resolution architectures[C]//International Workshop on Brainlesion: Glioma, Multiple Sclerosis, Stroke and Traumatic Brain Injuries. Springer, Cham, 2016: 150-161.

总结

我们面临的很多的数据都是高维的,比如街景地图,比如视频,比如医学图像,比如点云,将二维拓展至更高维的卷积也是很自然的想法,总之多尝试吧。

转载文章请后台联系

侵权必究

更多请关注知乎专栏《有三AI学院》

640?wx_fmt=png

640?wx_fmt=png

640?wx_fmt=png

往期精选

想要变身”AI专家“,就戳戳手指关注我们吧

别忘了点“好看”支持作者噢  ??? 

3D卷积神经网络:原理、应用与深入解析 你把这个小盒子放在积木堆的一个位置,然后把小盒子里的所有积木的数字加起来,得到一个新的数字。最后,你会得到一个新的、更小的积木堆,这个新的积木堆就是3D卷积的输出。在3D卷积中,卷积核(也称为滤波器)的大小、形状和权重都是通过训练得到的。3D卷积,或称为三维卷积,是卷积神经网络(CNN)中的一种技术,用于处理三维数据,如医学图像(如MRI、CT扫描)或视频数据。由于1万字的要求过于庞大,我将先给出3D卷积的原理、图示和公式,并尽量以通俗易懂的方式解释,如果您确实需要更多内容,可以在输出结束后输入“继续”。 阅读详情

相关推荐

深度学习-三维卷积神经网络(3DCNN)

深度学习-三维卷积神经网络(3DCNN)

weixin_40826634的博客 8799

吴恩达-深度学习-卷积神经网络-多层卷积 笔记

你已经知道如何对二维图像做卷积了,现在看看如何执行卷积不仅仅在二维图像上,而是三维立体上。 我们从一个例子开始,假如说你不仅想检测灰度图像的特征,也想检测RGB彩色图像的特征。彩色图像如果是6×6×3,这里的3指的是三个颜色通道,你可以把它想象成三个6×6图像的堆叠。为了检测图像的边缘或者其他的特征,不是把它跟原来的3×3的过滤器做卷积,而是跟一个三维的过滤器,它的维度是3×3×3,这样这...

洪流之源 1万+

【AI】高光谱图像分类 — HybridSN模型

文章目录前言实验目的论文地址1、这篇论文讲了个啥?论文细节2、2D卷积和3D卷积的区别2D卷积:3D卷积: 前言 实验目的 阅读论文《HybridSN: Exploring 3-D–2-DCNN Feature Hierarchy for Hyperspectral Image Classification》,并思考3D卷积和2D卷积的区别; 同时,阅读代码:https://gaopursuit.oss-cn-beijing.aliyuncs.com/202010/AIexp/10%20-%20Hybri

火火的博客 1万+

三维卷积( 3D CNN)

​ 3D CNN主要运用在视频分类、动作识别等领域,它是在2D CNN的基础上改变而来。由于2D CNN不能很好的捕获时序上的信息,因此我们采用3D CNN,这样就能将视频中时序信息进行很好的利用。首先我们介绍一下2D CNN与3D CNN的区别。如下图所示,a)和b)分别为2D卷积用于单通道图像和多通道图像的情况(此处多通道图像可以指同一张图片的3个颜色通道,也指多张堆叠在一起的图片,即一小段视频),对于一个滤波器,输出为一张二维的特征图,多通道的信息被完全压缩了。而c)中的3D卷积的。

qq_54695558的博客 9628

FAN 2D/3D人脸关键点预测论文解读

论文全称为: How far are we from solving the 2D & 3D Face Alignment problem? (and a dataset of 230,000 3D facial landmarks) 简介       ICCV 2017的论文,结合最先进的人脸特征点定位(landmark localization)架构和最先进的残差模块(residu...

rainforestgreen的博客 4574

【Cylinder3D论文解读及代码略解】

Cylinder3D论文解读及代码略解论文解读AbstractIntroductionRelated work室内点云分割室外点云分割3D体素划分Methodology(本文方法)Cylindrical PartitionAsymmetrical 3D Convolution NetworkAsymmetrical Residual BlockDDCMPoint-wise Refinement Module目标函数实验部分Dataset and Metricsemantic KITTI:nuScenes:E

sunny_ran123的博客 4206

「模型解读」从2D卷积到3D卷积,都有什么不一样

https://www.toutiao.com/a6711317983035130371/ 接着模型解读系列,在中国科幻作家刘慈欣的科幻小说《三体Ⅲ·死神永生》中,首次提出了降维打击这个概念,这是本质上区别于同一维度的攻击,破坏性也更大。 而现在我们要说的是从二维卷积升级到三维卷积,它相比2D卷积是否会有不一样呢? 作者 | 言有三 编辑 | 言有三 1 3D卷积 首先看一...

喜欢打酱油的老鸟 987

【OpenPCDet】稀疏卷积SPConv-v1.2代码解读(1)

以下左图展示了一个2D卷积,使用一个3x3的卷积核,在单通道图像上进行卷积,其中Padding为1,得到输出。右图为一个单通道的3D卷积,与2D卷积不同之处在于,输入图像多了一个 depth 维度,卷积核也多了一个depth维度,之前2D卷积上3x3的卷积核现在变成了3x3x3。这里的3D不是通道导致的,而是深度(多层切片,多帧视频),因此,虽然输入和卷积核和输出都是3D的,但都可以是单通道的。

3703

3d卷积神经网络_【模型解读】从2D卷积到3D卷积,都有什么不一样

接着模型解读系列,在中国科幻作家刘慈欣的科幻小说《三体Ⅲ·死神永生》中,首次提出了降维打击这个概念,这是本质上区别于同一维度的攻击,破坏性也更大。而现在我们要说的是从二维卷积升级到三维卷积,它相比2D卷积是否会有不一样呢? ...

weixin_42347486的博客 1394

3D卷积真的比2D强?UNet-3D/2D在肺部CT分割中的对比实验(PyTorch实现)

本文通过PyTorch实现的严谨对比实验,量化分析了UNet-3D与2D U-Net在肺部CT分割任务中的性能差异。实验表明,3D卷积能有效利用空间上下文信息,在Dice系数等指标上显著优于2D模型,但也带来了显存占用和训练时间的巨大挑战。文章为不同硬件配置与项目目标提供了清晰的选型指南和工程优化策略。

weixin_29056101的博客 378

【CVPR 2024】论文解读,DeCoTR:使用 2D 和 3D 注意力增强深度补全

本文提出了一种结合2D和3D注意力的新方法,用于在不需要迭代空间传播的情况下实现高精度的深度补全。首先,通过在2D特征上应用注意力机制增强了基线卷积深度补全模型的性能。然后,将2D特征提升为3D点云并构建3D点变压器来处理这些点,从而使模型能够显式地学习和利用3D几何特征。此外,还提出了点云归一化技术,以改进学习过程,提升模型精度。我们在NYU Depth V2和KITTI等基准数据集上评估了该方法DeCoTR,并展示了其优越的性能。进一步的零样本评估显示了DeCoTR的出色泛化能力。

2401_87064292的博客 719

卷积核和全连接层的区别_【模型解读】从2D卷积到3D卷积,都有什么不一样

接着模型解读系列,在中国科幻作家刘慈欣的科幻小说《三体Ⅲ·死神永生》中,首次提出了降维打击这个概念,这是本质上区别于同一维度的攻击,破坏性也更大。而现在我们要说的是从二维卷积升级到三维卷积,它相比2D卷积是否会有不一样呢?作者 | 言有三编辑 | 言有三013D卷积首先看一下二维卷积,一个3*3的卷积核,在单通道图像上进行卷积,得到输出。然后我们再看一下3维卷积,一个3*3*3的卷积核在...

weixin_39748183的博客 295

【lidar】3D目标检测PointPillars:论文解读、代码解读、部署实现(1)

Abstract 点云中的目标检测是自动驾驶等机器人应用中的一个重要方面。在本文中,作者思考了将点云编码成适合下游检测pipeline的格式问题。最近的文献提出了两种类型的编码器:固定编码器往往更快,但牺牲了准确性,而从数据学习的编码器更准确但是速度较慢。在这篇工作中,作者提出了一种可以利用PointNet去学习以垂直列组织的点云的表示(pillars)的新的encoder。这种编码特征可以用于任何标准的2D卷积检测体系结构,接着作者进一步提出了一个精简的下游网络。大量的实验表明,PointPillars.

踟蹰横渡口,彳亍上滩舟。 5417

UNet 、3D-UNet 、VNet 区别

UNet 、3D-UNet 、VNet 区别 医学图像的几个常用模型,简单总结一下。 三个model的代码在我的Github上,可以参考一下:(https://github.com/VickyLLY/unet_liver_pytorch 文章目录UNet 、3D-UNet 、VNet 区别一、UNet二、3D-UNet三、VNet 一、UNet 创新点: U型结构,下采样,上采样;短接通道(skip-connection) 二、3D-UNet 2D结构的U-Net是基本一样,唯一不同:2D操作换成了3D

qq_36484003的博客 3万+

Android 12高通thermal-engine调试实战:如何快速开启debug日志并解决CPU降频问题

本文详细介绍了Android 12高通thermal-engine的调试实战,包括如何快速开启debug日志、解读关键日志信息以及解决CPU降频问题。通过优化配置文件和调整温控策略,开发者可以有效提升设备性能,避免因温度管理导致的性能瓶颈。

i3j4k5的博客 308

关于使用CMT2300A FIFO缓存区间设置为64Byte的问题

帮助你解决在使用CMT2300A 时遇到的各种问题,若有需要,请及时与我交流

teleger的博客 1429

3D卷积论文阅读与代码复现:Learning Spatiotemporal Features with 3D Convolutional Networks

前言 最近由于一些必要的需求,要学习3D卷积网络的相关用法和实现,学习过程中不可避免要阅读相关的论文,其中这篇Learning Spatiotemporal Features with 3D Convolutional Networks是最值得研究的一篇相关论文之一,在学习的时候做好相关笔记以便后面遗忘时候快速捡起来。 摘要(copy) 提出了一种基于大尺度监督视频数据集的深度三维卷积网络学习时空...

贵在坚持 9466

对LSTM中每个batch都初始化隐含层的理解

不知道有没有人和我有一样疑惑 在LSTM相关的代码中,为什么每个batch都会将隐藏层重新初始化, 这样不会把以前训练出来的参数丢掉吗?? 比如 代码来自GitHub 看了一些解释是h与c是状态,不是参数,每个batch中都需要初始化为0,LSTM 中的参数是W,b。 网络中训练的是参数,不是状态。 说真的。。。当时我没怎么看懂。。。 咨询了实验室的师兄后,我有了自己的理解 产生误解的主要原因是我对RNN和LSTM的结构理解不深入,我们通常看到RNN结构图基本都是这样的 ...

Chauncey_Wang的博客 5911

【3D目标检测】PIXOR: Real-time 3D Object Detection from Point Clouds解读

文章目录前言摘要1. 介绍2.相关工作3. 框架4 结果总结 前言 1. 为什么要做这个研究? 2. 实验方法是什么样的? 3. 得到了什么结果? 摘要 作者解决了自动驾驶环境下直接从点云进行实时3D目标检测的问题。通过鸟瞰图(BEV)表示场景,可以更加有效地利用3D数据,并提出了PIXOR,一种无候选框的one-stage检测器。PIXOR能够在高精度和实时效率(10 FPS)之间取得平衡。 1. 介绍 3D目标检测使用的数据源包括RGB-D传感器得到的带有深度信息的图像和激光雷达得到的点云数据。雷达

毛毛的博客 1722

AIGC内容溯源技术:如何追踪AI生成内容的原始来源

本文旨在系统性地介绍AIGC内容溯源的技术体系,帮助读者理解如何追踪AI生成内容的来源。我们将覆盖从基础概念到前沿技术的完整知识链,包括但不限于数字水印、区块链存证、内容指纹等技术方案。文章将从AIGC的基本概念出发,逐步深入探讨各种溯源技术,分析其原理和实现,最后讨论实际应用和未来趋势。AIGC:AI Generated Content,人工智能生成内容内容溯源:追踪数字内容的创作、修改和传播历史数字水印:嵌入在数字内容中的不可见识别信息数字水印:隐藏在内容中的识别信息,像隐形墨水内容指纹。

SuperAGI2025 2073

MQL5教程 01 MT5有关EA的操作、MetaEditor 工具栏主要功能

MQL5教程 01 MT5有关EA的操作、MetaEditor 工具栏主要功能

weixin_42830015的博客 3991

学习笔记——I3D论文解读

当时主流的动作识别数据集(UCF-101、HMDB-51)规模极小:UCF-101 仅 1.3 万段视频,HMDB-51 仅 0.7 万段视频,且类别数少(51-101 类)、场景单一。

m0_63110102的博客 1113

桁架 拓扑优化 matlab程序_拓扑优化在结构轻量化及板壳加筋肋最优布置的应用...

1 拓扑优化简介材料的有效利用一直都是人类追求的目标,也是许多研究领域不变的话题,并伴随着结构优化理论和方法的产生而发展。结构优化设计通常分为三个层次:(1)拓扑优化:在一个确定的连续区域内寻求结构内部非实体区域位置和数量的最佳配置,寻求结构中的构件布局及节点联结方式最优化,使结构能在满足应力、位移等约束条件下,将外载荷传递到结构支撑位置,同时使结构的某种性态指标达到最优;(2)形状优化:指在保持...

weixin_39525355的博客 1878

深度学习——深入解读各种卷积的应用场景优劣势与实现细节

本文介绍了深度学习中常见的多种卷积类型,包括它们的定义、工作原理、优缺点以及应用场景。通过这些介绍,希望能帮助读者更好地理解卷积在深度学习中的作用,以及如何根据具体需求选择合适的卷积类型。

知来者逆的博客 1494

STM32CubeMX | HAL库实战:ADC多通道采集模式深度解析(轮询、DMA、TIM触发)

本文深度解析了基于STM32CubeMX与HAL库实现ADC多通道数据采集的三种核心模式:轮询、DMA以及TIM触发DMA。文章通过对比分析,详细阐述了各模式的配置要点、适用场景与潜在陷阱,旨在帮助开发者根据实时性、CPU占用及采样精度等需求,选择并实现高效稳定的多通道数据采集方案。

postgres8guard的博客 973

099、多摄融合与变焦系统:广角到长焦的无缝切换算法

本文分享了多摄融合与变焦系统开发中的实战经验和关键挑战。作者通过一个旗舰机项目案例,揭示了广角到长焦切换时画面抖动问题的根源——融合算法误将视差当作运动补偿,并提出"视差冻结窗口"的解决方案。文章总结了三大多摄融合难点:物理视差处理、亮度差异补偿和切换时机把控,详细阐述了分层架构设计、融合权重计算等核心技术。同时强调了产线校准的重要性,并给出五项实用建议:允许边缘鬼影保留、参数场景化配置、加强产线检测、完善调试接口,以及合理运用AI技术。全文展现了多摄融合技术在时间、空间和感知维度上的复杂平衡艺术。

sundong_81的博客 48
上一篇: 【AI白身境】深度学习中的数据可视化
下一篇: 【研究院】滴滴研究院,都在做什么
言有三
言有三 领域专家: 人工智能技术领域 领域专家: 人工智能技术领域
博客等级 码龄15年 3635粉丝 976原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

言有三

三人行必有AI

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值